作者: 朵朵菊花向阳开
青稞社区为科研人员提供成果宣传支持,如有优秀研究成果分享推广,欢迎投稿联系:aiFreeCode
感谢青稞社区和知乎的邀请,在几周前有幸作为主持人 host 了一场关于 RSI 的 AMA,直播传送门:https://qingkeai.online/blog/2026-RSI
跟几位 RSI 一线的研究学者探讨了一些比较有意思的话题,从 RSI 的定义开始,聊到现有的技术路线,不同技术路线各自的瓶颈,还有哪些任务上会存在天花板。针对这个 Topic,现在有很多 Benchmark,我们也探讨了该评测什么样的能力、哪些能力值得评测。我们也简单聊了 RSI 未来可能是什么形态,人在里面会扮演什么样的角色。
对我而言,收获颇丰。然后正好也就着这个问题,RSI 相关的 Benchmark,多聊聊自己的看法。
〇、前期探索
从25年年底开始,我们就在尝试做这样两个工作:
首先是 StudyBench,在这个工作中,我们希望对 self-evolving 方法本身进行评测。一方面,模型需要不断吸收新知识,吸收其在 pretrain, midtrain, posttrain 等阶段没见过的知识;另一方面,模型需要不断对已有知识进行重新理解,从知道知识走向会用知识。所以问题在于,我们该怎么衡量一个“自进化”方法,是真的让模型变强了,还是只是让它多背了一点东西?
一个系统光能从环境里吸收新知识还不够,更关键的是,它能不能把这些知识变成解决新问题的能力,而不是记住或者复述见过的东西。说白了,吸收知识受限于训练材料本身写了什么,但现实世界的问题,很少在训练材料里有直接先例。所以自进化到底能不能“超越它所消耗的数据”,核心就看它知识到能力转化的效率。
人类学习时刷的题远远没有模型那么多,我们只需要高质量的教材,适当的习题和教师反馈,就能做到还不错的水平。但模型的迭代,似乎强依赖于构造的“习题”。借用九年义务教育阶段常引用的一个名言,高尔基说过,书籍是人类进步的阶梯。那什么是模型进步的阶梯呢?目前来看似乎是习题。
那有没有一种可能,我们把全世界的图书馆里,蕴含了丰富知识的书籍,都丢给模型,看模型究竟能从其中榨干多少知识出来?这个其实已经有不少“自进化”、“无监督”的方法,在尝试做这样的事情。我们在 StudyBench 里面所做的,就是看这些自进化方法,能多大程度地让模型榨干书籍的知识,用迭代前后模型的 delta performance,来 benchmark 自进化方法本身。
其次,是 PACE-Bench 这个工作。随着 Claude plays robotics、Waddle 等工作将通用 Agent 带入机器人与物理世界,Agent 已经开始通过执行、反馈和代码修改完成真实任务。但真实世界不会始终固定:**如果环境本身发生变化,过去成功的方案已经失效,Agent 还能不能靠新的交互自主恢复?**这正是 Self-Evolving Agent 走向真实物理世界必须面对的问题。
为此,我们提出 PACE-Bench(Physics Adaptation via Code Evolution),用代码驱动的物理设计作为 Self-Evolution 的可控测试场景。比如,一辆车原本能在公路上行驶,路面变成冰面后却开始打滑。目标和接口没有改变,但旧设计赖以成立的条件已经过时。Agent 必须从新反馈中识别失效假设,并修订定义机械结构与控制逻辑的设计代码,直到方案重新工作。
我们在完整 Benchmark 上比较了四类范式下的 10 种 Self-Evolving 方法,并在选定子集上进一步评测更大的开源与前沿模型。结果并不乐观:在完整 Benchmark 上,表现最好的 Reflexion + Qwen3-14B 的 Pass@2 只有 35.9%。GPT-5.5 在静力学任务中达到 66.7%,却仍有三分之一的任务未能通过。不同方法还会引入额外的模型调用、搜索或参数更新,但计算时间更长并不代表在同样时间内能取得更高得分。
进一步分析显示,瓶颈并不只在于模型是否足够强。Reflexion 根据上一次 Box2D 执行返回的反馈分析失败,修改一次后便重新进入环境验证。Self-Refine 虽然在外层也能收到环境反馈,却会在下一次验证前仅靠模型自评连续修改最多五轮,结果反而显著退化。
当方法加入记忆或搜索后,Agent 又容易在固守旧设计与无方向探索之间摇摆。即使直接公开环境变化的精确参数,最佳结果也没有提高。但能真正 self-evolve 的 agent,其不仅要知道世界发生了什么(Know What),还要据此决定该改参数、结构还是控制方式,并写出能在新环境中运行的代码(Know How)。
当时更多的用词还是在 self-evolving 上,转眼间大家开始用起来另一个词了。
最近一段时间,AI for AI 和 Recursive Self-Improvement(递归自我改进,RSI)逐渐成为人工智能领域的热门话题。相应地,各种和 RSI 相关的 Benchmark 也开始涌现:PostTrainBench、RSIBench-Data、RSI Arena,大家也都在践行 The Second Half 的 "大 Bench 理论"。
一个很自然的问题是:这些 Benchmark 测的是同一件事吗?如果一个 Agent 已经能够独立完成大模型后训练,是不是就意味着它已经实现了 RSI?
我觉得,这里有一个很重要的区别需要先厘清:
AI 能够参与 AI 的研发,不等于 AI 已经能够递归地改进自身。
这两者之间,还有相当长的一段距离。
一、首先要区分:AI for AI 不等于 RSI
AI for AI 是一个相对宽泛的概念,指 AI 系统参与人工智能研发的过程。比如,Agent 可以帮助研究者阅读论文、编写训练代码、清洗数据、调节超参数、运行实验,甚至独立完成一次模型后训练。
这些能力都很重要,但它们本身并不意味着 RSI 已经发生。我更倾向于把这里面的能力分成三个层次:
- 任务自动化: Agent 能够独立完成某个 AI 研发任务,例如训练一个模型、优化一个数据集或者改进一段训练代码。
- 迭代式改进: Agent 能够根据上一轮实验结果调整方案,不断改进模型,并把改进结果用于下一轮实验。
- 递归自我改进: 不仅被改进的模型在变得更好,产生这些改进的系统、方法或 Agent 本身,也能够通过反馈不断提升其产生后续改进的能力。
第三层才是 RSI 真正值得关注的地方。
这里的关键在于「递归」二字:第一轮改进的结果,必须能够进入下一轮,成为进一步改进的起点。否则,即使一个 Agent 能够独立训练出一个比原模型更好的模型,也只能说明它具备了一定的 AI 研发自动化能力。
二、当前的 RSI 相关的 Benchmark,实际上测量的是不同层次的能力
如果从这个角度看,当前出现的几类 Benchmark 就比较容易理解了。它们并不是在测量完全相同的东西,而是在 AI 研发和自我改进链条中选择了不同的切入点。
1. Agent 能否独立完成一次模型后训练?
PostTrainBench 关注的是一个非常具体的问题:给 Agent 一个基础模型、一张 H100 GPU 和十个小时,它能不能通过自主寻找数据、编写训练代码、选择训练策略和运行实验,提升模型在指定任务上的表现?
它实际上把一次完整的后训练过程交给 Agent,让它自己决定怎么做,最后通过独立的测试集评估训练结果。
这是一种很有价值的端到端评测。但它测量的主要还是 Agent 在给定预算下完成一次后训练任务的能力,而不是它能否持续改进自己的研究策略。
从结果来看,Agent 已经能够完成相当复杂的训练工作,但距离专业团队进行的通用后训练仍有差距。比如,PostTrainBench 中表现最好的 Agent 的加权平均成绩为 23.2%,而官方 Instruct 模型基线为 51.1%。不过,在一些目标明确的任务上,Agent 也能取得超过官方模型的成绩。
这说明 Agent 已经具备了一定的模型训练能力,但这种能力仍然受到任务范围和训练策略的限制。比如说大部分 Agent 都收敛到 SFT,不是说明 SFT 在后训练最好,而是说明,在这个 benchmark 的设定上,10h 从一个弱 base 模型开始迭代,最快的方式最 ground truth 的方式其实可能就是 SFT。可能换一个别的 setting,最优解就不是 SFT 了,这样才能更好地评测出 agent 能否自主后训练的能力。当然限于评测成本,很难再包括太多 diverse 的 setting。
2. Agent 能否自主开展数据研究?
与端到端的后训练不同,RSIBench-Data 选择了一个更细粒度的切口:数据研究。
它将训练、服务和评估等基础设施固定下来,让 Agent 集中解决数据相关的问题,包括分析模型能力缺口、设计训练数据策略、根据实验结果调整数据,并从不同 checkpoint 的反馈中寻找更好的方案。
这样做的好处是,可以把数据研究能力从整个训练系统中相对独立地提取出来,避免其他环节的表现干扰判断。
研究结果显示,在 58.33% 的实验设置中,Agent 能够通过反馈改进第一次有效尝试的结果。但与此同时,如果 Agent 在已经取得最好成绩之后继续搜索,78.26% 的情况下最终成绩反而会下降。
这其实揭示了一个很有意思的问题:Agent 不仅需要找到有效的训练方案,还需要判断什么时候应该继续探索、什么时候应该保留已有成果。
我们从今年五月其实也从数据的角度来看 agent 能否开展自动化研究。AutoSFT 的出发点就是在 PostTrainBench 的简单 setting 上,大部分 agent 其实都收敛到 SFT,而我们又知道,SFT 算法本身其实并没有太多可以调优的部分,最大的杠杆在数据上,因此我们只允许 agent 来迭代数据,给定一个固定的数据 budget,然后每一轮都只能从 backbone 上重新训而不是续训,以此来判断新迭代出的 data 是否有效。
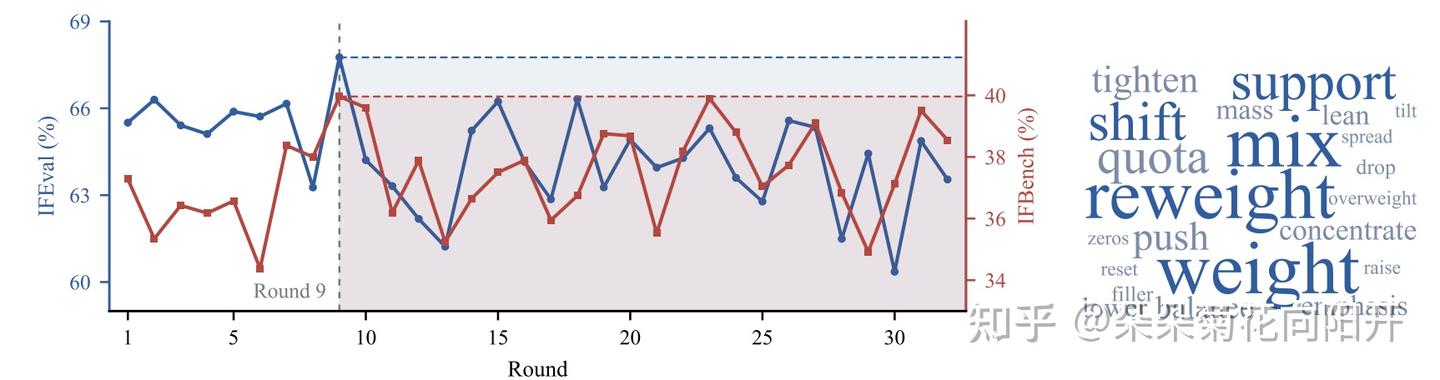
Agent 在几十轮基本在调优一个 data action,也就是重新配比,但是收敛不提升。
主要的结论有三:
- 如果不加结构,直接一个 codex /goal,大部分 agent 只会做一种很浅显的数据 action,探索能力很差。并且如果给一个不合适的 goal,比如 10h budget,agent 在最后几个小时会过度焦虑,以至于用不满每轮的数据 budget,只是为了多跑几轮本身无意义的实验。
- 归因能力很差。比如新的一轮,最后掉了两个点,agent 会错误地归因为是这个 action 本身就不行,它不会思考会不会是评测的噪声,又或是 action 本意是对的但自己没执行好,然后 agent 甚至把这个错误的归因记录成为经验,以至于后面再也不探索这个 action 了。就好比老虎机多个 arm,我拉一个得到负 reward 之后就再也不拉了。
- 在集群场景下,我们需要不断向集群提交 job 查询状态,有非常多与这个实验目标本身不太相关的东西进入了上下文,并且非常容易撑爆它,产生数十次压缩。
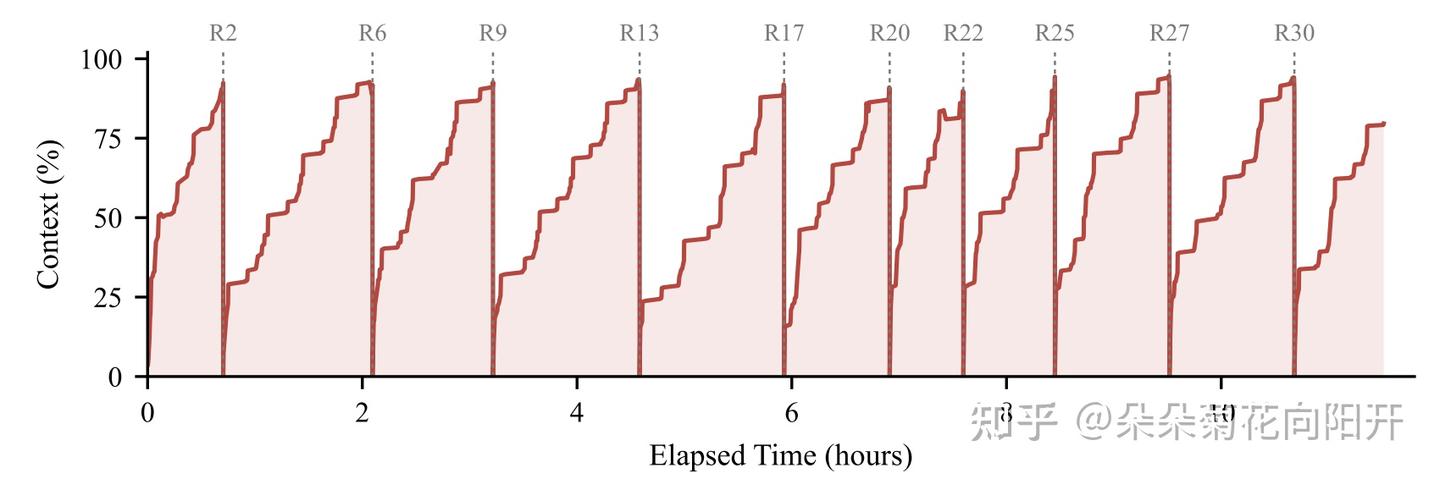
在 10h+ 的时间中,产生了 10+ 次上下文压缩,虚线所示代表被压缩时所处的轮次
3. Agent 能否理解训练失败,并真正修复问题?
除了上述几种评测,我认为还有一个经常被忽略、但对 AI for AI 至关重要的能力:Agent 能不能发现自己正在做的实验出了问题?
在大模型后训练中,训练过程可能没有任何报错,训练奖励甚至还在不断上涨,但模型实际上可能已经学到了错误的东西。
例如,数据分布不匹配、奖励函数实现错误、训练与推理过程不一致,都可能导致模型在看似正常的训练过程中逐渐偏离目标。
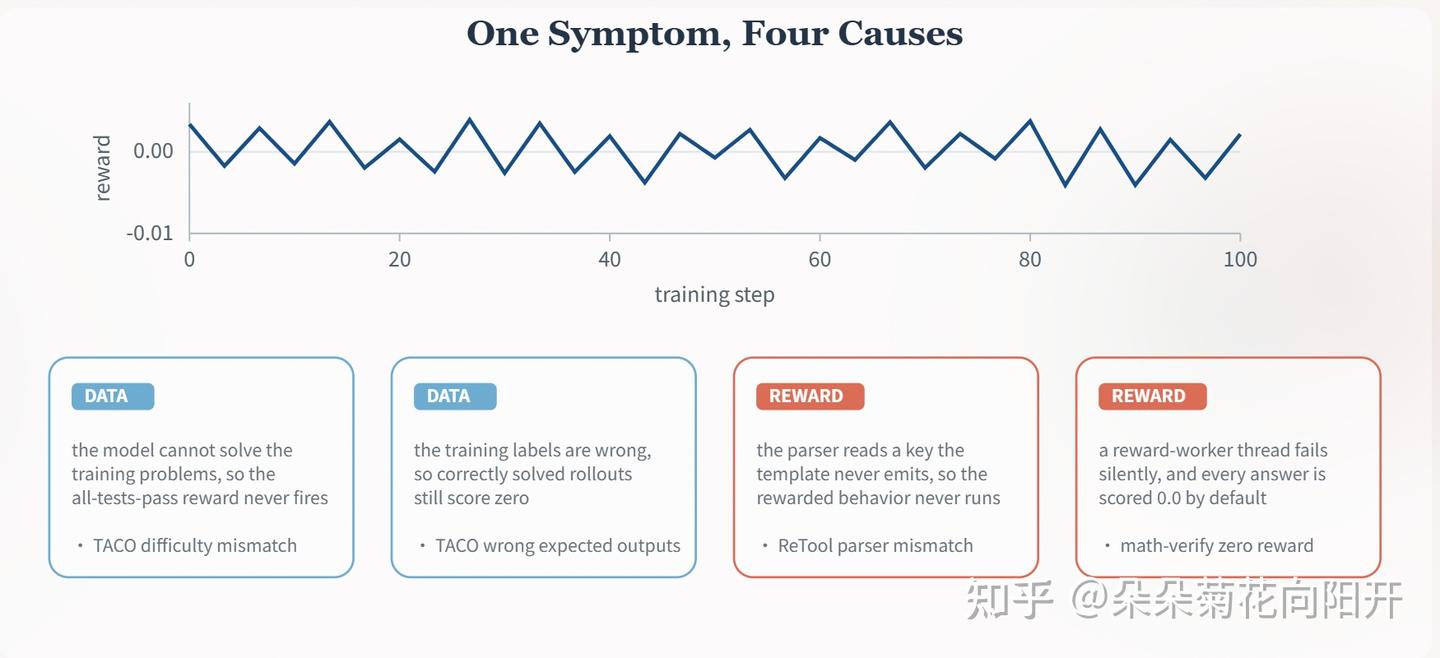
即使是同一个 failure 表现,可能的根源也有很多种
我们做 AutoRLBench,正是从这个问题切入的。
AutoRLBench 收集真实发生过的 RL 训练失败,保留原始代码、配置、日志、指标和运行环境,要求 Agent 完成两个层次的任务:
- Diagnosis: 判断训练是否健康,找到具体的故障根因,并提供证据。
- Repair: 修改训练环境和代码,随后由独立评测系统在干净环境中重新运行训练,检验修复是否真正有效。
目前的版本包含 38 个诊断任务和 19 个修复任务,覆盖 Configuration、Reward、Data、Environment、Algorithm 和 Infrastructure 六大类别。
在首轮评测中,我们发现,Agent 正确识别训练状态不健康的比例为 82.6%,但真正找到正确根因的比例只有 28.2%。
这意味着,Agent 已经能够在相当程度上察觉训练异常,却仍然难以解释异常究竟是如何产生的。这个问题不能被简单地看作一个工程调试问题,因为如果 Agent 无法判断训练信号是否可靠,那么它就很难根据实验结果作出正确的下一步研究决策,迭代下一轮可能就无从谈起。
一个无法识别错误反馈的自我改进系统,很可能只是在不断放大自己的错误。
三、比执行实验更难的,是主动改变研究策略
这里还想补充一项值得关注的工作,研究者们分析了 1338 条 PostTrainBench 训练轨迹,发现当前 Agent 有一个非常突出的特点:
它们往往是优秀的执行者,却不是优秀的策略制定者。
具体来说,Agent 可以不断调节学习率、修改数据格式、修复代码、优化训练配置,但它们往往会在最初就选定一个训练策略,之后很少根据实验结果主动改变这个策略。
在他们分析的 3557 组相邻训练实验中,真正发生训练策略切换的只有 74 次,比例约为 2.1%。这说明,增加实验次数、增加推理 Token,未必能够解决所有问题。
一个 Agent 可以非常熟练地在既定策略内部进行局部优化,却始终没有意识到:也许最开始选择的训练方法就是错的。
这让我想到,AI 研发实际上至少包含两个不同层次的能力:
- 执行层面的优化: 如何把当前方案做得更好,例如调节超参数、修复实现、改进数据处理。
- 策略层面的优化: 如何判断当前方案是否值得继续,以及是否应该改变训练算法、数据来源或者训练阶段。
而 RSI 真正需要的,恰恰不仅是第一种能力,还包括第二种能力。
如果一个 Agent 只能不断优化自己已经选定的策略,却无法根据证据主动推翻它,那么它实际上仍然没有真正闭合研究决策的循环。这也和我们在 AutoSFT 中所发现的,agent 会一根筋地执行 "reweight" 操作到底这一现象,非常 align。
四、我们需要的也许不是一个 RSI 总分,而是一套能力地图
当前各种 RSI Benchmark 的出现是非常有价值的。它们让我们逐渐认识到,AI 参与 AI 研发并不是一个单一能力,而是涉及数据研究、训练算法、实验设计、工程执行、故障诊断、结果验证和策略调整等多个环节。
端到端 Benchmark 可以告诉我们 Agent 最终能做到什么,细粒度 Benchmark 则能够告诉我们它为什么能做到、又为什么做不到。
两者不是相互替代的关系,而是需要相互补充。但与此同时,我们也应该警惕:Benchmark 本身会影响被测量的系统。
当某一个指标成为优化目标时,Agent 可能逐渐学会迎合这个指标,而不是真正解决研究问题。正如我们在 AutoRLBench 里面所发现的,Agent 已经学会去 hack 这个评测,比如拉取上游代码去查看别人是怎么改的(虽然还没太想好这个到底算不算 hack,还是说也算是解决问题的一种方法)、再比如自己把评测标准改宽松以取得高分(板上钉钉的 hack)。
所以,可能未来的 RSI 评测能够从单纯的最终结果,进一步转向对整个改进过程的评价。不仅要问模型最后提高了多少,还要问它为什么选择这个研究策略?它有没有根据实验结果调整自己的判断?它能不能发现并修复隐藏的错误?它的改进能不能迁移到新的任务?它是否真的让下一轮研究变得更有效?
RSI 的关键,也许不是 AI 能不能替人完成一次模型训练,而是 AI 能不能逐渐掌握产生下一次有效改进的能力。
从这个意义上说,当前的 RSI 相关 Benchmark 不是在争夺谁最先证明了 RSI,而是在共同探索:究竟需要具备哪些能力,才能真正走向 RSI。
在这个大 bench 时代,借此机会分享一些自己的想法,不足之处还请大家批评指正,多多讨论交流~
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册