
🧪 Title: GFT: From Imitation to Reward Fine-Tuning with Unbiased Group Advantages and Dynamic Coefficient Rectification
🎉 Venue: ACL 2026 Findings
📝 Paper: https://arxiv.org/abs/2604.14258
💻 Code: https://github.com/ZJU-OmniAI/GFT
这两年大家谈 LLM post-training,最常见的叙事大概是两条线:
- 一条是 Supervised Fine-Tuning(SFT):用高质量专家数据快速把知识和格式注入模型;
- 另一条是 Reinforcement Learning(RL):让模型在奖励信号下探索、比较、优化,学到更强的泛化策略。
直觉上,这两条线应该是互补的:先 SFT 冷启动,再接 RL 提升上限。但在很多 reasoning 场景里,一个很尴尬的现象反复出现:
SFT 很会“教格式”,但也很容易把模型教“死”;RL 很会“探索”,但接在 SFT 后面时,收益却常常被削弱。
换句话说,问题不只是“要不要 SFT”,而是:
SFT 到底在优化什么?它为什么会削弱后续 RL 的探索空间?有没有一种后训练方式,既保留 SFT 的知识注入效率,又能像 RL 一样利用奖励和比较信号?
我们的 ACL 2026 Findings 中稿论文 GFT: From Imitation to Reward Fine-Tuning with Unbiased Group Advantages and Dynamic Coefficient Rectification 尝试从训练动力学的角度回答这个问题。
前言:SFT 为什么会“学死”?
SFT的优势非常明确:它简单、稳定、效率高。只要有一批高质量专家示范,模型就可以快速学会回答格式、领域知识和推理风格。
但SFT的问题也同样明显。
在reasoning后训练中,我们经常看到一种现象:模型经过SFT后,训练集相关任务涨分了,但一些out-of-distribution 或通用能力反而下降;接着再做 RL,效果也不一定比直接从 base model 做 RL 更好。
图 1展示了这个问题。以 Qwen2.5-Math-1.5B 为例,SFT 后模型在多个评测上的表现相对 base model 出现退化;而在常见的 SFT + GRPO 流程中,RL 的收益也明显弱于直接做 GRPO。
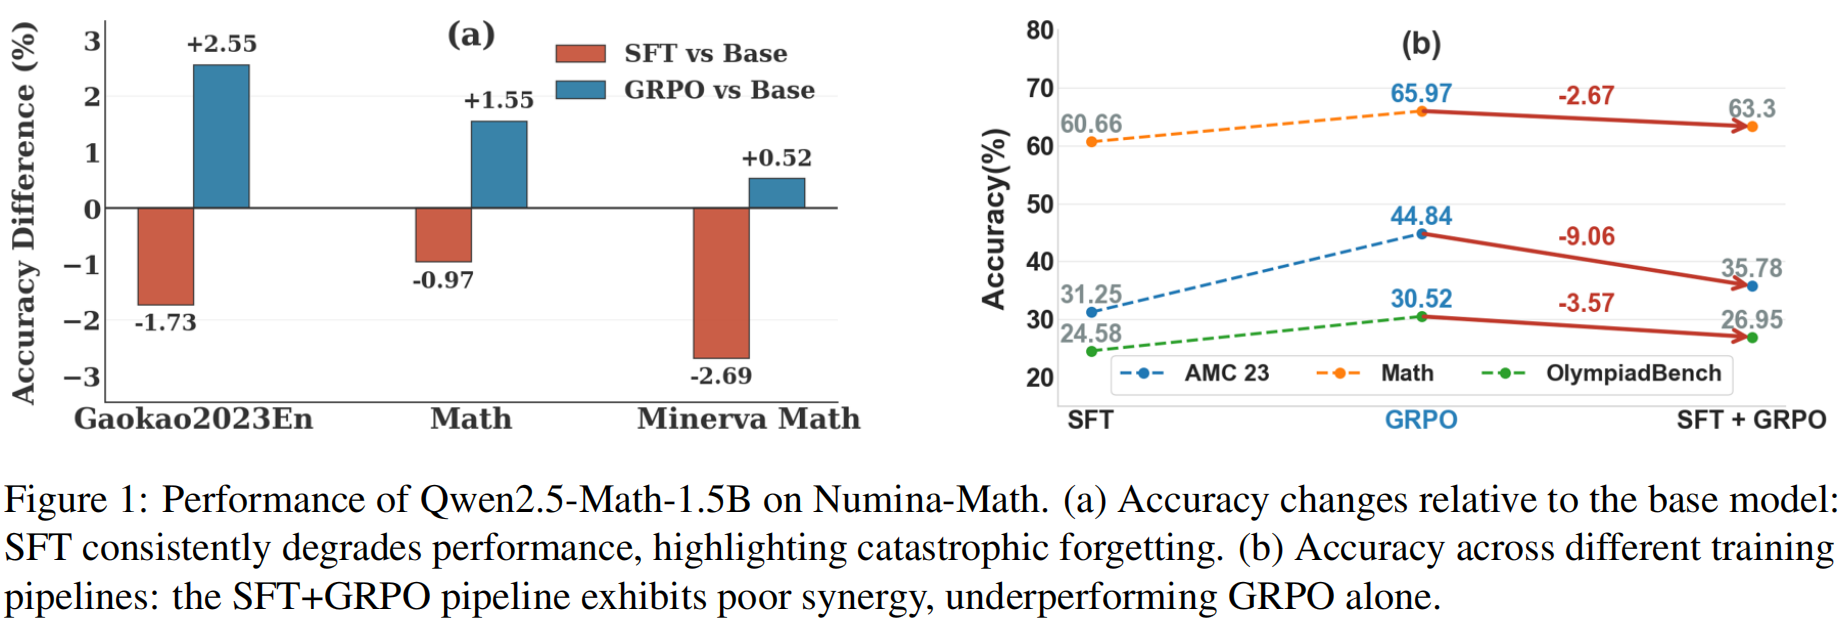
这说明 SFT 带来的不只是“知识注入”。在某些 reasoning 场景中,交叉熵式的单轨迹拟合可能会让策略分布过度集中在有限的示范轨迹附近,降低输出熵和候选解的覆盖范围。这样一来,后续 RL 所依赖的 rollout 多样性和探索空间就可能被压缩。
如果问题只发生在 SFT 内部,我们或许只需要讨论数据质量和监督目标;但现在更麻烦的是,它还会影响后续 RL 的收益。这意味着我们不能只把 SFT 当成一个普通的 supervised learning loss 来看,而需要把它和 RL 放到同一个训练动力学框架里比较。
所以,一个更基础的问题是:
从 policy gradient 的角度看,SFT 到底在做什么?它为什么会在提供冷启动能力的同时,又可能削弱后续 RL 所需要的探索空间?
从这个角度看,GFT 可以被理解为一种更 on-policy 的 SFT:它不是只在固定专家答案上做 imitation,而是让当前模型先生成一部分候选回答,再把这些 self-generated samples 与专家示范、教师输出放到同一个 response group 中进行比较。也就是说,GFT 仍然保留了 SFT 的训练效率,但训练信号已经不再完全来自离线示范,而是部分来自当前 policy 自己访问到的输出空间。
1. 从 RL 视角重新理解 SFT
标准SFT的目标很简单:最大化专家答案在当前模型下的似然。
给定专家数据集 (D={(x,y^*)}),其中(x)是输入,(y^*)是专家示范答案。SFT 的训练目标可以写成最大化专家答案的 log-likelihood。按照论文中的记号,它对应的梯度形式是:
这个公式很直观:模型只需要不断提高专家答案(y^*)在当前策略(\pi_\theta)下的概率。换句话说,SFT 的监督信号完全来自专家示范轨迹本身,它并不显式关心同一个问题下其他候选答案的质量。
而标准 RL 的 policy gradient 则是另一种形式。模型先从当前策略(\pi_\theta(\cdot|x))中采样输出(y),再根据这个模型生成的输出计算奖励(r(x,y))。其梯度可以写成:
表面上看,SFT 和 RL 很不一样:SFT 学的是固定专家答案,RL 学的是模型自己生成的答案及其奖励。
事实上,把SFT 改写成 RL 形式这一视角,在 DFT 论文On the Generalization of SFT: A Reinforcement Learning Perspective with Reward Rectification中已经有过系统推导。GFT 沿用这一训练动力学视角,先把 SFT 写成一个从当前策略(\pi_\theta)采样的policy-gradient形式:
这个式子就是理解SFT的关键。它把原本看起来像supervised learning的SFT,改写成了一个特殊的 RL 梯度形式。具体来说,式子里有两个关键项:
- 奖励项(r(x,y)=\mathbb{I}[y=y^*]):只有当模型采样出的 (y) 恰好等于专家答案 (y^*) 时,奖励才是 1;其他所有输出的奖励都是 0;
- 权重项(w(y|x)=\frac{1}{\pi_\theta(y|x)}):反概率 importance weight,用来修正“从当前策略采样”与“专家示范分布”之间的差异。
因此,SFT 可以被解释成一种非常特殊的 RL。这个视角揭示了SFT 泛化性弱的两个来源。
第一,奖励项过于稀疏,导致学习信号只存在于一条专家轨迹上。
对数学题来说,同一个问题可能有很多条正确推理路径;对开放生成任务来说,同一个 instruction 也可能有很多种合理回答。但 SFT 不关心这些候选答案之间谁更好、谁更差,它只告诉模型:请模仿这一条。
这就是single-path dependency。
第二,反概率权重可能导致训练不稳定。当模型一开始对某些专家 token 并不熟悉、给出的概率很低时,(w(y|x)=1/\pi_\theta(y|x)) 会变得非常大。
这就带来第二个问题:梯度爆炸。
所以,SFT 的问题并不只是“太监督”或者“太死板”。从训练动力学上看,它同时存在两个结构性缺陷:
- 奖励太稀疏,只监督单一路径;
- 更新太激进,低概率 token 会触发过大的梯度。
这也解释了为什么 SFT 容易造成机械记忆、熵塌缩和灾难性遗忘。
这个推导也提示了一个自然的改造方向:如果 SFT 的问题来自“只在固定专家轨迹上学习”,那么我们能不能仍然保留 SFT 的高效监督形式,但把当前 policy 自己生成的轨迹也纳入训练?这正是 GFT 和 on-policy 产生联系的地方。
2. GFT:从 Imitation 走向 Reward Fine-Tuning
为了解决上面两个问题,我们提出了 Group Fine-Tuning(GFT)。
它的核心想法并不是简单地把SFT和RL拼起来,而是把“模仿专家答案”改造成“在一组候选轨迹里做奖励驱动的相对比较”。
如果从 on-policy 的角度看,GFT 最关键的变化是:训练不再只围绕离线给定的 expert demonstration 展开,而是显式引入当前模型的 rollout samples。
也就是说,模型不只是学习“专家会怎么答”,还会看到“自己现在会怎么答”,再通过组内 reward advantage 判断哪些回答应该被强化、哪些回答应该被压低。
从 response group 的角度看,GFT 关心的是一个更一般的问题:当我们手里同时有 expert demonstration、teacher output 和 model-generated sample 时,应该如何组织这些轨迹?
传统 SFT 只会模仿单条专家答案;普通蒸馏容易把重点放在复刻教师轨迹;GFT则把多种来源的回答放在同一个 group 里,用 reward-normalized advantage 来做相对选择。
因此,它不是纯粹的离线 SFT,也不是完全在线的 RL,而是介于二者之间的一种 policy-aware / on-policy-augmented fine-tuning。
GFT 包含两个组件。
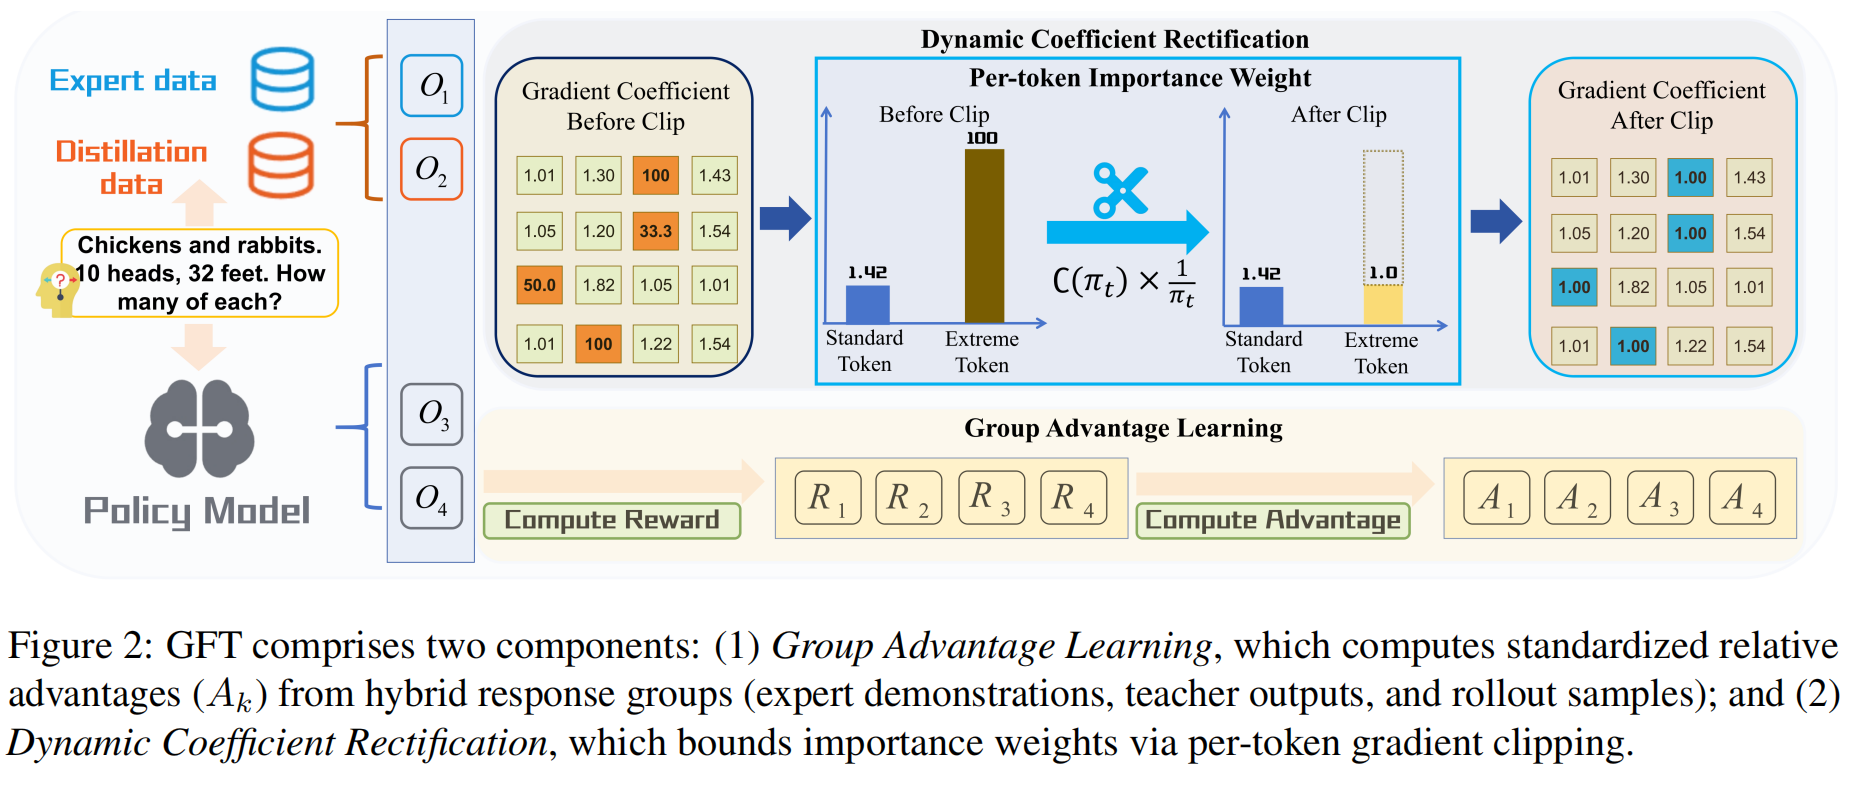
2.1 Group Advantage Learning:从单条专家答案到 on-policy response group
SFT的基本单位是一个query对应一条专家答案。
GFT 则把这个基本单位扩展成一个response group。对于每个输入x,我们构造一个候选回答组 Gx,其中可以包含三类数据:
- Expert Demonstrations:专家示范,保证训练方向里始终有可靠答案;
- Teacher Distillations:强教师模型生成的答案,引入更多推理模式;
- Self-Generated Samples:当前策略(\pi_\theta)自己 rollout 出来的回答,用来提供 on-policy 反馈。
这样做的好处是,模型不再只被迫模仿一条离线轨迹,而是可以在“专家轨迹、教师轨迹、当前policy轨迹”之间进行比较。
尤其是self-generated samples的加入,让训练信号能够覆盖模型当前真实访问到的状态/输出区域,这也是GFT相比普通SFT更接近 on-policy 学习的地方。
对于组内每个回答 yk,我们计算它的 reward R(yk),再做组内标准化,得到 advantage A(yk)。
直观上,这相当于告诉模型:
不是所有非专家答案都一文不值,也不是所有专家/教师答案都应该被无条件模仿。真正重要的是,在同一组候选答案里,哪些回答相对更好。
这一步把 SFT 的单点监督,变成了更接近 RL 的相对优势学习。
2.2 Dynamic Coefficient Rectification:不要让低概率 token 把训练带崩
GAL 解决的是“只学一条路径”的问题。
但如果直接把这种 group advantage 放进 SFT 风格的更新里,反概率权重仍然可能导致不稳定。尤其是在训练早期,模型对专家答案、教师答案或自采样中某些 token 给出的概率可能非常低,对应的1/πθ 会非常大。
为此,我们提出 Dynamic Coefficient Rectification(DCR)。
DCR 的做法很直接:引入一个概率阈值(\tau),只对低于阈值的极端低概率token 做系数修正。论文中使用的rectification function可以写成:
其中(\pi_t)表示当前token的预测概率,(\operatorname{sg}(\cdot)) 是 stop-gradient 操作。
这个阈值设计非常关键:DCR 并不是把所有 token 的更新都统一压小,而是只处理(\pi_t < \tau)的extreme tokens。对于这些token,反概率项 (1/\pi_t) 可能异常大,容易主导整个 batch 的更新,因此需要用 stop-gradient 形式把系数“消掉”或至少限制住。
但对于(\pi_t \ge \tau)的正常 token,DCR不做额外修正,仍然保留原始梯度。这样模型在学习专家答案、教师答案和自生成高质量轨迹时,不会因为过度 clipping而损失知识注入效率。
因此,DCR试图在两件事之间取得平衡:
- 对不熟悉但有价值的知识,仍然要有效注入;
- 对极端低概率token,不能让它们主导整个优化过程。
2.3 最终 GFT 目标
把GAL 和 DCR组合起来,就得到GFT的最终目标。对于每个输入(x),GFT先构造一个response group:
组内每条回答(y_k)都会得到reward (R(y_k)),再通过组内标准化得到 advantage:
这里的(\bar{R}(G_x))和(\sigma_R(G_x))分别表示组内 reward 的均值和标准差,(\epsilon) 是为了数值稳定加入的小常数。
根据原论文附录B,GFT的token-level loss 写作:
其中,(\pi_{k,t}\triangleq\pi_\theta(y_{k,t}\mid y_{k,<t},x)) 表示 token-level prediction probability。(A(y_k)) 决定组内哪条轨迹更值得学习,(C(\pi_{k,t})) 则对每个 token 的学习系数进行动态修正。
简单来说,GFT用group advantage 确定学习的方向,用 coefficient rectification 确定学习的幅度。
3. 实验:GFT 是否真的有效?
我们主要在数学推理场景中验证GFT。训练数据使用NuminaMath CoT,评测覆盖 AMC23,College Math,Gaokao,MATH,Minerva Math,TabMWP,OlympiadBench,MMLU-STEM,SAT Math,MAWPS,SVAMP等11个 benchmark。
模型方面,我们测试了不同大小和架构的模型,包括Qwen2.5-Math-1.5B/7B,LLaMA-3.2-3B,LLaMA-3.1-8B和DeepSeekMath-7B。
一个重要设置是:
GFT和GRPO使用10k query,每个 query构造8条trajectory;而SFT等单轨迹基线使用100k samples。
也就是说,GFT在更小query预算下进行训练。
这个设置也说明,GFT的收益不能简单归因于“多混了一些teacher distillation 数据”。它的每个group里不仅有expert demonstration和 teacher distillation,也有model self-generated samples。
也就是说,它不是单纯地复刻 teacher/off-policy 数据,而是显式引入当前 policy 自己生成的候选轨迹,再用 reward advantage 来判断哪些轨迹应该被强化。正是这部分self-generated rollouts,让GFT 相比标准 SFT 具有更明显的on-policy 属性。
3.1 主结果:更少数据,更稳定提升
主实验中,GFT在多个模型和多个 benchmark 上都取得了很强的数据效率。
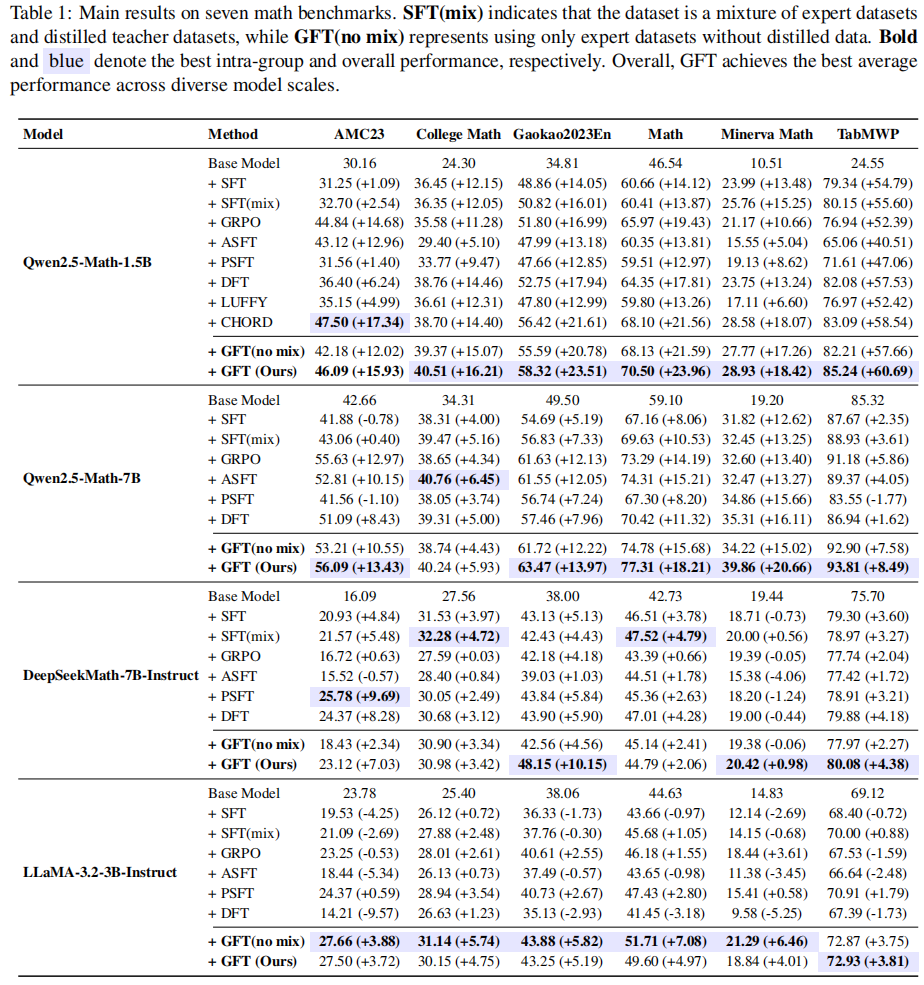
以 Qwen2.5-Math-1.5B 为例,GFT 在多个指标上相比 base model 有显著提升:
- AMC23:30.16 → 46.09
- MATH:46.54 → 70.50
- Minerva Math:10.51 → 28.93
- TabMWP:24.55 → 85.24
更关键的是,GFT 不只是比标准 SFT 更好,也能超过 DFT、ASFT、PSFT 等 SFT 稳定化变体,并且在不同模型族上表现比较一致。
这说明 GFT 的提升并不只是来自“混入了 teacher 数据”。事实上,论文里也比较了 GFT(no mix):只使用专家数据、不加入 teacher distillation 时,GFT 仍然保持很强表现。
换句话说,真正起作用的是训练机制本身,而不是简单的数据混合。
3.2 消融:GAL 和 DCR 各自解决什么问题?
为了验证两个组件的作用,我们在 Qwen2.5-Math-1.5B 上做了消融。
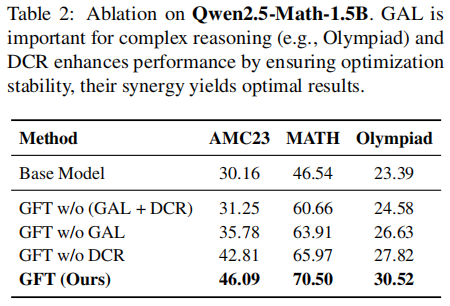
可以看到,去掉 GAL 后,复杂推理任务尤其是 OlympiadBench 上下降明显。这说明组内对比信号对于高难 reasoning 很重要。
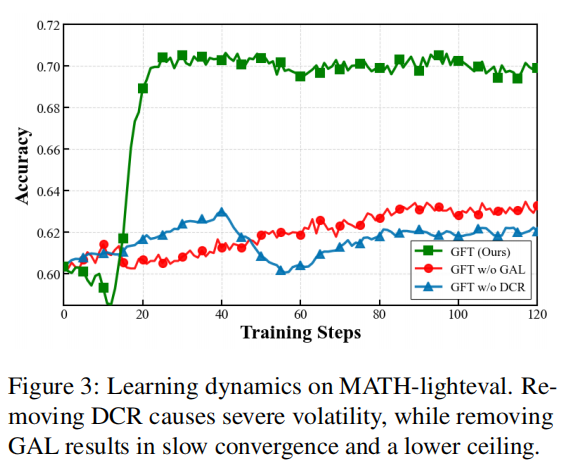
去掉 DCR 后,性能也会下降,并且训练曲线会出现明显波动。这符合我们的预期:DCR 主要负责抑制低概率 token 带来的梯度爆炸,提升优化稳定性。
所以,GAL 和 DCR 解决的是两个互补问题:
- GAL 让模型“看见多条路”;
- DCR 让模型“稳稳地学”。
3.3 与 RL 的兼容性:GFT 不是替代 SFT,而是改善 SFT 到 RL 的交接
一个很有意思的问题是:如果后面还要接 GRPO,GFT 有什么价值?
实验表明,GFT 可以作为更好的 RL 初始化阶段。
相比传统的 SFT + GRPO,GFT + GRPO 能让模型保留更多探索空间,给 GRPO 提供更高质量、更多样的 rollout。进一步地,SFT + GFT + GRPO 作为一个 staged pipeline,可以达到最高性能。
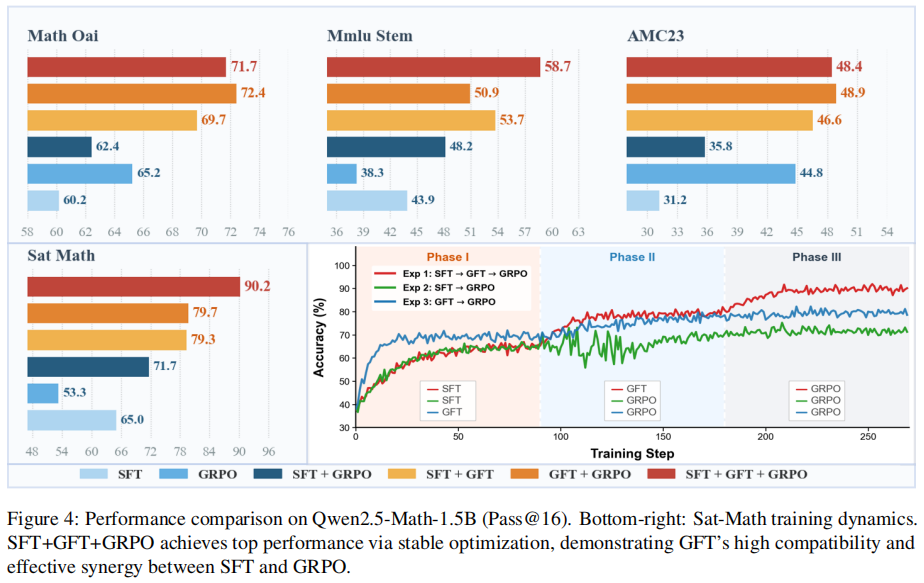
这个结果说明,GFT 并不是简单取代 SFT。
更合理的理解是:
- SFT 提供格式对齐和基本冷启动;
- GFT 在不剧烈漂移的情况下恢复探索能力,并稳定注入 reward 信号;
- GRPO 利用更好的初始化和更丰富的轨迹继续提升上限。
这也回应了开头提到的 synergy dilemma:问题不在于 SFT 和 RL 不能结合,而在于二者之间缺少一个能缓冲“模仿”与“探索”的中间阶段。
3.4 灾难性遗忘:GFT 更接近 base policy
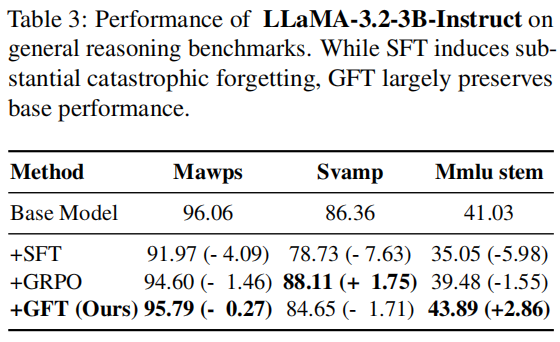
我们还分析了 domain training 后模型在通用 reasoning benchmark 上的遗忘问题。
在 LLaMA-3.2-3B-Instruct 上,SFT 会让 MAWPS、SVAMP、MMLU-STEM 出现明显下降;而 GFT 基本保留了 base model 的能力,并且在 MMLU-STEM 上还从 41.03 提升到了 43.89。
我们进一步用与 base model 的平均 KL divergence 衡量 policy drift。结果显示,SFT 的分布漂移最大,而 GFT 的 KL 水平接近 GRPO。
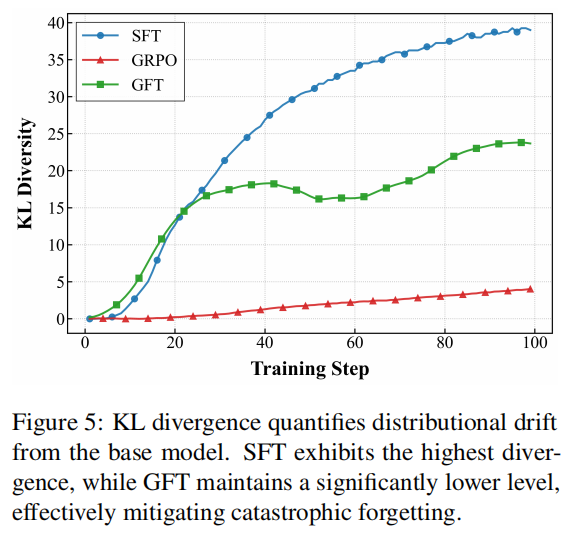
这也符合 GFT 的设计:GAL 用 reward-driven 的方式强化高质量轨迹,避免纯交叉熵式 trace fitting 带来的剧烈分布迁移;DCR 则抑制 extreme tokens 引发的大步更新。
3.5 多样性:既要正确,也要保留探索空间
后训练还有一个常见 trade-off:
蒸馏通常能提供更多推理轨迹,但如果监督信号设计不好,也可能只是复刻教师分布,缺少显式正确性激励;RL 能强化正确路径,但容易把策略变尖,压缩探索空间。
GFT 的目标是同时利用这几类信号:专家示范提供可靠锚点,教师输出提供多样推理模式,自生成轨迹补充模型自身分布附近的候选解,而 reward advantage 则负责告诉模型哪些路径真正值得学习。
在 Pass@k 评测中,GFT 的 Pass@128 和 Pass@256 平均分都高于 distillation 和 GRPO。
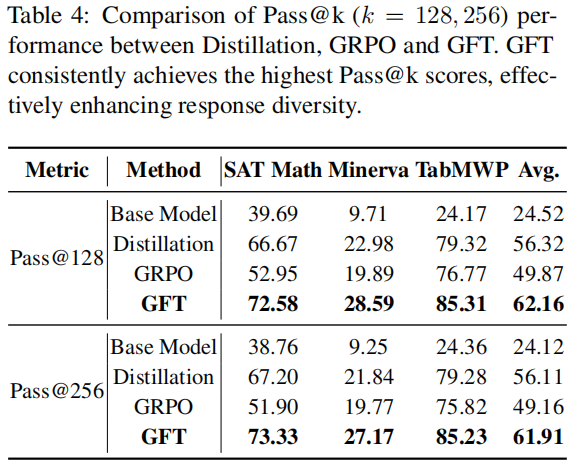
这说明 GFT 不只是让单次回答更准,也能保留更多潜在正确解法。对于数学 reasoning 来说,这一点尤其重要,因为模型的上限往往不只取决于“第一条路是否走对”,也取决于它是否还能探索到其他可行路径。
4. 怎么理解 GFT 的位置?
如果用一句话概括 GFT,我会说:
GFT 是把 SFT 从“单路径离线模仿”改造成“on-policy response group 上的奖励微调”的一种后训练范式。
它并不是简单地在 SFT loss 上加一个权重,也不是把 SFT 和 RL 机械交替。它的出发点是:既然 SFT 可以被看作一种退化的 RL,那么我们就可以沿着这个等价关系,把 SFT 中最不稳定、最稀疏的部分替换掉。进一步地,如果标准 SFT 的问题是只看离线专家轨迹,那么一个自然方向就是让模型也看见自己当前 policy 会生成什么,并在这些 on-policy samples 上获得更有区分度的反馈。
具体来说:
- 用 group advantage 替换单条专家轨迹的稀疏奖励;
- 用 dynamic coefficient rectification 替换不受控的反概率权重;
- 用 hybrid response group 同时吸收专家示范、教师推理和当前 policy 的自生成探索。
这样,GFT 保留了 SFT 的一个核心优点:高效知识注入。
同时,它也引入了 RL/on-policy 学习的一个关键优点:不只学习别人给定的答案,也利用当前模型自己生成的候选轨迹,并基于奖励和相对优势进行选择,而不是盲目模仿。
5. 讨论与局限
当然,GFT 也还有一些值得继续探索的问题。
第一,目前实验主要集中在数学推理这类具有客观正确性的任务上。对于开放式生成、长文本写作、主观偏好对齐等任务,reward 的定义会更复杂,GFT 如何扩展还需要进一步研究。
第二,GFT 需要为每个 query 构造 response group,相比标准 SFT 会带来一定的数据准备开销。不过这个成本仍然明显低于完整在线 RL,而且可以灵活利用已有专家数据、教师输出和模型自采样。
第三,受限于学术资源,论文实验主要覆盖到 8B 级别模型。GFT 在 70B+ 模型上的 scaling 行为仍然是一个重要后续方向。
结论
SFT 和 RL 的关系,可能并不是“模仿”和“探索”的二选一。从训练动力学角度看,SFT 本身就可以被解释成一种特殊的 RL,只是它的奖励太稀疏、更新太不稳定。因此,改进 SFT 的关键不只是换数据或加正则,而是重新设计它的学习信号。
GFT 做的就是这件事:它用 Group Advantage Learning 打破单路径依赖,用 Dynamic Coefficient Rectification 稳定低概率 token 的更新,在一个统一框架里兼顾知识注入、优化稳定性和探索多样性。
我们希望这篇工作能为社区重新理解 post-training 提供一个新的角度:不是在 SFT 和 RL 之间做选择,而是从更底层的训练动力学出发,重新设计模仿、蒸馏、奖励微调之间的连接方式。
如有疑问,欢迎在评论区交流;如果觉得这篇工作有帮助,也欢迎点点 star~
引用链接
[1] GFT Paper: https://arxiv.org/abs/2604.14258
[2] GFT Code: https://github.com/ZJU-OmniAI/GFT
[3] ACL 2026 Findings: GFT: From Imitation to Reward Fine-Tuning with Unbiased Group Advantages and Dynamic Coefficient Rectification
[4] On the Generalization of SFT: A Reinforcement Learning Perspective with Reward Rectification: https://arxiv.org/abs/2508.05629