作者:真中合欢
https://www.zhihu.com/question/2067555143608954948/answer/2067908579819102910
为什么OPD、RLHF在线强化学习统一使用反向KL,SFT离线蒸馏却用正向KL?仅调整顺序差异巨大?
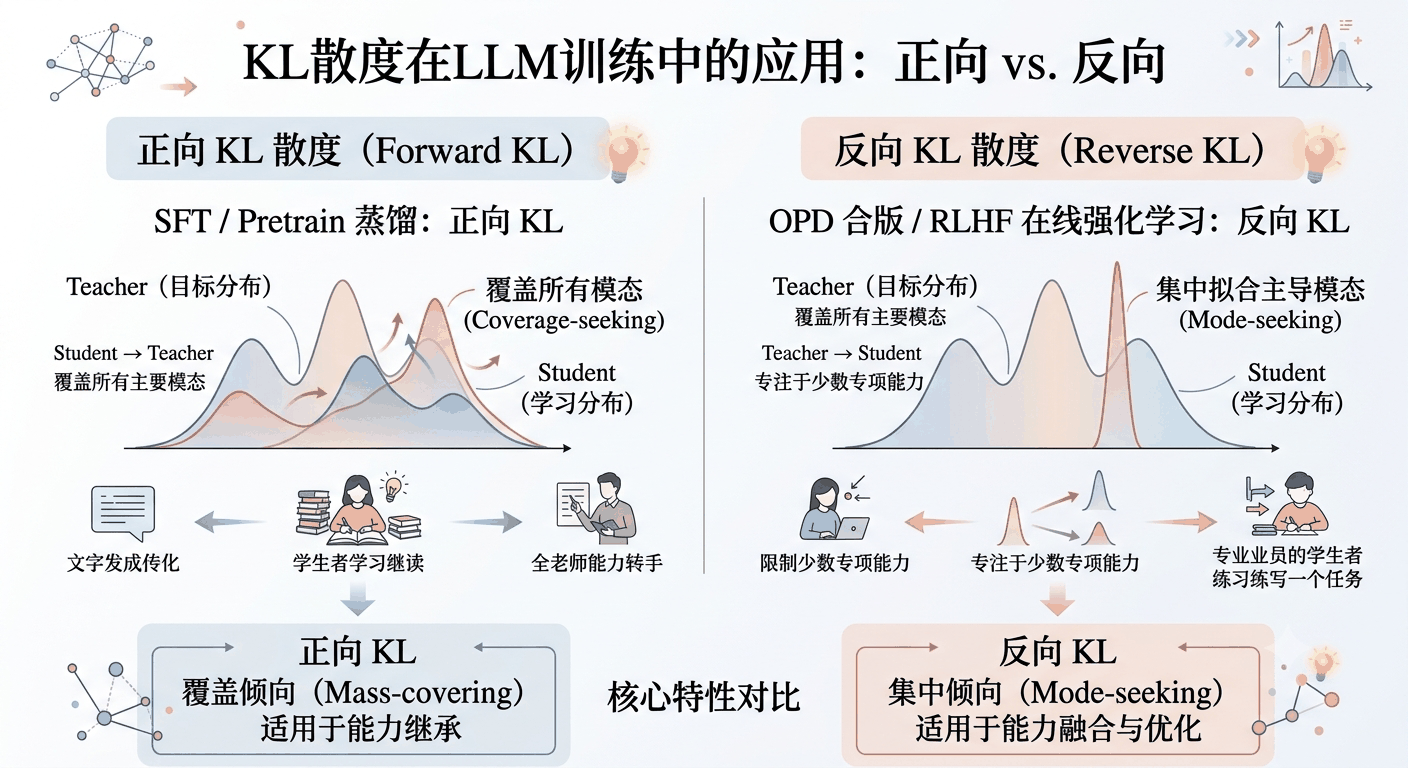
因为两个方向的 KL 具有不同的分布拟合特性。训练时需要根据具体目标,判断更需要哪种特性,再选择相应的损失函数。
注:下文提到的“多模态” 不是指图像、文本模态这个多模态,而是指概率分布上的多个峰。
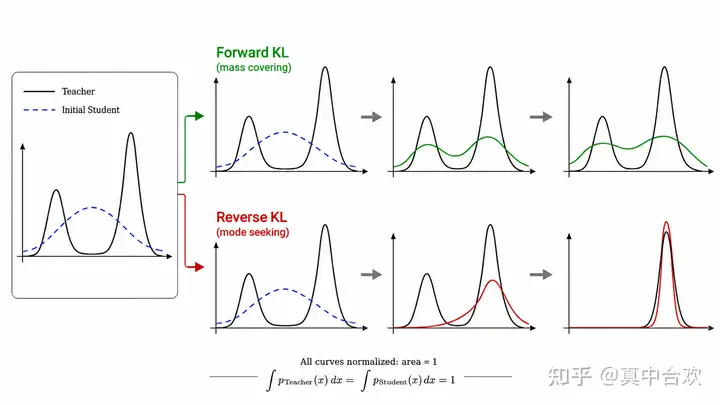
这篇文章 从统一视角分析了不同散度及其对应的消息传递算法。简单来说,在用 student 拟合 teacher 分布时,正向 KL 和反向 KL 会作出不同的取舍:
- 正向 KL 倾向于覆盖 teacher 的各个主要模态;
- 反向 KL 倾向于集中拟合其中一部分模态,甚至收缩到单个主导模态。 这个现象也叫 mode seeking;
放到LLM中可以这样理解:
正向 KL 的期望由 teacher 分布加权。因此teacher 分布中具有显著概率的不同 token都有机会进入训练数据,并为 student 提供梯度信号。
这会推动 student 覆盖 teacher 的各个主要模态,并在这些区域内向 teacher 靠近。
反向 KL 的期望则由 student 分布加权。通常先由 student 自己采样,再在这些 student 实际访问到的 token、前缀或轨迹上计算其与 teacher 的差异。
被 student 采样到的部分会受到约束,并逐渐向 teacher 靠近。但对于那些 teacher 赋予较高概率,而 student 概率极低的 token 或轨迹,student 在有限采样下可能几乎无法访问。
由于这些区域没有进入采样结果,它们也就很难参与梯度计算。即使 student 与 teacher 在这些区域存在很大差异,也缺乏足够的优化信号。
理解了 KL 的这些特性,也就不难理解不同任务为何会选择不同方向的 KL。
SFT蒸馏、或者传统的pretrain蒸馏目标通常是让student尽可能学习teacher的全部能力,用于后续下游任务训练,或者是得到一个“劣化版” teacher用于低成本推理。 所以选择正向KL,让student尽量覆盖teacher所有模态。
对于OPD,工业界和学术界的关注点不同,但是恰好都需要mode seeking。
在工业界OPD通常用于合版,也就是GLM、DS、Kimi等技术报告提到的,将十几个不同teacher的能力融合进一个模型。 teacher本身经过RL,概率已经集中到少数能力专项的区域。将多teacher合并,就相当于构造了一个由多个较尖锐的专项分布组成的多模态目标 。
此时想让 student 覆盖teacher所有模态是很困难的,因此选择主动mode seeking,牺牲一些不重要的模态。至于如何抉择哪些被放弃,则可以通过人为数据筛选、teacher权重来引导。
学术界侧重点通常是小student 在一些任务上追平甚至超越大teacher。小模型的整体能力通常弱于大模型,因此可能需要牺牲一些低优先级模态,将有限容量集中到少数核心任务上,并在这些任务上逼近 teacher。
关于OPD和反向KL有个常见的误解,就是“既然概率已经归一化,那么student采样不到的token也会因为softmax而获得梯度,也会逐渐拥有概率, 最终也会获得teacher的能力” 。
这其实是很困难的,因为student高概率模态被打压时,概率通常是流向附近的次高概率模态,而不是那些采样不到的模态。
最后更可能出现“按下葫芦浮起瓢”的情况:student 在已有的少数模态之间反复转移概率质量,却始终无法覆盖 teacher 赋予较高概率、但 student 尚未访问的模态。
最近有不少top-k、全词表OPD的工作。 这个可以缓解一部分问题,但是不能完全解决。 因为从根本上语言模型是联合概率,是整个采样序列概率的连乘积。 全词表只解决在一个token位置上token覆盖,并不解决整个序列的问题。