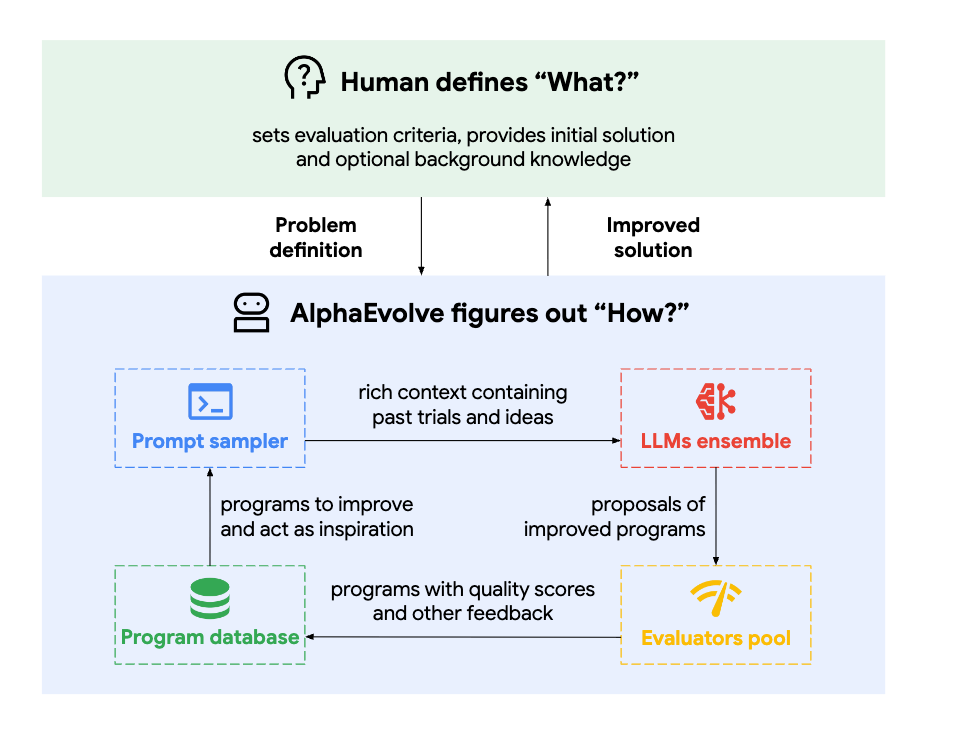
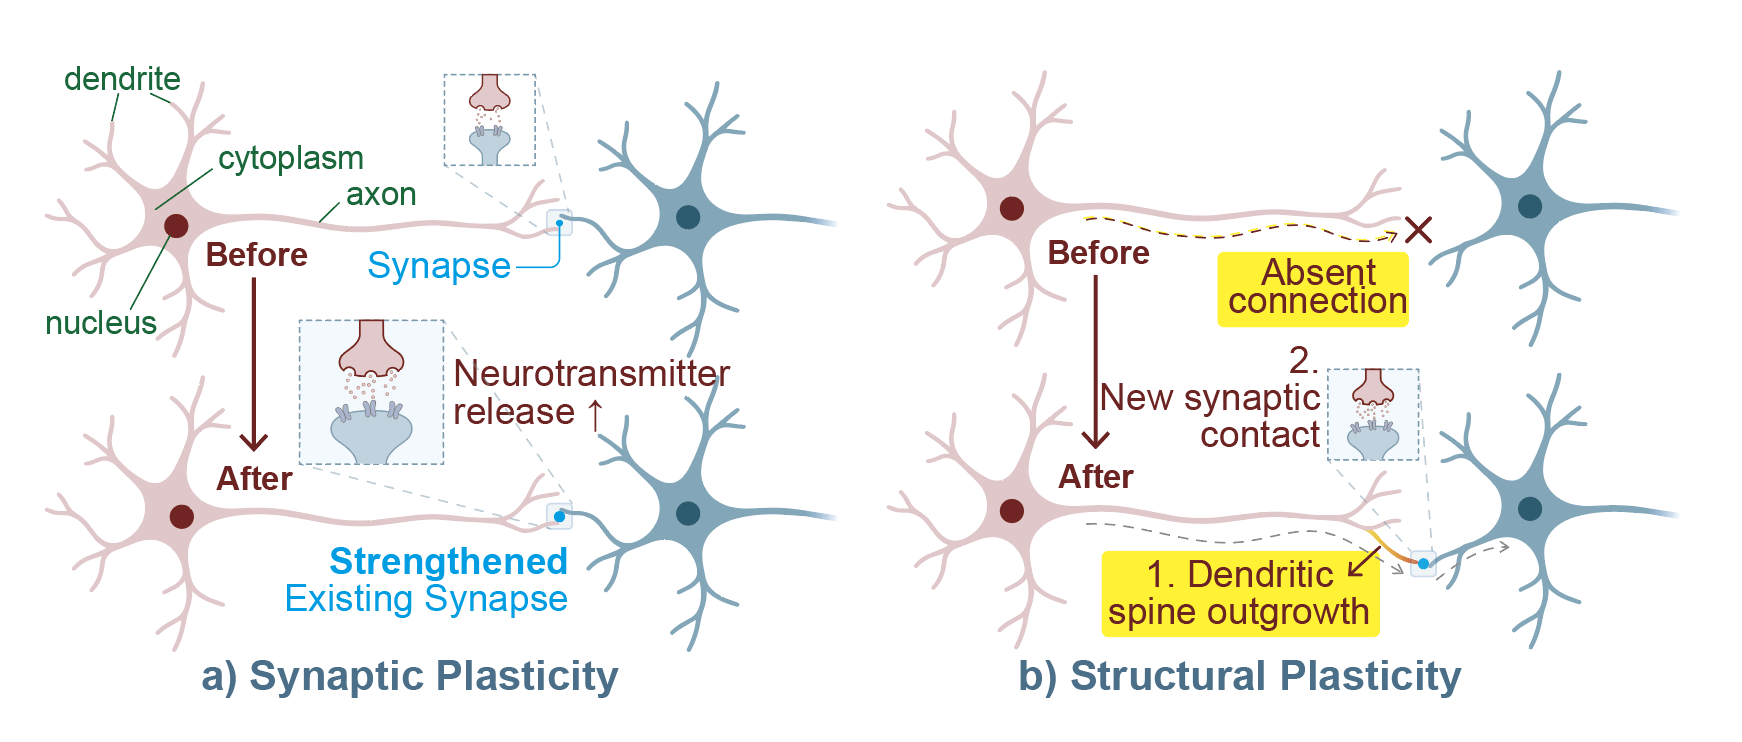
精选文章 Models、Harness 和 Artifacts,到底是什么在进化?普林斯顿博士后拆解 Agent 自进化的三层分类体系 作者:Shilong Liu,Postdoc Princeton,哥大助理教授(拟入职) https://lsl.zone/blog/2026/a-taxonomy-of-self-evolving-agents/ 自进化 Agent(Self-evolving agents)正变得越来越流行。 H
精选文章 2026,进入 Agent RL 时代! 序章:三条哲学 在探讨技术之前,我们需要先确立三条基石性的认知: 人类的本质:人类在生物界的独特性在于高等智慧,而人与动物的分野,在于制造与使用工具的能力。 大模型的定位:ChatGPT 标志着人类首次赋予机器高等智慧。大模型之于现代人类,如同智慧之于原始人类,不仅不可或缺,更不可退化。 Agent
青稞Talk 深度对话!2025 “青稞” AI 嘉年华,与 20+ 位青年科学家一起探讨AI 技术瞬间 本次活动专为青年科学家打造,旨在搭建一场 AI 技术的深度对话,来自学术和工业界的 20+ 青年科学家,将与大家一起回顾 2025,展望 2026!
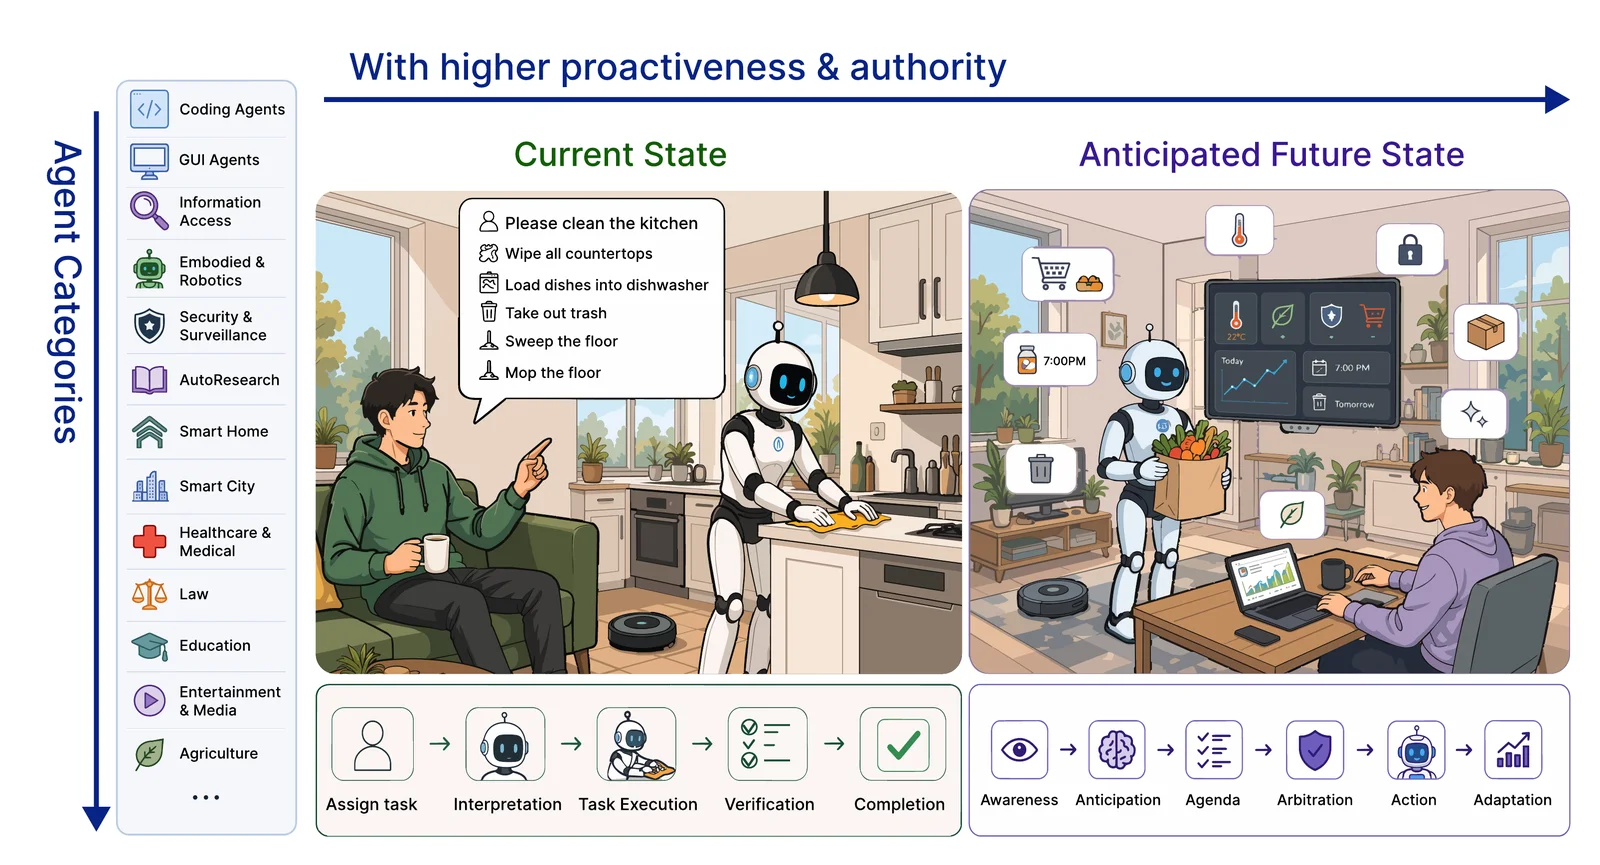
精选文章 下一代 Agent 到底需要什么能力?UIUC、Google、斯坦福等联合推出 Proactive AI 综述 试想这样一个场景:一位用户请 AI 助手协助准备周五的项目汇报。AI 助手收到要求后,可以整理材料、生成图表、写好讲稿。用户没有继续交代时,它能否发现某张图仍在使用旧数据,或某个关键结论缺少支撑?发现问题后,它应当先准备修改方案,还是立即向用户确认? 这些问题涉及一项容易被任务完成率掩盖的能力:主动
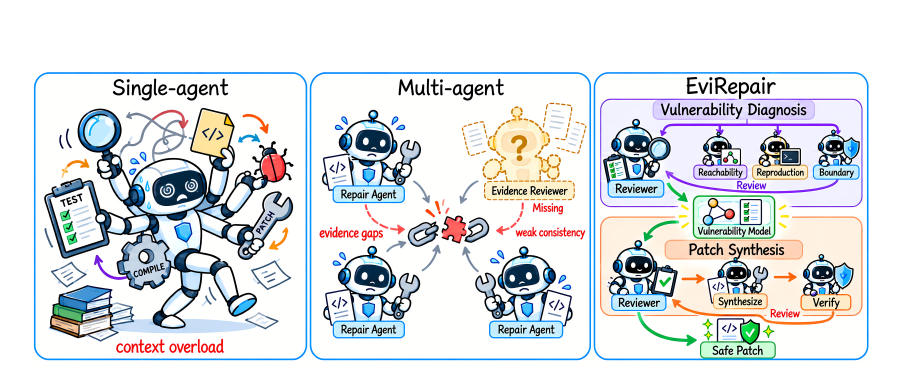
精选文章 AI 修漏洞,怎么证明自己真的修对了?南京大学提出 EviRepair,让 Agent 用证据说话 大语言模型会修漏洞,但它真的修对了吗? 大语言模型已经能够阅读代码、定位问题、生成补丁,还可以在修改后运行测试。看起来,自动漏洞修复似乎已经进入了“让智能体自己完成任务”的阶段。 但漏洞修复有一个容易被忽略的问题:补丁通过测试,并不一定意味着安全问题已经真正解决。 一个智能体可能只针对某个示例输入打
精选文章 把经验真正沉淀为长期参数记忆!浙大& Seed 提出 Cortex,探索 Agent 持续自我进化 一次成功操作、一段纠错反馈,能否成为智能体下一次进步的起点?Cortex 将经验带来的帮助沉淀为长期参数记忆,在学习新内容的同时尽量保留已有能力,为智能体的持续自我改进提供可积累的基础。 一个智能体(Agent)接到任务后,会查阅文档、调用工具、尝试不同方案。在解决问题的过程中,它可能借助文档用对了
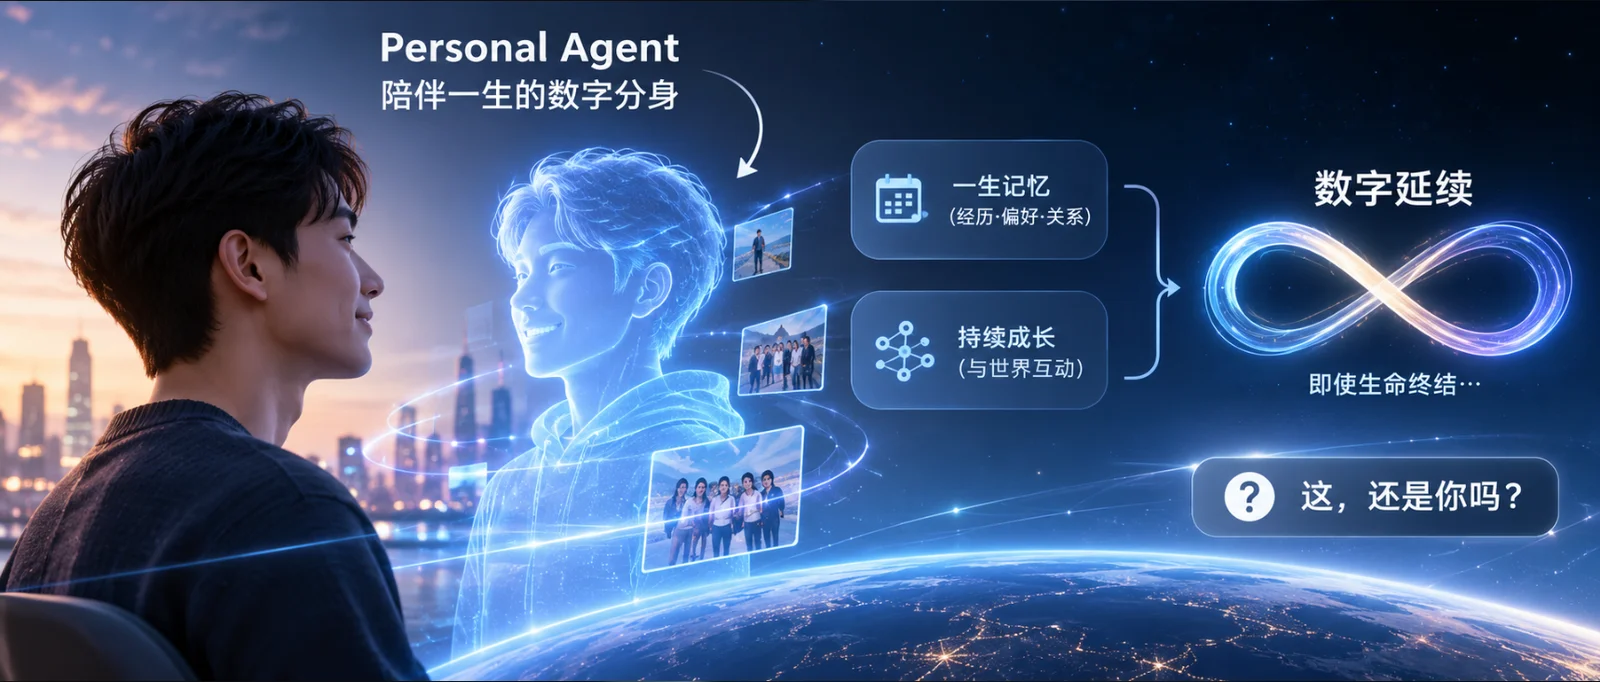
精选文章 DeepMate 创始人王鸿儒:Personal Agent,可能是人类实现「永生」的版本答案! Personal Agent,可能是人类实现「永生」的版本答案 一个有点可怕的想法:也许未来人类的死亡,不再意味着一个人的彻底消失。 最近在做 DeepMate,一个围绕人与 Personal Agent 的记忆、身份和社交关系构建的 AI 产品。 在思考 Agent 的长期记忆机制时,突然意识到一
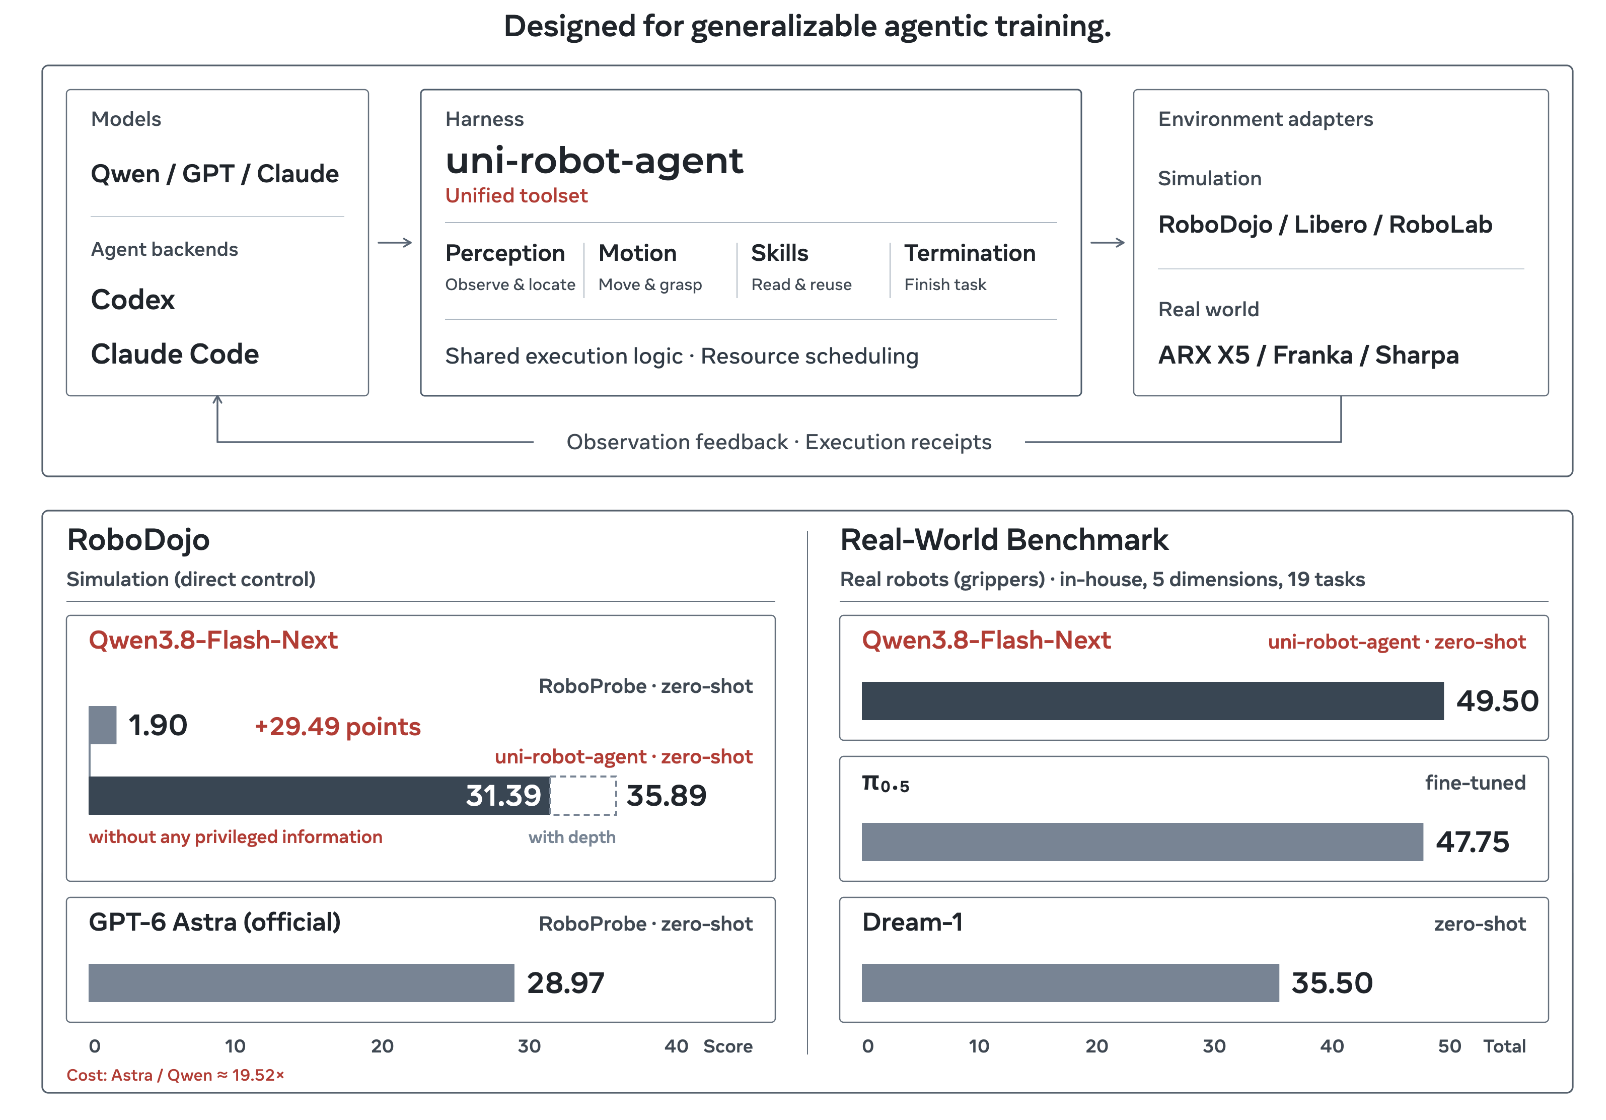
精选文章 开源模型也能直接操作机器人!清华、伯克利提出统一 Agent Harness,迈向 RUA 训练和本地部署 正文 在 RoboDojo 上,Qwen3.8-Flash-Next 通过直接操控机器人的方式拿到 31.39 分。这个分数,比 GPT-6 Astra 此前榜单上公开的 28.97 分更高。Qwen 以约 6.6% 的成本,跑赢 Astra 公开成绩。 一个开源、权重可以下载、单局调用成本只有 1
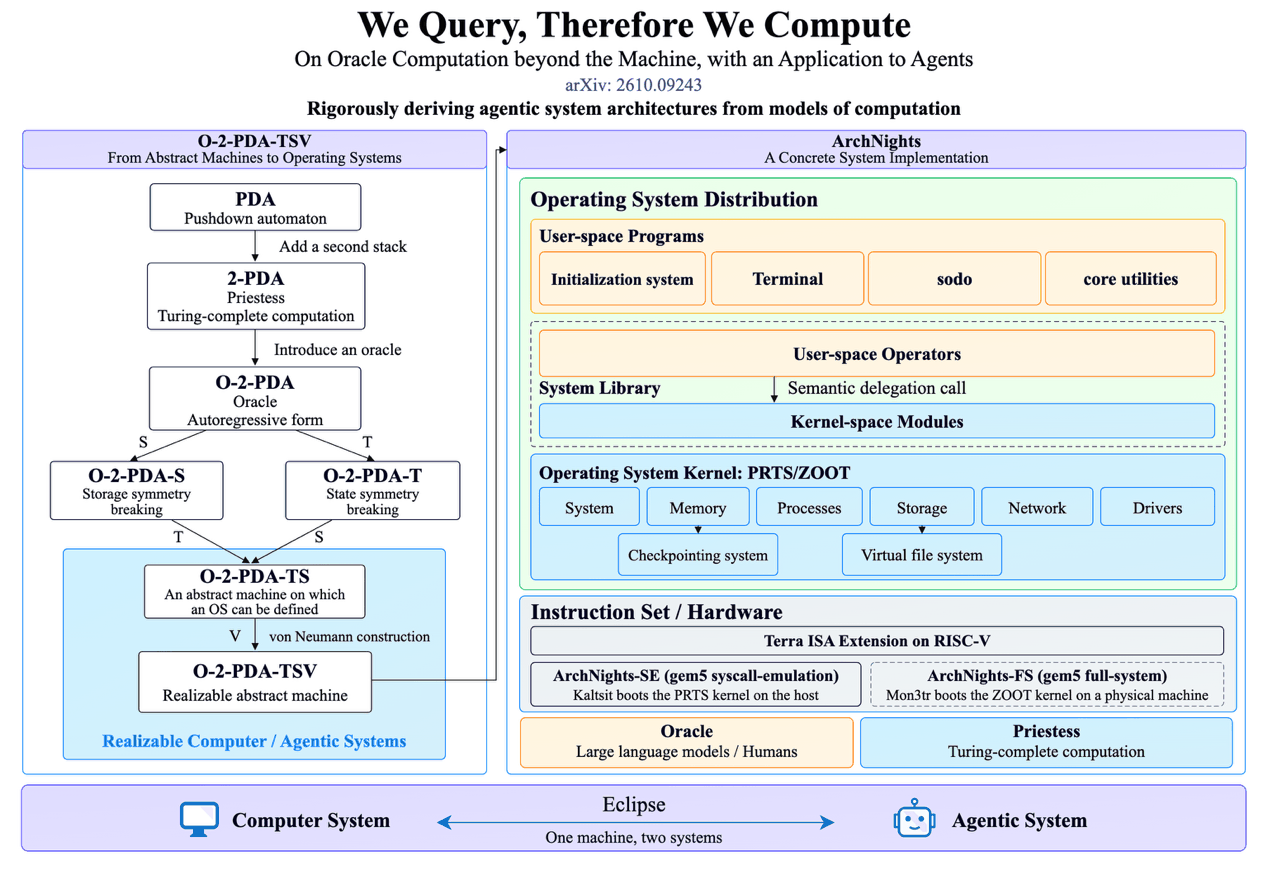
青稞Talk 直播预告!聊聊 ArchNights:如何给智能体系统造一台机器 先起一个 shell,塞两个工具,拼一段 system prompt,跑两天,再回来改 harness。这是很多 Agent 项目的日常。 但智能体系统在执行环境、上下文、可观测性这些地方,一直没形成统一的设计语言。 大家各自借词:上下文像内存,工具调用像系统调用,harness 像内核。借来的词能
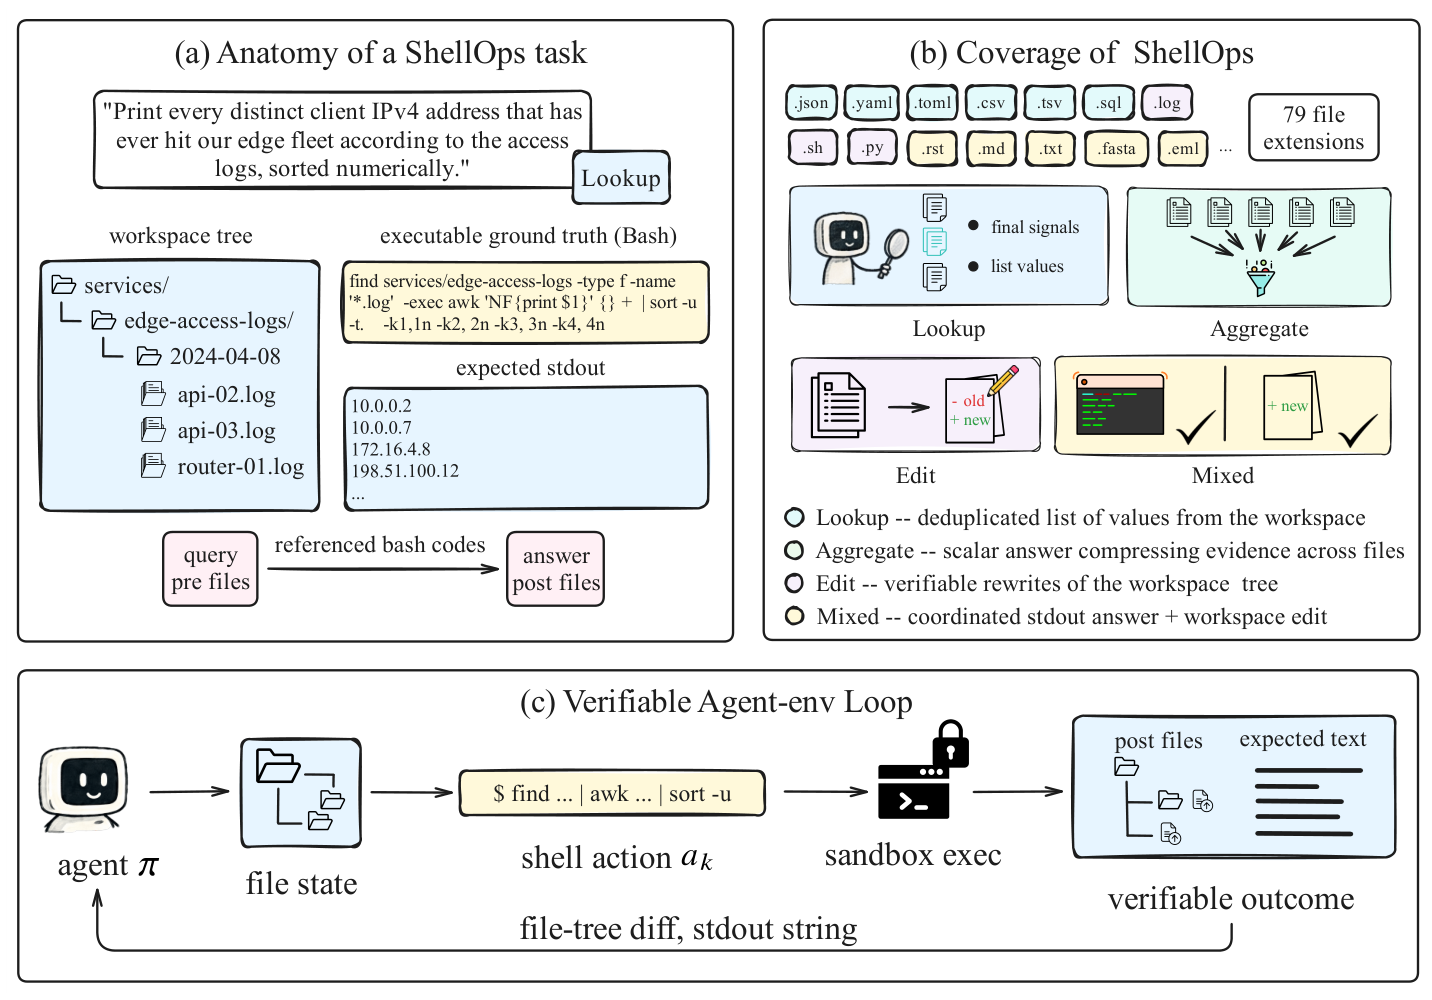
精选文章 AI 同事的训练环境从哪里来?CoworkEnv 的环境构建与训练实践 作者:CoworkEnv 团队 青稞社区为科研人员提供成果宣传支持,如有优秀研究成果分享推广,欢迎投稿联系:aiFreeCode 假设你向一个 AI 同事提出请求:找出超过 48 小时仍未关闭的企业客户工单,并向对应的客户经理发送工单升级处理的通知邮件。 要完成这项工作,Agent 需要查询工单、核
精选文章 Agentic RL 新解法!复旦上交开源 A3 框架,用 14B CLI Agent 击败 235B 大模型 作者:苏浩阳,复旦大学Ph.D Claude Code、Codex 让我们看到了编程智能体的潜力,也让一个训练问题变得更加具体:当模型能够连续执行命令、修改文件并根据反馈修正策略时,强化学习如何充分利用这些交互经验?任务最终是否成功提供了监督,但一条轨迹中包含的动作结构与决策差异,远比一个最终分数丰
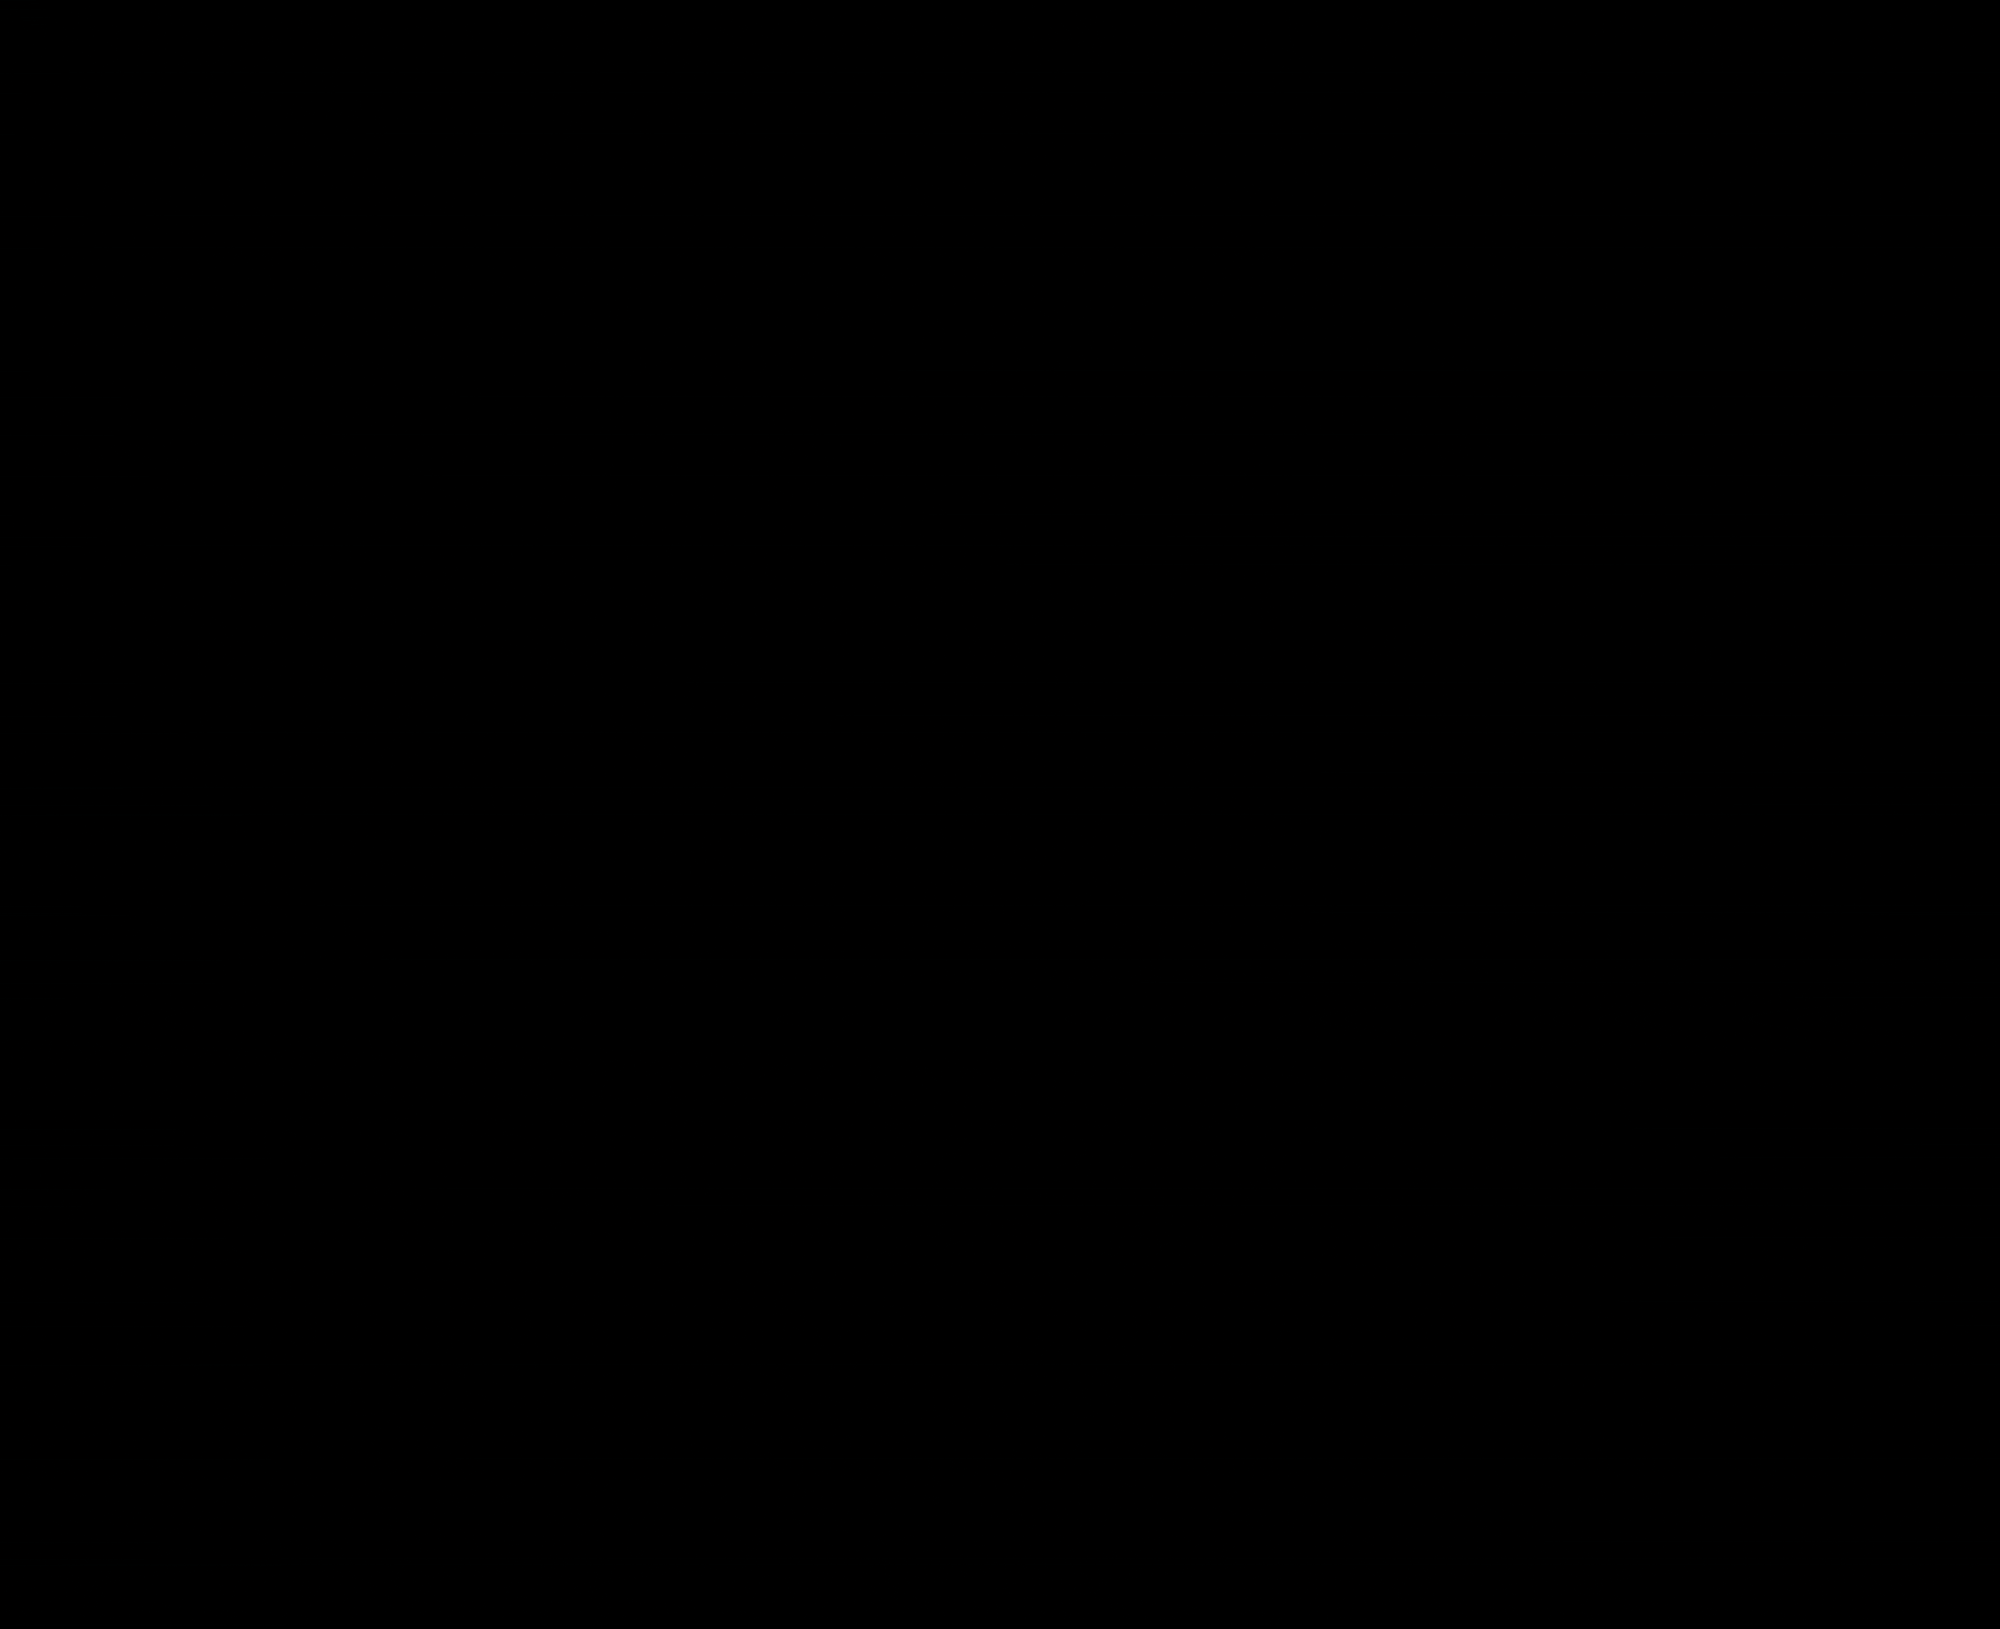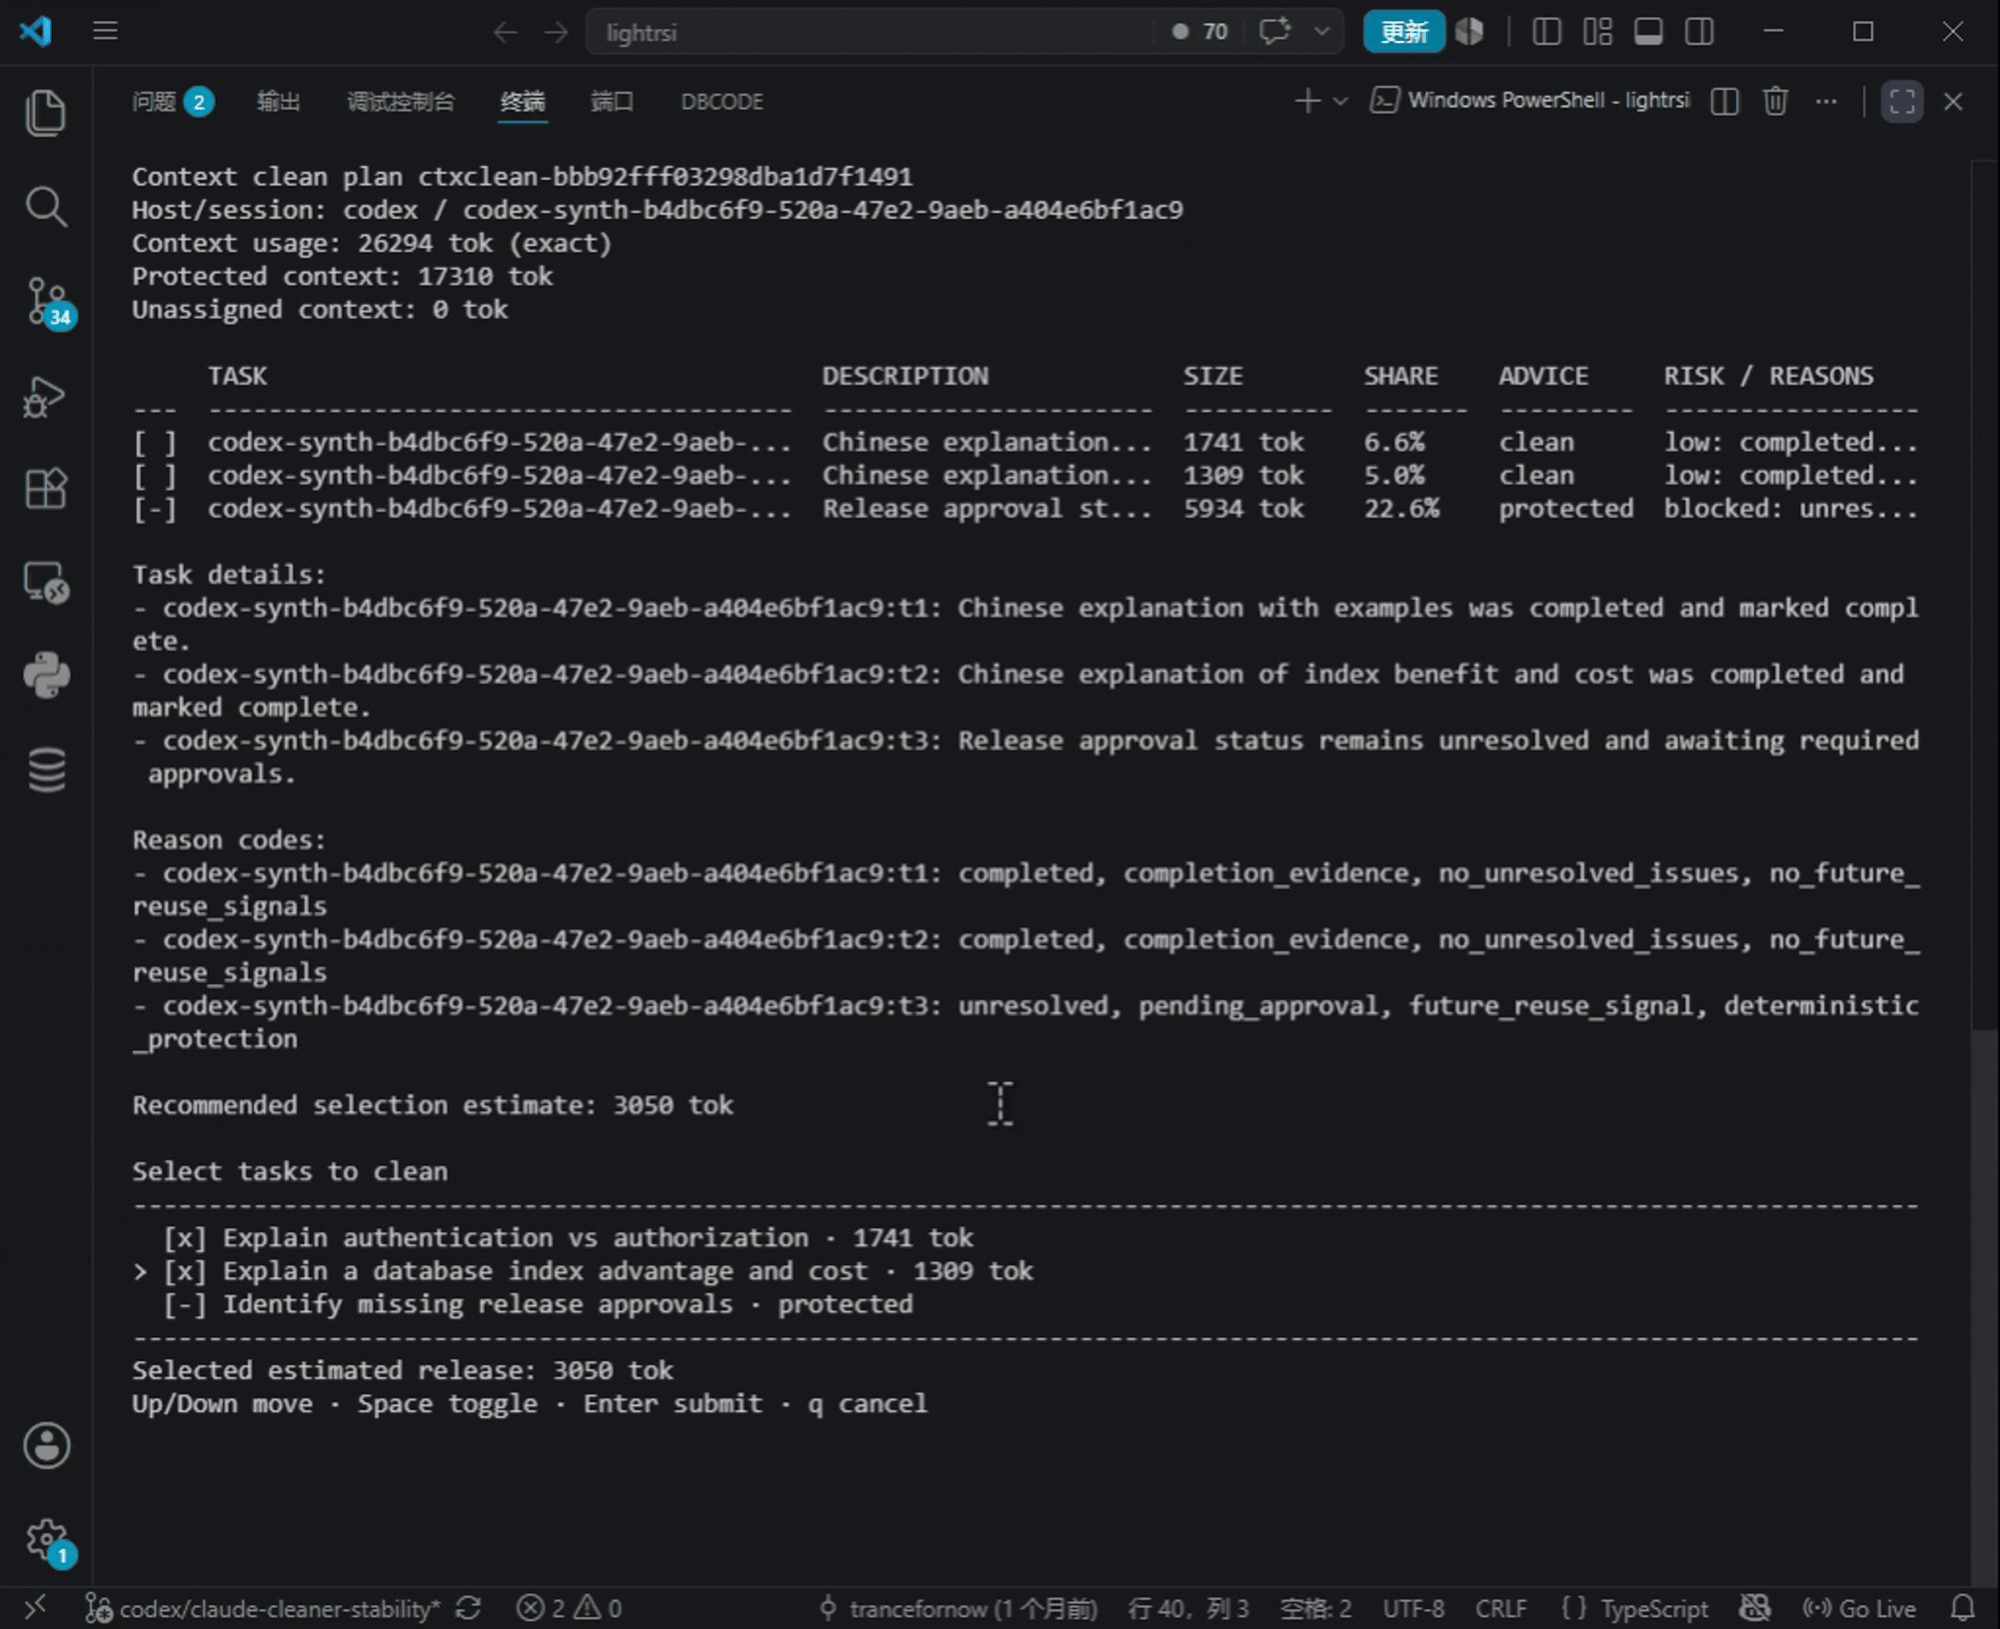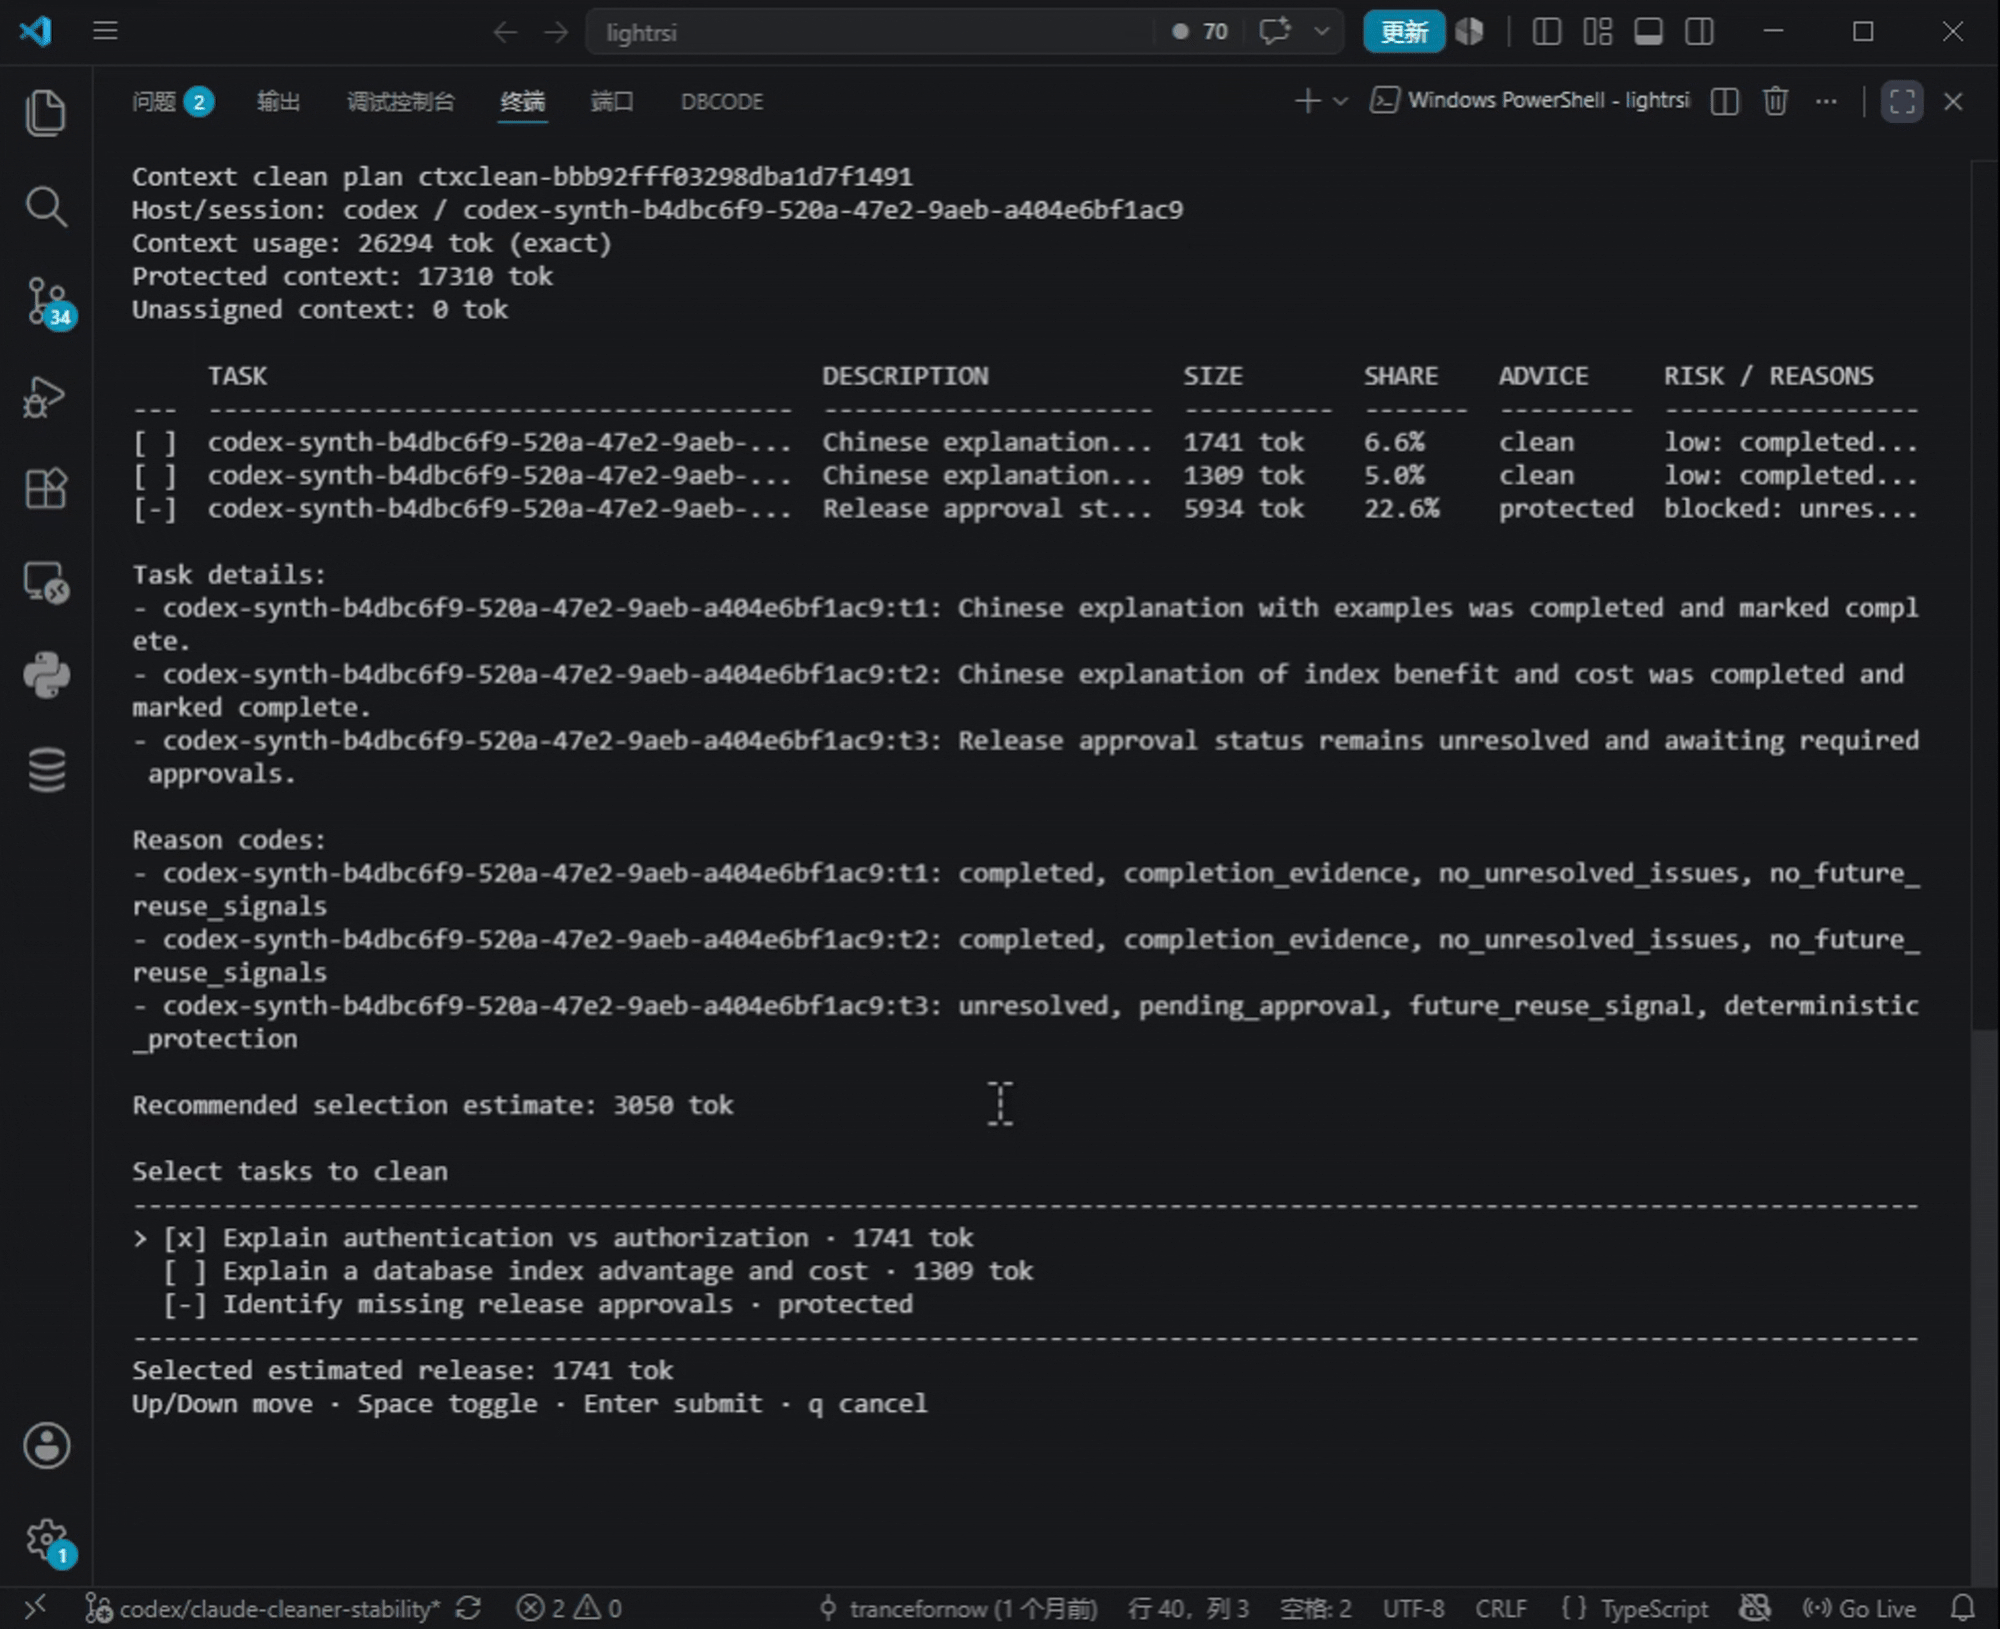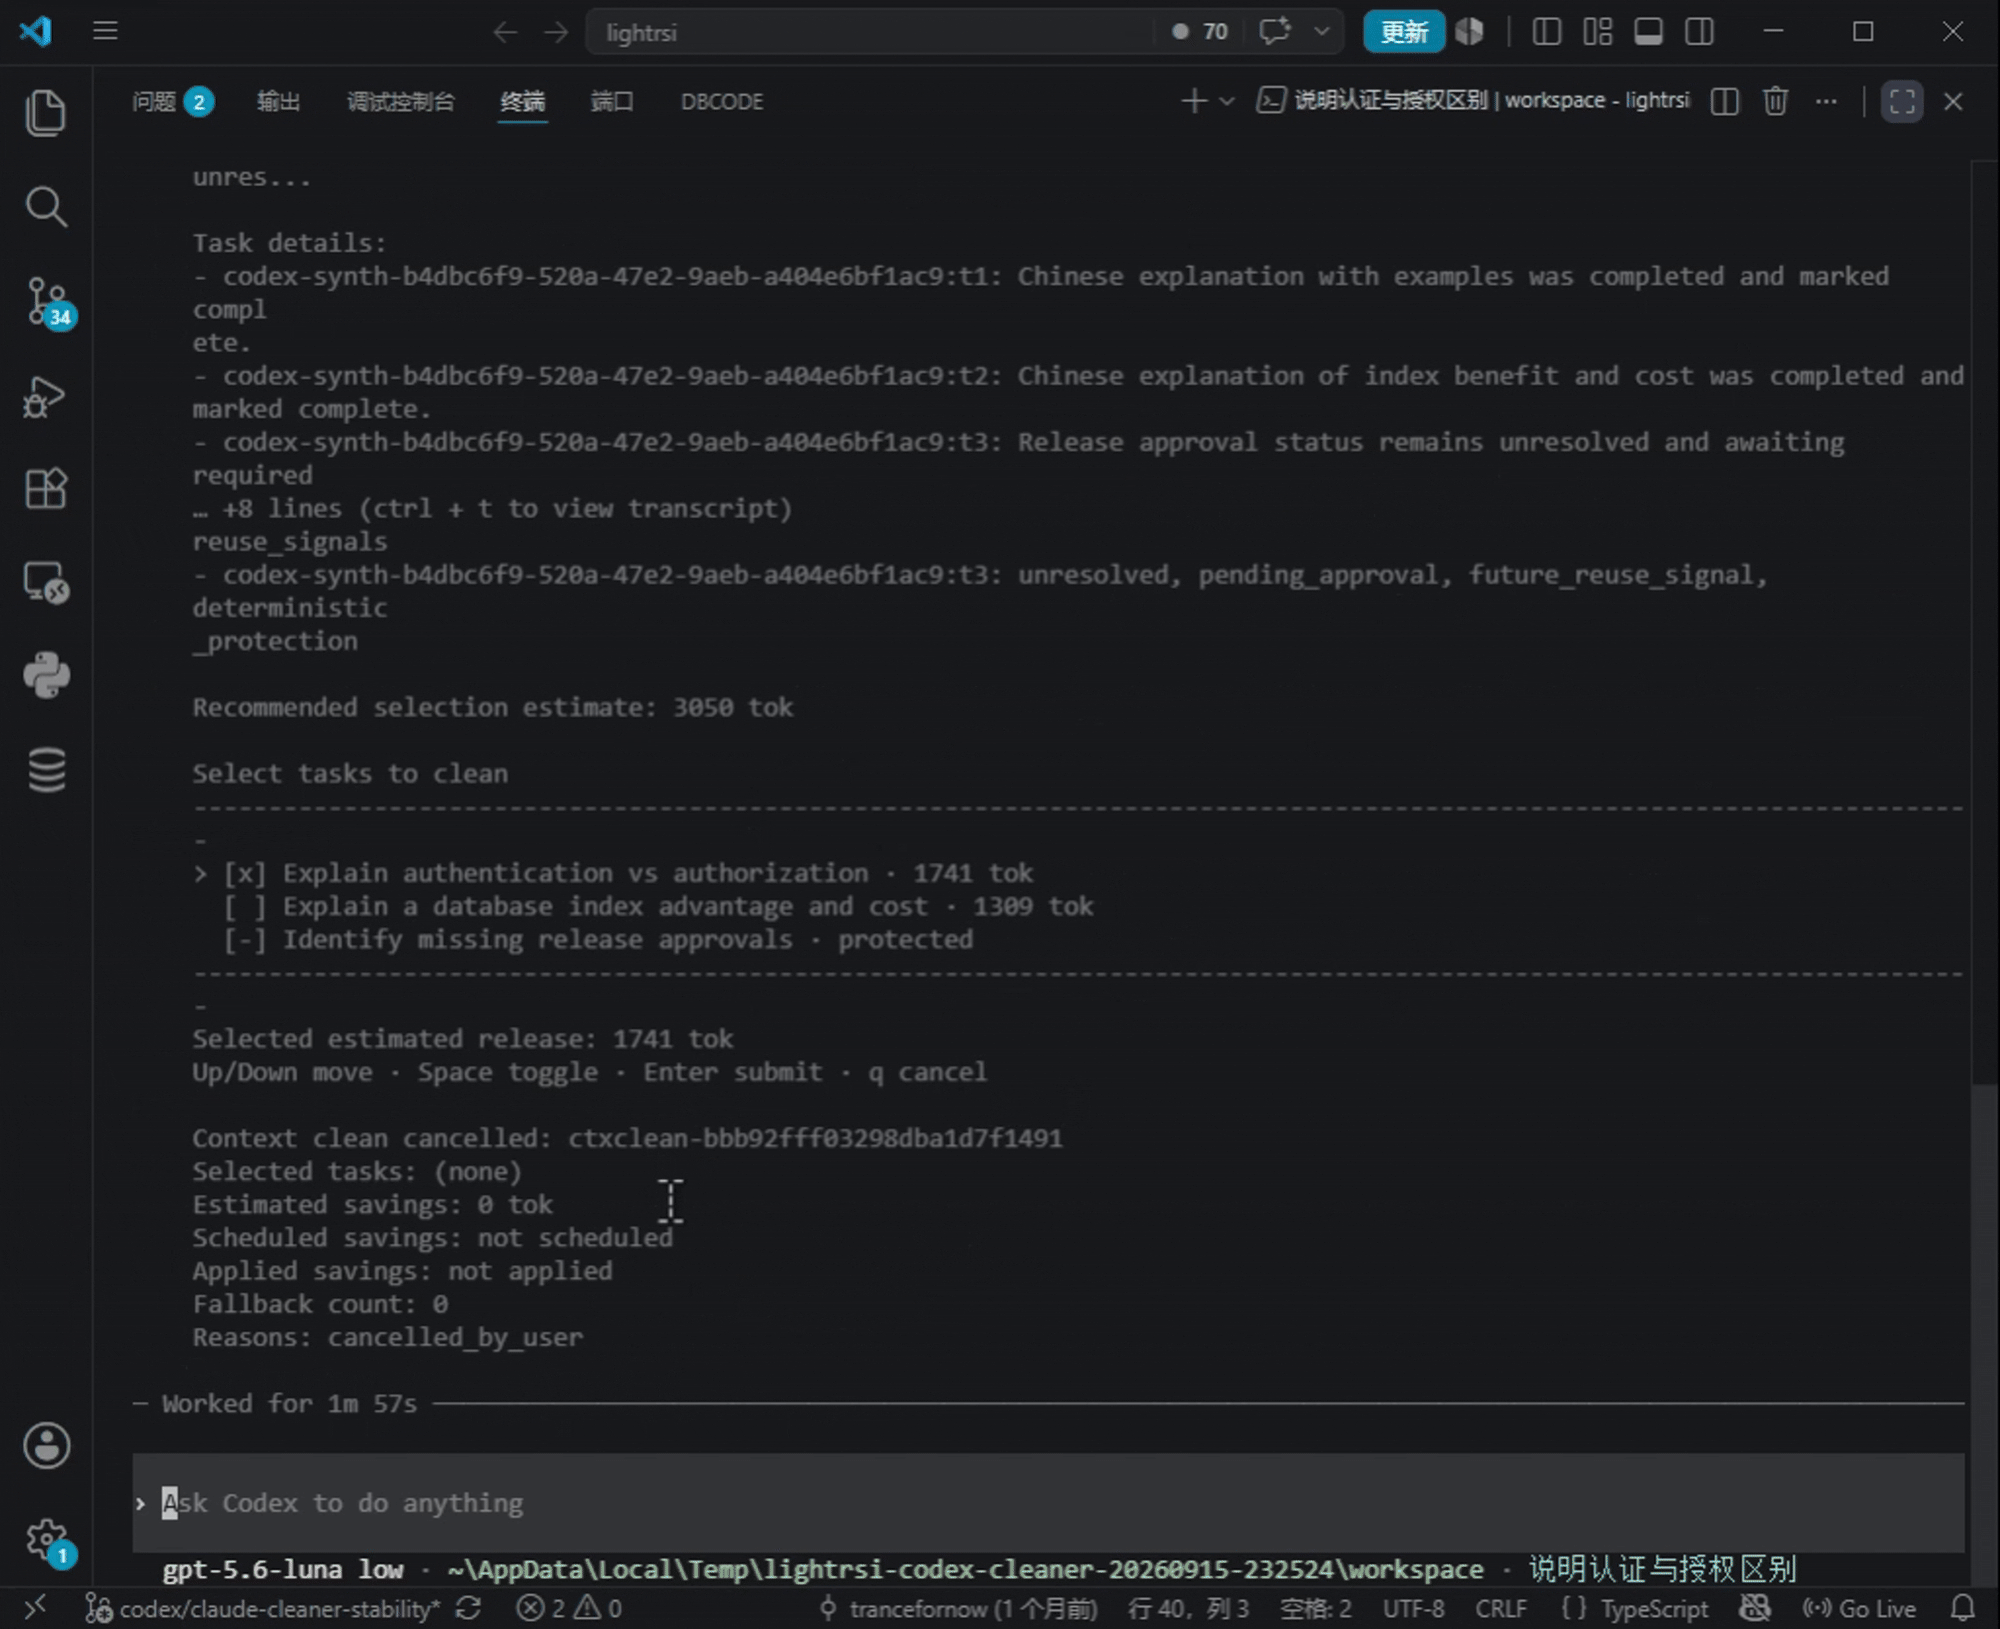
精选文章 让 Agent 长会话更省、更好管!浙大最新推出 LightRSI 探索低成本自进化 用 Agent 写代码,一个任务通常不止一次问答。它要读文件、调用工具、修改代码、跑测试,再根据结果继续行动。 在同一个会话里做得越久,积累的历史就越多。之前读过的文件、重复的测试日志、已经结束的任务,都可能继续跟在后面的请求里。当前只想改一个小功能,却要带上越来越多的旧信息。 这段时间,我们围绕这
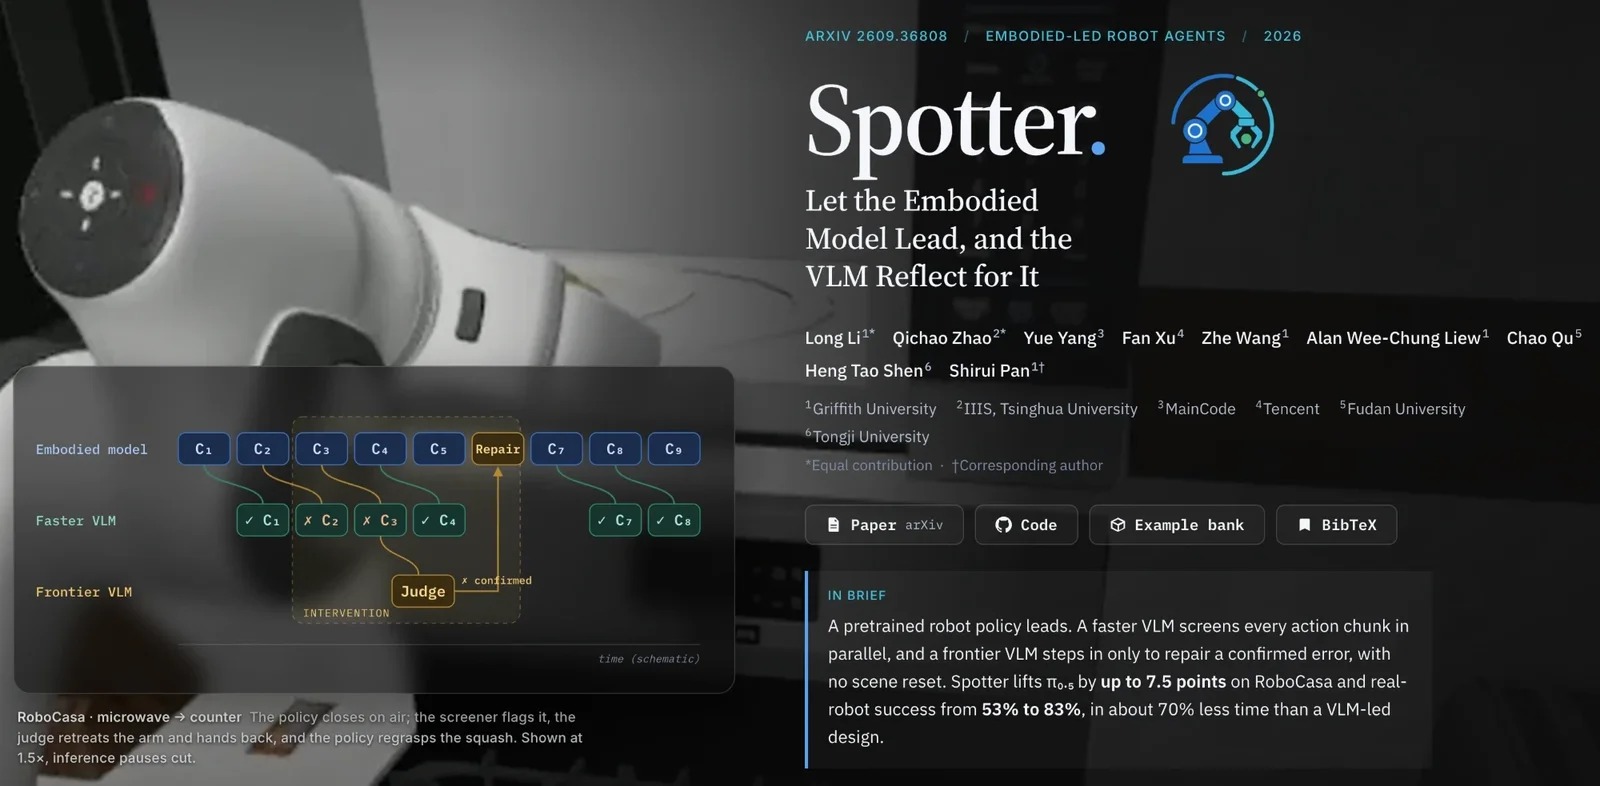
精选文章 本地千问就能跑!具身 Agent 只纠错就够了:Spotter 用并行结构让 VLM 只在出错时出手,又快又准 简介 具身模型(VLA)失手后很难自己改错,而让 VLM 每一步都当指挥又太慢。Spotter 反过来:具身模型一直执行,本地 Qwen 并行盯着,确认出错时才由 VLM 出手修复并反思,修完交还控制。同样步数下成功率更高,成功的回合只多十几秒,本地一个千问就能跑。 论文:Spotter: Let
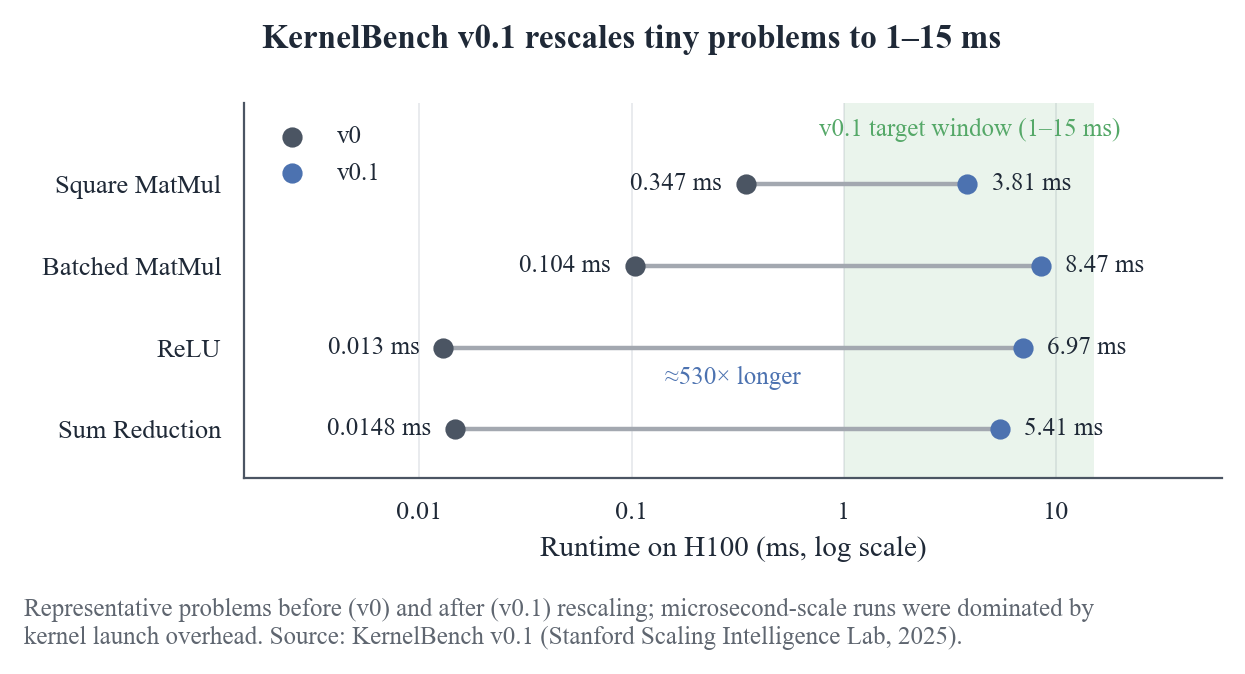
精选文章 两万字长文!2026 GPU Kernel Agent 最新进展:方法、基准与验证三者缺一不可 1. 前言 系统跑得快不快,很多时候不取决于纸面 FLOPS,而取决于真正落地的 kernel 质量。吞吐、效率和成本更多由 kernel 能否充分利用硬件决定,而不是硬件峰值本身 1。这在数据中心里是真金白银的差距:粗略估计,优化后的 kernel 每年在全球至少节省数亿美元 2。在每天数亿次调用
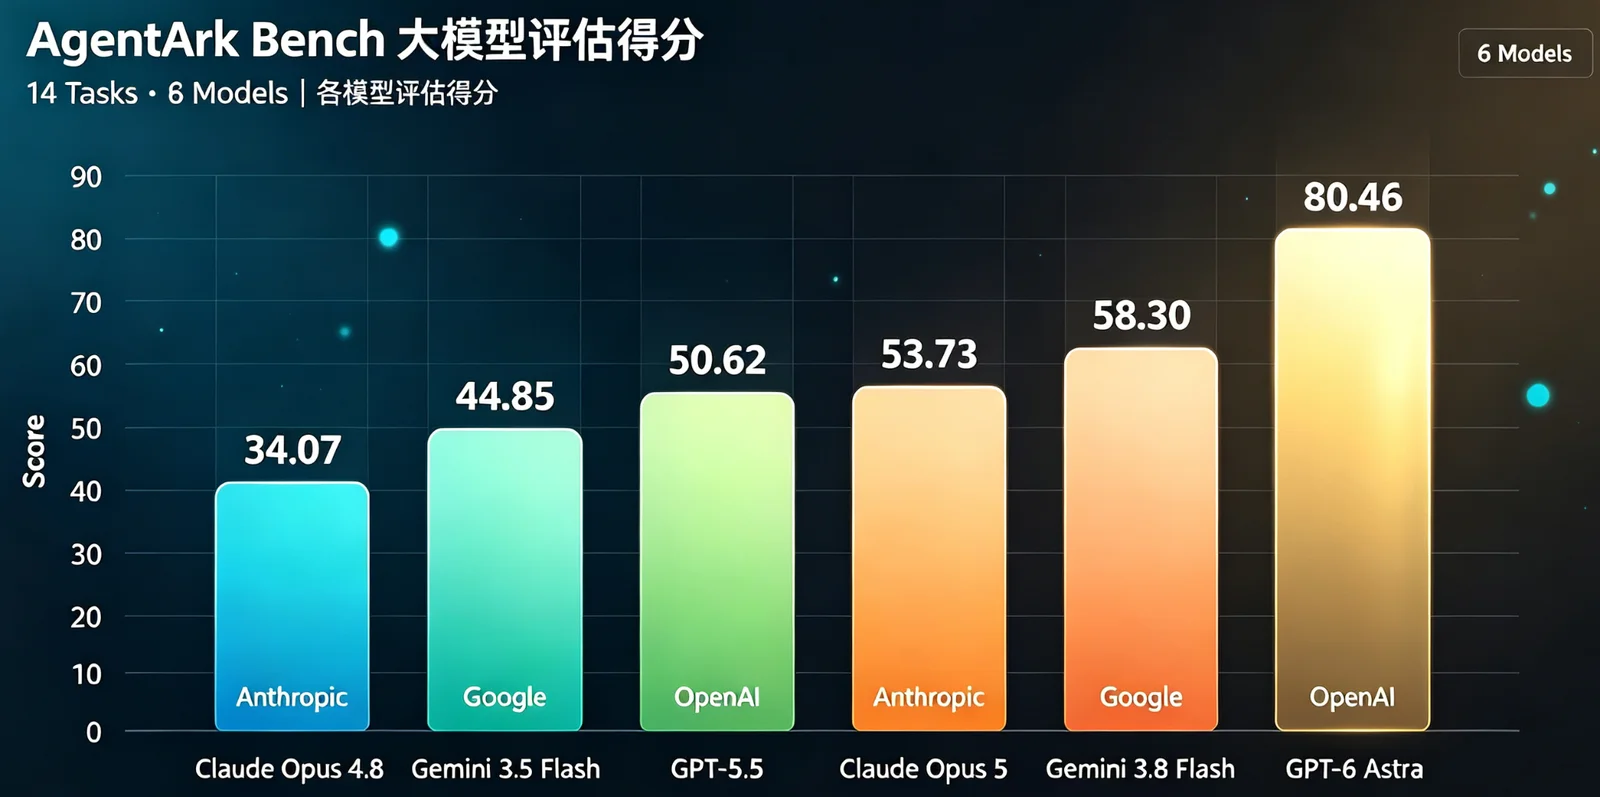
精选文章 “大模型的 Steam”!AgentArk 用 Coding Agent 扩展通用多模 Agent 的 RL 与评测环境 AgentArk 是一个面向多模态智能体的开放环境框架。核心思路是利用 Coding Agent 持续扩展 task,并让同一批环境同时支持 Agentic RL 训练与评测。 AgentArk:https://github.com/P90-RushB/AgentArk AgentArk Hub:h
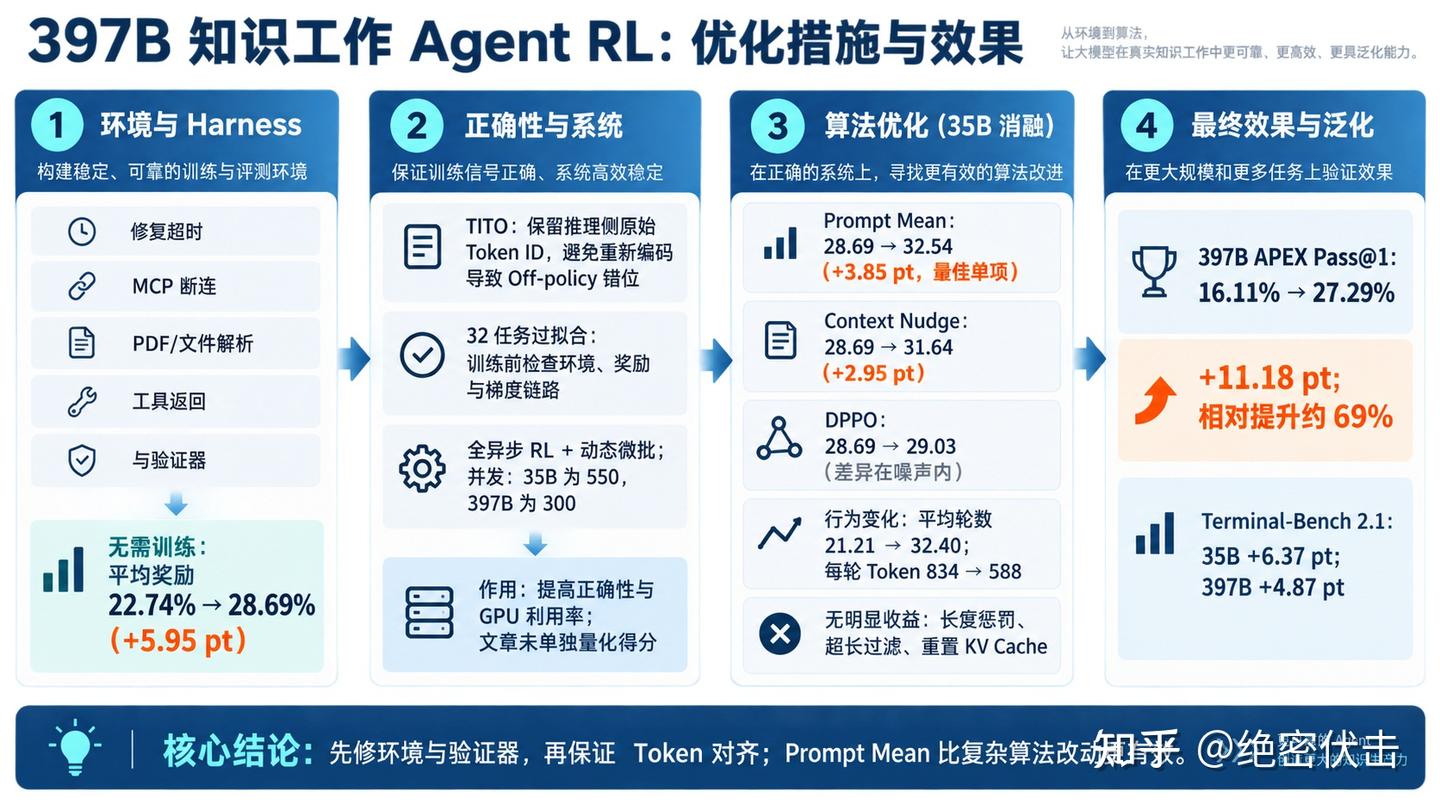
精选文章 LoRA 一作、OpenAI o1 核心成员的新工作:首次公开 397B 模型的 Agent RL 训练配方 LoRA 第一作者、OpenAI o1 核心成员 Edward Hu 近期加入 Mercor,担任 Head of AI Modeling。他加入后的首批公开成果之一,便是与 SkyRL 团队联合发布的一套面向复杂知识工作 Agent 的强化学习方案。 这项工作并未止步于公布最终结果,而是系统公开了
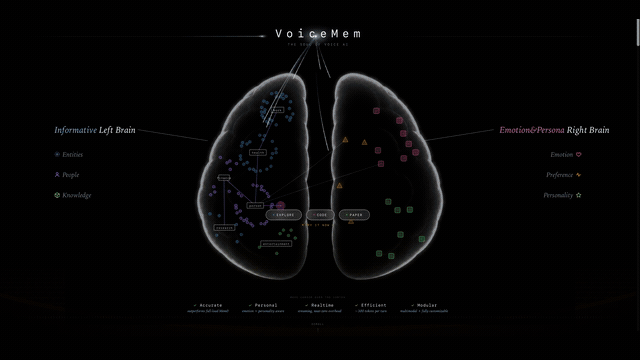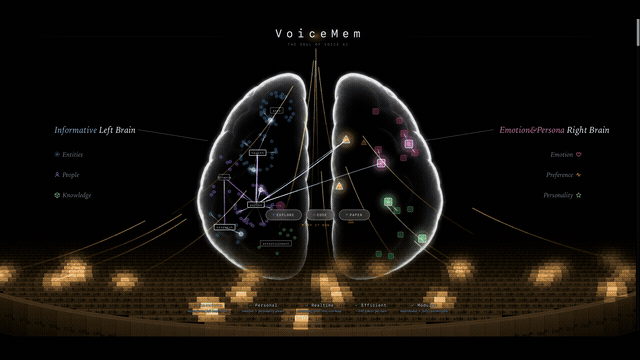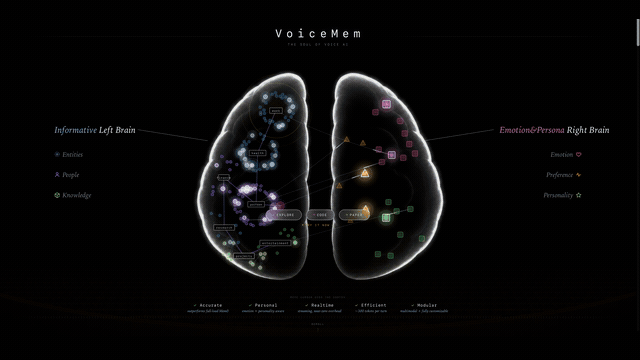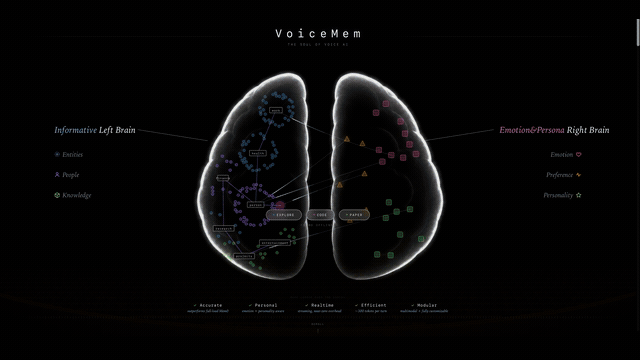
精选文章 语音 Agent 如何获得连续记忆?颜水成团队发布 VoiceMem!打造首个面向实时语音“流式双脑”记忆底座 当AI成为与人长期共生的AGI Being时,默契也将成为人机关系的一部分。 所谓默契,就是你不用反复交代过去,它也知道你为什么此刻提起此事;你的想法改变了,它也能及时跟上。 这种默契需要记忆。即使你没有重新提起过去的经历、偏好和感受,它也能听懂你此刻的话。 但在实时语音里,留给AI寻找这些的时间非
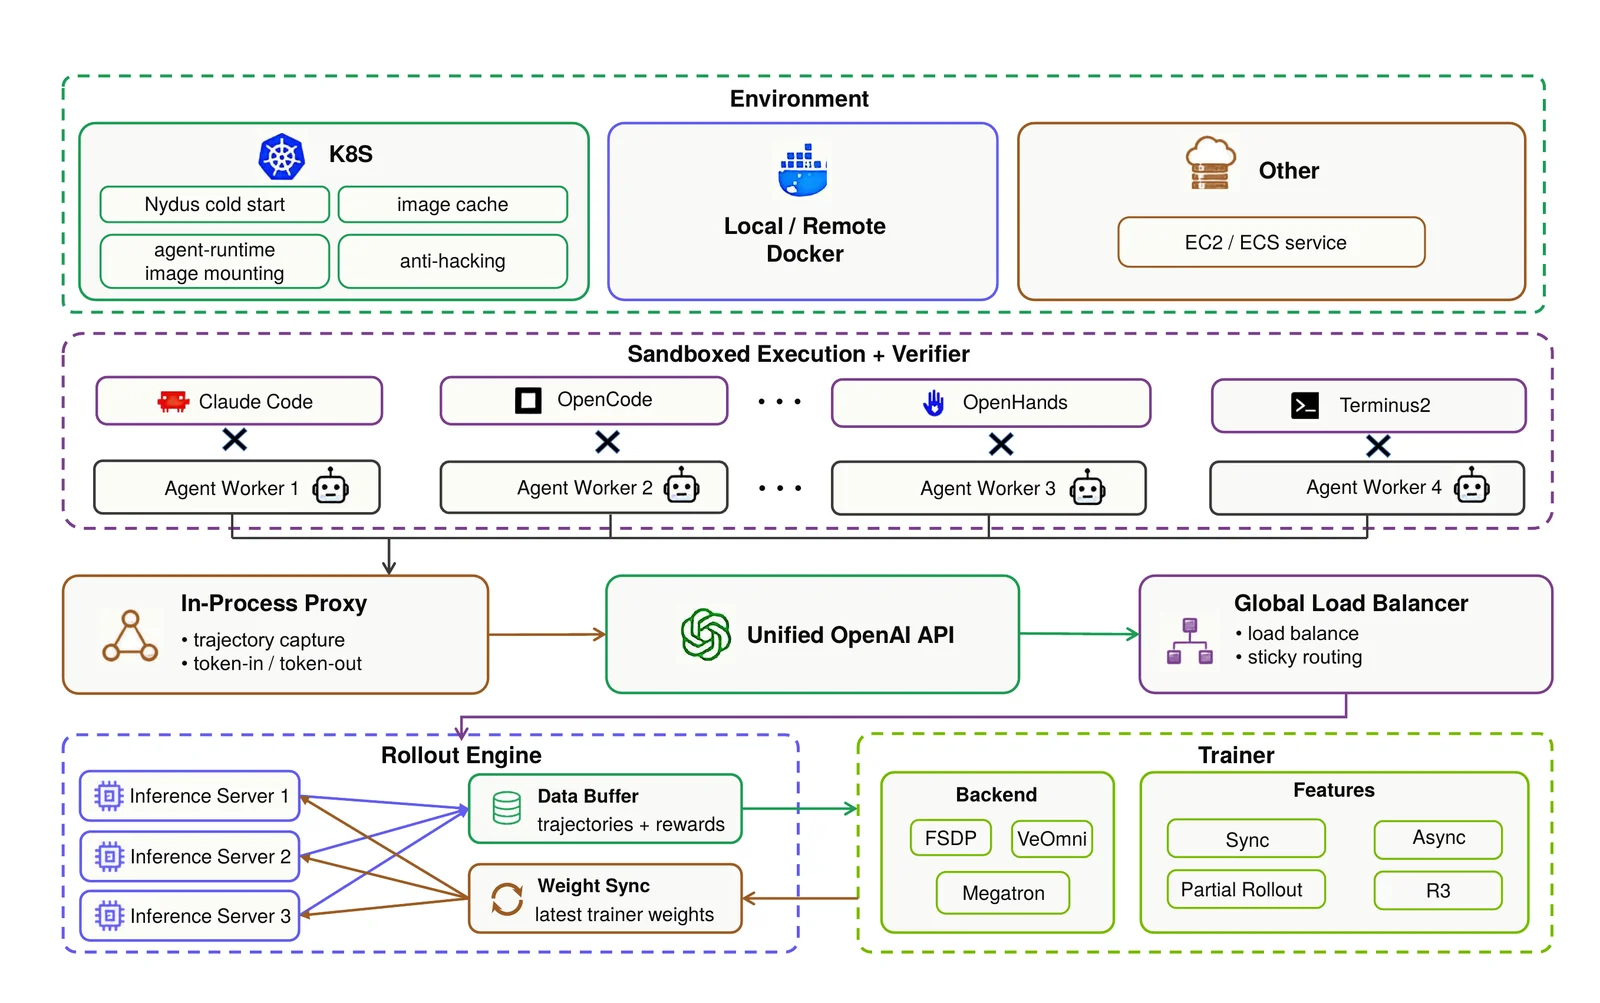
青稞Talk 直播预告!如何在真实 Coding Agent Harness 中接入 RL? 随着编码智能体从“模型能力”走向“模型 + Harness”协同,工具调用、上下文管理与控制流正在成为影响智能体能力的重要因素。 然而,将真实 Agent Harness 接入强化学习训练并不简单:环境故障与奖励投机会污染训练信号,训练与推理环境的差异也可能导致策略更新偏离真实 Agent 行为。
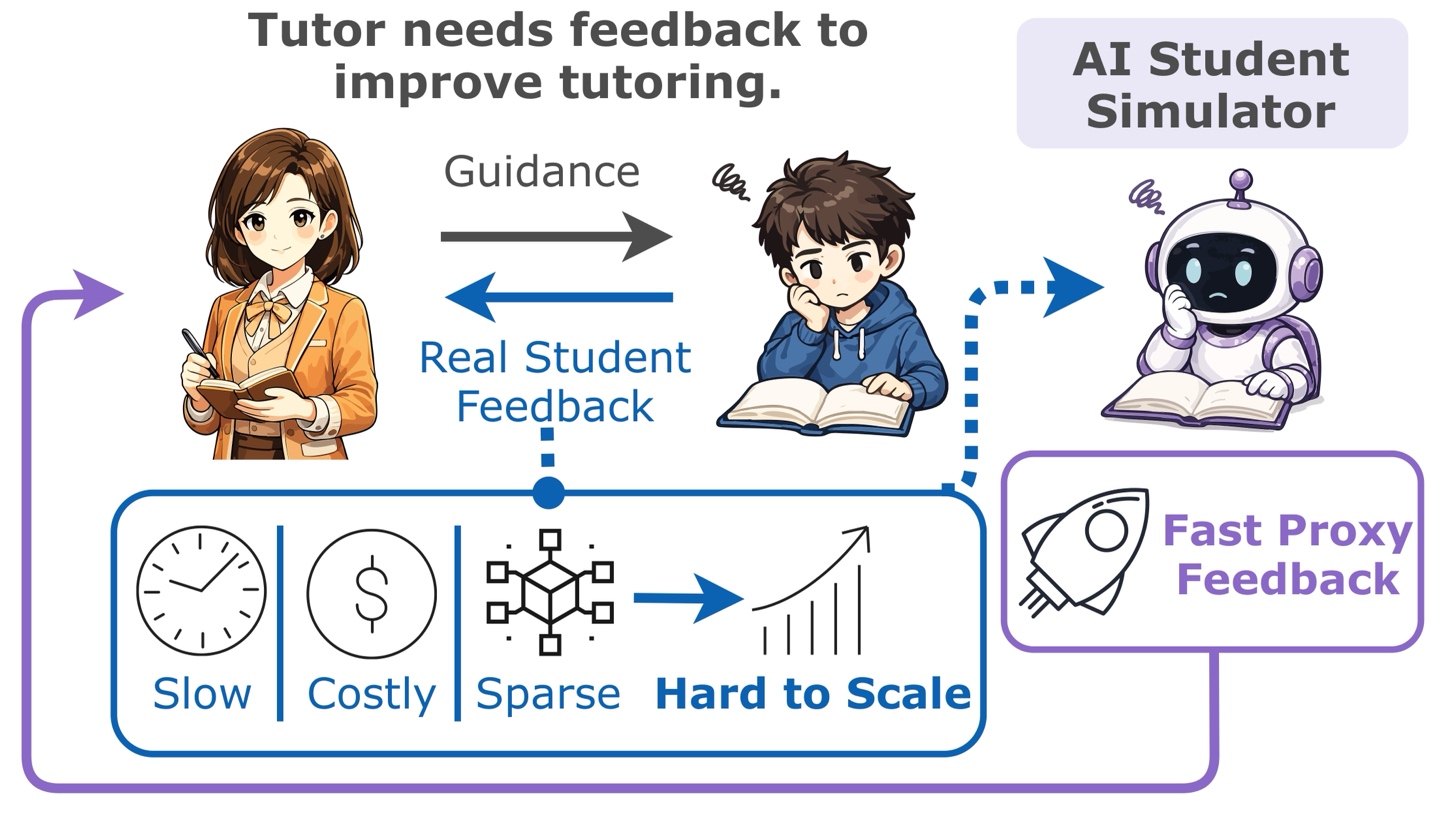
精选文章 微软最新提出面向 AI tutor 训练的学生模拟器 StudentSim:从真实学习记录构造 feedback model 论文标题:StudentSim: Training LLM-based Student Simulators 论文链接:https://arxiv.org/abs/2609.01591 Huggingface Paper 主页:https://huggingface.co/papers/2609.0
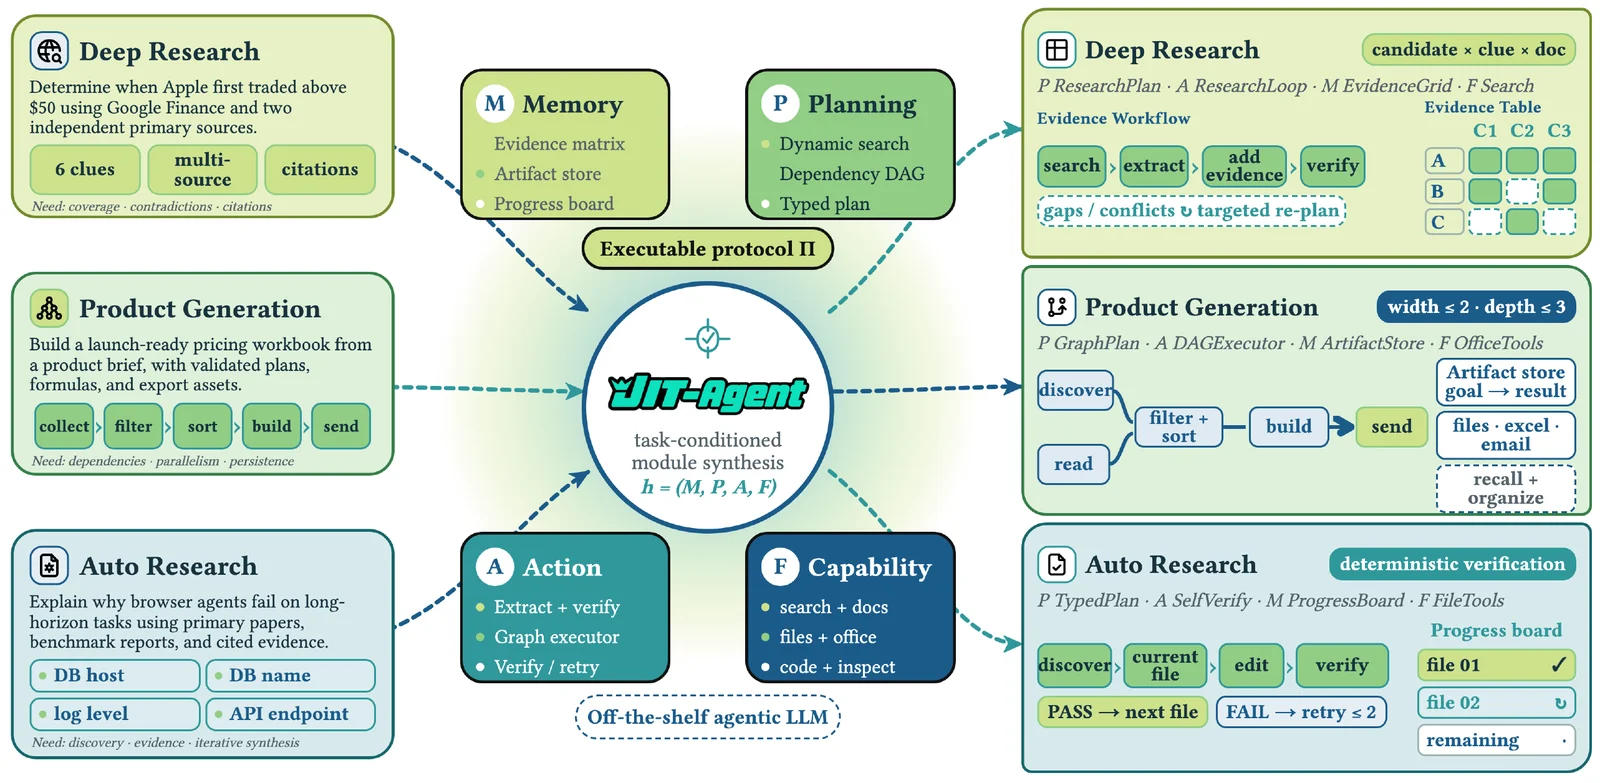
精选文章 Harness基模JIT-27B,为每个任务写一套“Claude Code” Harness基模JIT-27B,为每个任务写一套“Claude Code” Agent benchmark 通常把模型视为能力的主要来源,但同一模型只要更换记忆组织、规划协议、工具暴露方式或错误恢复流程,最终表现就可能跨越一个明显的档位。 这样的差异来自 Agent Harness:它定义模型在什
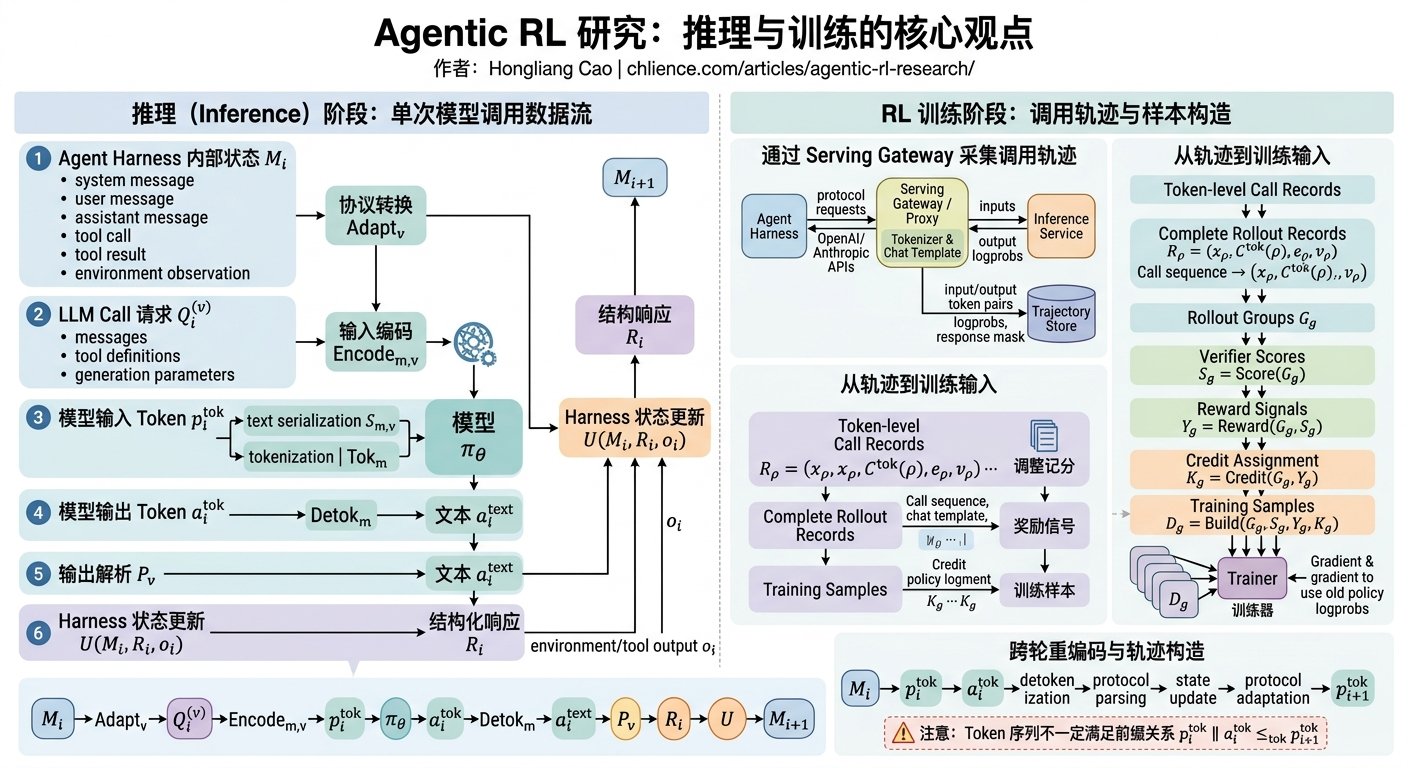
精选文章 聊聊 Agentic RL 中的多轮 rollout、上下文重建与 RL 训练 作者:Hongliang Cao https://chlience.com/articles/agentic-rl-research/ 推理 一次模型调用 对于一次典型的 agentic inference,第 i 次模型调用可以分为三个层次:agent harness 维护的内部状态、按照特定协议
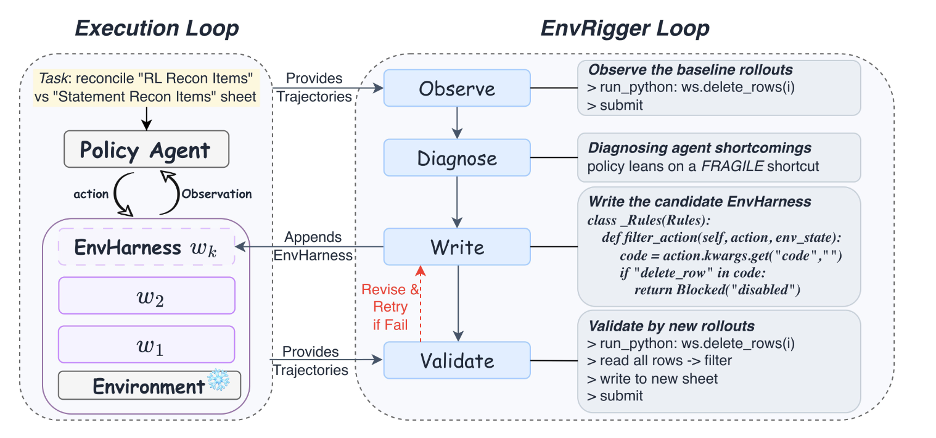
精选文章 自进化也能“左脚踩右脚”?Google提出 EnvHarness:环境自进化,倒逼 Agent 疯狂进化! Agent绝大部分时候都运行在环境当中,那么在agent进化的过程中,有没有办法让环境也进化呢。 论文:EnvHarness: Awakening Static Worlds for Agent Learning 链接:https://arxiv.org/abs/2608.19880 主页:http
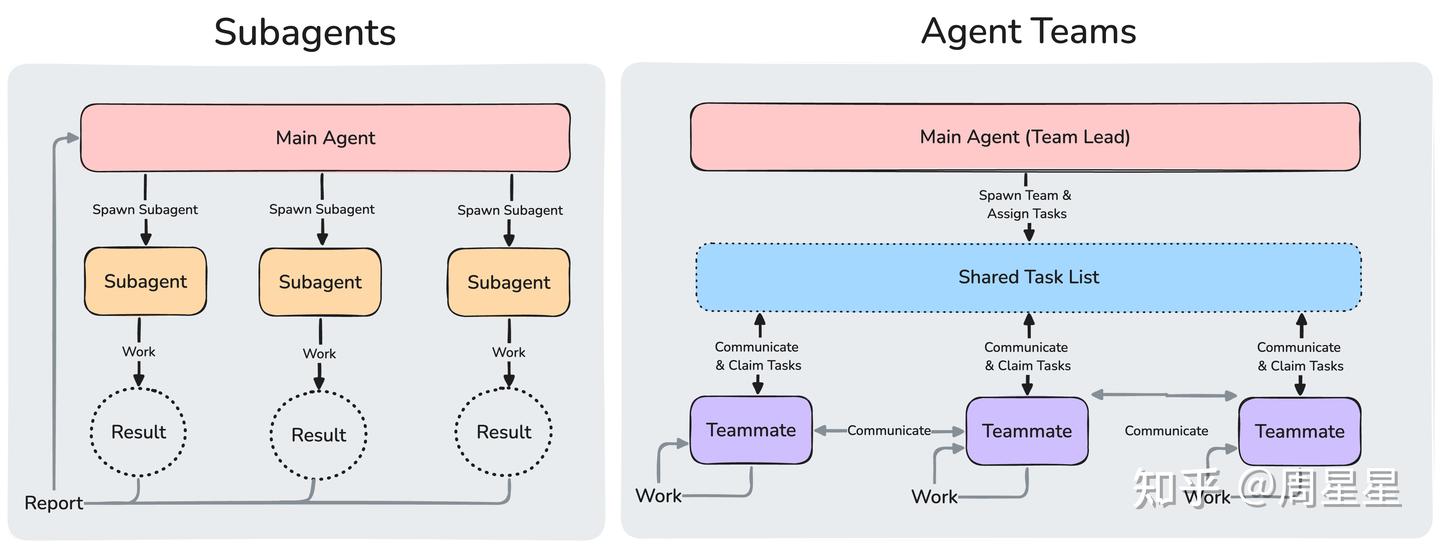
精选文章 Multi-Agent 的新趋势:从 Agent Team 到 Agent Swarm 作者:周星星 https://zhuanlan.zhihu.com/p/2069524382196691517 前言 当我们能同时调动上百个agent时,会诞生什么新的产品形态。 这是一篇没有明确中心思想的文章,想围绕多 Agent,聊几个最近不断冒出来的产品问题。 标题里 agent team 和
青稞Talk AI for AI 的前世今生: 从进化、自进化与元进化,迈向递归自我改进(RSI) 导语:当代码智能体(Code Agents)与测试床工程(Harness Engineering)飞速发展,AI 不再仅仅是被动接受指令的工具。AI for AI (AI4AI) 正在经历一场深刻的范式演变,其核心目标已明确指向人工智能领域的终极愿景之一——递归自我改进(Recursive Self
青稞Talk 直播预告!聊聊I Agentic RL 下半场:JitRL——无需梯度更新的即时强化学习 在 LLM Agent 的进化之路上,“持续学习(Continual Learning)”始终是一座难以逾越的大山: 靠上下文学习(ICL)? 拼接长历史不仅导致 Token 消耗激增、首字延迟飙升,且始终无法真正改变模型底层的动作概率分布; 靠传统强化学习(RL)? 离线微调的算力成本极其高昂,极
精选文章 长程智能体自我检查与早停行为:Reward Seeking 现象及其缓解措施 作者:storm https://zhuanlan.zhihu.com/p/2064127486921909656 笔者最近在大尺寸 coding/cowork agent 上做了一段时间的后训练与评测,发现了一类有意思的现象。 智能体接到任务后,会首先在思维链中大致猜测“评测会用到哪些测试”,在轨
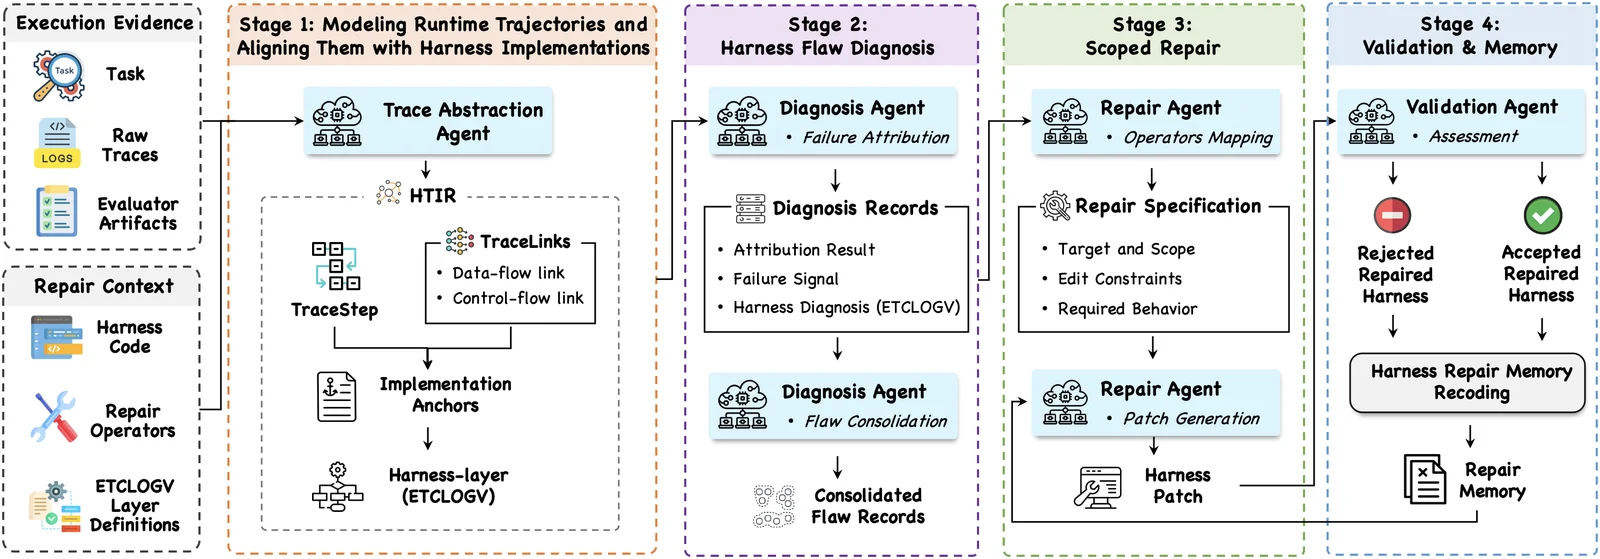
精选文章 当 Agent 失败时,别急着怪模型:HarnessFix 如何从失败轨迹中修复 Harness 作者:陈孟卓,中科院软件所 PhD 一次工具调用返回了 success,任务就真的完成了吗? 未必。 在一个应用自动化任务中,Agent 连续发起了 3 次付款请求。接口表面上返回“执行成功”,但由于请求缺少必填字段,预期的付款记录一条也没有生成。 更糟的是,错误被中间层吞掉,任务完成条件又只检查了
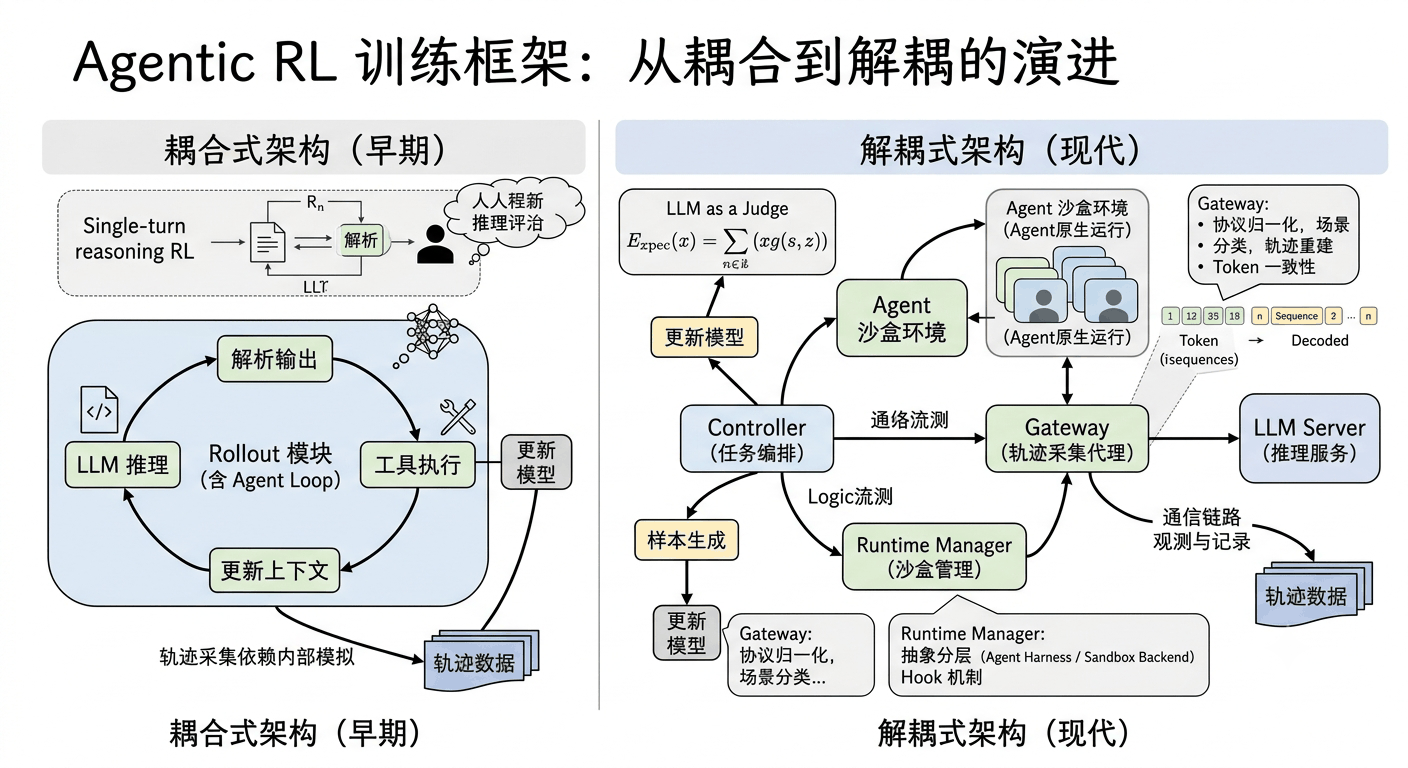
精选文章 从 LLM Rollout 到 Agentic Rollout!Agentic RL 训练框架设计中的一些总结和思考 作者:水木SH https://zhuanlan.zhihu.com/p/2062647902879667967 前言:前段时间支持了团队的Agentic RL训练工作,在框架开发过程中碰到诸多问题,有了一些新的思考,在此进行记录。 一、从 LLM Rollout 到 Agentic Rollout
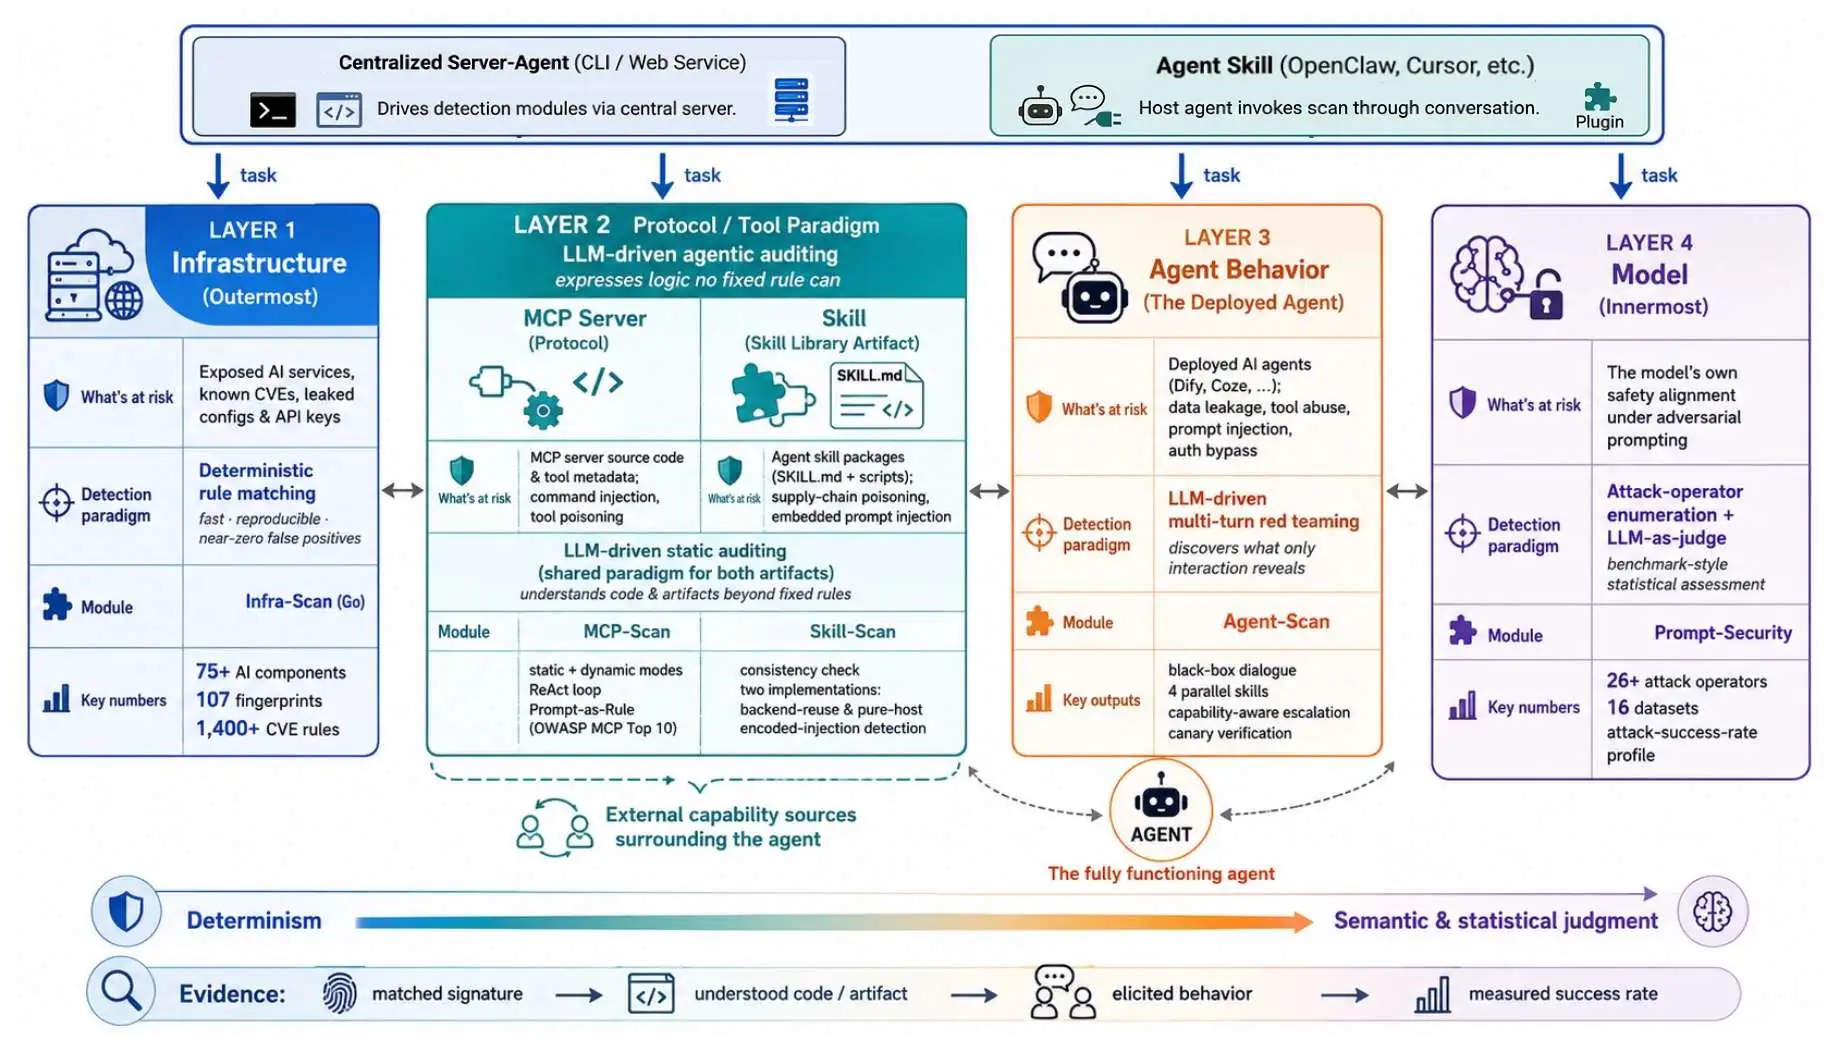
精选文章 AI Agent正在裸奔?腾讯朱雀实验室发布 AI-Infra-Guard 技术报告:AI Agent 安全需要分而治之 当Dify、MCP、Ollama等AI基础设施以周为单位迭代时,传统安全工具连“识别组件版本”都做不到。朱雀实验室这篇技术报告试图回答一个更根本的问题:安全检测范式,是否也需要随攻击面分层而进化? 上周,腾讯朱雀实验室发布了一篇题为《Securing the AI Agent: A Unified
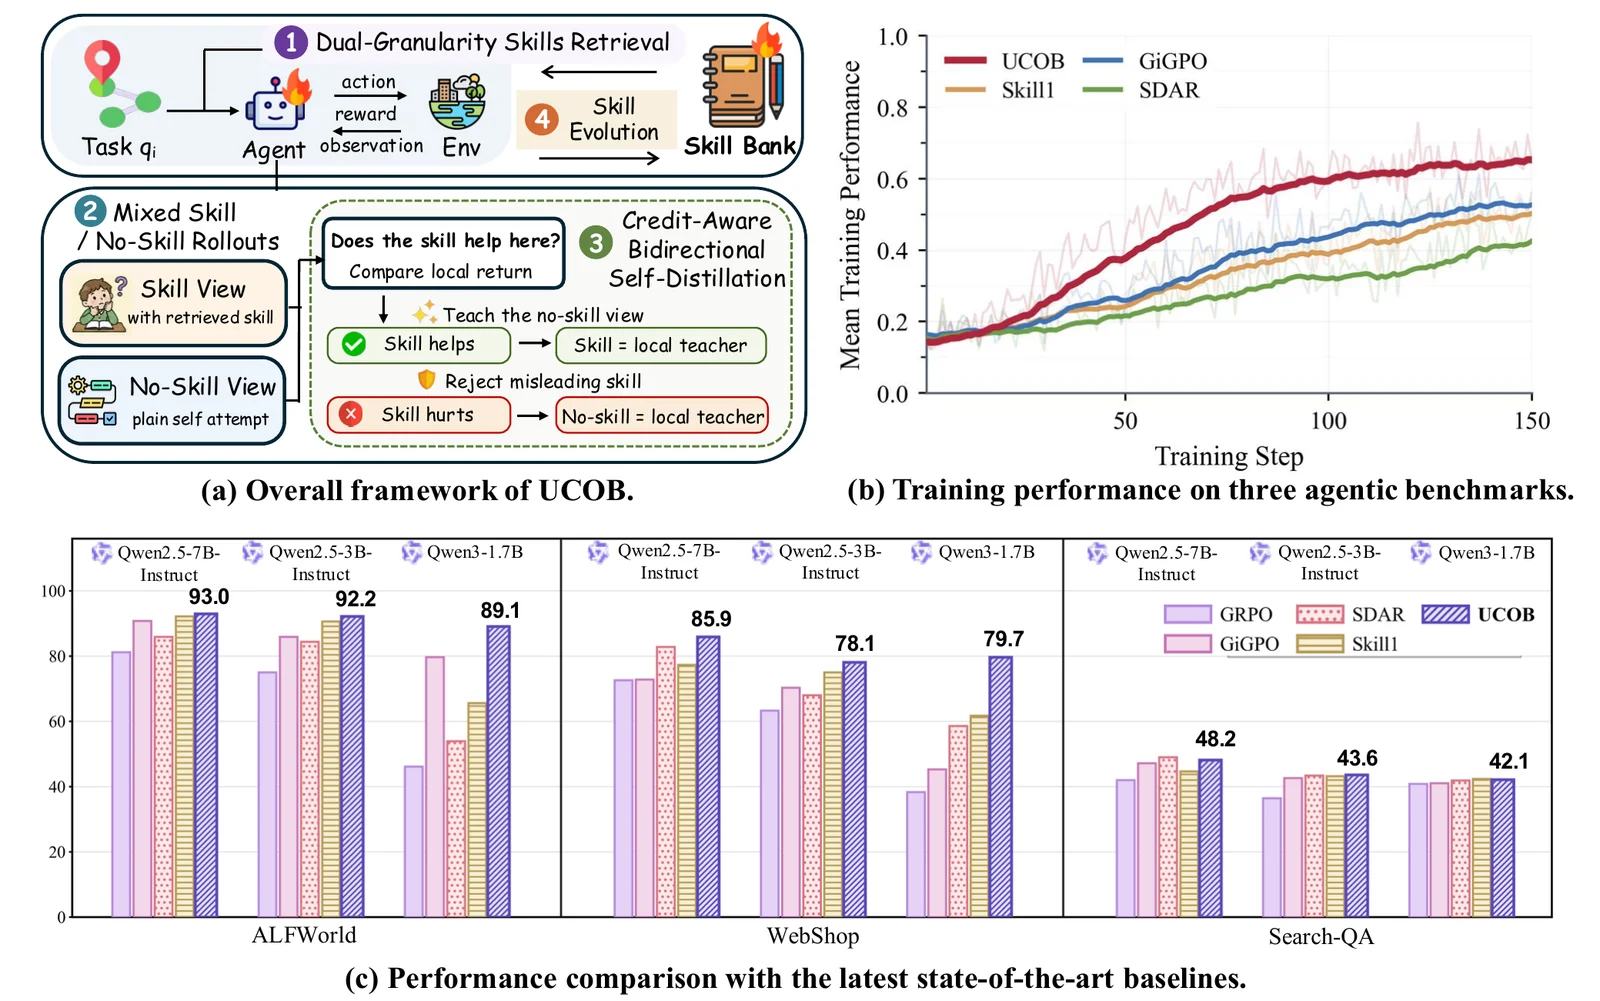
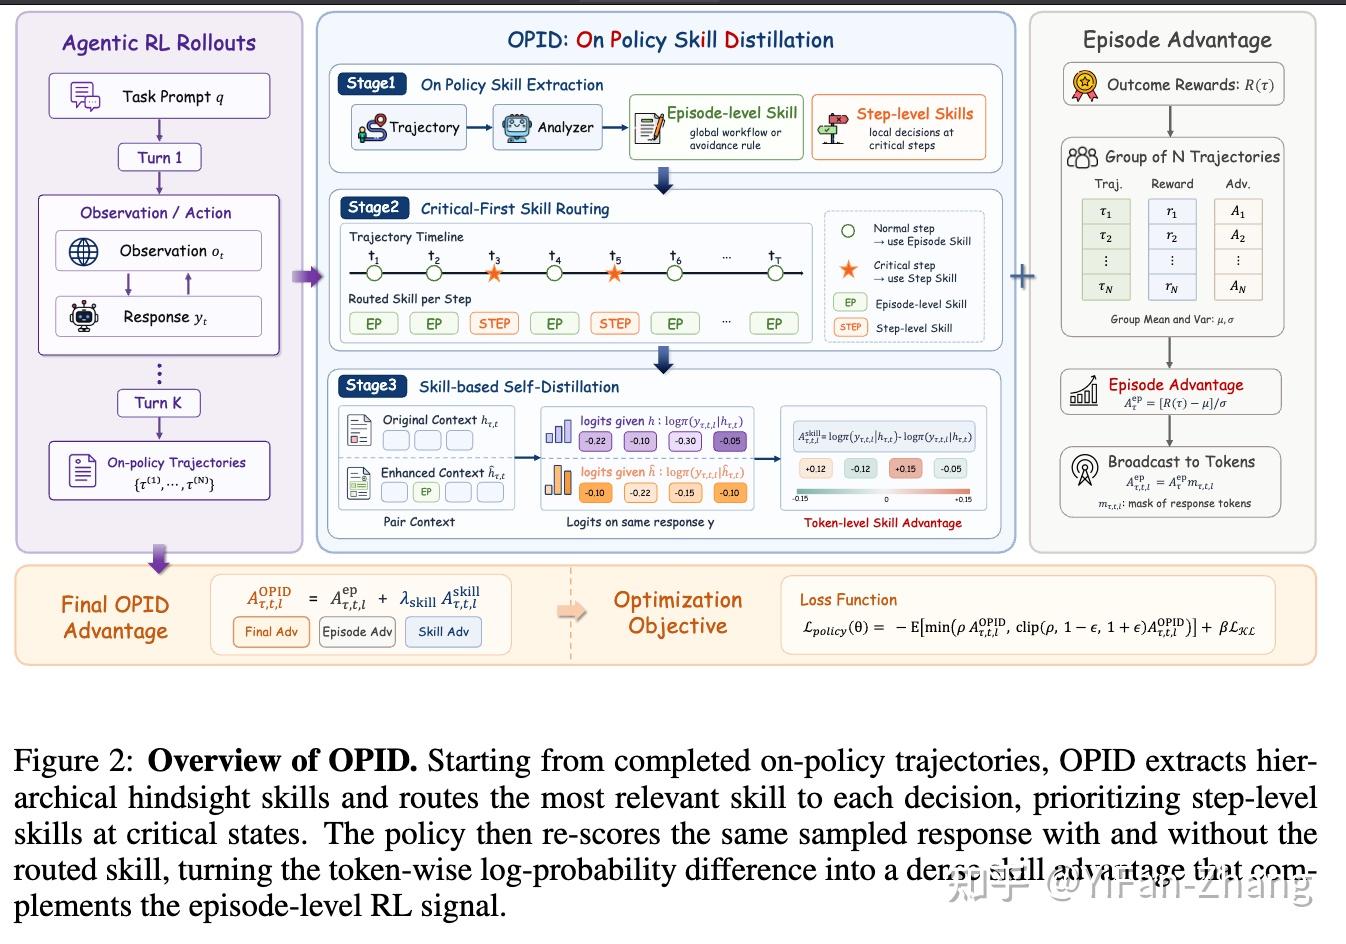
精选文章 技能不可靠,Agent 该信谁?中科院自动化所最新提出 UCOB:让大模型在交互中筛选、内化并演化技能 论文: UCOB: Learning to Utilize and Evolve Agentic Skills via Credit-Aware On-Policy Bidirectional Self-Distillation 链接: https://arxiv.org/abs/2606.2950
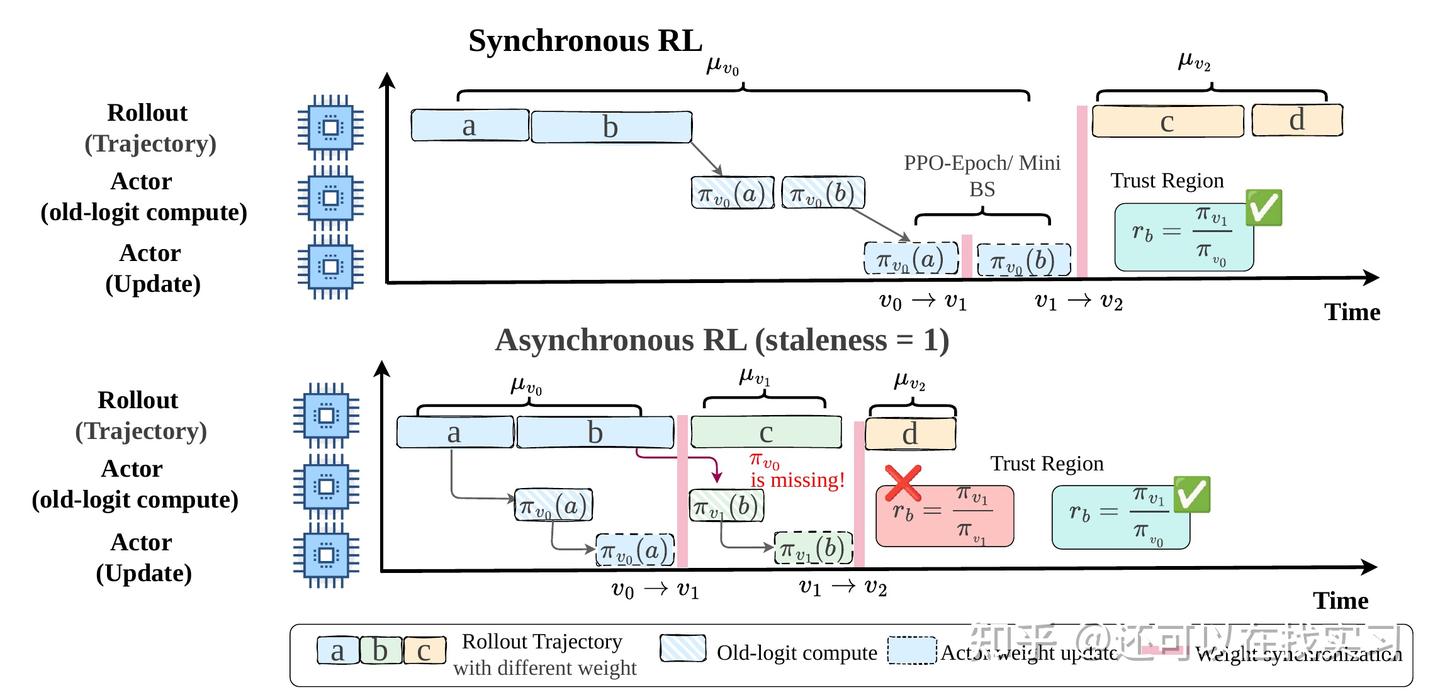
精选文章 当异步 Agentic RL 遇到“旧策略失忆”:重新理解 Off-Policy Correction 作者:还可以在找实习 https://zhuanlan.zhihu.com/p/2038002855374753895 欢迎关注我们关于异步 Agentic RL 的最新工作。本文聚焦一个在大规模 LLM 强化学习系统中非常基础、但经常被忽略的问题:当 rollout 和 training 异步解耦
精选文章 ICML 2026|让 Agent 真正协同作战:GoS 为多智能体推理构建共享信念状态 罗宇,南开大学博士生 近年来,大语言模型在数学、代码等任务上的表现不断刷新上限,但到了医疗诊断、故障排查这类真实世界任务里,真正困难的是让多个智能体在不确定的动态环境中持续协作推理。 以医疗诊断为例,主治医生不可能一开始就让病人把所有检查都做一遍,而是要根据当前诊断方向,动态安排影像科、检验科等不同
精选文章 从 GLM/Qwen 看: Agentic RL 最新进展 作者:YiFan-Zhang https://zhuanlan.zhihu.com/p/2054605815588435332 GLM 5.2: From Grpo to PPO 引入了 slime 这套训练与推理基础设施,同时在长链路任务里改用了更适合 compaction 的 PPO 训练方式,
精选文章 深入理解 Agentic RL 中的行为崩塌现象 作者:Jason 原文:https://zhuanlan.zhihu.com/p/2050794185909876253 过去一段时间里,我一直在思考一个问题:Agentic RL 到底和传统 RLVR 有什么本质区别? 最容易想到的答案当然是工具调用。传统 RLVR 往往围绕单轮回答展开,模型生成
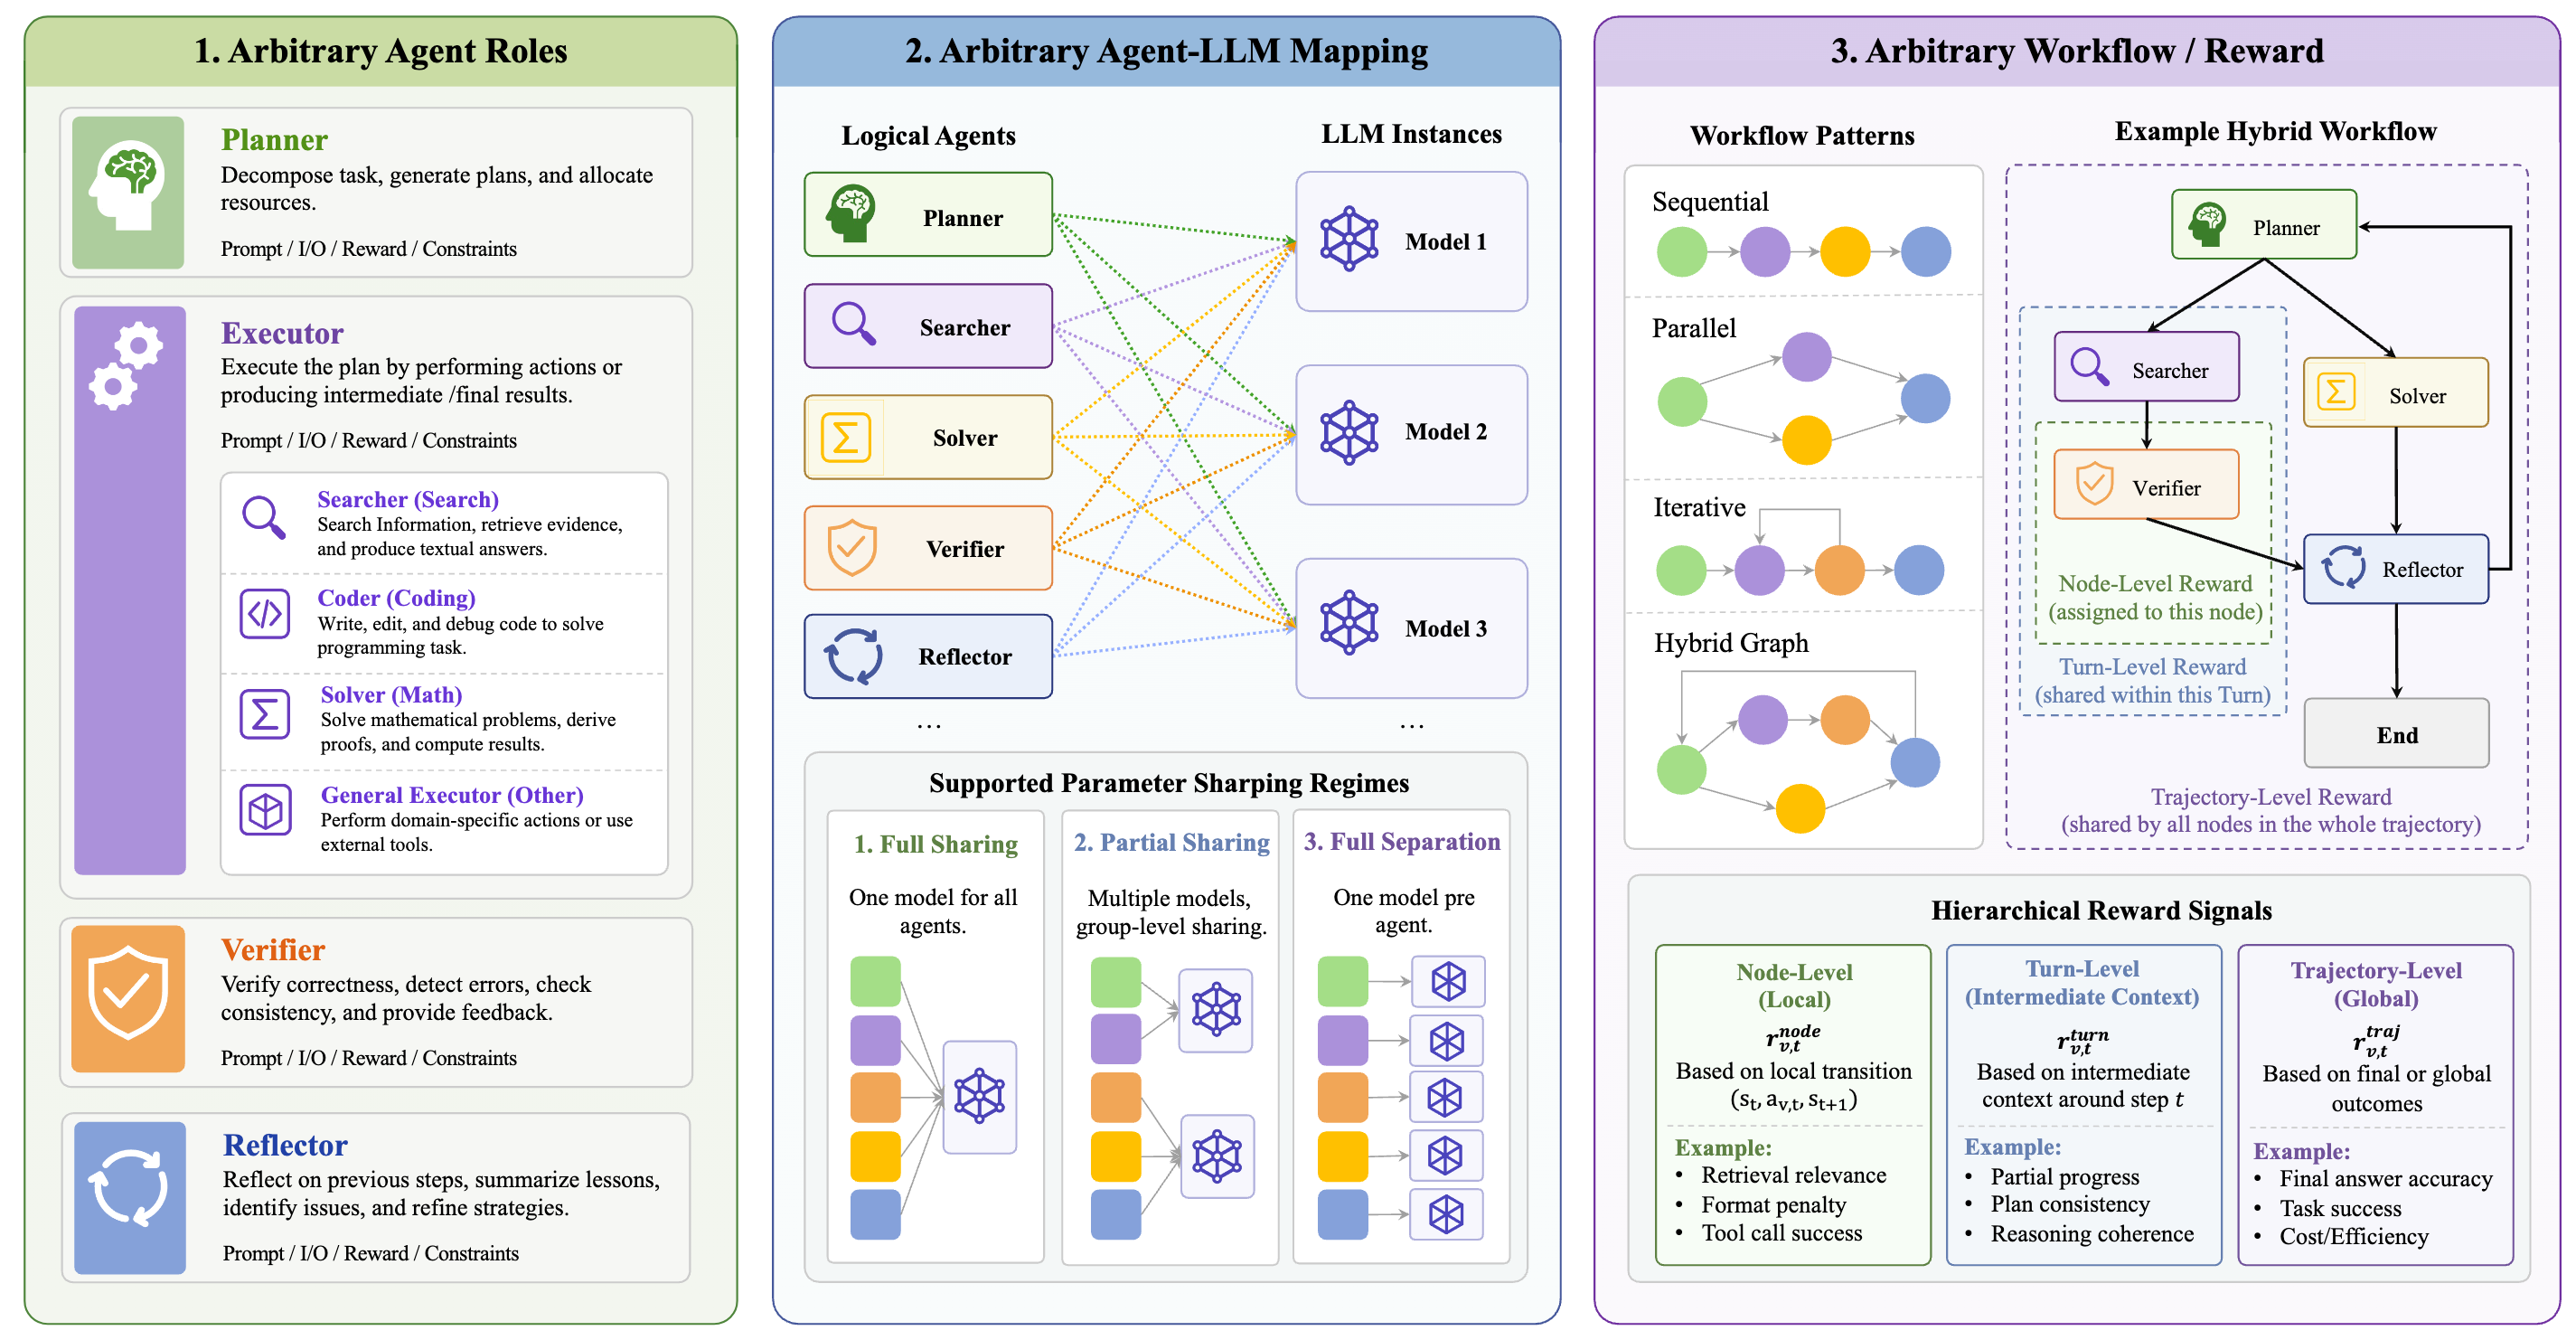
精选文章 当多智能体不再只是“搭流程”:UnityMAS-O 想把 LLM Multi-Agent 真正训练起来 论文标题: UnityMAS-O: A General RL Optimization Framework for LLM-Based Multi-Agent Systems 论文链接: https://arxiv.org/pdf/2605.26646 代码链接: https://github.co
精选文章 陈天奇团队最新开源 PithTrain:Agent 时代的 MoE 训练框架设计 作者:赖睿航,CMU CS Ph.D. https://zhuanlan.zhihu.com/p/2045509863221064141 TL;DR PithTrain 是一个精简、agent-native 的 MoE(Mixture-of-Experts)训练框架,整套实现约 1.1 万行 Pyt
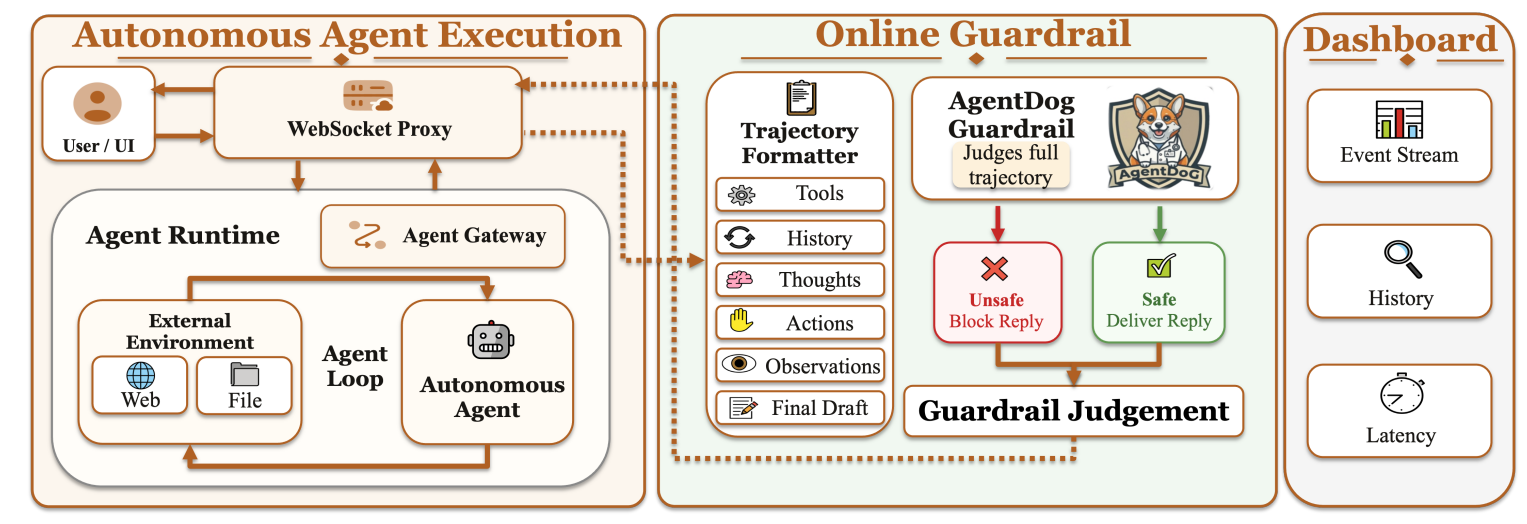
精选文章 上海 AI Lab 最新开源 AgentDoG 1.5:面向完整执行轨迹的轻量可扩展 Agent 安全框架 1.Technical Report: https://arxiv.org/abs/2605.29801 2.GitHub: https://github.com/AI45Lab/AgentDoG 3.Project Page: https://ai45lab.github.io/AgentDoG/
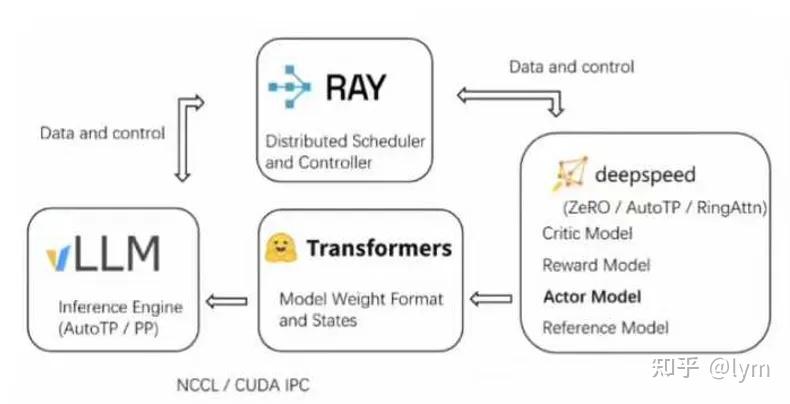
精选文章 slime v0.3.0 发布: 重新思考面向 Agent 时代的 RL 训练框架 作者:朱小霖 原文:https://zhuanlan.zhihu.com/p/2044533166694732929 毫无疑问,OpenClaw 和 Opus 一起撞开了 agent 时代。 slime 从一开始坚持的 server-based engine + custom rollout 设计,
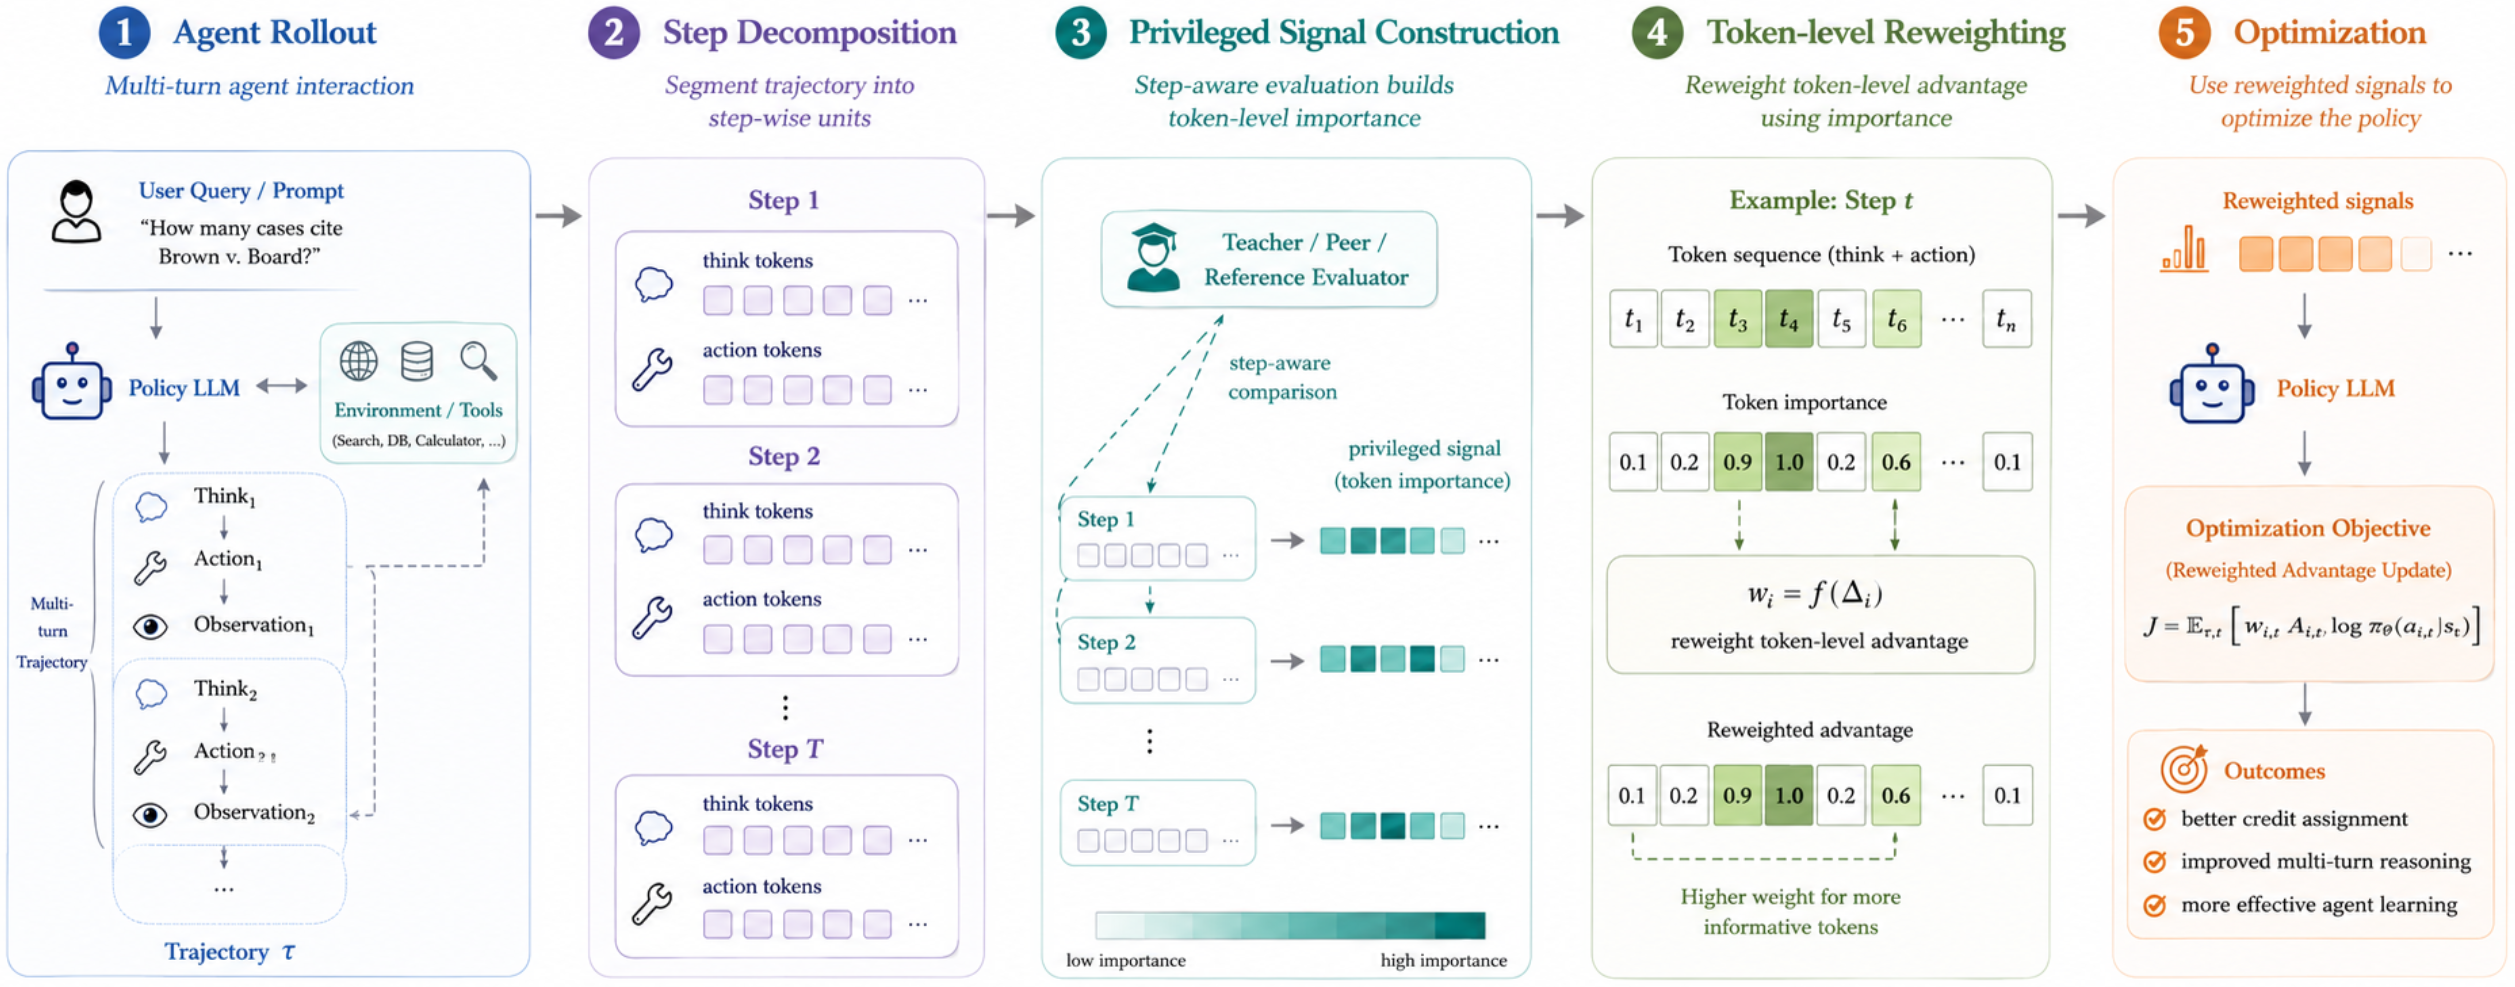
精选文章 给 Agent RL 加个“事后复盘”:StepOPSD 让模型精准找到“哪一步走错了”? 论文:StepOPSD: Step-Aware Online Preference Distillation for Agent Reinforcement Learning 链接:https://arxiv.org/html/2605.27140v1 作者:Yanfei Zhang, Xu Lin
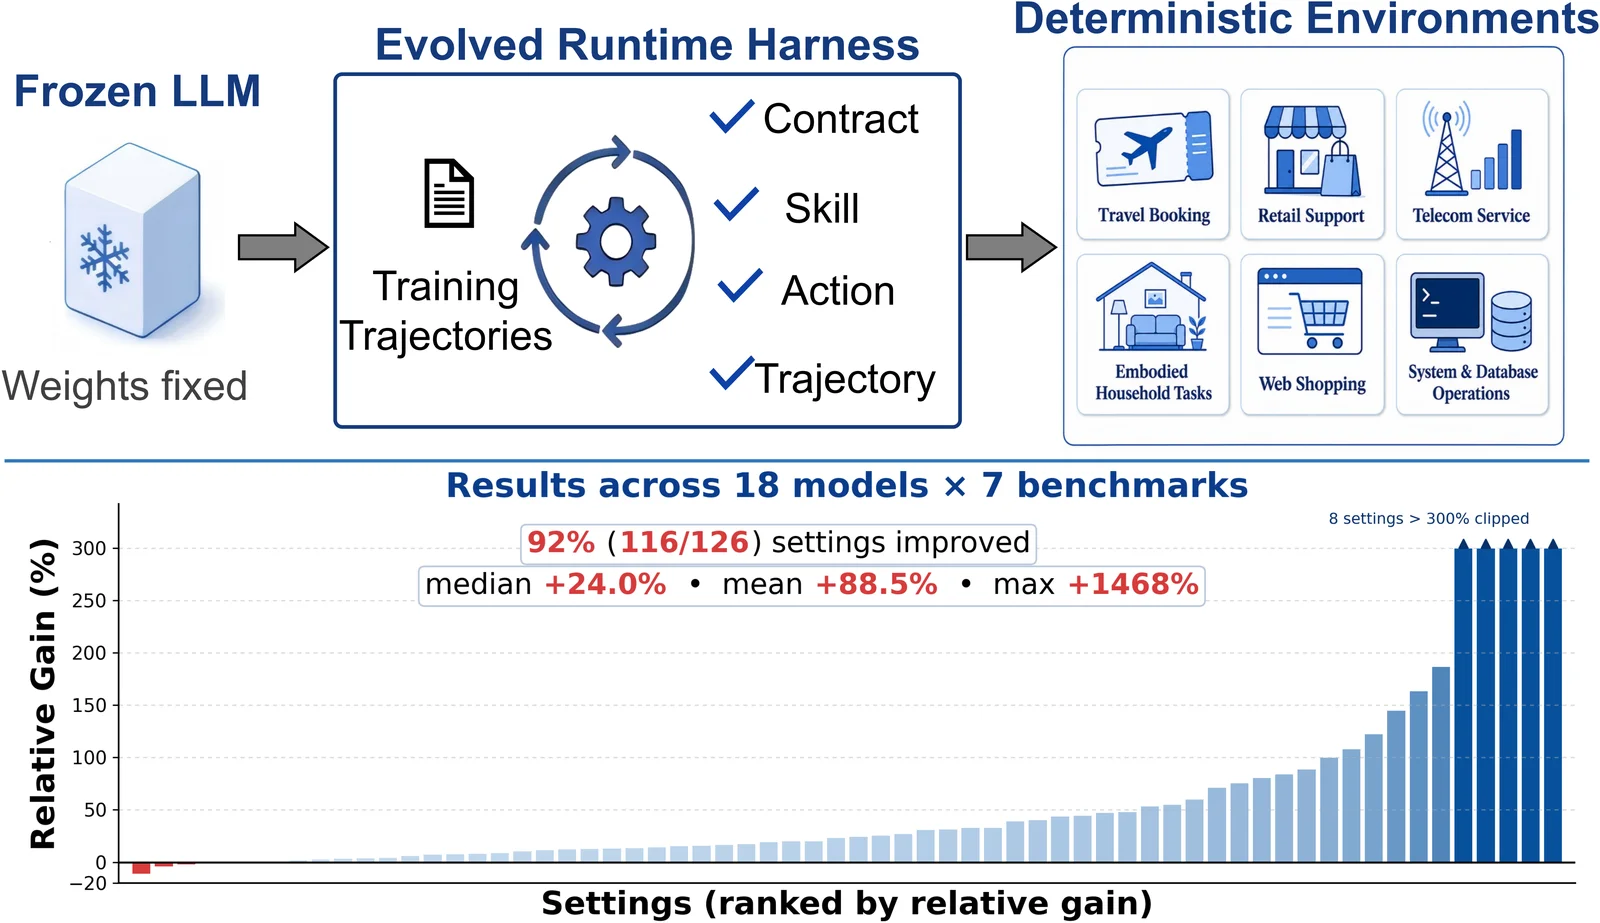
精选文章 不改模型,也能提升垂域 Agent?4 层 Harness 即可带来 88.5% 平均提升 大模型 Agent 这两年很火。 大家一提到“提升 Agent 能力”,第一反应通常是:换更强的模型、做微调、上强化学习、继续训练。 但我们最近一直在想一个问题: 如果 Agent 表现不好,问题真的一定出在模型本身吗? 很多时候,答案可能不是。 因为Agent并不是一个只会聊天的LLM。 它还要理
青稞Talk 从 ARPO,到 AEPO,再到 Agent-World:探索通用智能体训练的可行路径 6月6日上午10点,青稞Talk 129 期,青稞社区邀请到中国人民大学高瓴人工智能学院博士生董冠霆,来直播分享《从 ARPO,到 AEPO,再到 Agent-World:探索通用智能体训练的可行路径》。 本次分享将主要围绕三篇通用智能体强化学习论文展开,沿着"智能体强化学习 → 多环境强化学习"的
精选文章 Claude Code 源码深度解析:运行机制与 Memory 模块详解 本文档基于 Claude Code CLI 工具的源码进行深度分析,旨在用清晰易懂但专业的语言,详细讲解其内部运行机制。特别关注 Memory(记忆)模块的设计与实现。 1. 项目总览:Claude Code 是什么 Claude Code 是 Anthropic 官方开发的命令行 AI 编程助手(
精选文章 大模型的下半场是什么?林俊旸:从 Reasoning Thinking 到 Agentic Thinking 林俊旸在x上发了一篇长文,特此分享 https://x.com/JustinLin610/status/2037116325210829168 过去这两年,彻底颠覆了我们评估和期待大模型的方式。 OpenAI 的 o1 告诉我们:思考本身就能成为模型一种核心的一等能力,你可以专门为了思考去训练模型,
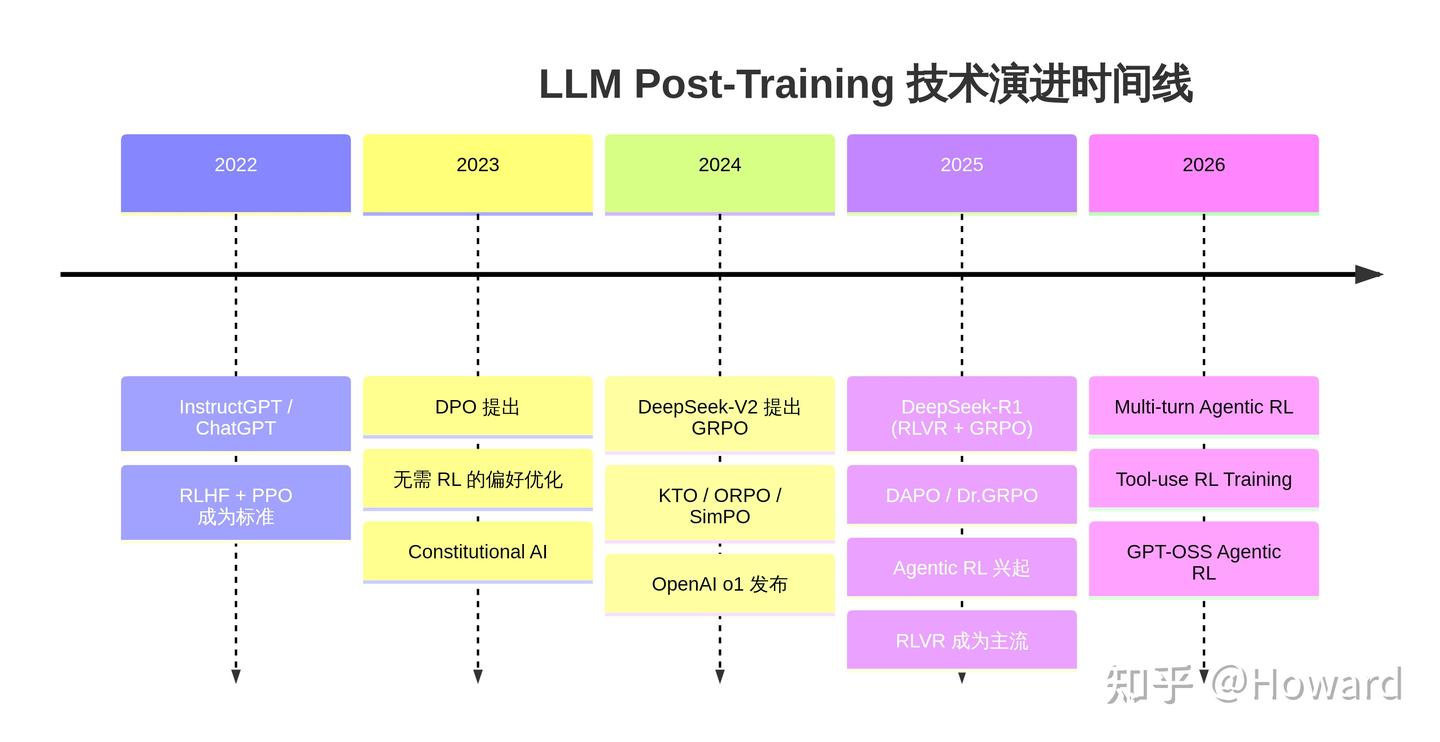
精选文章 LLM Post-Training 全景指南:从 RLHF 到 GRPO 再到 Agentic RL 作者:Haohe,Meta FAIR 研究科学家 https://zhuanlan.zhihu.com/p/2012909606771400823 1. 引言:什么是 Post-Training? 大语言模型(LLM)的训练通常分为两个大阶段:预训练(Pre-training) 和 后训练(Post
青稞Talk 面向对象的 Agent Infra 新范式:有状态运行时管理的设计与工程实践 当前主流的 LLM Agent 框架普遍采用 Text-in-Text-out 的交互范式——无论输入还是输出,所有数据都必须经过文本序列化。 这使得 Agent 难以直接操作复杂的外部对象(如 DataFrame、数据库连接、训练好的模型),其产出也无法被下游系统(数据可视化、Agentic UI
精选文章 当记忆从“历史”变成“经验”!UIUC、清华、微软研究院最新提出 PlugMem,让 Agent 告别流水账式记忆 当AI Agent开始从“工具调用者”走向“长期协同者”,记忆便成了决定其天花板的关键。然而,现有的记忆方案正面临一个尴尬的悖论:Agent 往往拥有一本厚厚的“交互日记”,却缺乏一套真正的“知识储备”。 近日,由UIUC、清华与微软研究院 联合提出的PlugMem引起了广泛关注。作为一个任务无关的
精选文章 从Text-in-Text-out到Object-in-Object-out:LLM Agent工具调用的范式转变 CaveAgent:一个面向工程落地的有状态Agent运行时框架 论文地址:https://arxiv.org/abs/2601.01569 项目地址:https://github.com/acodercat/cave-agent 安装:pip install 'cave-agent[all]' 这
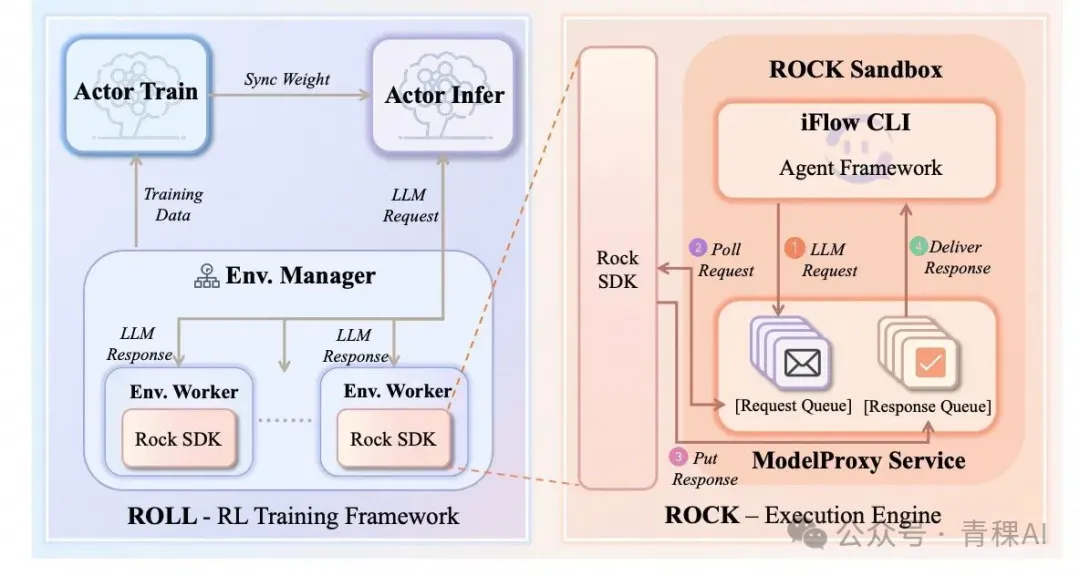
精选文章 从 ROLL、ForgeRL、Seer 和 ThunderAgent,看 26 年 Agentic RL Infra 优化方向 作者:attack204 https://zhuanlan.zhihu.com/p/2007250216227729670 调研了一些目前Agentic-RL场景下对Infra的一些需求,主要内容都来自于各家大厂的文章 值得一提的是除了最后一篇Seer的文章外,其他3篇都是春节期间发布的,LLM还是
精选文章 ICLR 2026!腾讯混元联合 KCL 提出 WildToolBench,评估 Agent 对用户狂野行为的适应能力 TLDR. Agent是强大的,但用户是狂野的 😦又是一个工具使用Benchmark?不是说模型厂商追逐榜单严重,忽略用户实际体验? 确实,但我们面对这个质疑提出了WildToolBench:当我们衡量模型的工具调用能力时,不能仅仅看在完美的提问下,完美的实验环境下,LLM能否操纵工具回答正确,因
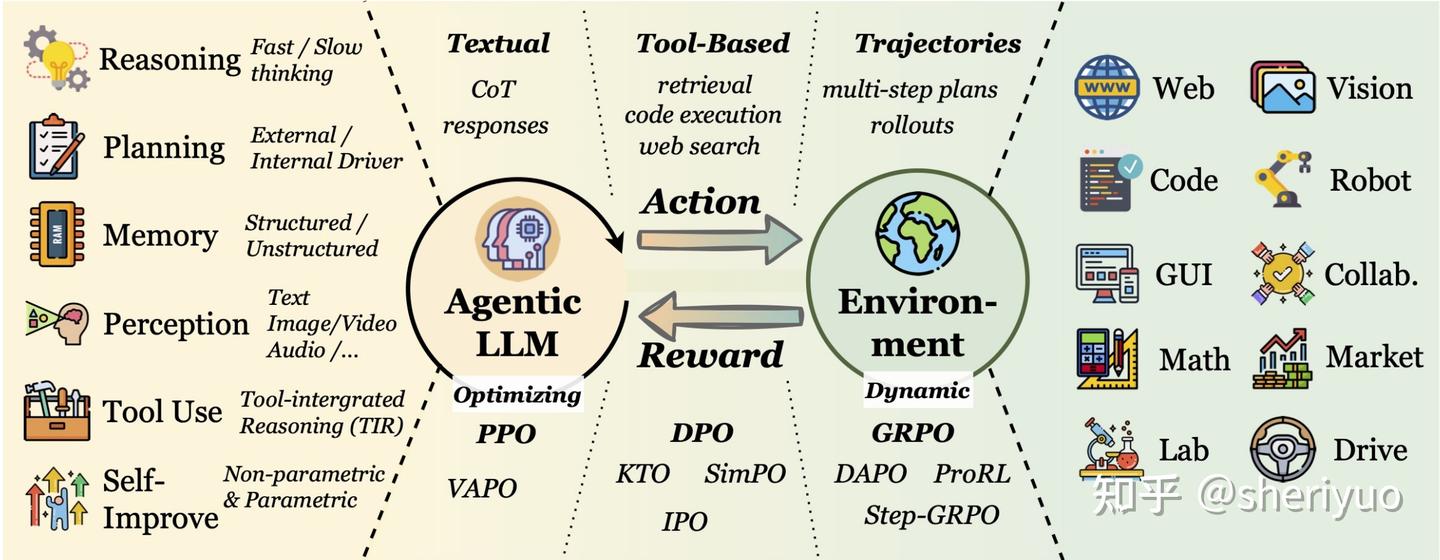
精选文章 Agentic RL:解耦 Reasoning 与 Tool-use 作者:sheriyuo https://zhuanlan.zhihu.com/p/2009946011120971848 近年来,随着 Agentic RL 的兴起,LLM 逐渐从“单次问答器”转变为能够在推理(Reasoning)与外部工具调用(Tool-use)之间反复交互(multi-turn
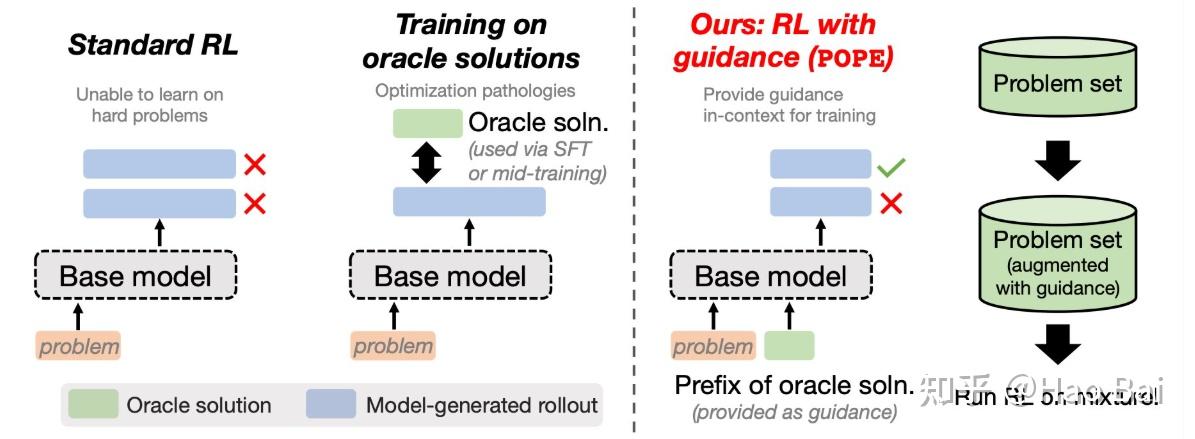
精选文章 聊聊 Agentic RL 热门话题:Off-policyness,Sample Efficiency与Priviledge Information 作者:Hao Bai https://zhuanlan.zhihu.com/p/2006963575110013959 今天来聊一下RL的近期热门问题,涉及Off-policyness,Sample Efficiency与Priviledge Information这些话题,可以理解为SFT+RL的
青稞Talk BOAD:引入多臂老虎机,自动化搜索层级结构的多 Agent 架构设计 大型语言模型(LLM)展现出强大的推理与编程能力,但在真实世界的软件工程(SWE)任务上仍难以泛化。这类问题往往涉及长时序决策,并且具有明显的 Out of Distribution问题。 现有系统通常依赖单一智能体处理 SWE 任务。它需要在一条推理链中同时进行需求理解、浏览大型代码库以及实现修复
精选文章 通往 AGI 的必经之路:Agent 自进化到底是在“进化”什么? 本文为 AI AMA 栏目第一期 Agent自进化 主题全观点转录。 青稞 AMA(AI AMA)是由魔搭社区、青稞社区、机智流与知乎联合发起的 AI 前沿技术圆桌对话栏目。围绕真正值得讨论的AI技术方向,以「多元视角」邀请一线实践者同框深度对谈:拆解原理、还原细节、碰撞观点,直面工程落地的真实挑战
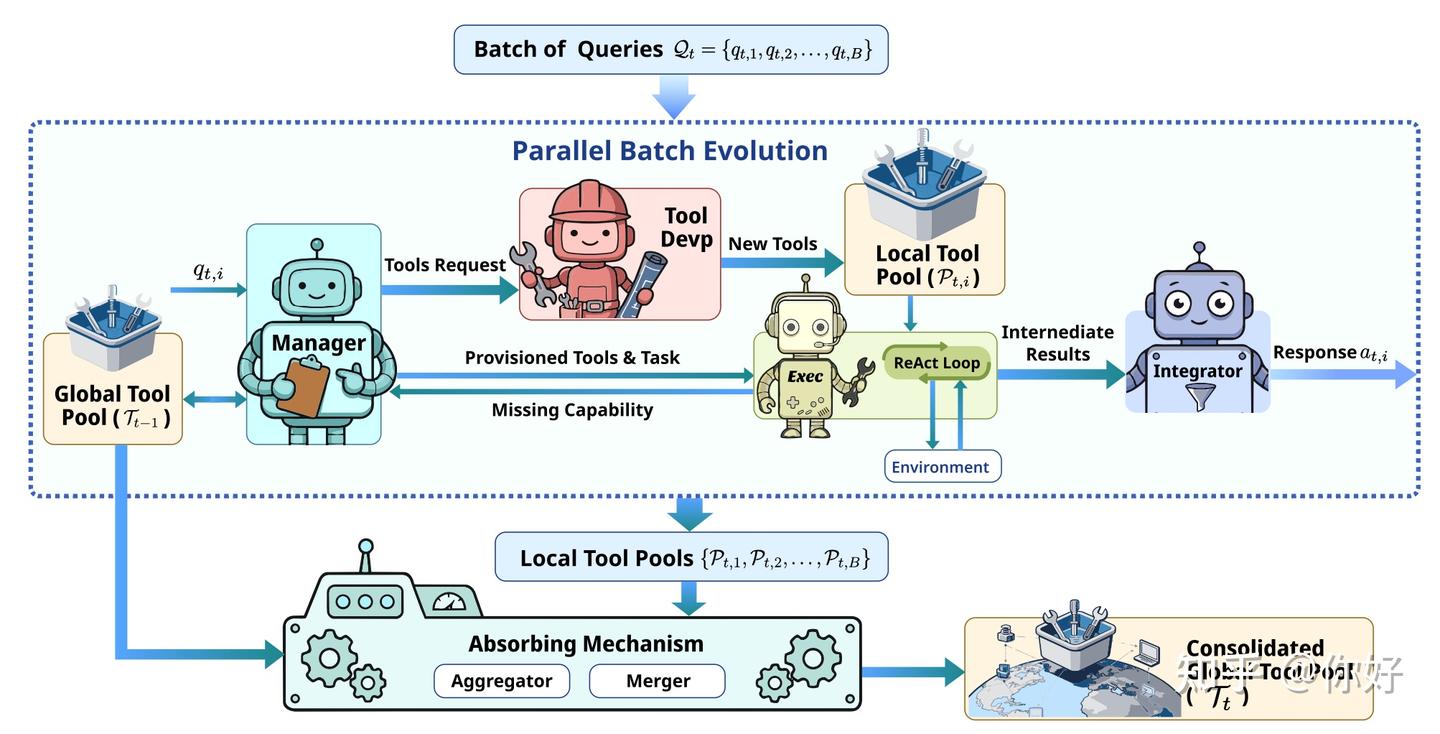
精选文章 从零开始构建自进化智能体的心路历程 TL;DR 我们提出了 Yunjue Agent,一个面向开放域任务的原地自进化智能体系统。与当前主流的”在新环境生成数据再训练”范式不同,我们认为真正的自进化应该是 In-Situ(原位自进化)——在推理过程中持续积累工具能力,无需外部监督。 在HLE,DeepSearchQA等五个 benchm
青稞AMA Agent如何“在经验中成长”:关于自进化的关键问题与技术路径对谈 回顾刚过去的2025年,AI领域最引人注目的范式转移正在悄然发生。 如果说大语言模型的"顿悟时刻"是让机器学会了思考,那么Agent自进化的"镜像时刻",则让AI第一次拥有了"从经验中成长"的能力。 它不再是静态的工具,而是一个能够与环境持续交互、从失败中学习、在任务中迭代策略的数字生命体。 这不是
精选文章 小米大模型 Plus 团队提出BTL-UI:基于直觉-思考-关联的GUI Agent推理 本文作者来自小米大模型 Plus 团队,共同一作为张少杰、张若嶒、付培,通讯作者为多模态感知方向负责人罗振波。 在打造智能数字助手的过程中,让智能体像人类一样自然地理解并操作图形界面是一项核心难题。尽管多模态大模型与强化学习微调推动了智能体的进步,但其交互逻辑与真实的人机交互仍存在明显差距。 为缩小
精选文章 纯干货!工业场景下,LLM Agent RL的一些实践感悟 最近几个月在各种场景上做了大量的agent RL训练,例如search agent, 数据分析agent 等等。既有小的dense model,也有大的moe。有单一数据场景,有多源合板数据场景。有失败的经历,也有成功的经历。这里抽空分享下一些感悟,比较乱,随便看看就行: 1、稳定性是工业级场景下R
青稞Talk OpenCUA:用于构建 Computer-Use Agent 的开源框架 来帮社区的同学“还愿”了!!! OpenCUA 是港大联合月之暗面提出的一个全面的开源框架,旨在扩展CUA的数据和基础模型,使用户可以高效、低门槛开发自主操作电脑的Agent。 论文:OpenCUA: Open Foundations for Computer-Use Agents 链接:https
青稞Talk MemGen:生成式隐式记忆,Agent Memory 的第三种可能 更多解读请阅读:最新成果!Agent记忆的第三种可能:生成式隐式记忆 10月16日(周四)晚8点,青稞Talk 第81期,新加坡国立大学博士生张桂彬,将直播分享最新成果《MemGen:生成式隐式记忆,Agent Memory 的第三种可能》。 分享嘉宾 张桂彬是新加坡国立大学计算学院博士研究生,导师
青稞Talk “知人者智”:以用户为中心的智能体交互与训练 10月18日(周六)上午10点,青稞Talk 第79期,伊利诺伊大学香槟分校 (UIUC) 博士生钱成,将直播分享《“知人者智”:以用户为中心的智能体交互与训练》。 分享嘉宾 钱成,伊利诺伊大学香槟分校 (UIUC) 二年级博士生,导师为季姮教授。本科就读于清华大学计算机系,导师为刘知远教授。目前工
青稞Talk Theory of Agent: From Definition, to Behavior and Objective 9月9日(周二)晚8点,青稞Talk 第77期,香港中文大学王鸿儒博士,将直播分享《Theory of Agent: From Definition, to Behavior and Objective》。 分享嘉宾 王鸿儒博士于香港中文大学获得博士学位,导师为黄锦辉教授(ACL Fellow),研
青稞Talk Evaluation Agent:面向视觉生成模型的高效可提示的评估框架 8月9日(周六)上午10点,青稞Talk 第70期,南洋理工大学MMLab博士生田淑琳,将直播分享 ACL 2025 Oral 成果《Evaluation Agent:面向视觉生成模型的高效可提示的评估框架》。 论文:Evaluation Agent: Efficient and Promptabl
青稞Talk GUI-Reflection:让多模态 GUI 智能体获得反思纠错能力的训练框架 GUI-Reflection,是一个开源的,让端到端多模态GUI模型学会自我反思和纠错的自动化框架。GUI-Reflection在智能体的各个训练阶段引入 “反思与纠错”机制,这一机制贯穿预训练、监督微调和在线训练全过程,模拟了人类“犯错→反思→重试”的认知过程,使模型在面对真实环境中的不确定性时,
青稞Talk InferCept、Preble&Cognify:面向下一代 AI Agent 工作流系统的构建 主讲嘉宾 张怡颖,现任加州大学圣地亚哥分校计算机科学与工程系副教授。她的研究领域涵盖人工智能系统与数据中心云计算系统,当前主要致力于构建下一代的AI Agent系统。她曾获得OSDI最佳论文奖、SYSTOR最佳论文奖、美国国家科学基金会CAREER奖,以及来自谷歌、Meta、亚马逊、英特尔、VMwa
青稞Talk PC-Agent:面向复杂 PL 任务的多模态智能体框架 3月15日上午11点,青稞Talk 第41期,阿里通义实验室高级算法工程师张熙,将直播分享《PC-Agent:面向复杂 PL 任务的多模态智能体框架》。 分享嘉宾 张熙,博士毕业于中科院自动化研究所,目前担任阿里通义实验室高级算法工程师,负责多模态智能体Mobile-Agent等工作。在国际顶级期刊
青稞Talk OminiParser:基于纯视觉的 GUI Agent 11月30日上午11点,微软研究院 AI Frontiers 实验室高级研究员鲁亚东,将直播分享《OminiParser:基于纯视觉的 GUI Agent》。 主讲嘉宾 鲁亚东,微软研究院 AI Frontiers 实验室高级研究员。研究兴趣主要集中在大型视觉语言模型上,专注于构建能够在图形用户界面
青稞Talk 使用CAMEL Agents构建GraphRAG及应用实践 9月26日19点,青稞Talk 第24期,Eigent AI Founding Engineer、CAMEL AI开源多智能体框架核心贡献者范文栋,将直播分享《使用 CAMEL Agents 构建 GraphRAG 及应用实践》 主讲嘉宾 范文栋,Eigent AI Founding Enginee
青稞Talk Mobile-Agent:基于多模态Agent架构的手机智能体 7月11日晚7点,青稞Talk第14期,阿里通义实验室高级算法专家徐海洋,将直播分享《Mobile-Agent:基于多模态Agent架构的手机智能体》。 分享嘉宾 徐海洋,阿里通义实验室高级算法专家,负责通义多模态大模型mPLUG系列工作,包括基础多模态模型mPLUG/mPLUG-2,多模态对话大模
青稞Talk ChatDev:大语言模型驱动的多智能体协作与演化 4月15日晚7点,青稞社区组织【青稞Talk】第二期,并邀请到 ChatDev 一作、清华大学自然语言处理实验室(THUNLP)博士后钱忱参与,分享《ChatDev:大语言模型驱动的多智能体协作与演化》。本次 Talk 会基于 ChatDev 的关键思路,围绕大语言模型智能体的构建、协同、进化等方面