青稞Talk 直播预告!GroundingPI & GroundAnything:从精准定位到高速感知,具身基模该怎么进化 先说个场景。 你让机器人去桌上拿那个蓝色杯子,它答得挺快:好,蓝色杯子。 然后手伸过去,抓了个空。 不是它不认识。它认识,甚至能告诉你杯子里有没有水。但它指不准——杯柄在左边还是右边,杯口离桌沿还有几厘米。就差这么一点,手就空了。 第一反应往往是“手”的问题:控制不够精细、动作不够稳。但把这两篇论文
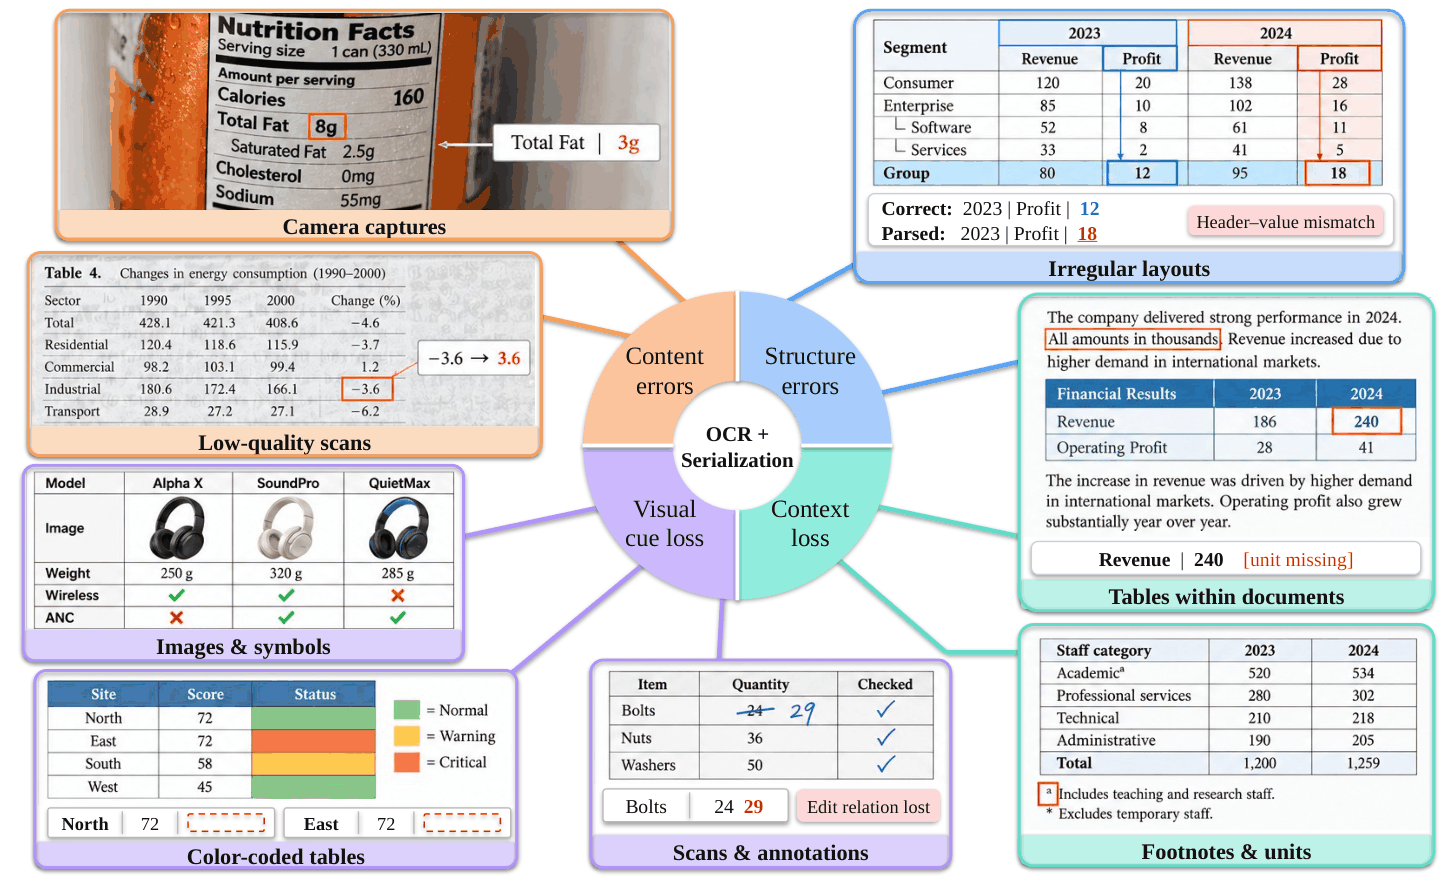
精选文章 表格转成文本,丢掉了什么?人大联合贝壳提出 MERIT,让 8B 模型从原图中找证据、做推理 一张表格,经过 OCR 和结构解析,变成了整齐的 Markdown。数字看起来齐全,语法也没有问题,但模型仍可能算出一个错误答案:它用到的数字,属于另一组表头;问题限定的高亮单元格,在转换后已经失去了颜色;决定数值含义的单位和脚注,也可能没有进入输入。 当证据在转成文本的过程中发生了变化,后续推理再
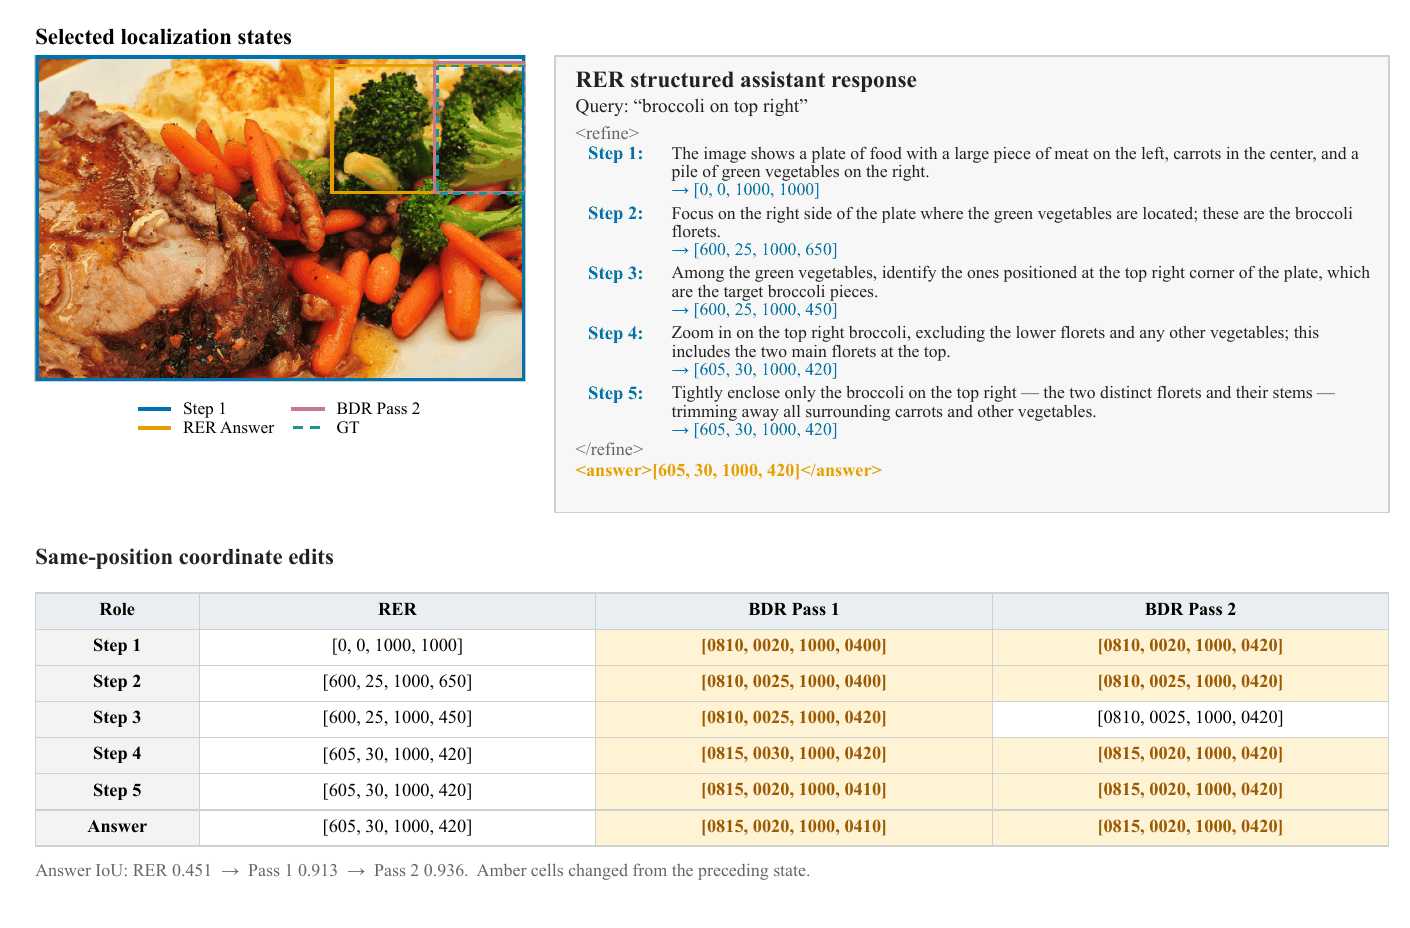
精选文章 大模型画框总翻车?给 9B 视觉模型装上“进度条”与“撤回键” 详细的语言描述,并不等于准确的视觉定位。 让模型框出“餐盘右上角的西兰花”,它可能完整描述了食物类别和相对位置,却仍把相邻的一簇圈进目标框。视觉指代定位要求将语言理解落实到具体区域与精确边界;流畅的解释本身,并不能保证中间空间判断可检查、最终坐标可纠正。 这一落差也要求重新审视后训练的终点。对于已经
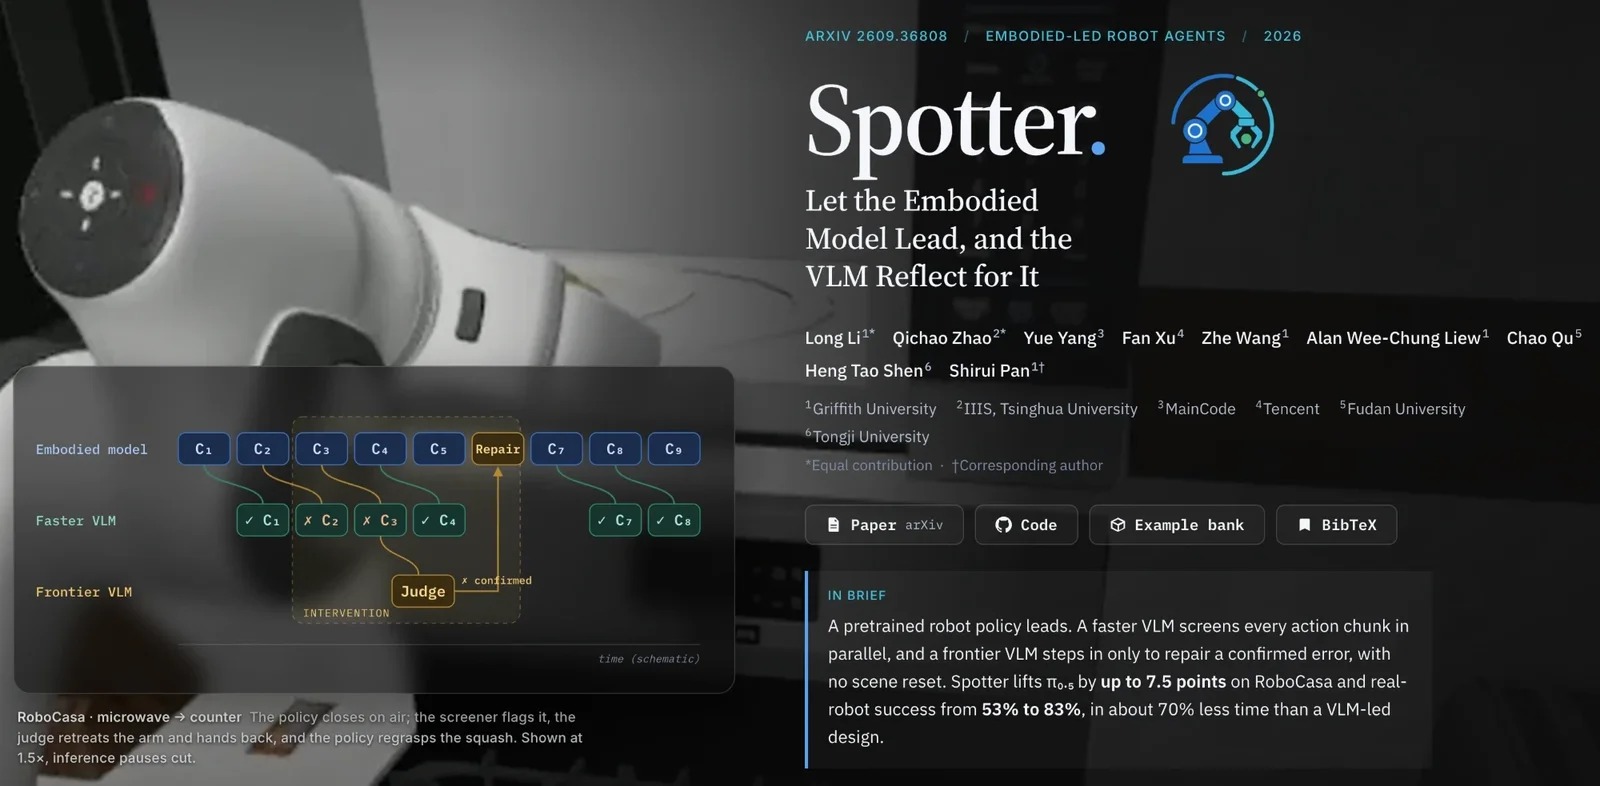
精选文章 本地千问就能跑!具身 Agent 只纠错就够了:Spotter 用并行结构让 VLM 只在出错时出手,又快又准 简介 具身模型(VLA)失手后很难自己改错,而让 VLM 每一步都当指挥又太慢。Spotter 反过来:具身模型一直执行,本地 Qwen 并行盯着,确认出错时才由 VLM 出手修复并反思,修完交还控制。同样步数下成功率更高,成功的回合只多十几秒,本地一个千问就能跑。 论文:Spotter: Let
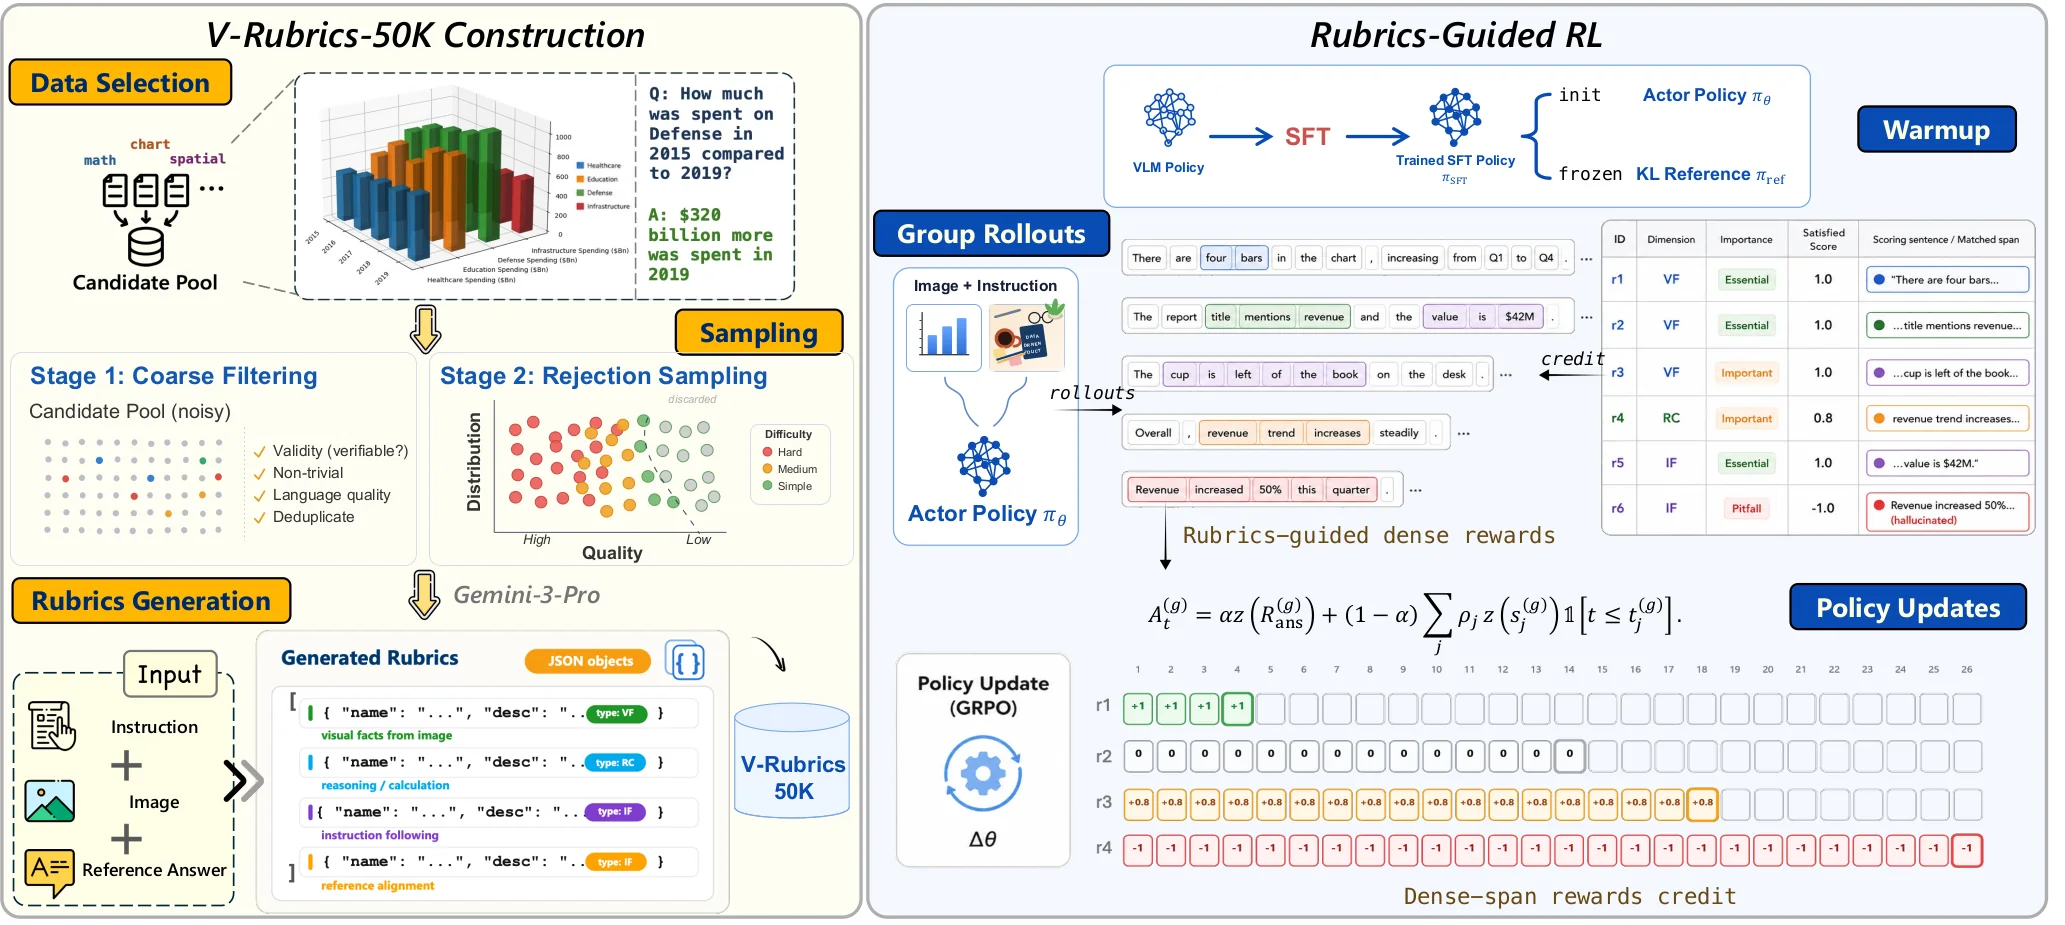
青稞Talk 直播预告!基于细粒度准则的多模态强化学习奖励,如何让模型的推理更忠于视觉证据? 视觉语言模型能生成流畅的回答,却可能看错图表数值,或在推理中引入图像无法支持的结论。 来自南洋理工大学 S-Lab、A*STAR 和 UIUC 的研究团队提出了 V-Rubrics,用逐项评分(rubrics)来处理“信用分配”(credit assignment)问题。 论文:V-Rubrics:
青稞Talk 直播预告!聊聊 DPA & LLaVA-HUD v4:多模态大模型的深度预对齐与高效视觉编码优化 6月30日(周二)晚8点,青稞Talk 第134期,清华大学人工智能学院博士生方科晨,将直播分享《DPA & LLaVA-HUD v4:多模态大模型的深度预对齐与高效视觉编码优化》。 DPA 提出一种新的视觉语言模型架构:在视觉特征进入目标 LLM 前,引入小型 perceiver VLM 进行深度
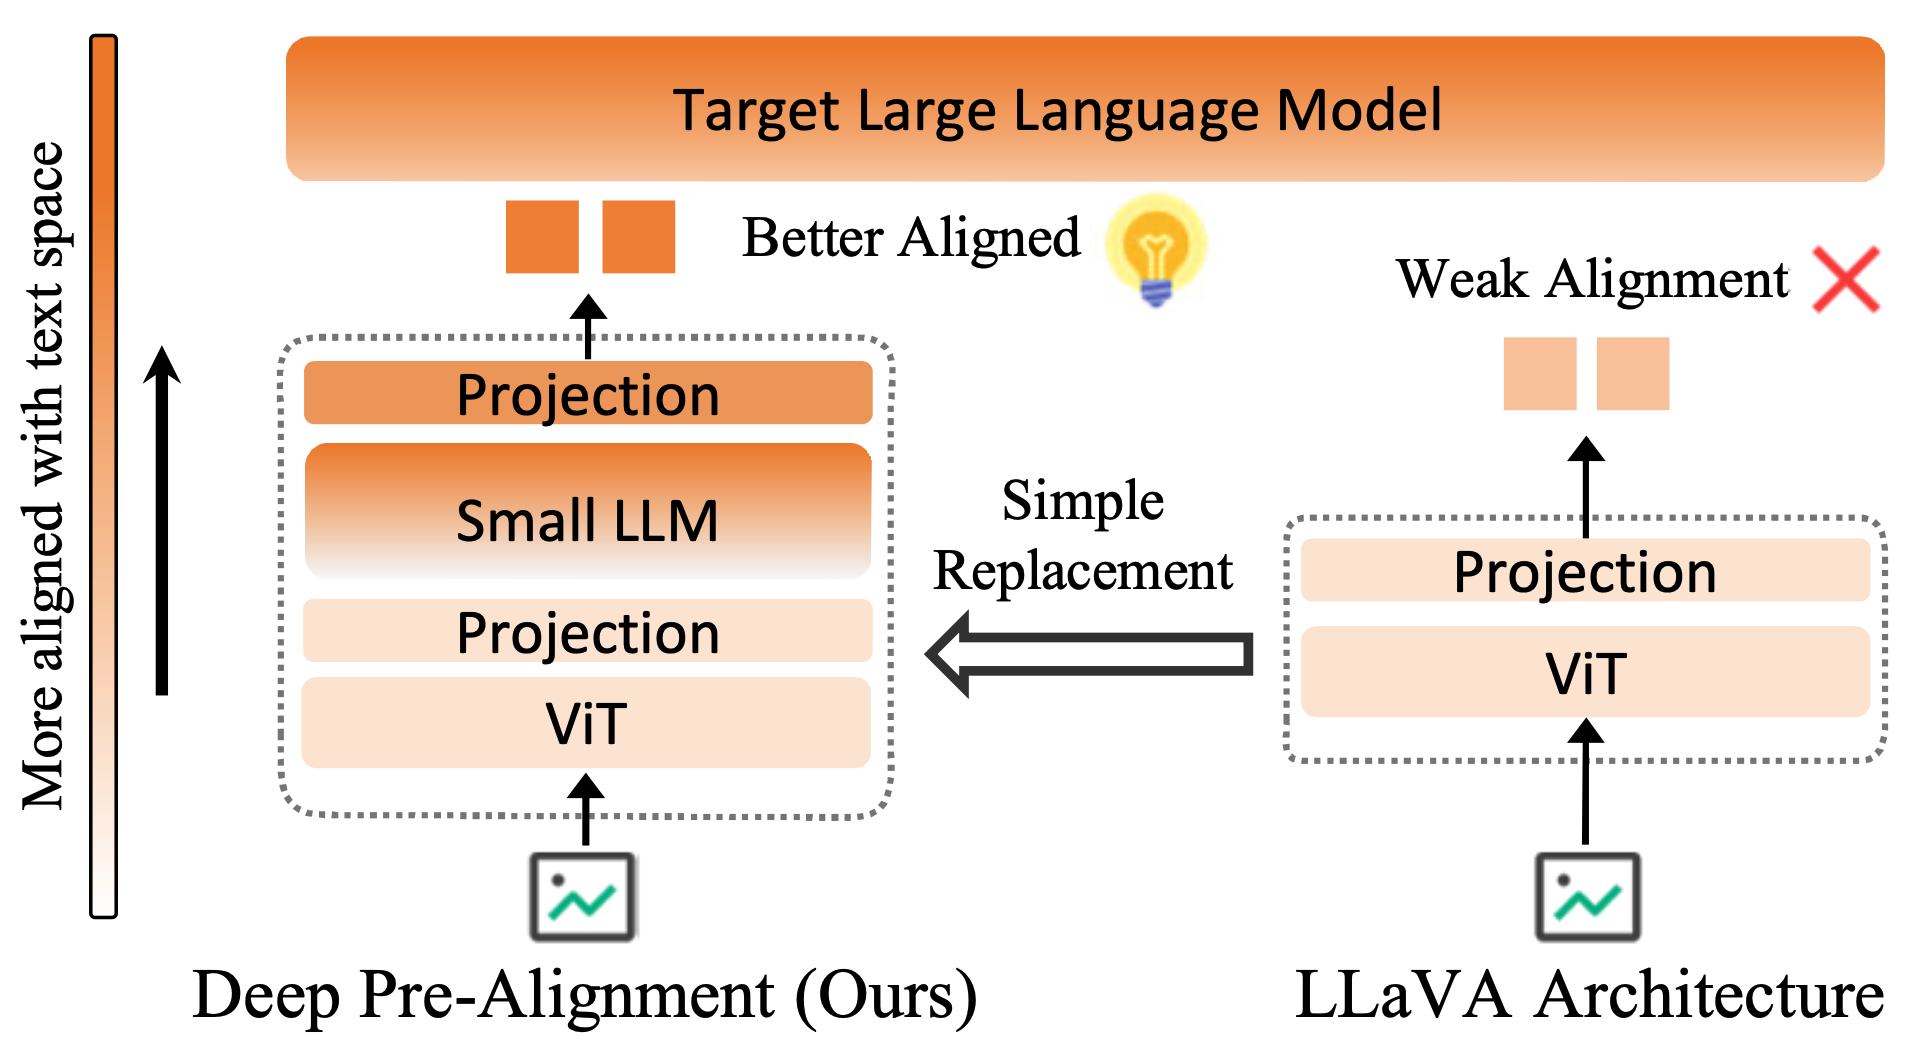
精选文章 清华最新提出全新 VLM 架构 DPA:让多模态大模型先“对齐”,再“理解”! 近年来,视觉语言模型(Vision-Language Models, VLMs)已经成为多模态理解与推理任务中的主流范式。当前大多数 VLM 采用 “视觉编码器(通常为 Vision Transformer, ViT)+轻量投影层(projector)+大语言模型(Large Language Mo
青稞Talk Puffin: 统一多模态空间智能大模型——从任意视角理解和生成世界 多模态空间智能不仅要求机器理解任意相机视角下的现实世界,更要求其具备从任意相机方位创造世界的能力。然而,当前的视觉与生成模型大多仅隐式地感知相机几何,或将理解与生成任务割裂开来。 新加坡南洋理工大学、商汤科技、密西根大学和马普所的研究者们联手提出了一种全新的范式——将“相机几何”破译为一种“语言”,
精选文章 原生多模态推理的涌现时刻?ThinkMorph 仅用 24K 数据开启 Scaling 新赛道 NUS、ZJU、UW、Stanford、CUHK联合提出「ThinkMorph」,主张让文字与图像在统一架构里「原生协作」、「共同演化」,而不是像当下大多数多模态模型那样,看完图像就闭上眼睛,后续完全靠文字链条推进。 仅用2.4万条数据微调7B统一模型,视觉推理平均提升34.74%,多项任务比肩甚至
青稞Talk SimpleVLA-RL:简单可拓展的VLA强化学习训练 VLA模型已成为使机器人在真实环境中解决各类复杂操作任务极具前景的新范式,其发展仍受限于数据稀缺与泛化能力不足等问题,而强化学习能缓解数据依赖并显著提升模型性能与泛化性,正受到广泛关注。 本次报告将解读所提出的专为VLA模型设计的高效强化学习框架SimpleVLA-RL,内容主要分为三部分: • 首
青稞Talk VILA^2 :视觉语言模型能力的自我提升 主讲嘉宾 方云浩,本科毕业于浙江大学,硕士毕业于UCSD(苏昊教授),自24年2月起在Nvidia VILA团队实习(陆垚博士、韩松教授)。主要科研方向是大模型相关的1. 推理能力(通过探索提升推理上限: Unleashing the Creative Mind;通过演绎验证获得可靠思维链: Ded
青稞Talk MiniCPM-V:端侧可用的GPT-4V级多模态大模型 7月15日晚7点,青稞Talk第15期,清华大学自然语言处理实验室博士生余天予,将直播分享《MiniCPM-V:端侧可用的 GPT-4V 级多模态大模型》。 分享嘉宾 余天予,清华大学自然语言处理实验室博士生,发表AAAI、CVPR 等人工智能顶会论文多篇,主要研究方向为多模态大模型。 主题提纲 M
青稞Talk 3D-VLA:构建生成式三维具身世界模型 5月10日晚7点,青稞社区组织【青稞Talk】第五期,邀请到 3D-VLA 一作甄昊宇参与,分享《3D-VLA:构建生成式三维具身世界模型》。 分享嘉宾 甄昊宇,上海交通大学大四,麻省理工学院访问学生,在ICML、NeurIPS、ICCV等会议上发表多篇论文。 主题提纲 3D-VLA:构建生成式三维
青稞Talk 从 3D LLM 到 MultiPLY ,3D 具身基础模型的构建 4月19日早9点,青稞社区组织【青稞Talk】第三期,邀请到 3D-LLM 和 MultiPLY 一作、加州大学洛杉矶分校在读博士洪逸宁参与,分享《从 3D LLM 到 MultiPLY ,3D 具身基础模型的构建》。 分享嘉宾 洪逸宁,加州大学洛杉矶分校在读博士,MIT-IBM沃森人工智能实验室研