青稞Talk 深度对话!2025 “青稞” AI 嘉年华,与 20+ 位青年科学家一起探讨AI 技术瞬间 本次活动专为青年科学家打造,旨在搭建一场 AI 技术的深度对话,来自学术和工业界的 20+ 青年科学家,将与大家一起回顾 2025,展望 2026!
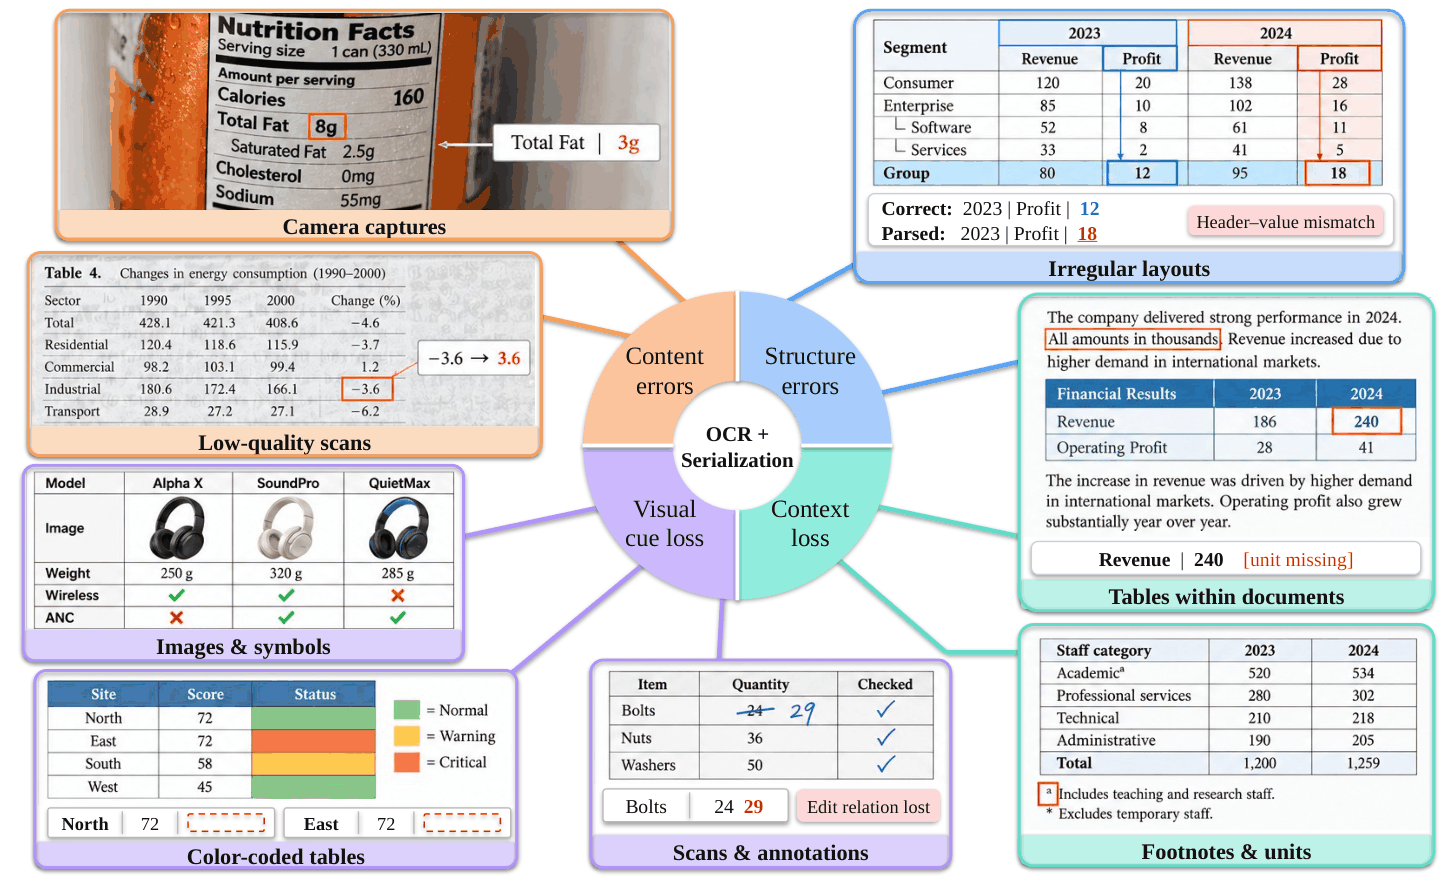
精选文章 表格转成文本,丢掉了什么?人大联合贝壳提出 MERIT,让 8B 模型从原图中找证据、做推理 一张表格,经过 OCR 和结构解析,变成了整齐的 Markdown。数字看起来齐全,语法也没有问题,但模型仍可能算出一个错误答案:它用到的数字,属于另一组表头;问题限定的高亮单元格,在转换后已经失去了颜色;决定数值含义的单位和脚注,也可能没有进入输入。 当证据在转成文本的过程中发生了变化,后续推理再
精选文章 大模型的下半场是什么?林俊旸:从 Reasoning Thinking 到 Agentic Thinking 林俊旸在x上发了一篇长文,特此分享 https://x.com/JustinLin610/status/2037116325210829168 过去这两年,彻底颠覆了我们评估和期待大模型的方式。 OpenAI 的 o1 告诉我们:思考本身就能成为模型一种核心的一等能力,你可以专门为了思考去训练模型,
青稞Talk 从 Depth Scaling 到 Width Scaling!WideSeek-R1:通过多智能体 RL 探索大模型的广度扩展(Width Scaling) DeepSeek-R1 的成功证明,深度扩展(Depth Scaling)在复杂逻辑推理中具有巨大潜力。但当任务从“深推理”转向“广信息”——如汇总全球头部科技公司多维财务数据——单一大模型往往受限于多轮检索带来的上下文干扰与串行效率瓶颈。 为此,我们提出“广度扩展”(Width Scaling)这
精选文章 原生多模态推理的涌现时刻?ThinkMorph 仅用 24K 数据开启 Scaling 新赛道 NUS、ZJU、UW、Stanford、CUHK联合提出「ThinkMorph」,主张让文字与图像在统一架构里「原生协作」、「共同演化」,而不是像当下大多数多模态模型那样,看完图像就闭上眼睛,后续完全靠文字链条推进。 仅用2.4万条数据微调7B统一模型,视觉推理平均提升34.74%,多项任务比肩甚至
精选文章 Thinking with Images为什么(不)work? 去年有次组会,师弟和我说在复现一些Thinking with Images工作的时候,发现interleaved images是错的/被丢掉了,模型的表现也不会受到影响。另外,有些模型在实际上没有执行工具的时候也会幻觉说执行了工具。考虑到我们之前发现llm4math里有答案正确过程不对的情况,vis
精选文章 入坑必备基础知识!关于推理模型的一些科普 作者:ybq https://zhuanlan.zhihu.com/p/1943048398333780944 这篇文章随便聊一下如今比较火的推理模型,给新入坑的同学做一些简单的科普,都是一些偏基础的知识。 推理模型的训练 推理模型的训练和普通模型的训练并无什么区别,仅仅是 sft 语料多了一些特殊
青稞Talk 统一 SFT & RL:迈向大型语言模型后训练的统一视角 10月28日(周二)晚8点,青稞Talk 第83期,清华大学博士生吕兴泰,将直播分享《统一 SFT & RL:迈向大型语言模型后训练的统一视角》。 分享嘉宾 吕兴泰,清华大学二年级博士生,导师为周伯文教授。研究方向为大语言模型架构优化、强化学习和高效训练技术。在ACL,EMNLP,NeurIPS,I
青稞Talk Satori-SWE:用 Evolutionary Test-Time Scaling 让小语言模型解决复杂软件工程 7月5日(周六)上午10:00,青稞Talk 第60期,新加坡科技设计大学博士生曾广韬,将直播分享《Satori-SWE:用 Evolutionary Test-Time Scaling 让小语言模型解决复杂软件工程》。 分享嘉宾 曾广韬,新加坡科技设计大学的四年级博士生,研究方向为 Large L
青稞Talk 大模型推理强化学习中的熵机制 往期解读:聊聊在大模型推理强化学习中熵机制上的探索 强化学习已经成为大模型智能跃升的下一个增长点,在这个背景下,本文旨在解决将强化学习用于大语言模型推理时面临的一个主要障碍——策略熵塌缩问题。 这种现象在大量未引入熵干预的强化学习训练中普遍出现,表现为策略熵在训练初期急剧下降,探索能力随之减弱,并始
青稞Talk 从 TTS 到 TTRL:无标签数据强化学习探索与展望 在预训练 Scaling Law之后,测试时扩展(Test-time Scaling, TTS)已成为提升大模型推理能力的关键。OpenAI o1与DeepSeek R1等模型通过强化学习(RL)进行推理的范式,充分展现了TTS的潜力。然而,推理模型的性能上限仍深受基础模型(其架构与预训练数据)的制
青稞Talk Satori:通过训练LLM做自回归搜索来增强推理能力 2月15日上午11点,青稞Talk 第38期,Satori第一作者、MIT博士生沈茂昊,将直播分享《Satori:通过训练LLM做自回归搜索来增强推理能力》。 主讲嘉宾 沈茂昊,MIT EECS系四年级博士生,长期和MIT-IBM Watson AI lab 合作,本科毕业于UIUC ECE系。研究