作者:Sherry
https://www.xiaohongshu.com/user/profile/642d87c90000000011020daf
World Model 这个概念其实已经提出很久了,我最近才第一次系统涉猎。虽然大家都在讨论 World Model,但真正试图解决的似乎并不是同一个问题。结合上一次分享的 Agentic RL 中的 Credit Assignment 问题,以及最近阅读的一些文献,我认为整条研究脉络可以拆成以下三个连续的问题:
- 信号如何进入训练? 是先学习 World Model 再进行任务 RL,还是与 Policy Model 一起更新?World Model 的预测信号应该进入 reward/advantage,还是作为独立的 auxiliary loss?
- World Model 要保留什么? 是要求预测状态在文本层面接近真实状态,还是要求预测能够让后续决策产生相同的 action contribution?
- 预测未来之后,怎样形成 Credit? 是仅生成更多 imagined rollouts,还是进一步估计 Q/value,从而回答“采取这一步,比同一历史下的替代动作好多少”?
一、传统 RL 与 Agentic RL
在传统 RL 中,棋盘状态或机器人位置就是 state,动作也相对紧凑。World Model 在这里很像一个可以反复调用的模拟器,即:执行这一步后,棋盘会怎样变化?
但在 Agentic RL 中,我们通常将问题建模为 POMDP。Agent 真正依据的是一段历史,例如用户要求、网页内容和 Memory 等;它采取的动作也可能是一段 prompt、一次 API 调用,甚至是在 multi-agent 场景下将子任务交给另一个 Agent。两个页面的文本可能很相似,却代表完全不同的任务进度;两段输出文字也可能不同,但在决策意义上等价。

图 1:传统 RL 与 Agentic RL 中的 World Model 对比
所以,根据上图,大概可以将 World Model 在 Agentic RL 中的角色分为以下三种:
- P(Prediction):预测动作会造成什么后果。
- Q(Action Value):预测采取该动作后,未来累计结果有多好。
- A(Advantage/Credit):将该动作与同一历史下的替代动作进行比较,形成局部 Credit。
只有第三层真正进入 Credit Assignment。
二、论文总览
按照上述角色分类,可以将最近阅读的论文大致归纳为以下三条研究脉络。
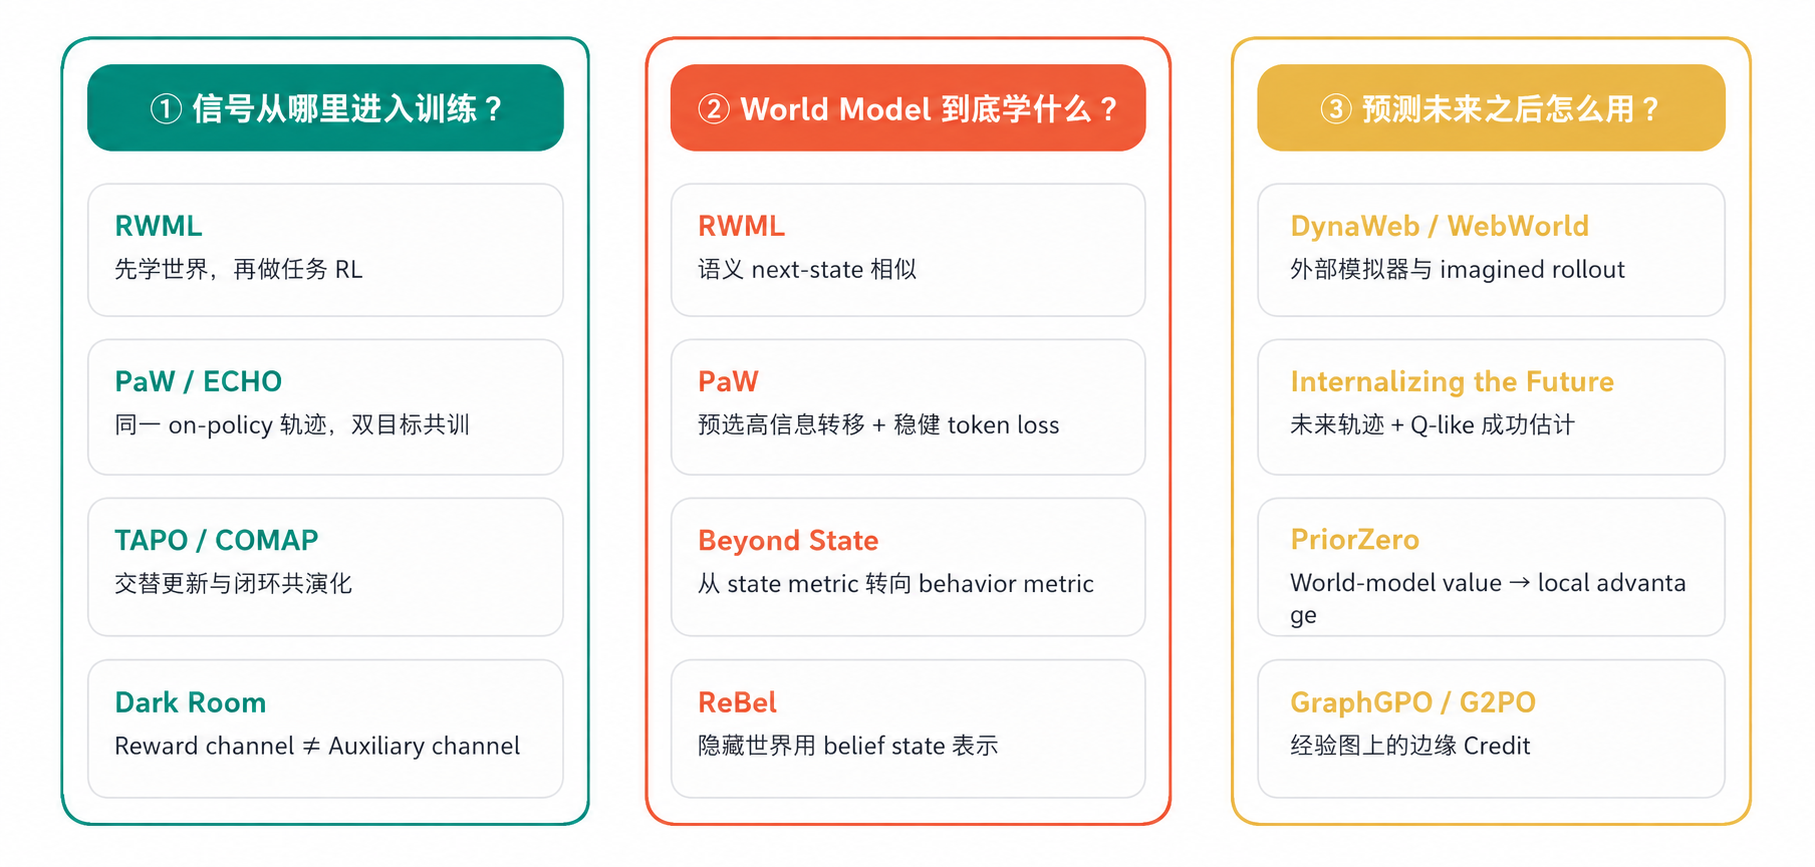
图 2:World Model in Agentic RL 的论文分类与研究脉络
1. 训练接口
RWML → PaW / ECHO → TAPO / COMAP → Dark Room
研究从“先学习世界、再执行任务”,逐步走向“使用同一批 on-policy 轨迹,同时训练 Policy 和 World Model”,随后开始区分 reward channel、auxiliary-loss channel、交替更新与闭环共演化。
2. 预测目标
State token / embedding similarity → robust observation loss → behavior consistency → belief state
研究从判断“预测文本是否相似”,走向判断“预测状态能否诱导相同的下一步行为”,并进一步承认 Agent 根本无法看到完整状态,因此需要显式建模 belief。
3. 未来的用途
One-step prediction → imagined rollout → plan-conditioned success estimate → value/advantage
研究从预测下一步 observation,走向在外部模拟器中生成 imagined rollouts,或在同一个模型中 verbalize future,最终使用 action value 构造局部 Credit。
三、Part 1:训练时序与信号通道
RWML:基线起点
RWML 并不复杂:它从真实交互的 trajectory 中抽取 (history, action, next state),让同一个 LLM 根据 history 和 action 生成 imagined next state,再比较 imagined state 与真实 state 在预训练 embedding 空间中的语义相似度,并使用这个 sim-to-real gap 构造 GRPO 的 World-Model reward。
这里没有逐 token 构建 next-state likelihood,因为同一个 state 可以由不同 token 组成的不同措辞来表达。逐 token 比较会将大量容量浪费在表面形式上,因此 RWML 使用 embedding 来保留语义信息。
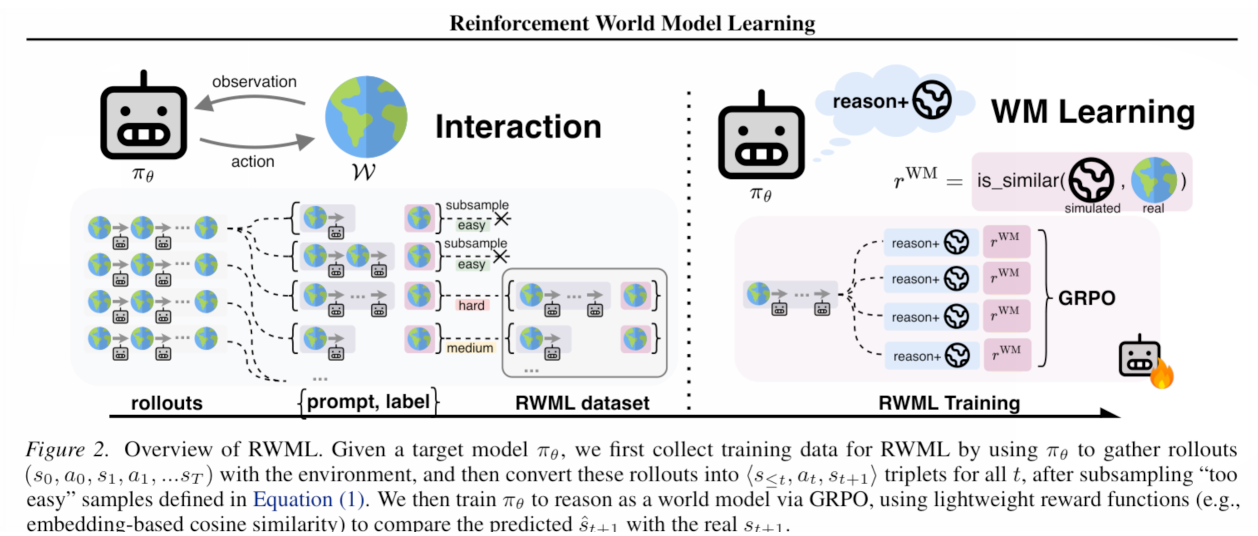
图 3:RWML 的交互、数据构建与训练流程
RWML 采用 2-stage training:
- World Model Learning:学习“我的动作会对环境造成什么?”
- Downstream Policy RL:根据 outcome reward 学习“我应该做什么?”
这种拆分的优点是训练数据非常直接:所有 rollout 产生的交互都可以作为 World Model 的训练数据。但它也会带来一个自然的问题:World Model 学习的是旧 Policy 下的 state-action 分布。当下游 RL 持续改变 Policy 后,Agent 会访问新的状态、产生新的动作,训练后冻结的 World Model 可能逐渐偏离 on-policy distribution。
PaW、ECHO、TAPO 和 COMAP 等工作,正是从不同角度回答这一问题。
RWML → PaW
PaW 的核心 insight 是:on-policy rollout 本身就包含两种监督信号。
- 对于 Policy,提供
(h_t, a_t, A_t)。 - 对于 World Model,提供
(h_t, a_t, o_{t+1})。
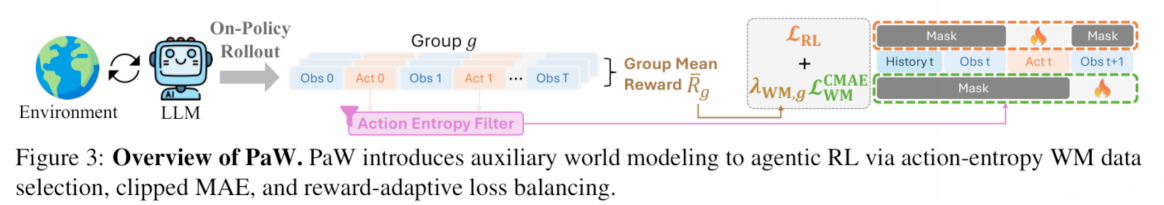
图 4:PaW 的整体训练流程
因此,PaW 将 RWML 的两个训练阶段合并并进行联合优化。这里的联合优化不是简单地将两个 reward 或两个 advantage 相加,而是在 loss 层面组合训练目标。
公式 1:PaW 的联合优化目标
- 第一项:由 outcome reward 计算得到的 advantage 驱动,即 Policy 的 RL loss。
- 第二项:next-observation 的辅助监督,即 World-Model loss;它通过共享参数改变模型表示。
同时,PaW 还采用了三项工程手段:使用 action entropy 选择信息量更高的 transition,使用 noise-tolerant loss 降低 observation token 噪声,并根据组内 task reward 自适应调整 World-Model loss 的权重。
所以,PaW 相当于让 World Model 长期陪伴一个不断变化的 Policy,而不是只进行一次性的“课前预习”。
四种 Co-training 接口
下面将四种接口放在一起比较。
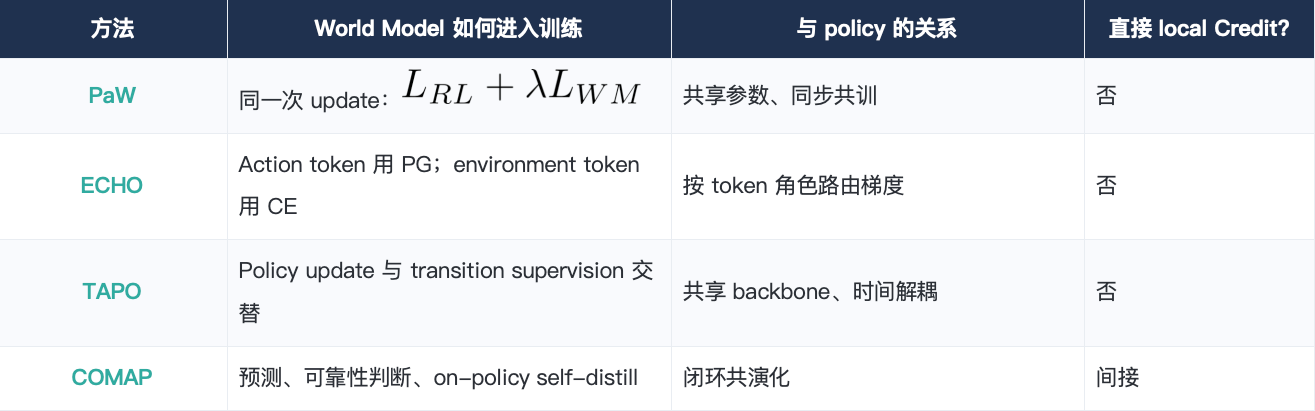
表 1:四种 Co-training 接口的对比
PaW:同一次更新中的联合目标
同一个 transition 同时产生 policy loss 与 World-Model loss,并通过样本筛选、稳健损失和 reward-adaptive weighting 控制相互干扰。它最接近标准的 multi-task co-training。
ECHO:按 token 角色路由梯度
ECHO 聚焦 terminal agent:命令 token 使用 GRPO policy loss;stdout、error、file 和 log 等 environment token 使用 cross-entropy prediction loss。它的洞察很直接:失败轨迹也许没有好的 outcome credit,但 terminal 已经如实记录了动作后果,不应被直接丢弃。
Transition-Aware TAPO:交替更新,而不是在同一步中混合
TAPO 在共享 backbone 上交替进行 policy optimization 与 action-conditioned next-observation supervision。它保留了统一模型,但将两类 update 在时间上分开,以减少直接的梯度竞争。
COMAP:World Model 与 Policy 的闭环共演化
COMAP 更进一步:World Model 不只是被动接收数据,而是在每个决策点预测候选动作的未来反馈;Policy 还需要判断预测是否可靠,并据此修正动作。新的 on-policy transitions 又会反过来 self-distill World Model。
这些工作共同承认了一件事:World Model 的数据分布不是静态的,因为 Policy 本身一直在改变它即将遇到的世界。
Dark Room:内容相同、Channel 不同,结果可能完全相反
Dark Room 区分了两条完全不同的信号通道。
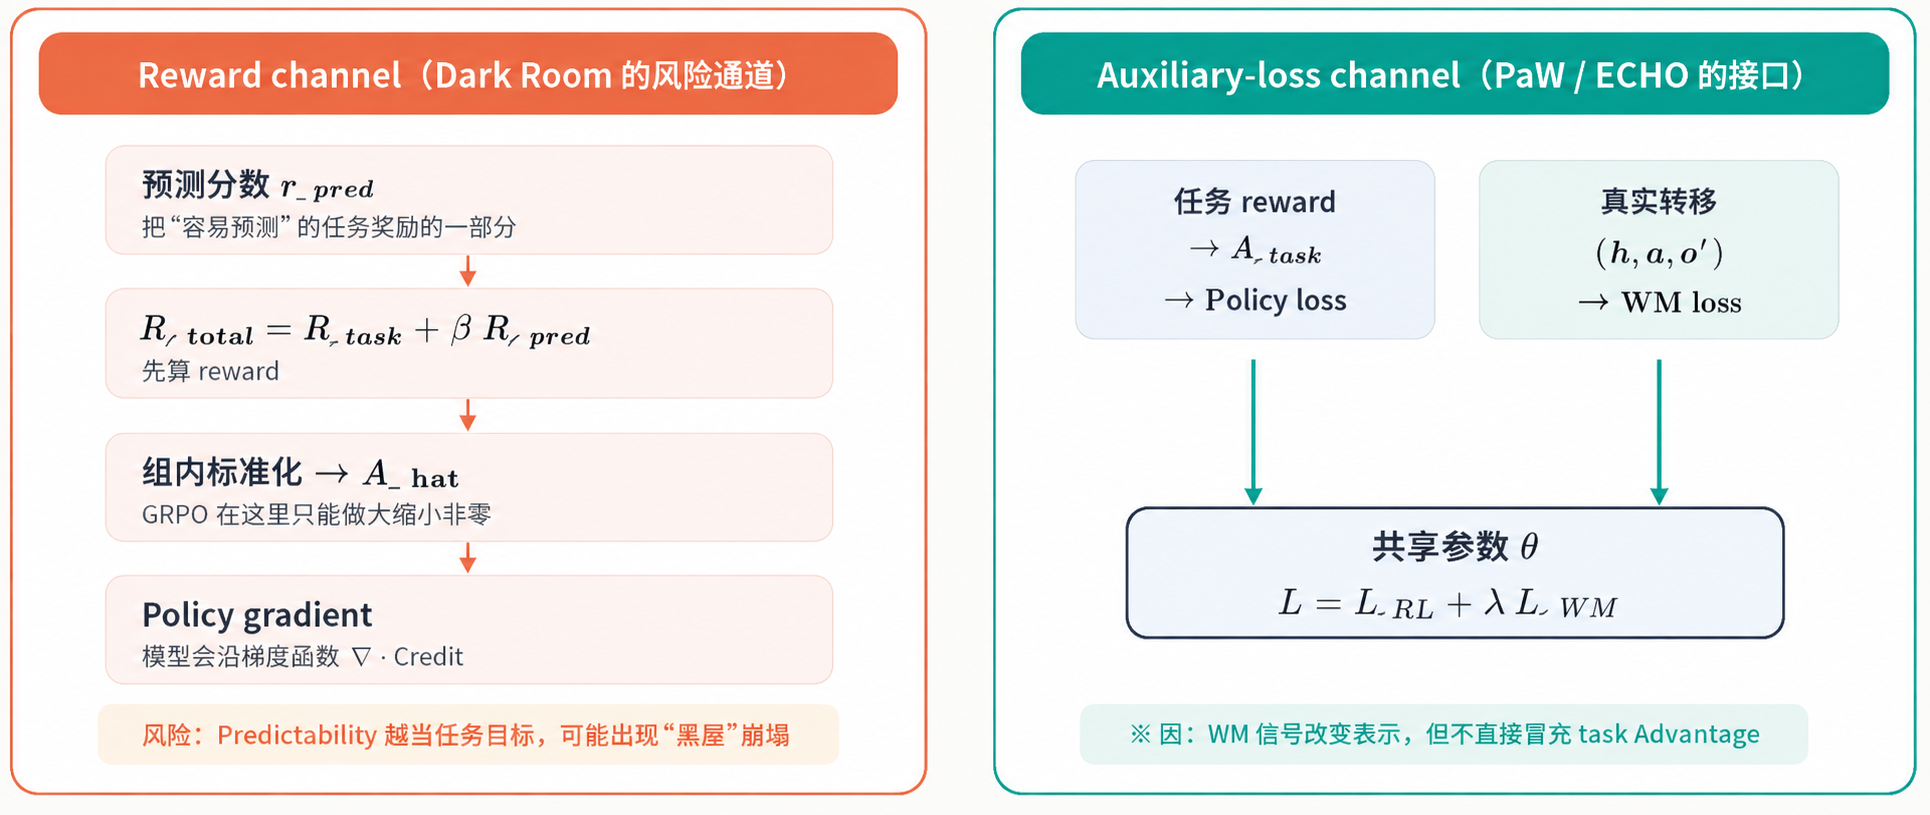
图 5:Reward Channel 与 Auxiliary-loss Channel 的信号路径对比
Reward Channel
先将 prediction score 加入 reward,再经过 mean/std normalization 得到 group advantage,最后直接进入 policy gradient。此时,Agent 会把“下一状态容易预测”当作需要主动追逐的任务目标(具体可参考原文推导)。
论文在 ALFWorld 中观察到一种极端退化:prediction accuracy 接近 1,episode 长度达到上限,而 task success 却降到 0。Agent 相当于给自己建了一个“什么都不会发生,因此极易预测”的黑屋。
更关键的是,在 all-fail group 中,如果 advantage 经过组内 z-score,缩小 shaping coefficient 未必能真正减弱训练压力,因为缩放系数可能同时被标准差抵消。
Auxiliary-loss Channel
这也是上文 PaW 所采用的实现形式:World-Model 信号改变模型的表示和动态知识,但不直接改写 task advantage。
不过,在论文的 v2 版本中,作者补充了更多实验,并得到以下结论:将正确的 next-state supervision 打乱后,辅助通道在部分设置中仍能匹配、甚至超过 true-gold supervision。
这意味着“auxiliary loss 比 reward shaping 更稳定”可能成立,但性能提升未必全部来自正确的 World-Model 内容,也可能来自:
- 额外的 token-level 更新所带来的 regularization;
- 参数更新频率或梯度尺度的变化;
- 模型保留了更广泛的语言建模能力;
- 对共享 backbone 产生了某种通用的稳定作用。
因此,目前更稳妥的结论是:auxiliary-loss 接口比直接将 predictability 加入 GRPO reward 更安全;但要证明性能提升来自 world knowledge,而不是 placebo regularization,就必须加入 shuffled target、matched update count 和 matched token budget 等控制实验。
最终还需要评估模型是否真正提升了 action consequence prediction、behavioral equivalence 和 model-based decision quality。
最近的相关论文也在持续研究:能力提升中究竟有多少真正来自 World Model。这个问题值得继续关注。
四、Part 2:从 State Consistency 到 Behavior Consistency
理想情况下,我们可以比较真实状态与预测状态下的完整 policy distribution,例如计算 KL divergence。但在 Agent 这种开放式文本动作空间中,完整分布很难精确获取。BehR 的实际做法是使用 frozen reference agent,并根据日志中真实发生的下一动作,比较它在两个状态下的 likelihood:
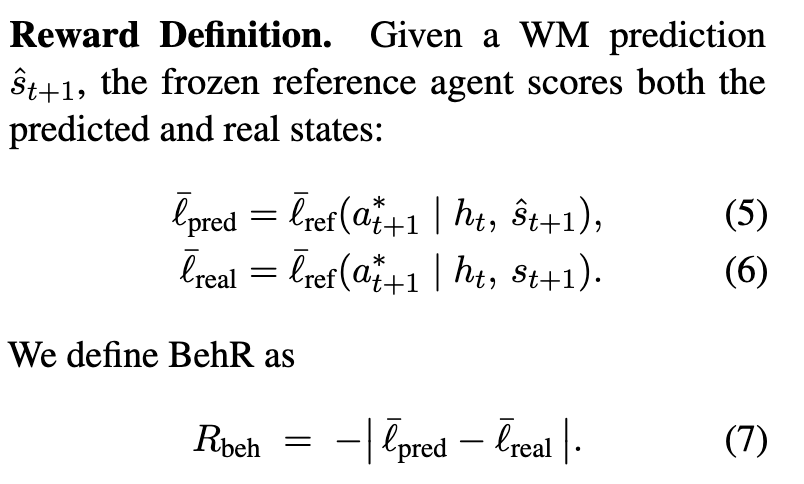
公式 2:BehR 对真实状态与预测状态的行为一致性度量
对于 Agentic World Model 来说,最重要的不是重建所有文字,而是保留那些会改变决策的因果差异。这与 Credit Assignment 的关系非常直接:如果模型连替代动作将如何被选择都无法保持,那么基于它计算出的 counterfactual Q 和 advantage 也不会可信。
五、Part 3:World Model 如何进入 Credit
前两部分讨论的是 World Model 怎么学,以及它应该保留什么。走到 Credit Assignment,还差最后一步:模型预测出的未来必须真正改变某一步、或某个 Agent 的训练信号。
沿着公式继续往后看,需要关注 World Model 的输出是否逐步进入 agent reward、value/TD、advantage 和 policy gradient 等环节。
如果最终只是多生成几条 trajectory、增加一个 next-state loss,或在推理时辅助搜索,它当然可能让 Agent 更强,但依然没有回答:“这一步应该分多少 Credit?”
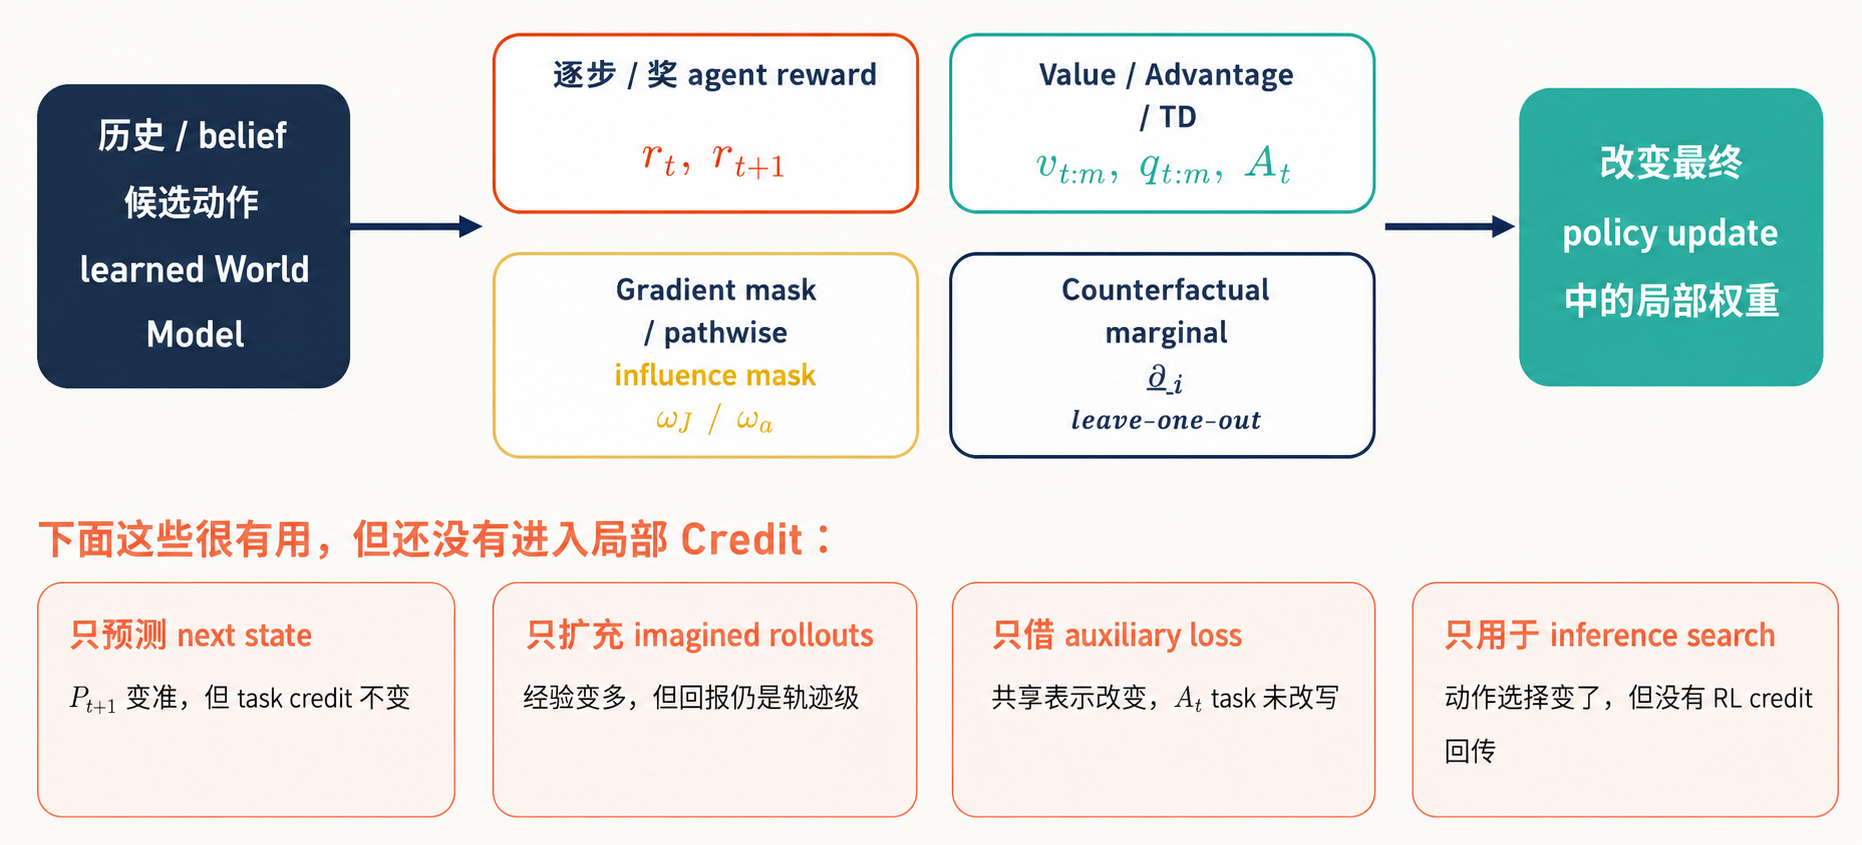
图 6:World Model 输出进入局部 Credit 的主要路径
不过,最近直接关注这一问题的文献似乎并不多。笔者大致将相关方法拆分为以下四种:
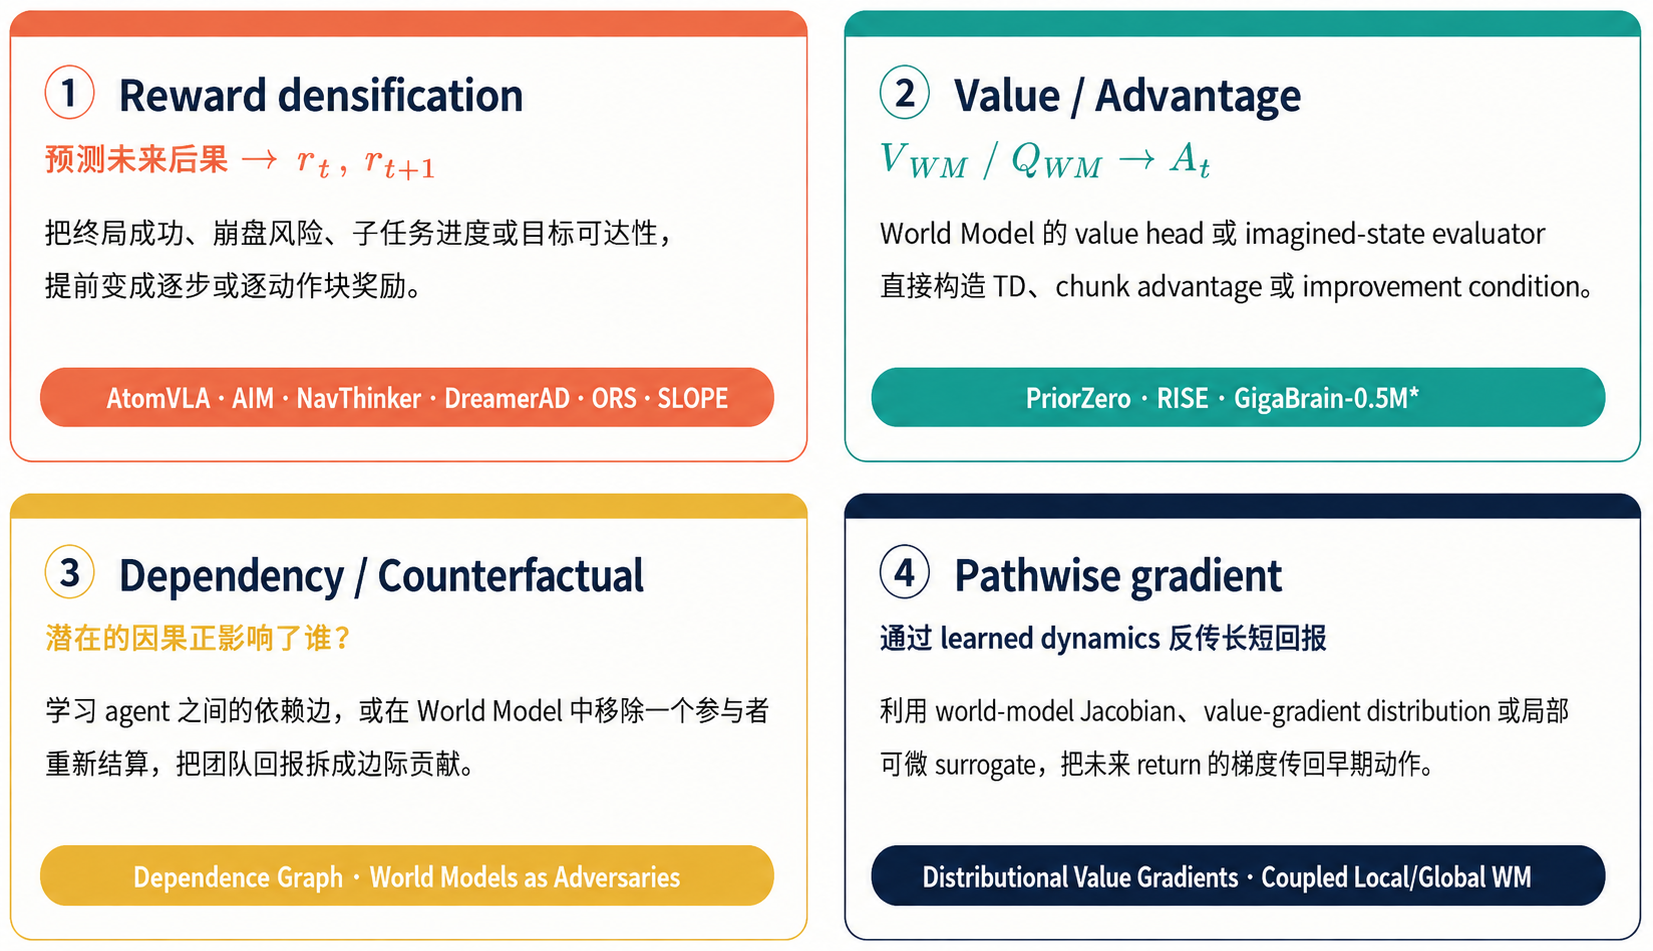
图 7:World Model 进入 Credit Assignment 的四类方法
1. PriorZero
前两部分讨论了 World Model 怎样学习,以及预测结果怎样保留决策信息。PriorZero 更进一步:预测未来之后,怎样真正改写 Agent 的局部更新?它处理的是语言先验与环境 dynamics 的错位,即 LLM 知道哪些动作在语义上合理,却未必知道在具体任务中哪一步会带来长期收益。整体流程如下。
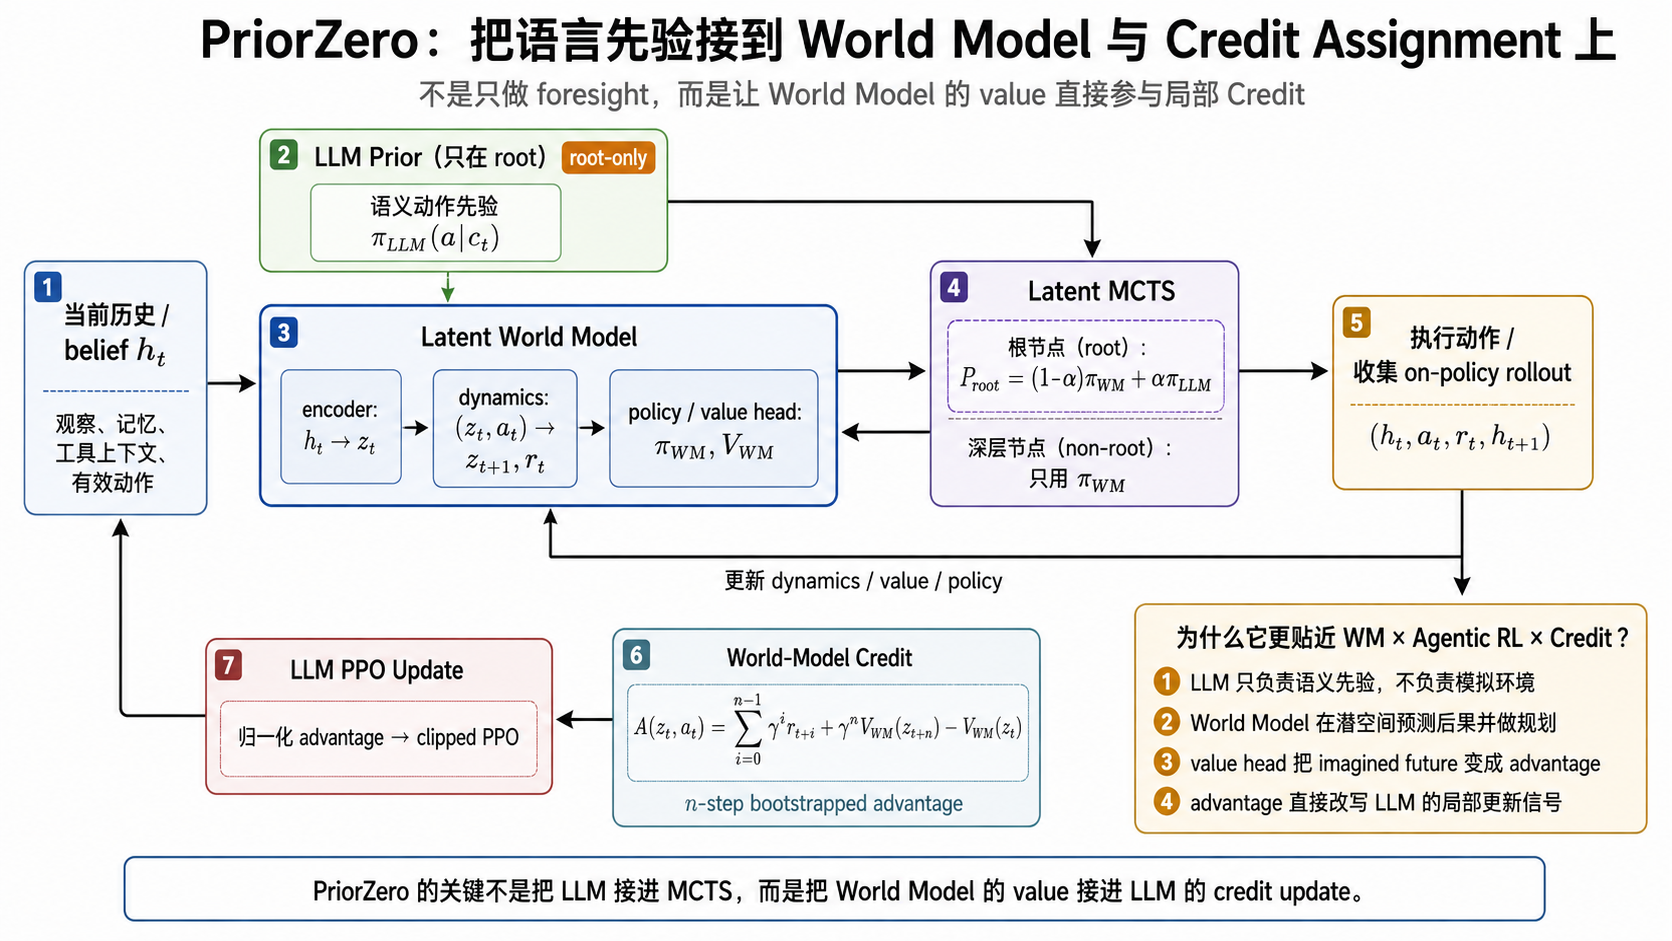
图 8:PriorZero 将语言先验、World Model 与局部 Credit 连接起来
它的分工很克制:LLM 只在 MCTS root 提供 action prior;深层 imagined rollout 交给 latent World Model,dynamics 学习动作后果,policy/value head 再将未来压缩成 Q/V。语言知识负责缩小搜索范围,环境经验负责校正长期判断。
先预测后果,再估计价值,最后回答“这一步比替代动作好多少”。但风险也会同步放大:value 一旦失真,World Model bias 就会升级为 Credit bias。因此,下一步真正缺少的可能不是更长的 rollout,而是 uncertainty 与 behavior consistency 对 Credit 的校准和门控。
2. VLA
笔者对 VLA 方向还不够熟悉。从现有论文来看,主流做法是将终局成功拆分为动作块、子任务或空间区域的 Credit。它们通常不会直接追求 token 级归因,而是先将稀疏成功信号拆到 action chunk、atomic subtask 或 spatial region。
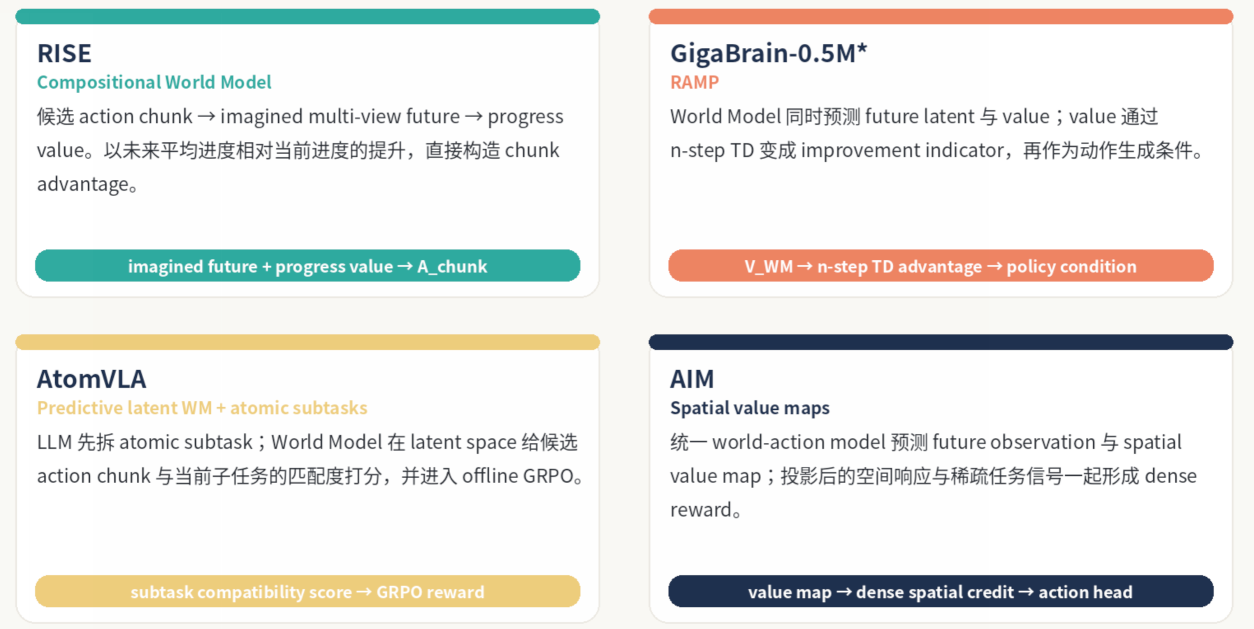
图 9:VLA 场景中四种 World-Model Credit 设计
这里粗粗带过:RISE 使用 imagined future 的 chunk progress improvement 构造 advantage;GigaBrain 使用 World-Model value 进行 n-step TD;AtomVLA 使用 latent subtask compatibility 进入 offline GRPO;AIM 则将 spatial value map 投影为 dense reward。
3. 安全与时序 Credit
在导航和自动驾驶中,等待真实碰撞或任务失败后再给 reward 往往太晚。World Model 的价值在于将未来风险提前映射到当前动作。
NavThinker:预测人类轨迹 → Social Cost
它将 action-conditioned future features 融入状态,同时把预测的人类轨迹转换为 social reward shaping,直接写入 DD-PPO 的逐步奖励。
DreamerAD:Imagined Latent Sequence → Autoregressive Dense Reward
它在视频 World Model 的 latent space 上训练 dense reward model,在多个未来 horizon 上输出安全与驾驶质量信号,再用于 GRPO 的相对 advantage。
这类 anticipatory Credit 很实用,但预测误差也会直接转化为错误 reward。换言之,World Model bias 也会成为 Credit bias。
4. 多智能体
多智能体方向主要回答“哪个 Agent 应该对未来结果负责”。笔者暂未深入涉及,这里先保留两篇相关文献:
- Explicit Credit Assignment in Multi-Agent Reinforcement Learning
- World Models as Adversaries: Multi-Agent Self-Play Fine-Tuning for Robust Motion Planning
总结
将这些论文放在一起后,笔者最终想留下的判断并不是“World Model 会成为 Agent 的标配”,而是:Agentic RL 正在将 World Model 从一个 next-state predictor,逐步推向一个 Credit estimator。
RWML、PaW、ECHO 和 TAPO 试图解决 World Model 如何进入训练;Beyond State 追问预测结果是否保留了真正影响决策的信息;DynaWeb / WebWorld 扩展 imagined experience;
而 PriorZero、RISE、GigaBrain、DreamerAD 和 Dependence Graph 等工作,才进一步让 World Model 的输出落到 value、advantage、逐步 reward、梯度路径或反事实贡献上。
它们之间真正的区别不是“有没有模拟未来”,而是 World Model 的判断进入优化器有多深,以及它最终是否改变了某一步、某个 Agent 获得的更新权重。
因此,这条研究线下一步最缺少的也不是更多 imagination,而是将 imagination 稳定地转换为可信 Credit 的机制:World Model 给出的 value 是否与真实任务目标一致;比较动作时是否有可靠的 baseline;预测不确定时能否降低权重;它保留的究竟是表面相似,还是会改变动作排序的因果信息。
否则,更多 rollout 可能只会提高 sample efficiency;一旦错误预测直接进入 reward 或 advantage,World Model bias 就会进一步转化为 Credit bias。期待业界给出新的解法。