精选文章 深度!具身世界模型 Ropedia W0:从人类第一人称经验中学习跨本体的移动操作 机器人数据不足且难以跨本体复用:夹爪录的“把杯子放进盒子”换到灵巧手上,手型和接触就全变了,机械臂、人形机器人、夹爪、灵巧手动作空间对不上,一批数据往往只能喂一个本体。另一边,人类第一人称视频数量巨大,却与机器人之间存在本体差异。 11月5日,青稞Talk 166 期邀请到 Ropedia W0 一
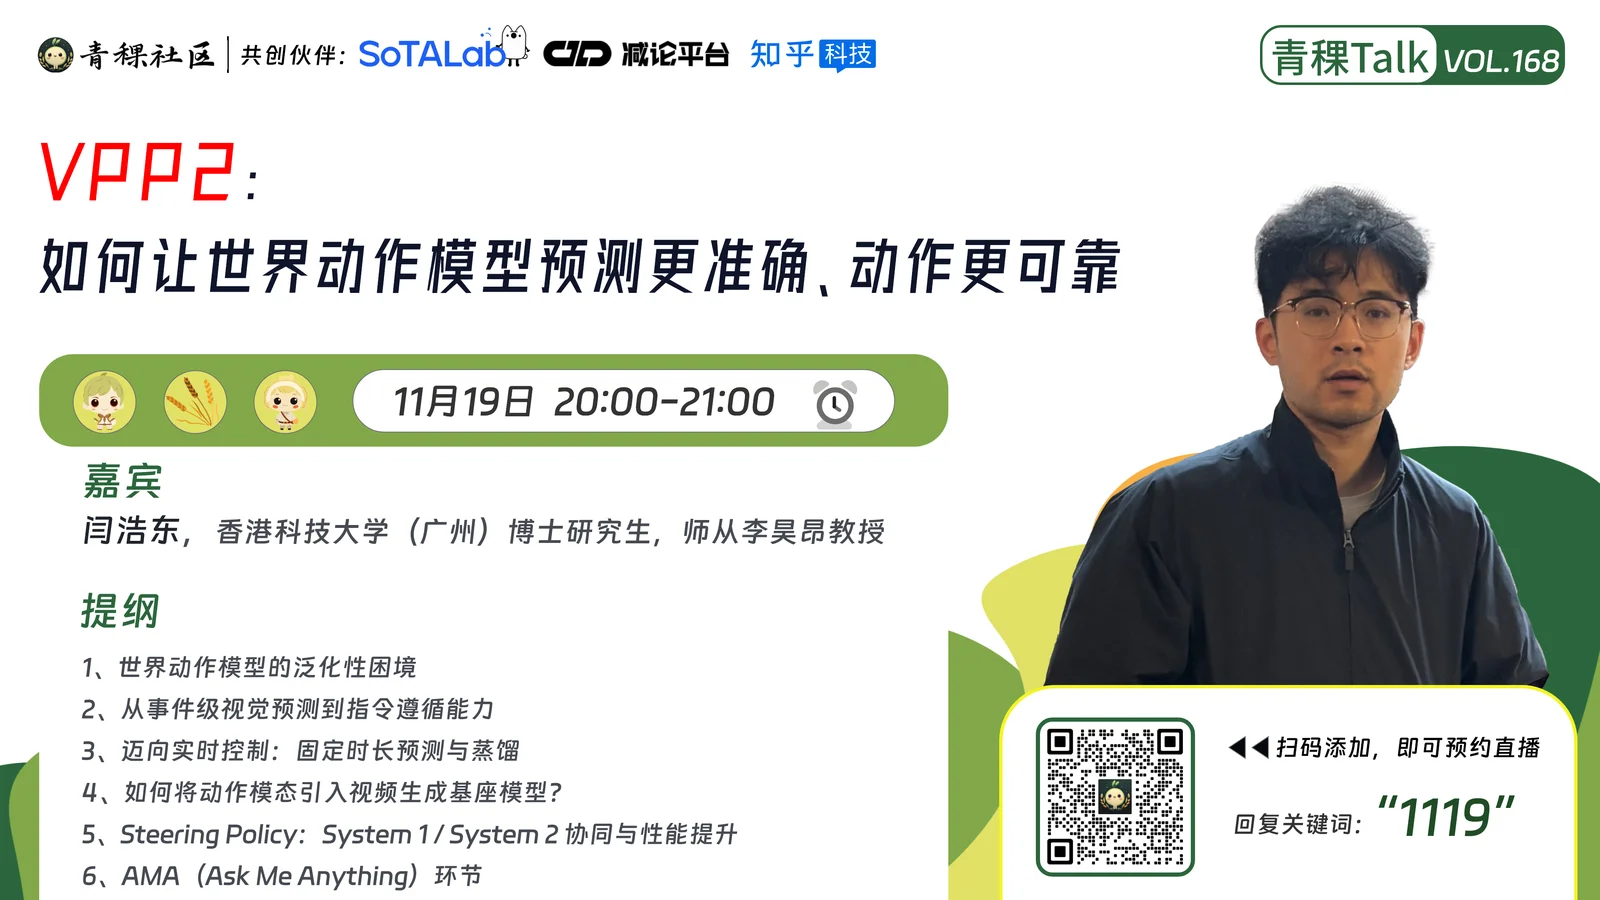
青稞Talk 直播预告!聊聊 VPP2:如何让 WAM 预测更准确、动作更可靠 世界动作模型(World Action Model)的想象很直接:视频模型已经学过物理世界的动态,那就让它先“想象”未来,再从想象里反推出动作。 问题在于,这个链条的第一环经常断。 在开放环境里,很多 WAM 的视频预测会跑偏:该抓的没抓,该放的放错位置。预测一旦错了,动作就跟着错。标准测试集上接近
青稞Talk 直播预告!具身世界模型 Ropedia W0:从人类第一人称经验中学习跨本体的移动操作 机器人数据不够用,是个老问题。 更麻烦的是换个本体就不好用:同一段“把杯子放进盒子”的视频,夹爪录的换到灵巧手上,手型和接触全变了;机械臂、人形机器人、夹爪、灵巧手,动作空间对不上,一批数据往往只能喂一个本体。另一边,人类的第一人称视频多到用不完,可它和机器人之间隔着一层本体差异。 来自南洋理工大学
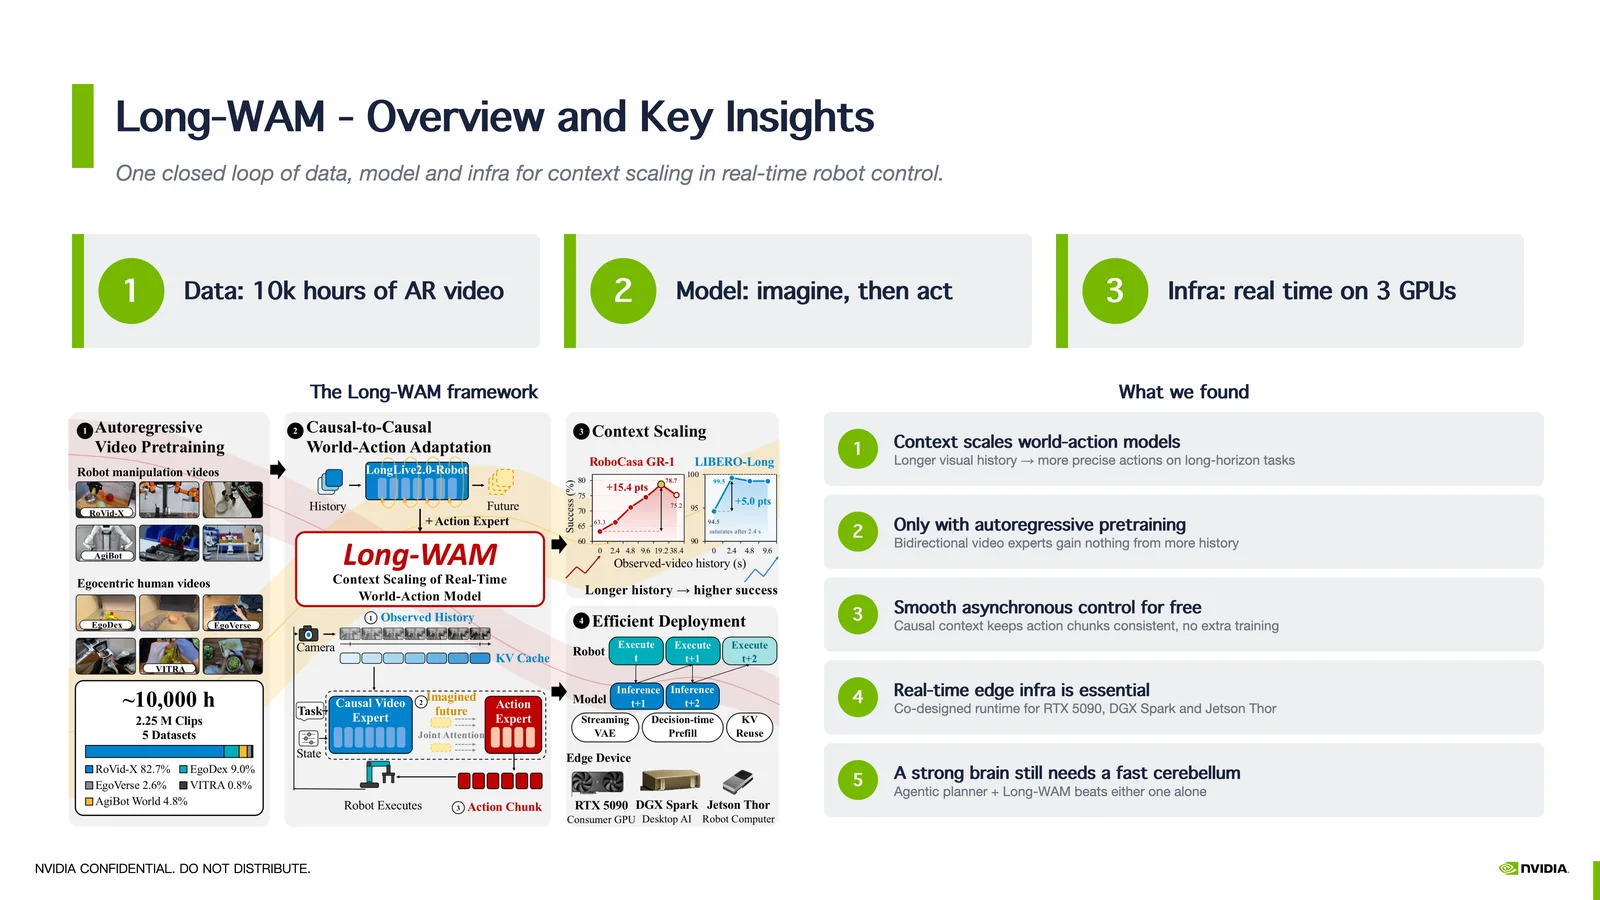
精选文章 Long-WAM 实录!世界动作模型的记忆、长上下文、异步控制、边缘部署,以及与 GPT Astra 的结合 机器人实时控制面临一对天然矛盾:要判断物体如何运动、任务进行到哪一步,需要足够长的视觉历史;但一旦处理历史,动作就会变慢。更关键的是,给模型历史,它不一定会用。 10月27日,青稞Talk 162 期邀请到 Long-WAM 第一作者、香港大学 ECE 博士生(NVIDIA Research Eff
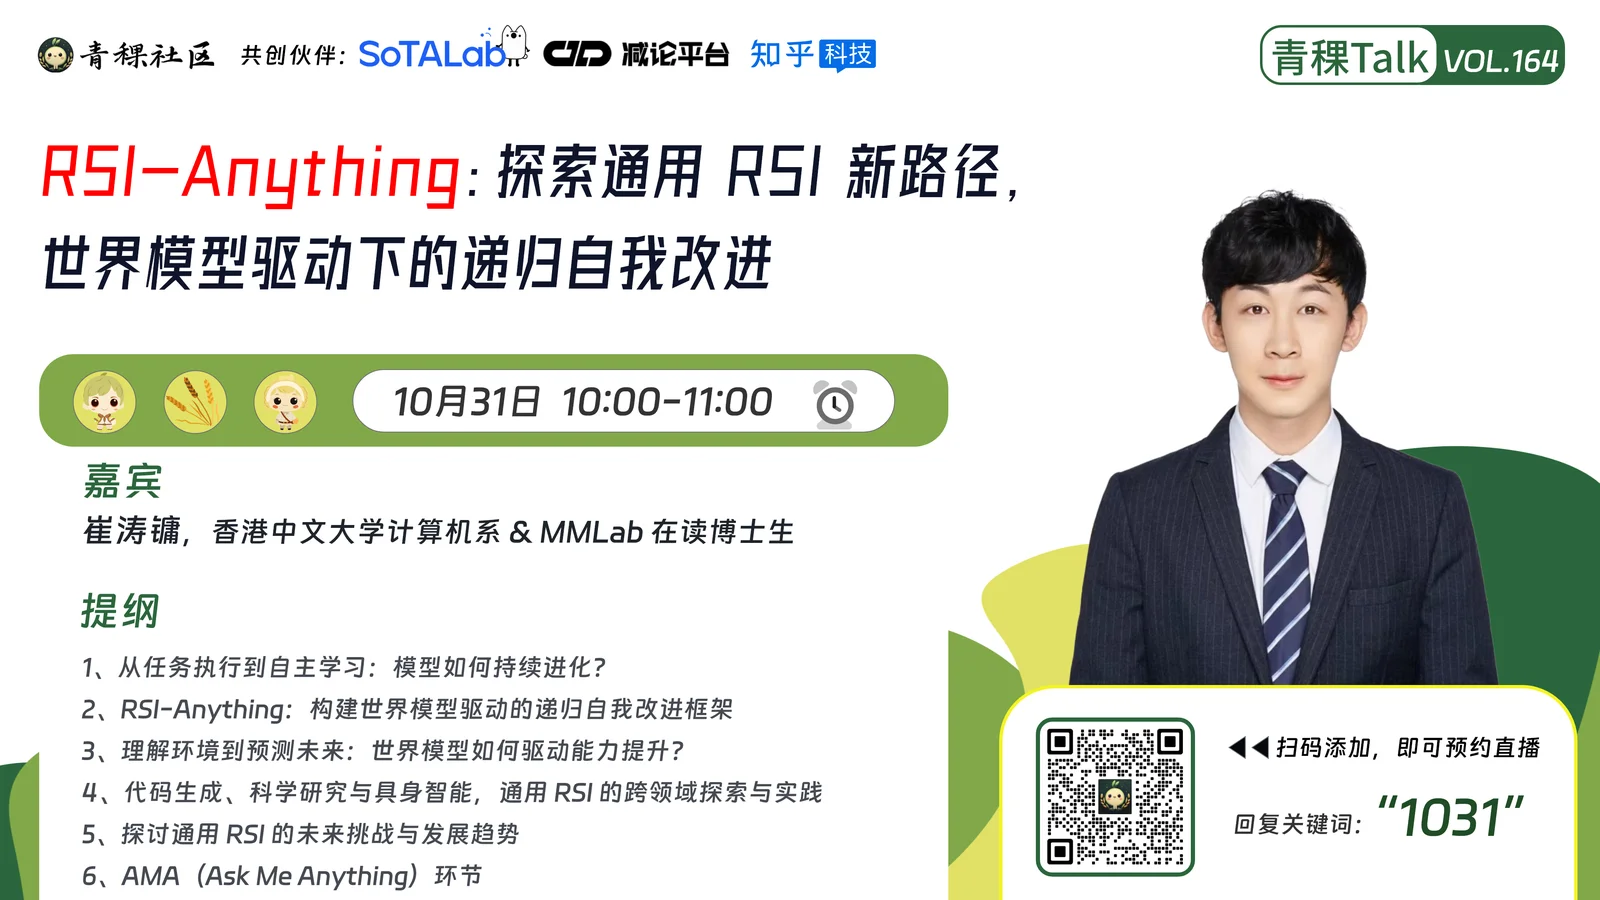
青稞Talk 直播预告!从 JEPA-Anything 到 RSI-Anything:探索通用 RSI 新路径,世界模型驱动下的递归自我改进 让模型继续变强,眼下最缺的往往不是想法,而是反馈:代码修复要跑测试,化学反应要上实验台,免疫研究要做湿实验。每一次执行都是真实成本。 反馈一贵,问题就从“怎么改”变成“先试哪个”。同一个 coder 给出四个候选补丁,同一轮里只执行其中一个;同一批反应条件,实验台只给 40 次机会。选错一次,机会就
青稞Talk 直播预告!世界动作模型为什么需要"记忆"?聊聊 Long-WAM 的上下文 Scaling 与边缘 Infra 机器人要做到实时控制,需要足够长的视觉历史,来判断物体怎么动、任务进行到了哪一步;但只要开始处理历史,动作就会变慢——这是一对天然矛盾。 更微妙的问题在于:给模型历史,它就会用吗? 来自 NVIDIA、MIT、香港大学与 UCSD 的团队提出 Long-WAM——一个面向实时控制约束、系统性扩展因果
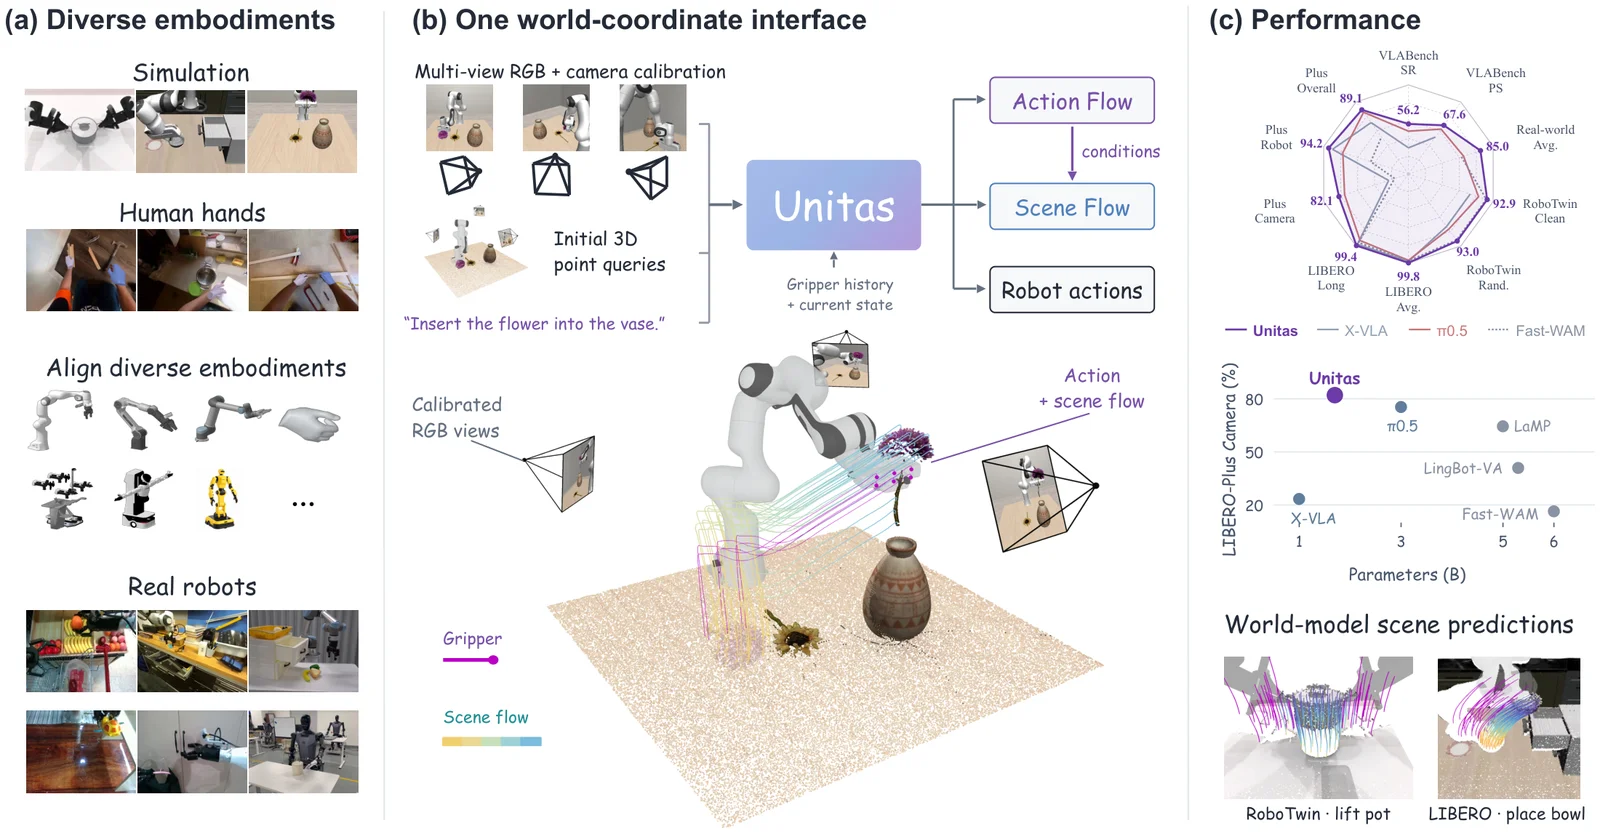
精选文章 1.7B 挑战 8B 模型!港中大(深圳)最新成果 UNITAS 跳出视频生成,开辟三维原生 WAM 新路线 只有 1.7B 参数,却在双臂操作基准上超过 6B、8B 模型;四个操作基准,全部拿下论文对比方法中的最高整体成功率。 世界动作模型(World Action Model,WAM)的竞争,迎来了一条值得关注的新路线。 当不少研究还在借助预训练视频模型学习动作与未来画面时,香港中文大学(深圳)团队推出
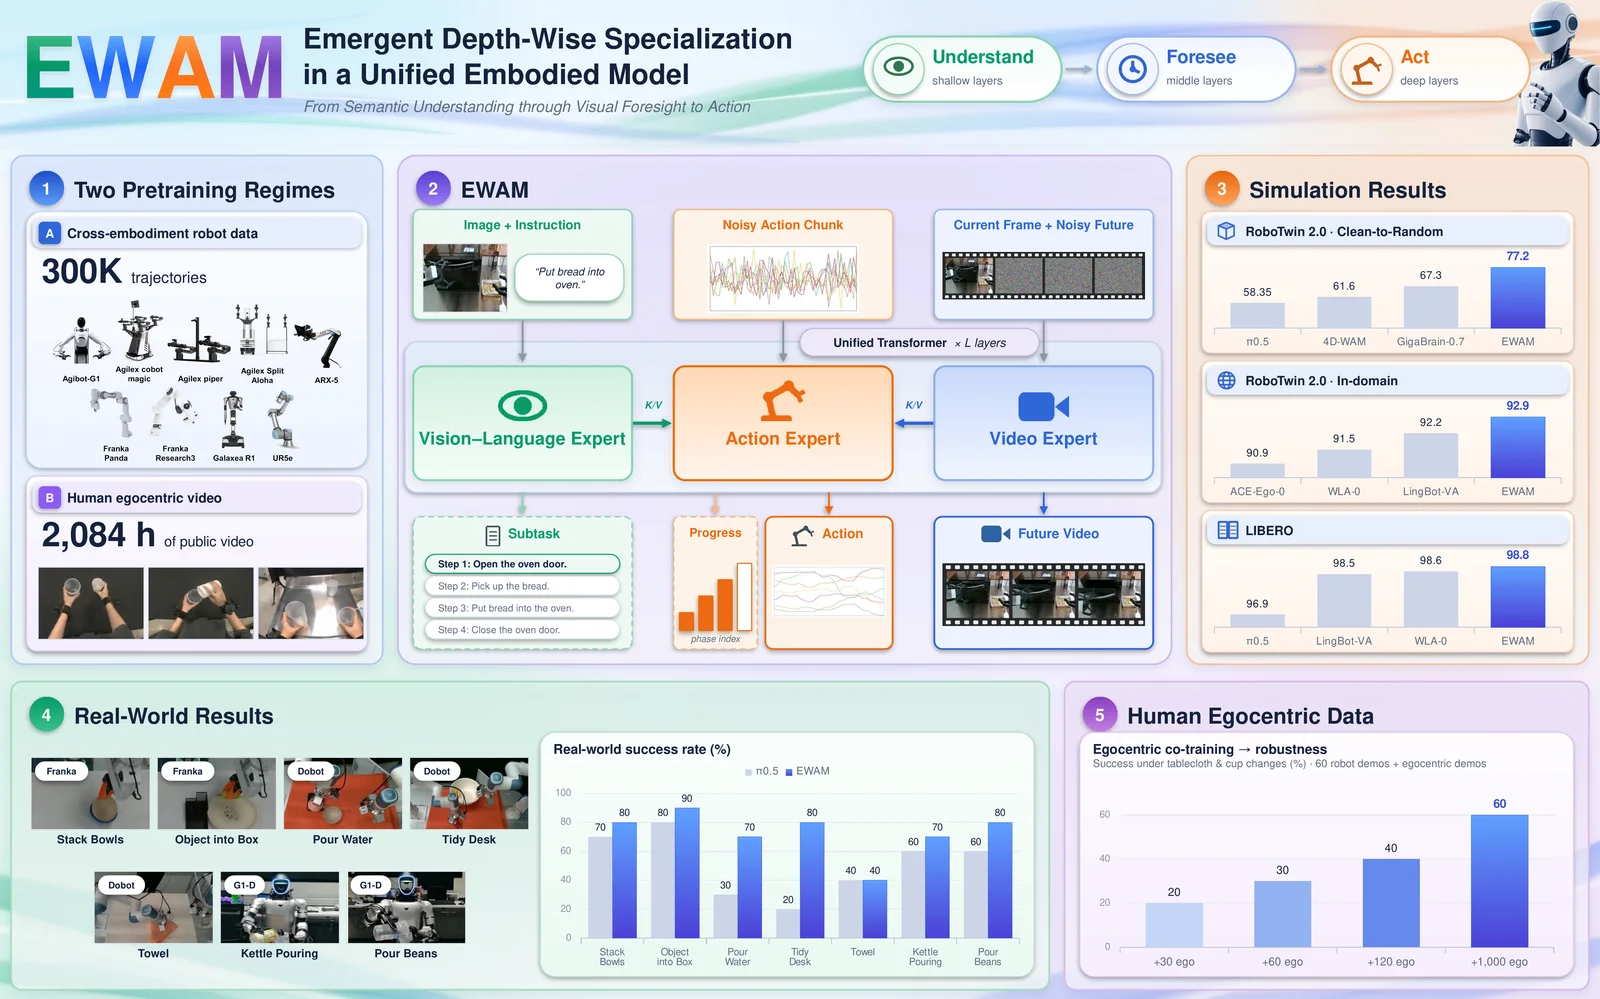
精选文章 VLA 和世界模型放进一个网络,会打架还是分工?EWAM:统一具身模型涌现层级分工 作者:王昊,中山大学博士 01. 倒一杯水之前,大脑先做了什么? 倒一杯水,看起来只是一个动作。但手还没伸出去,大脑已经忙了一轮:先认出杯子和水壶在哪,再预想手怎么移过去、水会怎么流进杯子,最后才决定手腕倾斜多少、什么时候停。 心理学家 Kenneth Craik 在 1943 年就写过类似的想法:
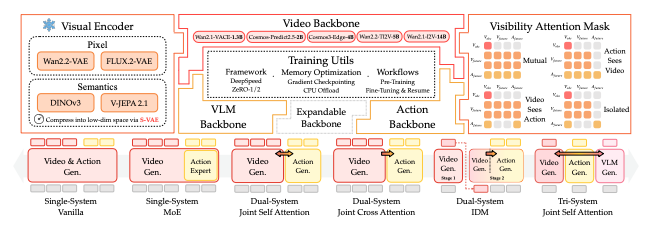
青稞Talk 直播预告!聊聊 OpenWAM ,面向世界–动作模型的开源研究全栈与基座模型 要让机器人真正“动手”,光有理解还不够:它既要看懂世界的物理与因果,还要把这些理解转化成可执行的动作。 但今天的世界–动作模型(World-Action Model,WAM)大多是“单体式”的:生成主干、视觉表示、网络架构、信息流、推理过程与训练数据全部耦合在一起,以至于研究者很难回答一个基本问题—
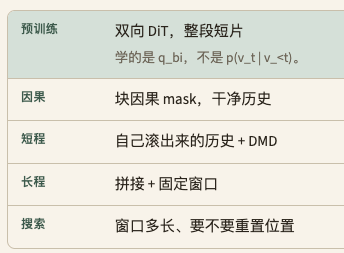
精选文章 我们离原生自回归视频模型还有多远 原文:https://waynejin0918.github.io/how-far-native-ar-video/zh.html 作者:Weiyang Jin,香港大学 语言模型里,自回归的意思其实早就清楚了。预训练拟合的就是 p(w_{1:n})=\prod_i p(w_i\mid w_{<i}
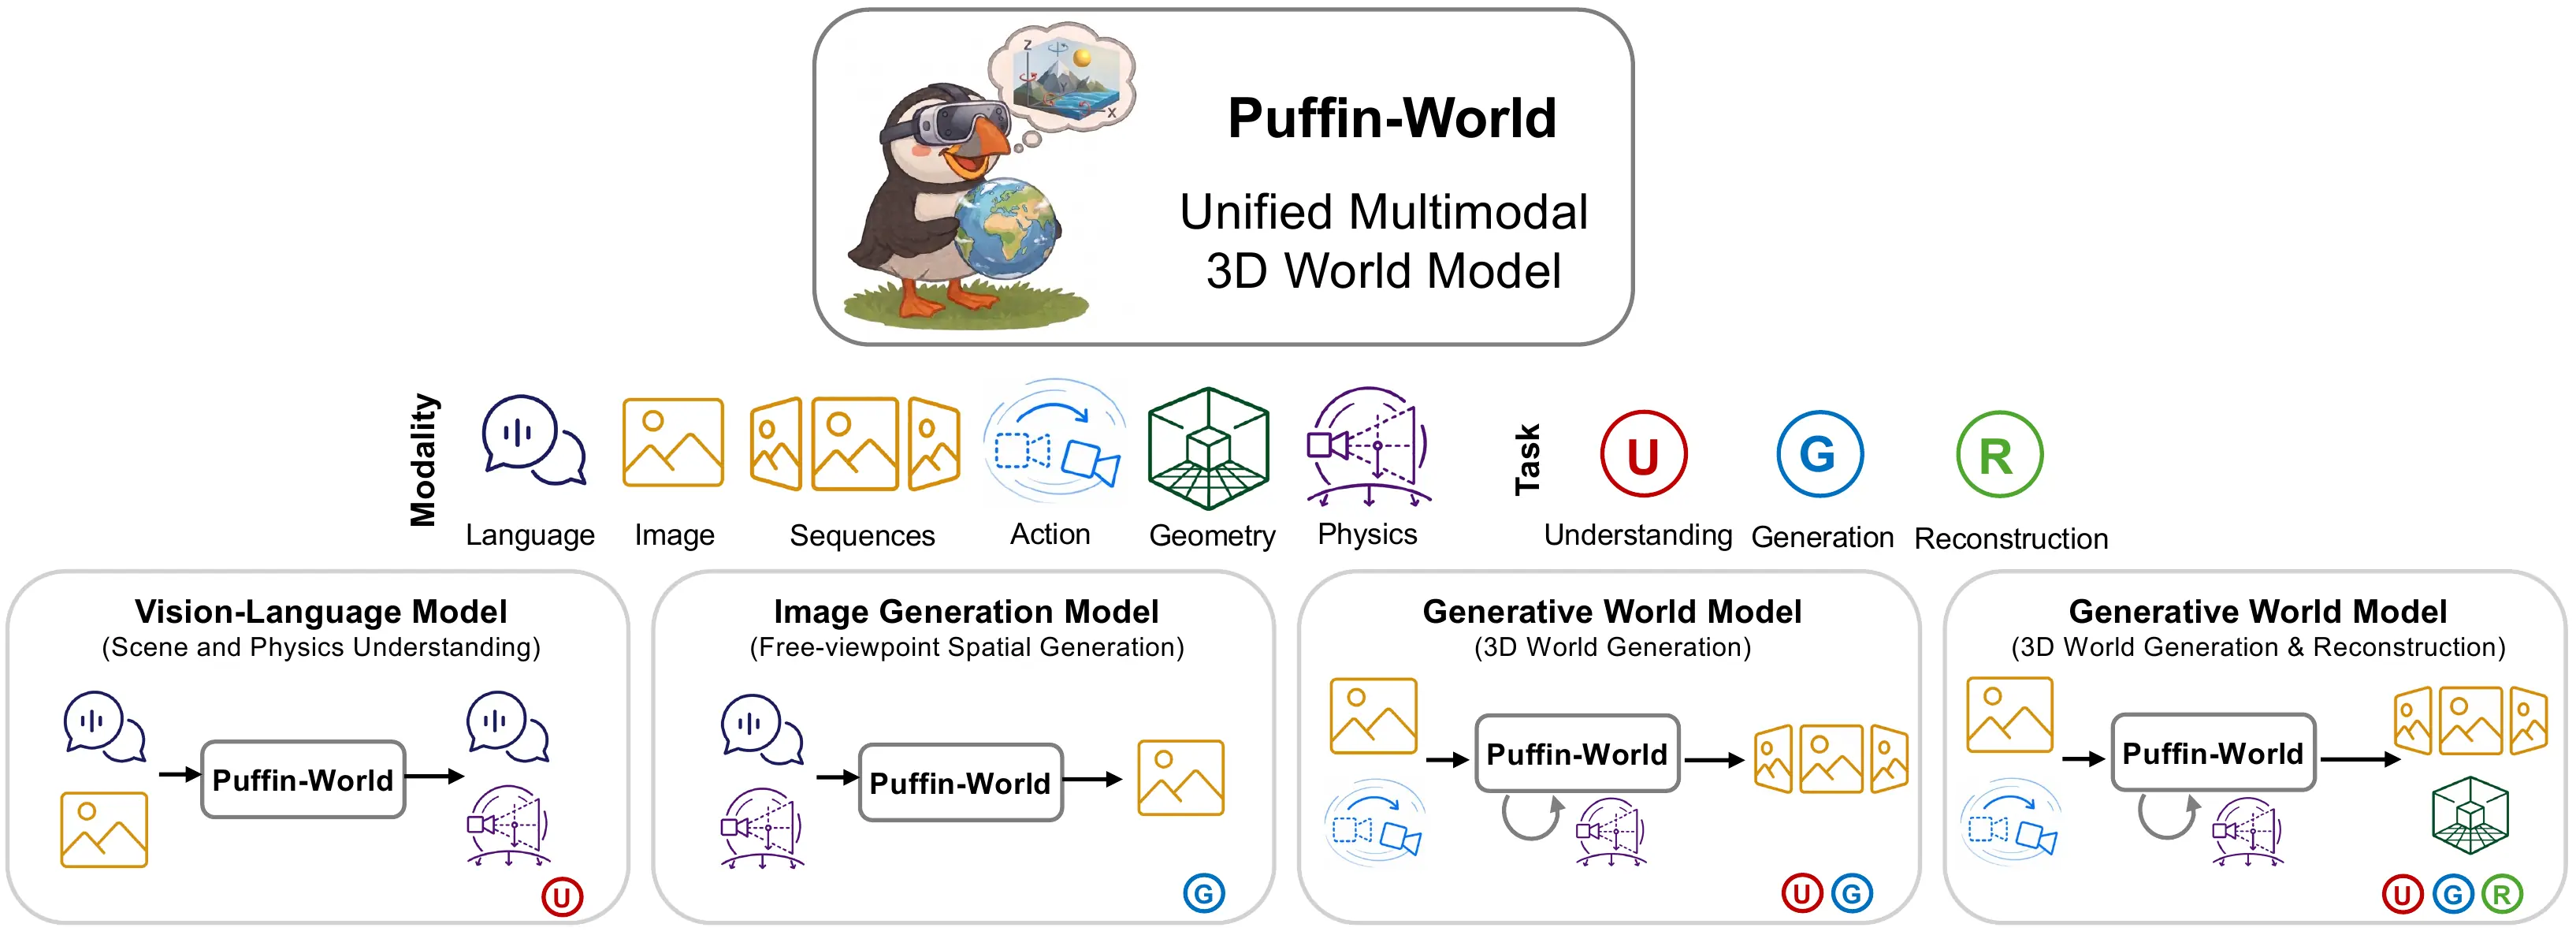
精选文章 面向空间智能的统一世界模型Puffin-World:从“生成画面”走向“理解并构建物理可信世界” 世界模型正在成为空间智能和物理AI的重要技术主线。真正的世界模型不应只是逐帧生成逼真的像素,还需要理解当前视角所处的物理世界朝向、场景的几何结构,并支持对世界的建模与连贯模拟。 在这一方向上,来自南洋理工大学S-Lab和大晓机器人等机构的研究团队近期发布了 Puffin-World。它让同一个模型同
青稞Talk 从"如何生成"到"如何验证",探讨物理一致世界模型如何实现可扩展机器人学习 当机器人要学会叠衣物、理线缆、摆弄软体——可变形物体操作的真实数据采集成本高昂、状态空间复杂、仿真与现实的差距显著。物理一致的世界模型,能成为可扩展机器人学习的"数据引擎"吗? 9月1日(周二)20:00,青稞Talk 第150期,上海人工智能实验室物理智能中心青年研究员周云松、王帅,将以 SIM1
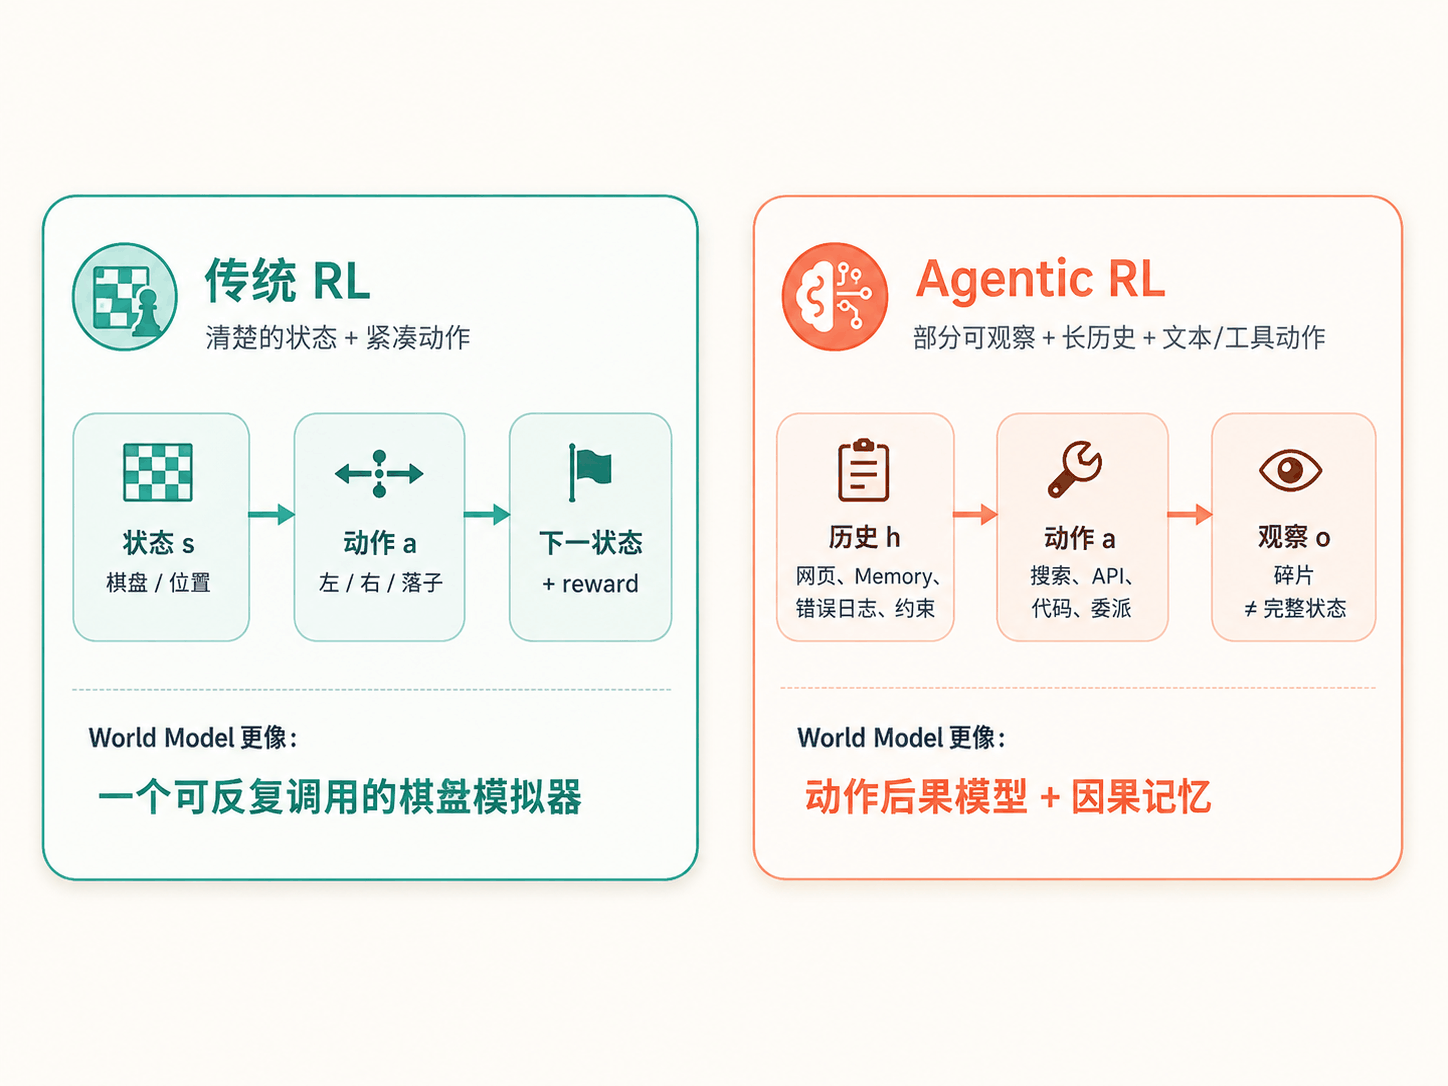
精选文章 系统梳理 World Model in Agentic RL! 作者:Sherry https://www.xiaohongshu.com/user/profile/642d87c90000000011020daf World Model 这个概念其实已经提出很久了,我最近才第一次系统涉猎。虽然大家都在讨论 World Model,但真正试图解决的似乎并不是同一
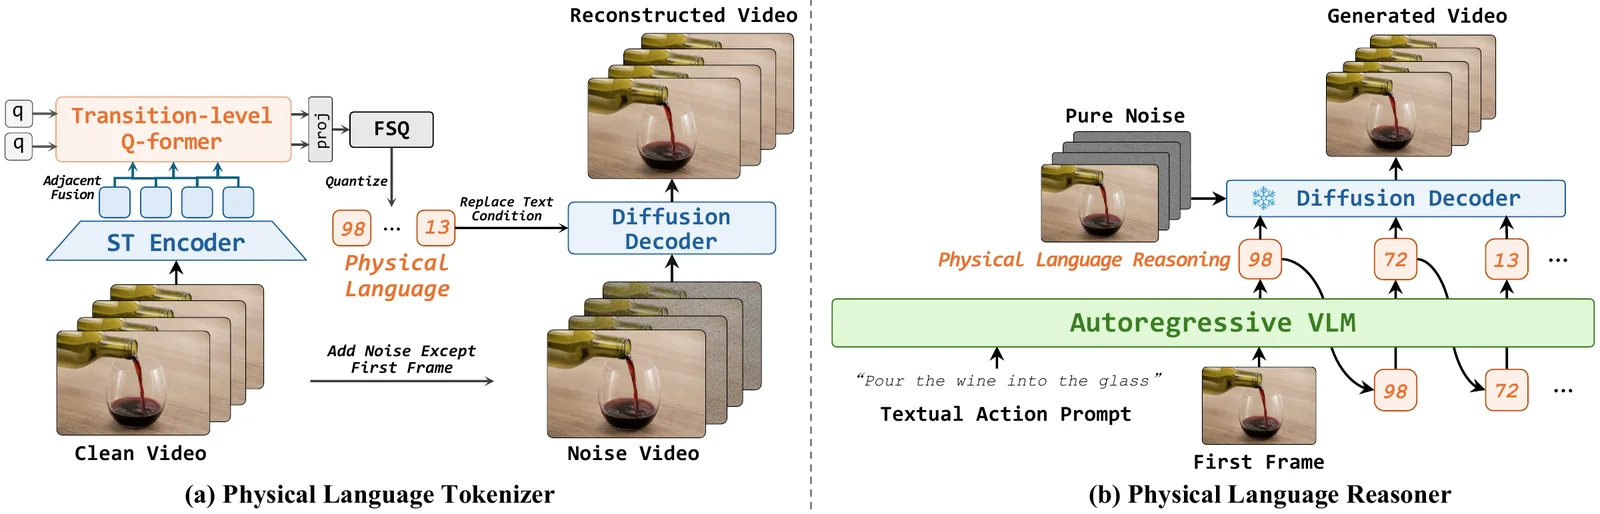
精选文章 不再困于自然语言!中科院自动化所最新推出 PhiZero,用“物理语言”帮助世界模型理解世界 作者:尚书尧 中科院自动化所 自然语言连接了 AI 与人类积累的数字知识。下一步,当AI走入物理世界,PhiZero希望用“物理语言”连接 AI 智能与真实世界。 人类用语言保存经验、传递知识,也用语言进行思考。从日常交流到科学定律,从历史记录到程序代码,自然语言凝结了人类长期积累的知识与经验。今天
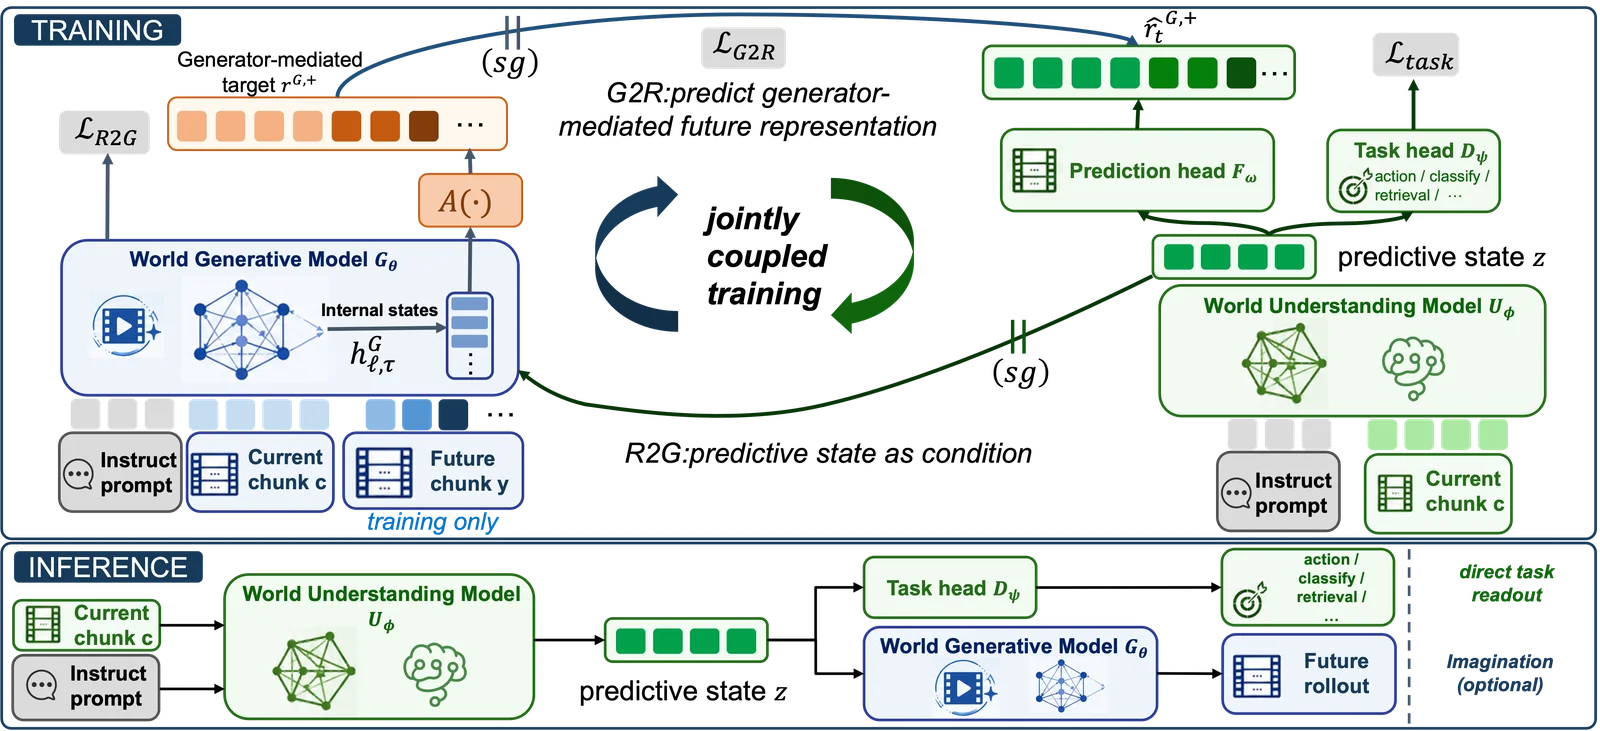
精选文章 世界生成模型不仅仅是未来模拟器!上海交通大学最新提出 Enfold:把世界模型的“未来计算”折叠进当下 作者:曾伟力,上海交通大学博士生 无需在每次决策时生成视频,也能让未来建模持续影响机器人的实时控制 世界模型让机器人拥有“想象未来”的能力,但如果每次动作预测都要完整运行一次视频生成,想象本身就会成为实时控制的负担。 来自上海交通大学和齐鲁工业大学(山东省科学院)的研究团队提出 Enfold:不再把
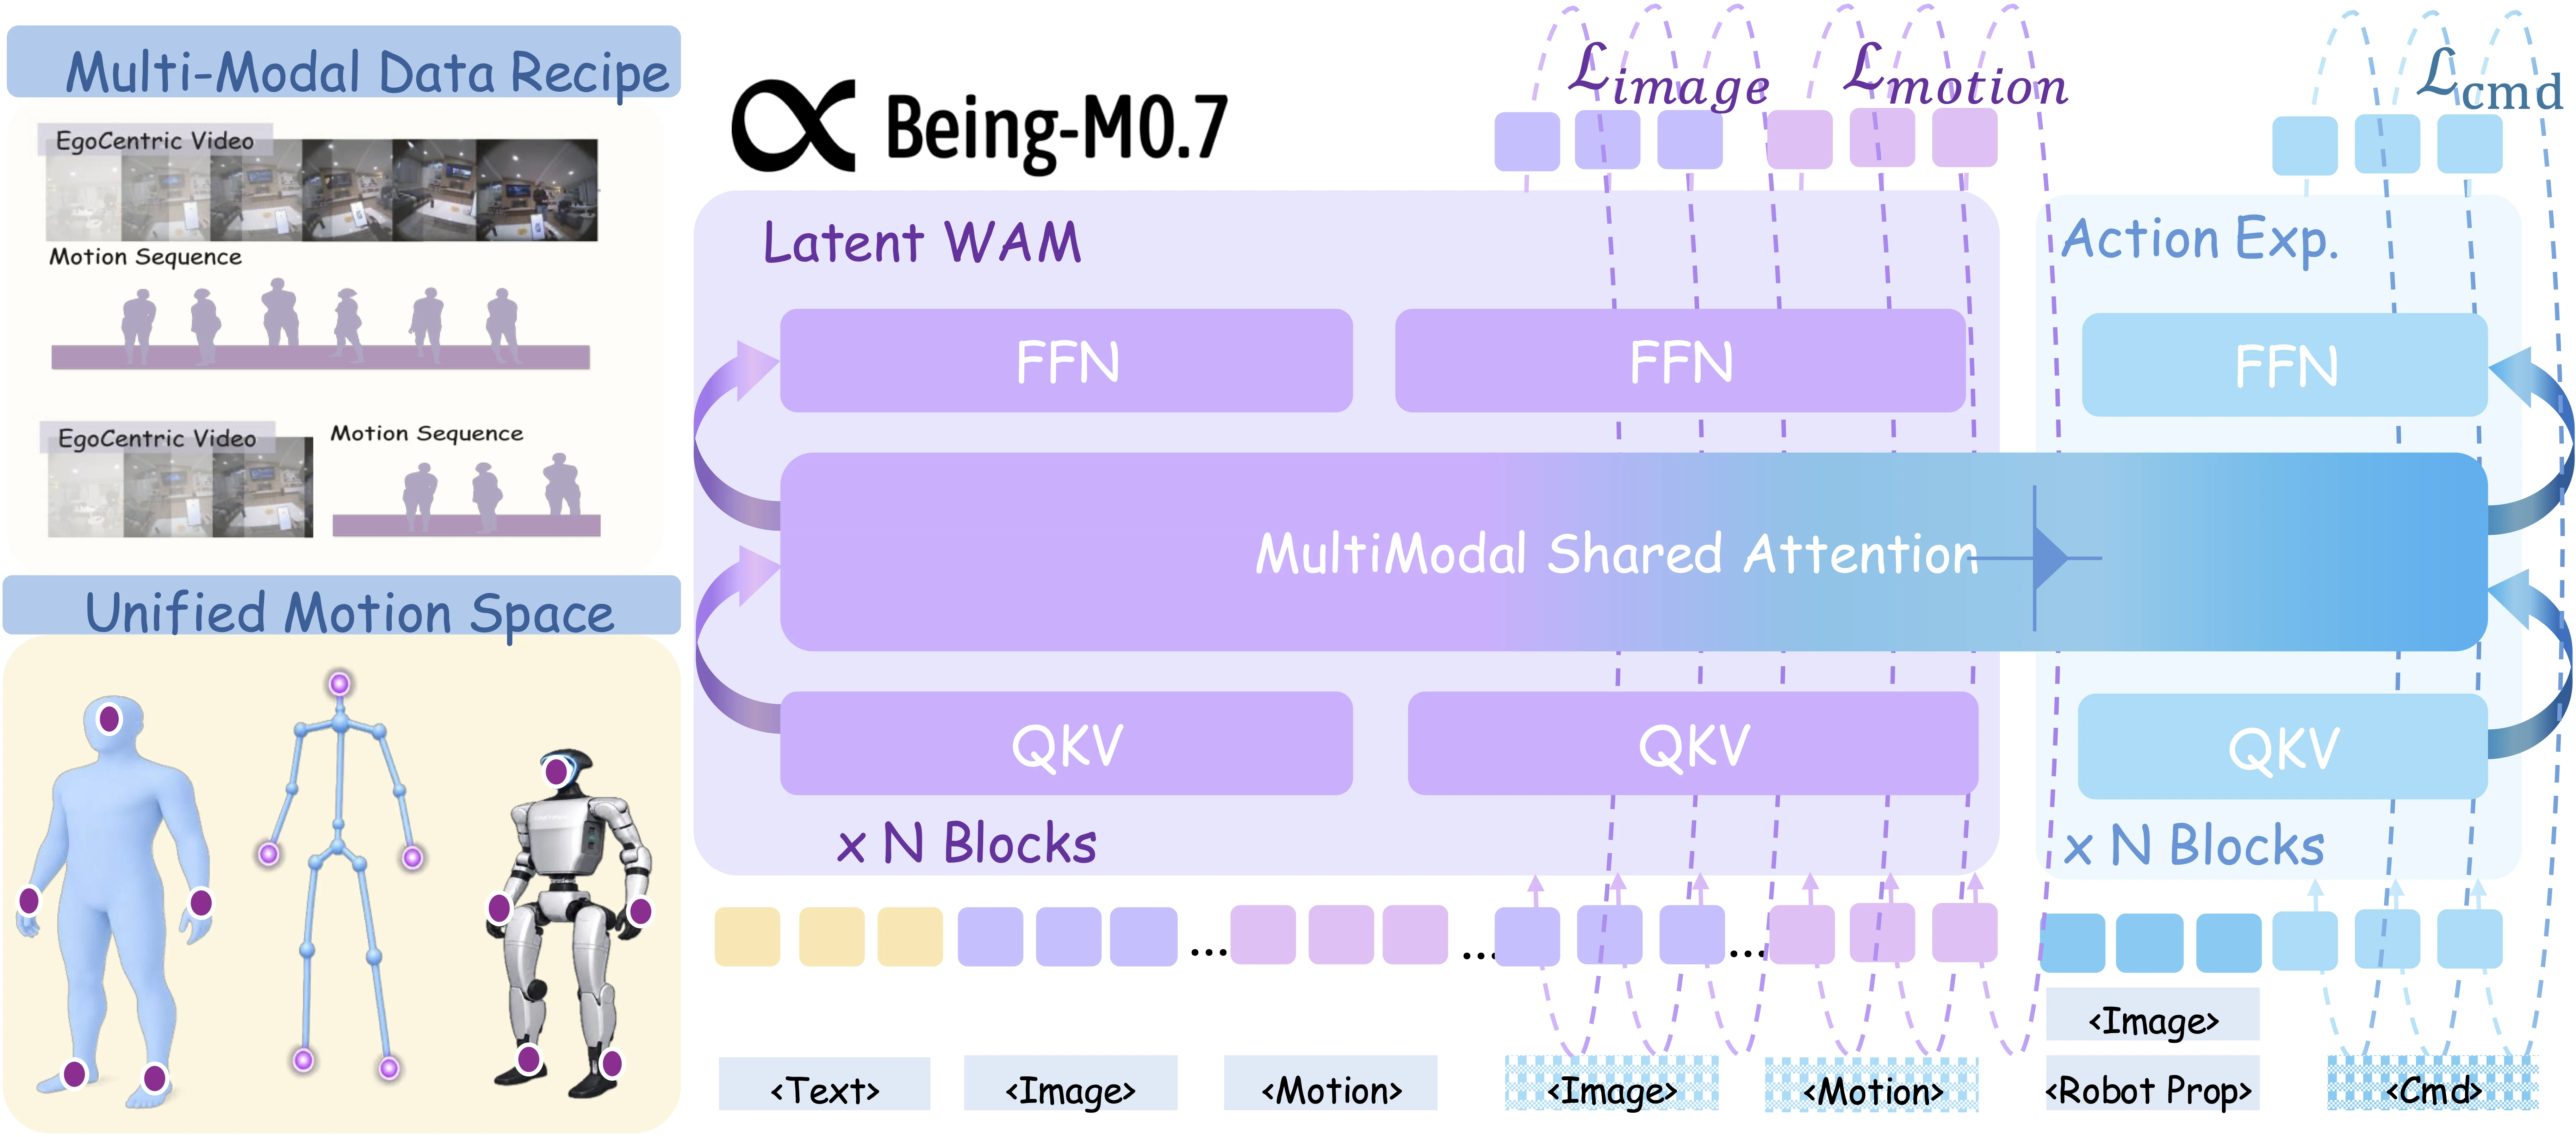
精选文章 从 Being-M0.7 看人形机器人的 WAM 路线 作者:黄奇浩 https://zhuanlan.zhihu.com/p/2066221445697508532 2026 年 7 月,BeingBeyond 团队放出了 Being-M0.7,一个专门为人形机器人全身移动操作(loco-manipulation)设计的 latent world-ac
青稞Talk 直播预告!聊聊 NTU & 大晓机器人最新开源的新一代具身智能数据范式 ACE-Data-0 ACE-Data-0 是 南洋理工大学 S-Lab 和大晓机器人联合开源的一个面向具身智能与机器人学习的人类中心、多模态、长时程交互数据集。 基于环境式采集系统 ACE,将真实家居环境转化为空间标定、时间同步的数据采集平台,同时记录第一视角与多视角视频、全身与手部运动、物体几何及六自由度动作、运动轨
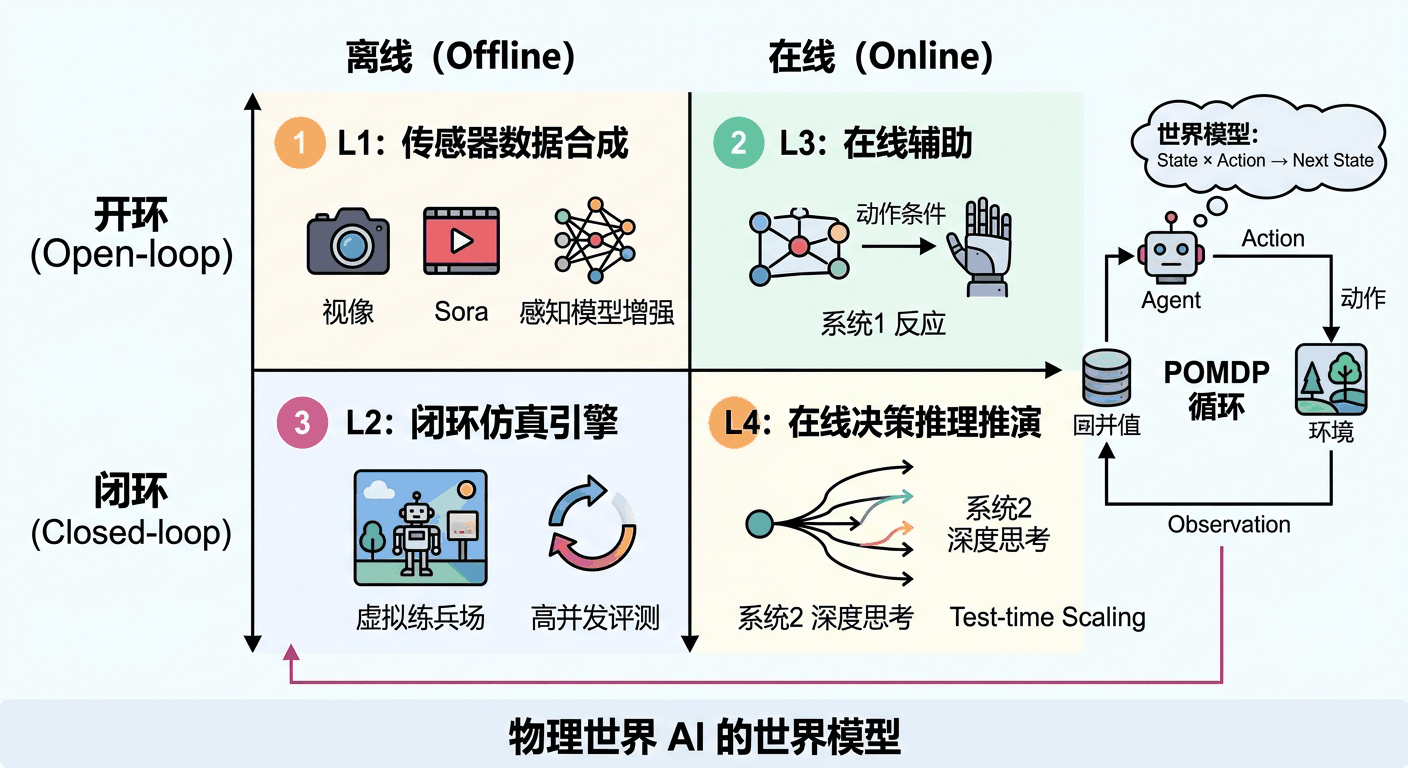
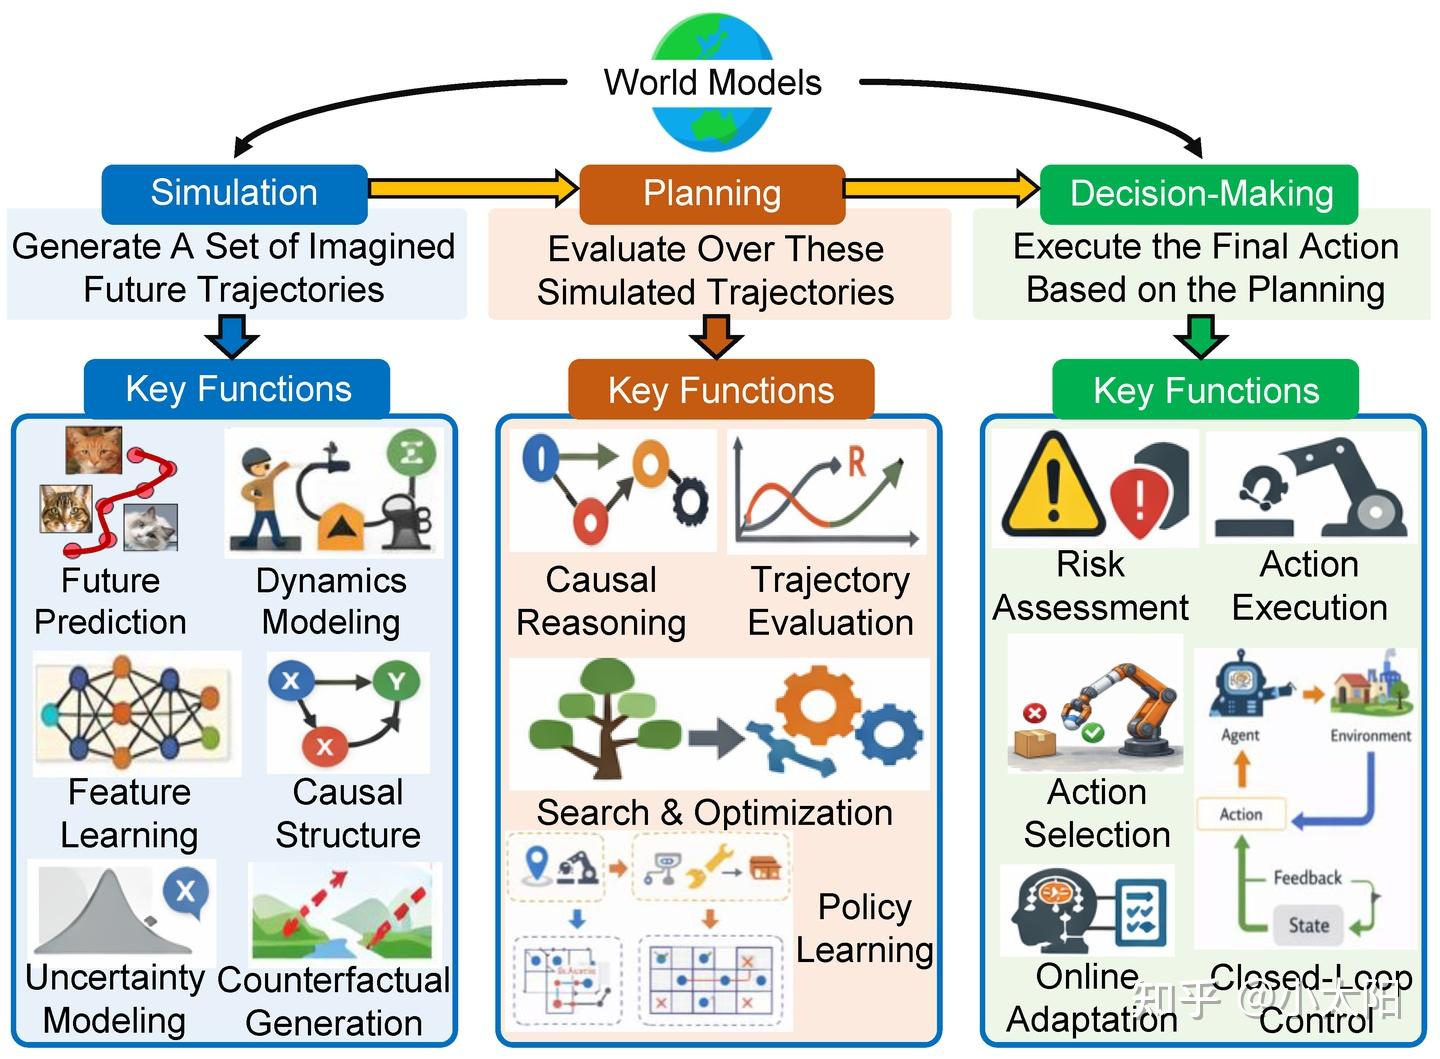
精选文章 谈论 World Model,请先对齐你的坐标!World Model 的四个象限 作者:Naiyan Wang https://zhuanlan.zhihu.com/p/2066565953501009575 在上一篇文章中,我们探讨了 Physical AI(物理世界 AI)想要在真实环境中运转,必须具备三大核心能力:理解世界(表征)、预测世界(世界模型)以及改造世界(强化学习
青稞Talk 清华 x 正行创新最新开源 LAWAM:隐空间世界动作模型将 WAM 瘦身24倍,同时成功率90%+! 折毛巾时,物理世界不会停下来等待机器人思考。 布料会滑动,褶皱会改变,前一秒还合适的抓取点,下一秒可能已经偏离。真实机器人做动态操作时,“想象未来”不能停留在离线视频生成里。它必须进入控制回路,在动作还来得及调整时,给策略一个可用的未来线索。 一个直接的想法,是让模型先生成未来画面,再让机器人根据这
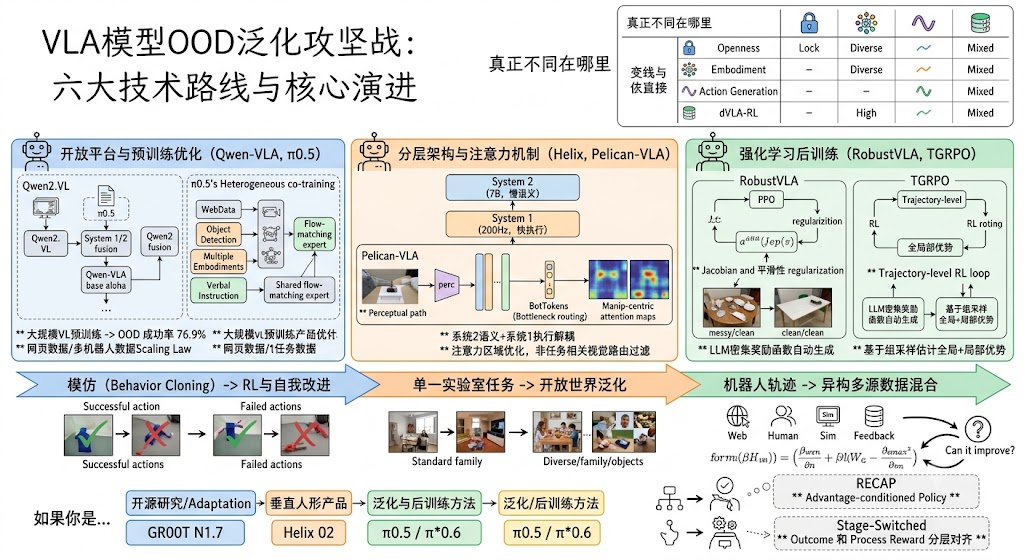
精选文章 VLA的OOD困境:不是模型不够大 作者:原来ID可以这么长 https://zhuanlan.zhihu.com/p/2060361643851256385 核心要点速览 Vision-Language-Action(VLA)模型虽然在机器人操控任务中展现出强大的能力,但在面对分布外(Out-of-Distribution, OOD
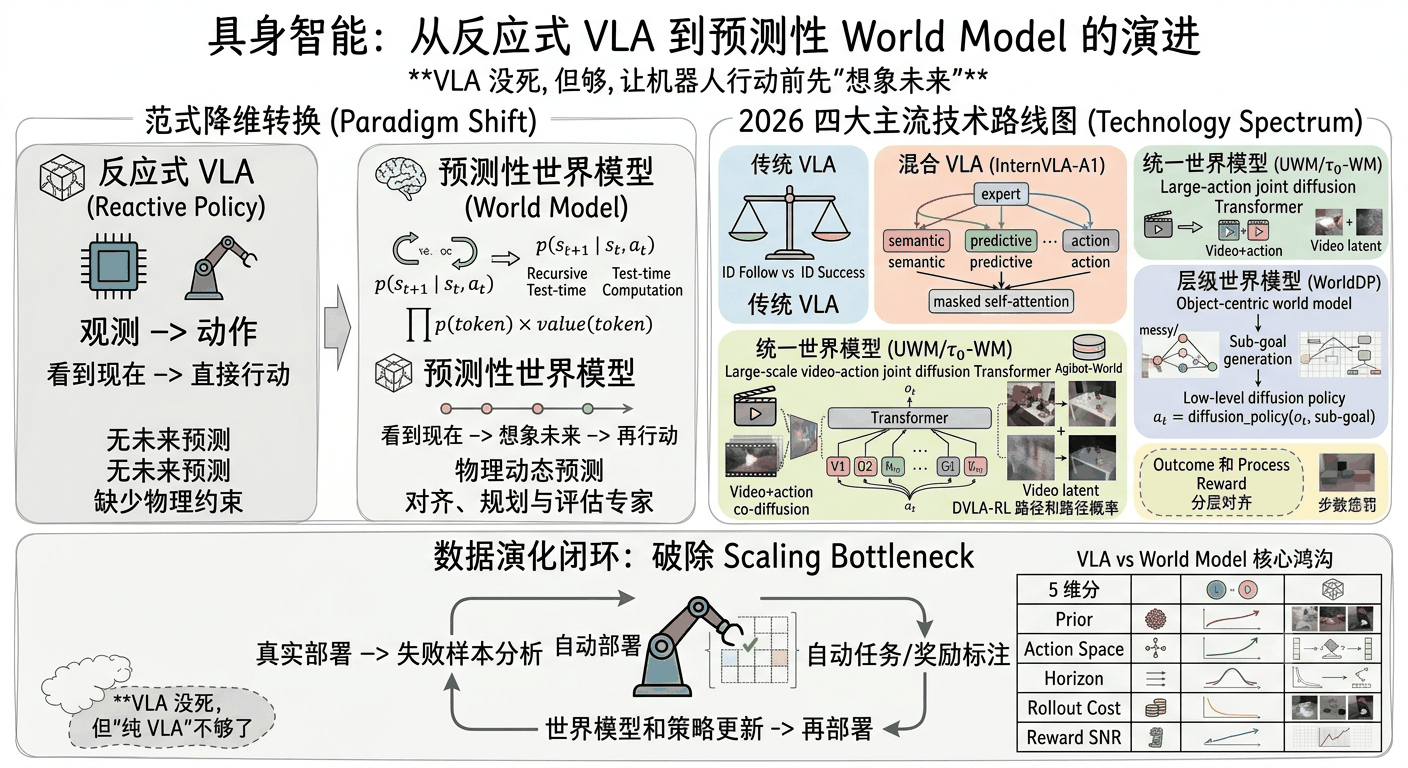
精选文章 VLA 已死?2026 年具身智能路线之争:World Model vs VLA 作者:硅基星人 https://zhuanlan.zhihu.com/p/2057783219144110491 VLA 没死,但“纯 VLA”确实不够了。 更准确地说,2026 年这轮争论不是“Vision-Language-Action 要被 World Model 替代”,而是“只把机器人策略
青稞Talk 直播预告!和 Qwen 团队研究员陈雄辉,一起聊聊Qwen-Robot Suite 的设计原理和背后的思考 大模型已经具备强大的视觉、语言与空间理解能力,但“看懂世界”并不等于“能够在世界中行动”。 千问(Qwen)大模型团队在 Qwen-Robot Suite / Embodied Foundation Models 方向最新推出了 Qwen-Robot Suite 系列三项重磅工作。 这组工作围绕一个
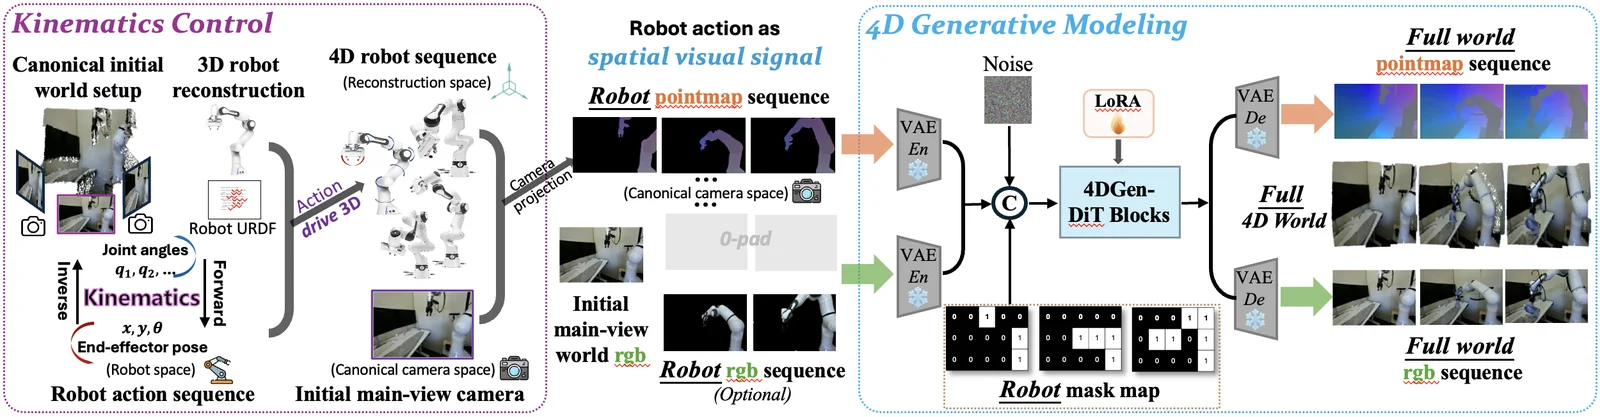
青稞Talk 青稞Talk预告!NTU MMLab 博士后许牧天:面向时空具身仿真的运动学 4D 世界建模 Kinema4D 在具身智能领域,模拟机器人轨迹至关重要。近期,研究者开始利用视频生成模型来进行模拟,但仍存在关键缺陷: (1) 维度缺失:局限于 2D空间,缺乏交互所需的 4D 时空约束; (2) 精度不足:依赖语言指令、隐式动作理解、或静态环境先验,使得模型需要去"猜测"潜在的机器人动作,难以提供精确控制和动态引
精选文章 高德最新开源 ABot-M0.5: 统一移动操作的世界-动作模型 作者:杨燕丹,高德地图算法工程师 导语:通用机器人的终极考验,在于能否在复杂多变的物理世界中实现“边走边操作”(Mobile Manipulation)。今日,备受瞩目的具身智能最新成果ABot-M0.5正式发布。本文工作由高德地图完成,是ABot-Manipulation系列继ABot-M0之后的
精选文章 预训练构建想象,微调驱动行动:World-Action Models 的崛起 原文链接:https://developer.nvidia.com/blog/pretrained-to-imagine-fine-tuned-to-act-the-rise-of-world-action-models 背景 视觉动作策略负责将当前观测与目标或指令相融合,映射为机器人的执行动作。世
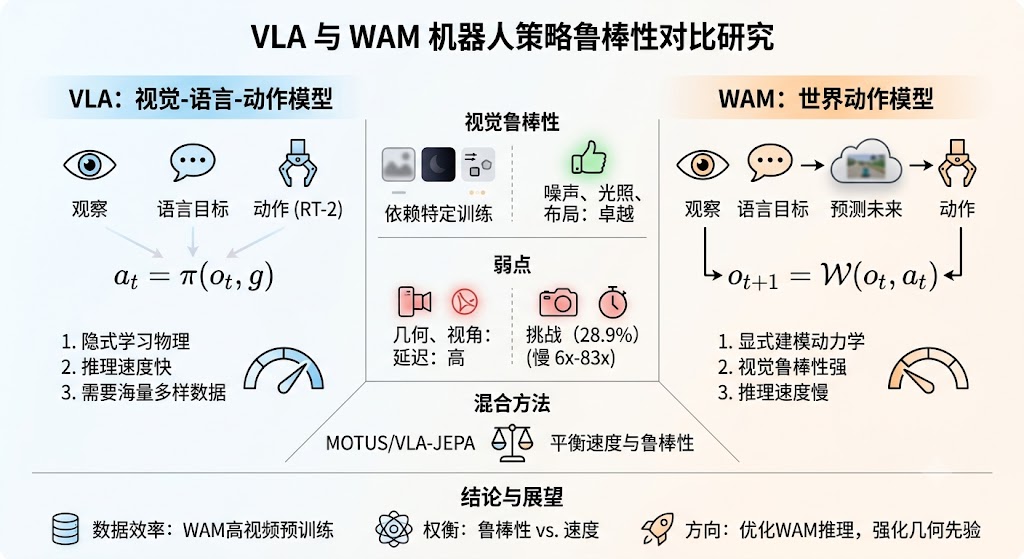
精选文章 World Action Models 真的比 VLAs 更强吗? 作者:Kadima-Du 原文:https://zhuanlan.zhihu.com/p/2030412523703379683 研究人员比较了视觉-语言-动作(VLA)模型和世界动作模型(WAM)在各种视觉和语言扰动下机器人策略的鲁棒性。 WAMs由于其视频预训练,在噪音、光照和布局变化方面表现出
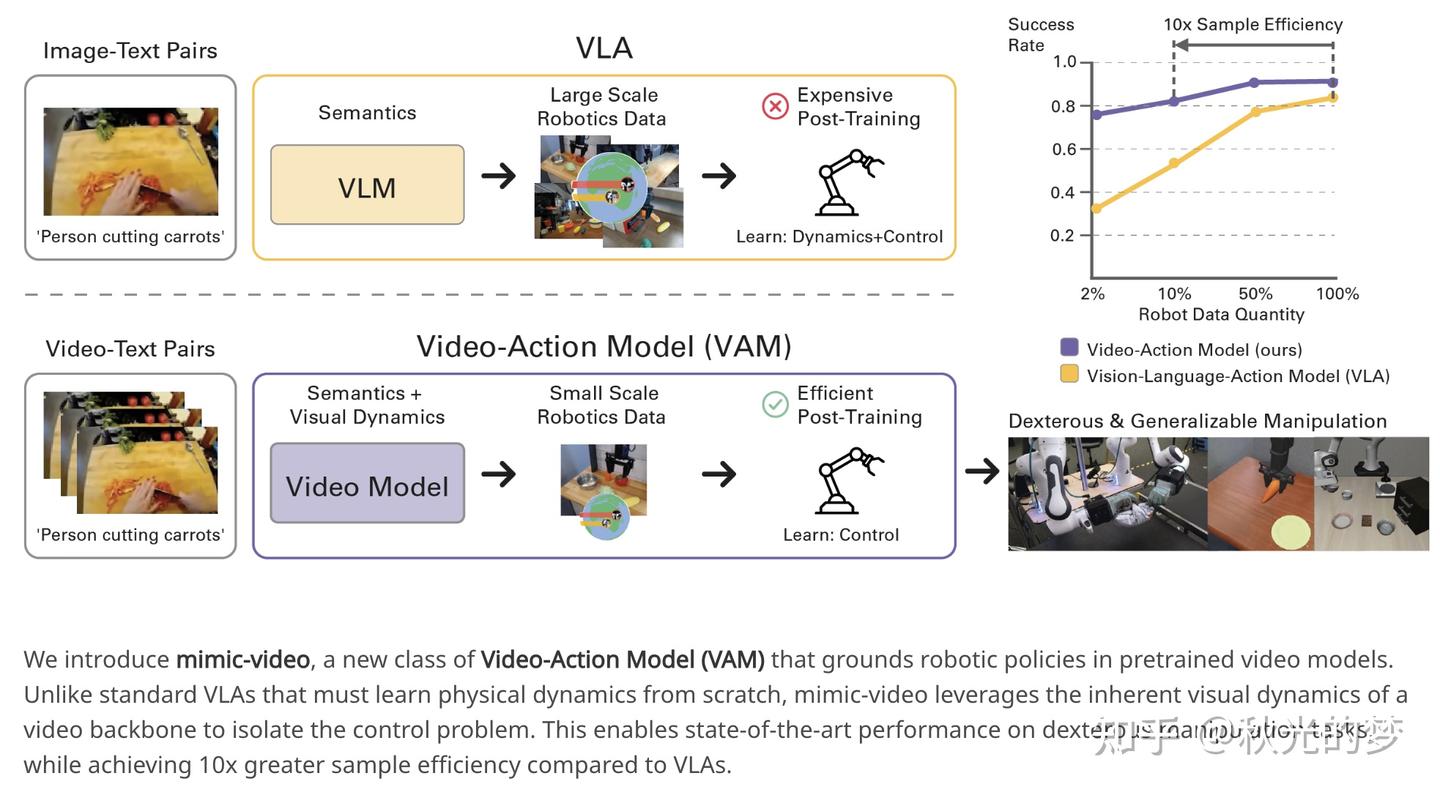
精选文章 World Model VLA:真的是形似而神不似? 作者:秋光的梦 https://zhuanlan.zhihu.com/p/2003112989201553035 近期许多基于视频生成网络的VA(也可以说是WAM)的工作,从25年末的LVP到Mimic-Video再到最近比较火的Lingbot-VA以及两篇NVIDIA的工作Cosmos Polic
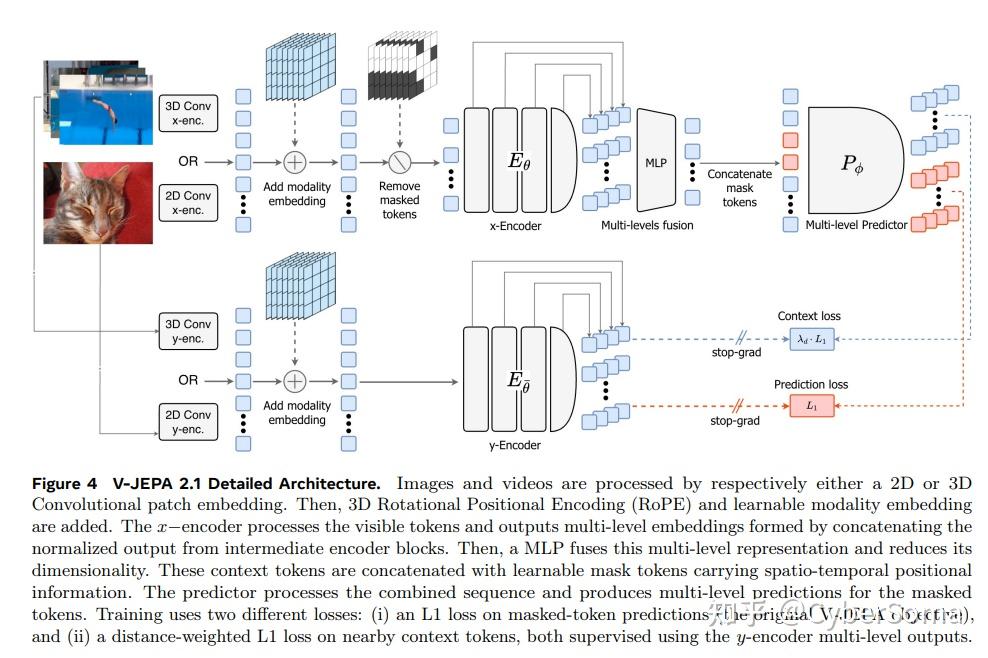
精选文章 我们离世界模型还有多远?Yann LeCun提出的自主机器智能愿景到哪层了?关于JEPA家族发展现状研究 作者:CyberSoma https://zhuanlan.zhihu.com/p/2022391438546072926 JEPA的愿景框架与工作进展 提起世界模型& JEPA,JEPA就是不抠像素(细节),只学抽象规律,预测未来,确实的本质特征,相比生成式AI要省算力。要知道2022年Yann提
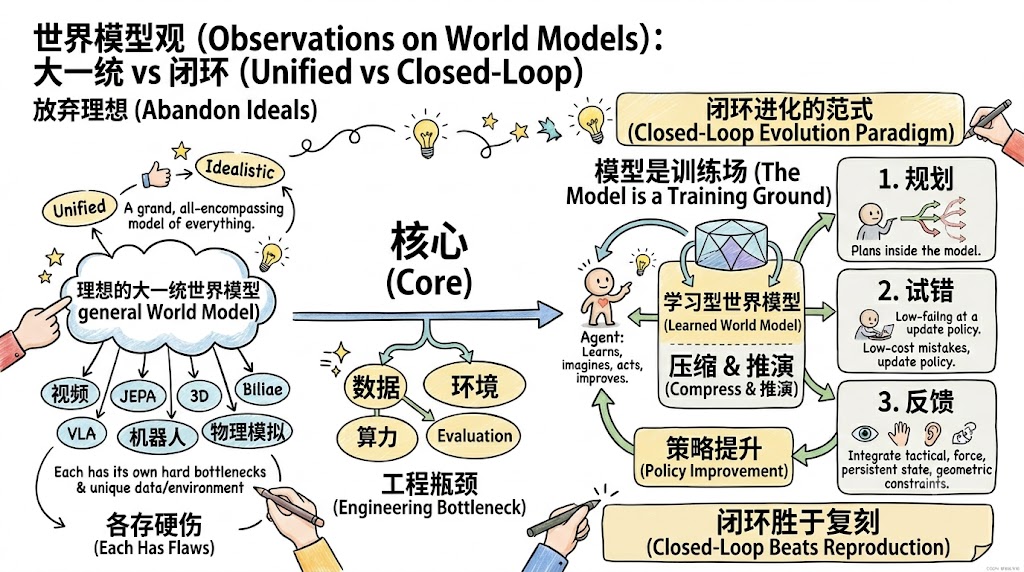
精选文章 World Model方向观察:大一统很远,闭环进化更近 作者:Kiki Huang http://xhslink.com/o/9vI0xkOqra3 最近集中听了几场 world model 相关分享,听下来我最大的感受是:大家其实都在逐渐放弃一种过于理想化的大一统模型想象。 不是说没人想做 unified model,而是落到具体问题上,video、J
精选文章 从 LLM 的局限到世界模型:LeWorldModel 为何更接近 AI 的第一性原理? 作者:小太阳 https://zhuanlan.zhihu.com/p/2038976197065963264 引言 笔者最近在阅读《LeWorldModel》论文和《第一性原理》一书时,偶然发现两者在方法论上有某种相通之处,于是想写下这篇博客,记录自己的一段学习与思考。 当前,大语言模型(LLM)
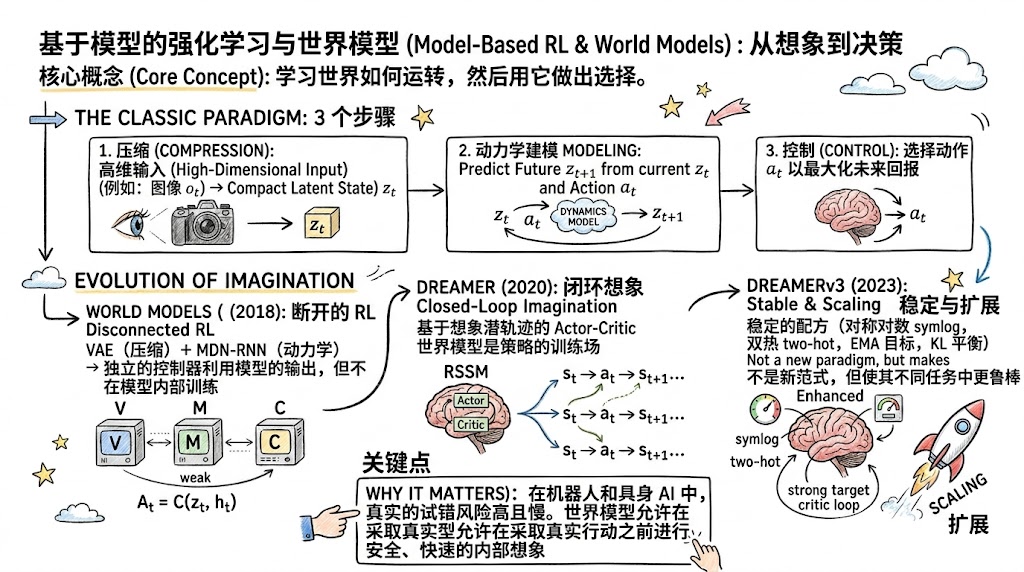
精选文章 Model-Based RL 与世界模型!拆解 Latent 世界模型范式 一、为什么具身智能重新关注世界模型? "世界模型"在具身智能领域似乎又变成了一个高频词,它为什么又回到了热门呢,和传统强化学习又有哪些区别? 首先,从 Model-Based RL 的视角看,世界模型并不是一个全新的概念,它可以理解为 Model-Based RL 中的 learned dynami
精选文章 还在用 2D 空间训具身?南洋理工 MMLab 提出 4D 具身世界模拟器,构建虚拟与现实的时空桥梁! 本文第一作者许牧天,南洋理工大学MMLab博士后。导师刘子纬教授,为本文通讯作者。 机器人-环境交互模拟是具身智能的核心。近期,一些研究展现了利用视频生成技术突破传统模拟器“僵化”的视觉与物理限制的潜力。 然而,这些工作主要在 2D 空间运行、或受制于静态环境的单一引导,忽略了一个基本事实:机器人与
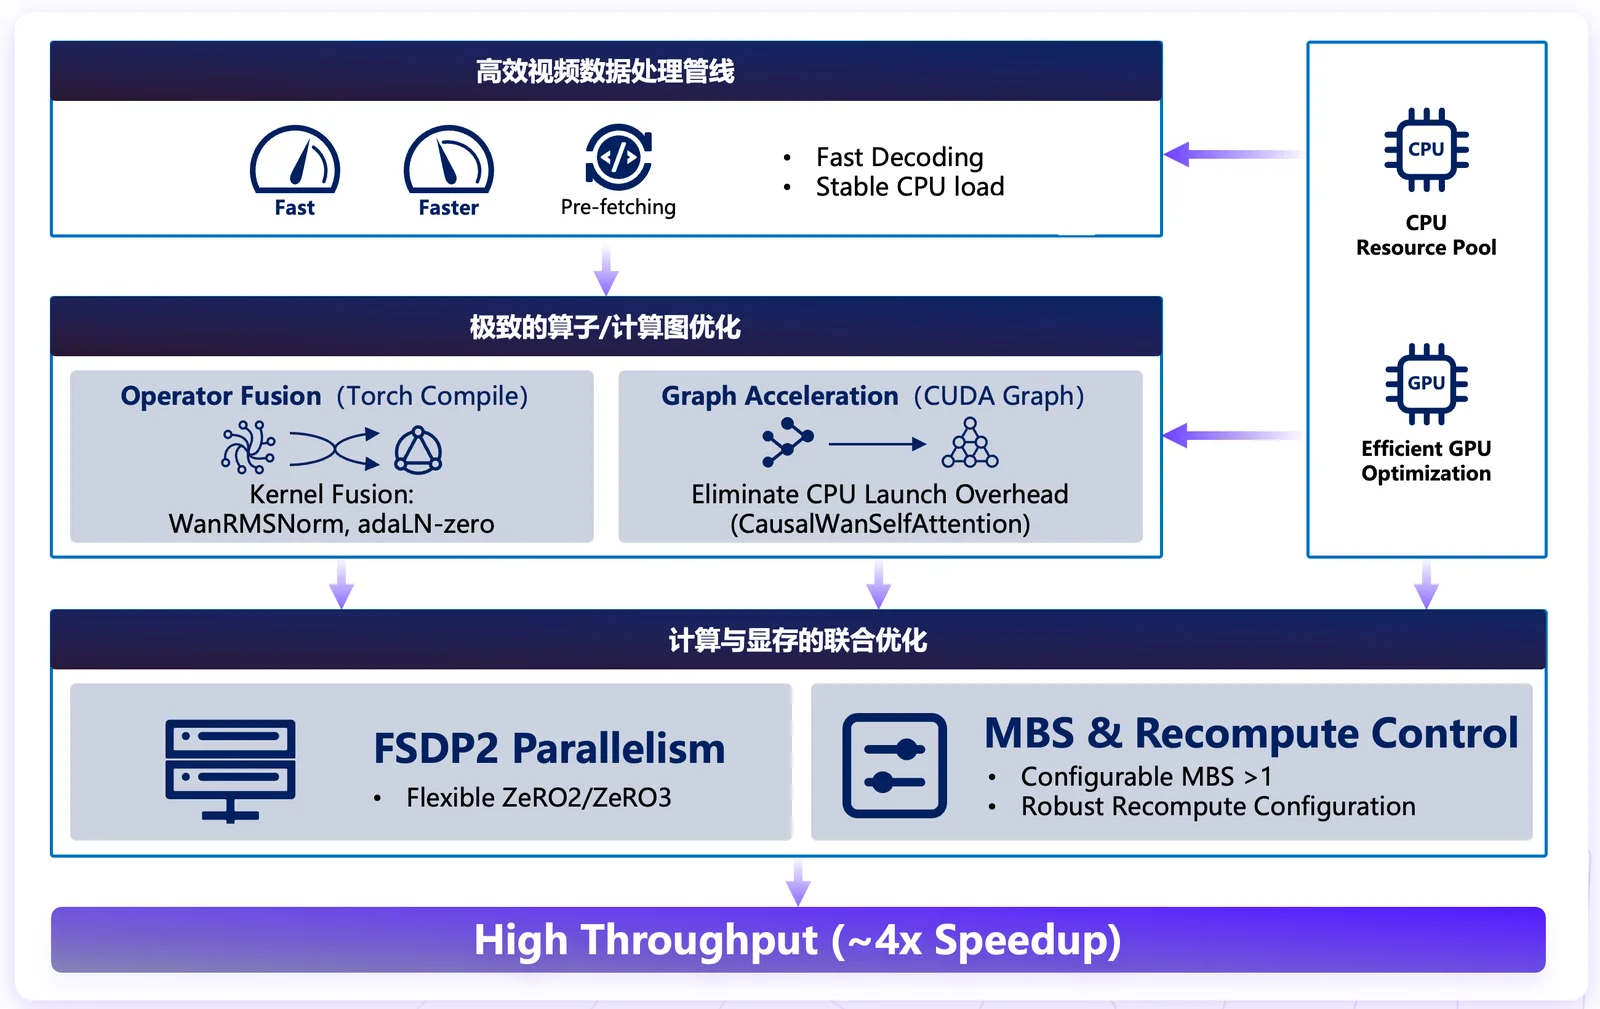
精选文章 近 4 倍训练吞吐加速,RLinf 怎样让世界动作模型 DreamZero 训练时长从 1 个月缩短至 1 周? 在通往AGI的道路上,世界模型(World Model)被视为让AI真正理解并预测物理世界的关键拼图。英伟达近期重磅发布的世界动作模型(WAM)DreamZero 一经发布就在两项机器人基准测试RoboArena,MolmoSpaces上双双登顶,在具身智能领域获得极大关注。 与传统VLA等模型不同
精选文章 关于 Physical AI 第一性原理的思考:理解世界、预测世界、改造世界 作者:Naiyan Wang https://zhuanlan.zhihu.com/p/2032931834288419524 在 xLM 席卷虚拟世界的各种应用后,大家谈论的下一个热点自然迁移到 Physical AI(物理世界 AI)。 抛开繁杂的具体技术架构,我们回归第一性原理来思考:一个系统
青稞AMA 直播预告!深度探讨:世界模型(World Model)是进化终点还是视觉幻象? 物理智能的“预言家”:世界模型(World Model)是进化终点还是视觉幻象? 在具身智能的演进历程中,我们正处于从“机械模仿”向“认知决策”跨越的关键节点。早期的模型主要依赖行为克隆,但在涉及精密操作时难以为继。 如今,世界模型正成为连接数字智慧与物理交互的桥梁,它不仅让机器人知道“做什么”,更
精选文章 思考 World Action Model!从 Masked World Model 到 Fast WAM 和 Cosmos Policy 作者:钱泽中 原文:http://xhslink.com/o/7qoBKO5BfoI 前言 前两天ICML刚结束,合作的一个项目从3.25 rebuttal涨分到了3.75着实很厉害,这个paper主要做的事情是让world model从预测RGB改为预测Mask,然后增强了鲁棒性。他claim的点
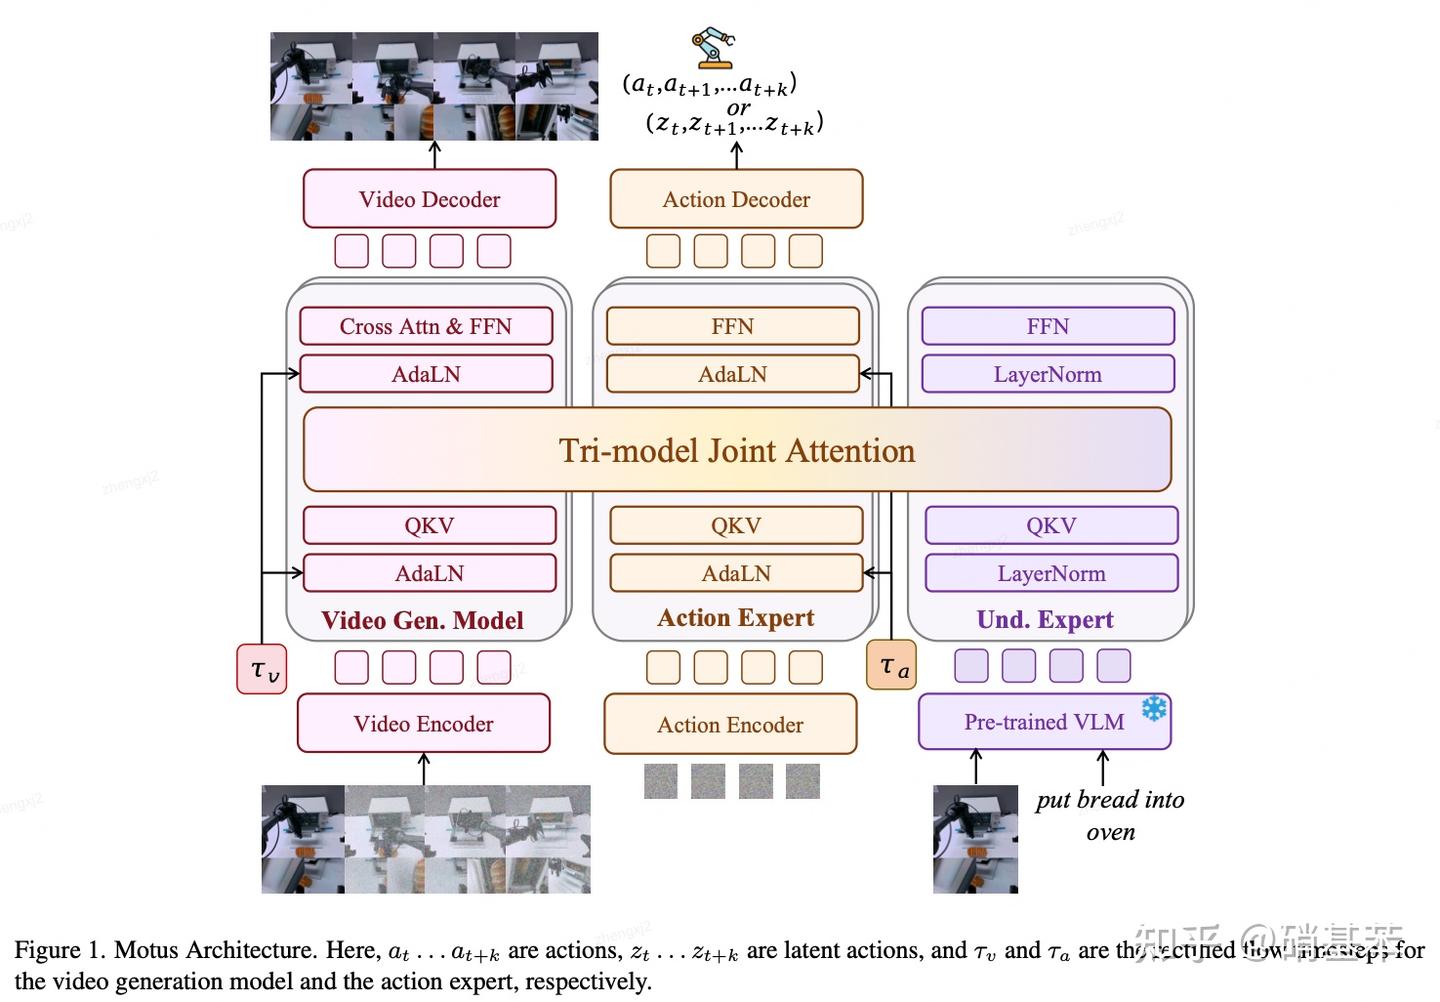
精选文章 关于 World Action Model 的思考和总结 作者:硝基苯 https://zhuanlan.zhihu.com/p/2019875354538428076 写在前面 从过年一直到现在,World Action Model这个概念很火,学术界有很多工作(Cosmos Policy, DreamZero, Motus, LingBot-VA, F
青稞Talk Puffin: 统一多模态空间智能大模型——从任意视角理解和生成世界 多模态空间智能不仅要求机器理解任意相机视角下的现实世界,更要求其具备从任意相机方位创造世界的能力。然而,当前的视觉与生成模型大多仅隐式地感知相机几何,或将理解与生成任务割裂开来。 新加坡南洋理工大学、商汤科技、密西根大学和马普所的研究者们联手提出了一种全新的范式——将“相机几何”破译为一种“语言”,
青稞Talk RISE: 组合式世界模型,在“想象”中实现机器人策略的自主进化 在具身智能领域,物理世界中的强化学习(RL)长期受限于高昂的硬件成本、繁琐的环境重置需求以及试错过程带来的安全风险 。 为此,OpenDriveLab提出了RISE,一种通过“想象”来实现机器人策略自主进化的可扩展强化学习框架 。 论文:RISE: Self-Improving Robot Poli
精选文章 世界模型正在重塑机器人大脑!解析World Model × 具身智能的最新论文 作者:gurubar 原文:https://zhuanlan.zhihu.com/p/1974055240048345546 为什么World Model 在Robotics领域中非常重要? 从理论与认知科学角度,Schmidhuber 等人长期主张“智能 = 学会一个可压缩、可预测的世界”;Ha