工业级 LLM 预训练数据工程的关键实践!
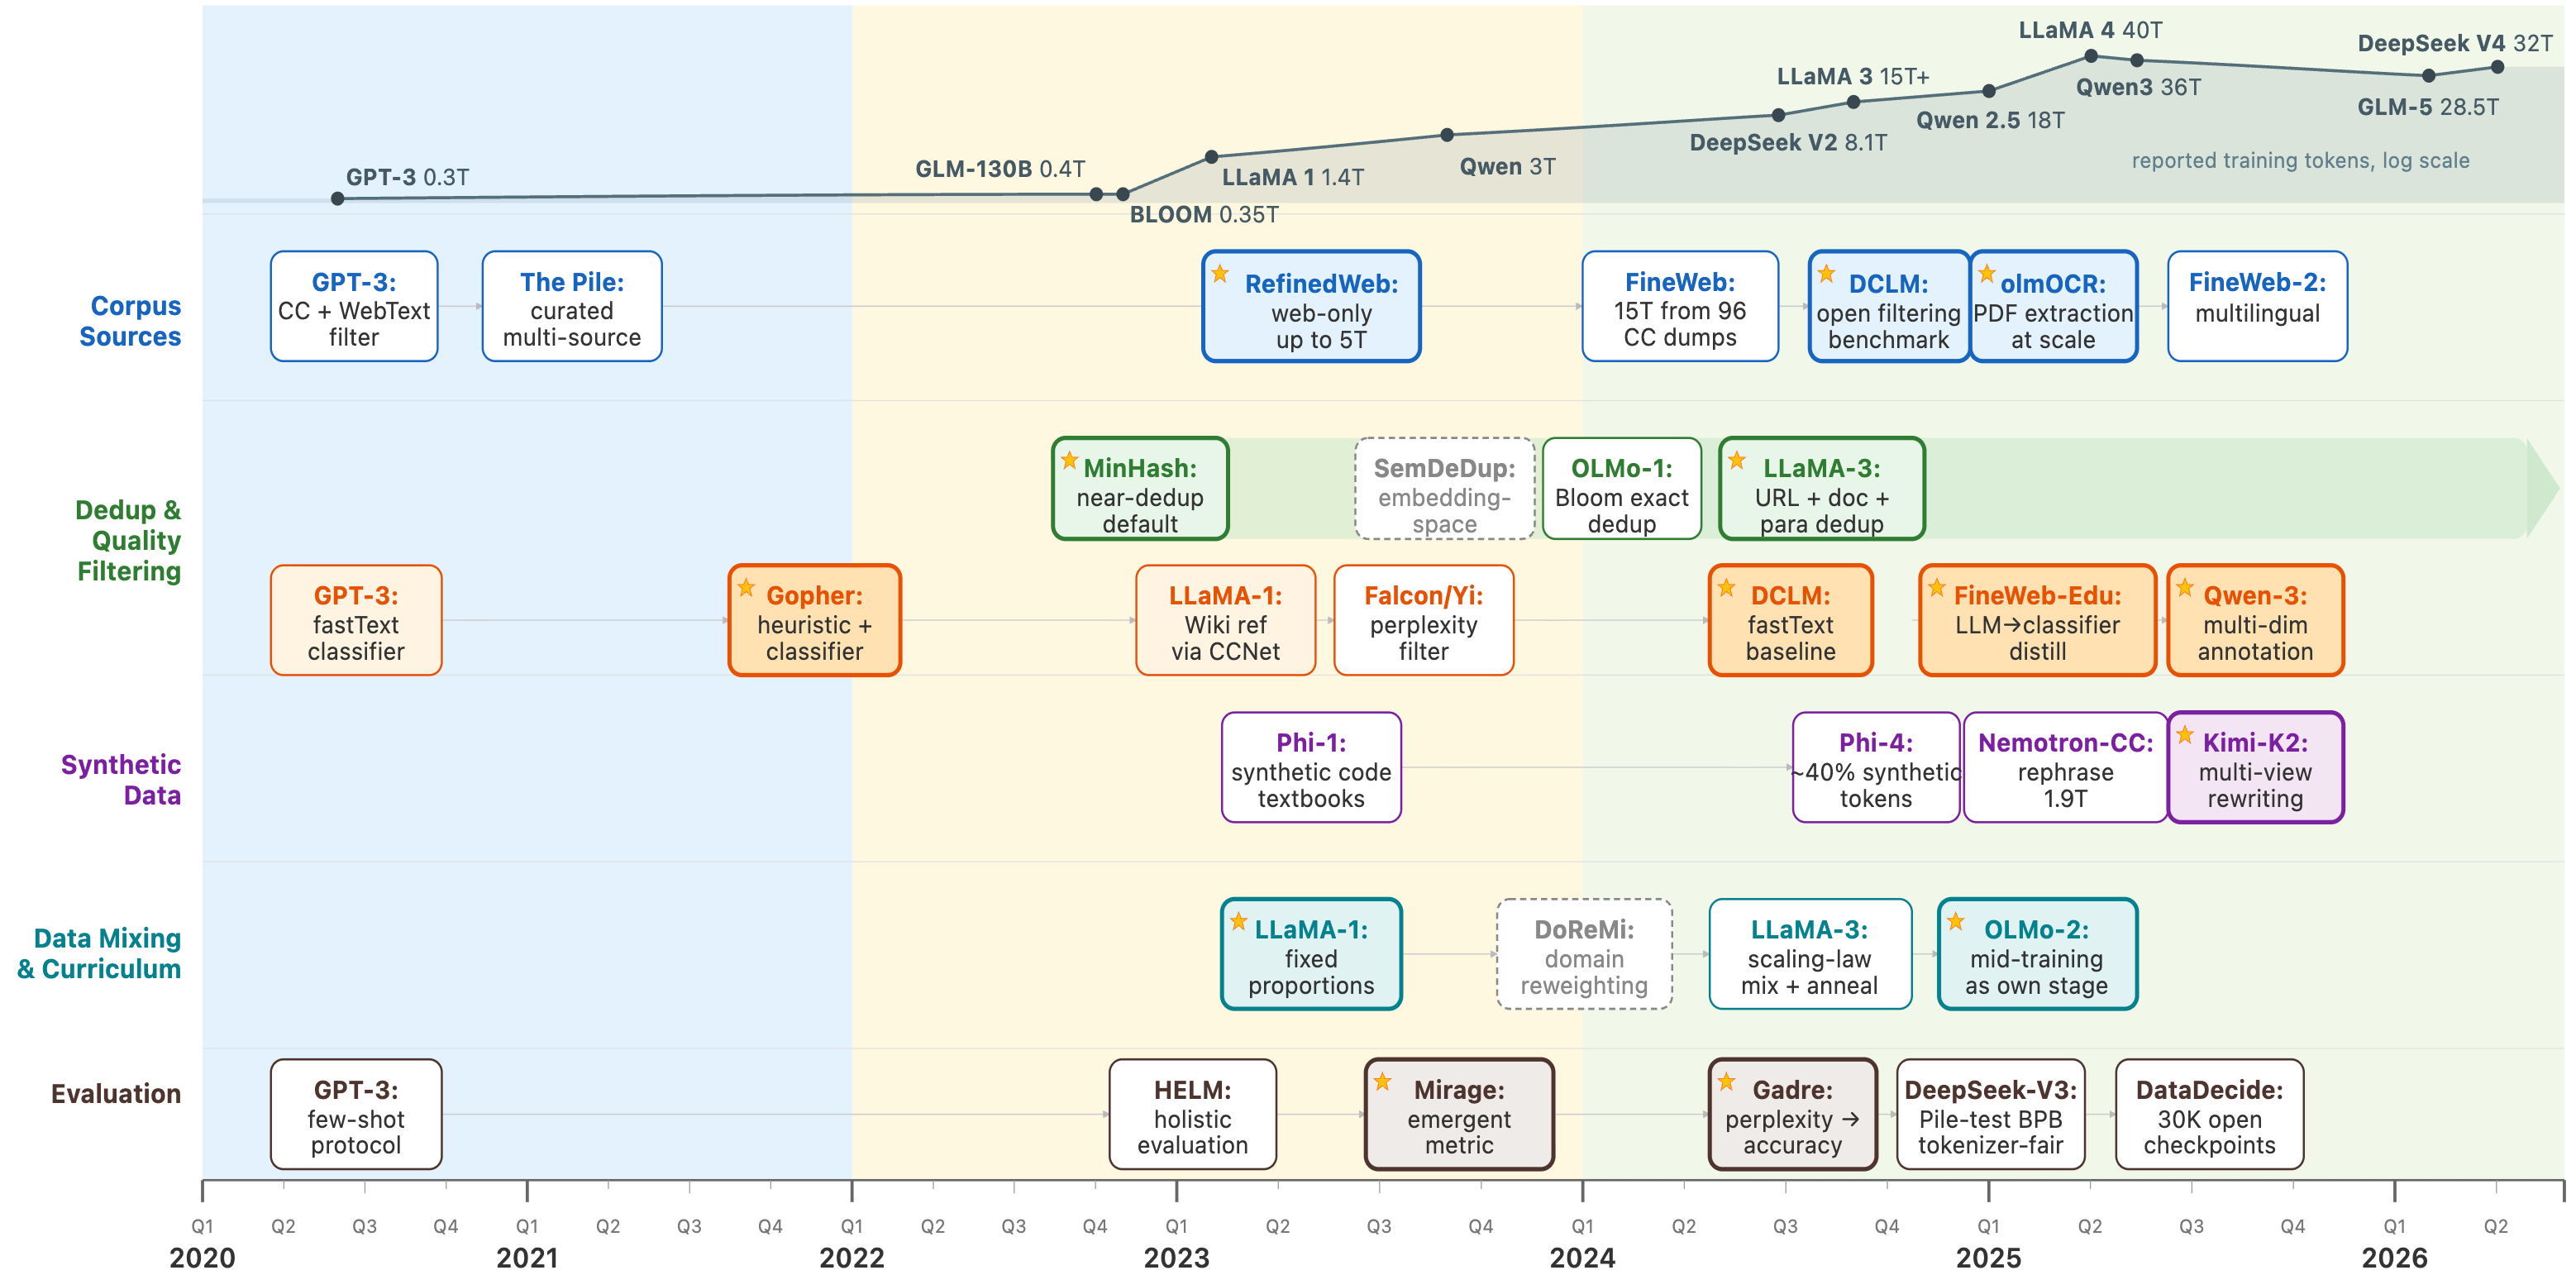
作者:李煜东 Yudong https://zhuanlan.zhihu.com/p/2032080549381190858 写在前面: LLM 研究的关注重心正在这几年内不断转移,从post train到强化学习再到agentic/harness工作流。这些都体现了技术前沿和社区焦点的演进。对于用
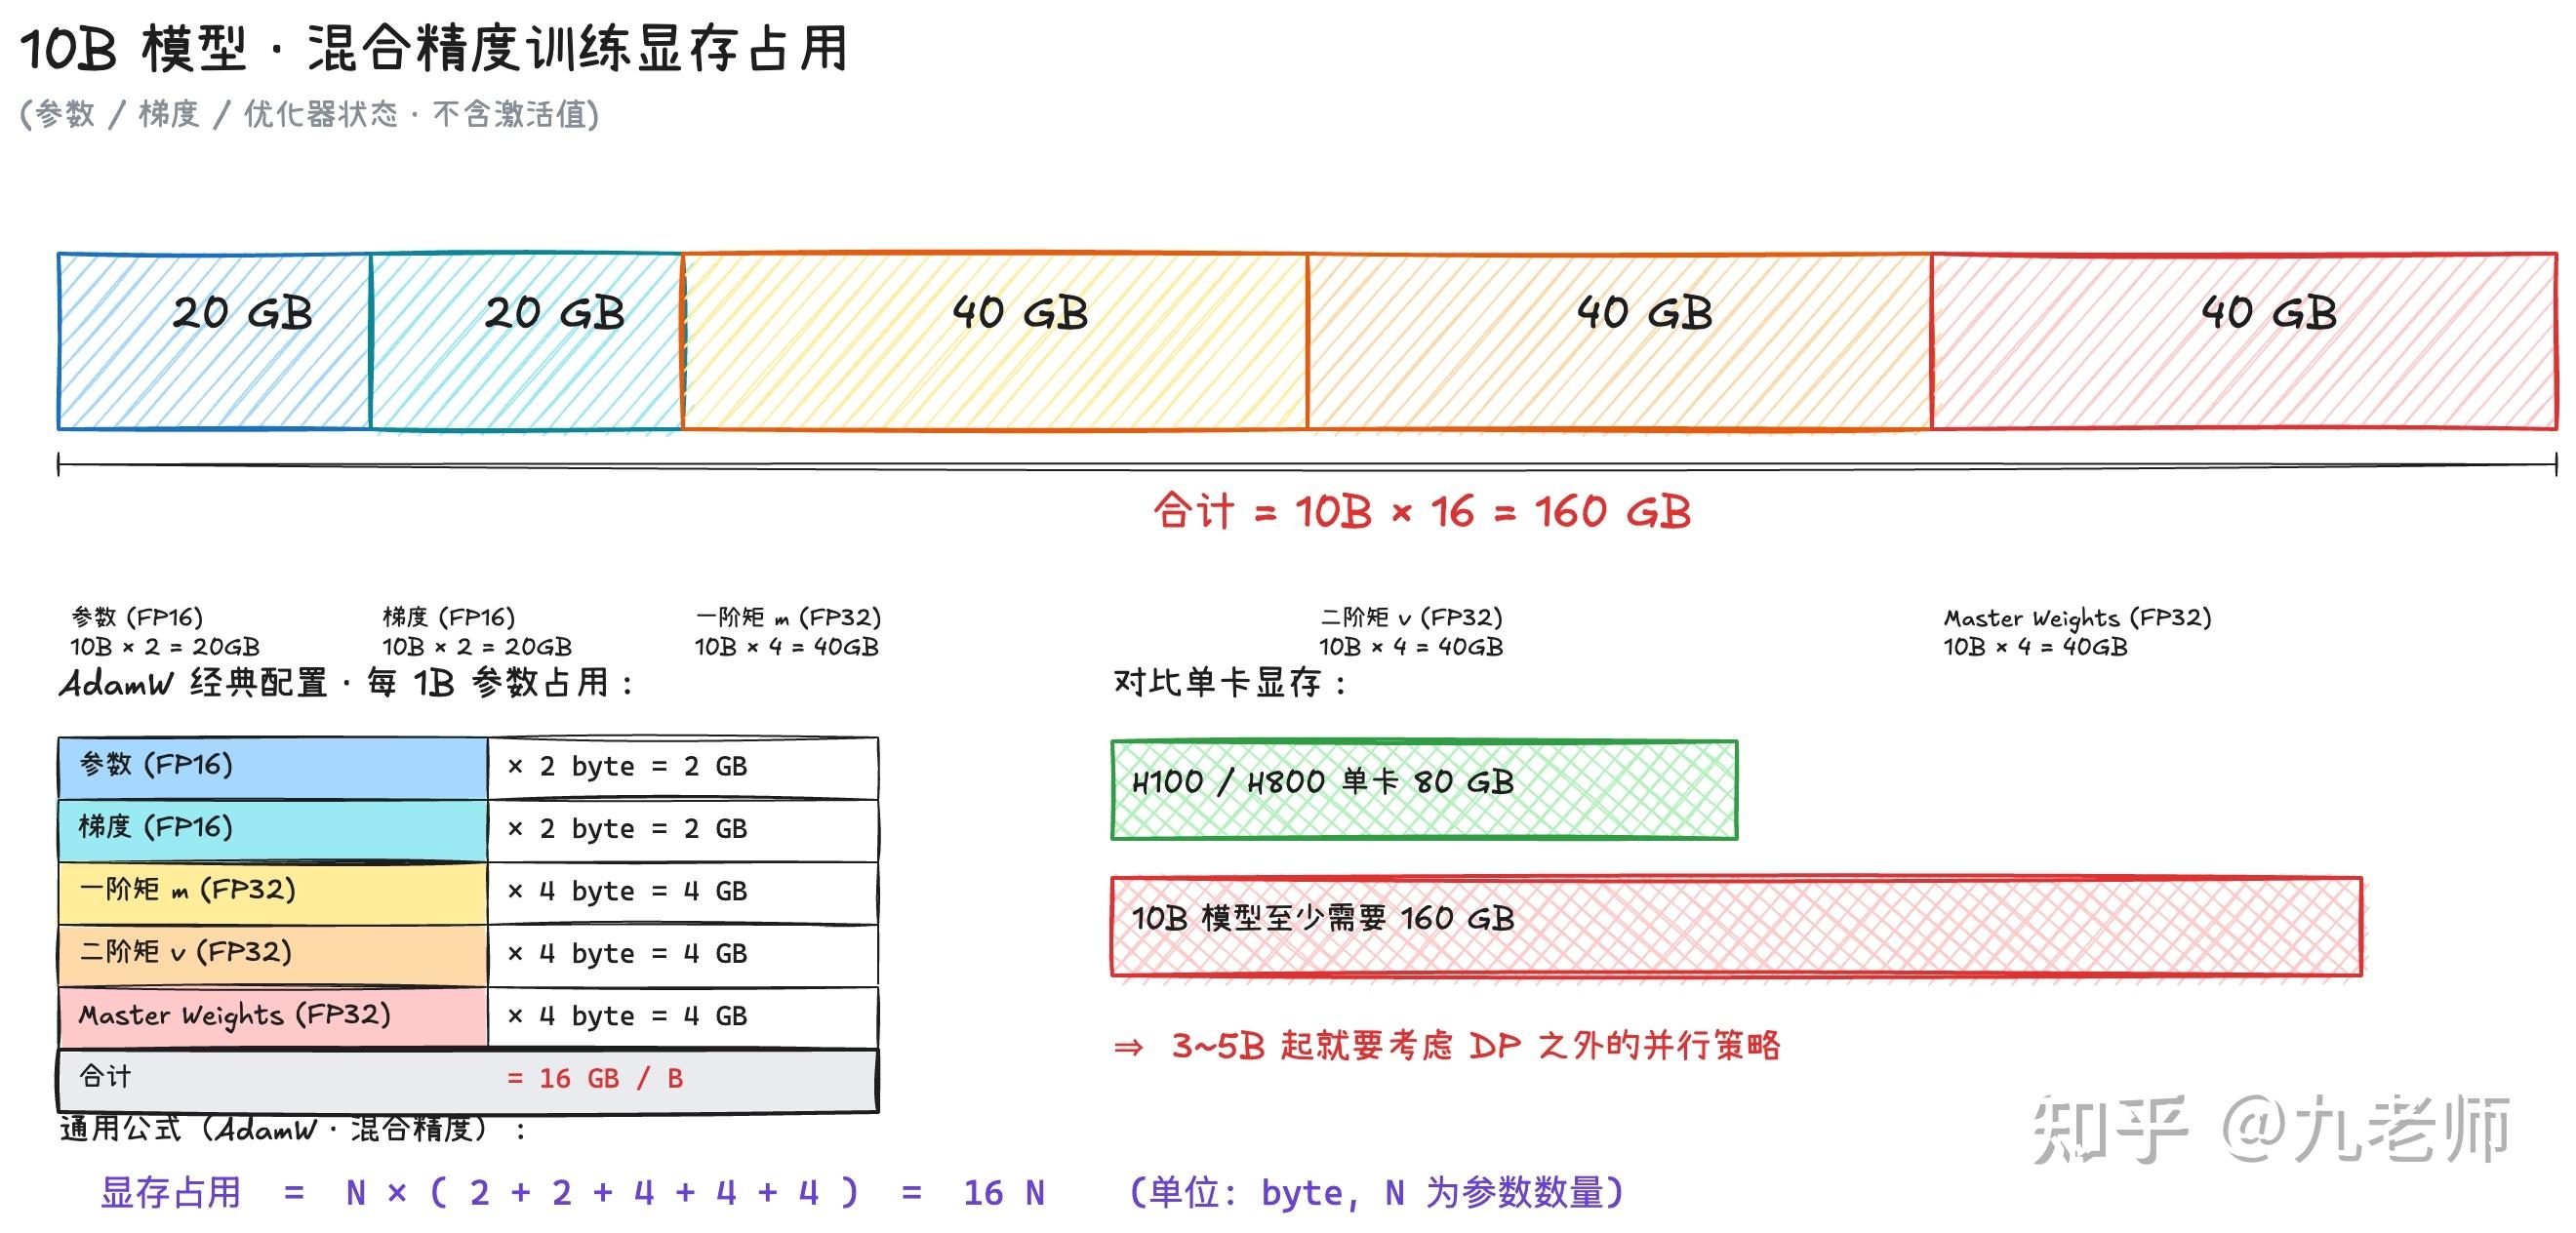
作者:九老师 https://zhuanlan.zhihu.com/p/2034669267807888405 最近模型从Dense切到了MoE,MFU 也相应地暴跌了,大家直觉上觉得Expert被切的很小,所以计算强度上不去,但实际切分完的维度至少也有1024,MFU暴跌的原因一定不来自这里。 深
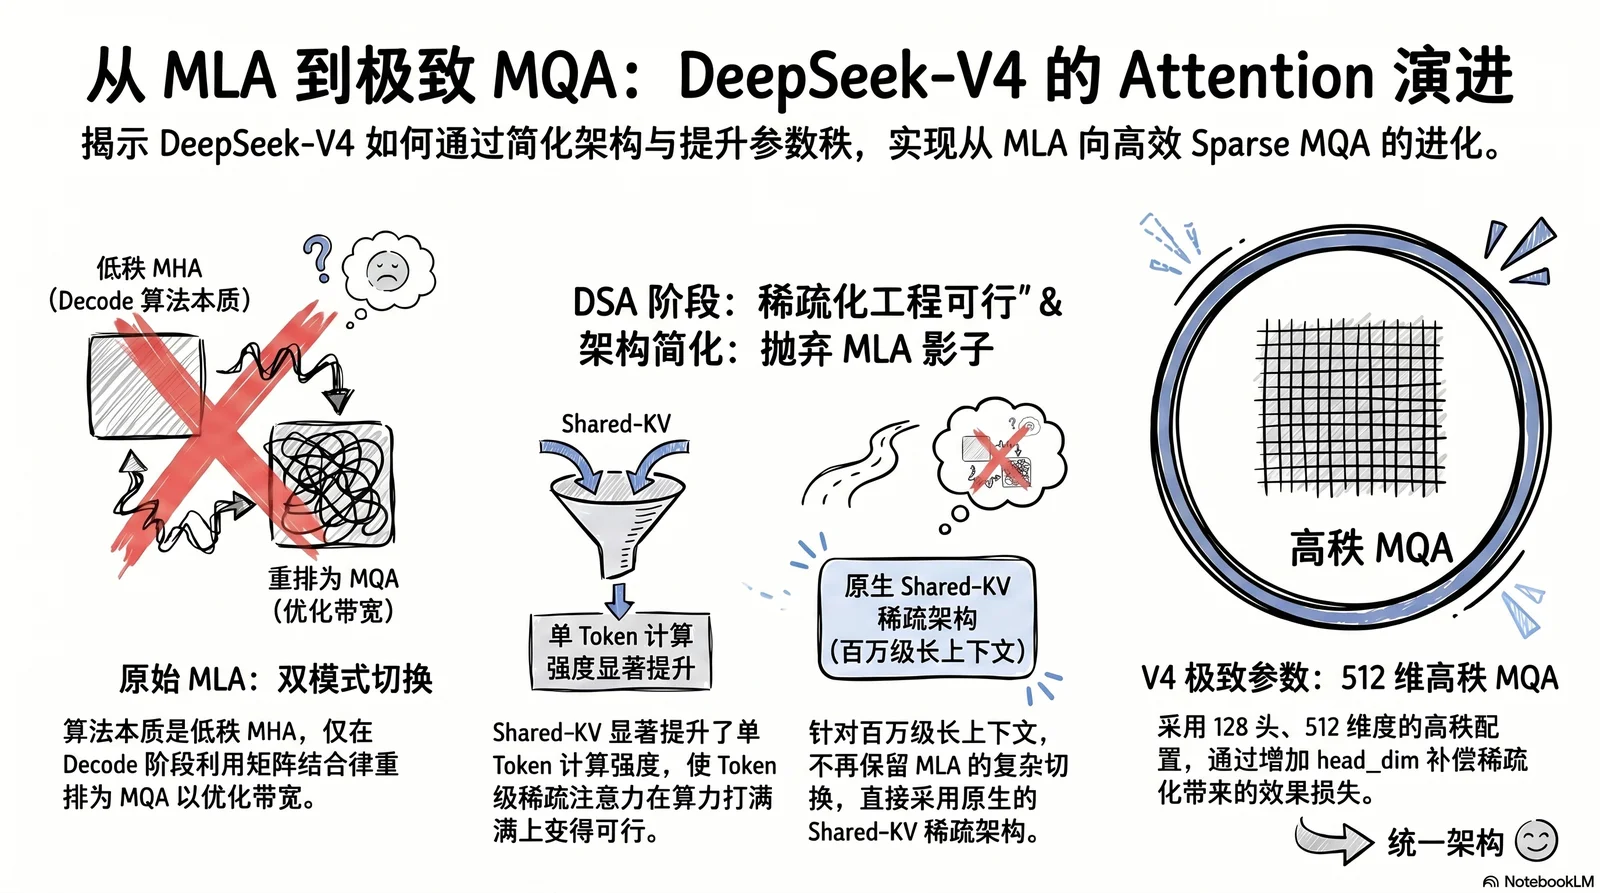
作者:YyWangCS https://zhuanlan.zhihu.com/p/2031149621397935813 DeepSeek-V4 的论文里已经基本看不到 MLA 形式的表述了,attention 部分是以原生 shared-KV MQA 的形式出现的,而且这个 MQA 还是 head
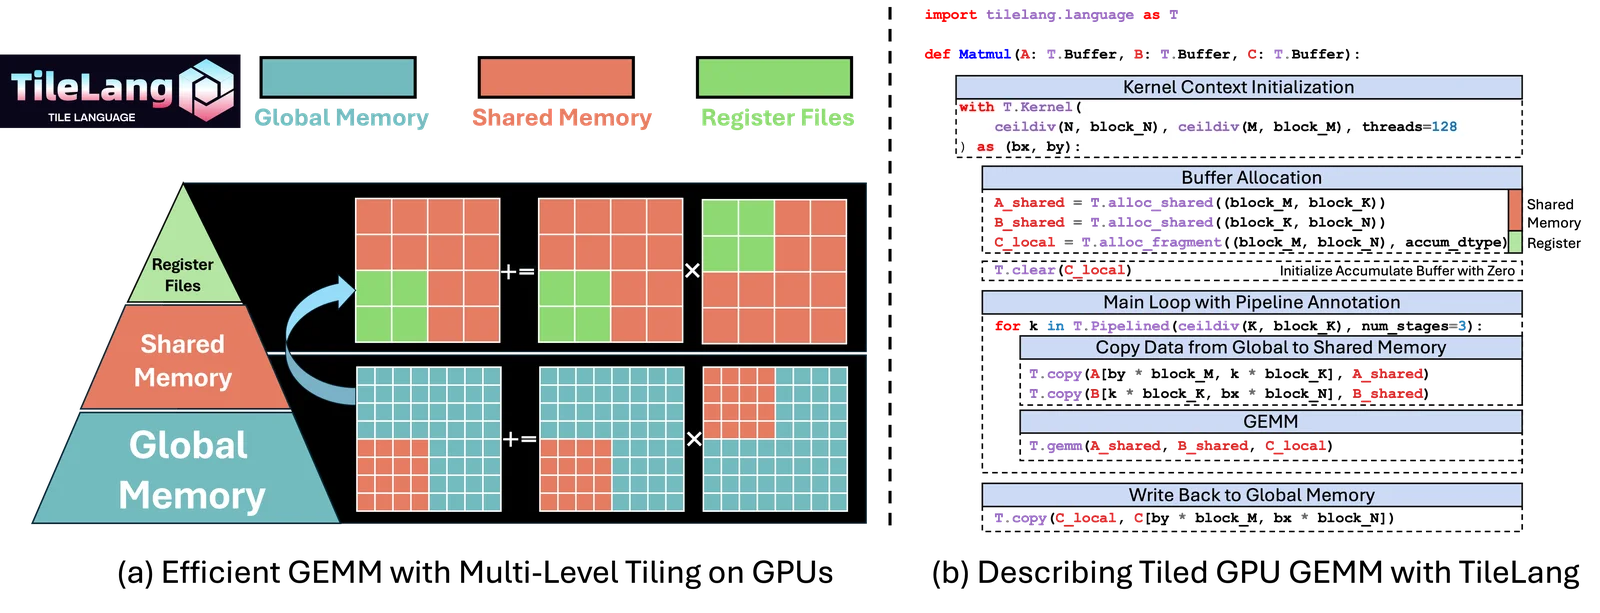
作者:SiriusNEO https://zhuanlan.zhihu.com/p/2033034202720022871 大家五一快乐!最近 V4 的技术报告讨论度很高,其中 TileLang 在报告中也占了一部分内容,主要是总结了社区最近的一些技术进展、以及其投入实际工业界应用后的一些打磨经验。
作者:九老师 https://zhuanlan.zhihu.com/p/2031622077107659474 2026 年了,一个 LLM 的训练流程并不陌生——pre-train,SFT,RLHF/RLVR。但实际这是一个领域 LLM 的训练方案,比如 Coder/Match/文本专家,怎么整合
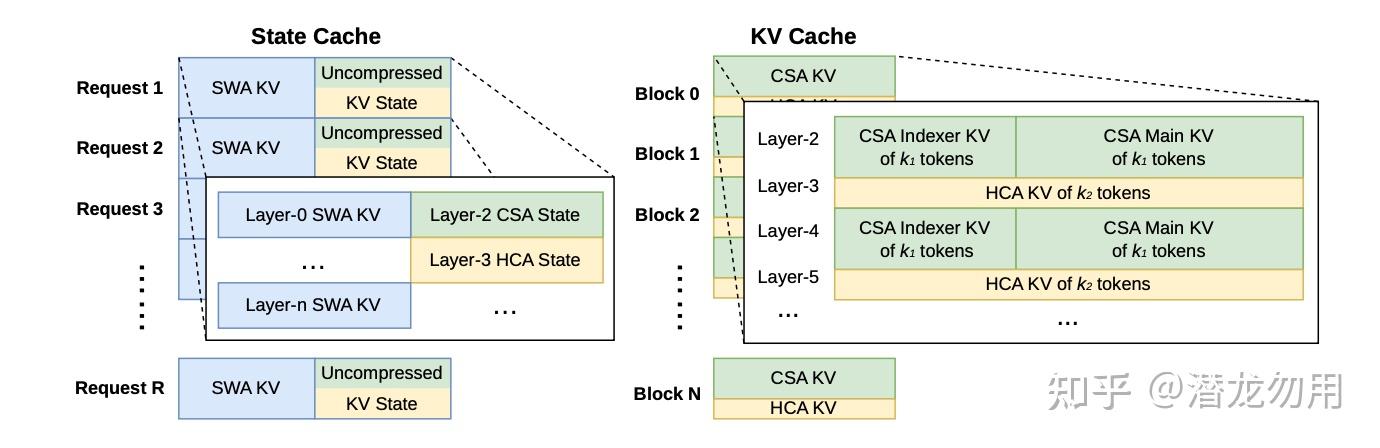
作者:潜龙勿用 https://zhuanlan.zhihu.com/p/2030982954617414764 这份技术报告发布了 DeepSeek-V4 系列的 preview 版本,包含两个 MoE 模型:DeepSeek-V4-Pro(总参数 1.6T,激活 49B)与 DeepSeek-V
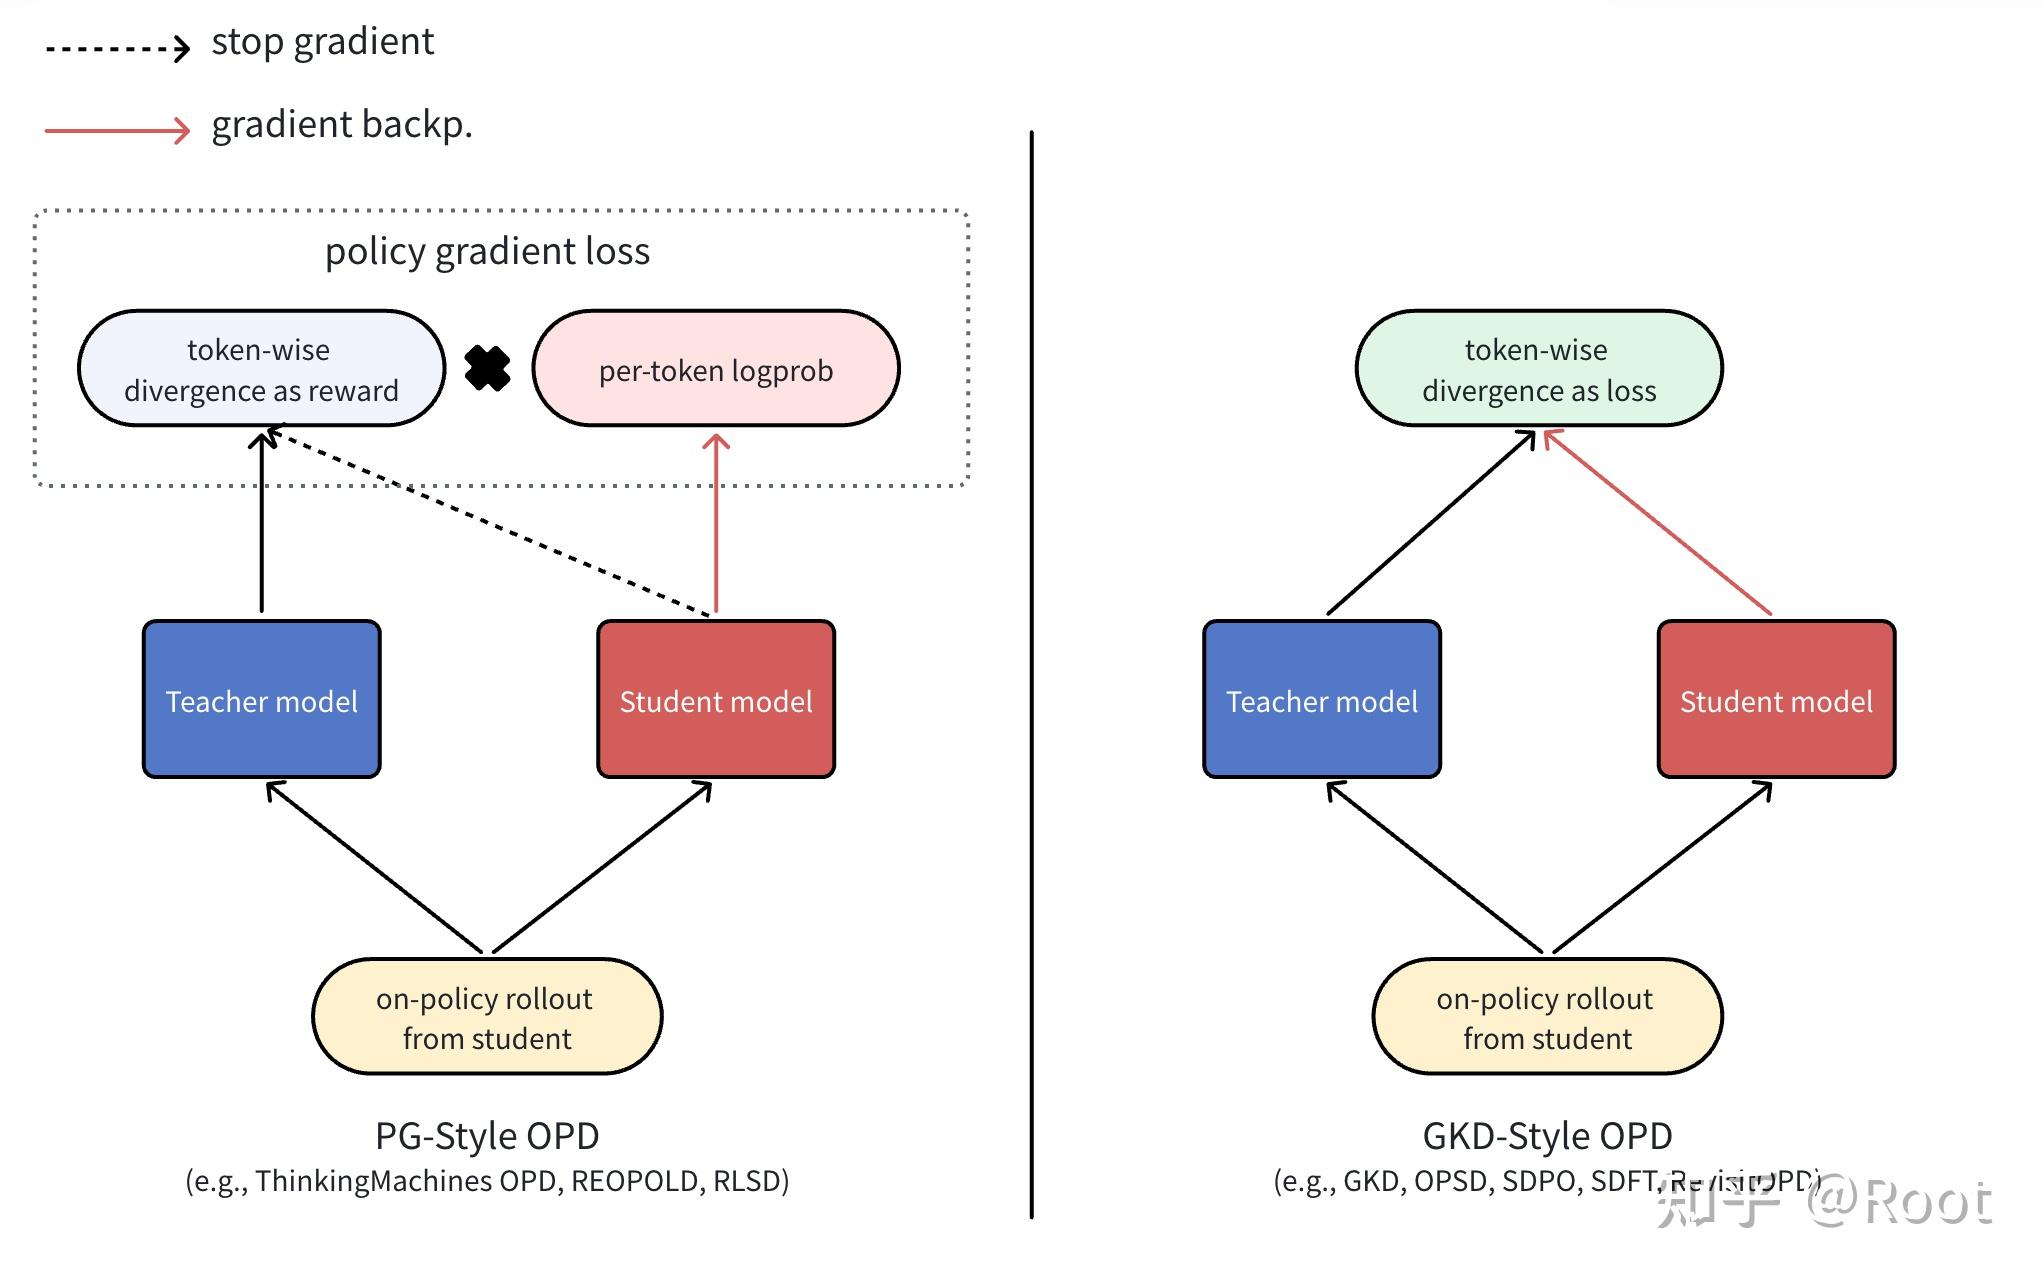
作者:Root 原文:https://zhuanlan.zhihu.com/p/2027548813129267030 前言 On-policy distillation最近在LLM后训练领域非常火,我也一直有在关注OPD/OPSD相关论文的进展。之前,我一直认为这波OPD热潮涌现的一系列方法都可以
作者:恰似故人归 https://zhuanlan.zhihu.com/p/2023482883415835093 这两年大家谈 LLM post-training,常见的叙事是两条线: 一条是 outcome reward 的 RL 一条是 teacher 提供 dense signal 的 kn
作者:Frankdark https://zhuanlan.zhihu.com/p/2026908932694647597 最近在做 RL-based knowledge distillation 的过程中,我们被一个老生常谈的问题折磨了很久:REINFORCE 的梯度方差太大,训练极其不稳定。 最
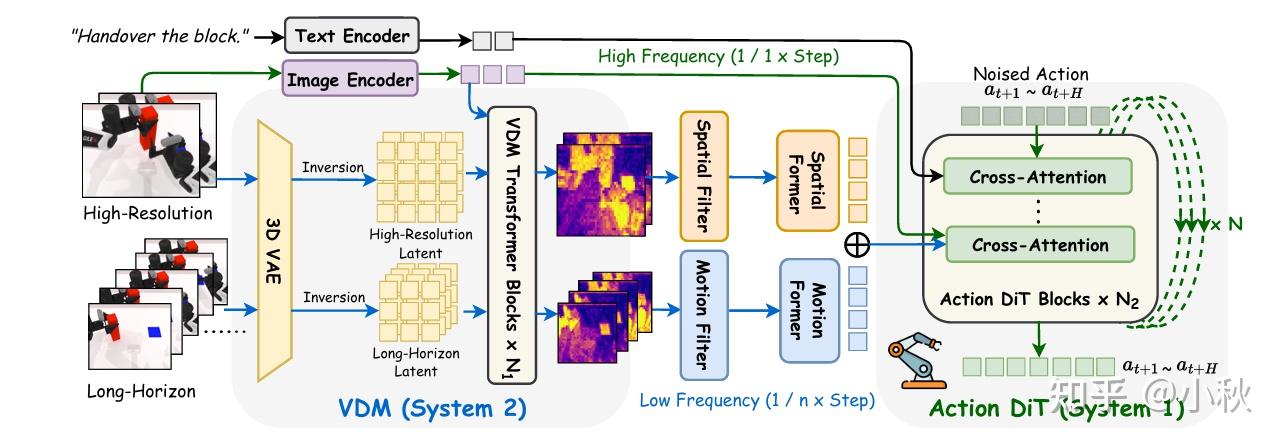
作者:钱泽中 原文:http://xhslink.com/o/7qoBKO5BfoI 前言 前两天ICML刚结束,合作的一个项目从3.25 rebuttal涨分到了3.75着实很厉害,这个paper主要做的事情是让world model从预测RGB改为预测Mask,然后增强了鲁棒性。他claim的点
作者:Yuwei Niu 应该是从去年做完WISE 开始,碰到我的朋友都以为我是做生成出身的,但其实我从最开始做科研就是沿着CLIP LLaVA的经典多模态理解路线,并且我心中也一直更喜欢多模态理解多一些。 然而,近一年以来,似乎社区的热度在多模态方面始终更倾向于生成(GPT-Image, Nano
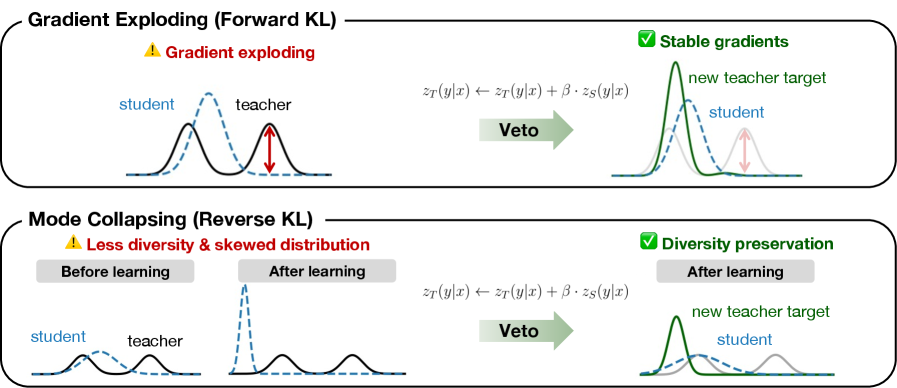
作者:欲壑难填 https://zhuanlan.zhihu.com/p/2024947723019843192 KL 散度是机器学习中的一个重要概念,其非对称性导致在实际中有 Forward KL 和 Reverse KL 两种形式,本文介绍这两种形式在优化过程中的差异,再讨论实际中应该如何选择。
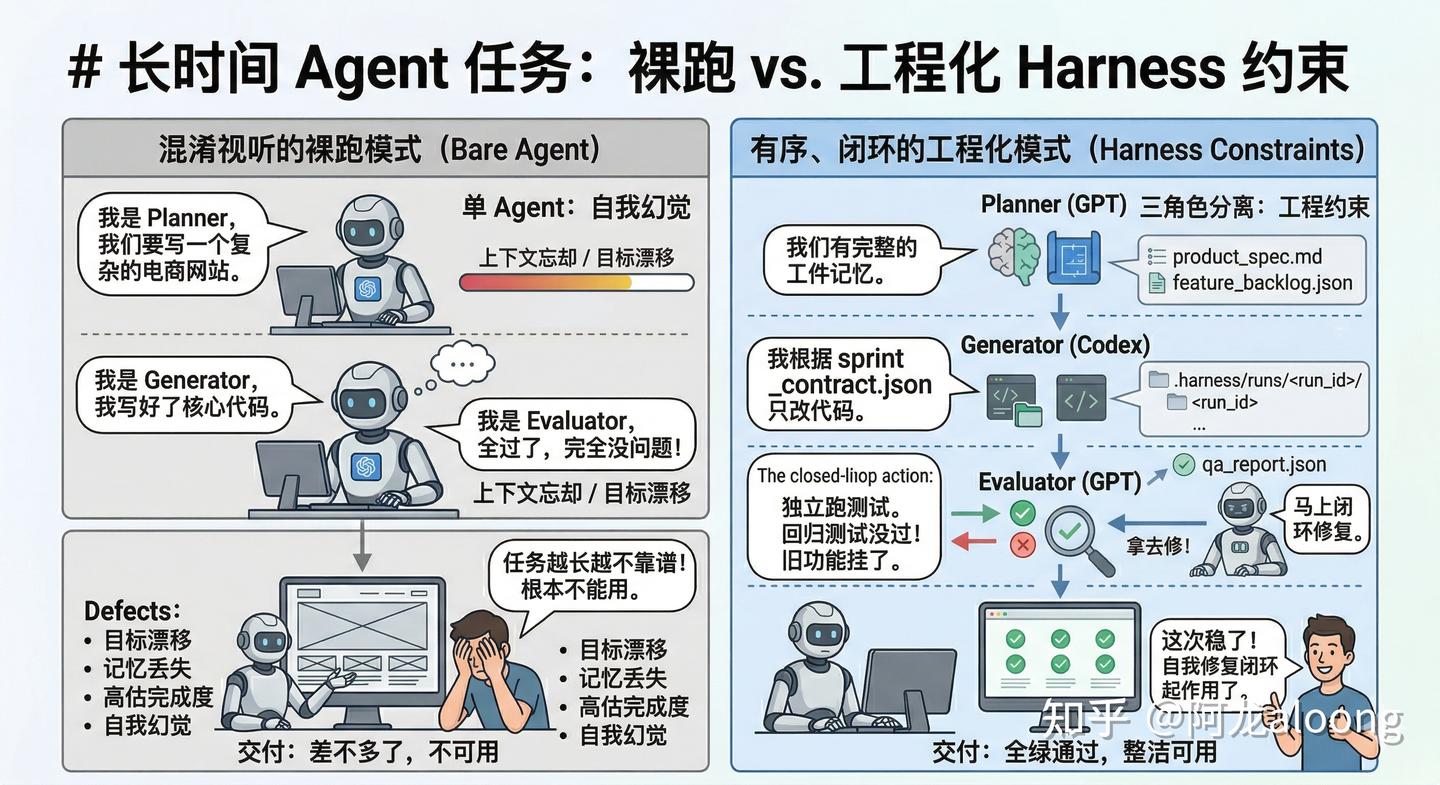
作者:阿龙aloong https://zhuanlan.zhihu.com/p/2021015362817328193 那篇文章改变了我对 agent coding 的看法 2026 年 3 月 24 日,Anthropic 发了一篇工程文章:Harness Design for Long-Run
作者:方弦 https://zhuanlan.zhihu.com/p/2020514624856957623 记录整理一下最近学习vllm和sglang源码的一些思考和笔记。 其中包含了和LLM交互问答得到的一些内容(源码分析和注释等部分),用于加深对现代高性能推理引擎实现的理解。分析基于的源码版本
随着大基础模型的崛起,视觉-语言-动作模型 (VLA) 展现出了极大的潜力,通过继承丰富的视觉理解和语言基础,为通用机器人策略学习提供了可扩展的途径。然而,目前的VLA研究领域依然处于一种“原始汤 (primordial soup)”阶段——充满了各种天马行空的探索和设计,但缺乏清晰的架构。 A组说
最近 Qwen Pilot 团队一直在研究 RL 如何解锁复杂推理能力。翻遍数据后,抓到了 3 个反直觉的发现: 1️⃣ RL 其实很“懒” 策略演化极稀疏 在 >98% 的生成步骤里模型没变,RL 并没有重写基座,它更像是个教练,只在关键逻辑分叉口轻轻推一把。 论文:Sparse but Crit
作者:hsj https://zhuanlan.zhihu.com/p/2023447662066762473 机器人不缺数据,缺的是把数据变成能力的结构 一、一个显而易见的问题,做了几年还是没解 Joe Harris 前阵子发了条推文,说机器人行业根本不缺数据,每家部署超过半年的公司都有 TB 级
作者:方弦 https://zhuanlan.zhihu.com/p/2023880667814003300 2026年4月2日,Google DeepMind发布Gemma 4。31B参数的dense模型在AIME 2026上拿到89.2%,MoE变体26B-A4B以3.8B活跃参数在MMLU P
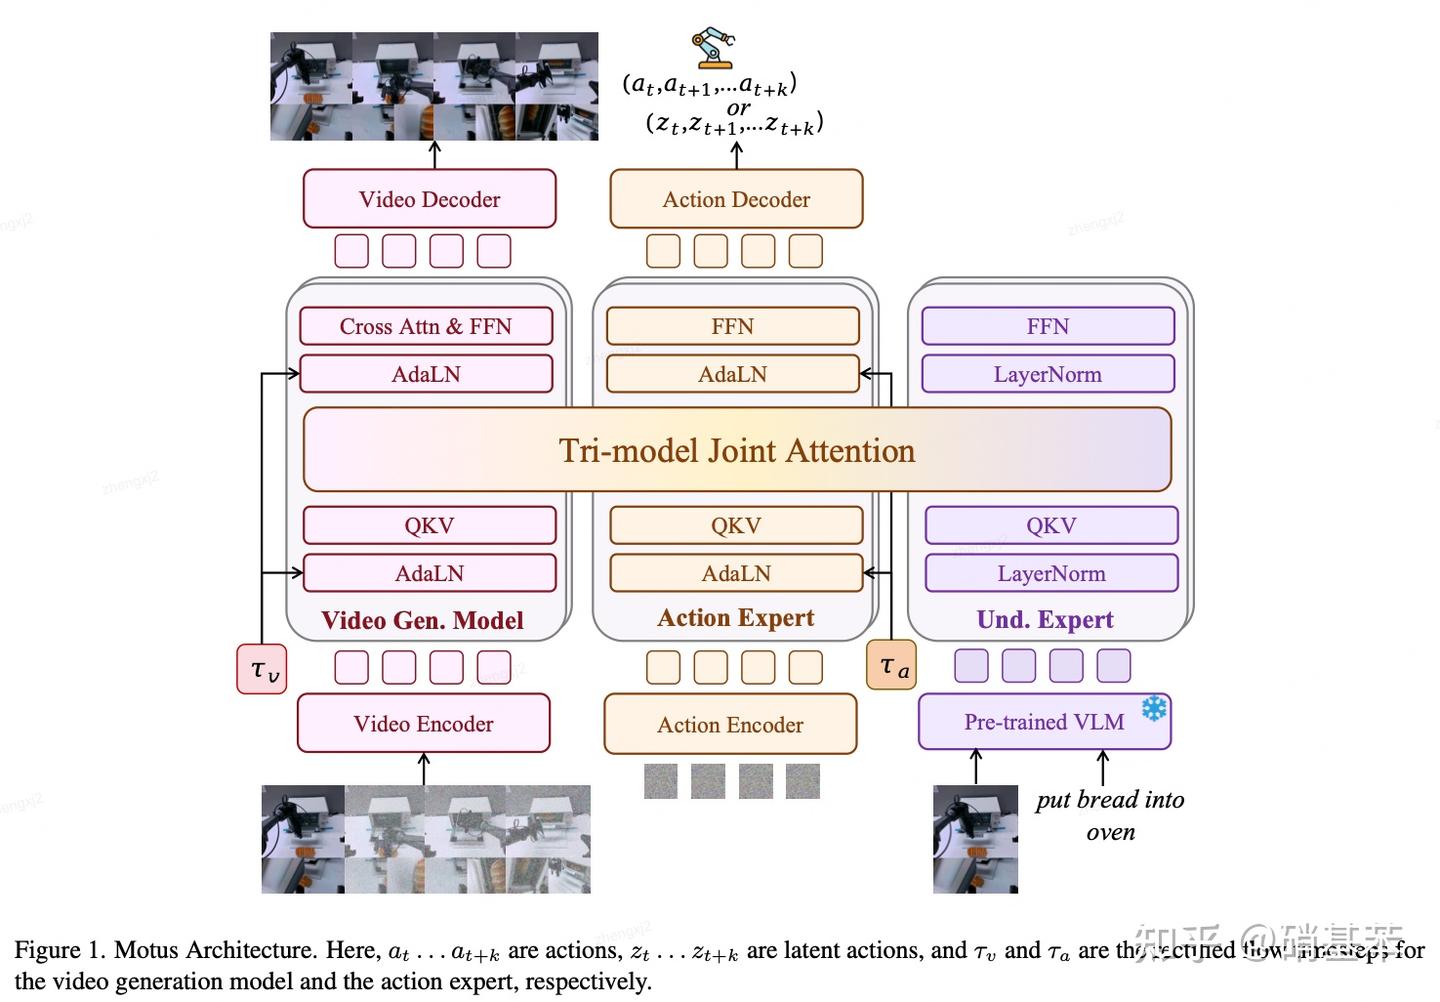
作者:硝基苯 https://zhuanlan.zhihu.com/p/2019875354538428076 写在前面 从过年一直到现在,World Action Model这个概念很火,学术界有很多工作(Cosmos Policy, DreamZero, Motus, LingBot-VA, F
本文档基于 Claude Code CLI 工具的源码进行深度分析,旨在用清晰易懂但专业的语言,详细讲解其内部运行机制。特别关注 Memory(记忆)模块的设计与实现。 1. 项目总览:Claude Code 是什么 Claude Code 是 Anthropic 官方开发的命令行 AI 编程助手(
随着大语言模型逐步从「单轮问答」走向「真实环境中的持续交互」,各种各样如OpenClaw的agentic applications正在成为当前研究与产业共同关注的核心方向。无论是在网页环境中进行信息检索与操作,还是完成代码生成与调试、个性化推荐等复杂决策任务. 这些场景都要求LLM agent具备主
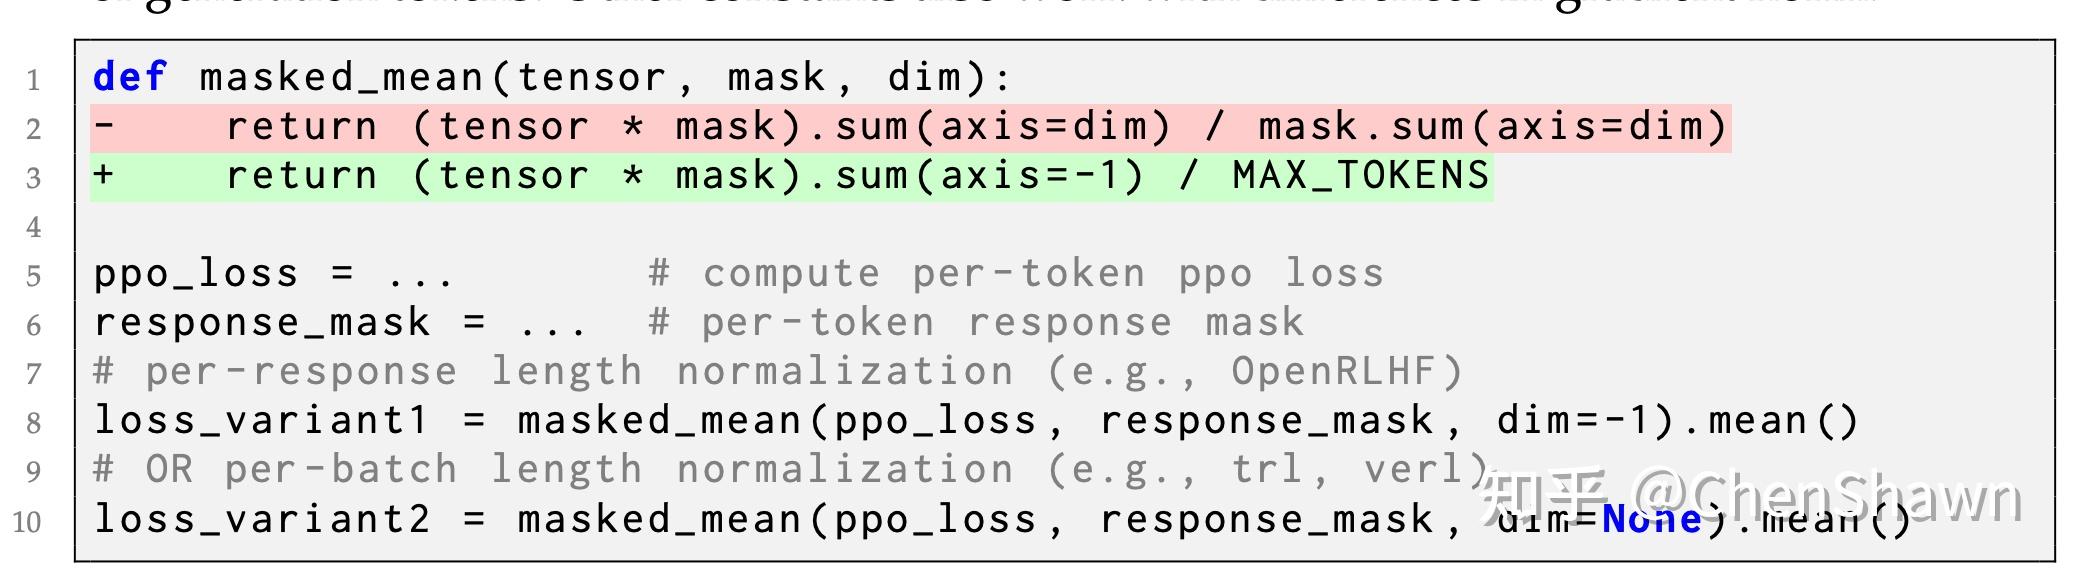
作者:ChenShawn https://zhuanlan.zhihu.com/p/2005256302918665528 我们最近 release 的工作 VESPO,是一个在 off-policy setting 下解决 LLM RLVR 训练稳定性问题,以及 bias-variance tra
作者:Sonata,清华大学 计算机科学与技术博士在读原文:https://zhuanlan.zhihu.com/p/2022547604903339697 这里是一些最近做机器人研究产生的的个人看法。具体内容难免存在局限和疏漏,也可能和主流观点并不相同,欢迎友好讨论和指正。 VLA很火热,但也很稚
一、 引言:大模型强化学习算法的演化格局 近年来,以 OpenAI 的 o1 系列、DeepSeek 的 R1,以及 Qwen 系列模型为代表,大语言模型在数学证明、代码生成等长链路推理任务中展现出更强的稳定性与推理深度。 在这一背景下,面向大语言模型的强化学习(RL for LLMs, RL4LL
痛点与破局 RL 训练过的人都知道那种感觉——跑了三天 GRPO,token 消耗是 SFT 的十几倍,最后一看提升,几乎为零。 问题出在哪?Reward 信号太稀疏,credit assignment 做不到 token 级,rollout 全错时梯度直接归零。 但 SFT 也有自己的软肋:推理时
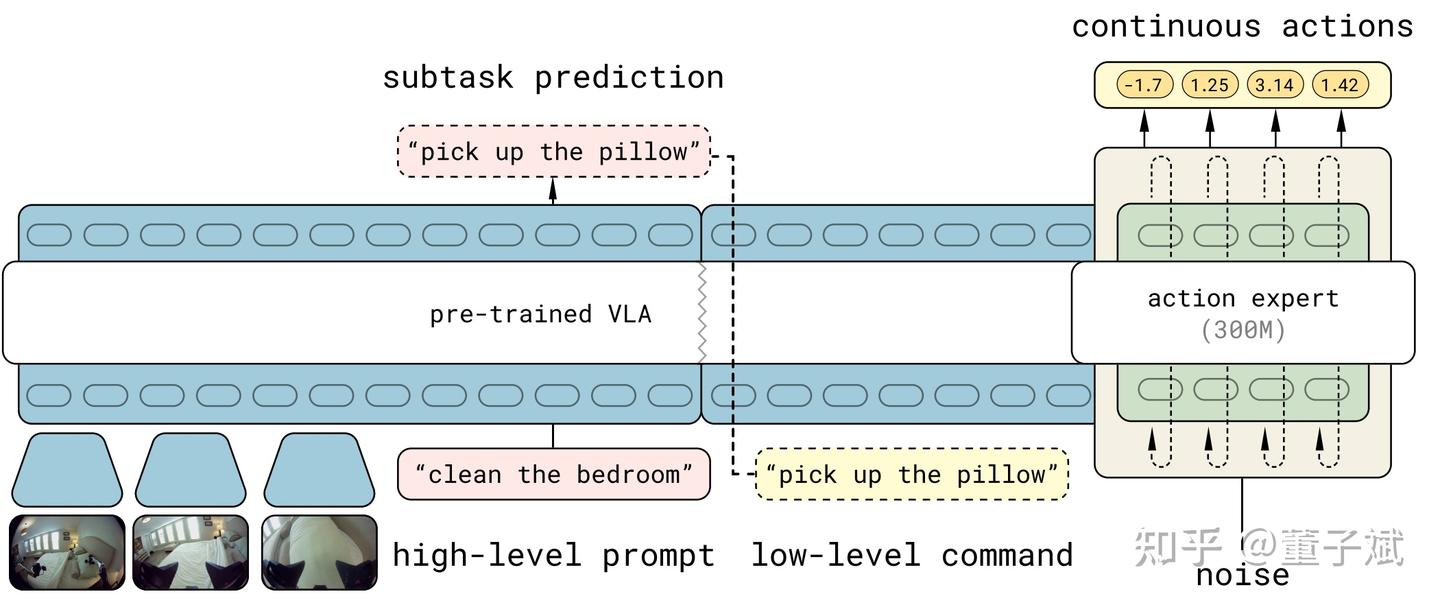
作者:董子斌 https://zhuanlan.zhihu.com/p/2006493733990981927 1. 主流 VLA 架构以及为什么我们需要 action tokenizer 不得不承认 physical intelligence 依旧是 VLA 实践灯塔之一,自从 \pi_{0.5}
林俊旸在x上发了一篇长文,特此分享 https://x.com/JustinLin610/status/2037116325210829168 过去这两年,彻底颠覆了我们评估和期待大模型的方式。 OpenAI 的 o1 告诉我们:思考本身就能成为模型一种核心的一等能力,你可以专门为了思考去训练模型,
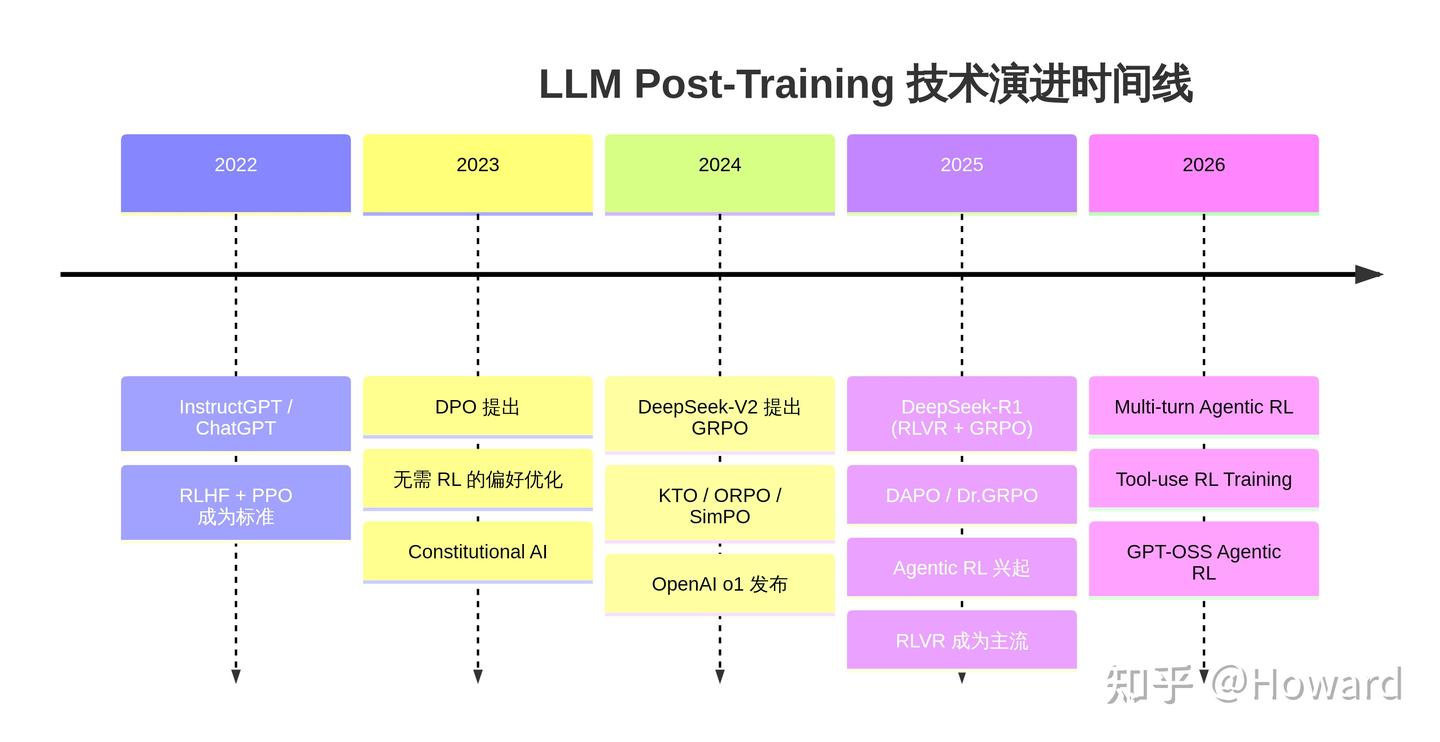
作者:Haohe,Meta FAIR 研究科学家 https://zhuanlan.zhihu.com/p/2012909606771400823 1. 引言:什么是 Post-Training? 大语言模型(LLM)的训练通常分为两个大阶段:预训练(Pre-training) 和 后训练(Post
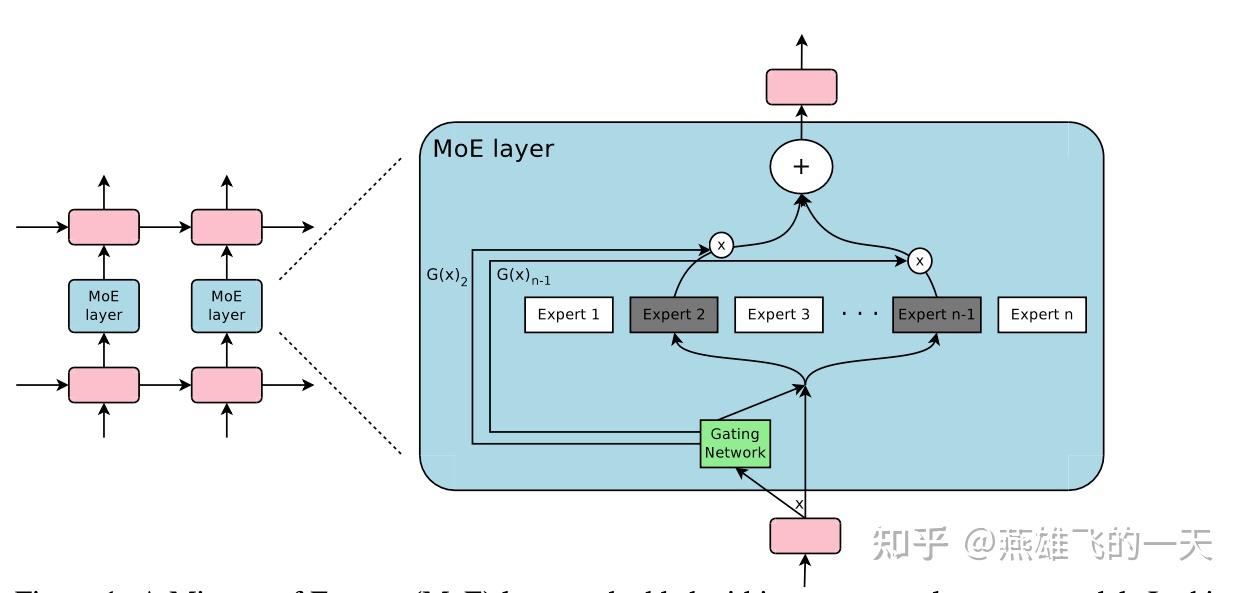
作者:燕雄飞的一天 https://zhuanlan.zhihu.com/p/2018018879109091590 无论是开源还是顶尖商业模型,moe架构已经成为绝对主流,区别于dense模型,在sft和rl阶段有什么独特的训练难点或者挑战,对于这些挑战如何缓解。期望从基础原理入手,看如何训练mo
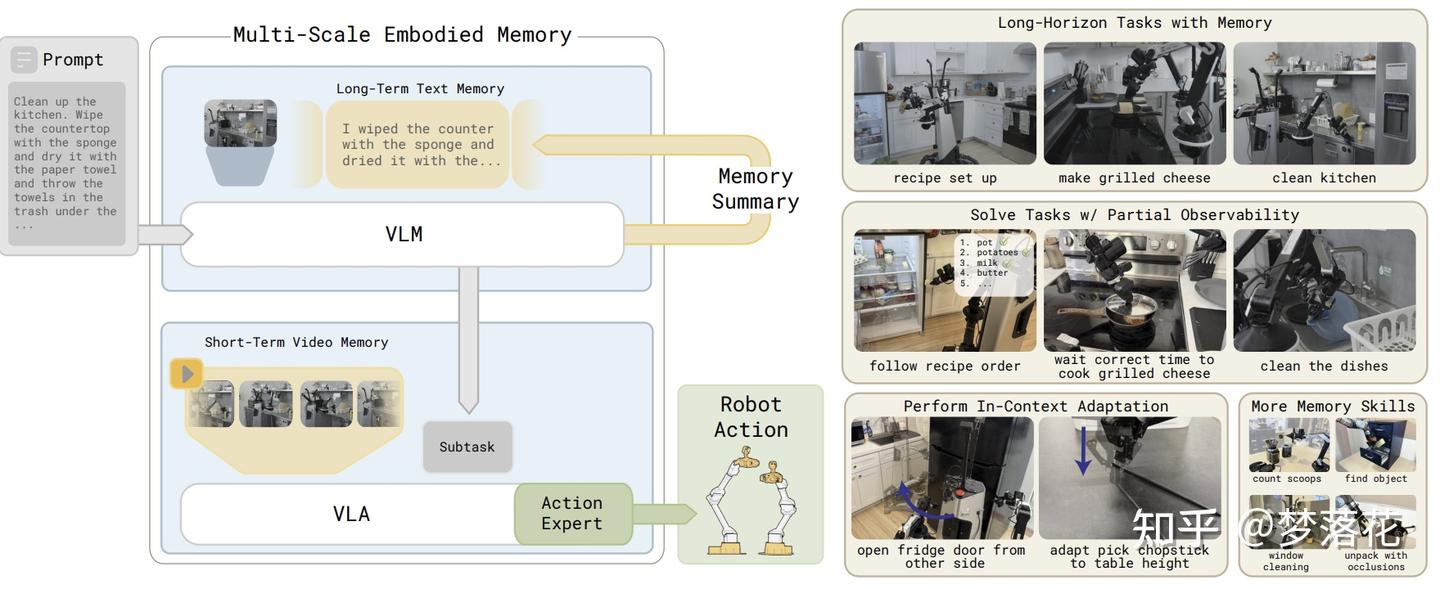
作者:梦落花 https://zhuanlan.zhihu.com/p/2017560172977992865 为什么vla需要有记忆? 机器人在运动过程中视线被遮挡时,需要从未被遮挡的历史数据中推断出物品真实位置;而机器人在做饭时需要记住它过去加了哪些食材,顺序是怎么样的。 本文通过这两个例子引出
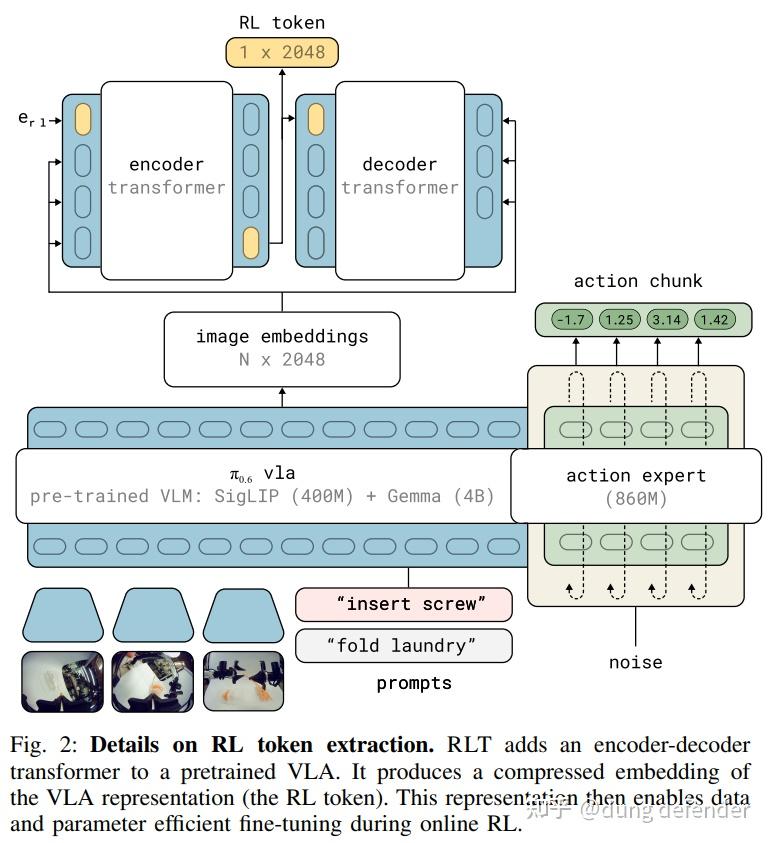
作者:dung defender https://zhuanlan.zhihu.com/p/2019320352367494543 今天主要来分享physical intelligence的最新工作: 标题:RL Token: Bootstrapping Online RL with Vision-
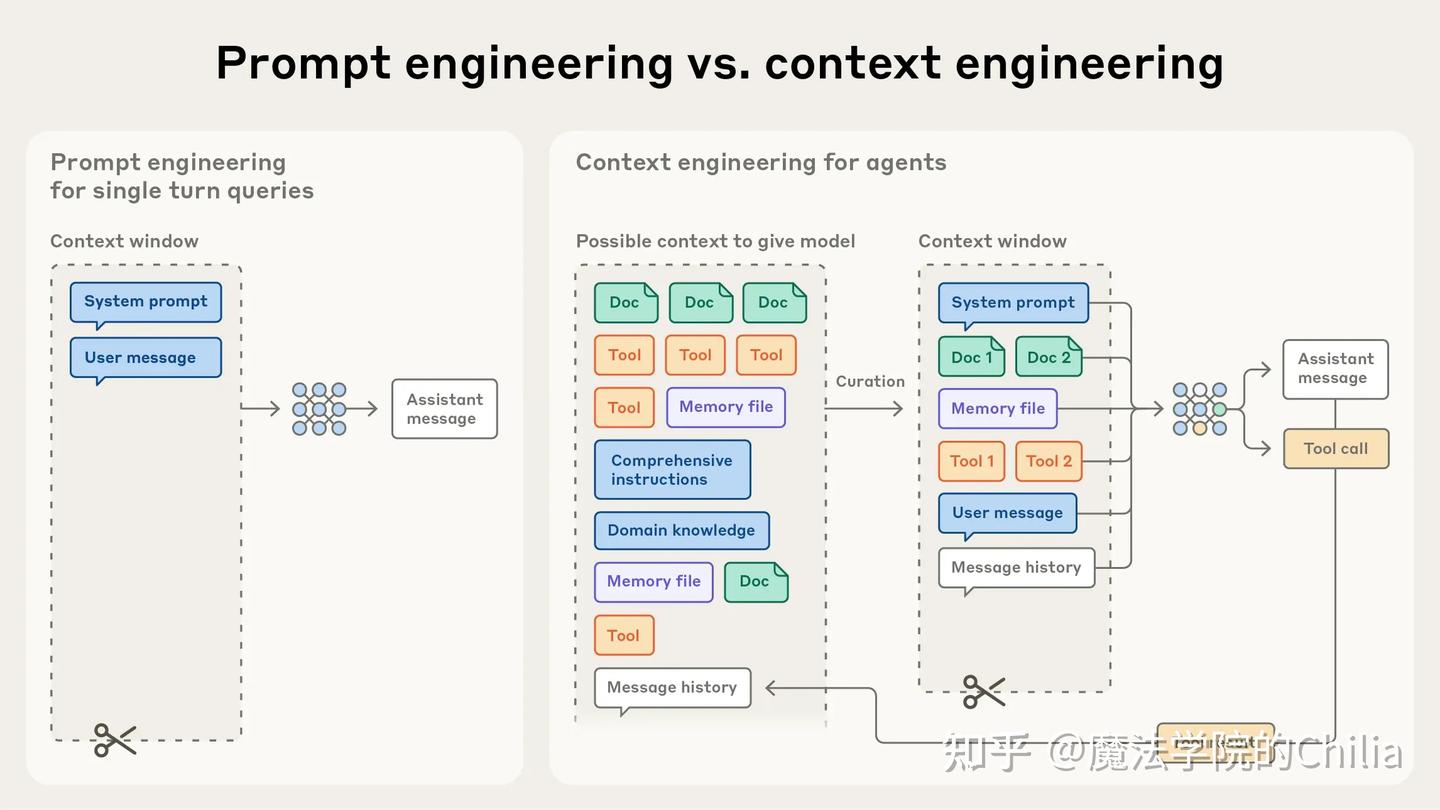
作者:魔法学院的Chilia https://zhuanlan.zhihu.com/p/2012088406826562496 0x01. 背景 (1)什么叫上下文工程(Context Engineering)? “上下文工程”简单来说,就是在一些LLM的约束下(如上下文窗口大小、注意力长度的限制)
作者:YyWangCS https://zhuanlan.zhihu.com/p/2017528295286133070 前言 作为月之暗面 AI Infra 团队的一员,这篇文章我想从 AI Infra,尤其是推理架构的角度(关于训练,我们的同事有一篇非常好的回答,推荐读一下,这里就不多谈了),聊
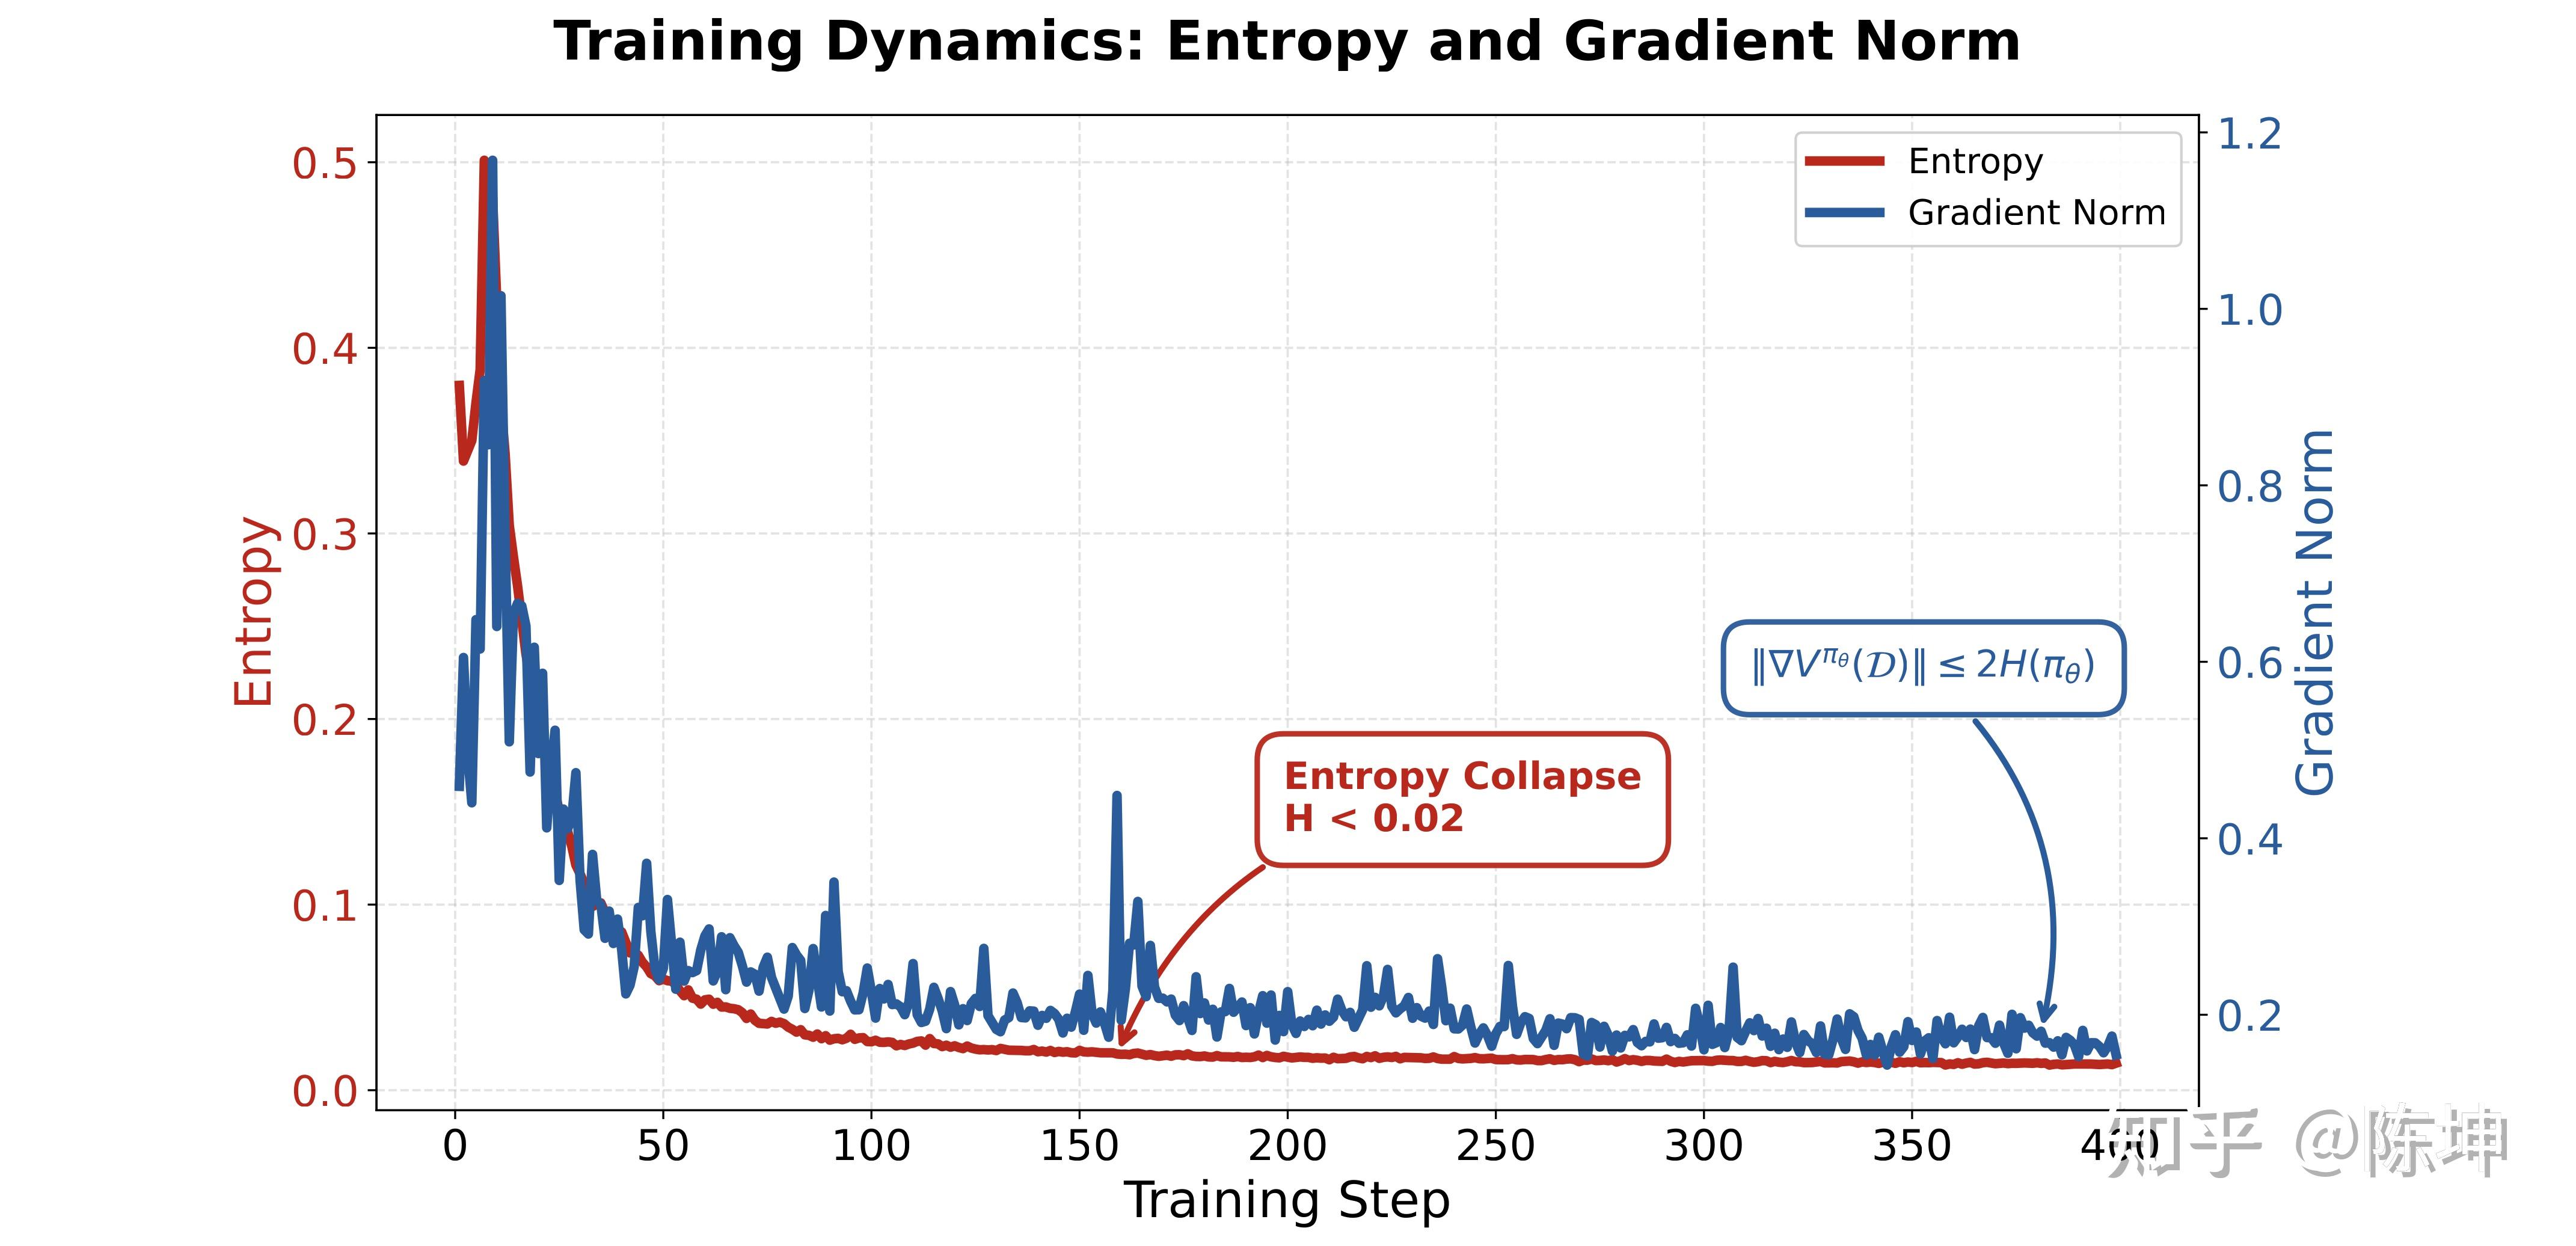
作者:陈坤 史鹏 https://zhuanlan.zhihu.com/p/2017276876004017170 本文介绍我们近期在 RLVR 训练动态方面的一项研究。我们从梯度保留裁剪(Gradient-Preserving Clipping)的理论视角出发,提出了一套灵活的熵调节机制,并基于熵
1.引言 在CVPR 2026接收的论文《Conan: Progressive Learning to Reason Like a Detective over Multi-Scale Visual Evidence》中,我们提出了基于多尺度视觉证据的多步视频推理框架,解决多模态大语言模型(MLLM
NUS、ZJU、UW、Stanford、CUHK联合提出「ThinkMorph」,主张让文字与图像在统一架构里「原生协作」、「共同演化」,而不是像当下大多数多模态模型那样,看完图像就闭上眼睛,后续完全靠文字链条推进。 仅用2.4万条数据微调7B统一模型,视觉推理平均提升34.74%,多项任务比肩甚至
作者:硅基趣玩喵 原文链接:https://zhuanlan.zhihu.com/p/2016080986690041206 一、背景 LLM强化学习训练面临一个核心架构选择:是使用在线RL(Online RL)——在训练中实时采样当前策略的rollout,还是使用离线RL(Offline RL)—
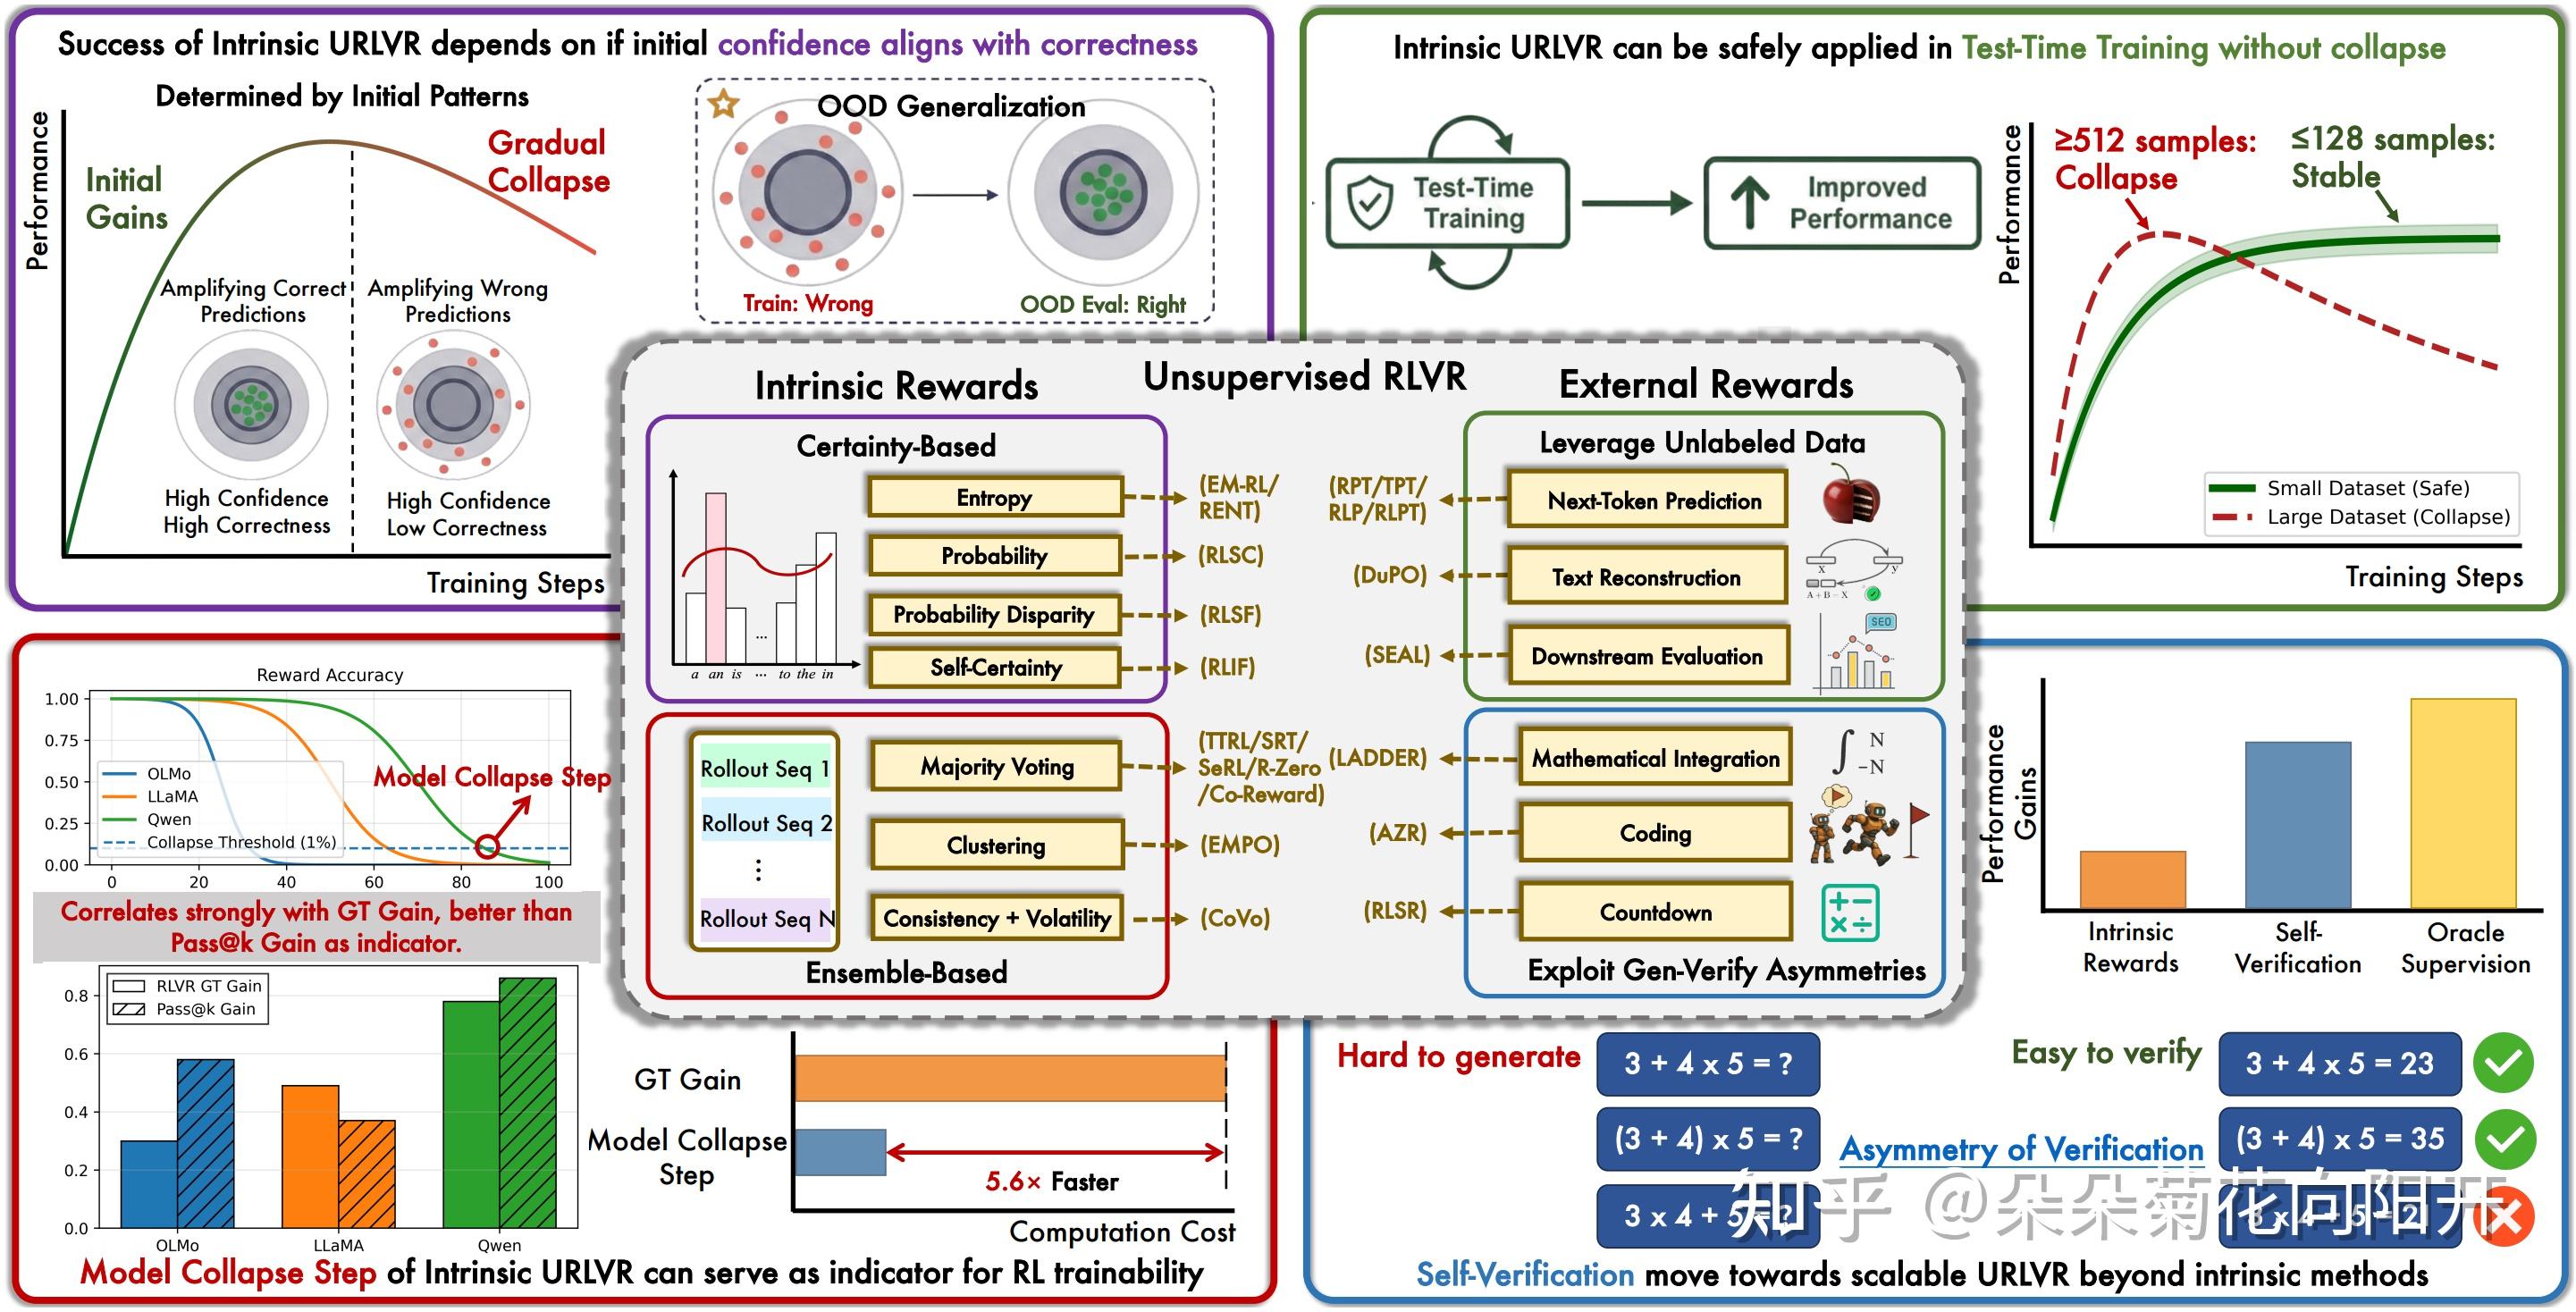
作者:朵朵菊花向阳开 原文:https://zhuanlan.zhihu.com/p/2015470633765593982 从TTRL开始,无监督RLVR(Unsupervised RLVR)应运而生,让模型在没有人工标注的情况下持续进化。这不仅是降本增效的需求,更是通往超级智能的必经之路。就像预
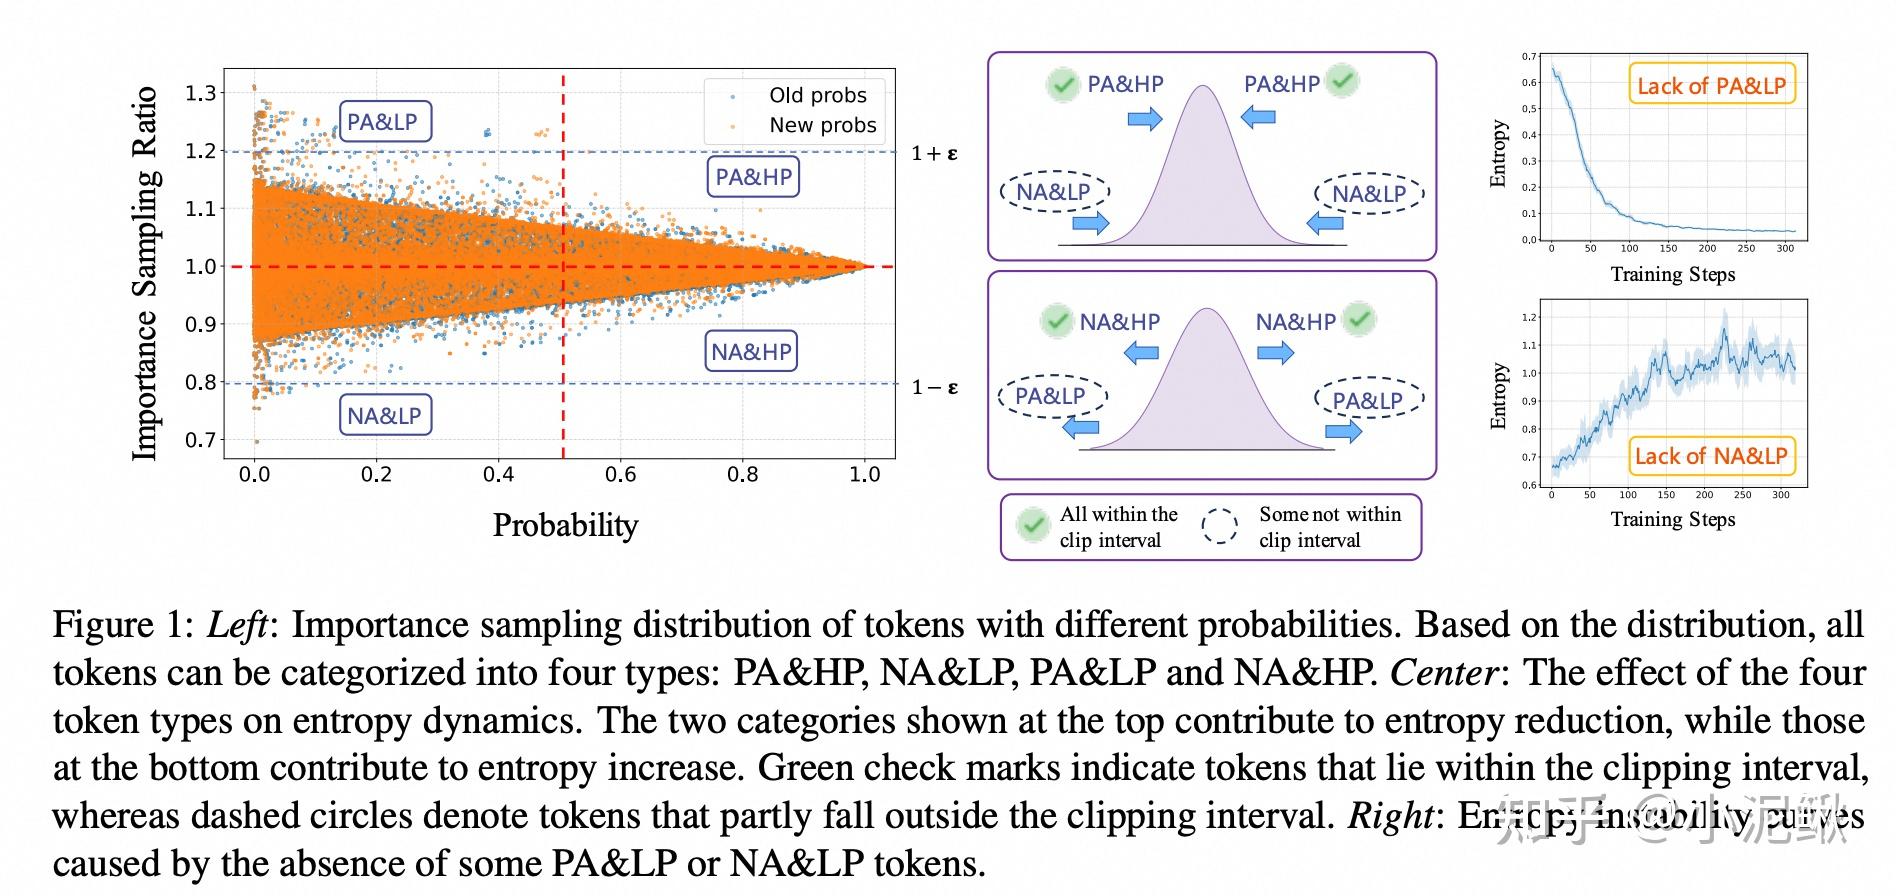
作者:小泥鳅 https://zhuanlan.zhihu.com/p/2004633029096776871 TL;DR:推导公式拆解RL训练中Entropy变化流程、基于判别式S_k=p_k(H+\log p_k)分四类讨论Token的Entropy-Dynamic性质、统一解释主流RL-Ent
当AI Agent开始从“工具调用者”走向“长期协同者”,记忆便成了决定其天花板的关键。然而,现有的记忆方案正面临一个尴尬的悖论:Agent 往往拥有一本厚厚的“交互日记”,却缺乏一套真正的“知识储备”。 近日,由UIUC、清华与微软研究院 联合提出的PlugMem引起了广泛关注。作为一个任务无关的
论文题目:Scoring, Reasoning, and Selecting the Best! Ensembling Large Language Models via a Peer-Review Process 作者信息:Zhijun Chen 1, Zeyu Ji 1, Qianren Mao
CaveAgent:一个面向工程落地的有状态Agent运行时框架 论文地址:https://arxiv.org/abs/2601.01569 项目地址:https://github.com/acodercat/cave-agent 安装:pip install 'cave-agent[all]' 这
视觉几何基础变换器(VGGT)在静态场景中表现优异,但在动态场景下面临固有矛盾:相机姿态估计需抑制动态区域,而几何重建则需建模动态信息。如何在统一框架下协调这一任务冲突? 来自MIT和Harvard的研究团队提出了PAGE-4D(Disentangled Pose and Geometry Esti
作者:attack204 https://zhuanlan.zhihu.com/p/2007250216227729670 调研了一些目前Agentic-RL场景下对Infra的一些需求,主要内容都来自于各家大厂的文章 值得一提的是除了最后一篇Seer的文章外,其他3篇都是春节期间发布的,LLM还是
TLDR. Agent是强大的,但用户是狂野的 😦又是一个工具使用Benchmark?不是说模型厂商追逐榜单严重,忽略用户实际体验? 确实,但我们面对这个质疑提出了WildToolBench:当我们衡量模型的工具调用能力时,不能仅仅看在完美的提问下,完美的实验环境下,LLM能否操纵工具回答正确,因
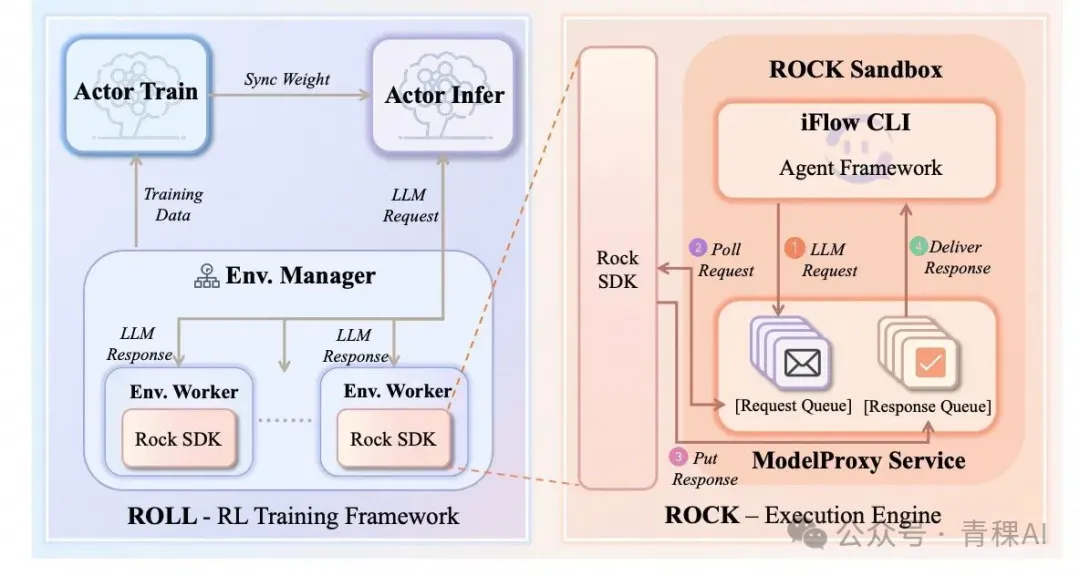
作者:Xiaoyang Li, Weixun Wang and Yancheng He | Project Leader: Weixun Wang | March 5, 2026** 本文英文名称:Save, Load and Learn: Boosting Agentic LLMs via Rol
作者:sheriyuo https://zhuanlan.zhihu.com/p/2011084180654671820 从工程上看,我们通常把 RLHF 当成“在 \pi_{\rm ref} 附近,通过偏好信号或显式 reward 优化策略”的交互学习: 先收集偏好/评分数据,再通过某种带 KL
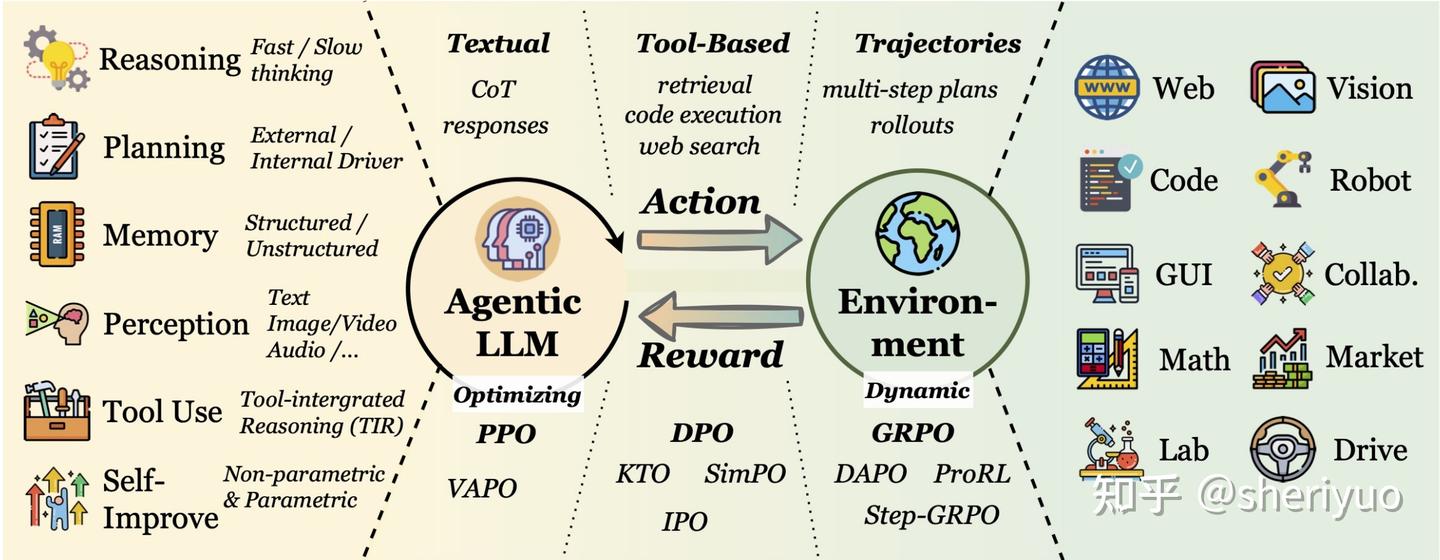
作者:sheriyuo https://zhuanlan.zhihu.com/p/2009946011120971848 近年来,随着 Agentic RL 的兴起,LLM 逐渐从“单次问答器”转变为能够在推理(Reasoning)与外部工具调用(Tool-use)之间反复交互(multi-turn
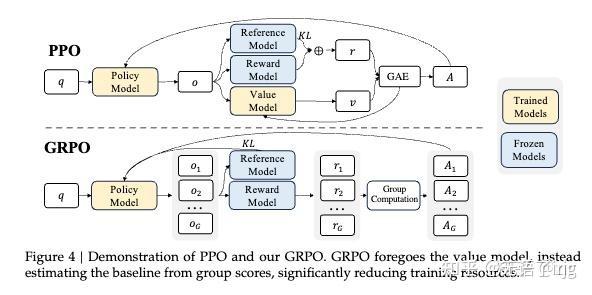
作者:无语了ing https://zhuanlan.zhihu.com/p/2010029640434087295 作为新入门强化学习的小白,由于缺乏相关的基础理论知识,经常会遇到一个很尴尬的问题:硬读PPO/GPRO的论文却被各种公式符号搞得摸不着头脑,只看博客和相关文章但却总感觉对里面所讲述的
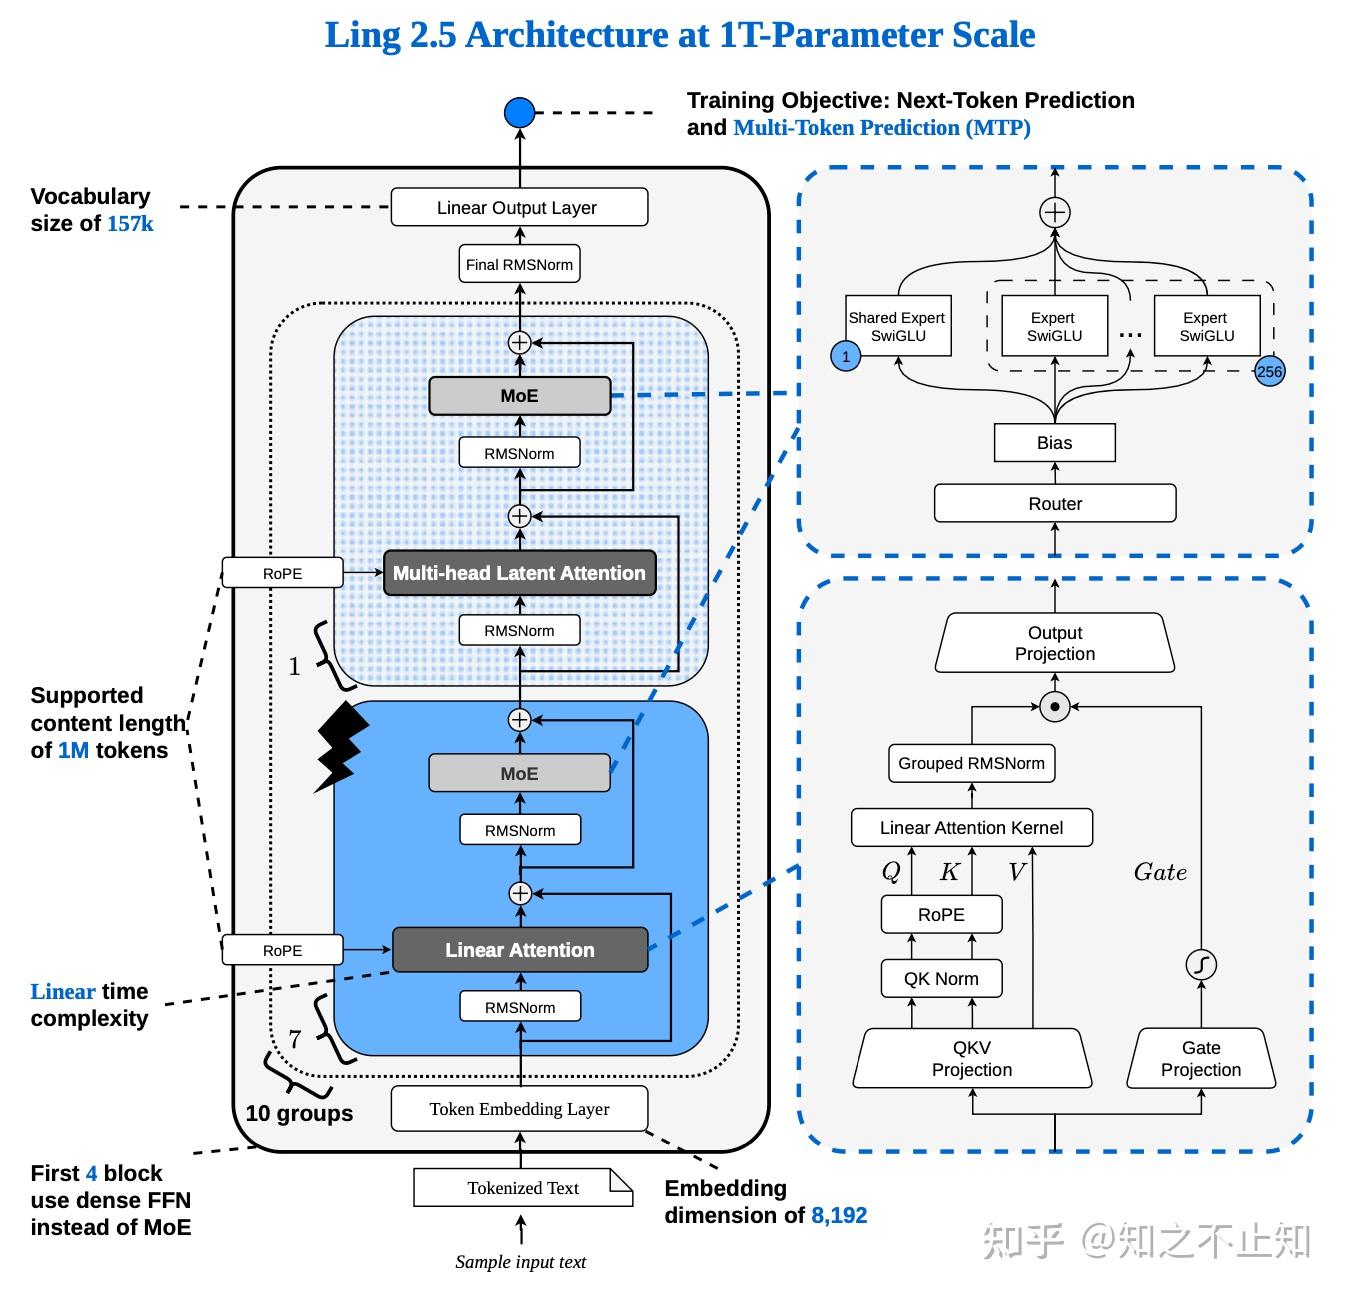
作者:知之不止知 原文:https://zhuanlan.zhihu.com/p/2010050657122546578 基模架构设计的核心思路是用更低的理论计算(FLOPs)或真实算力(GPU hours)实现更大的架构效率杠杆(Efficiency-Leverage)。在 Ling 2.0架构的
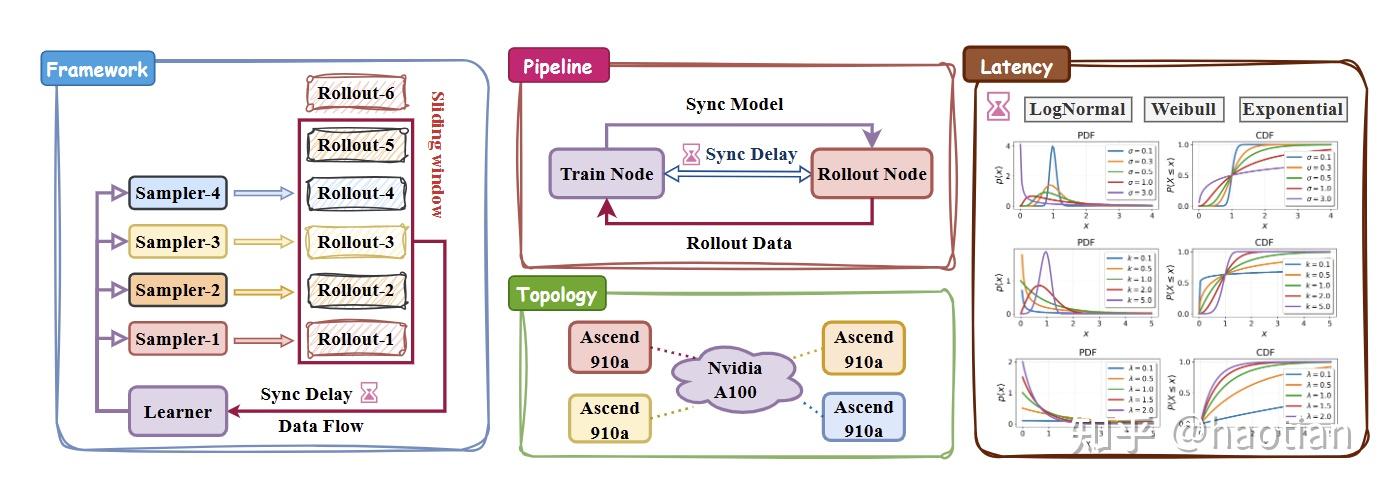
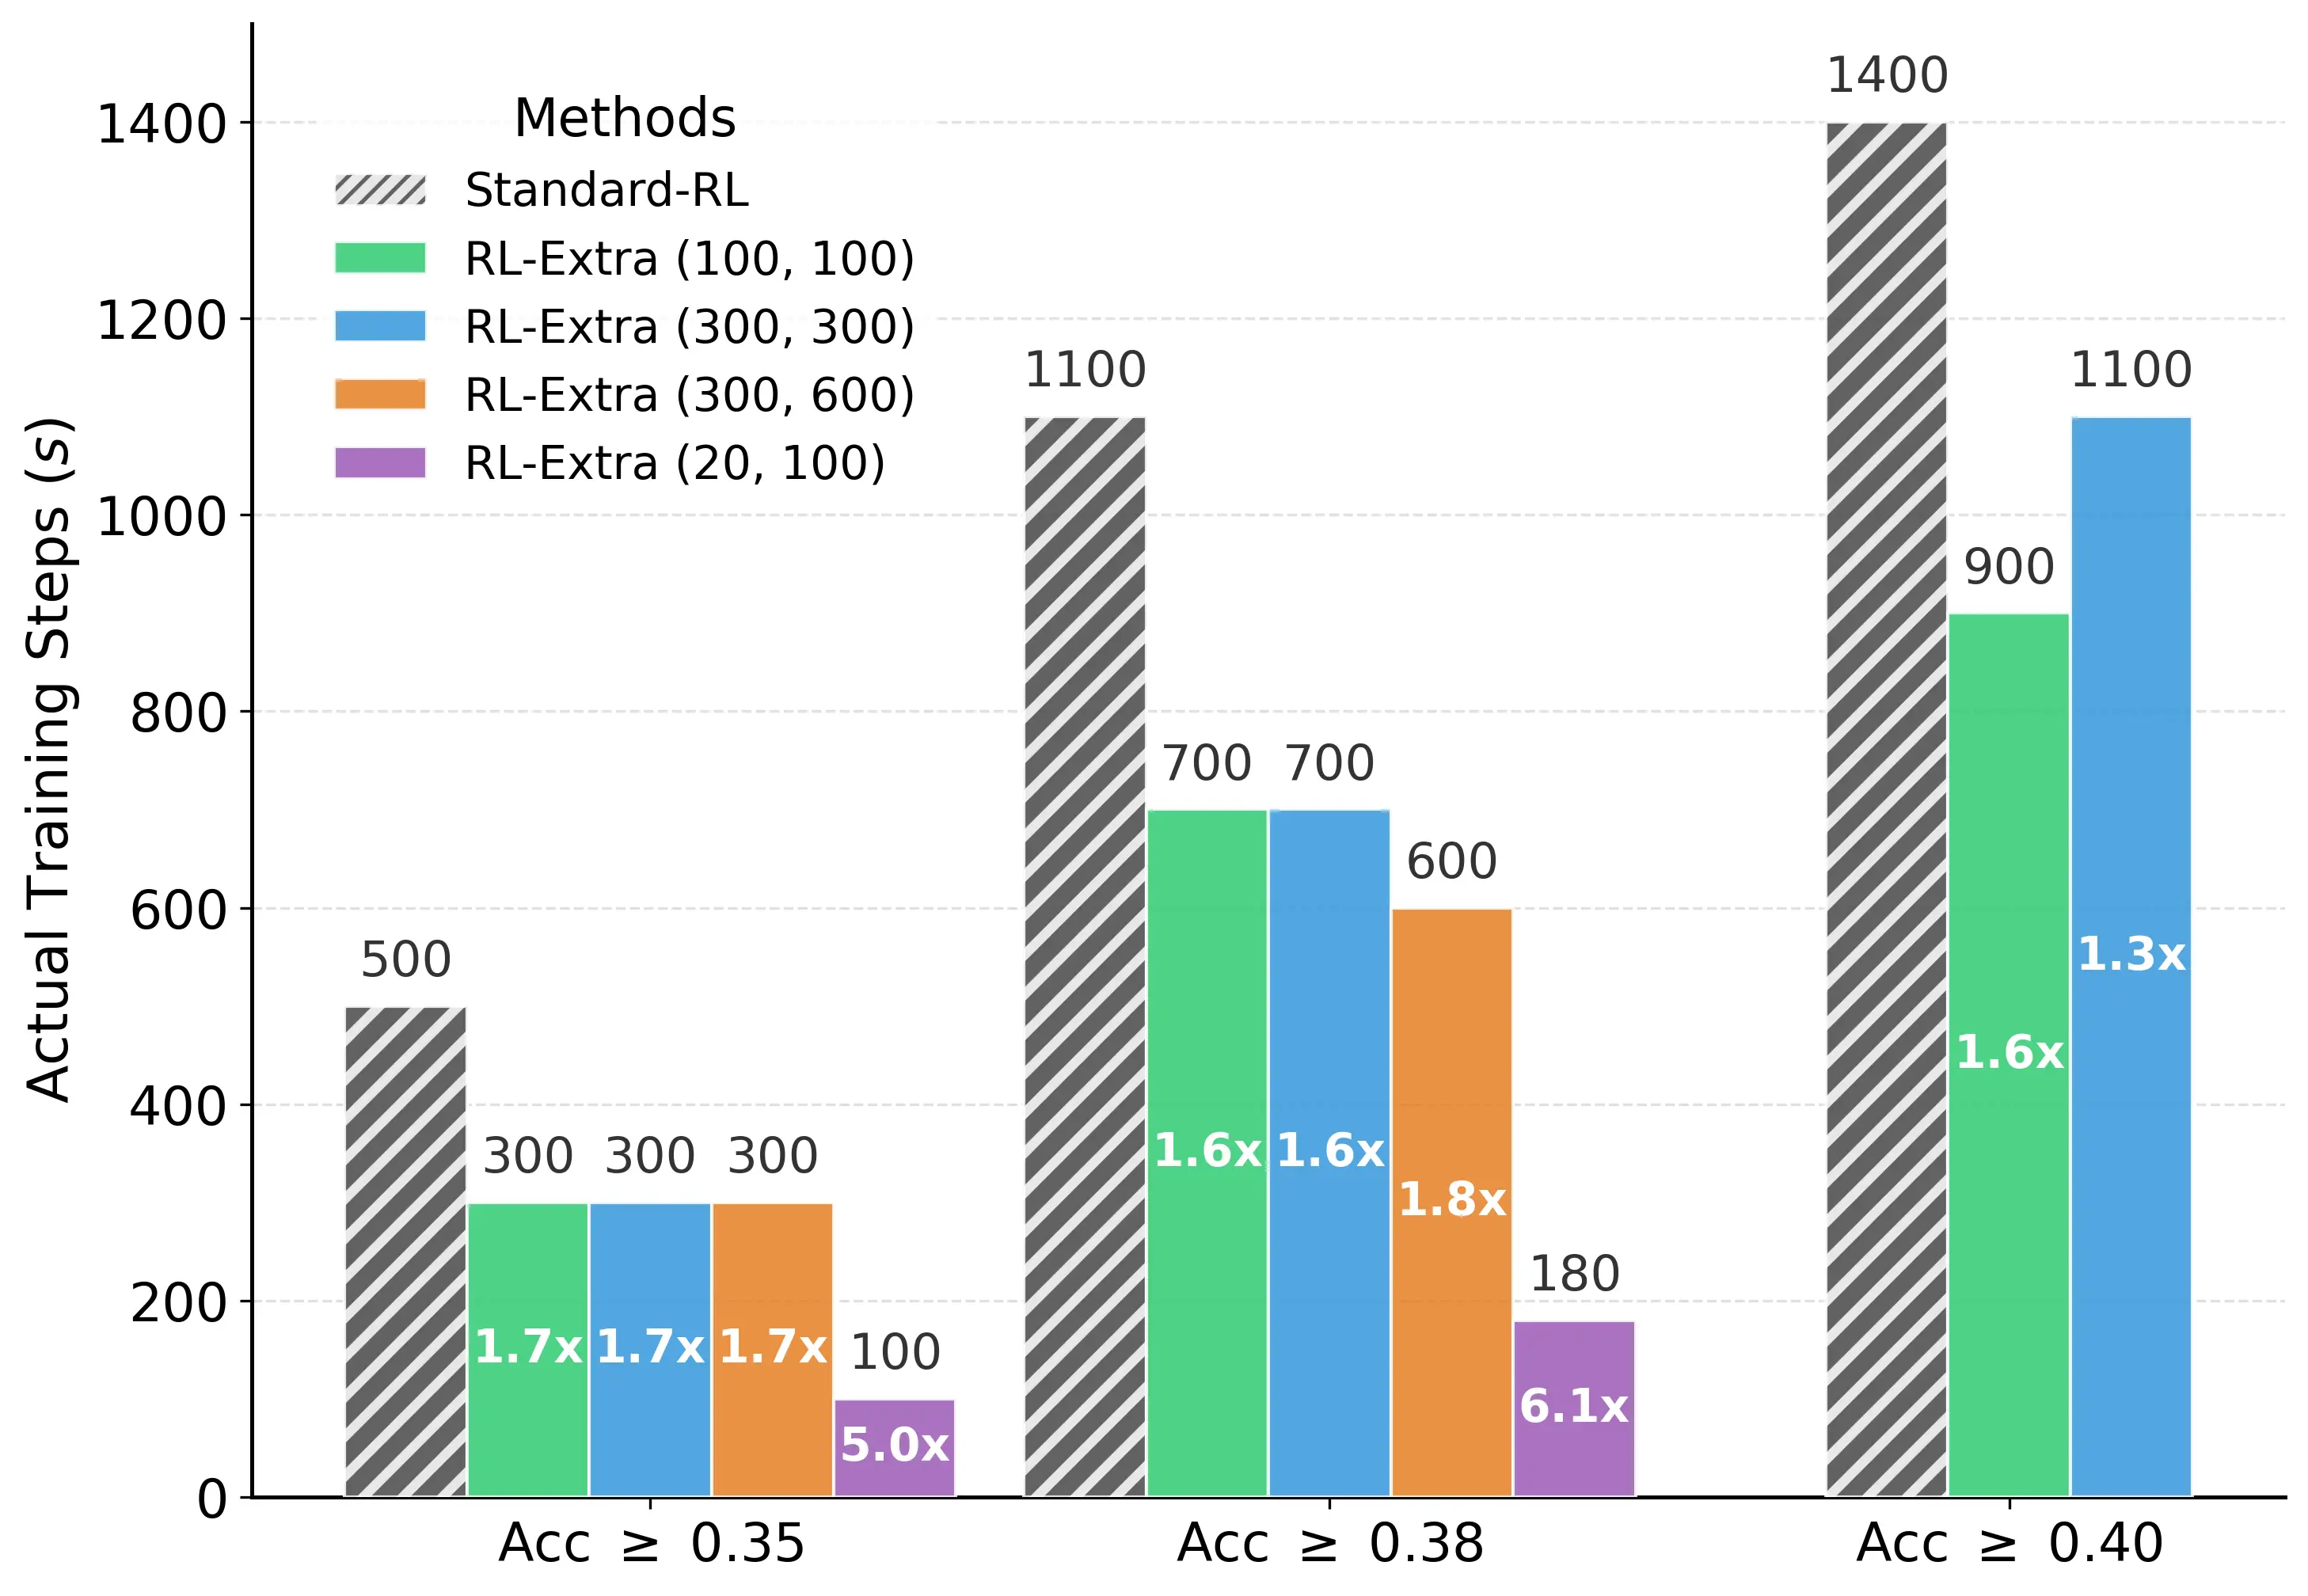
作者:haotian https://zhuanlan.zhihu.com/p/2010293867208021164 目前,为了追求上限,各家都尽可能地使用onpolicy训练。对于agentic任务,往往是全异步配置,不可避免带来offpolicy的问题。offpolicy在使用合适的训练set
作者:王天乐,香港城市大学数据科学系博士生,导师为苗宁教授,研究方向为大语言模型推理。 DeepSeek-R1 的爆火让 RLVR(带验证奖励的强化学习) 再次成为大模型后训练(Post-training)的焦点。然而,复现过 R1-Zero 或类似流程的同学都知道,RLVR 极其昂贵——它不仅需要
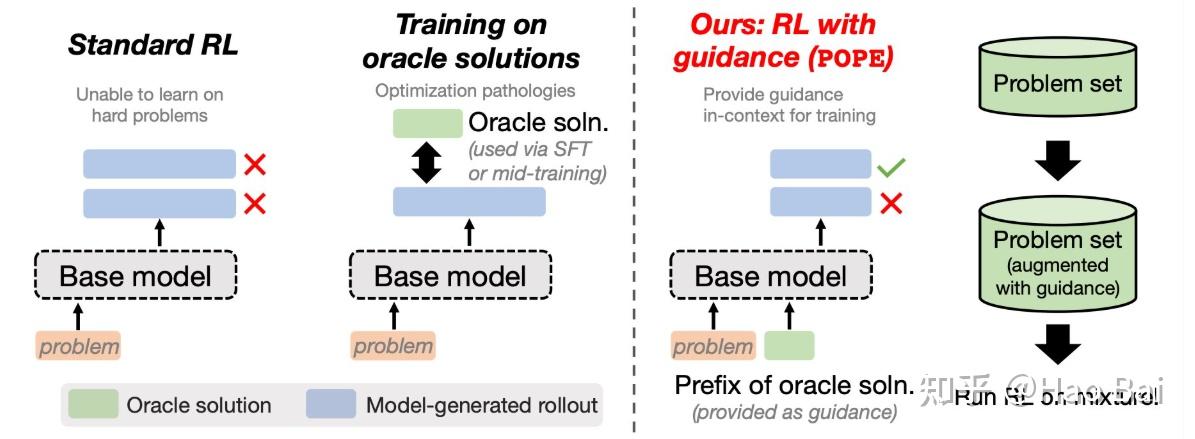
作者:Hao Bai https://zhuanlan.zhihu.com/p/2006963575110013959 今天来聊一下RL的近期热门问题,涉及Off-policyness,Sample Efficiency与Priviledge Information这些话题,可以理解为SFT+RL的
作者:extreme1228 原文:https://zhuanlan.zhihu.com/p/1997363850849300572 过去半年到一年时间,自己也算是在LLM RL领域的一个科研工作者。 自从25年年初DeepSeek-R1横空出世后,LLM RL就变成了一个非常火爆的方向,与此同时基
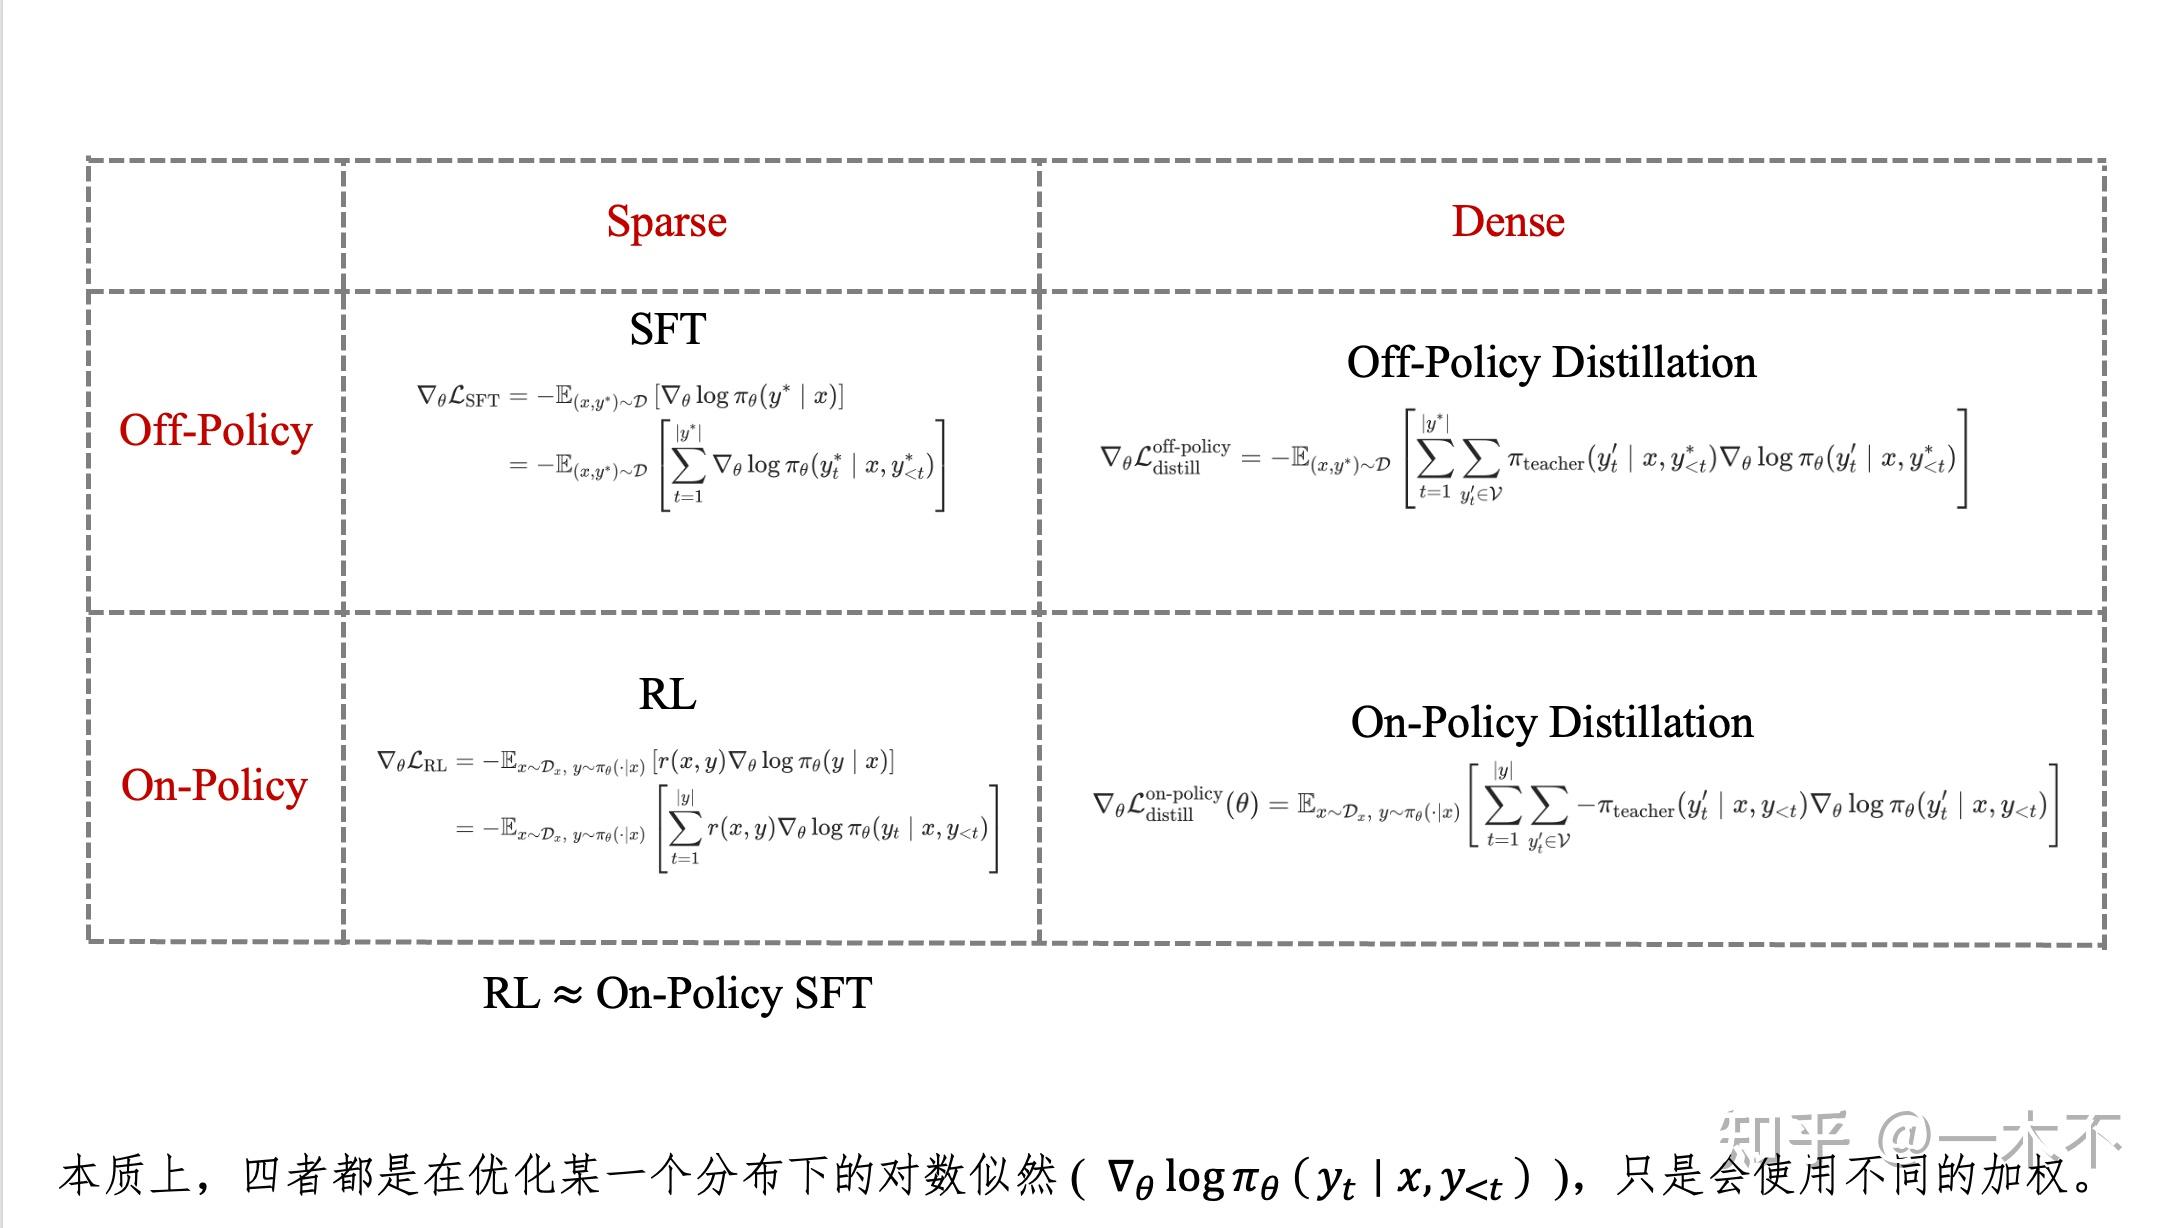
作者:一木不 原文:https://zhuanlan.zhihu.com/p/2004262797710738371 我们在此讨论SFT,Off-Policy Distillation,RL,On-Policy Distillation之间的联系和区别。 在RL没火的时候,我们提到distillat
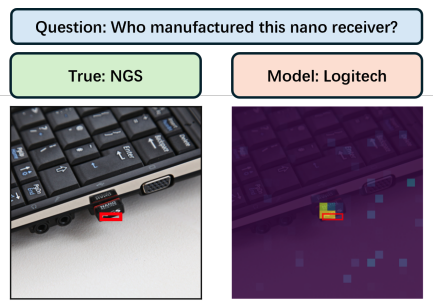
去年有次组会,师弟和我说在复现一些Thinking with Images工作的时候,发现interleaved images是错的/被丢掉了,模型的表现也不会受到影响。另外,有些模型在实际上没有执行工具的时候也会幻觉说执行了工具。考虑到我们之前发现llm4math里有答案正确过程不对的情况,vis
本文为 AI AMA 栏目第一期 Agent自进化 主题全观点转录。 青稞 AMA(AI AMA)是由魔搭社区、青稞社区、机智流与知乎联合发起的 AI 前沿技术圆桌对话栏目。围绕真正值得讨论的AI技术方向,以「多元视角」邀请一线实践者同框深度对谈:拆解原理、还原细节、碰撞观点,直面工程落地的真实挑战
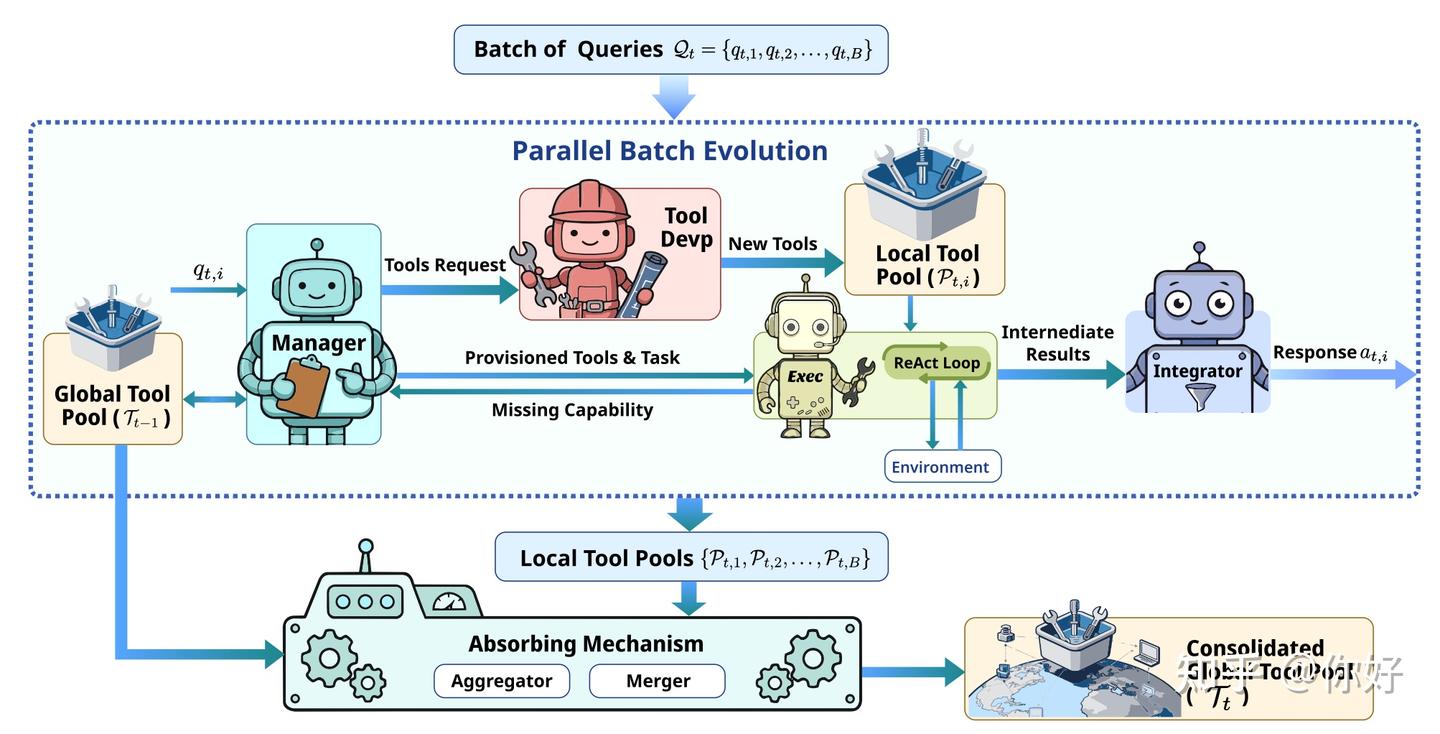
TL;DR 我们提出了 Yunjue Agent,一个面向开放域任务的原地自进化智能体系统。与当前主流的”在新环境生成数据再训练”范式不同,我们认为真正的自进化应该是 In-Situ(原位自进化)——在推理过程中持续积累工具能力,无需外部监督。 在HLE,DeepSearchQA等五个 benchm
作者:龙心尘 https://zhuanlan.zhihu.com/p/2005366418179385192 声明:为突出重点,部分背景知识已略去,同时涵盖的内容也难免有疏漏之处,还望读者理解。 背景说明 1.KL散度正则化涉及多种决策项,包括:使用正向KL散度还是逆向KL散度(2种)、将其置于损
让大模型生成 GPU Kernel是大家对大模型发展的一个共同期望,并且GPU Kernel本身作为一类代码,天然可被执行,从而获得来自环境的反馈。直觉上非常适合通过 LLM 结合强化学习(RL)的范式进行训练。然而目前并没有行之有效的办法对Kernel生成进行有效的、长时间的 RL 训练。 来自港
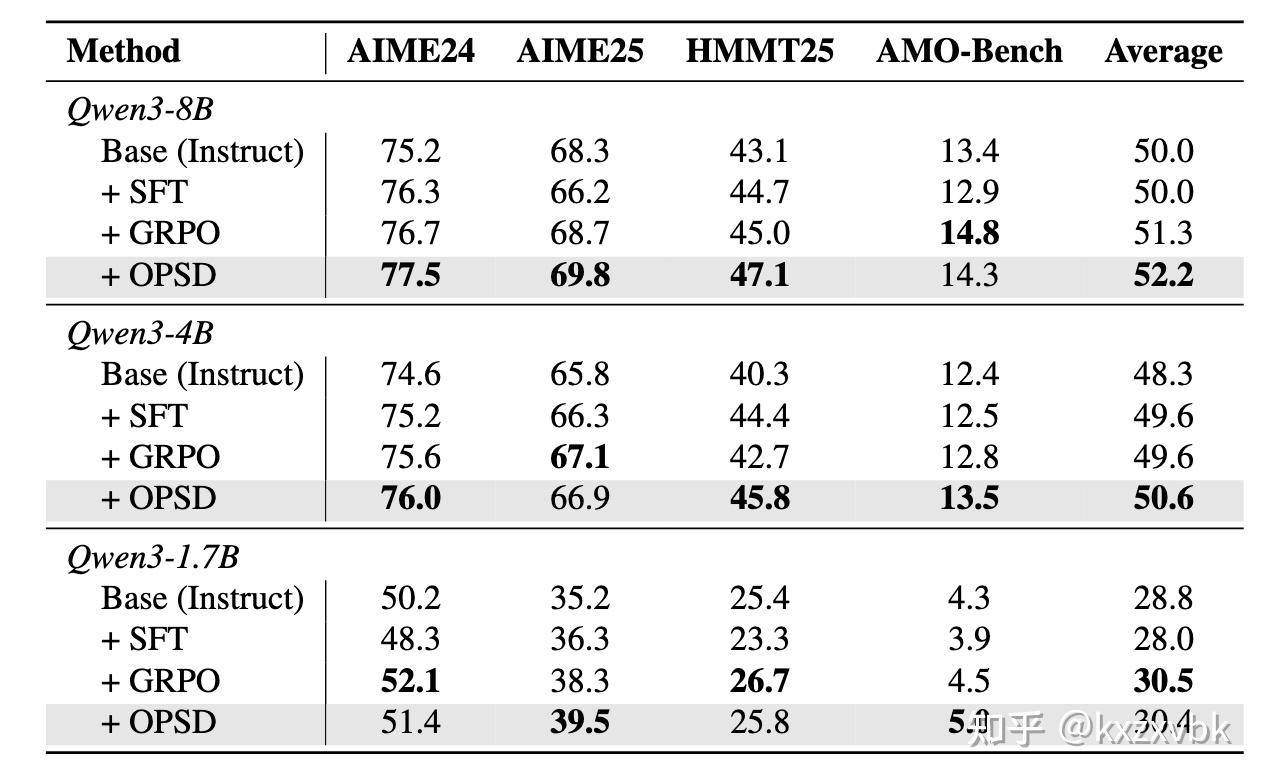
作者:kxzxvbk 原文:https://zhuanlan.zhihu.com/p/2000612721868177979 最近,越来越多 LLM 相关的工作提到了一个关键词 On-Policy Distillation (后文会简称为 OPD),这个方法迅速受到大家的广泛追捧和好评。 本文将从
作者:Haoning Wu https://www.zhihu.com/question/1999487395494588876/answer/2000362433332660070 Big Model Smell 作为一个在这个项目里拧了几个月螺丝的工程师,release 之后看到大家讨论,挺多感
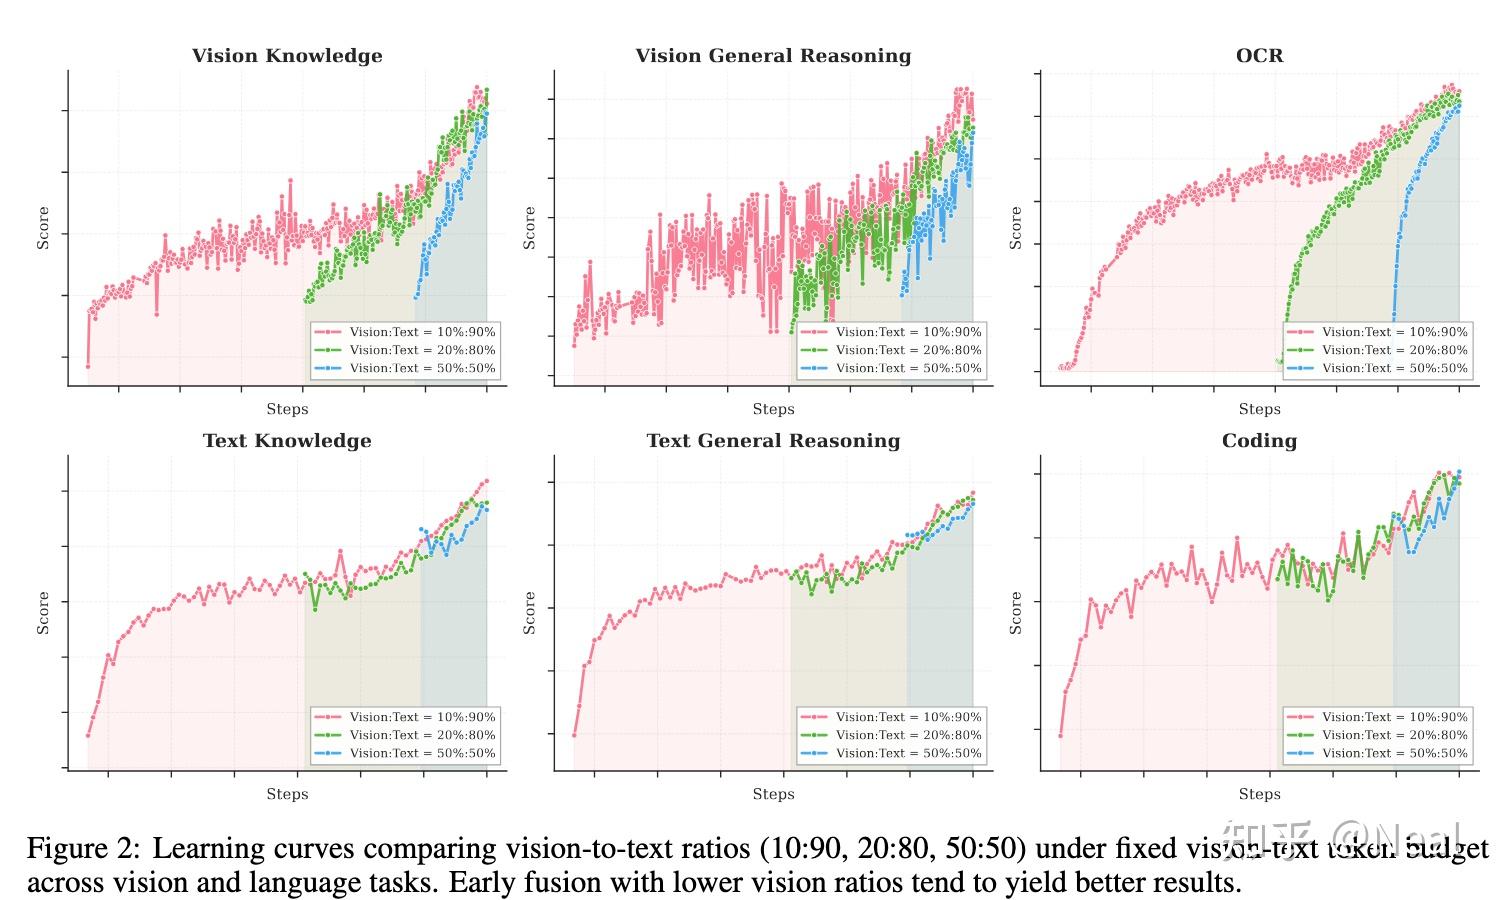
作者:Neal 链接:https://www.zhihu.com/question/1999487395494588876/answer/2000722695596299217 利益相关,在K2.5参与了Pretrain和部分Post-train的环节。本来想默默潜水,后面发现酒香也怕巷子深(还有很
作者:ybq https://zhuanlan.zhihu.com/p/1995265459285694156 LLM 论文千千万,有用的工作却没几篇。这篇文章,我想简单讨论下到底该如何把后训练工作做的 solid。文章并没什么技术细节,大家随便看看。 敲定正确的 Baseline 有太多论文工作不
作者:王小惟 Weixun https://zhuanlan.zhihu.com/p/1993017628877426830 大模型领域的发展,让我对时间的流速有了截然不同的认知。一方面,由于一直在埋头推进诸多事项,从微观层面来看,痛苦总会让人觉得时间过得很慢。 另一方面,领域的快速发展、不断突破的
作者:钱泽中,西安交通大学少年班本科大三 原文:http://xhslink.com/o/4JTOFucqnmw 之前的相关工作 其实从最早期的一派以Q-learning为基础,以及更加倾向于offline RL的真机强化学习算法就可以展现出整个具身社区对RL这一块的态度了,也就是online RL
作者:木木 原文:https://zhuanlan.zhihu.com/p/1986141224588027138 在DPO(Direct Policy Optimizatio)之后,后续的典型工作发展路线为:GRPO -> DAPO -> GSPO -> SAPO,在有PPO的理论推导基础(可以看
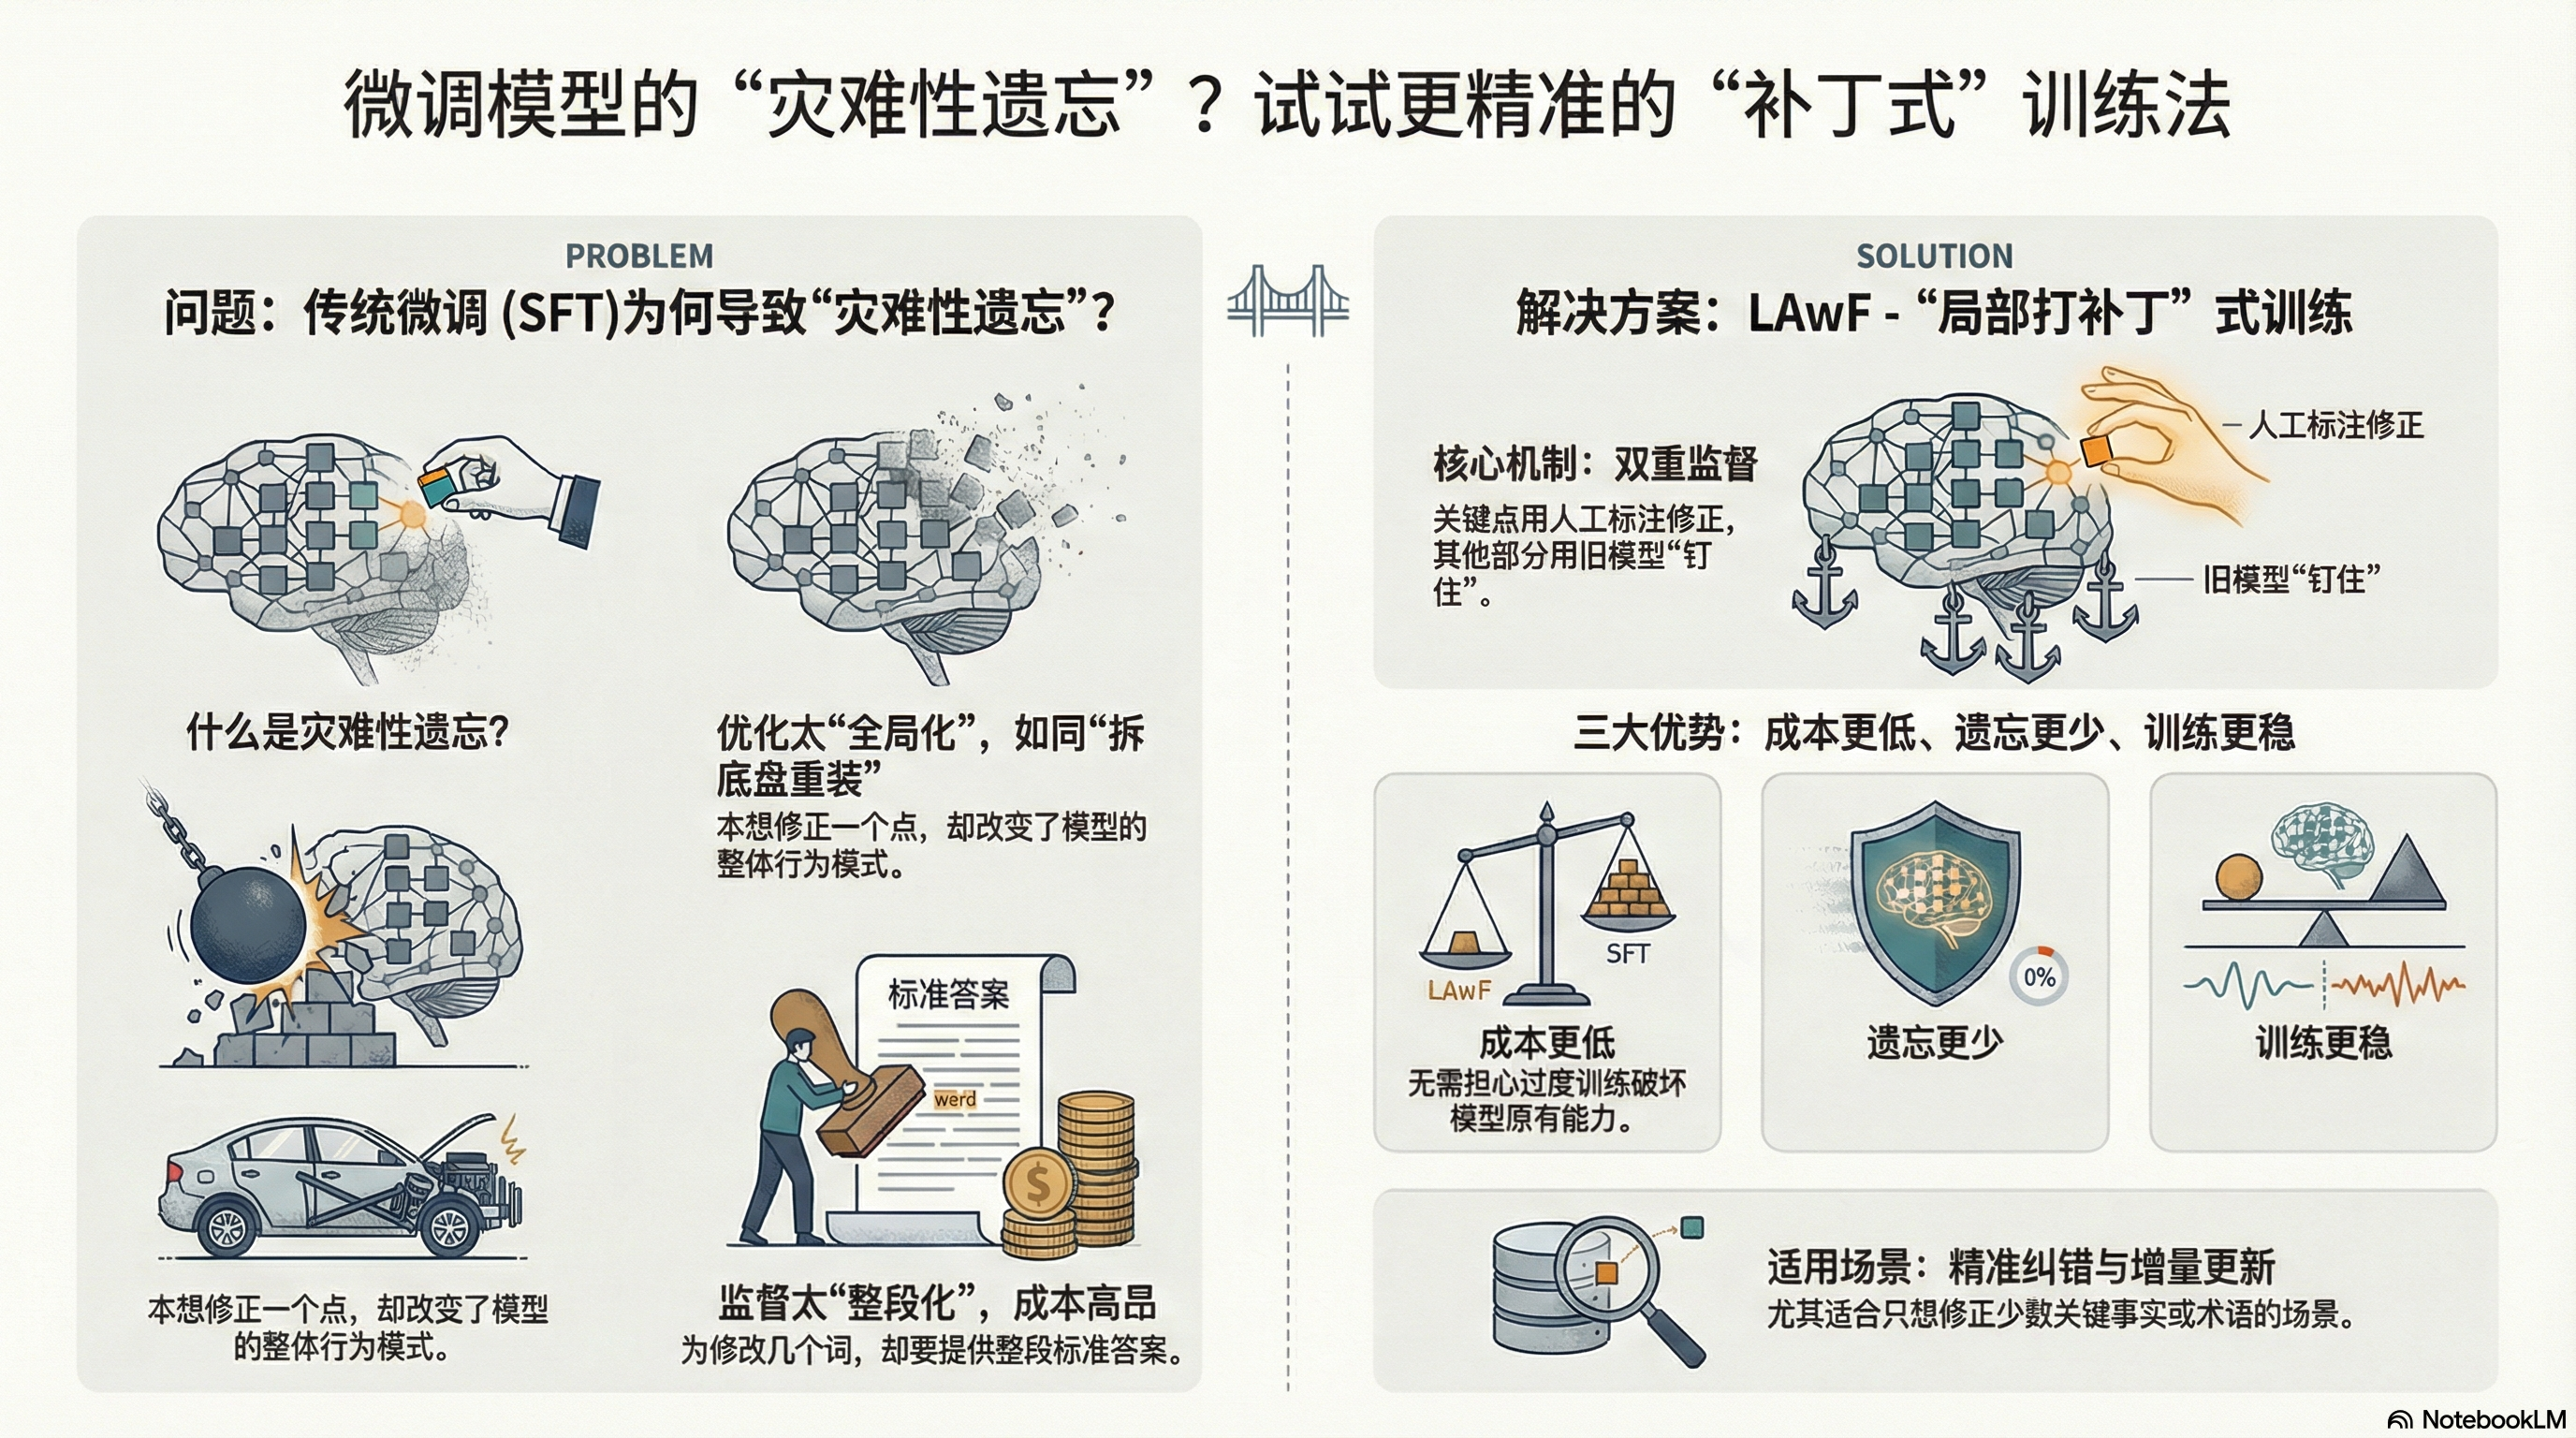
想微调一小部分,为什么模型会“连带变笨”? 很多人第一次微调大模型都会被一个现象吓到:你只是想教它一件很小的事——比如“某个术语必须按公司口径解释”,结果训练完它在别的题型上反而变差了,甚至一些原本答得挺稳的常识也开始飘。 这就是大家熟悉的灾难性遗忘(catastrophic forgetting)
无需真实奖励,哪怕用随机、错误的信号进行训练,大模型准确率也能大幅提升? 此前,学术界已经发现了一个令人困惑的现象:像 Qwen2.5 这样的模型,即使在 RLVR(带验证奖励的强化学习)过程中给予虚假奖励(Spurious Rewards),它在对应测试集上的准确率依然能神奇地大幅提升,并通过一系
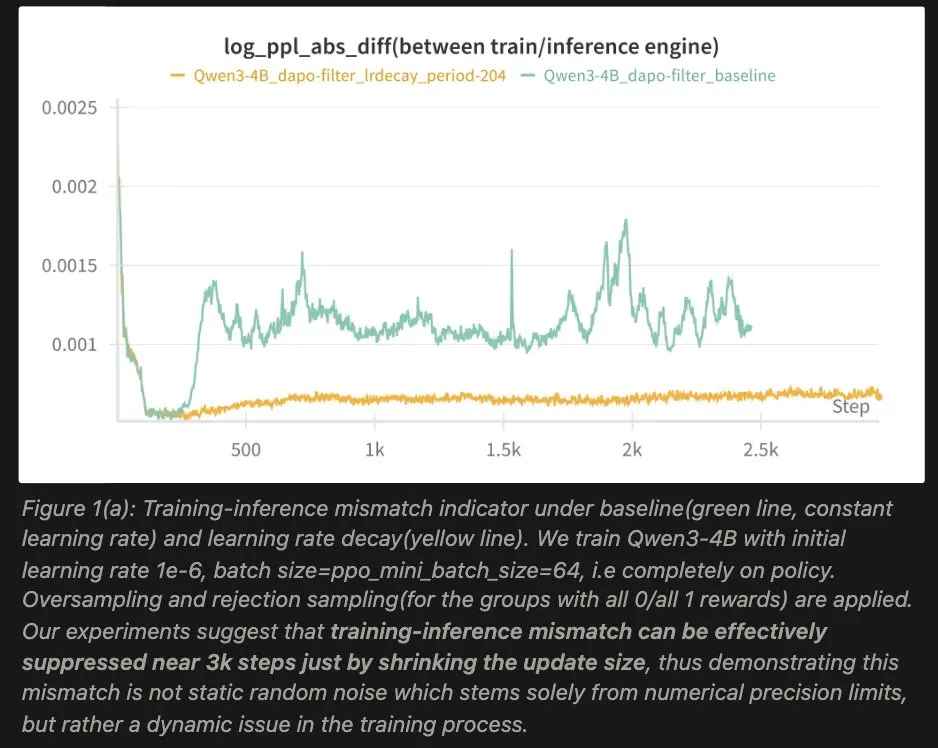
在 LLM 强化学习(RL)的训练中,有一个长期困扰算法工程师的“幽灵”:训练-推理不一致(Training-Inference Mismatch) 。很多时候,你会发现训练开始阶段一切正常,但是一段时间后训练引擎和推理引擎生成token的概率分布就有可能越来越远,accuracy断崖式下跌。 主流
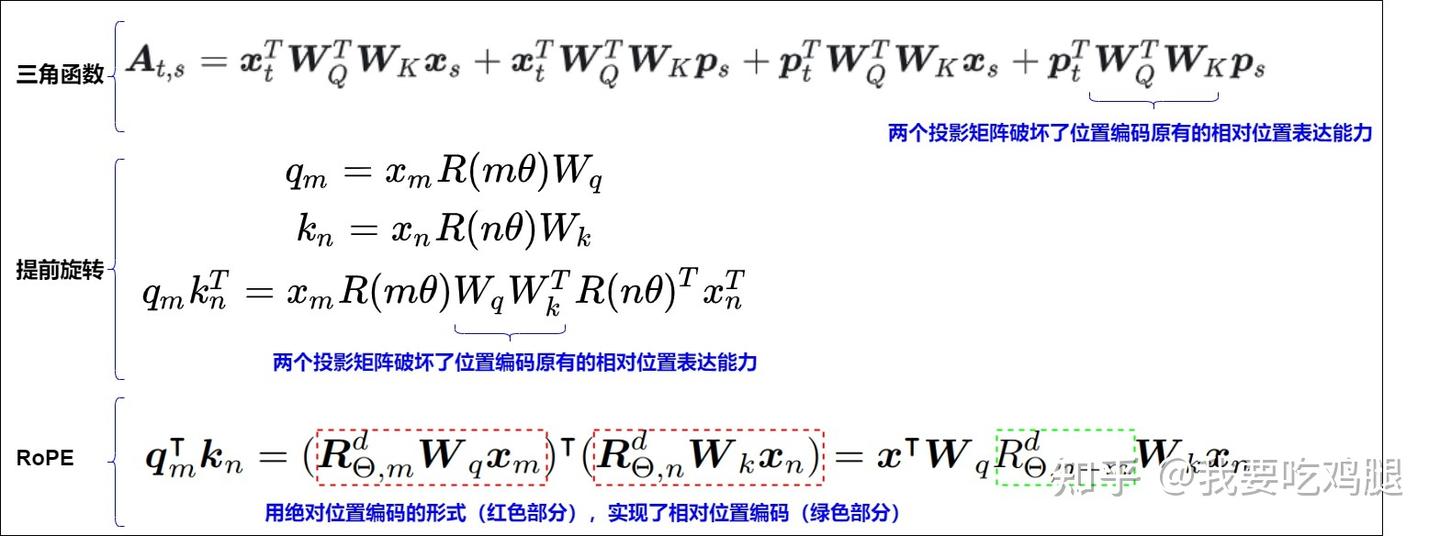
第一章:为什么位置编码如此重要? 在人工智能浪潮席卷全球的今天,大型语言模型(LLM)无疑是那朵最璀璨的浪花。从能够对答如流、撰写代码的ChatGPT,到在各个领域展现出惊人创造力的Llama、Qwen、ChatGLM等模型,我们正亲眼见证一个由算法和数据驱动的智能新纪元的到来。 这些模型似乎拥有了
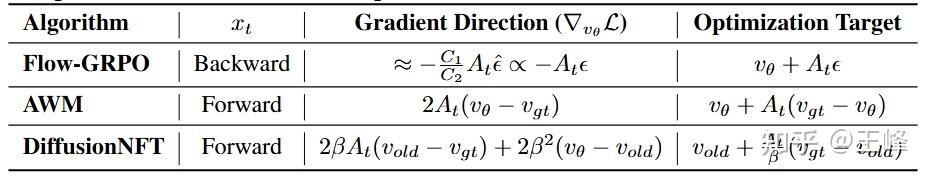
作者:王峰 https://zhuanlan.zhihu.com/p/1995493539912623296 这段时间一直在搞Diffusion+RL,各种调参下来也算有了一些心得,但没什么创新点,感觉不值得发一篇paper,上次为了写CPS那篇论文又是研究底层理论、又是做对比实验,还要跟审稿人对线
作者:归来仍是少年 原文链接:https://zhuanlan.zhihu.com/p/1991109652348418036 很多人在学习PPO(Proximal Policy Optimization)用于语言模型优化时,会直观认为既然已有 reward model(RM)来判断一个 respo
作者:车中草同学 https://zhuanlan.zhihu.com/p/1893791455769776556* 本篇博客的目的: 陆陆续续学习RL一阵子,看过ppo,grpo,gspo等的论文,但是一直没有建立一个大的领域框架,来兼容最新的改进。 因此本篇博客从RL应用到LLM的初步定义开始,
RLLaVA:模块化多模态强化学习框架的设计与实践 OpenAI 联合创始人 Ilya Sutskever 在最近的访谈中指出,AI 已经从单纯堆算力的“规模扩张时代(Scaling Era)”回到了“研究时代(Research Era)”。 在这一背景下,强化学习(RL)正在从单纯的“偏好对齐”转
作者:唐瀚霖,阿里巴巴高级技术专家,开源推理引擎RTP-LLM的核心作者之一 研究方向为LLM和AIGC的高倍压缩和推理加速方案,曾参与DoubleSqueeze, 1bit-Adam, RazorAttention等工作。 团队介绍 RTP-LLM是阿里巴巴智能引擎团队自研的高性能大模型推理引擎,
作者:乞力马扎罗雪人 https://zhuanlan.zhihu.com/p/1992730229291111674 2025 年无疑是 Agentic RL 的“混战元年”。这一年从零到一做了很多尝试,认知也在不断刷新,这一篇不是严谨的博客或笔记分享,都只是当下的想法。 LLM 很有意思的一点是
最近,随着大模型能力的不断提升,越来越多的研究开始在RL(强化学习)训练中同时优化多种偏好(如正确性、格式、长度、bug ratio等)。 这个趋势看似合理,但一个被广泛忽视的问题正在影响着训练效果——多奖励RL中的"优势崩溃"(Advantage Collapse)。 来自 NVIDIA 的研究者
核心摘要 在本研究中,我们推出了 DFlash。这是一种利用轻量级块扩散 (Block Diffusion) 模型在投机采样(Speculative Decoding)中进行草图拟合(Drafting)的新方法。 DFlash 实现了高效且高质量的并行草图生成,进一步突破了投机采样的性能极限。如图
当今的网络世界,虚假信息像野火一样蔓延,它们不仅误导公众认知,影响人们的判断和决策,还可能引发社会恐慌、损害个人或团体的声誉,甚至干扰公共安全与秩序。面对这些危害,传统的人工事实核查方式已难以跟上谣言扩散的“网速”,因此,AI事实核查系统应运而生。 在人们对这些AI"真相卫士"寄予厚望时,来自香港浸
青稞社区于12月28日组织了青稞Talk 第100期特辑:2025 “青稞” AI 嘉年华! 本次活动专为青年科学家打造,旨在搭建一场 AI 技术的深度对话,来自学术和工业界的 20+ 青年科学家,与大家一起回顾 2025,展望 2026! 其中 Infra 专题,由 Sea AI Lab 算法工程
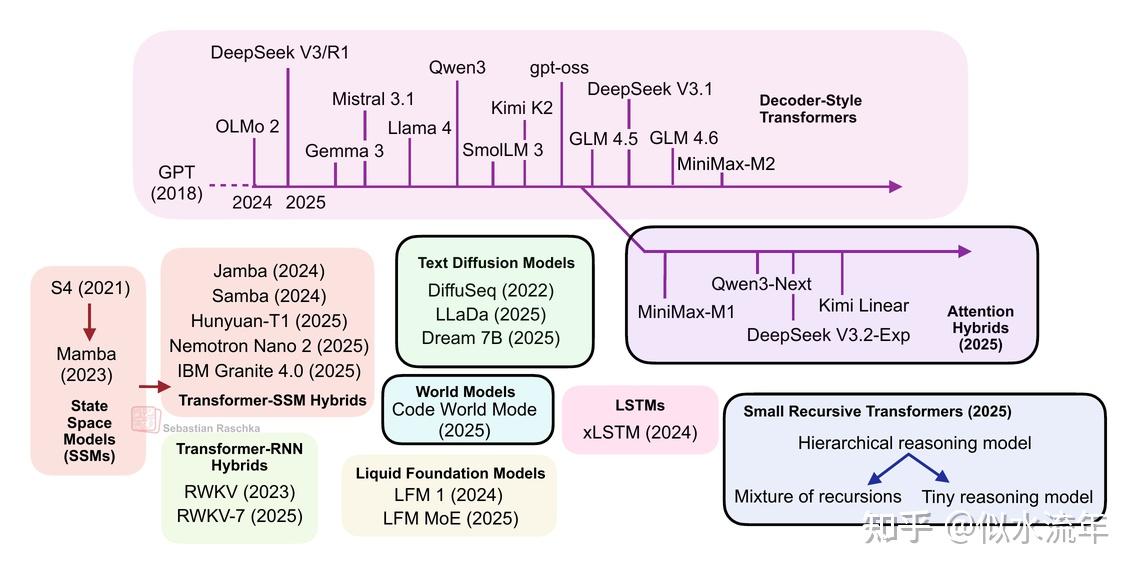
从DeepSeek R1到MiniMax-M2,当今最大且功能最强的开源权重大型语言模型(LLMs)仍然是基于原始多头注意力机制变体的自回归解码器式Transformer。 然而,近年来我们也看到了标准LLMs的替代方案不断涌现,从文本扩散模型到最新的线性注意力混合架构。其中一些旨在提高效率,而另一
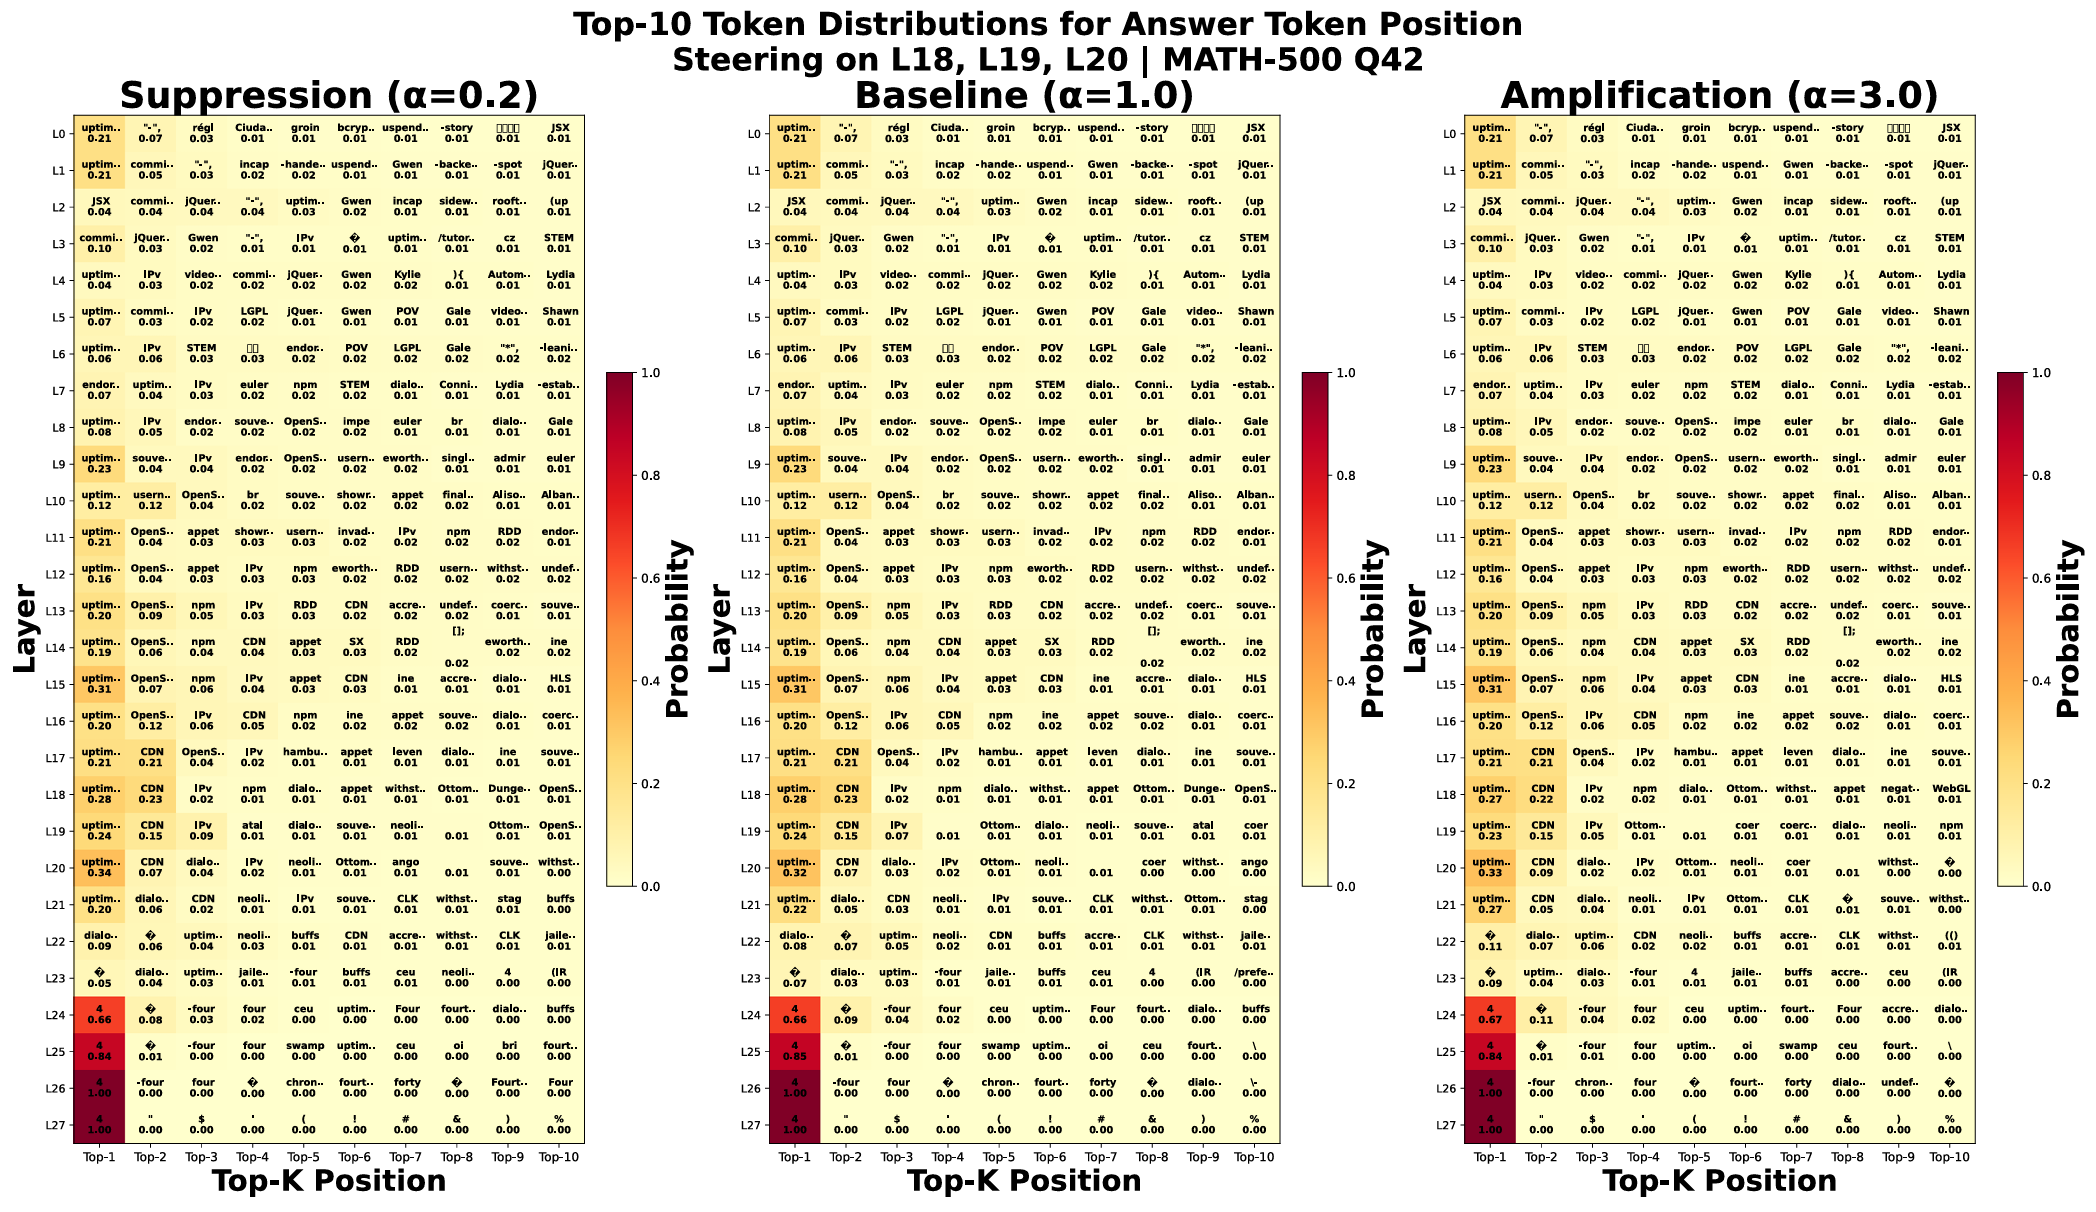
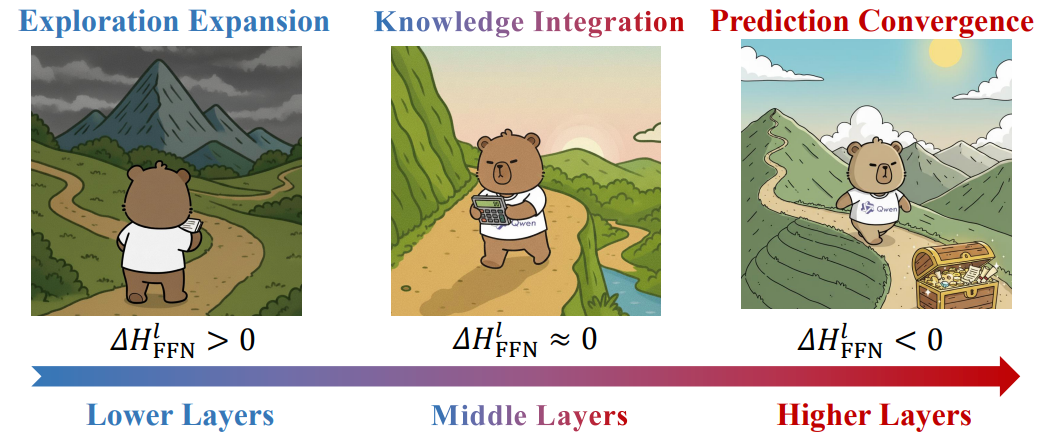
当前,大模型+强化学习成为AI领域极为热门的研究。现有的强化学习(RL)方法通常将大语言模型(LLM)视为一个单一的整体策略进行优化,主要的算法优化集中在表层的奖励设计等方面,却忽略了模型内部复杂的层级演化机制。 大模型的黑盒特征通常阻碍了我们进一步了解其内部工作机理,然而理解其如何执行内部推理能为
作者:大润发杀鱼工 https://zhuanlan.zhihu.com/p/1985812420770428370* 前情提要 窝趴在电脑前下棋的我,突然被微信里 junrong 老师Q到了,说知乎上又刷到了我去年的年终总结,还问我今年什么时候写。ahhh,其实本来是有想写的,可惜这个班害人不浅,
作者:唐杰 https://weibo.com/2126427211/5247011059141988 最近的一些感悟,分享一下,希望对大家有用。 1、预训练使得大模型已经掌握世界常识知识,并且具备简单推理能力。更多数据、更大参数和更饱和的计算仍然是scaling基座模型最高效的办法。 2、激活对齐
作者:天晴 https://zhuanlan.zhihu.com/p/1986921621240447760 用 RL 做后训练 LLM 时,探索效率和训练稳定性是两个最核心的问题。这半年,我积累了不少心得感悟,也踩了很多坑。由于打算金盆洗手不再做这方面的工作了,索性把这些经验分享给大家。 当然,这
本文作者来自小米大模型 Plus 团队,共同一作为张少杰、张若嶒、付培,通讯作者为多模态感知方向负责人罗振波。 在打造智能数字助手的过程中,让智能体像人类一样自然地理解并操作图形界面是一项核心难题。尽管多模态大模型与强化学习微调推动了智能体的进步,但其交互逻辑与真实的人机交互仍存在明显差距。 为缩小
视觉-语言-动作 + 强化学习:VLA+RL 最新研究全景(含论文、链接与代码) 随着基于大规模模仿学习的视觉-语言-动作 (VLA) 模型取得显著进展,将 VLA 与强化学习 (RL) 相结合已成为一种极具前景的新范式。该范式利用与环境的试错交互或预先采集的次优数据,进一步提升机器人的决策与执行能
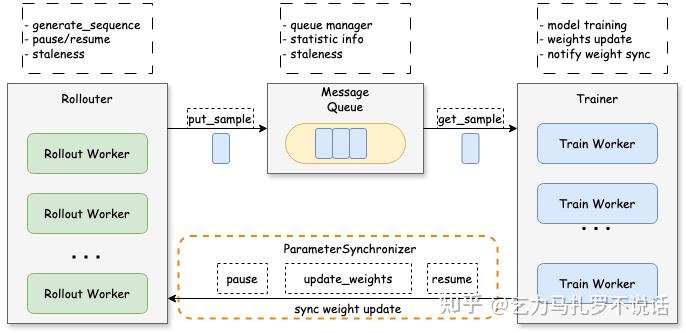
作者:乞力马扎罗不说话 https://zhuanlan.zhihu.com/p/1978600046514685178 这篇博客想法诞生于上半年基于 trl / verl 魔改 agentic rl 时期,但拖延一直搁置。眼看相关技术栈演进速度惊人,再不发出来就要过气了,于是决定抛砖引玉分享。预计
在AI席卷各行各业的今天,体育圈的“智能化”走到哪一步了?现有的智能体育系统,大多还停留在“打分+可视化”的阶段。屏幕上画出的骨骼线很酷,但对于运动员和教练来说,往往面临一个尴尬的灵魂拷问:“我知道我动作不对,分很低,但为什么不对?我该怎么练才能提高?” 通用大模型(如 GPT-5)虽然在自然语言交
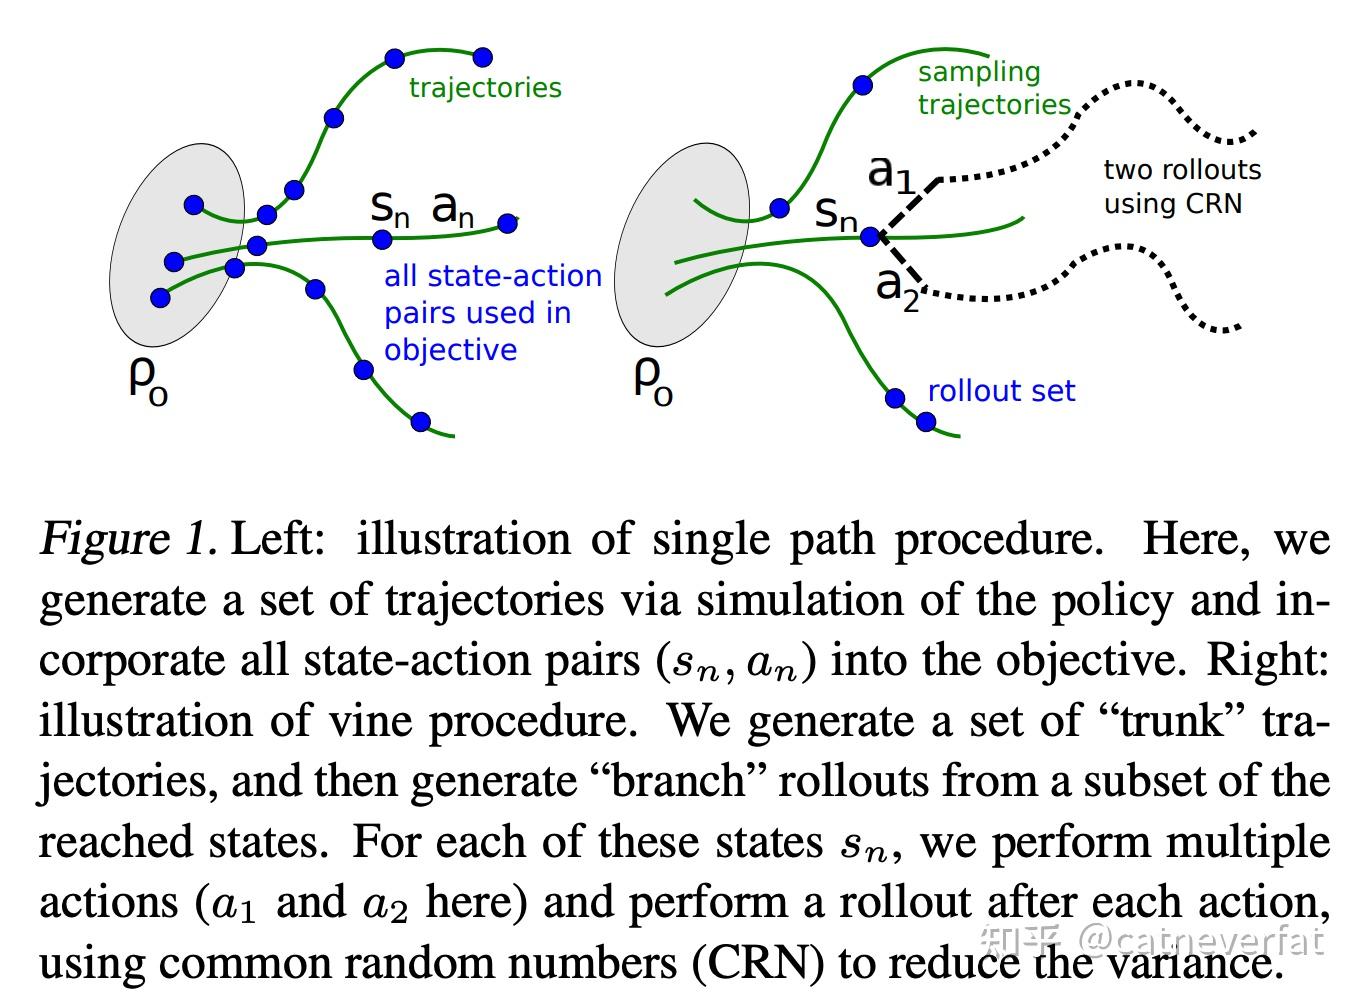
作者:catneverfat https://zhuanlan.zhihu.com/p/1908671543476749557 PPO是一种被广泛应用于各个场景下的强化学习算法,笔者之前对它展开过介绍。但是当时主要的理论推导集中在Policy Gradient部分,对PPO主要介绍的是它的目标函数以
随着大语言模型(LLM)的广泛应用,它们在医疗、金融、教育等关键行业扮演着愈发重要的角色。然而,一个被忽视的现实是:大模型的知识并不会自动更新,更不总是准确。当模型输出过时信息、错误事实甚至自信满满的“胡说八道”时,如何快速、精准、低成本地纠正它?知识编辑(Model Editing)因此成为近年来
生成式视频模型正以前所未有的速度进化,从数秒短片拓展至长时段叙事,从模糊低清跃升至逼真4K。然而,随着视频时长和空间分辨率的提升,序列长度急剧增加,二次复杂度的注意力计算量随之飙升,即便采用 FlashAttention 等高效优化,推理延时仍然难以遏制。以生成一段 720p、5 秒的视频为例,单是
作者:Cyril-KI 原文:https://zhuanlan.zhihu.com/p/1982850692340273471 一个有趣的训练现象 在SFT阶段,我们精心设计”Let’s think step by step”提示,成功诱导出丰富的思维链。然而进入RL阶段后,Wandb监控曲线显示R
1、VLM 做 AD 的头部问题:(1)幻觉问题,具体表现为无中生有、视而不见;(2)3D 空间理解能力不足;(3)速度慢。 幻觉问题的原因:静态感知。解决方案:动态感知,例如通过多次校验减少训练数据中的幻觉;例如通过 DPO 减少训练模型时产生的幻觉。例如允许模型“回头放大看看”。 3D 空间理解
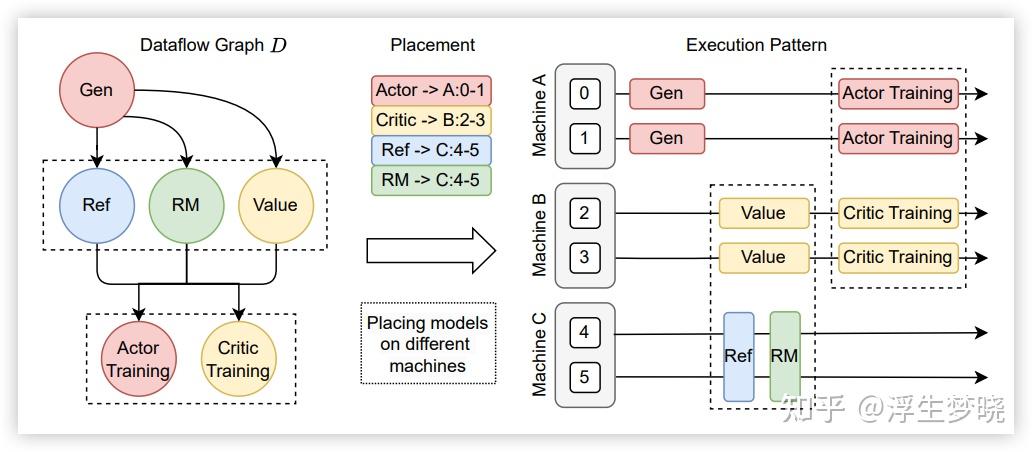
作者:浮生梦晓 https://zhuanlan.zhihu.com/p/1979237927641949997 前段时间调研了一些 RL 训练框架,目前开源社区的 RL 训练框架可以说百花齐放,老牌的有 openlhf、trl、unsloth、verl。还有今年新开源的 slime、AReaL、R
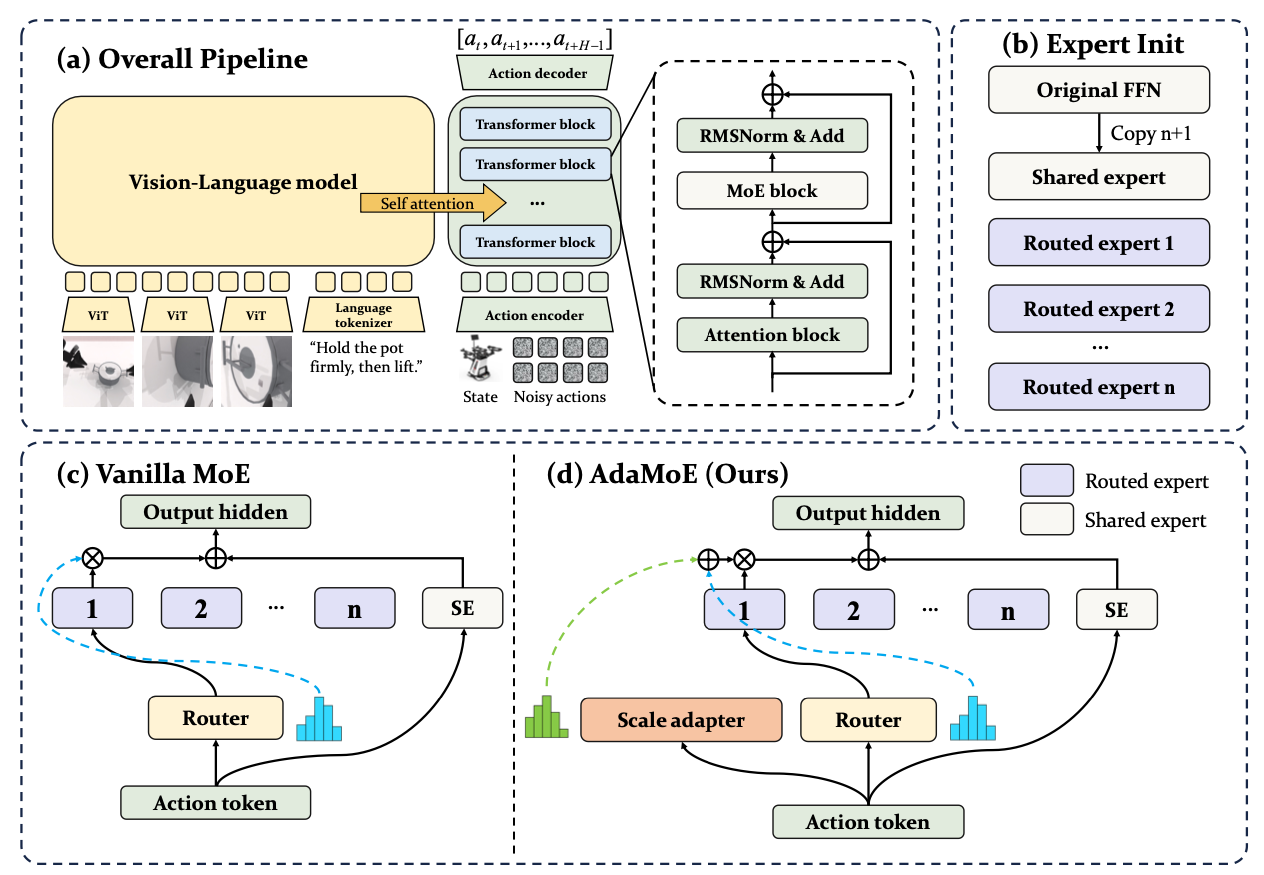
作者:小红师兄 https://zhuanlan.zhihu.com/p/1980358735869268796 今天聊聊AdaMoE(VLA),先用一句话概括一下:AdaMoE 这篇论文想解决的是「在 Vision-Language-Action (VLA) 模型里用 Mixture-of-Exp
最近几个月在各种场景上做了大量的agent RL训练,例如search agent, 数据分析agent 等等。既有小的dense model,也有大的moe。有单一数据场景,有多源合板数据场景。有失败的经历,也有成功的经历。这里抽空分享下一些感悟,比较乱,随便看看就行: 1、稳定性是工业级场景下R
作者:小秋 https://zhuanlan.zhihu.com/p/1979682819170145066 前言 快慢双系统早已不是第一次在具身智能里被提出来了。 从 Daniel Kahneman 的《思考,快与慢》到机器人,大家都在拿 System 1 / System 2 打比方:一个负责“
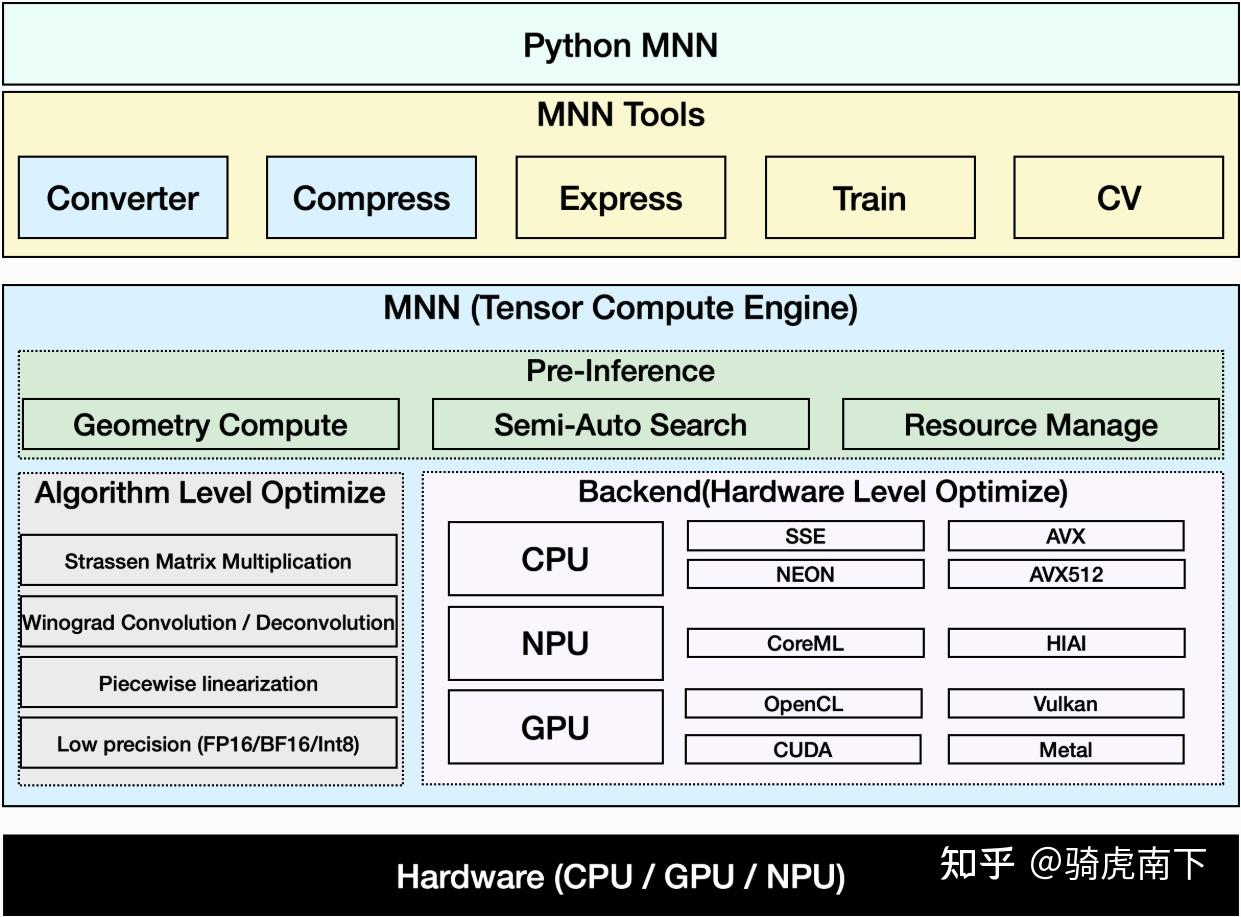
作者:骑虎南下 https://zhuanlan.zhihu.com/p/1931235792501608813 这里,分两个主要模块介绍AI模型推理引擎整体架构与主要功能。回顾AI落地的发展过程,我们可以简单地将AI模型的发展分为小模型领域与大模型领域。 在小模型领域以CNN模型为主,模型结构变化