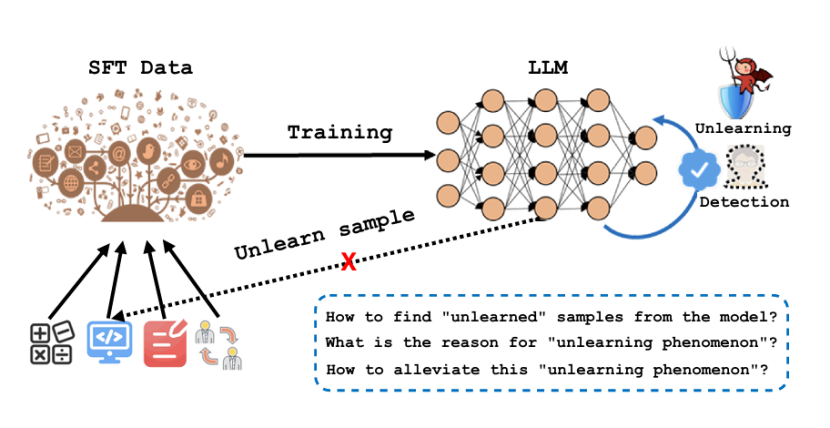
不是所有SFT失败都该加epoch——ACL 2026腾讯混元教你五把「手术刀」
论文: Why Supervised Fine-Tuning Fails to Learn: A Systematic Study of Incomplete Learning in Large Language Models 会议: ACL 2026 |单位: 腾讯混元 × UNSW arXiv:
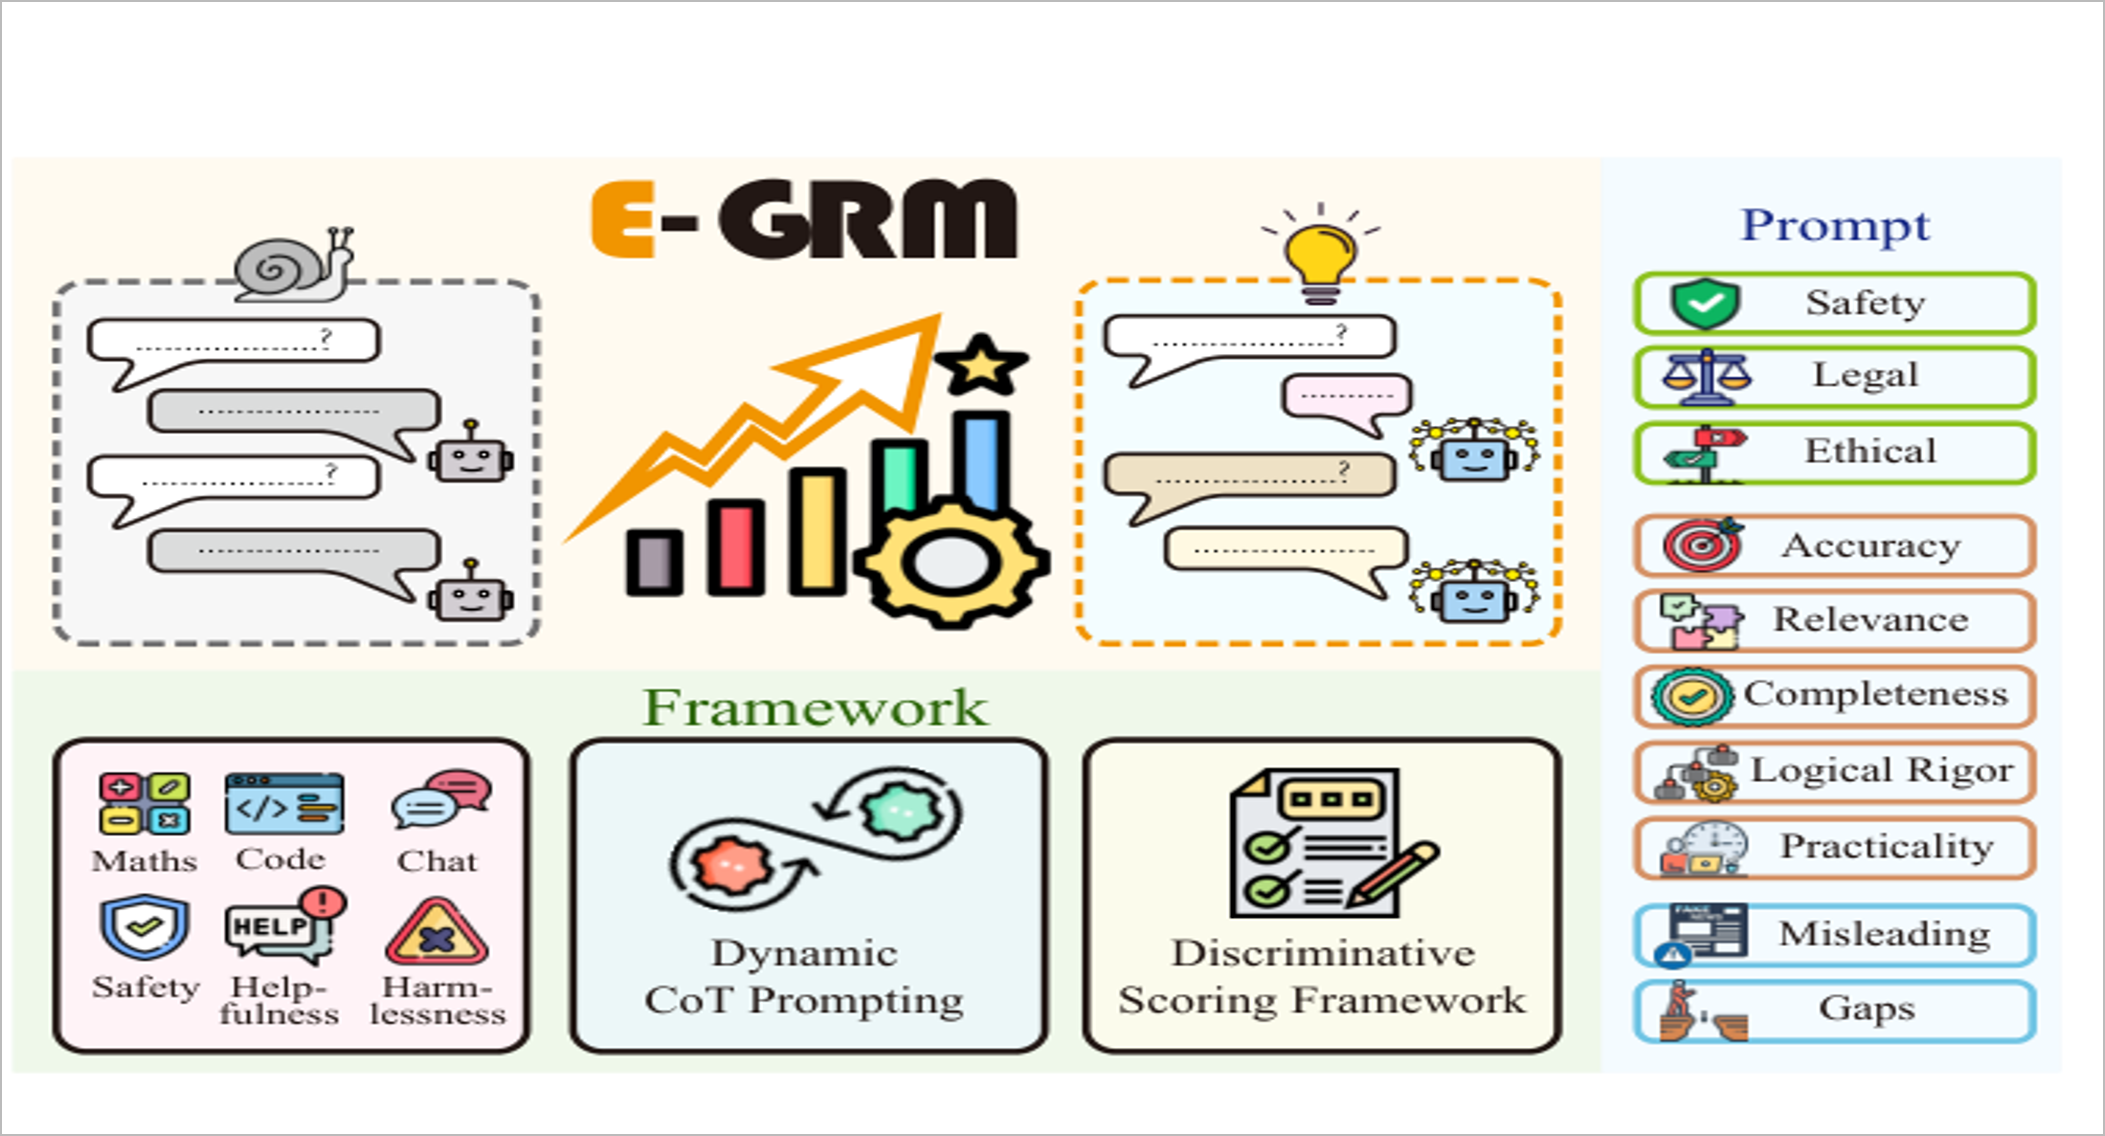
论文题目:Reason Only When Needed: Efficient Generative Reward Modeling via Model-Internal Uncertainty arXiv 链接:https://arxiv.org/abs/2604.10072 作者单位:腾讯混元
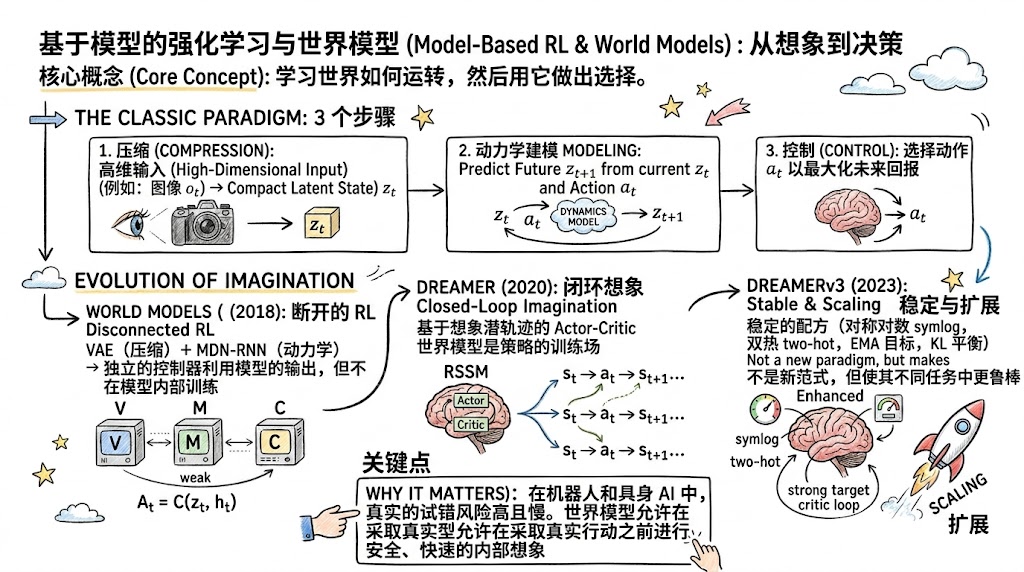
作者:小太阳 https://zhuanlan.zhihu.com/p/2038976197065963264 引言 笔者最近在阅读《LeWorldModel》论文和《第一性原理》一书时,偶然发现两者在方法论上有某种相通之处,于是想写下这篇博客,记录自己的一段学习与思考。 当前,大语言模型(LLM)
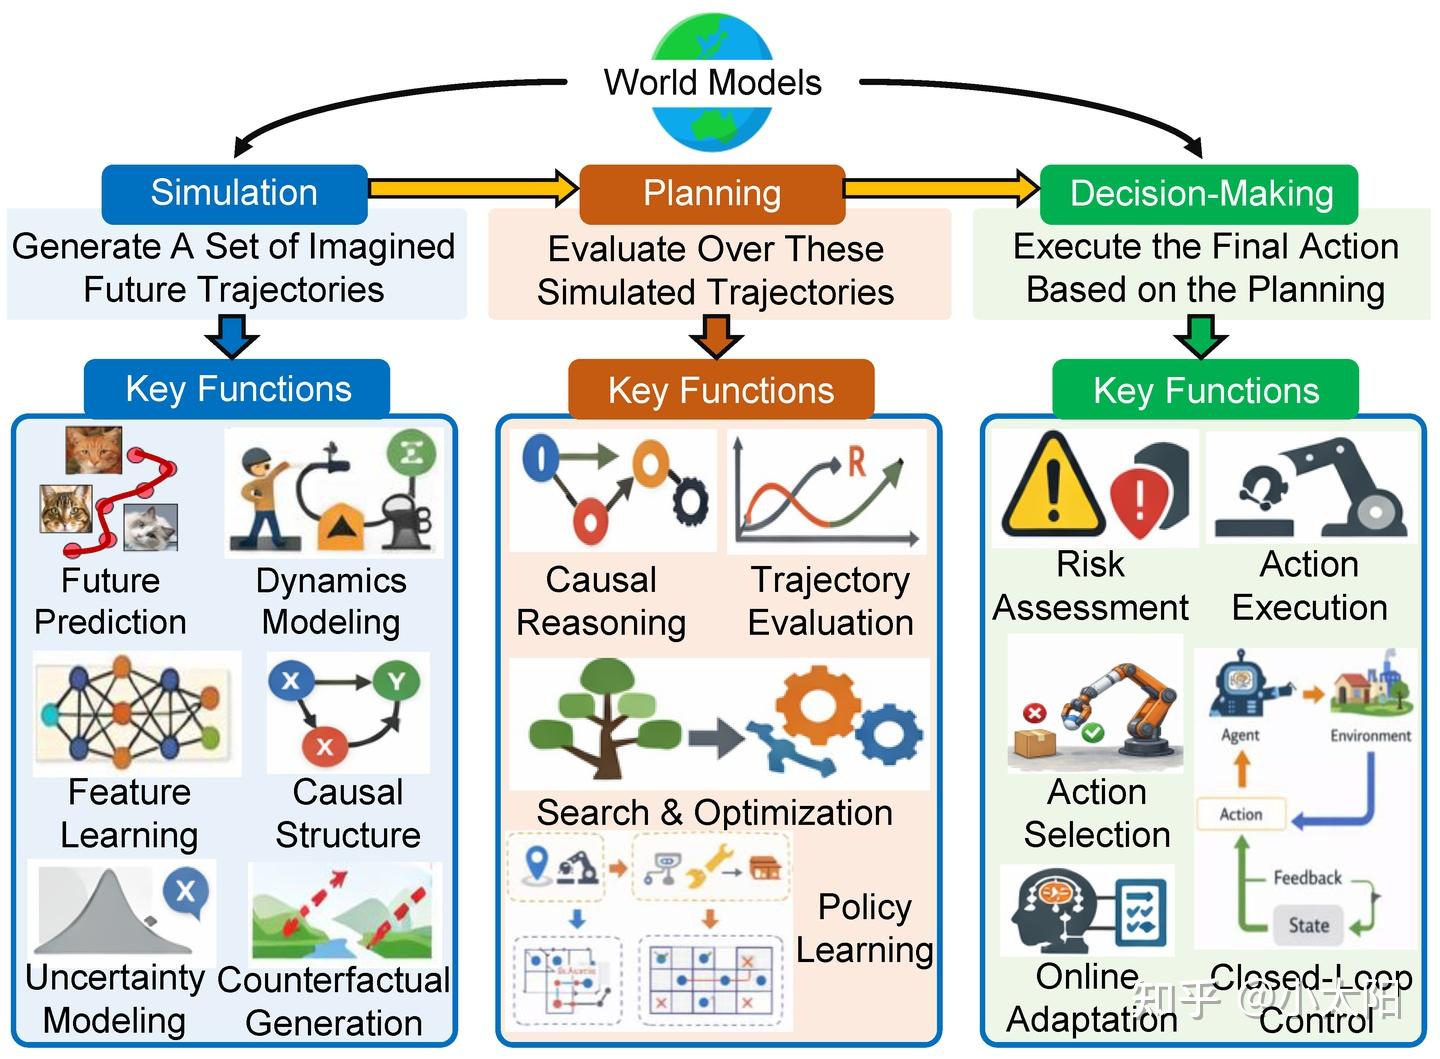
一、为什么具身智能重新关注世界模型? "世界模型"在具身智能领域似乎又变成了一个高频词,它为什么又回到了热门呢,和传统强化学习又有哪些区别? 首先,从 Model-Based RL 的视角看,世界模型并不是一个全新的概念,它可以理解为 Model-Based RL 中的 learned dynami
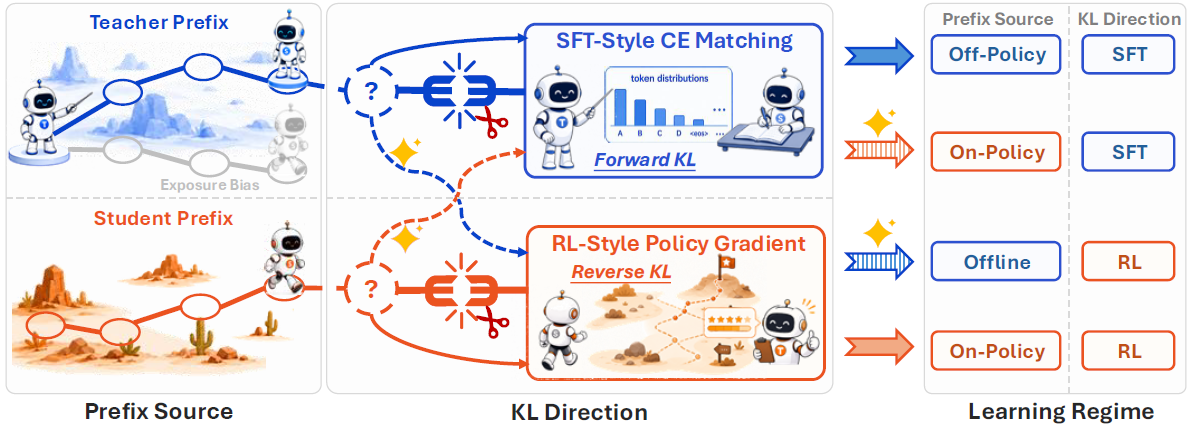
蒸馏 + RL 已经是 reasoning 模型后训练的标配:DeepSeek-R1、s1、OpenThinker 走的是“off-policy 蒸馏再 RL”,Qwen3、MiMo、GLM-5 则把 on-policy distillation(OPD)直接编进了后训练管线。 但有一个问题很少有人
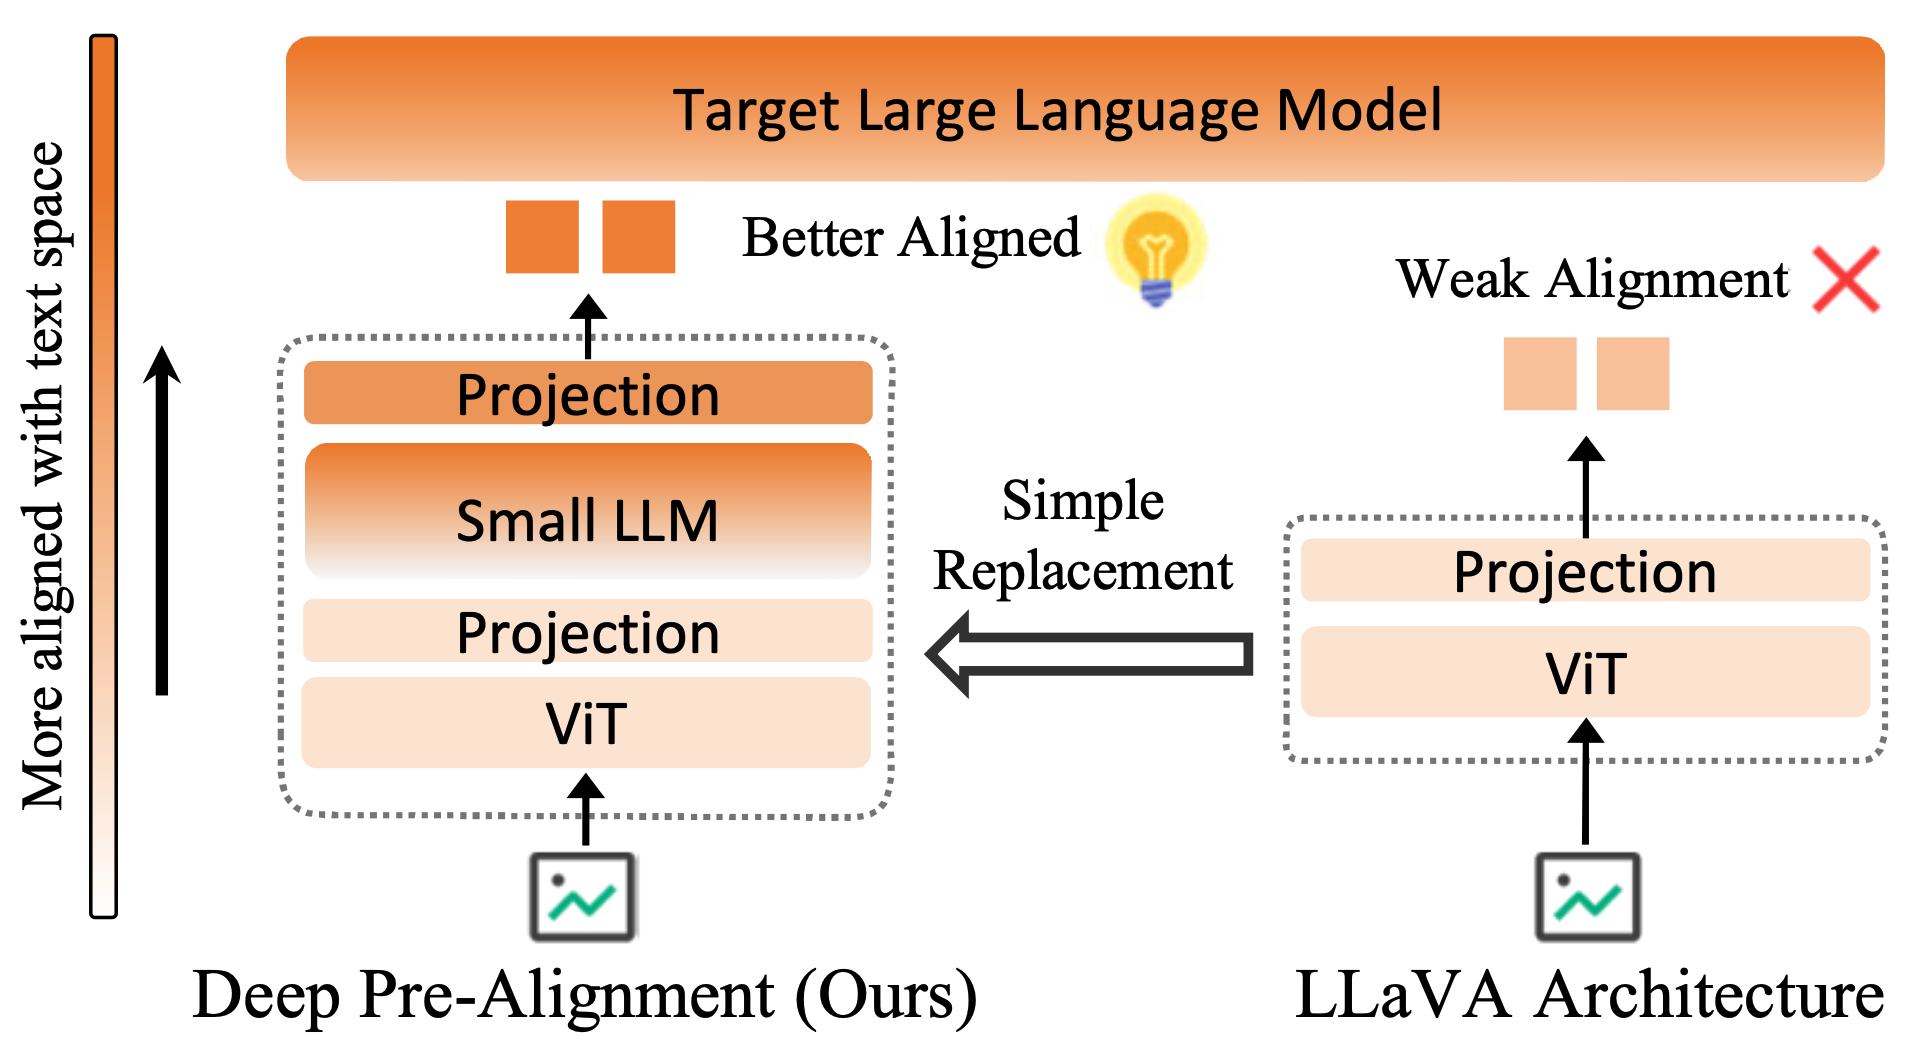
近年来,视觉语言模型(Vision-Language Models, VLMs)已经成为多模态理解与推理任务中的主流范式。当前大多数 VLM 采用 “视觉编码器(通常为 Vision Transformer, ViT)+轻量投影层(projector)+大语言模型(Large Language Mo
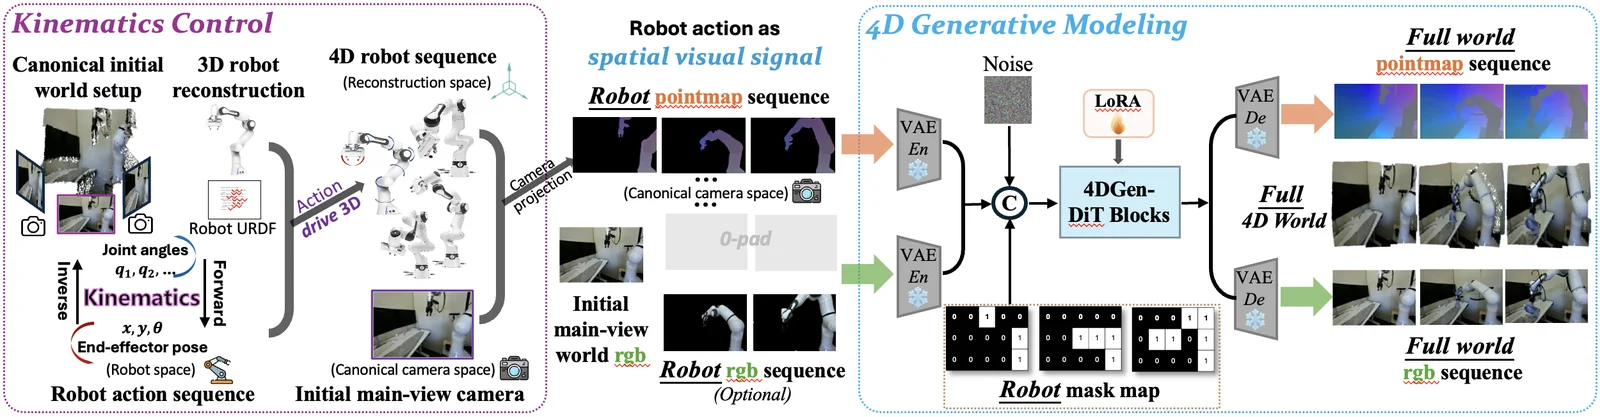
本文第一作者许牧天,南洋理工大学MMLab博士后。导师刘子纬教授,为本文通讯作者。 机器人-环境交互模拟是具身智能的核心。近期,一些研究展现了利用视频生成技术突破传统模拟器“僵化”的视觉与物理限制的潜力。 然而,这些工作主要在 2D 空间运行、或受制于静态环境的单一引导,忽略了一个基本事实:机器人与
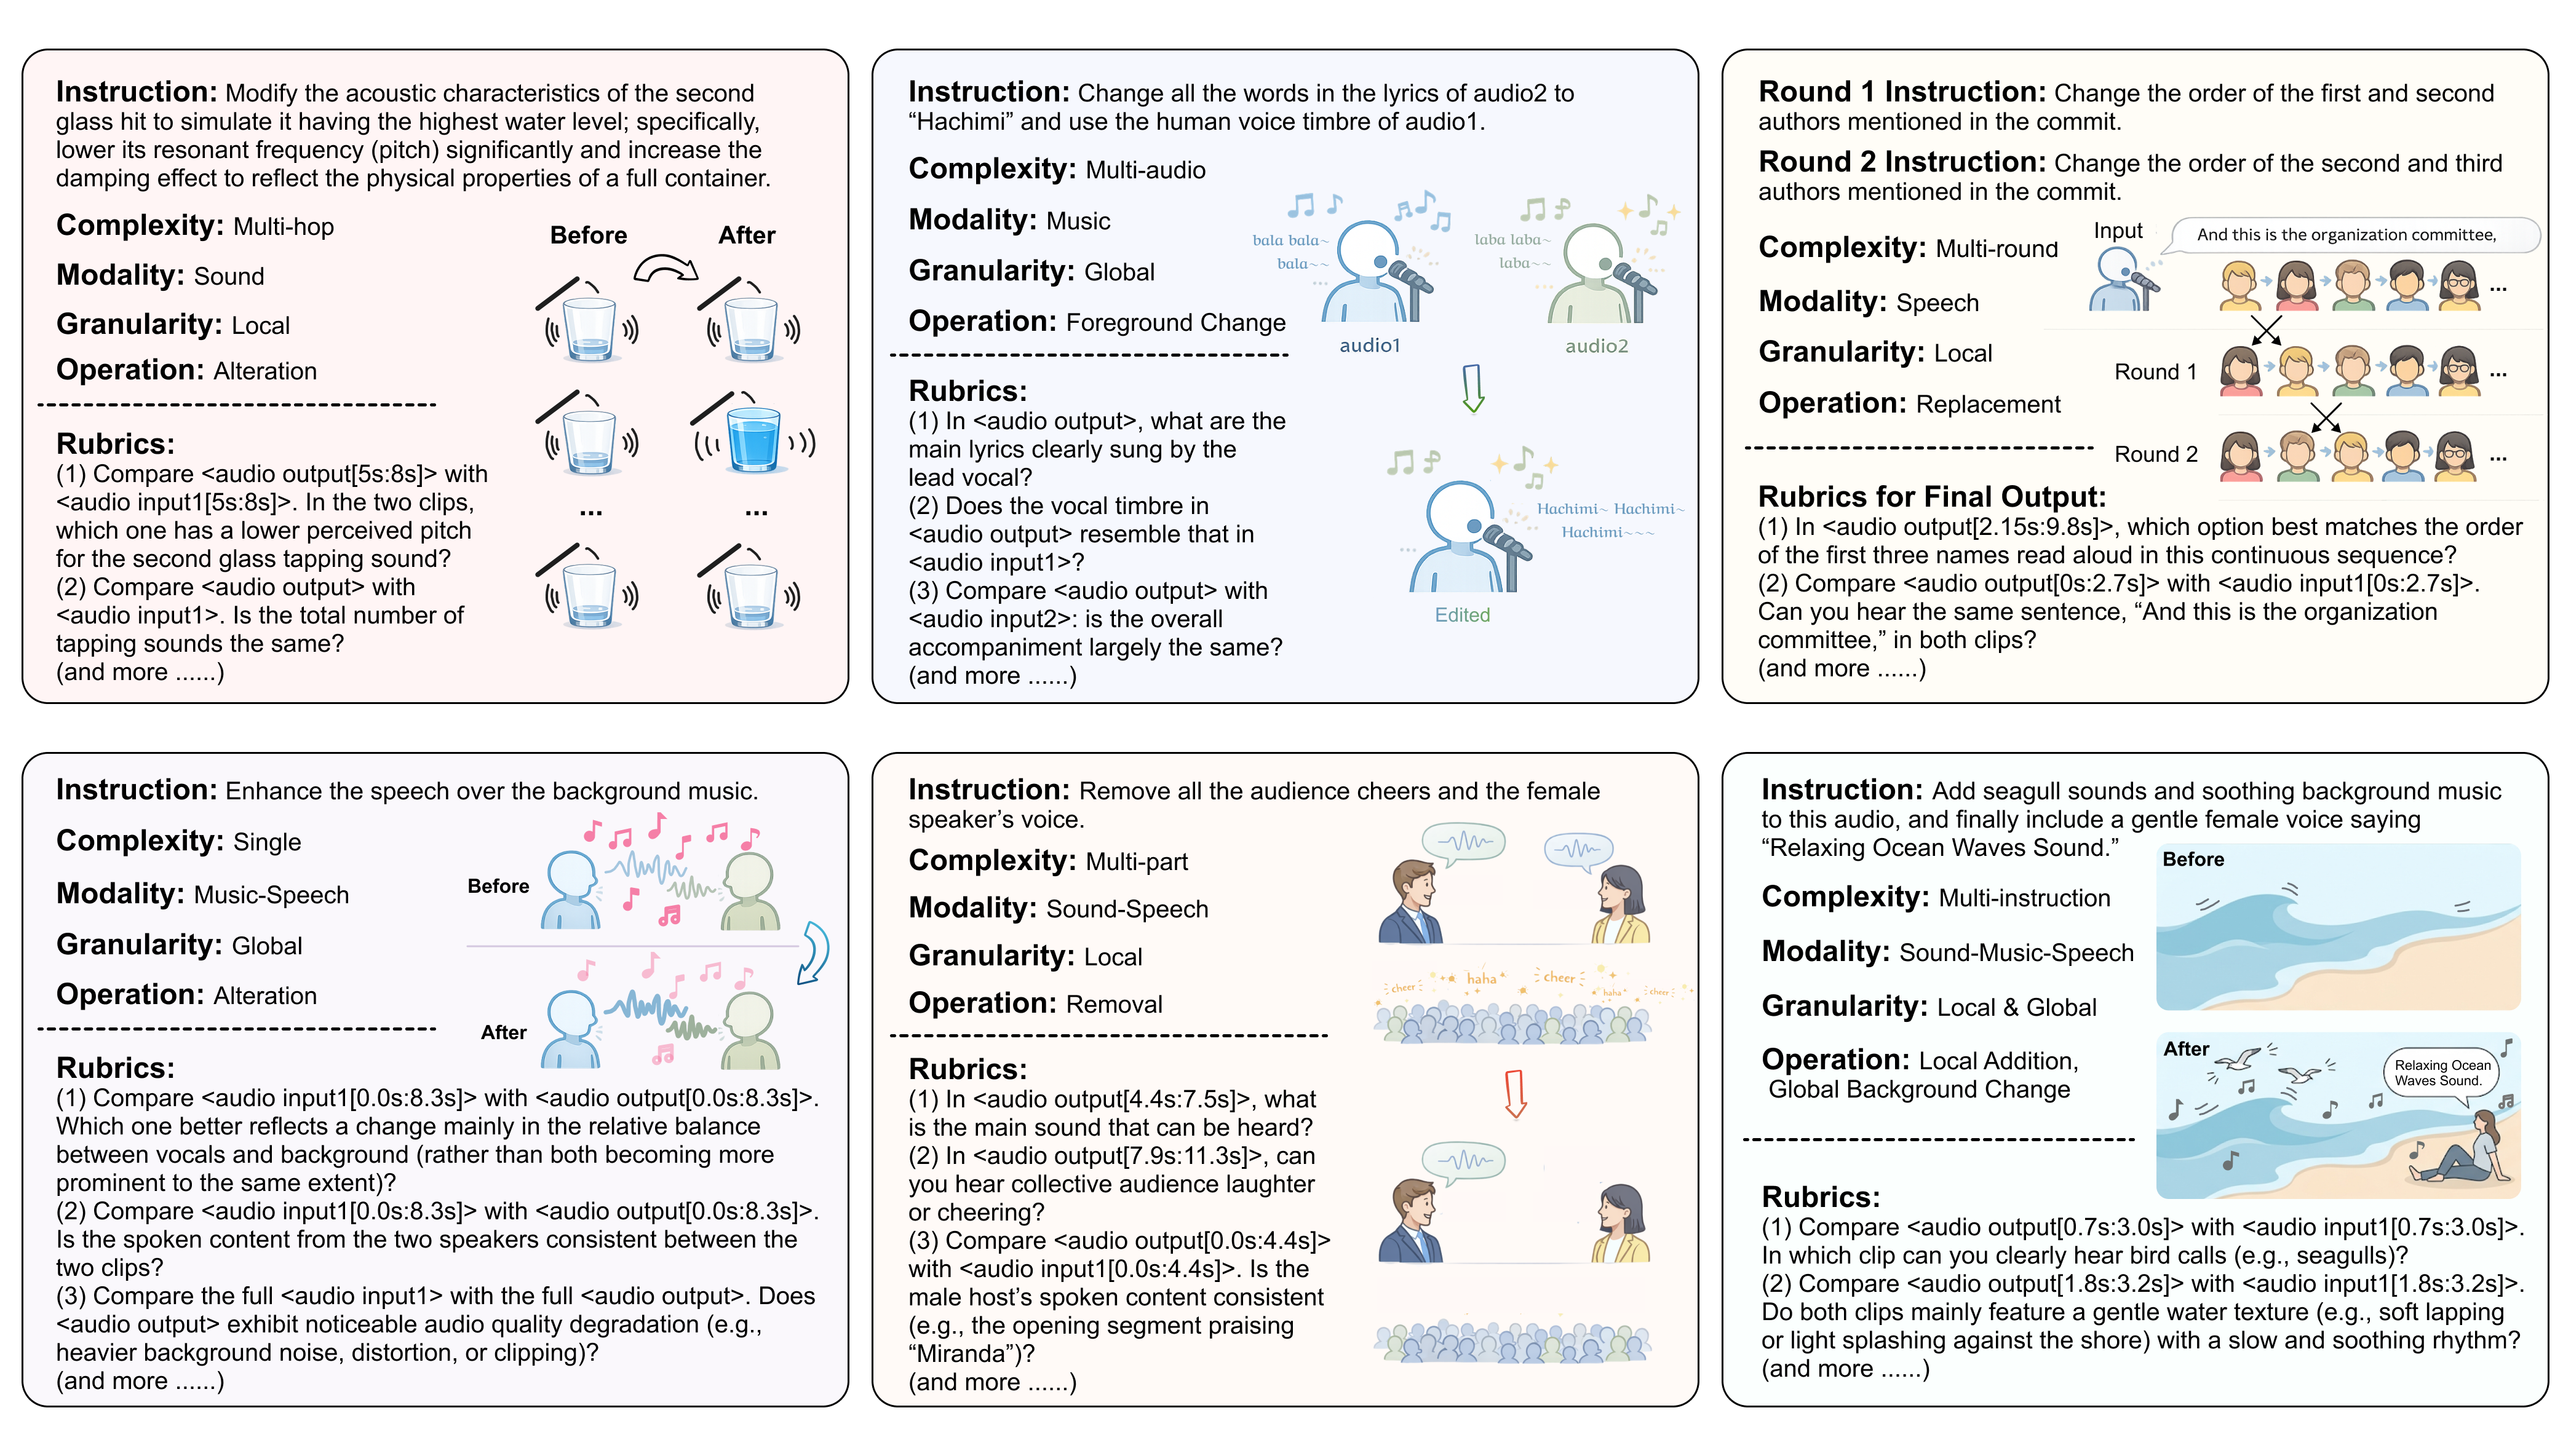
开源链接 📄 Paper: https://arxiv.org/abs/2606.07229 🔥 Daily Paper: https://huggingface.co/papers/2606.07229 💻 Code: https://github.com/ddlBoJack/MMAE 🤖
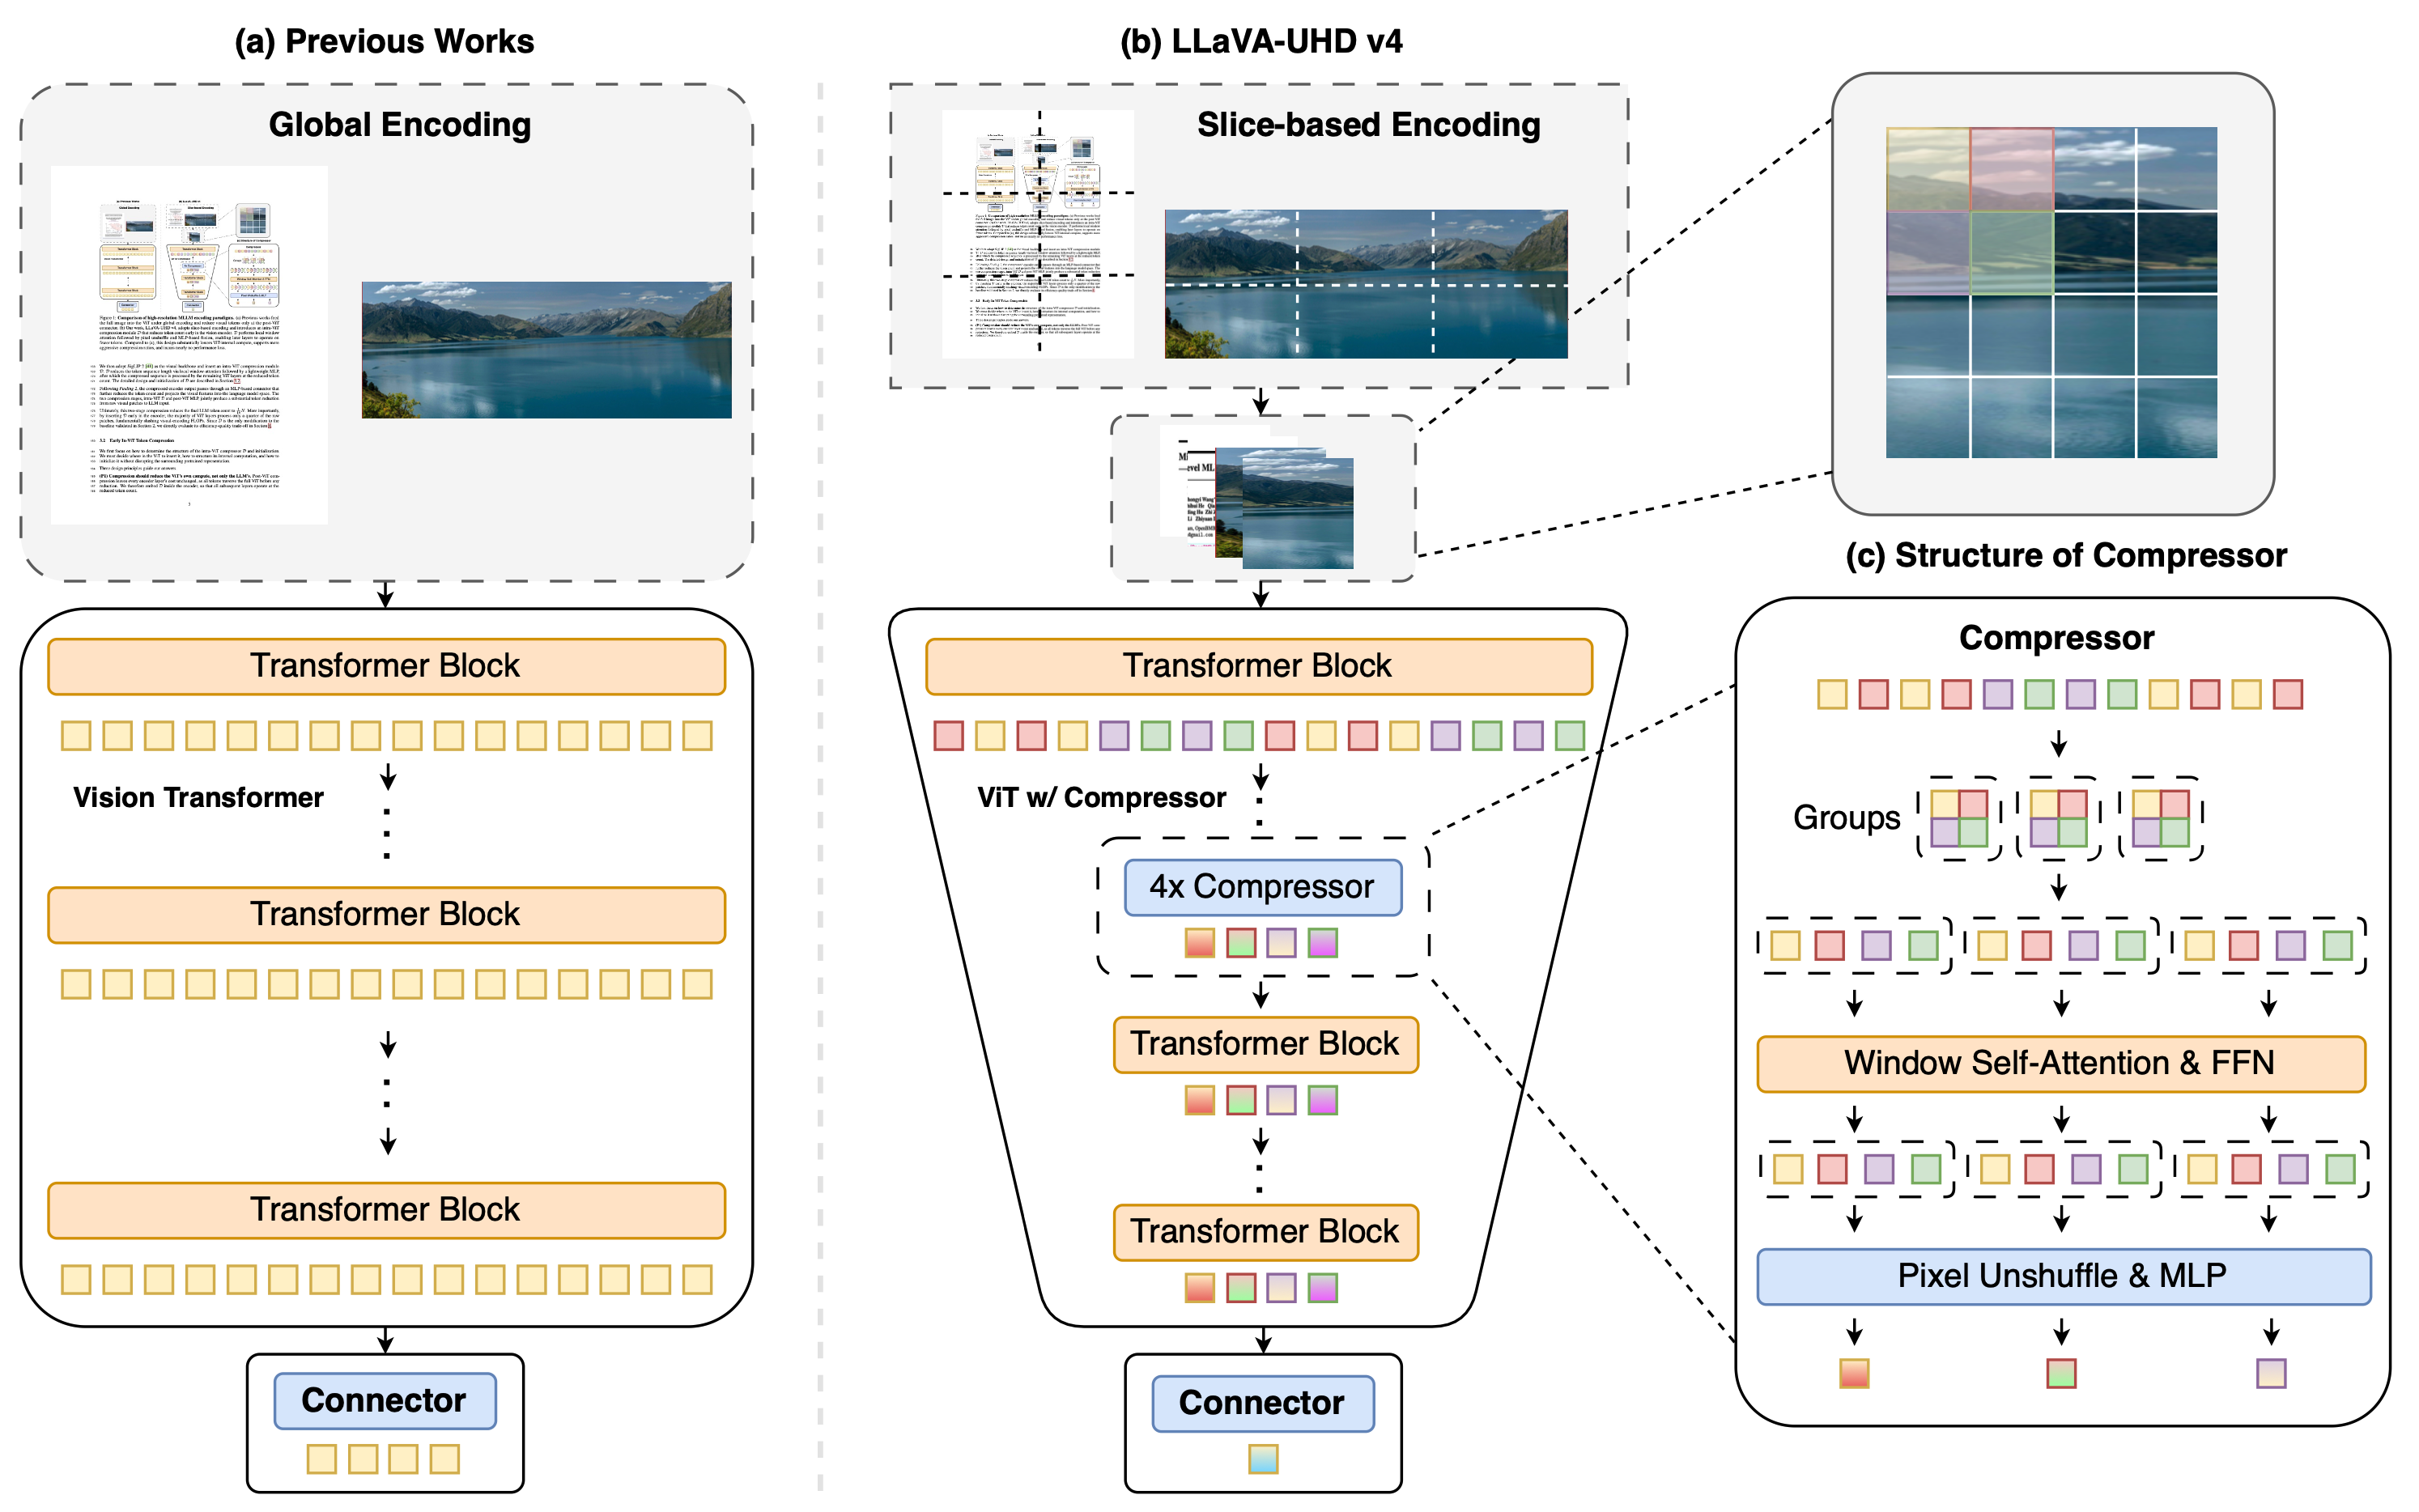
随着多模态大语言模型(Multimodal Large Language Models, MLLMs)不断向文档理解、OCR、图表分析与高分辨率真实场景理解等细粒度任务拓展,高分辨率图像输入正在逐渐成为主流配置。 然而,更高的视觉分辨率也带来了急剧增长的视觉 token 数量,使得视觉编码本身逐渐成
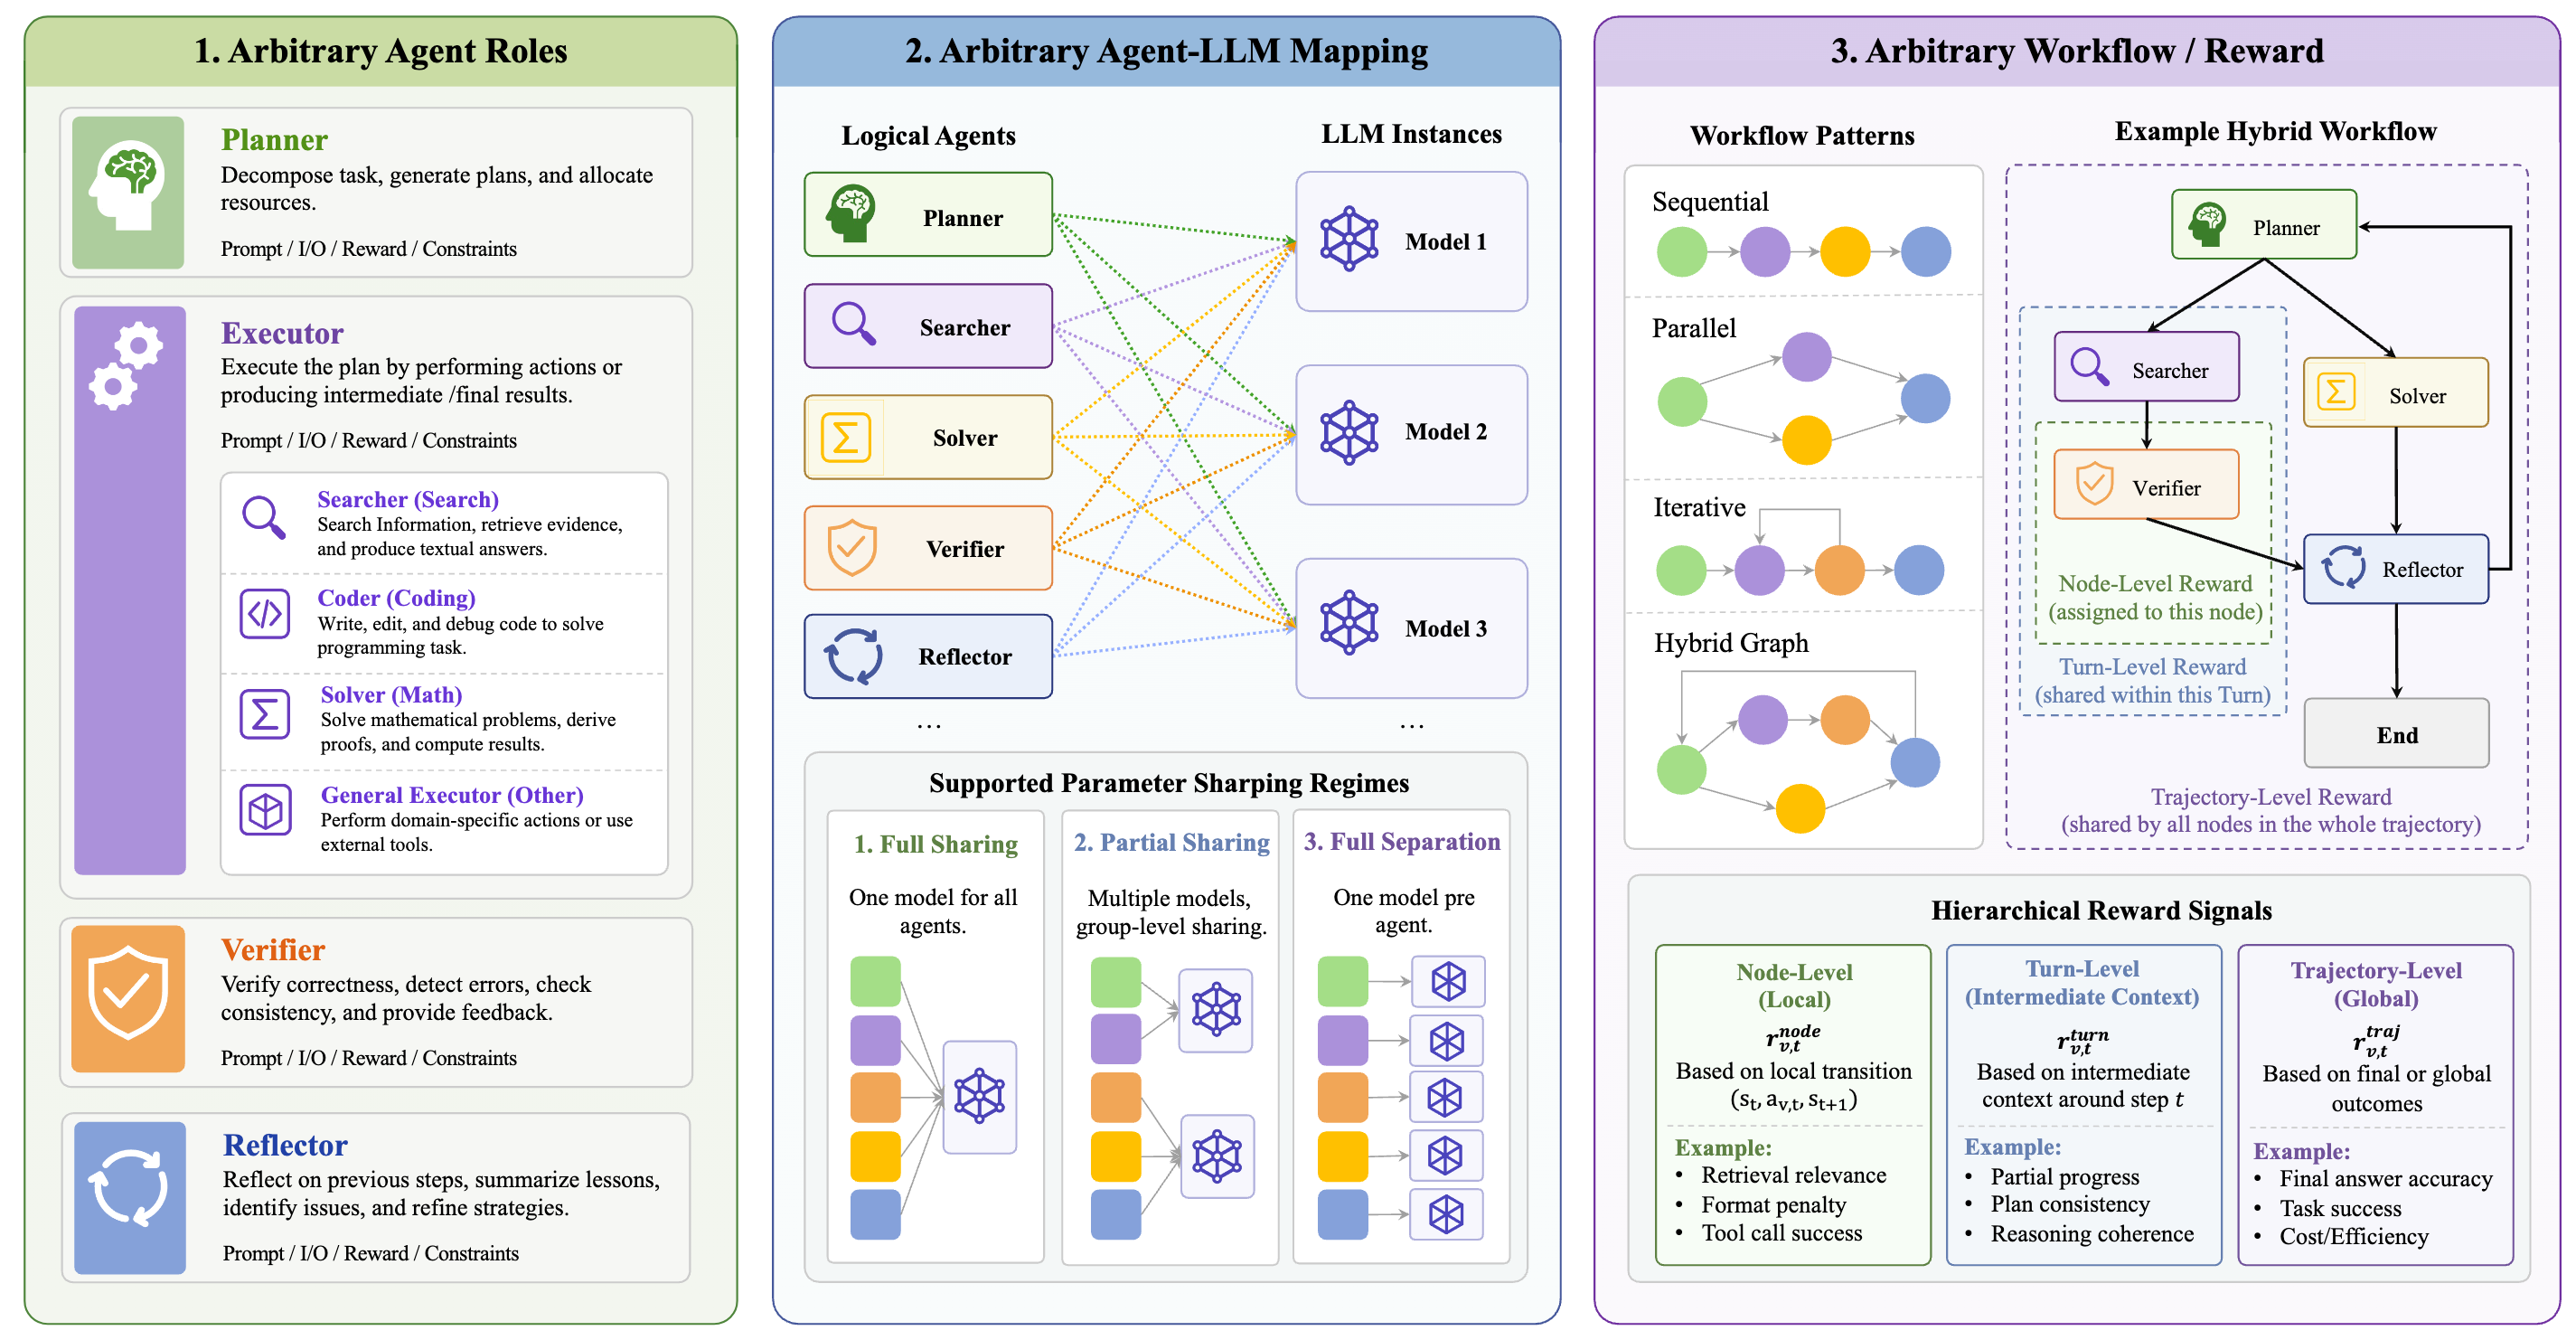
论文标题: UnityMAS-O: A General RL Optimization Framework for LLM-Based Multi-Agent Systems 论文链接: https://arxiv.org/pdf/2605.26646 代码链接: https://github.co
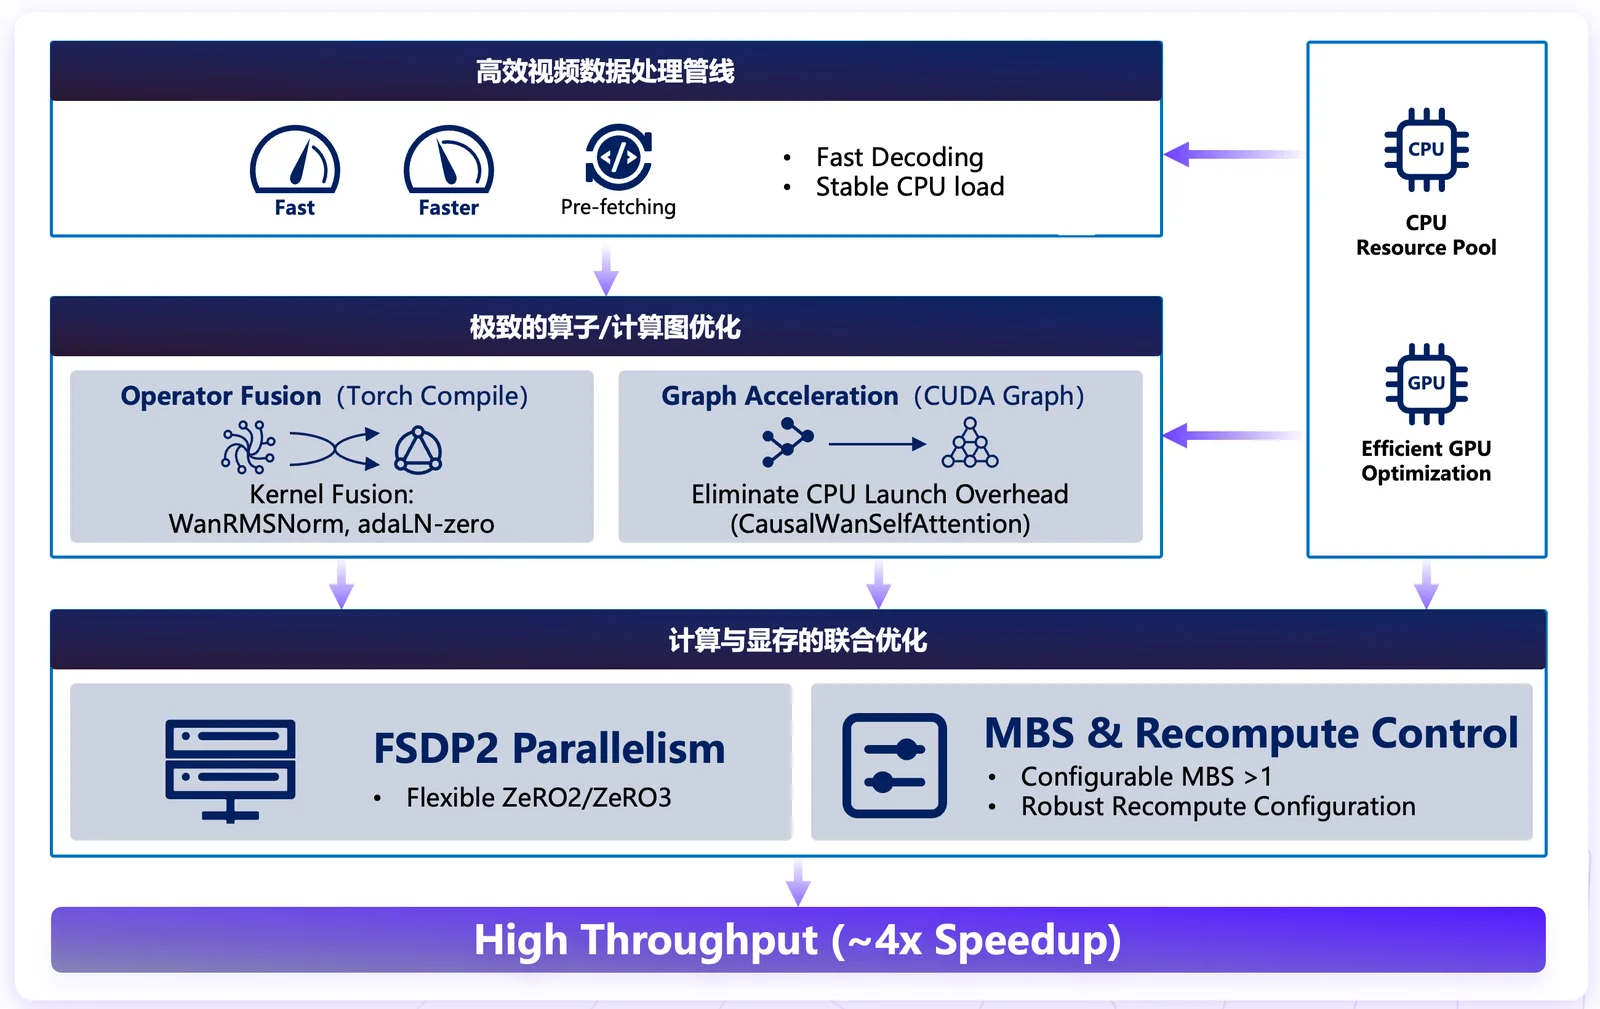
作者:赖睿航,CMU CS Ph.D. https://zhuanlan.zhihu.com/p/2045509863221064141 TL;DR PithTrain 是一个精简、agent-native 的 MoE(Mixture-of-Experts)训练框架,整套实现约 1.1 万行 Pyt
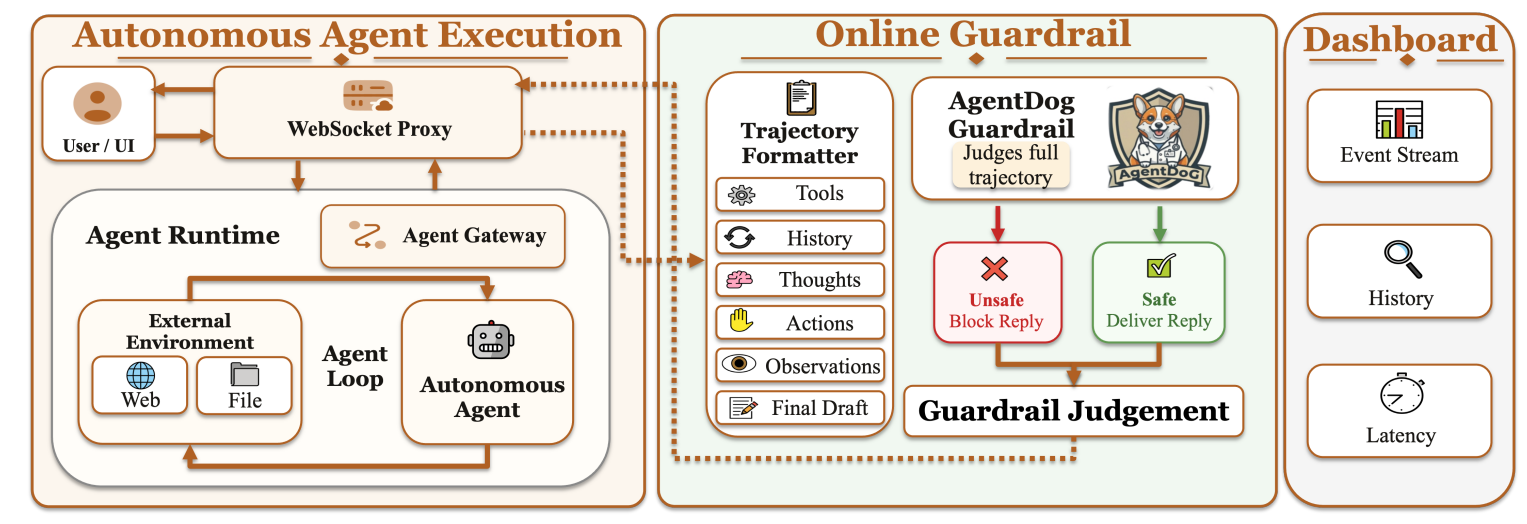
1.Technical Report: https://arxiv.org/abs/2605.29801 2.GitHub: https://github.com/AI45Lab/AgentDoG 3.Project Page: https://ai45lab.github.io/AgentDoG/
作者:朱小霖 原文:https://zhuanlan.zhihu.com/p/2044533166694732929 毫无疑问,OpenClaw 和 Opus 一起撞开了 agent 时代。 slime 从一开始坚持的 server-based engine + custom rollout 设计,
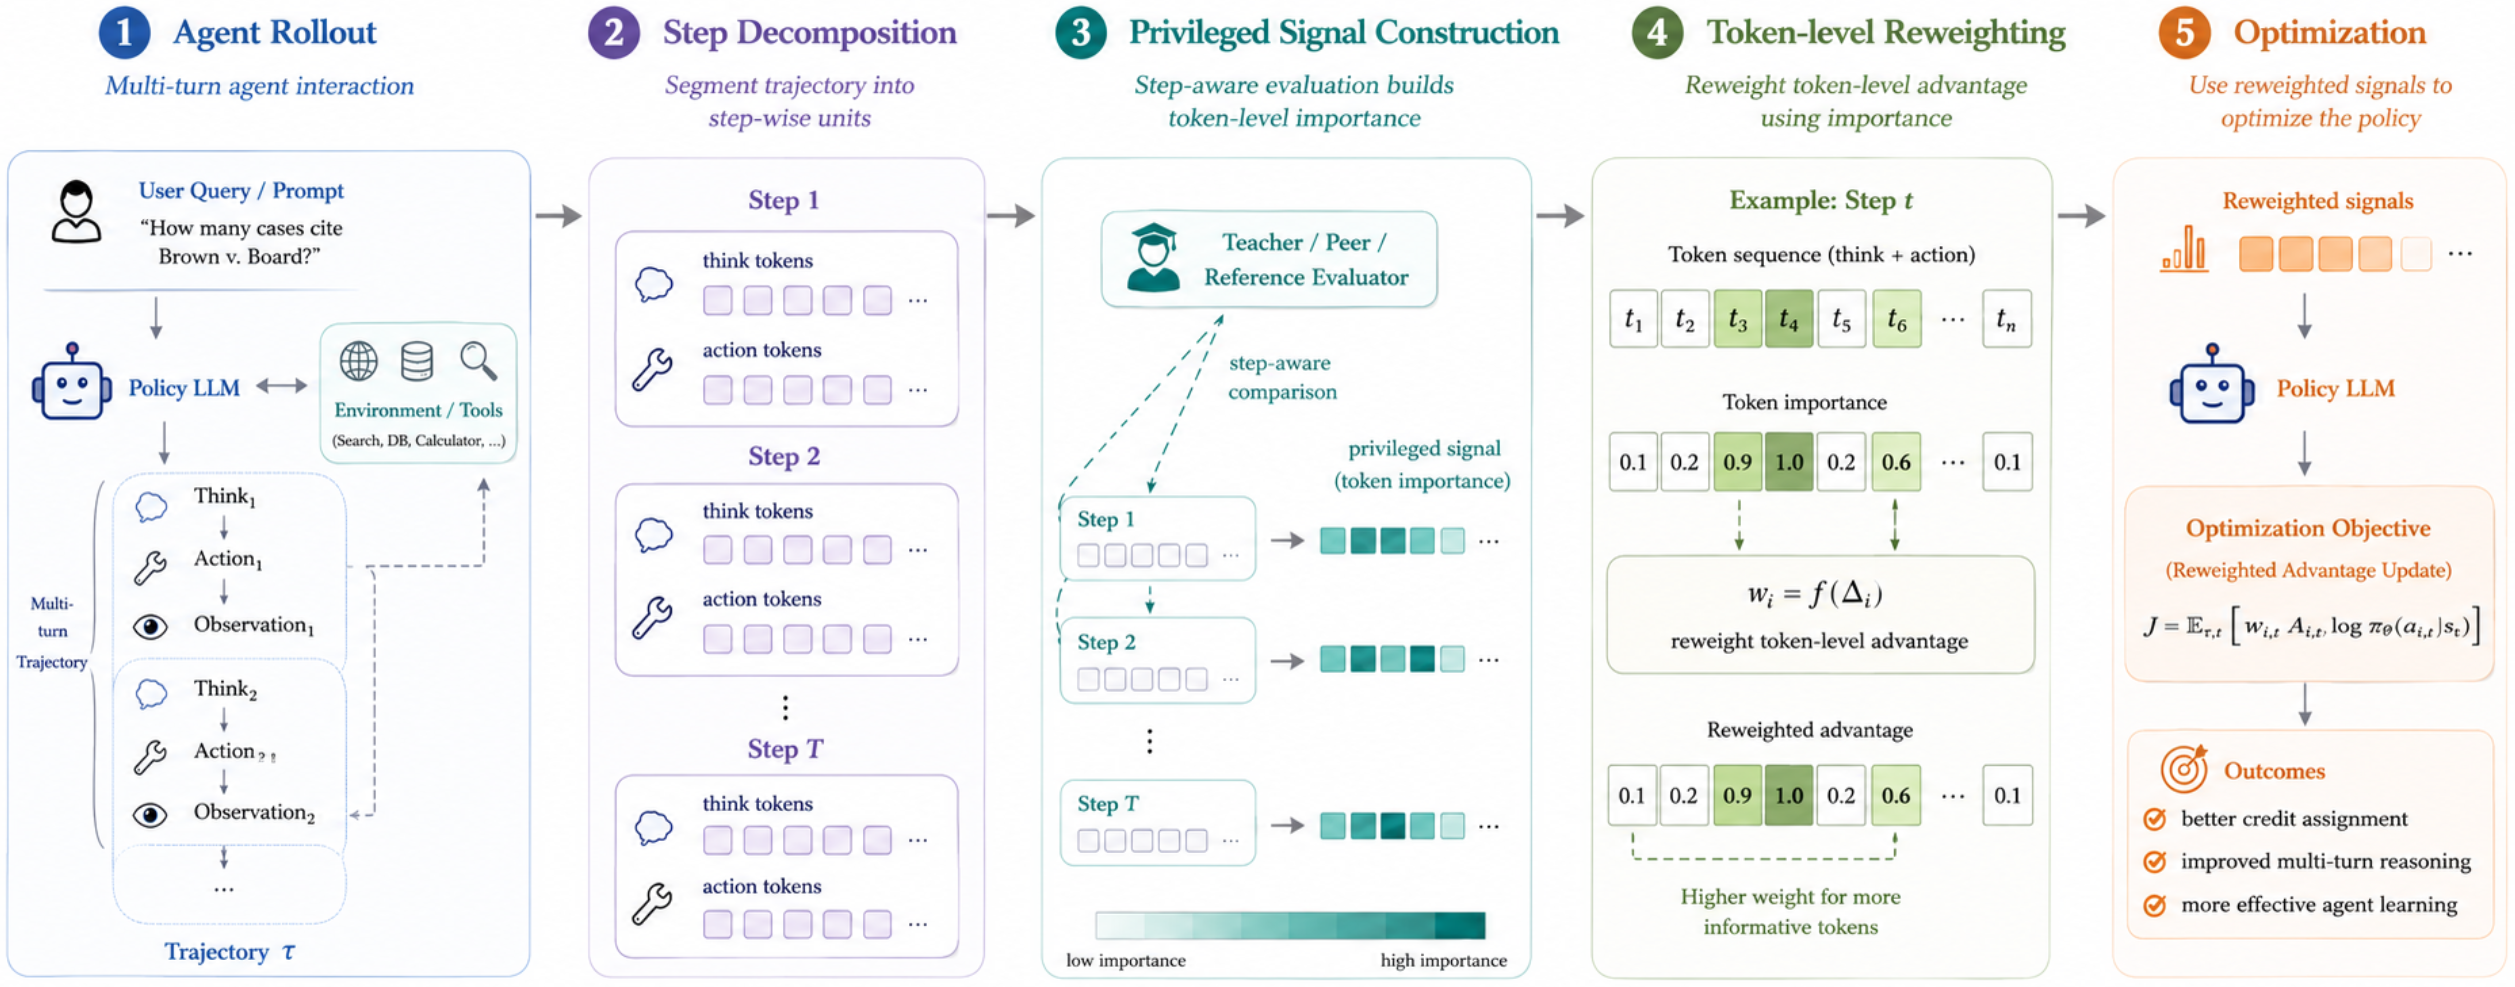
论文:StepOPSD: Step-Aware Online Preference Distillation for Agent Reinforcement Learning 链接:https://arxiv.org/html/2605.27140v1 作者:Yanfei Zhang, Xu Lin
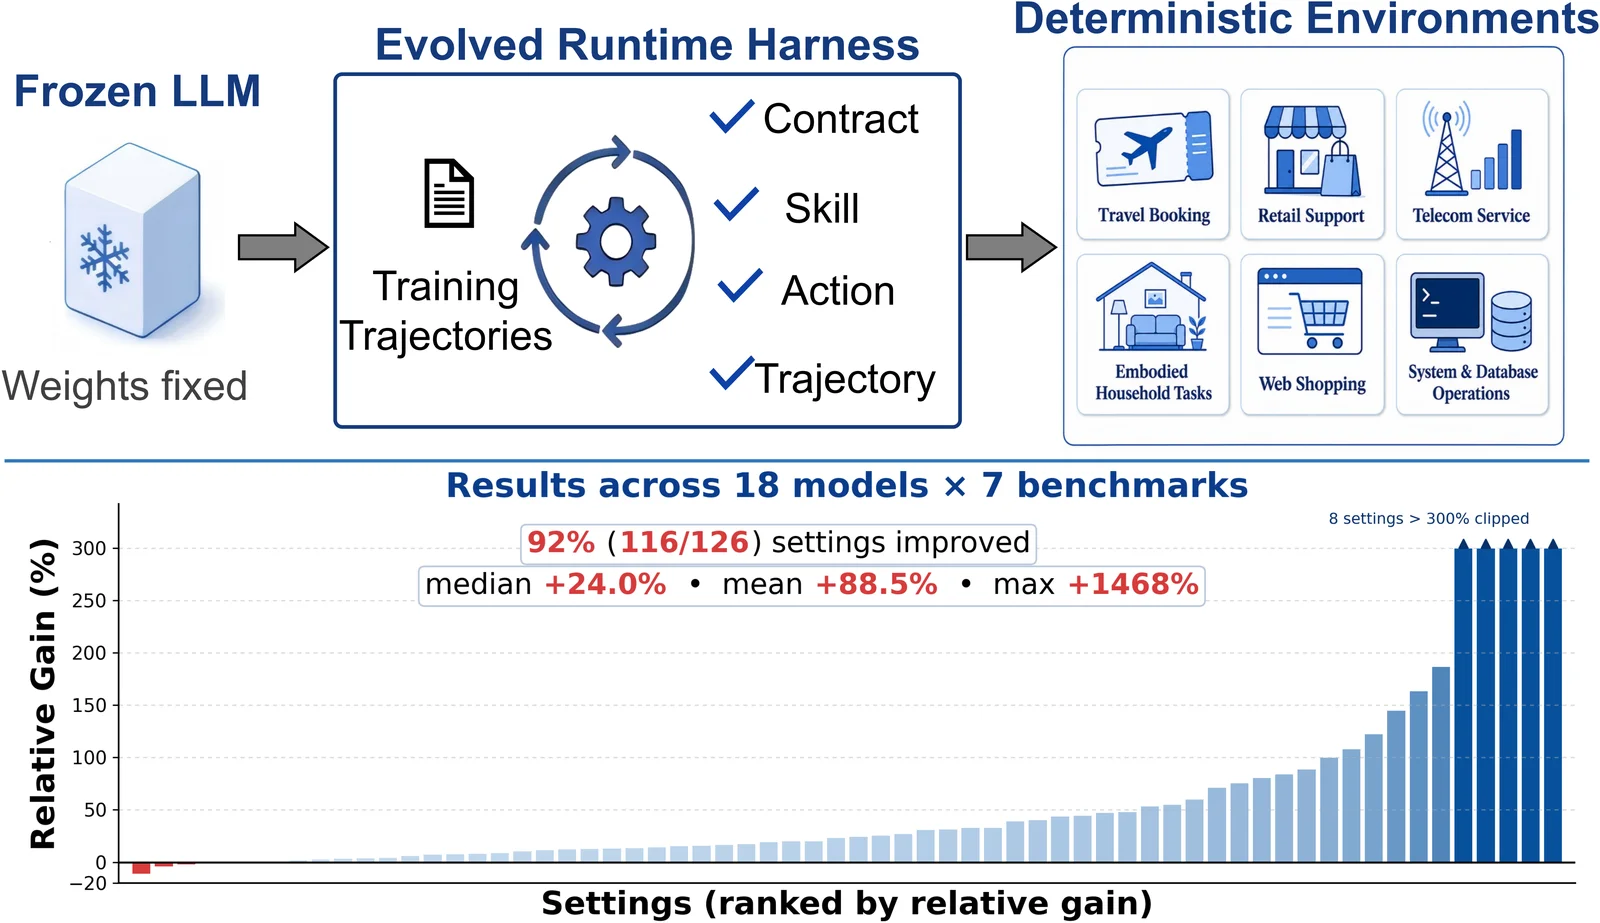
大模型 Agent 这两年很火。 大家一提到“提升 Agent 能力”,第一反应通常是:换更强的模型、做微调、上强化学习、继续训练。 但我们最近一直在想一个问题: 如果 Agent 表现不好,问题真的一定出在模型本身吗? 很多时候,答案可能不是。 因为Agent并不是一个只会聊天的LLM。 它还要理
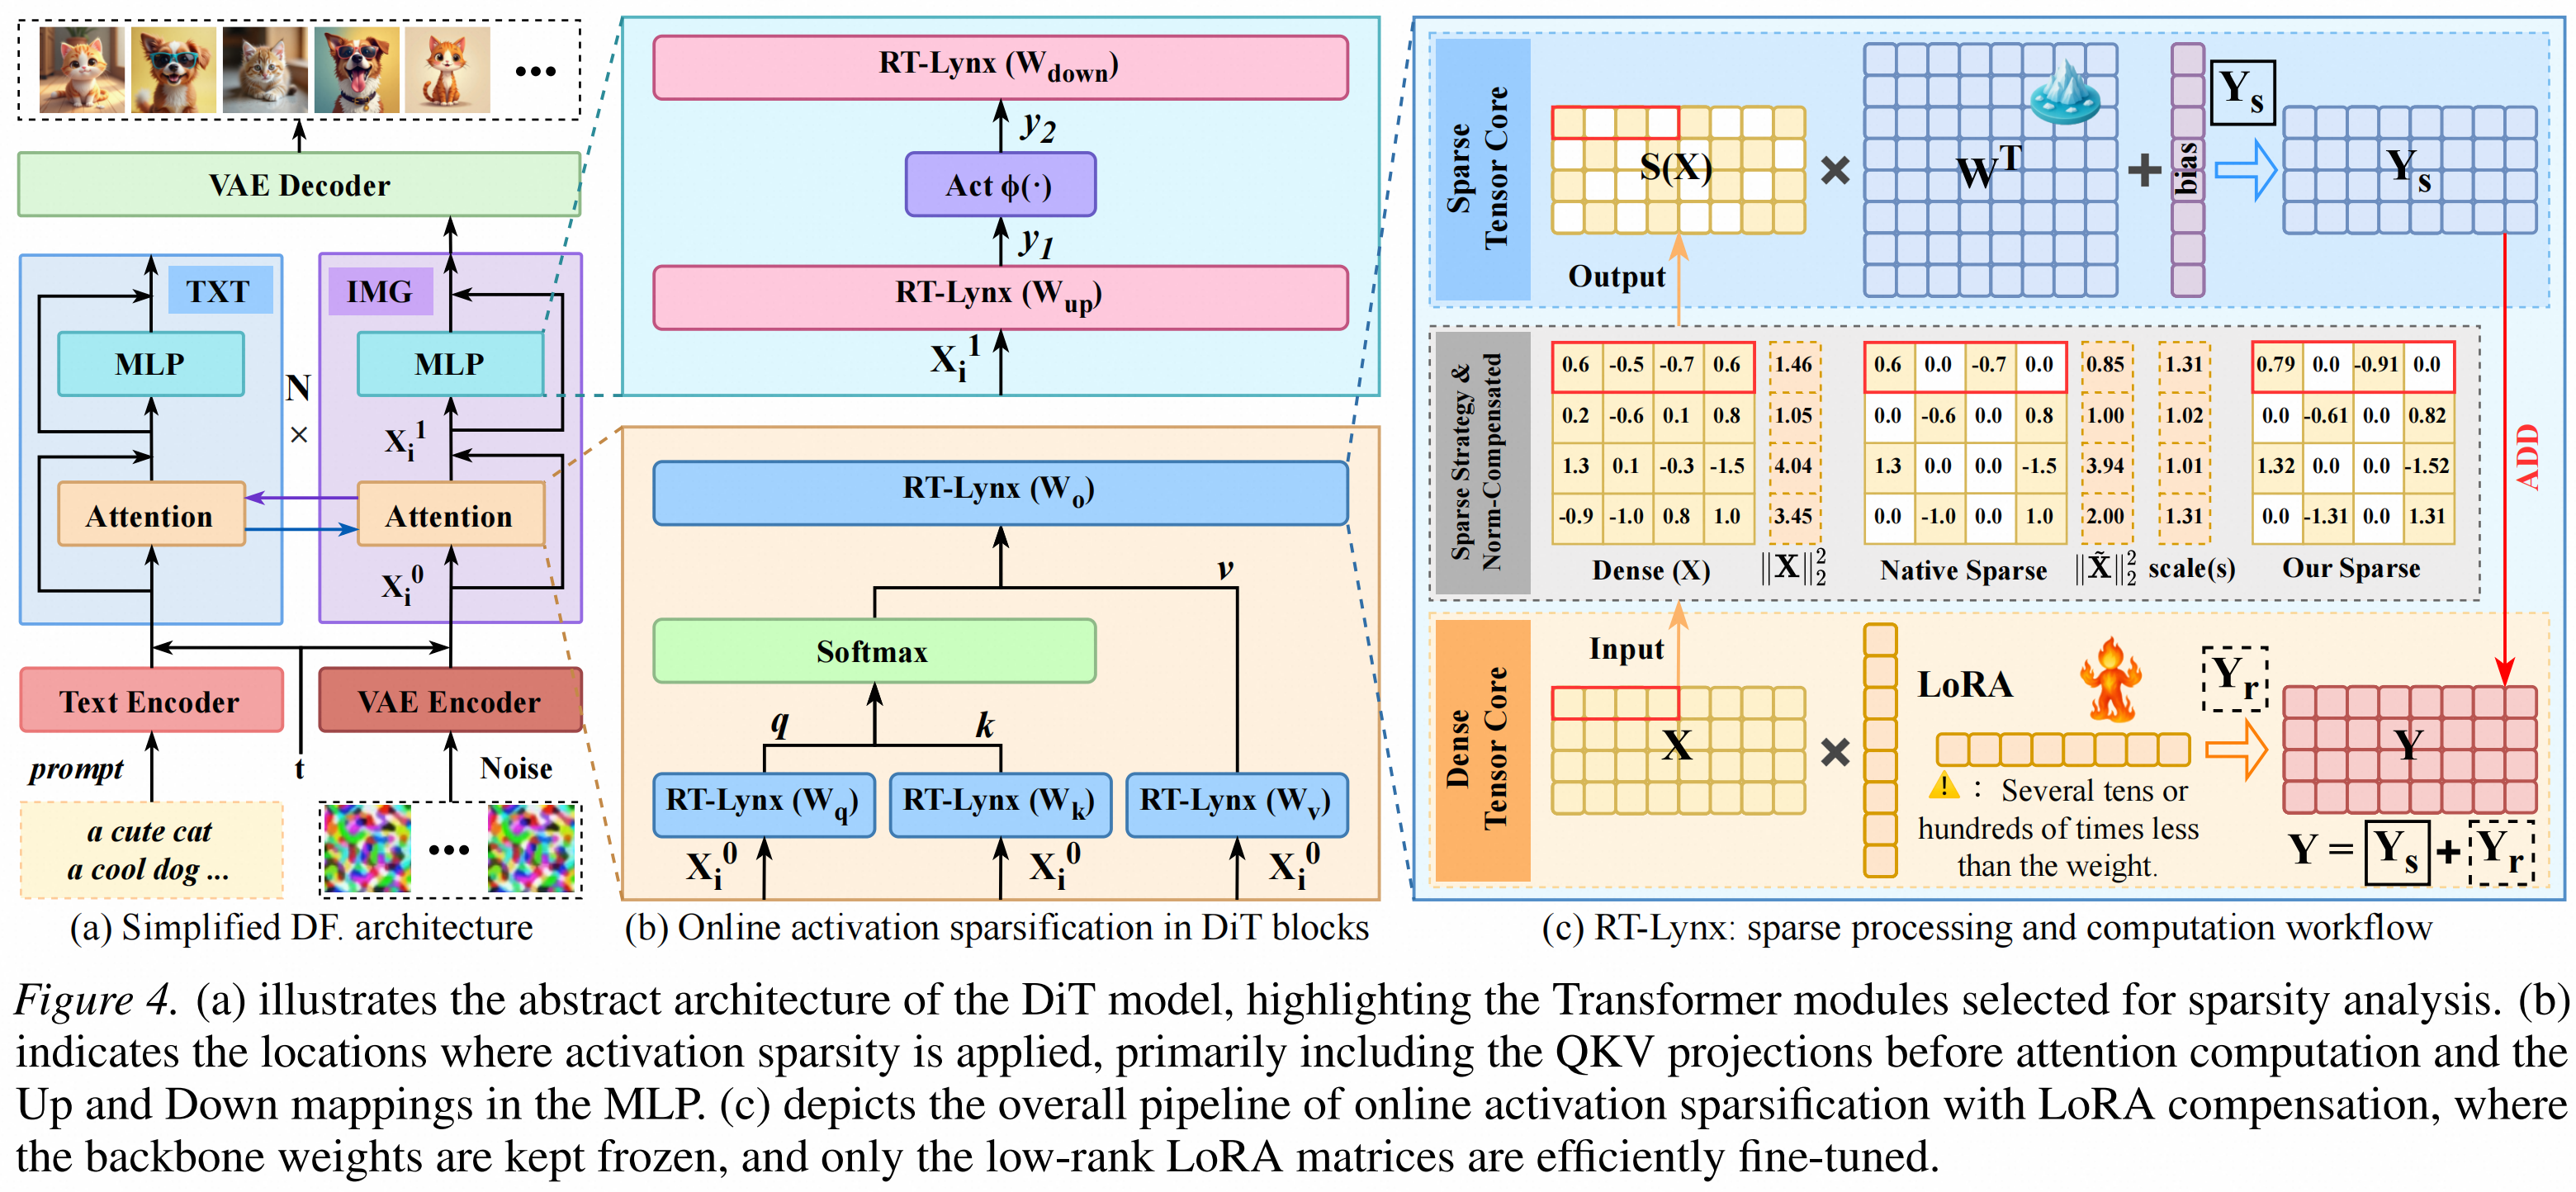
如果说过去很多稀疏化方法一直在问“如何更好地剪掉权重”,那么 RT-Lynx 给出的答案是:对于 Diffusion Transformer,真正适合半结构化稀疏的对象可能不是权重,而是激活。 论文标题:RT-Lynx:Putting GEMM Sparsity in the Right Place
作者:jzx 原文:https://zhuanlan.zhihu.com/p/2043283053787841480 TL;DR:SwiGLU 是目前大模型的标配激活函数,但它在低精度训练中会产生严重的数值不稳定问题。我们设计了一个新激活函数 PowLU,用更平缓的增长曲线替代 SwiGLU 的二次
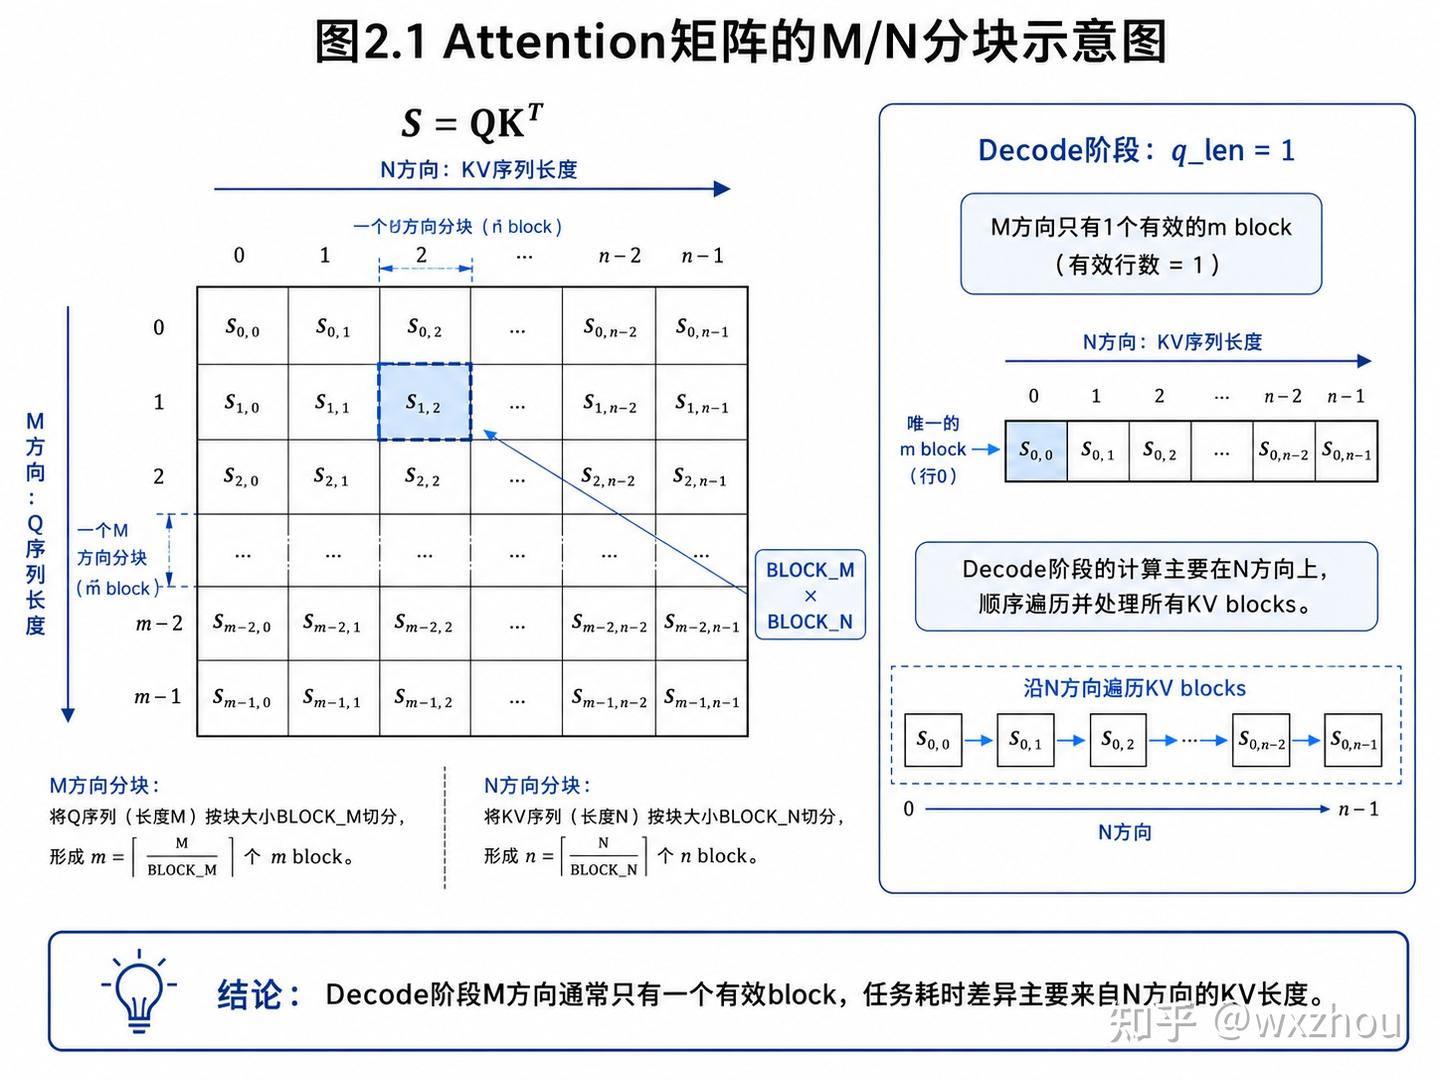
作者:wxzhou https://zhuanlan.zhihu.com/p/2044873485688861958 本文仅使用大模型进行润色,并努力去除 AI 味,部分图片使用 gpt 生成。 1. 引言 先抛出一个问题:以典型 GQA 架构为例,在 LLM 推理的 Decode 阶段,Atten
作者:张曜程,朱圆恒,赵冬斌@中科院自动化所 研究背景 智能体在训练过程中往往面临几个核心瓶颈,标注数据昂贵、奖励信号稀疏,以及长程任务中的信用分配困难。自博弈(Self-Play)提供了一条很有吸引力的路径:模型可以自己生成问题、自己学习解决问题,从而减少对外部训练数据的依赖。然而,现有自博弈方法
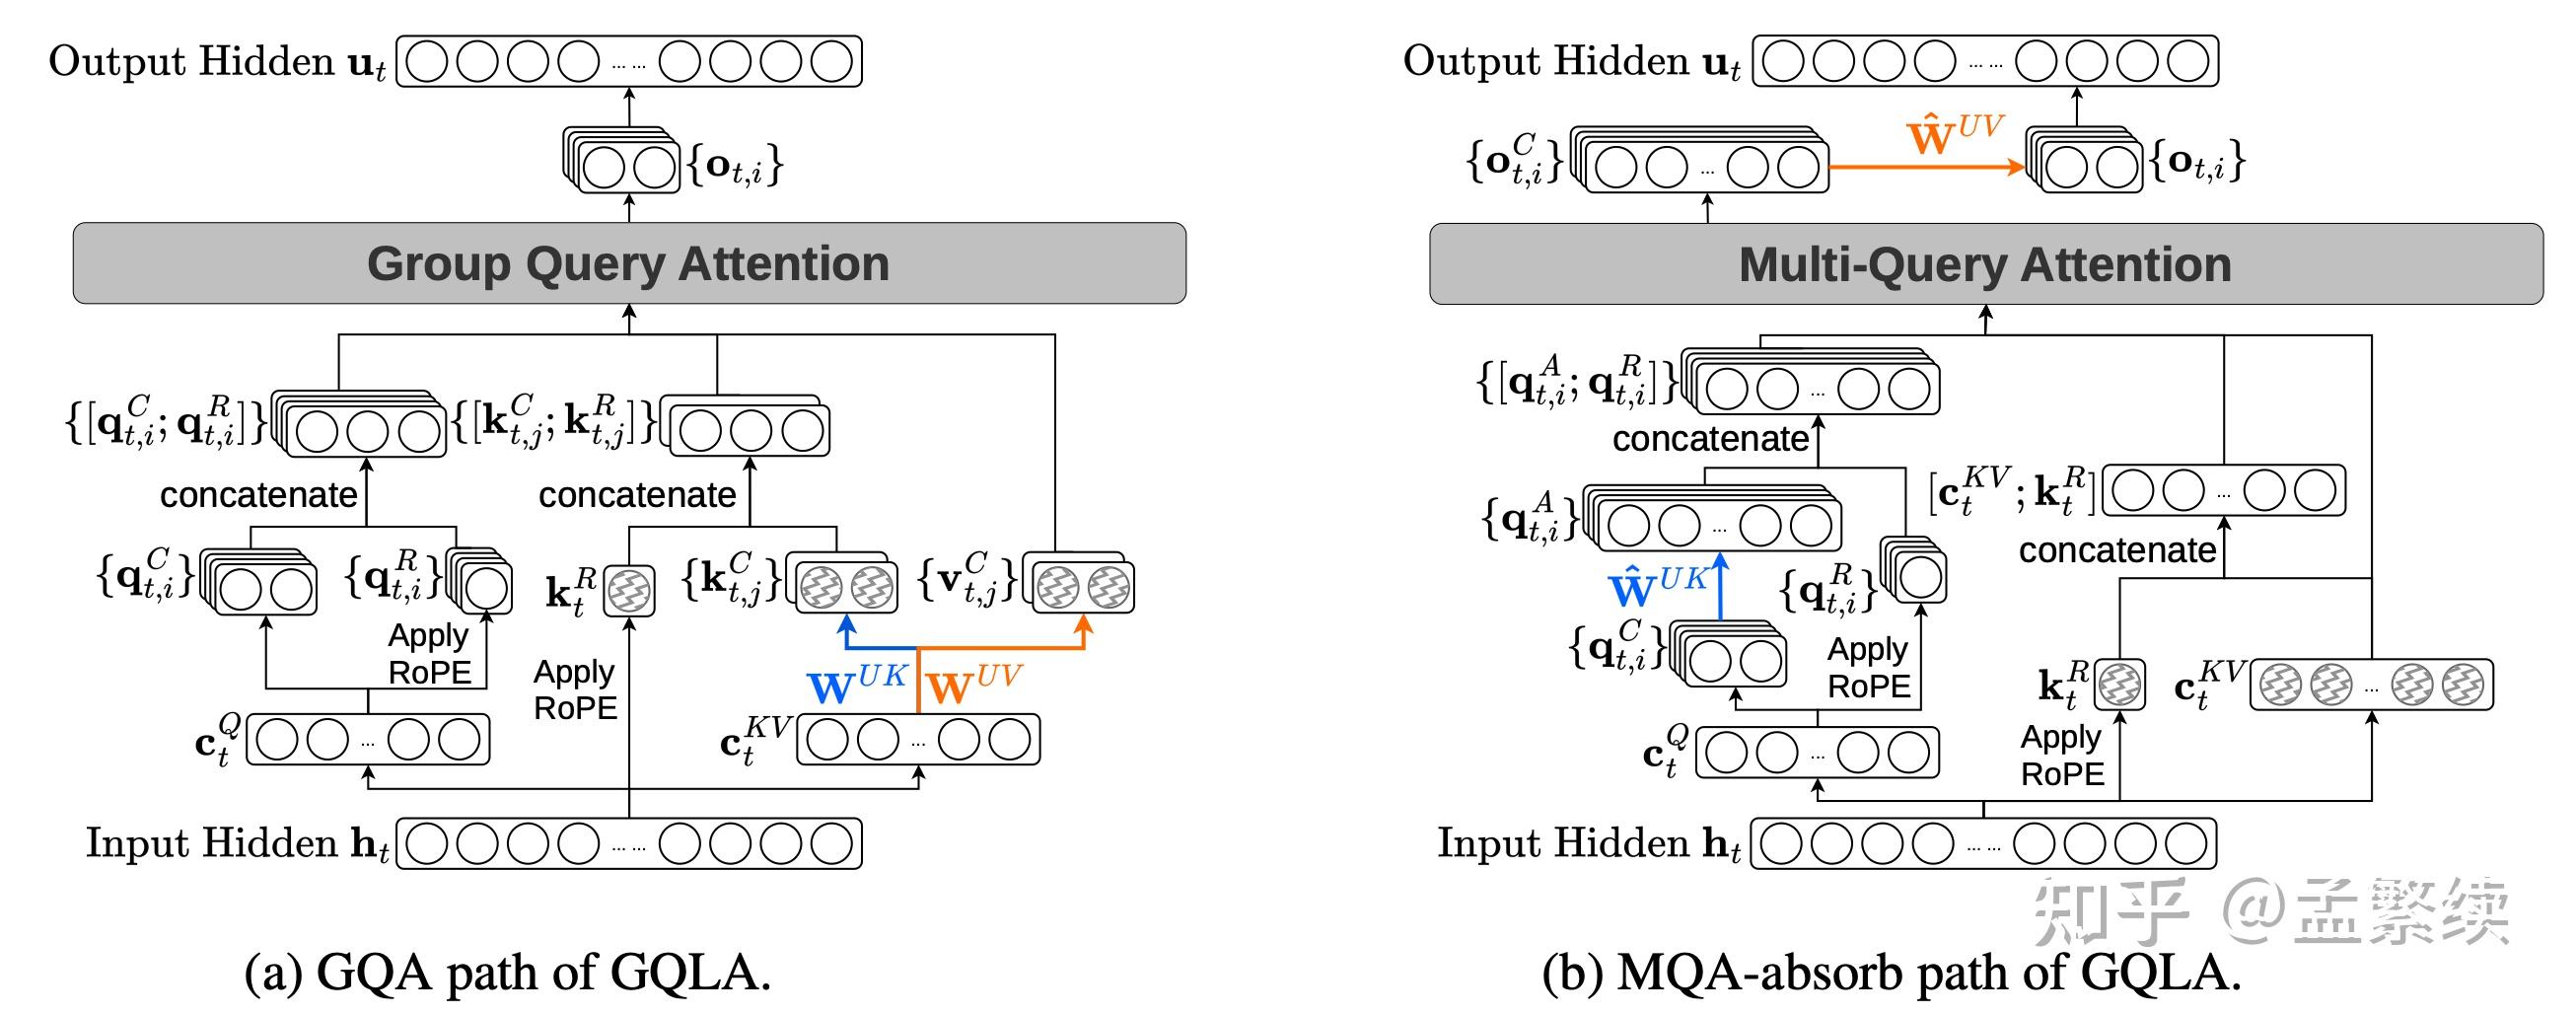
作者:孟繁续 https://zhuanlan.zhihu.com/p/2039637653314856841 文章链接:https://huggingface.co/papers/2605.15250 代码链接:https//github.com/MuLabPKU/TransArch GQLA的前
在通往AGI的道路上,世界模型(World Model)被视为让AI真正理解并预测物理世界的关键拼图。英伟达近期重磅发布的世界动作模型(WAM)DreamZero 一经发布就在两项机器人基准测试RoboArena,MolmoSpaces上双双登顶,在具身智能领域获得极大关注。 与传统VLA等模型不同
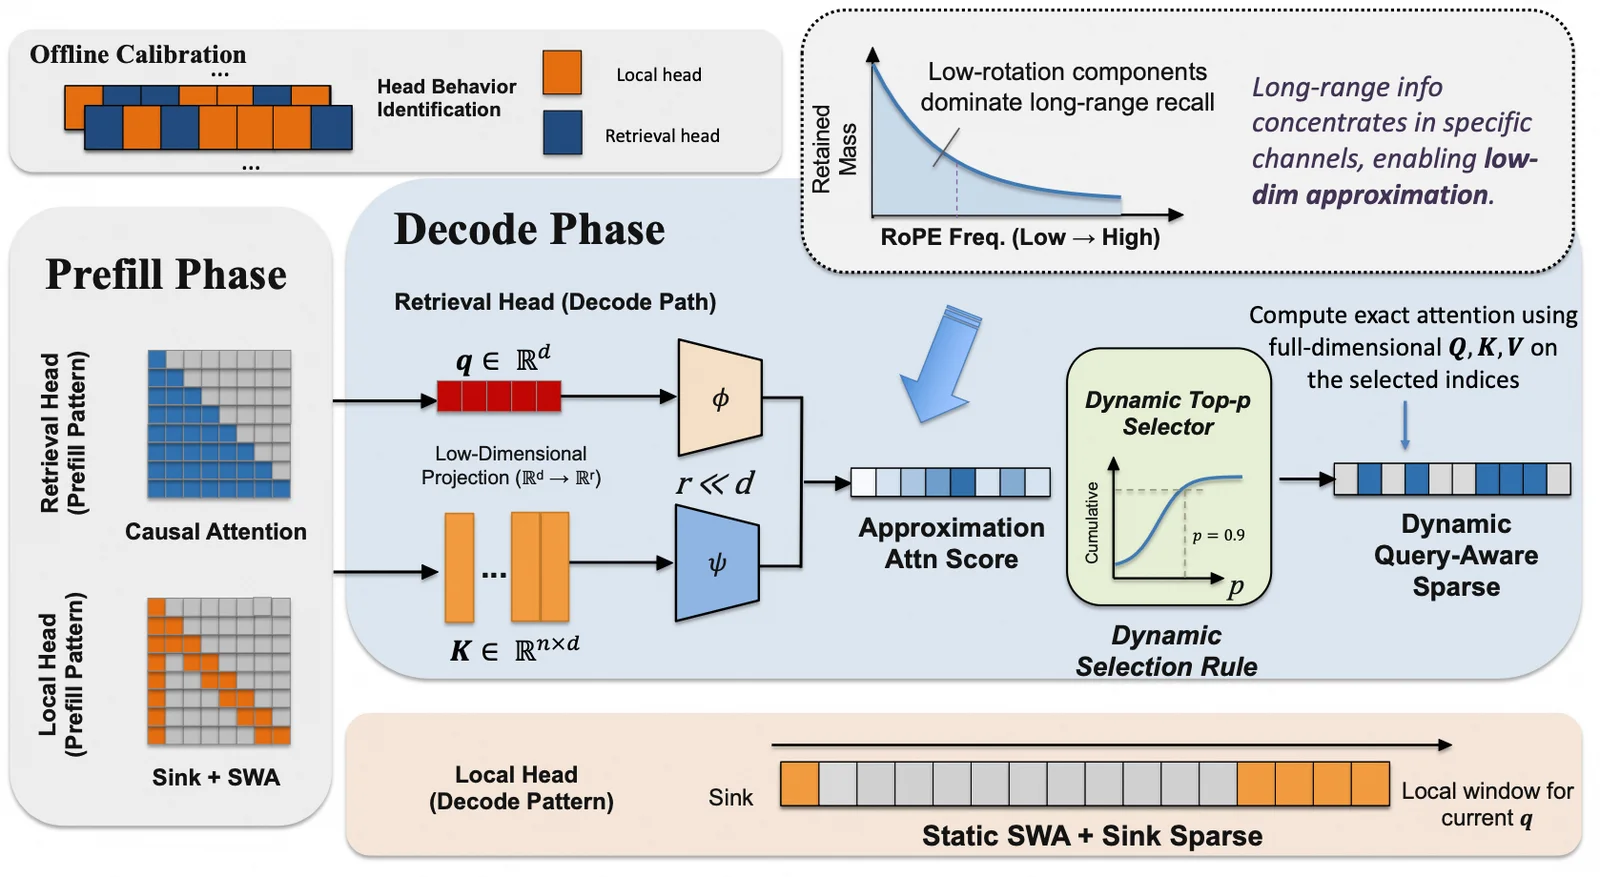
作者:周琰轲,南京大学二年级硕士研究生,阿里巴巴实习生,RTP-LLM项目核心贡献者 长上下文能力已成为现代大语言模型的基础要求,但全注意力机制(Full Attention)随序列长度呈平方级增长的计算复杂度,构成了推理阶段的核心瓶颈。为了缓解这一问题,目前业界主要探索了两条技术路线: 1.Tra
作者:吕兴泰@清华-博士生 原文:https://zhuanlan.zhihu.com/p/2040445503150805754 免费为科研人员提供成果宣传支持,如有优秀研究成果分享推广,欢迎投稿联系:aiFreeCode 在标准 MoE 里,每个 token 通常都会激活固定数量的 expert
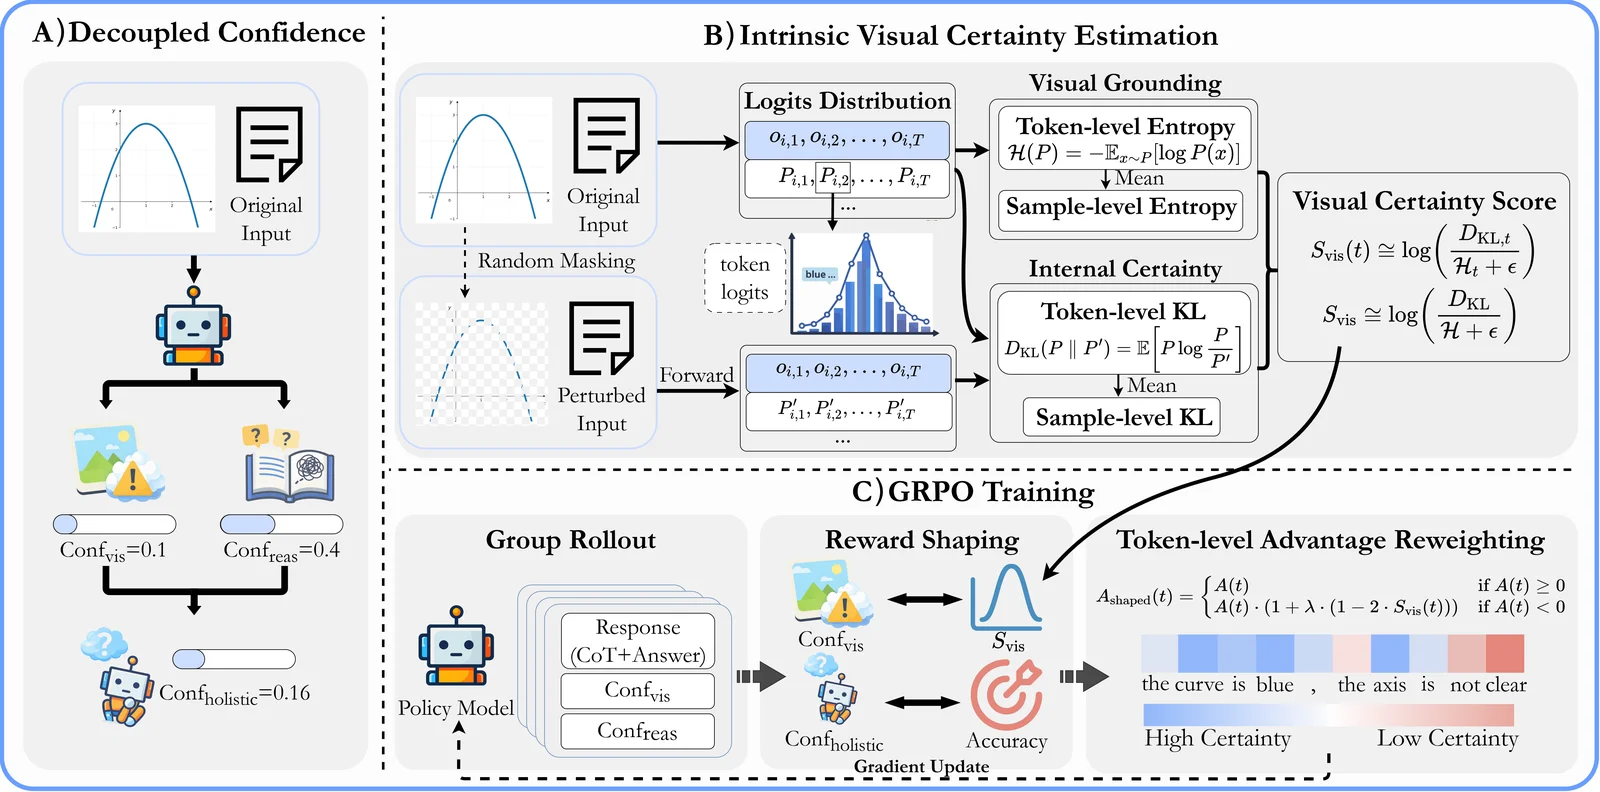
作者:VL- Calibration研究团队 免费为科研人员提供成果宣传支持,如有优秀研究成果分享推广,欢迎投稿联系:aiFreeCode 长期以来,大型视觉语言模型(LVLMs)在多模态理解与推理任务中展现了惊人的能力,但它们也面临着一个致命的弱点:经常“非常自信地胡说八道”。 模型不仅会产生严重
论文标题:Next-ToBE: Probabilistic Next Token-Bag Exploitation for Activating Anticipatory Capacity in LLMs 论文链接:https://openreview.net/pdf?id=T8IJojfaOh 如
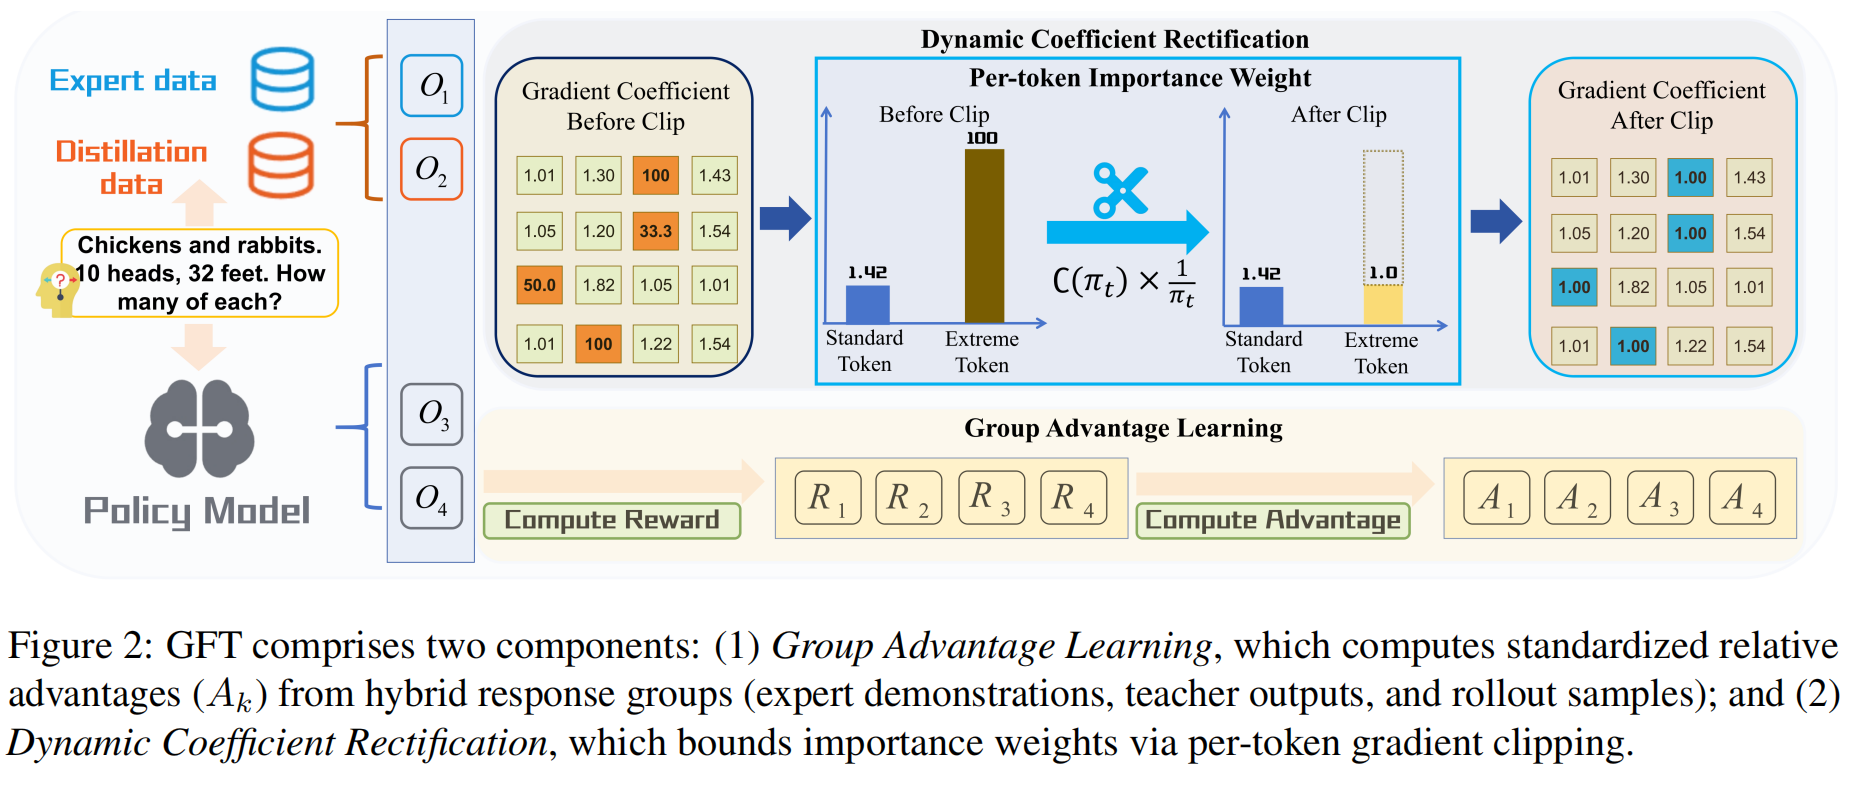
🧪 Title: GFT: From Imitation to Reward Fine-Tuning with Unbiased Group Advantages and Dynamic Coefficient Rectification 🎉 Venue: ACL 2026 Findings 📝 P
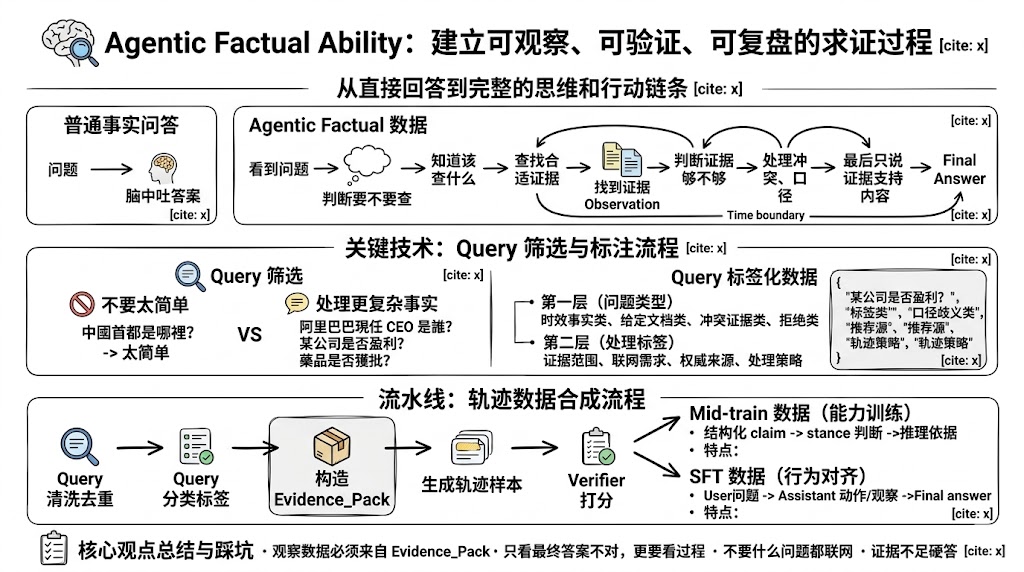
作者:好奇的小逸 原文:https://zhuanlan.zhihu.com/p/2036619681105228260 最近正好在搞 agentic factual ability的问题,就想着先总结一下目前的内容,这里首先想一下我们的目标是什么?直接给出结果的普通事实类问答吗?显然不是。我们这里
作者:Naiyan Wang https://zhuanlan.zhihu.com/p/2032931834288419524 在 xLM 席卷虚拟世界的各种应用后,大家谈论的下一个热点自然迁移到 Physical AI(物理世界 AI)。 抛开繁杂的具体技术架构,我们回归第一性原理来思考:一个系统
作者:黄呈松,圣路易斯华盛顿大学博士生 在Deep Learning之前,我们在做传统机器学习,通过研究规律,写基于规则的代码来完成我们想要完成的任务。 在LLM之前,我们用深度学习来提取特征,设计网络来完成我们想要完成的任务 在LLM之后,我们似乎试图用LLM来解决所有的任务 但...我们真的达到
作者:翁家翌 原文:https://trinkle23897.github.io/learning-beyond-gradients/#zh Continual Learning 一直难以被解决,主要卡在神经网络的灾难性遗忘:学了新东西,旧能力就容易被冲掉。那如果不把目光只放在神经网络权重上,还有没
假如让一个人去一个陌生城市找一家小店,他通常不会一开始就把地图放到最大。 他会先看整个城市,大致定位街区,再双指放大到具体门牌。一次"缩放"比在全景里满街扫要高效得多。 但今天的 RAG(Retrieval-Augmented Generation,检索增强生成)系统,主流路线却常常不是这样工作的。
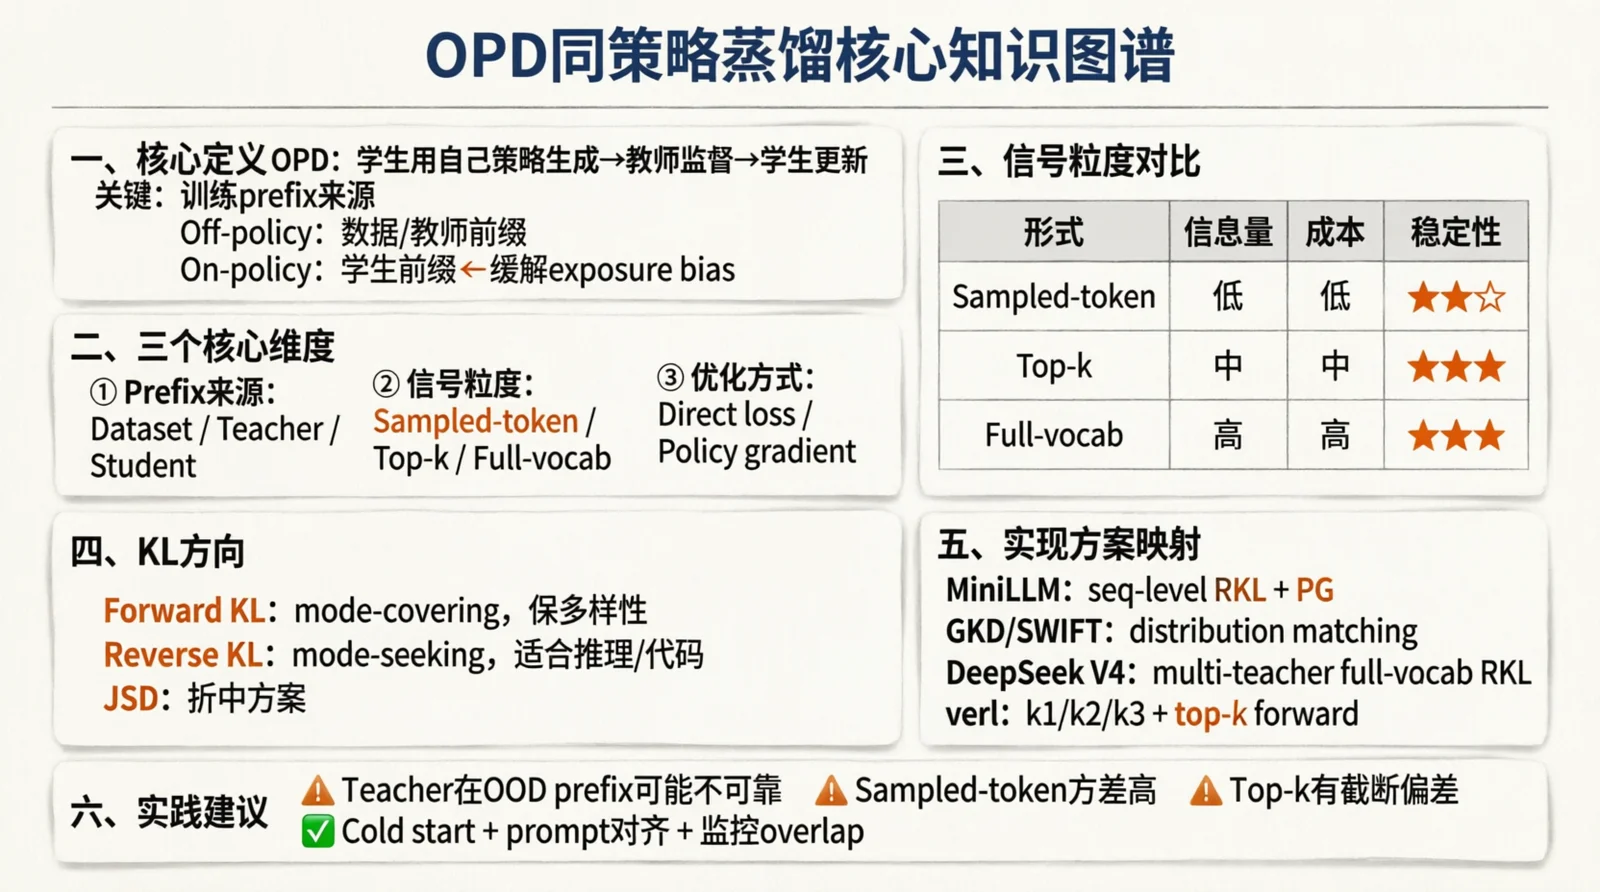
作者:banana https://zhuanlan.zhihu.com/p/2033212181823608430 这篇文章要回答的问题:OPD 到底在优化什么?训练 prefix 从哪里来,以及在每个 prefix 上你比较的是一个 sampled token、一个 top-k 局部分布,还是整
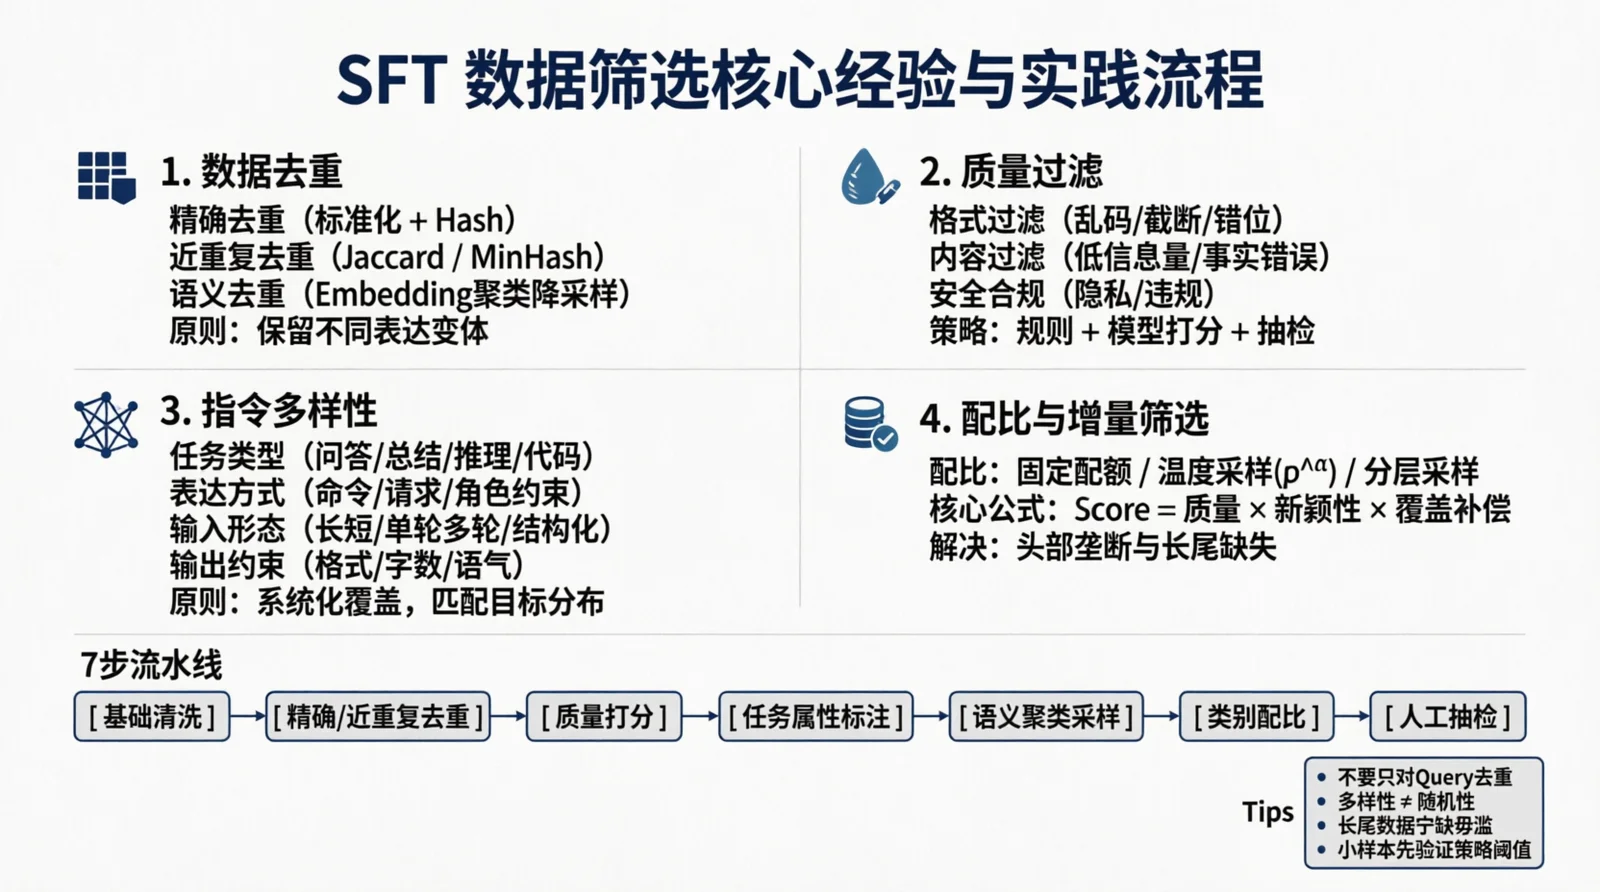
作者:好奇的小逸 https://zhuanlan.zhihu.com/p/2035128896316756341 之前再做Mid-train和SFT时,积攒了一些经验,一直没有去写这方面的内容,这次就好好的总结一下相关的内容, 首先我们先有个认知就是:真正影响训练效果的,往往不是总量,而是样本的信
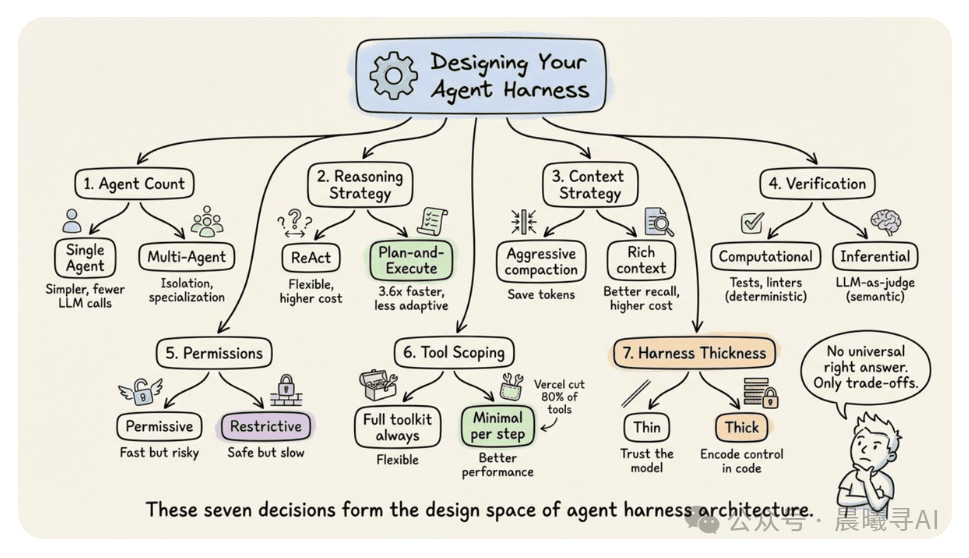
最近,Anthropic、OpenAI、LangChain、Perplexity等全球顶流团队不约而同地将目光投向Harness Engineering。为什么偏偏是Harness? 试想这样一个场景:面对不同的开发任务,同样的Harness + 大语言模型(LLM)组合,有时丝滑流畅,有时却表现糟
作者:李煜东 Yudong https://zhuanlan.zhihu.com/p/2032080549381190858 写在前面: LLM 研究的关注重心正在这几年内不断转移,从post train到强化学习再到agentic/harness工作流。这些都体现了技术前沿和社区焦点的演进。对于用
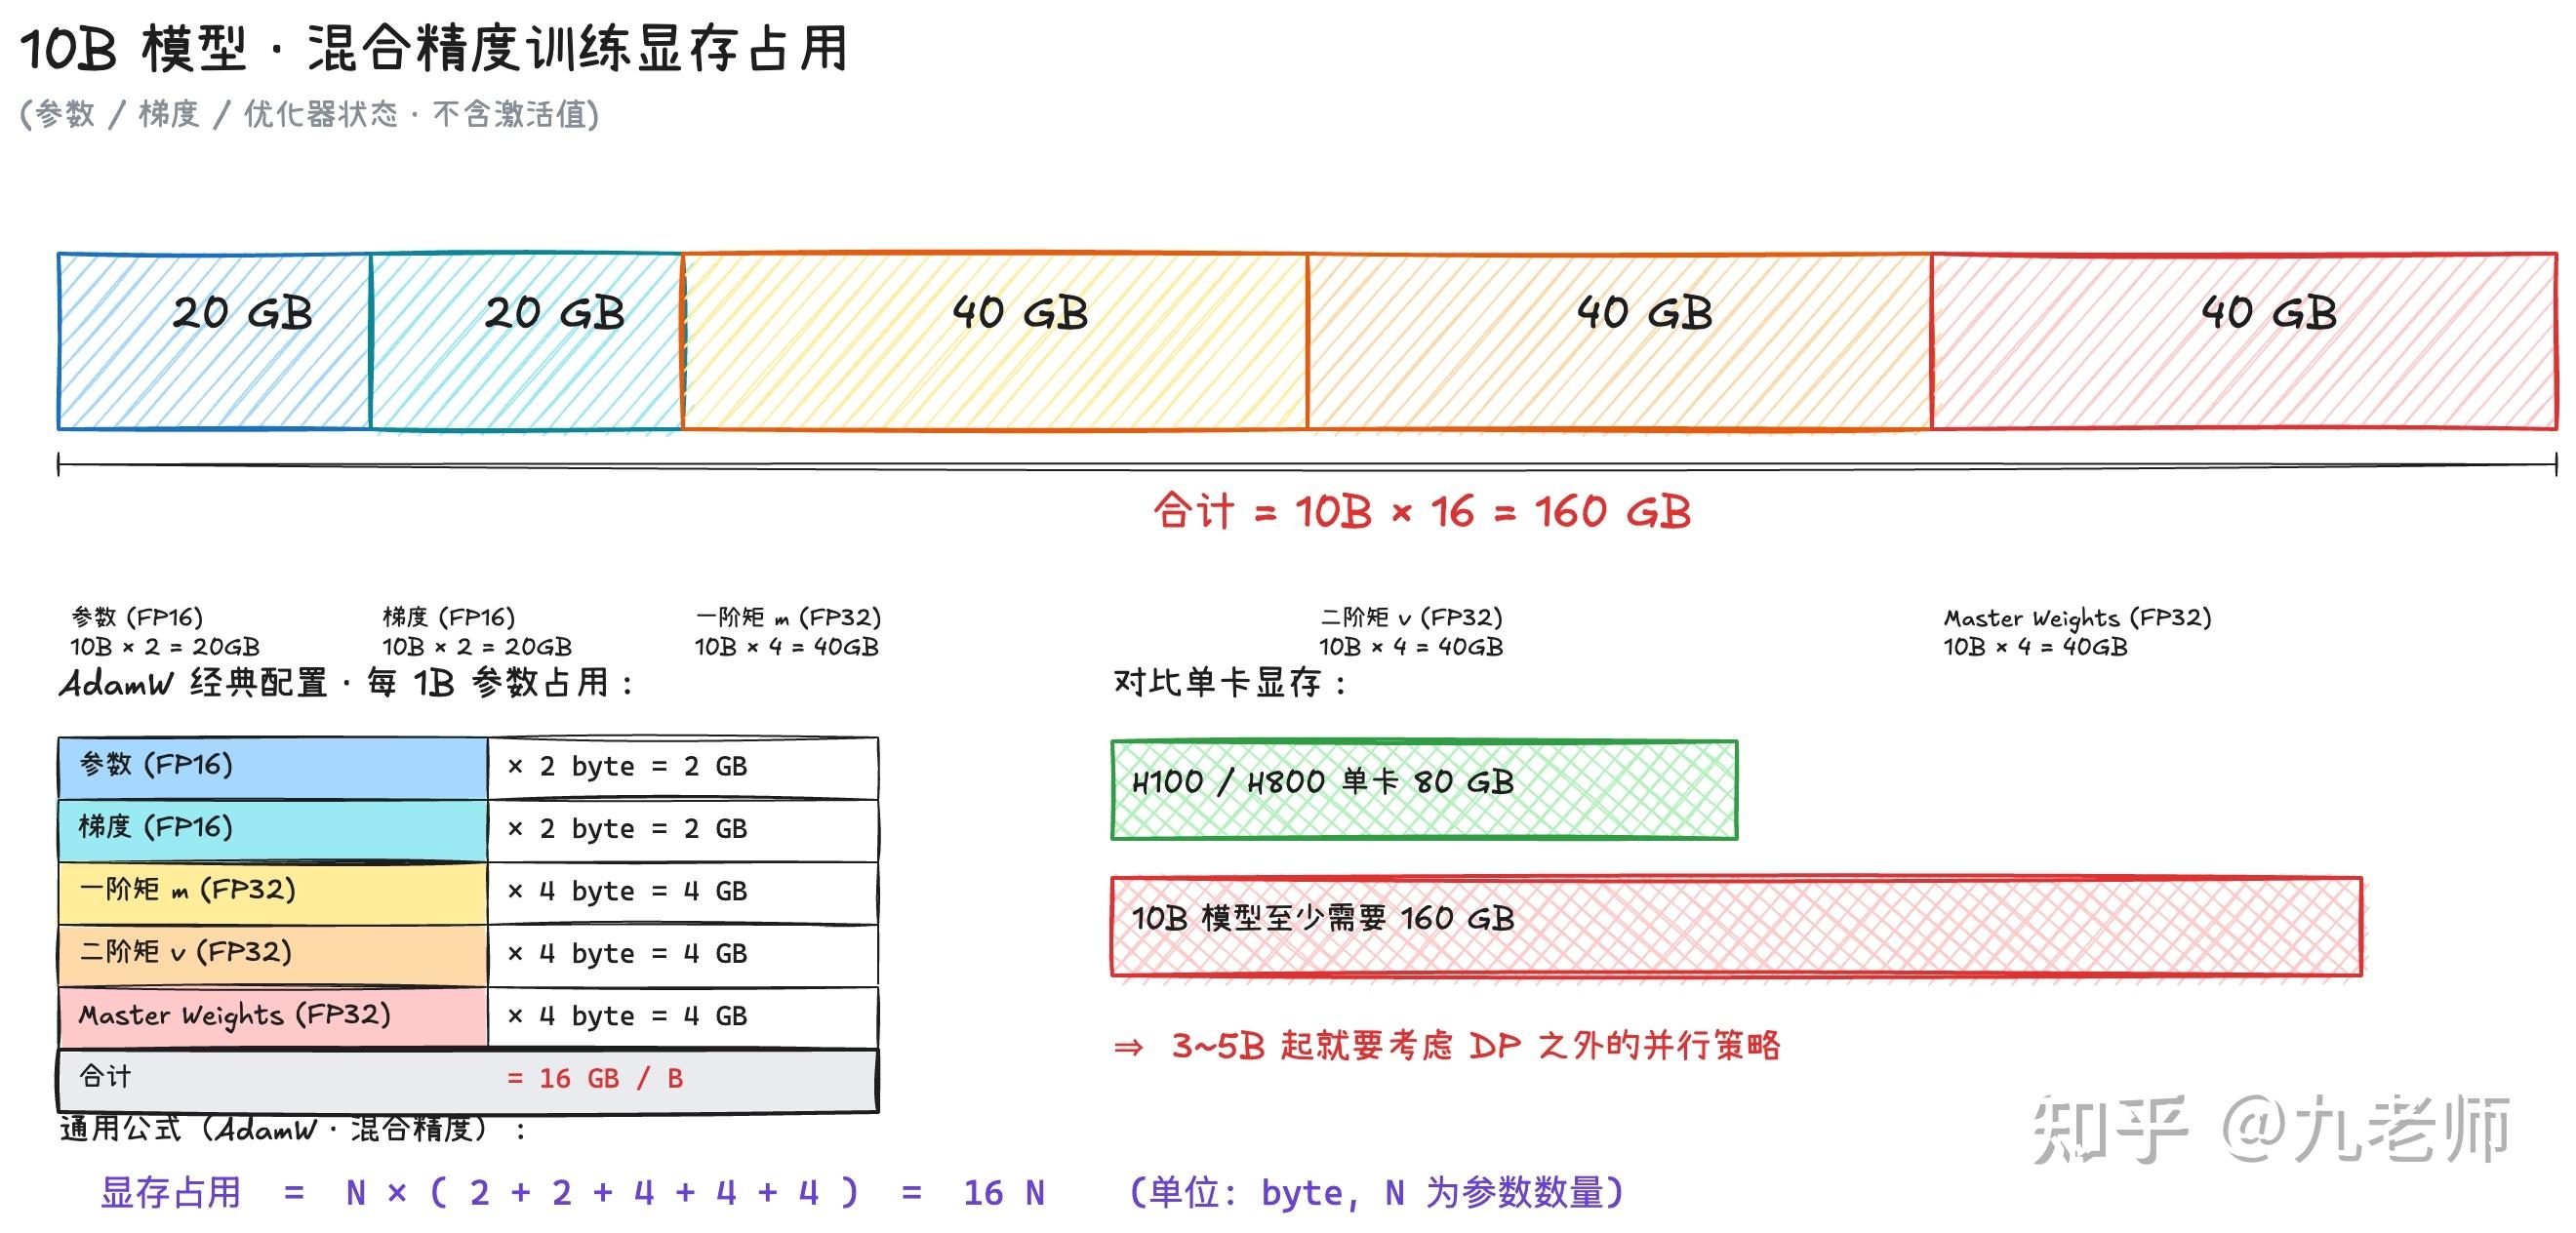
作者:九老师 https://zhuanlan.zhihu.com/p/2034669267807888405 最近模型从Dense切到了MoE,MFU 也相应地暴跌了,大家直觉上觉得Expert被切的很小,所以计算强度上不去,但实际切分完的维度至少也有1024,MFU暴跌的原因一定不来自这里。 深
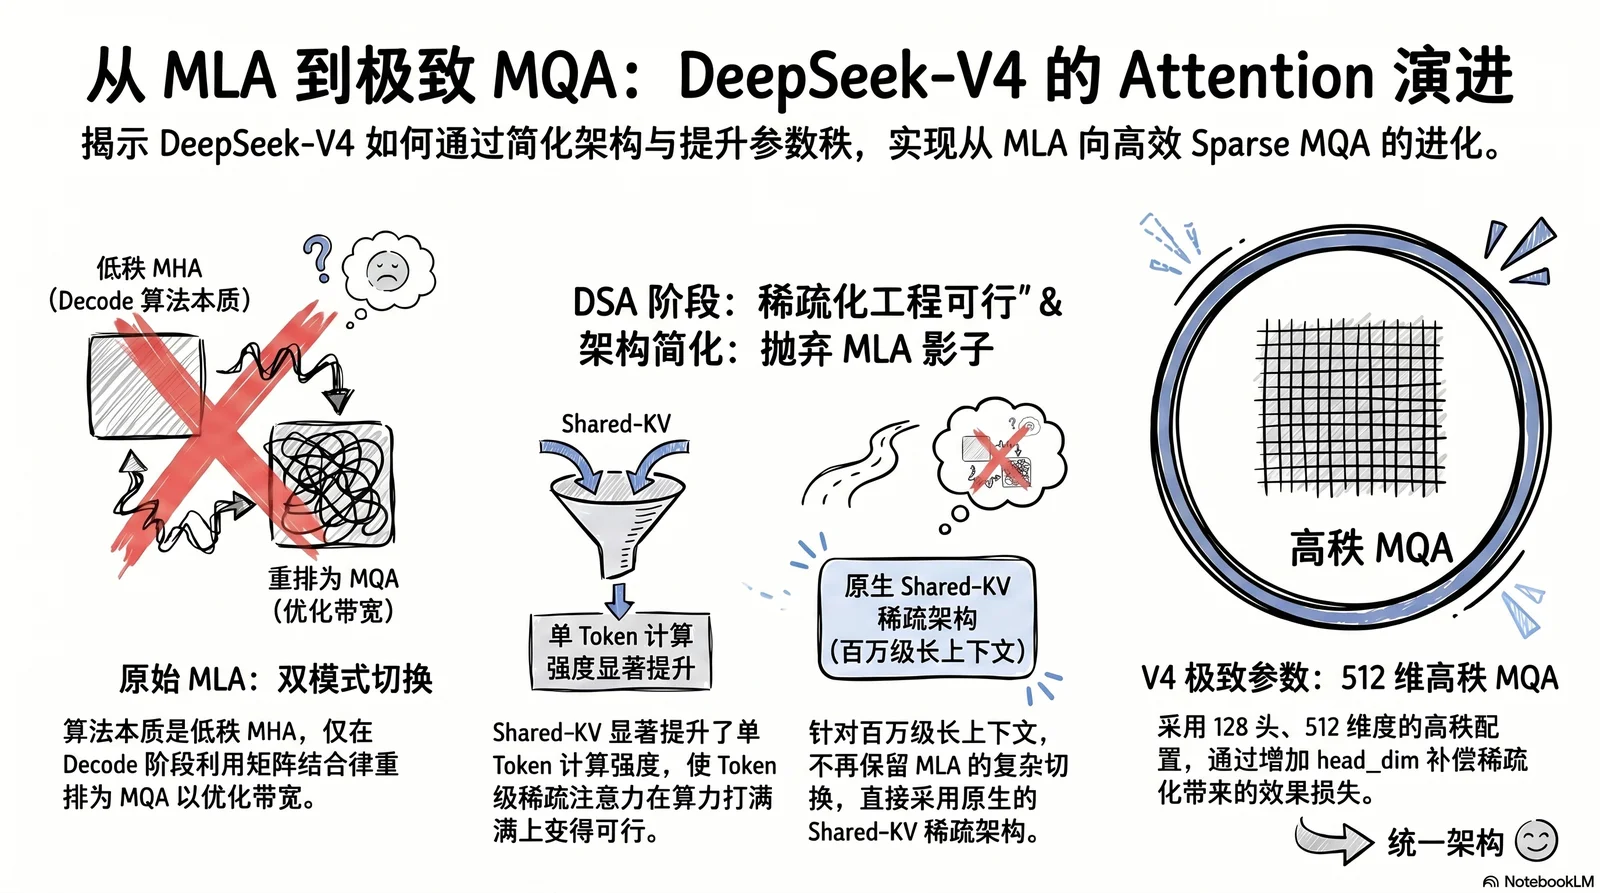
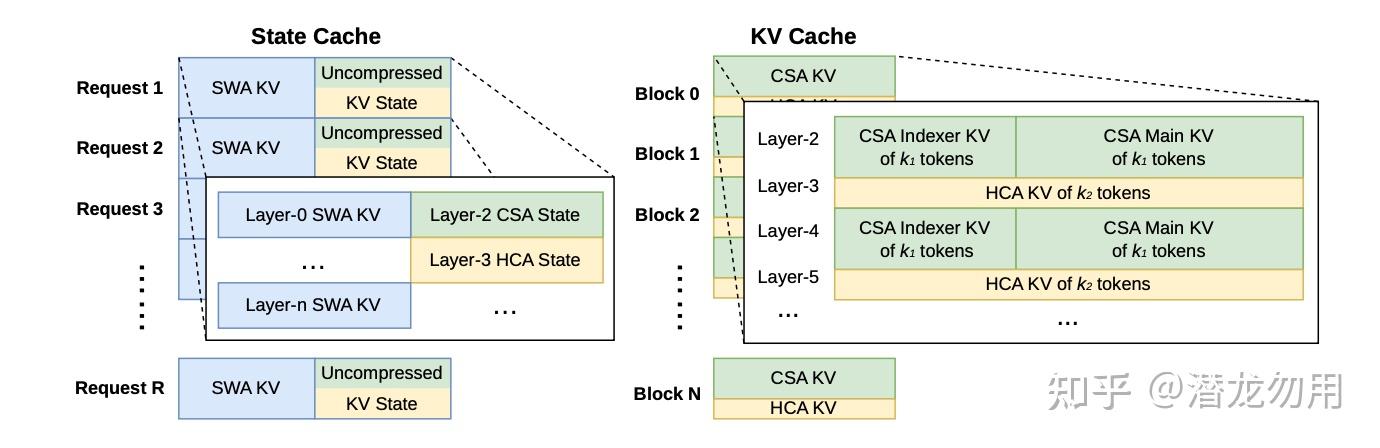
作者:YyWangCS https://zhuanlan.zhihu.com/p/2031149621397935813 DeepSeek-V4 的论文里已经基本看不到 MLA 形式的表述了,attention 部分是以原生 shared-KV MQA 的形式出现的,而且这个 MQA 还是 head
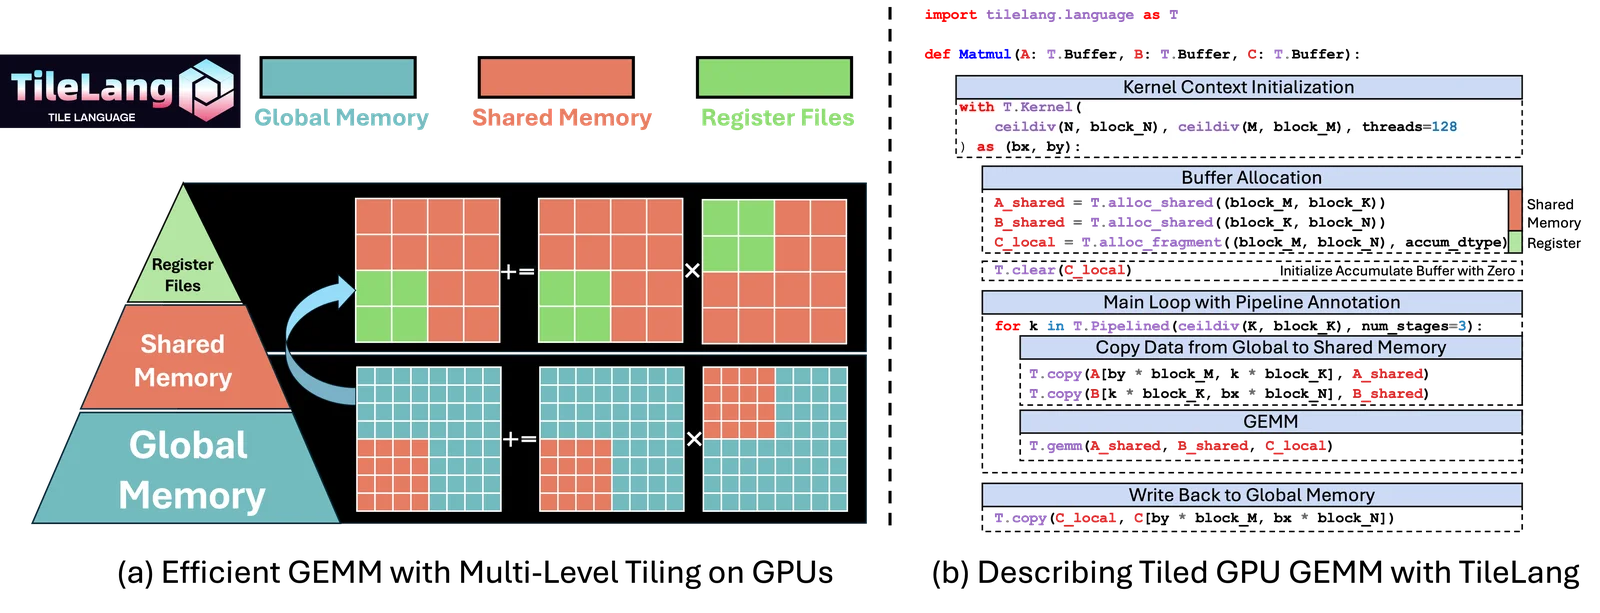
作者:SiriusNEO https://zhuanlan.zhihu.com/p/2033034202720022871 大家五一快乐!最近 V4 的技术报告讨论度很高,其中 TileLang 在报告中也占了一部分内容,主要是总结了社区最近的一些技术进展、以及其投入实际工业界应用后的一些打磨经验。
作者:九老师 https://zhuanlan.zhihu.com/p/2031622077107659474 2026 年了,一个 LLM 的训练流程并不陌生——pre-train,SFT,RLHF/RLVR。但实际这是一个领域 LLM 的训练方案,比如 Coder/Match/文本专家,怎么整合
作者:潜龙勿用 https://zhuanlan.zhihu.com/p/2030982954617414764 这份技术报告发布了 DeepSeek-V4 系列的 preview 版本,包含两个 MoE 模型:DeepSeek-V4-Pro(总参数 1.6T,激活 49B)与 DeepSeek-V
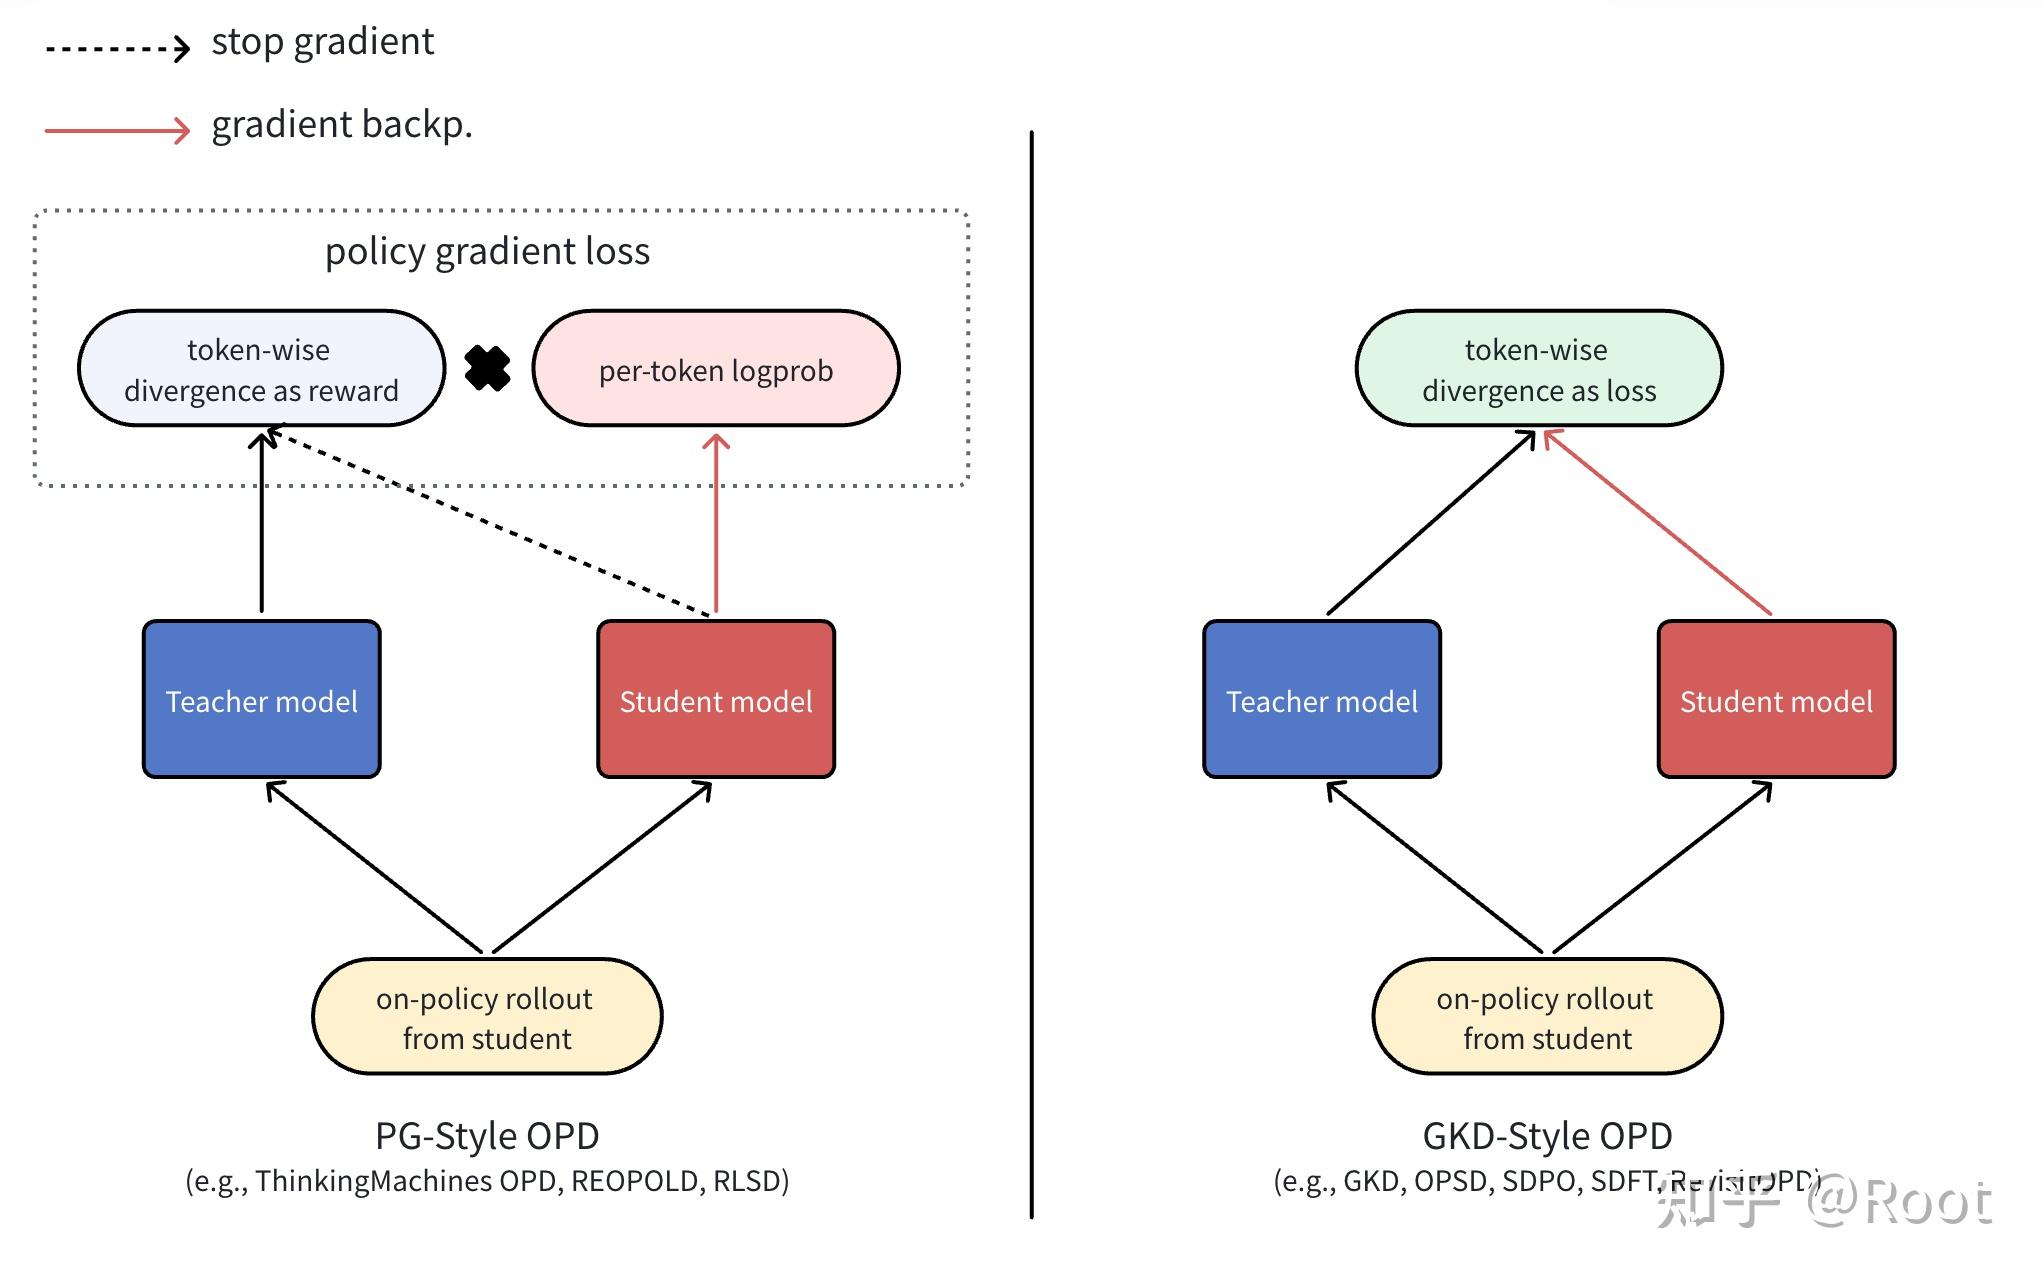
作者:Root 原文:https://zhuanlan.zhihu.com/p/2027548813129267030 前言 On-policy distillation最近在LLM后训练领域非常火,我也一直有在关注OPD/OPSD相关论文的进展。之前,我一直认为这波OPD热潮涌现的一系列方法都可以
作者:恰似故人归 https://zhuanlan.zhihu.com/p/2023482883415835093 这两年大家谈 LLM post-training,常见的叙事是两条线: 一条是 outcome reward 的 RL 一条是 teacher 提供 dense signal 的 kn
作者:Frankdark https://zhuanlan.zhihu.com/p/2026908932694647597 最近在做 RL-based knowledge distillation 的过程中,我们被一个老生常谈的问题折磨了很久:REINFORCE 的梯度方差太大,训练极其不稳定。 最
作者:钱泽中 原文:http://xhslink.com/o/7qoBKO5BfoI 前言 前两天ICML刚结束,合作的一个项目从3.25 rebuttal涨分到了3.75着实很厉害,这个paper主要做的事情是让world model从预测RGB改为预测Mask,然后增强了鲁棒性。他claim的点
作者:Yuwei Niu 应该是从去年做完WISE 开始,碰到我的朋友都以为我是做生成出身的,但其实我从最开始做科研就是沿着CLIP LLaVA的经典多模态理解路线,并且我心中也一直更喜欢多模态理解多一些。 然而,近一年以来,似乎社区的热度在多模态方面始终更倾向于生成(GPT-Image, Nano
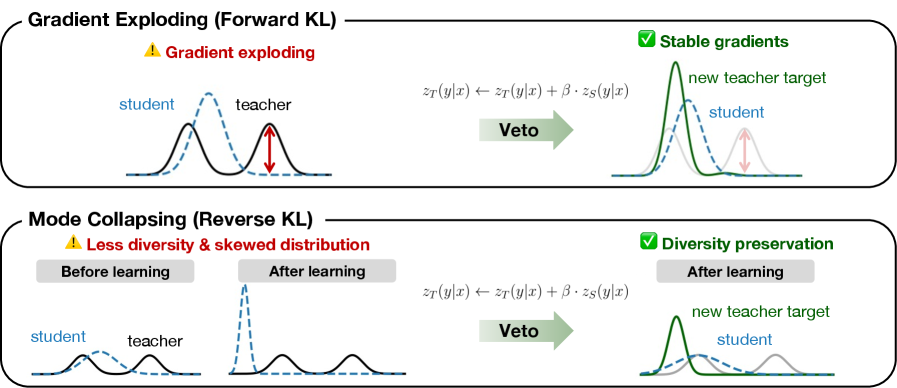
作者:欲壑难填 https://zhuanlan.zhihu.com/p/2024947723019843192 KL 散度是机器学习中的一个重要概念,其非对称性导致在实际中有 Forward KL 和 Reverse KL 两种形式,本文介绍这两种形式在优化过程中的差异,再讨论实际中应该如何选择。
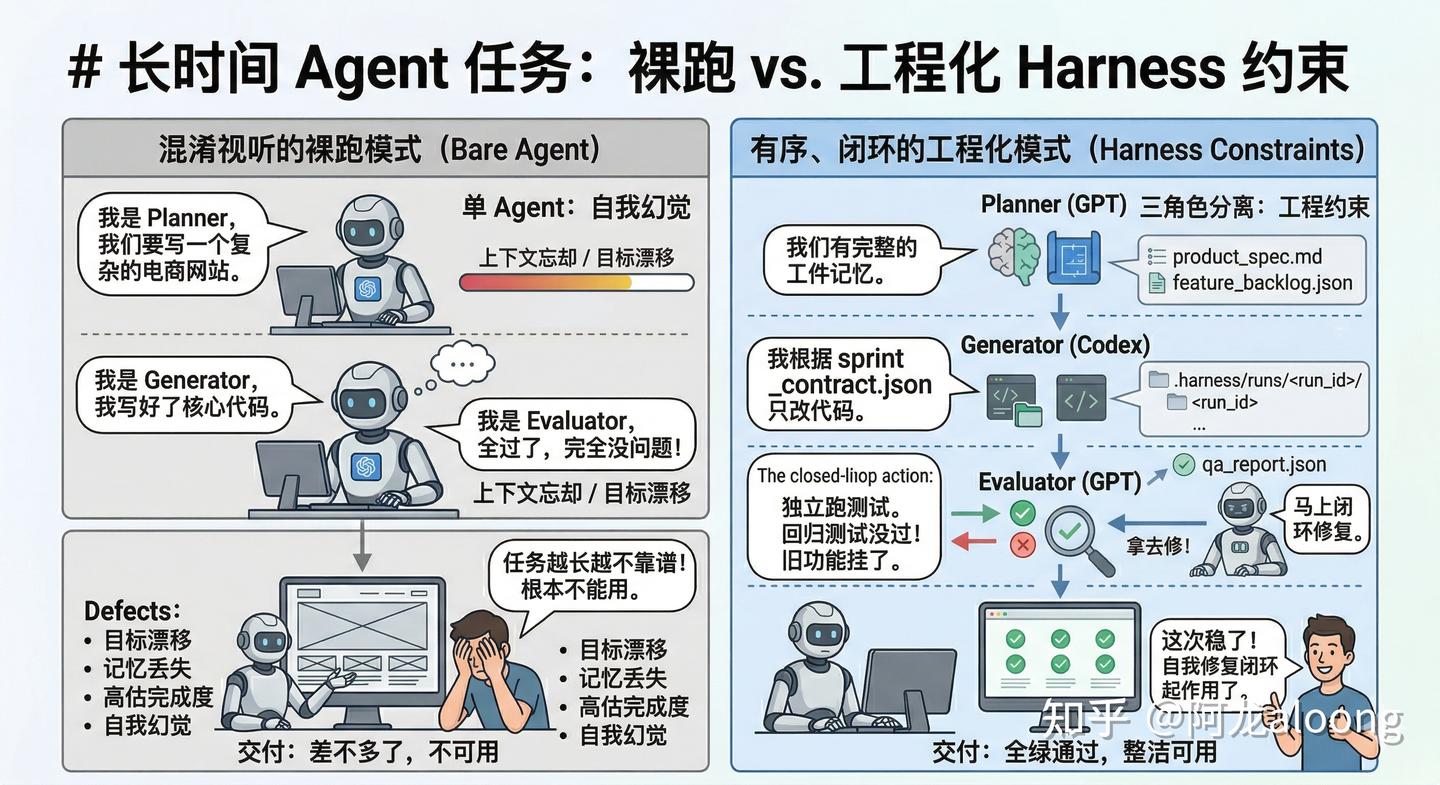
作者:阿龙aloong https://zhuanlan.zhihu.com/p/2021015362817328193 那篇文章改变了我对 agent coding 的看法 2026 年 3 月 24 日,Anthropic 发了一篇工程文章:Harness Design for Long-Run
作者:方弦 https://zhuanlan.zhihu.com/p/2020514624856957623 记录整理一下最近学习vllm和sglang源码的一些思考和笔记。 其中包含了和LLM交互问答得到的一些内容(源码分析和注释等部分),用于加深对现代高性能推理引擎实现的理解。分析基于的源码版本
随着大基础模型的崛起,视觉-语言-动作模型 (VLA) 展现出了极大的潜力,通过继承丰富的视觉理解和语言基础,为通用机器人策略学习提供了可扩展的途径。然而,目前的VLA研究领域依然处于一种“原始汤 (primordial soup)”阶段——充满了各种天马行空的探索和设计,但缺乏清晰的架构。 A组说
最近 Qwen Pilot 团队一直在研究 RL 如何解锁复杂推理能力。翻遍数据后,抓到了 3 个反直觉的发现: 1️⃣ RL 其实很“懒” 策略演化极稀疏 在 >98% 的生成步骤里模型没变,RL 并没有重写基座,它更像是个教练,只在关键逻辑分叉口轻轻推一把。 论文:Sparse but Crit
作者:hsj https://zhuanlan.zhihu.com/p/2023447662066762473 机器人不缺数据,缺的是把数据变成能力的结构 一、一个显而易见的问题,做了几年还是没解 Joe Harris 前阵子发了条推文,说机器人行业根本不缺数据,每家部署超过半年的公司都有 TB 级
作者:方弦 https://zhuanlan.zhihu.com/p/2023880667814003300 2026年4月2日,Google DeepMind发布Gemma 4。31B参数的dense模型在AIME 2026上拿到89.2%,MoE变体26B-A4B以3.8B活跃参数在MMLU P
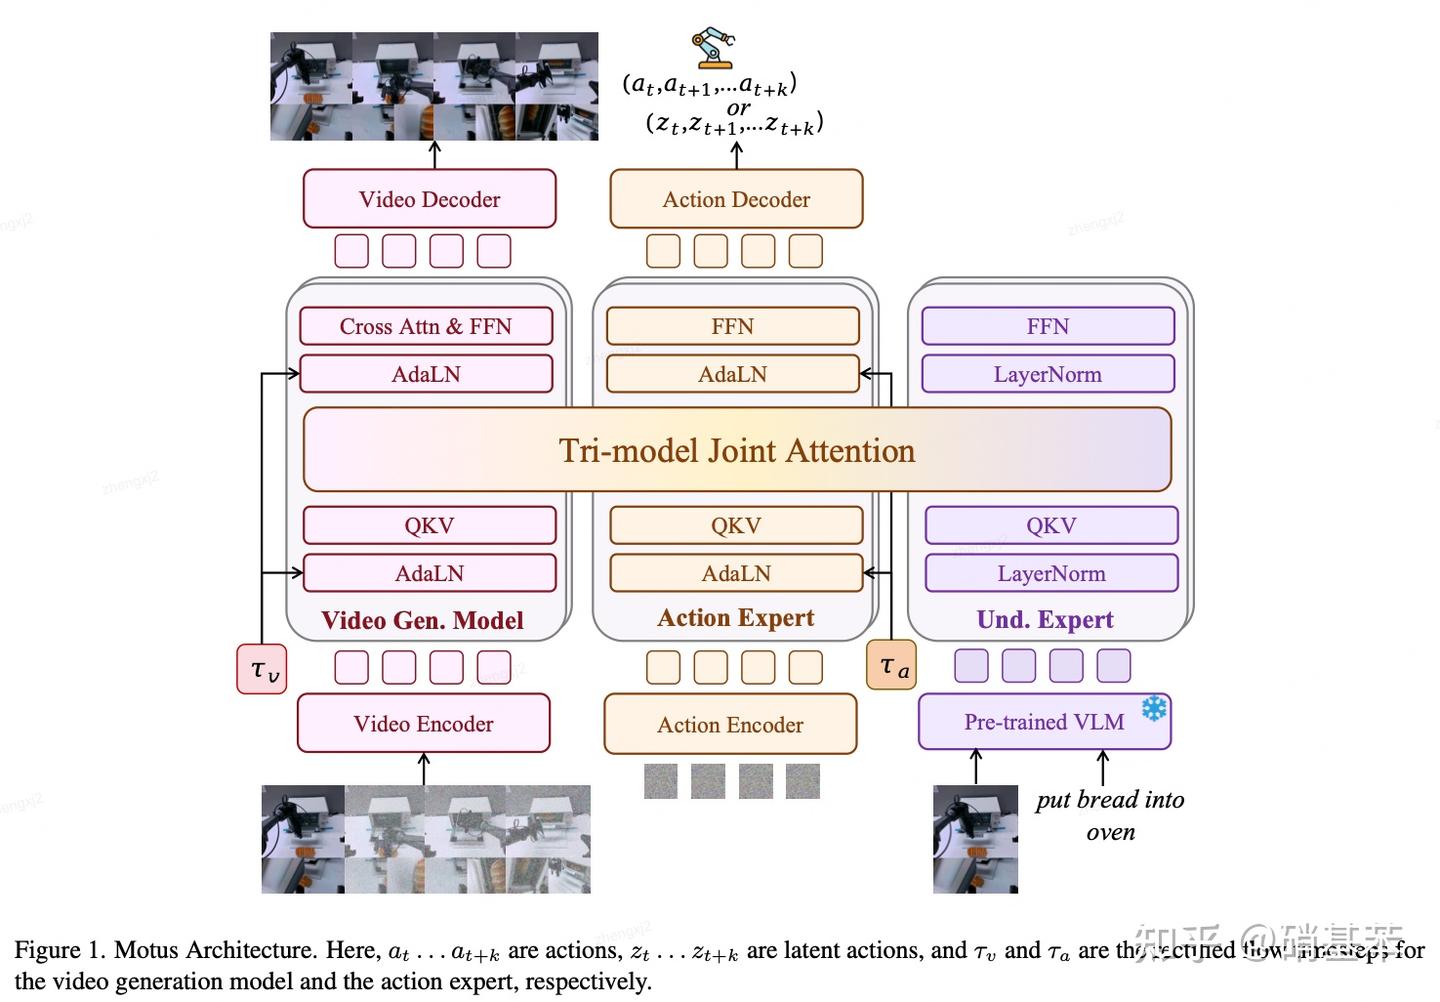
作者:硝基苯 https://zhuanlan.zhihu.com/p/2019875354538428076 写在前面 从过年一直到现在,World Action Model这个概念很火,学术界有很多工作(Cosmos Policy, DreamZero, Motus, LingBot-VA, F
本文档基于 Claude Code CLI 工具的源码进行深度分析,旨在用清晰易懂但专业的语言,详细讲解其内部运行机制。特别关注 Memory(记忆)模块的设计与实现。 1. 项目总览:Claude Code 是什么 Claude Code 是 Anthropic 官方开发的命令行 AI 编程助手(
随着大语言模型逐步从「单轮问答」走向「真实环境中的持续交互」,各种各样如OpenClaw的agentic applications正在成为当前研究与产业共同关注的核心方向。无论是在网页环境中进行信息检索与操作,还是完成代码生成与调试、个性化推荐等复杂决策任务. 这些场景都要求LLM agent具备主
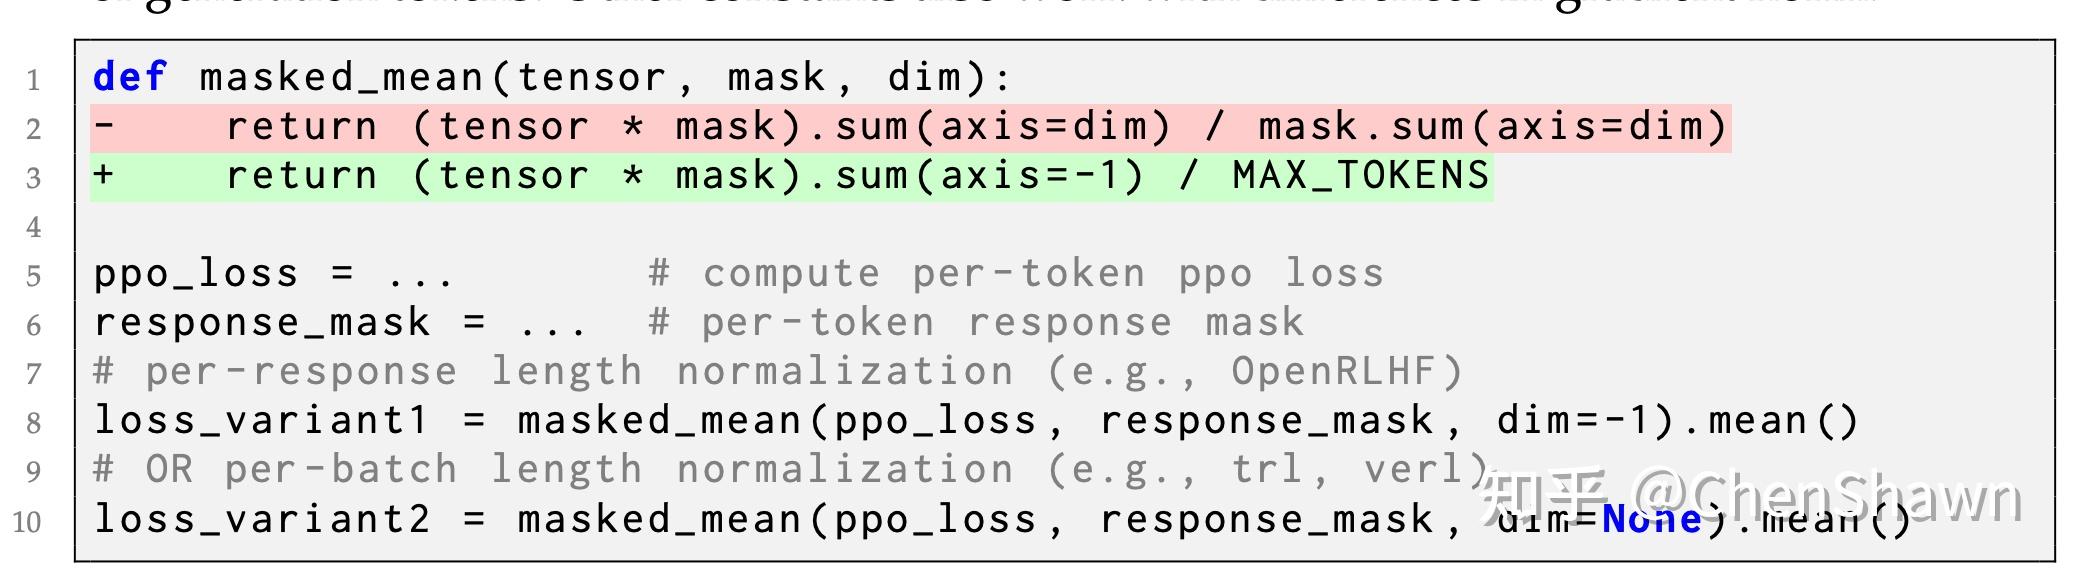
作者:ChenShawn https://zhuanlan.zhihu.com/p/2005256302918665528 我们最近 release 的工作 VESPO,是一个在 off-policy setting 下解决 LLM RLVR 训练稳定性问题,以及 bias-variance tra
作者:Sonata,清华大学 计算机科学与技术博士在读原文:https://zhuanlan.zhihu.com/p/2022547604903339697 这里是一些最近做机器人研究产生的的个人看法。具体内容难免存在局限和疏漏,也可能和主流观点并不相同,欢迎友好讨论和指正。 VLA很火热,但也很稚
一、 引言:大模型强化学习算法的演化格局 近年来,以 OpenAI 的 o1 系列、DeepSeek 的 R1,以及 Qwen 系列模型为代表,大语言模型在数学证明、代码生成等长链路推理任务中展现出更强的稳定性与推理深度。 在这一背景下,面向大语言模型的强化学习(RL for LLMs, RL4LL
痛点与破局 RL 训练过的人都知道那种感觉——跑了三天 GRPO,token 消耗是 SFT 的十几倍,最后一看提升,几乎为零。 问题出在哪?Reward 信号太稀疏,credit assignment 做不到 token 级,rollout 全错时梯度直接归零。 但 SFT 也有自己的软肋:推理时
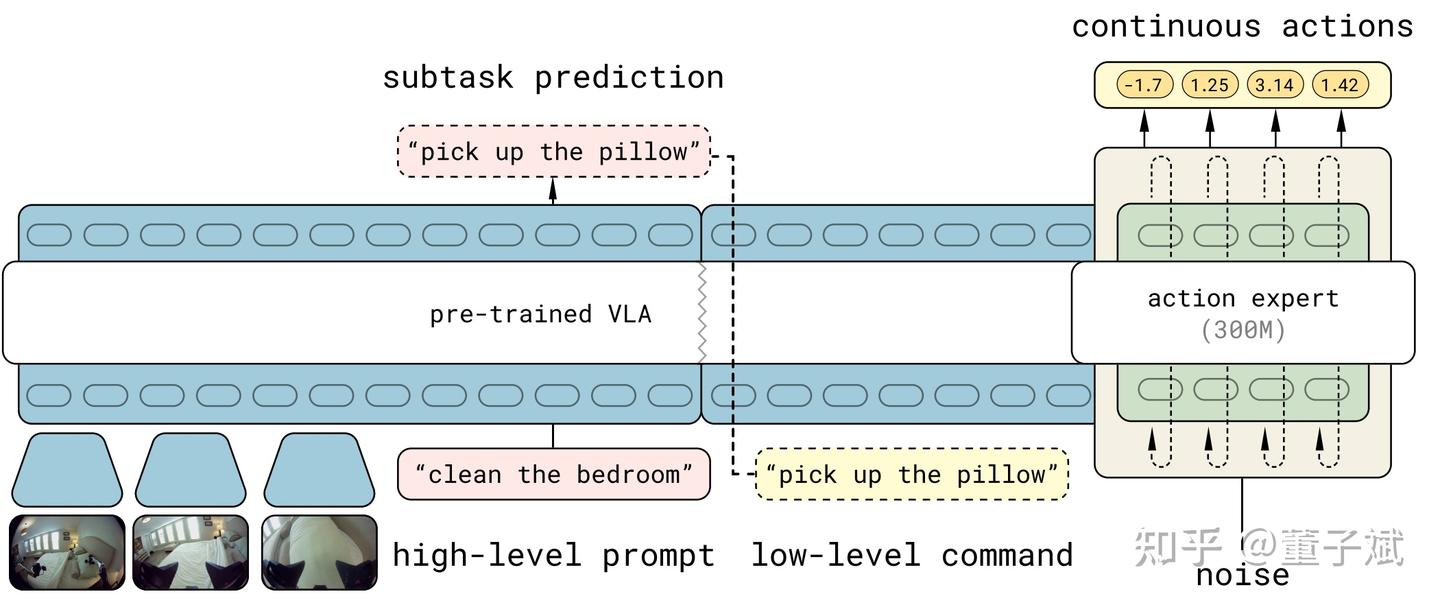
作者:董子斌 https://zhuanlan.zhihu.com/p/2006493733990981927 1. 主流 VLA 架构以及为什么我们需要 action tokenizer 不得不承认 physical intelligence 依旧是 VLA 实践灯塔之一,自从 \pi_{0.5}
林俊旸在x上发了一篇长文,特此分享 https://x.com/JustinLin610/status/2037116325210829168 过去这两年,彻底颠覆了我们评估和期待大模型的方式。 OpenAI 的 o1 告诉我们:思考本身就能成为模型一种核心的一等能力,你可以专门为了思考去训练模型,
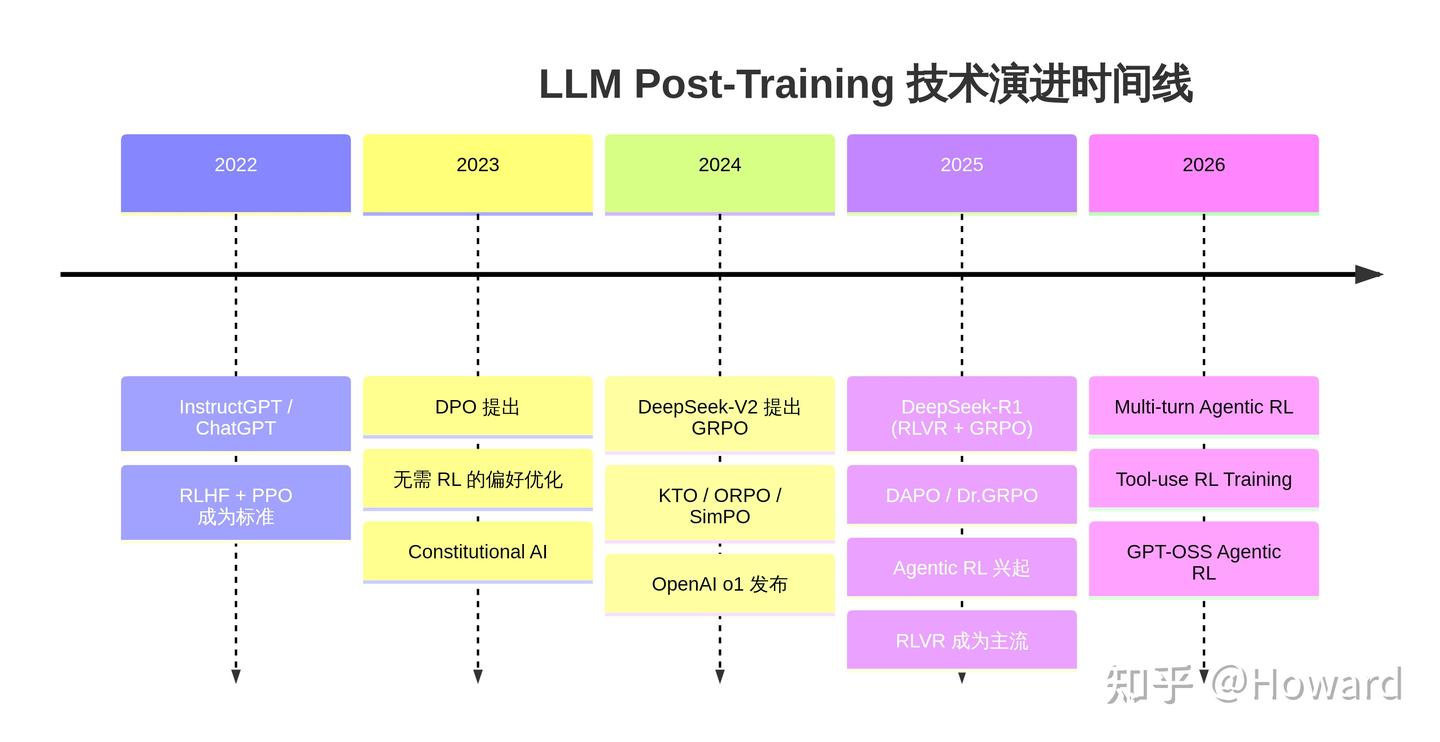
作者:Haohe,Meta FAIR 研究科学家 https://zhuanlan.zhihu.com/p/2012909606771400823 1. 引言:什么是 Post-Training? 大语言模型(LLM)的训练通常分为两个大阶段:预训练(Pre-training) 和 后训练(Post
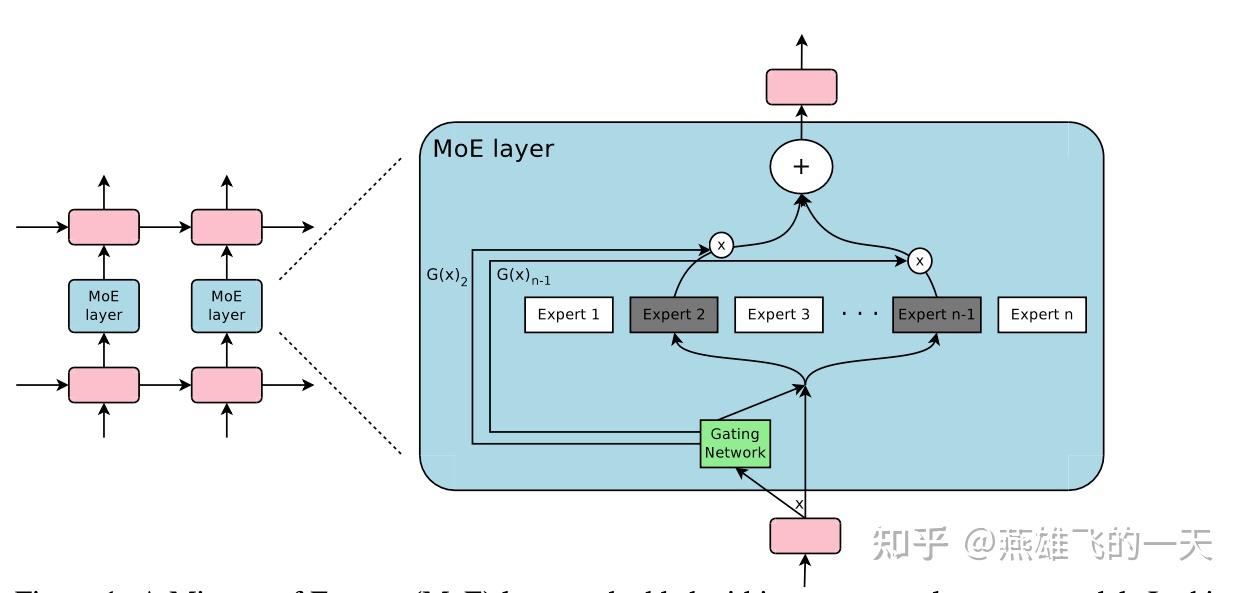
作者:燕雄飞的一天 https://zhuanlan.zhihu.com/p/2018018879109091590 无论是开源还是顶尖商业模型,moe架构已经成为绝对主流,区别于dense模型,在sft和rl阶段有什么独特的训练难点或者挑战,对于这些挑战如何缓解。期望从基础原理入手,看如何训练mo
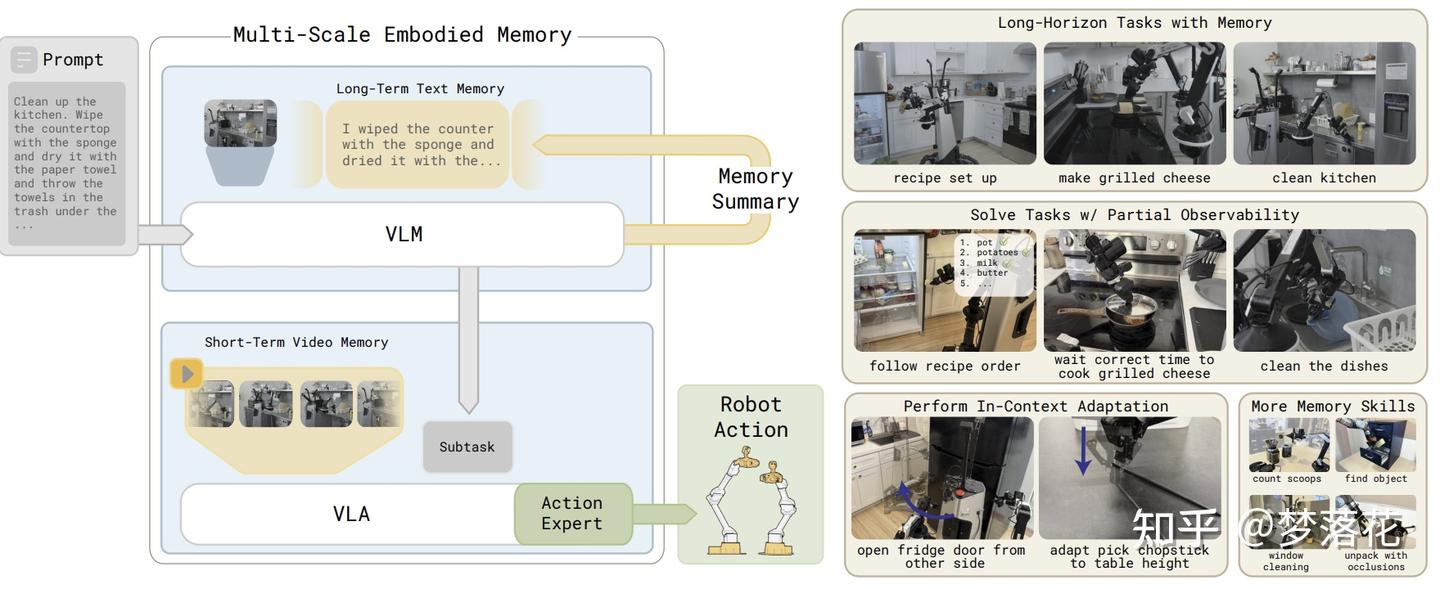
作者:梦落花 https://zhuanlan.zhihu.com/p/2017560172977992865 为什么vla需要有记忆? 机器人在运动过程中视线被遮挡时,需要从未被遮挡的历史数据中推断出物品真实位置;而机器人在做饭时需要记住它过去加了哪些食材,顺序是怎么样的。 本文通过这两个例子引出
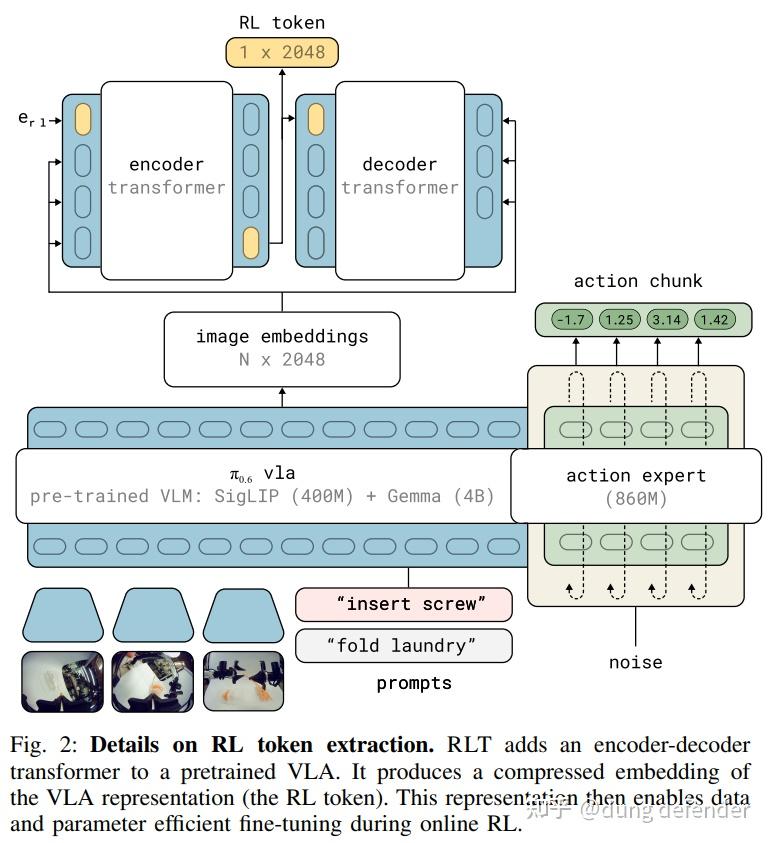
作者:dung defender https://zhuanlan.zhihu.com/p/2019320352367494543 今天主要来分享physical intelligence的最新工作: 标题:RL Token: Bootstrapping Online RL with Vision-
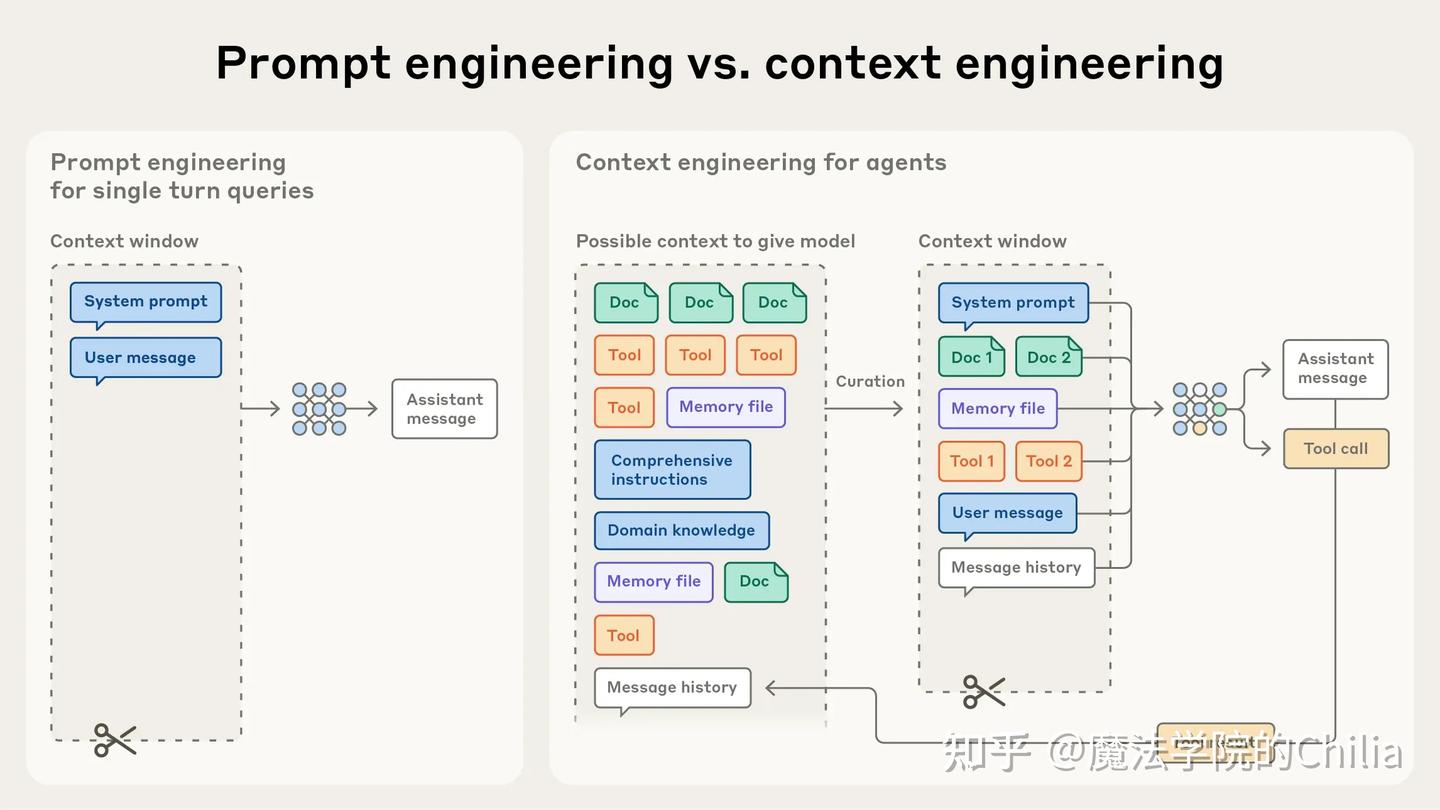
作者:魔法学院的Chilia https://zhuanlan.zhihu.com/p/2012088406826562496 0x01. 背景 (1)什么叫上下文工程(Context Engineering)? “上下文工程”简单来说,就是在一些LLM的约束下(如上下文窗口大小、注意力长度的限制)
作者:YyWangCS https://zhuanlan.zhihu.com/p/2017528295286133070 前言 作为月之暗面 AI Infra 团队的一员,这篇文章我想从 AI Infra,尤其是推理架构的角度(关于训练,我们的同事有一篇非常好的回答,推荐读一下,这里就不多谈了),聊
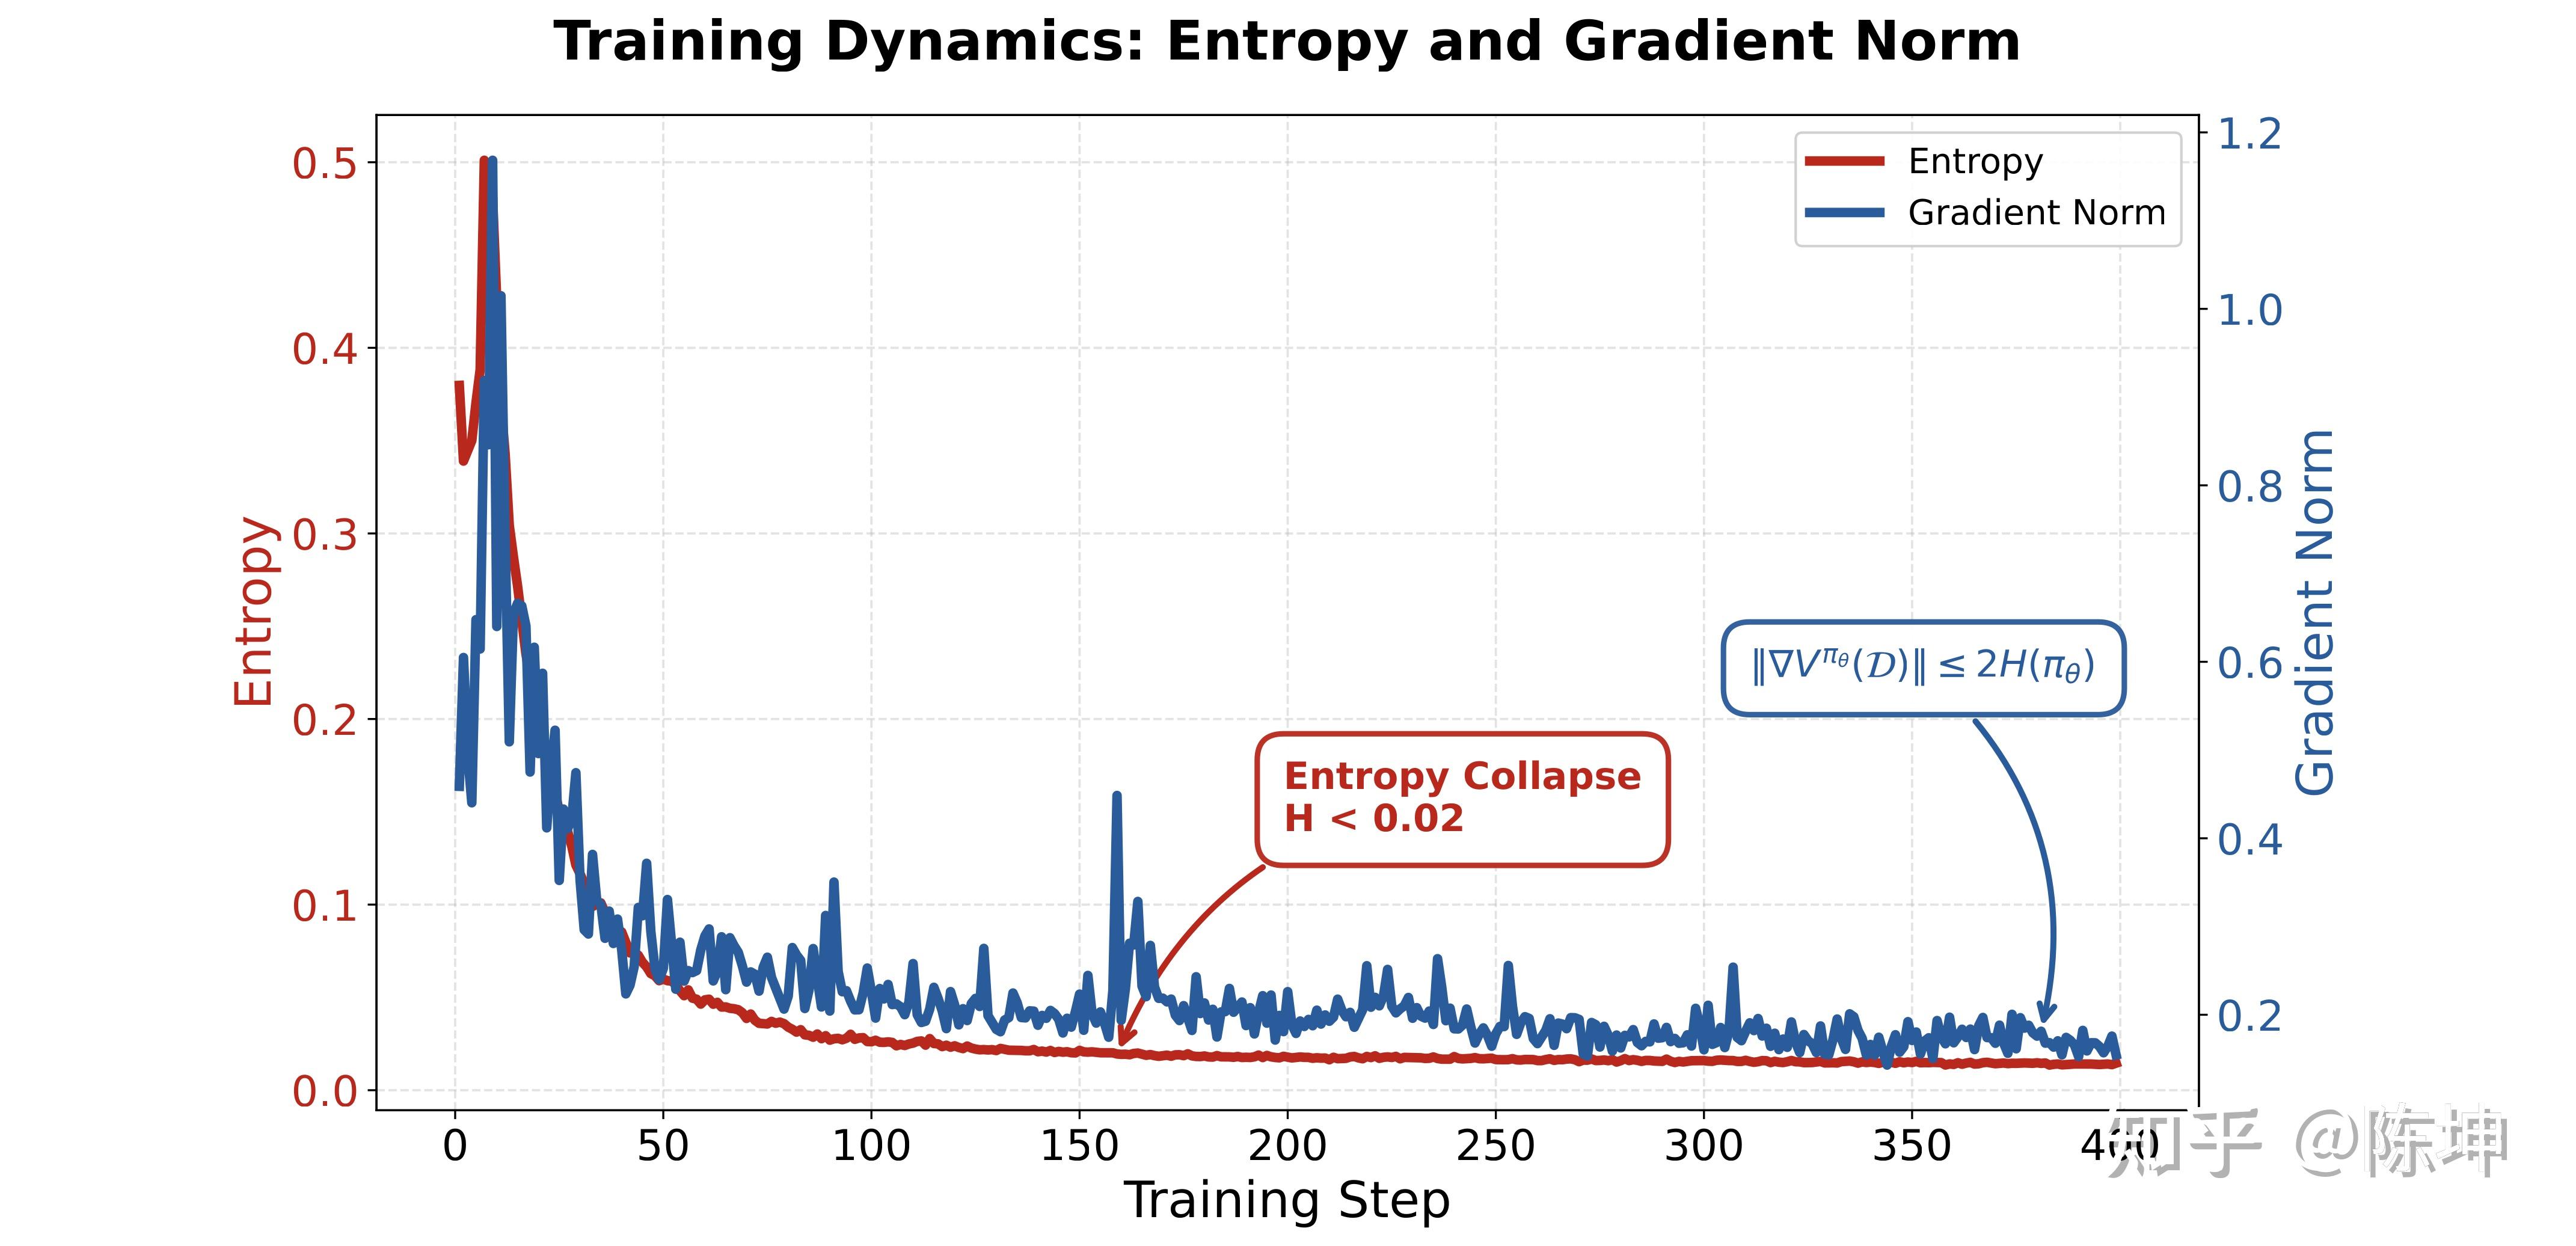
作者:陈坤 史鹏 https://zhuanlan.zhihu.com/p/2017276876004017170 本文介绍我们近期在 RLVR 训练动态方面的一项研究。我们从梯度保留裁剪(Gradient-Preserving Clipping)的理论视角出发,提出了一套灵活的熵调节机制,并基于熵
1.引言 在CVPR 2026接收的论文《Conan: Progressive Learning to Reason Like a Detective over Multi-Scale Visual Evidence》中,我们提出了基于多尺度视觉证据的多步视频推理框架,解决多模态大语言模型(MLLM
NUS、ZJU、UW、Stanford、CUHK联合提出「ThinkMorph」,主张让文字与图像在统一架构里「原生协作」、「共同演化」,而不是像当下大多数多模态模型那样,看完图像就闭上眼睛,后续完全靠文字链条推进。 仅用2.4万条数据微调7B统一模型,视觉推理平均提升34.74%,多项任务比肩甚至
作者:硅基趣玩喵 原文链接:https://zhuanlan.zhihu.com/p/2016080986690041206 一、背景 LLM强化学习训练面临一个核心架构选择:是使用在线RL(Online RL)——在训练中实时采样当前策略的rollout,还是使用离线RL(Offline RL)—
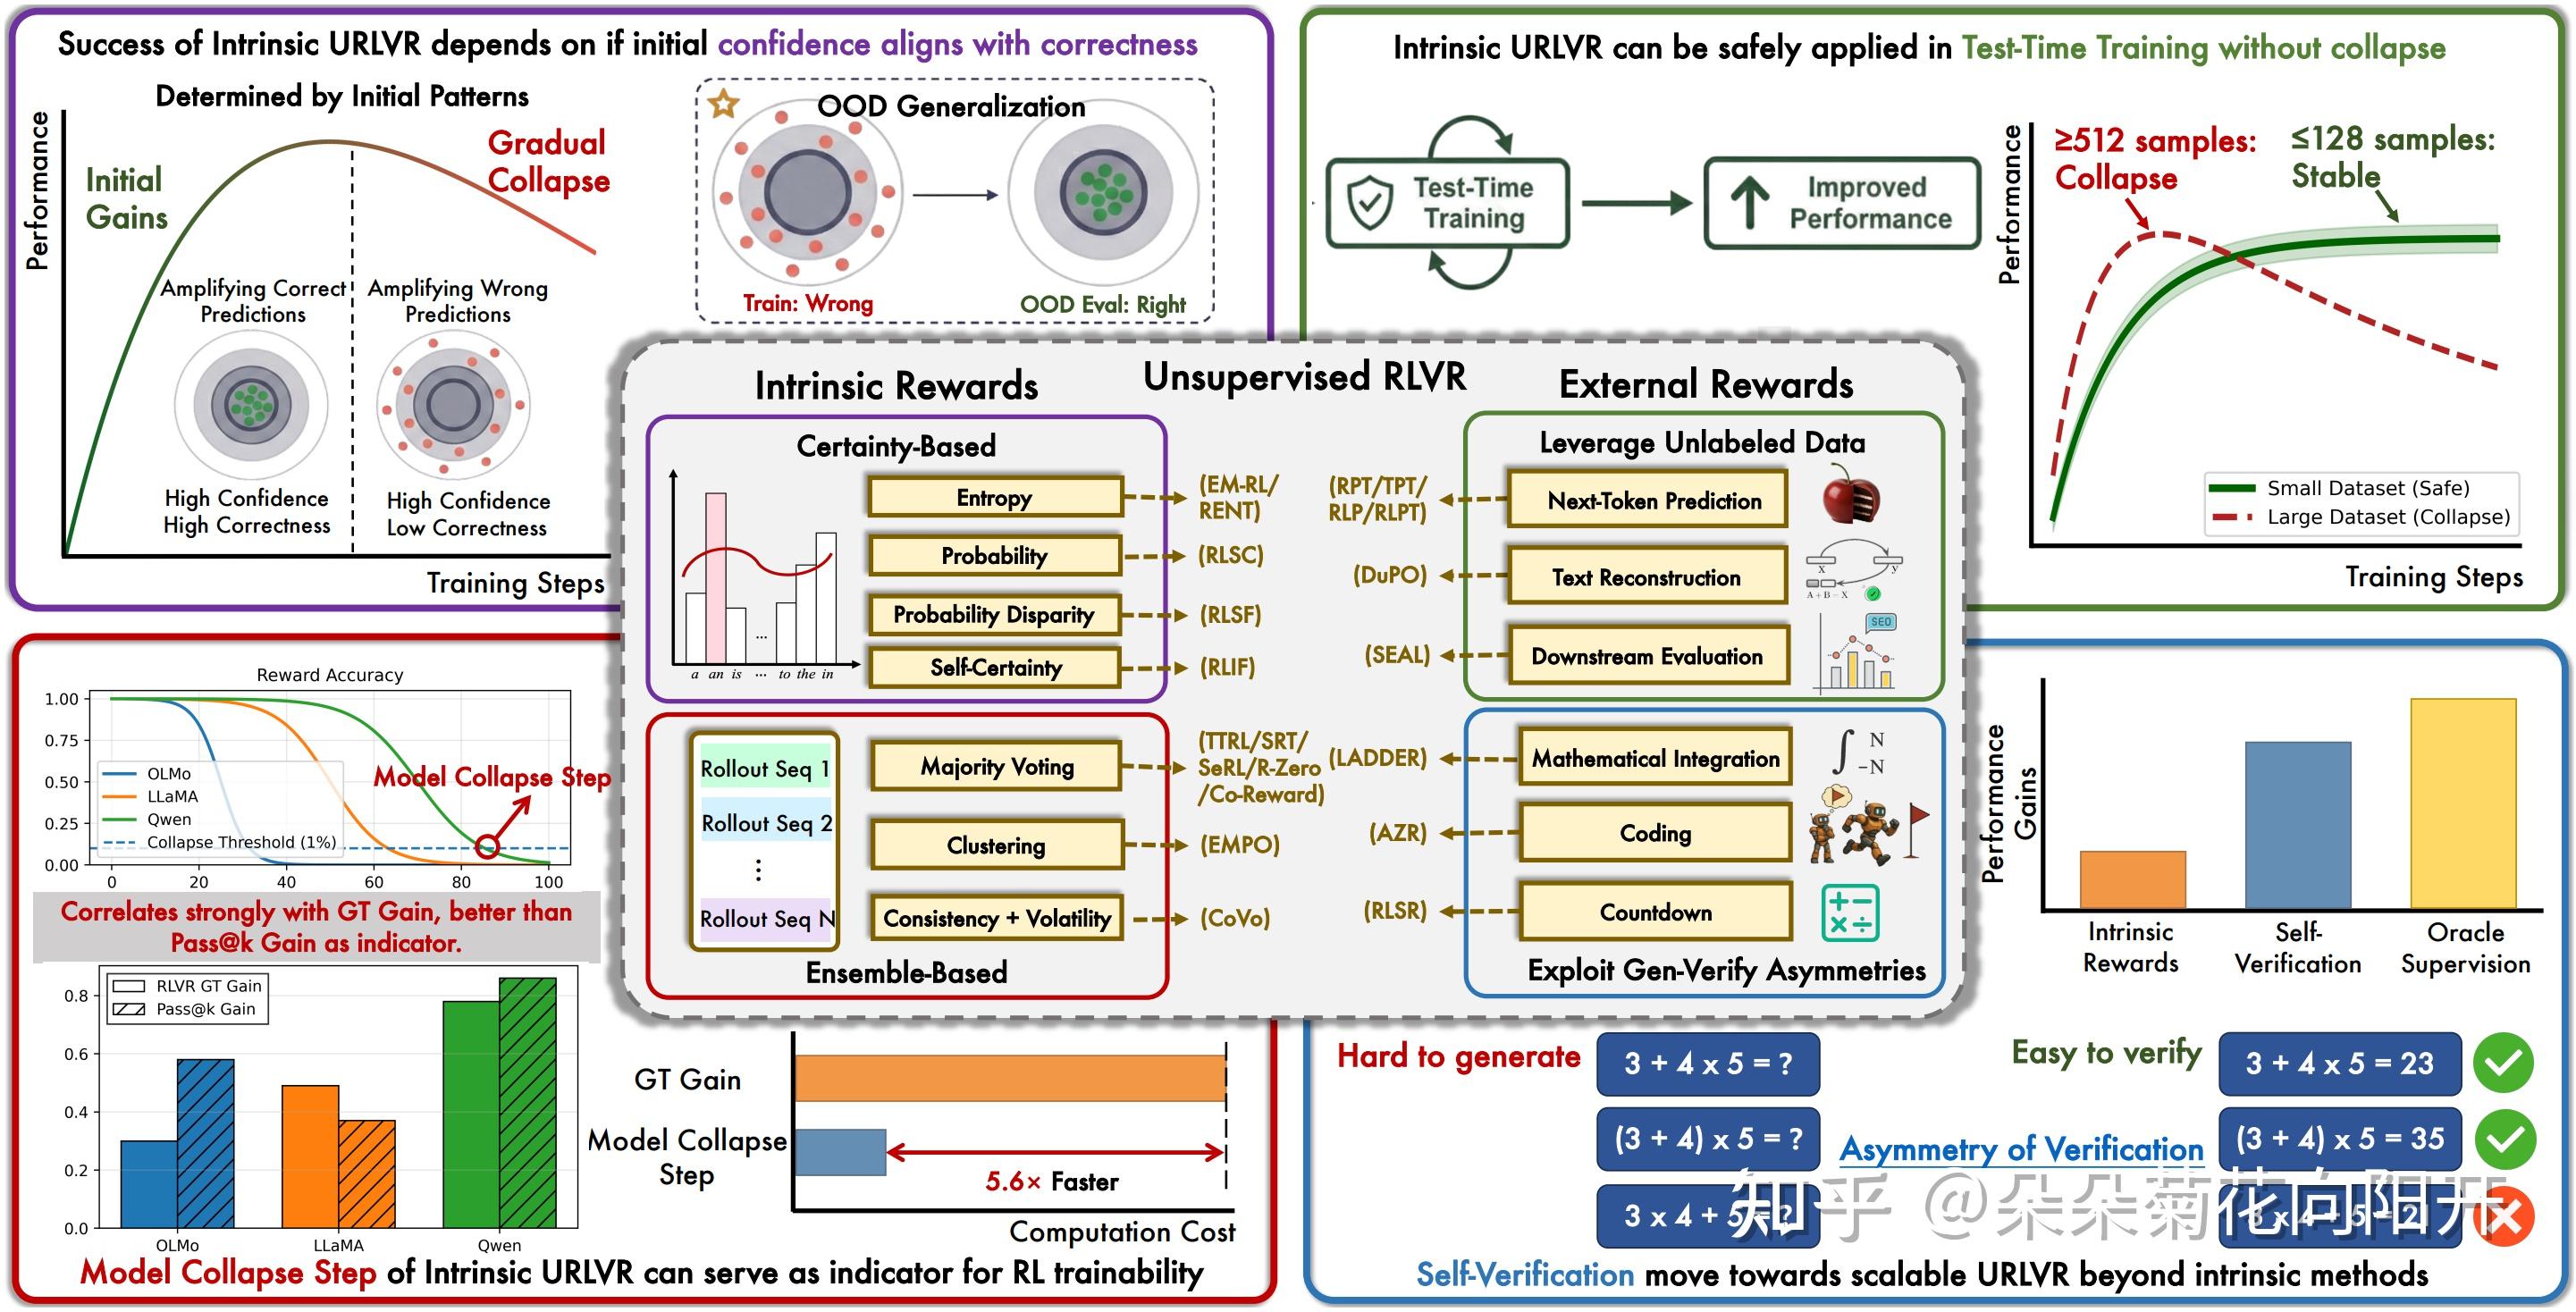
作者:朵朵菊花向阳开 原文:https://zhuanlan.zhihu.com/p/2015470633765593982 从TTRL开始,无监督RLVR(Unsupervised RLVR)应运而生,让模型在没有人工标注的情况下持续进化。这不仅是降本增效的需求,更是通往超级智能的必经之路。就像预
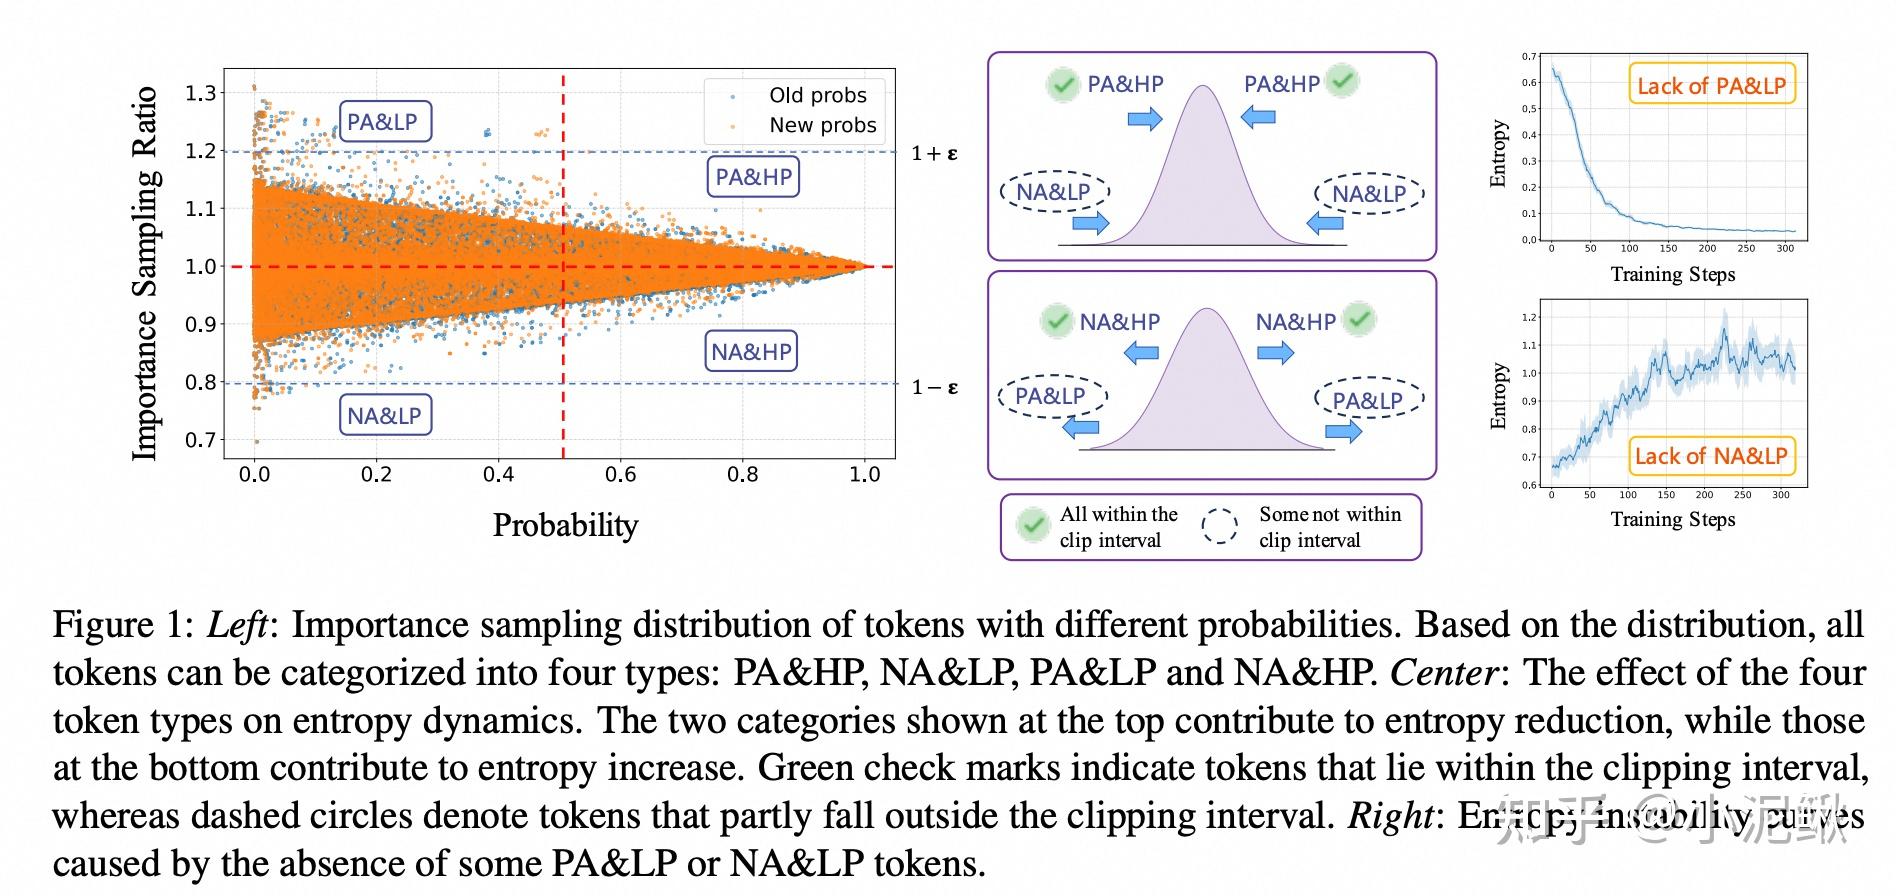
作者:小泥鳅 https://zhuanlan.zhihu.com/p/2004633029096776871 TL;DR:推导公式拆解RL训练中Entropy变化流程、基于判别式S_k=p_k(H+\log p_k)分四类讨论Token的Entropy-Dynamic性质、统一解释主流RL-Ent
当AI Agent开始从“工具调用者”走向“长期协同者”,记忆便成了决定其天花板的关键。然而,现有的记忆方案正面临一个尴尬的悖论:Agent 往往拥有一本厚厚的“交互日记”,却缺乏一套真正的“知识储备”。 近日,由UIUC、清华与微软研究院 联合提出的PlugMem引起了广泛关注。作为一个任务无关的
论文题目:Scoring, Reasoning, and Selecting the Best! Ensembling Large Language Models via a Peer-Review Process 作者信息:Zhijun Chen 1, Zeyu Ji 1, Qianren Mao
CaveAgent:一个面向工程落地的有状态Agent运行时框架 论文地址:https://arxiv.org/abs/2601.01569 项目地址:https://github.com/acodercat/cave-agent 安装:pip install 'cave-agent[all]' 这
视觉几何基础变换器(VGGT)在静态场景中表现优异,但在动态场景下面临固有矛盾:相机姿态估计需抑制动态区域,而几何重建则需建模动态信息。如何在统一框架下协调这一任务冲突? 来自MIT和Harvard的研究团队提出了PAGE-4D(Disentangled Pose and Geometry Esti
作者:attack204 https://zhuanlan.zhihu.com/p/2007250216227729670 调研了一些目前Agentic-RL场景下对Infra的一些需求,主要内容都来自于各家大厂的文章 值得一提的是除了最后一篇Seer的文章外,其他3篇都是春节期间发布的,LLM还是
TLDR. Agent是强大的,但用户是狂野的 😦又是一个工具使用Benchmark?不是说模型厂商追逐榜单严重,忽略用户实际体验? 确实,但我们面对这个质疑提出了WildToolBench:当我们衡量模型的工具调用能力时,不能仅仅看在完美的提问下,完美的实验环境下,LLM能否操纵工具回答正确,因
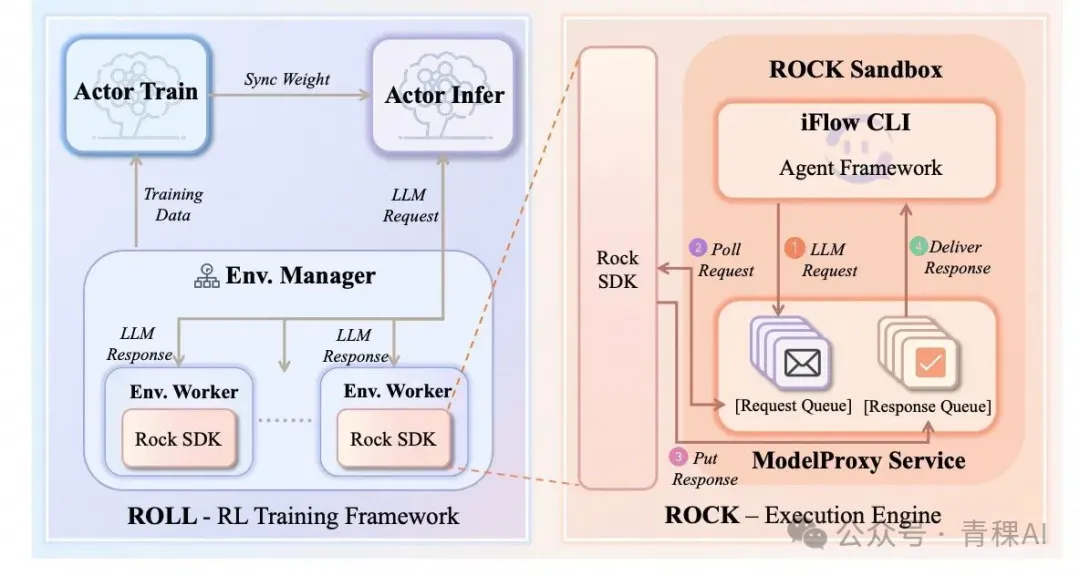
作者:Xiaoyang Li, Weixun Wang and Yancheng He | Project Leader: Weixun Wang | March 5, 2026** 本文英文名称:Save, Load and Learn: Boosting Agentic LLMs via Rol
作者:sheriyuo https://zhuanlan.zhihu.com/p/2011084180654671820 从工程上看,我们通常把 RLHF 当成“在 \pi_{\rm ref} 附近,通过偏好信号或显式 reward 优化策略”的交互学习: 先收集偏好/评分数据,再通过某种带 KL
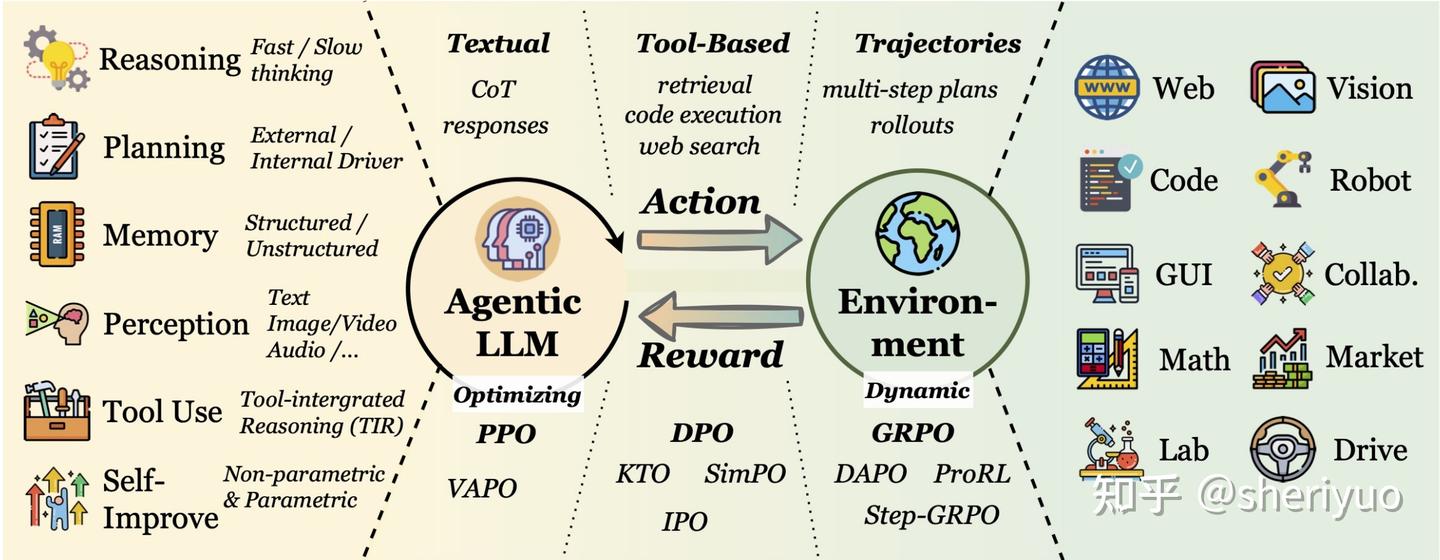
作者:sheriyuo https://zhuanlan.zhihu.com/p/2009946011120971848 近年来,随着 Agentic RL 的兴起,LLM 逐渐从“单次问答器”转变为能够在推理(Reasoning)与外部工具调用(Tool-use)之间反复交互(multi-turn
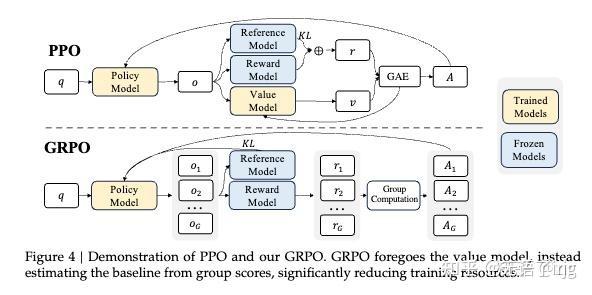
作者:无语了ing https://zhuanlan.zhihu.com/p/2010029640434087295 作为新入门强化学习的小白,由于缺乏相关的基础理论知识,经常会遇到一个很尴尬的问题:硬读PPO/GPRO的论文却被各种公式符号搞得摸不着头脑,只看博客和相关文章但却总感觉对里面所讲述的
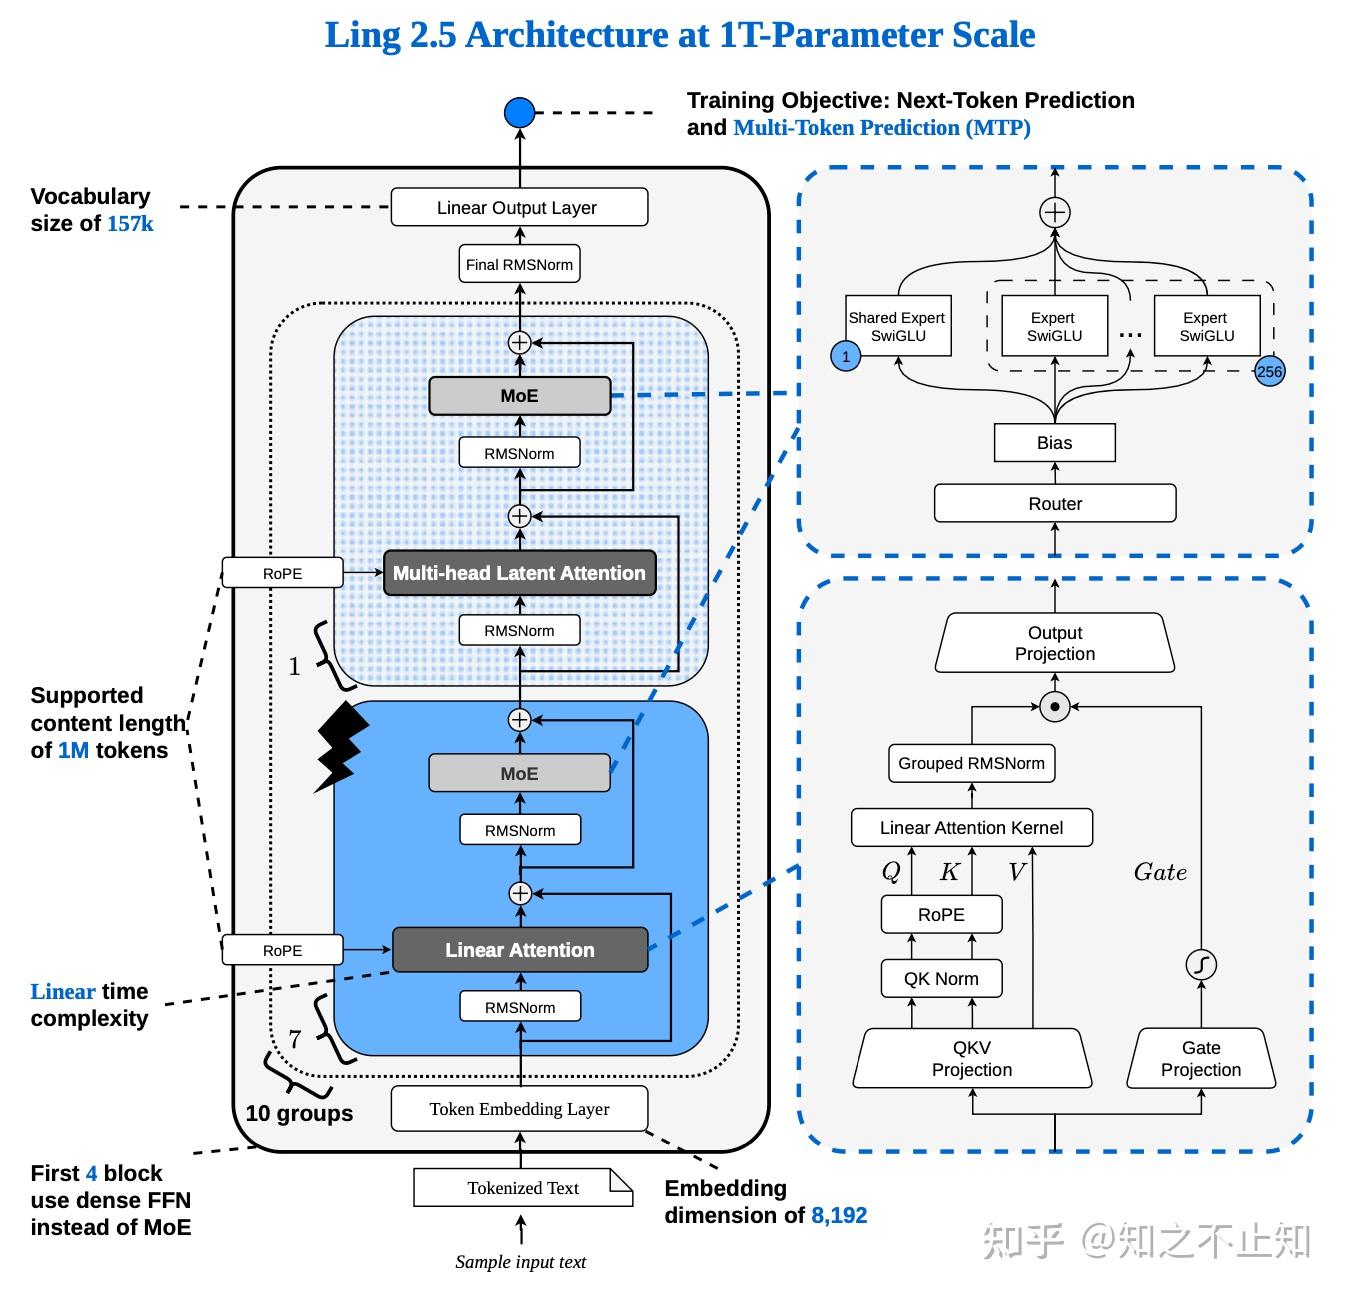
作者:知之不止知 原文:https://zhuanlan.zhihu.com/p/2010050657122546578 基模架构设计的核心思路是用更低的理论计算(FLOPs)或真实算力(GPU hours)实现更大的架构效率杠杆(Efficiency-Leverage)。在 Ling 2.0架构的
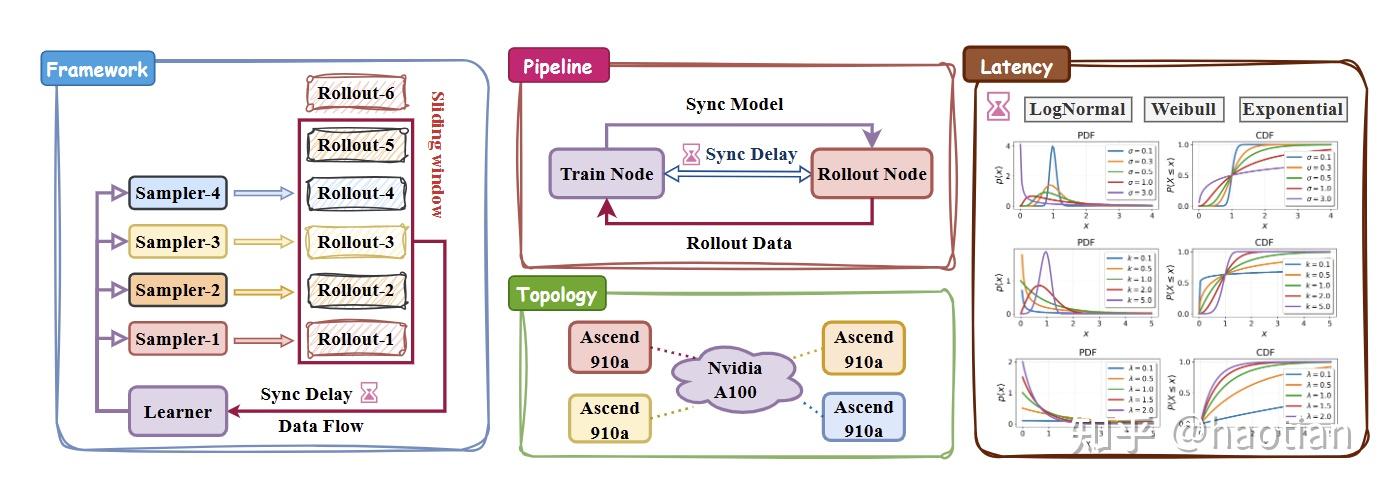
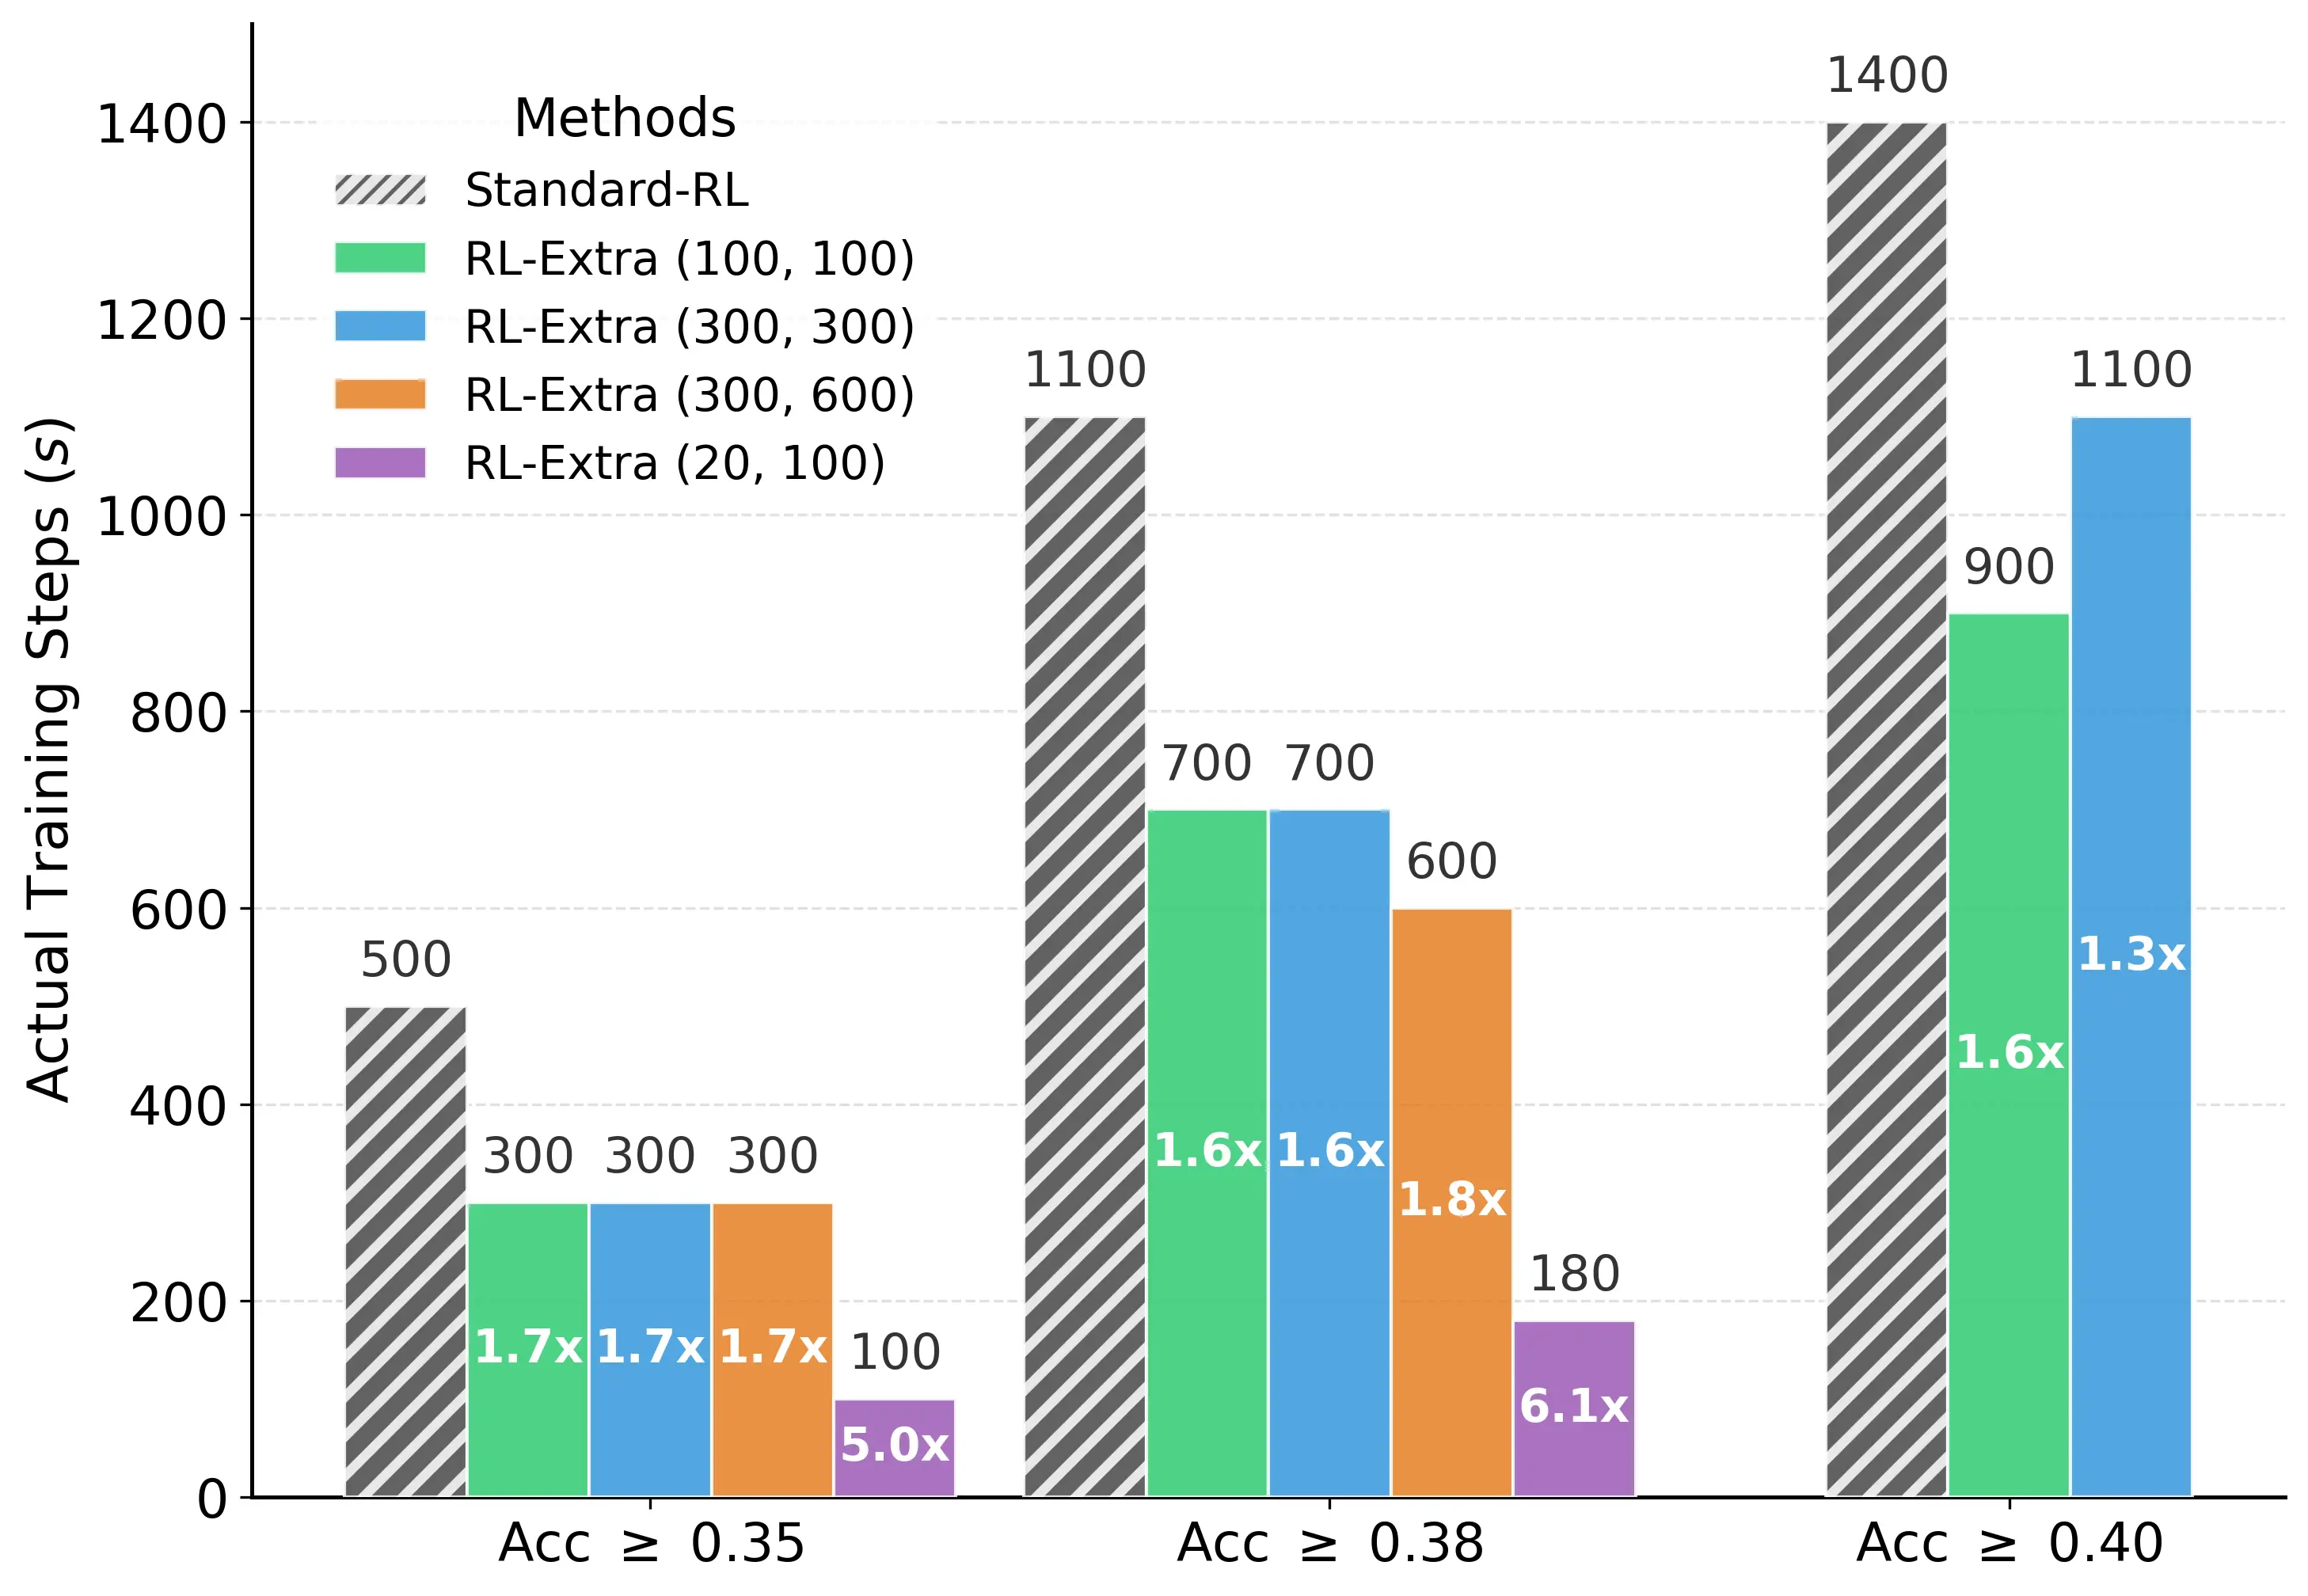
作者:haotian https://zhuanlan.zhihu.com/p/2010293867208021164 目前,为了追求上限,各家都尽可能地使用onpolicy训练。对于agentic任务,往往是全异步配置,不可避免带来offpolicy的问题。offpolicy在使用合适的训练set
作者:王天乐,香港城市大学数据科学系博士生,导师为苗宁教授,研究方向为大语言模型推理。 DeepSeek-R1 的爆火让 RLVR(带验证奖励的强化学习) 再次成为大模型后训练(Post-training)的焦点。然而,复现过 R1-Zero 或类似流程的同学都知道,RLVR 极其昂贵——它不仅需要
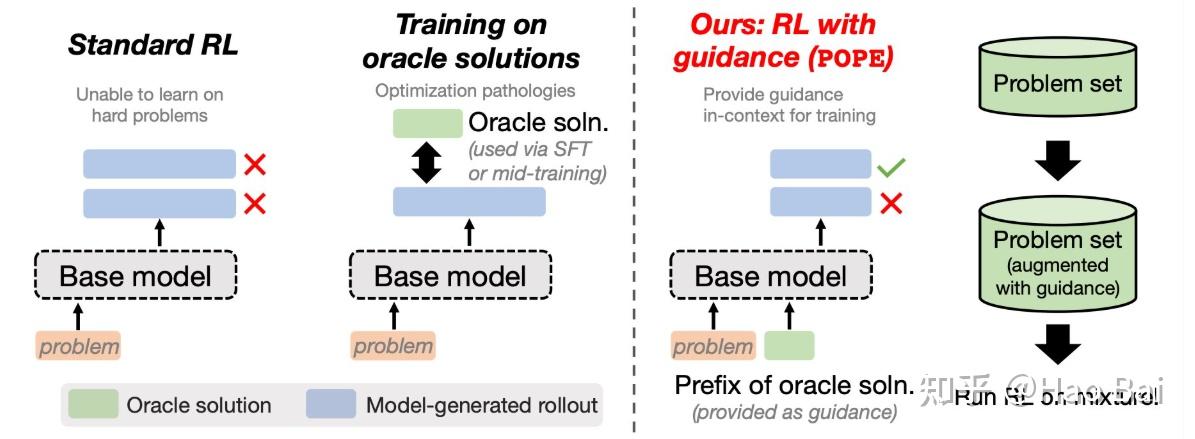
作者:Hao Bai https://zhuanlan.zhihu.com/p/2006963575110013959 今天来聊一下RL的近期热门问题,涉及Off-policyness,Sample Efficiency与Priviledge Information这些话题,可以理解为SFT+RL的
作者:extreme1228 原文:https://zhuanlan.zhihu.com/p/1997363850849300572 过去半年到一年时间,自己也算是在LLM RL领域的一个科研工作者。 自从25年年初DeepSeek-R1横空出世后,LLM RL就变成了一个非常火爆的方向,与此同时基
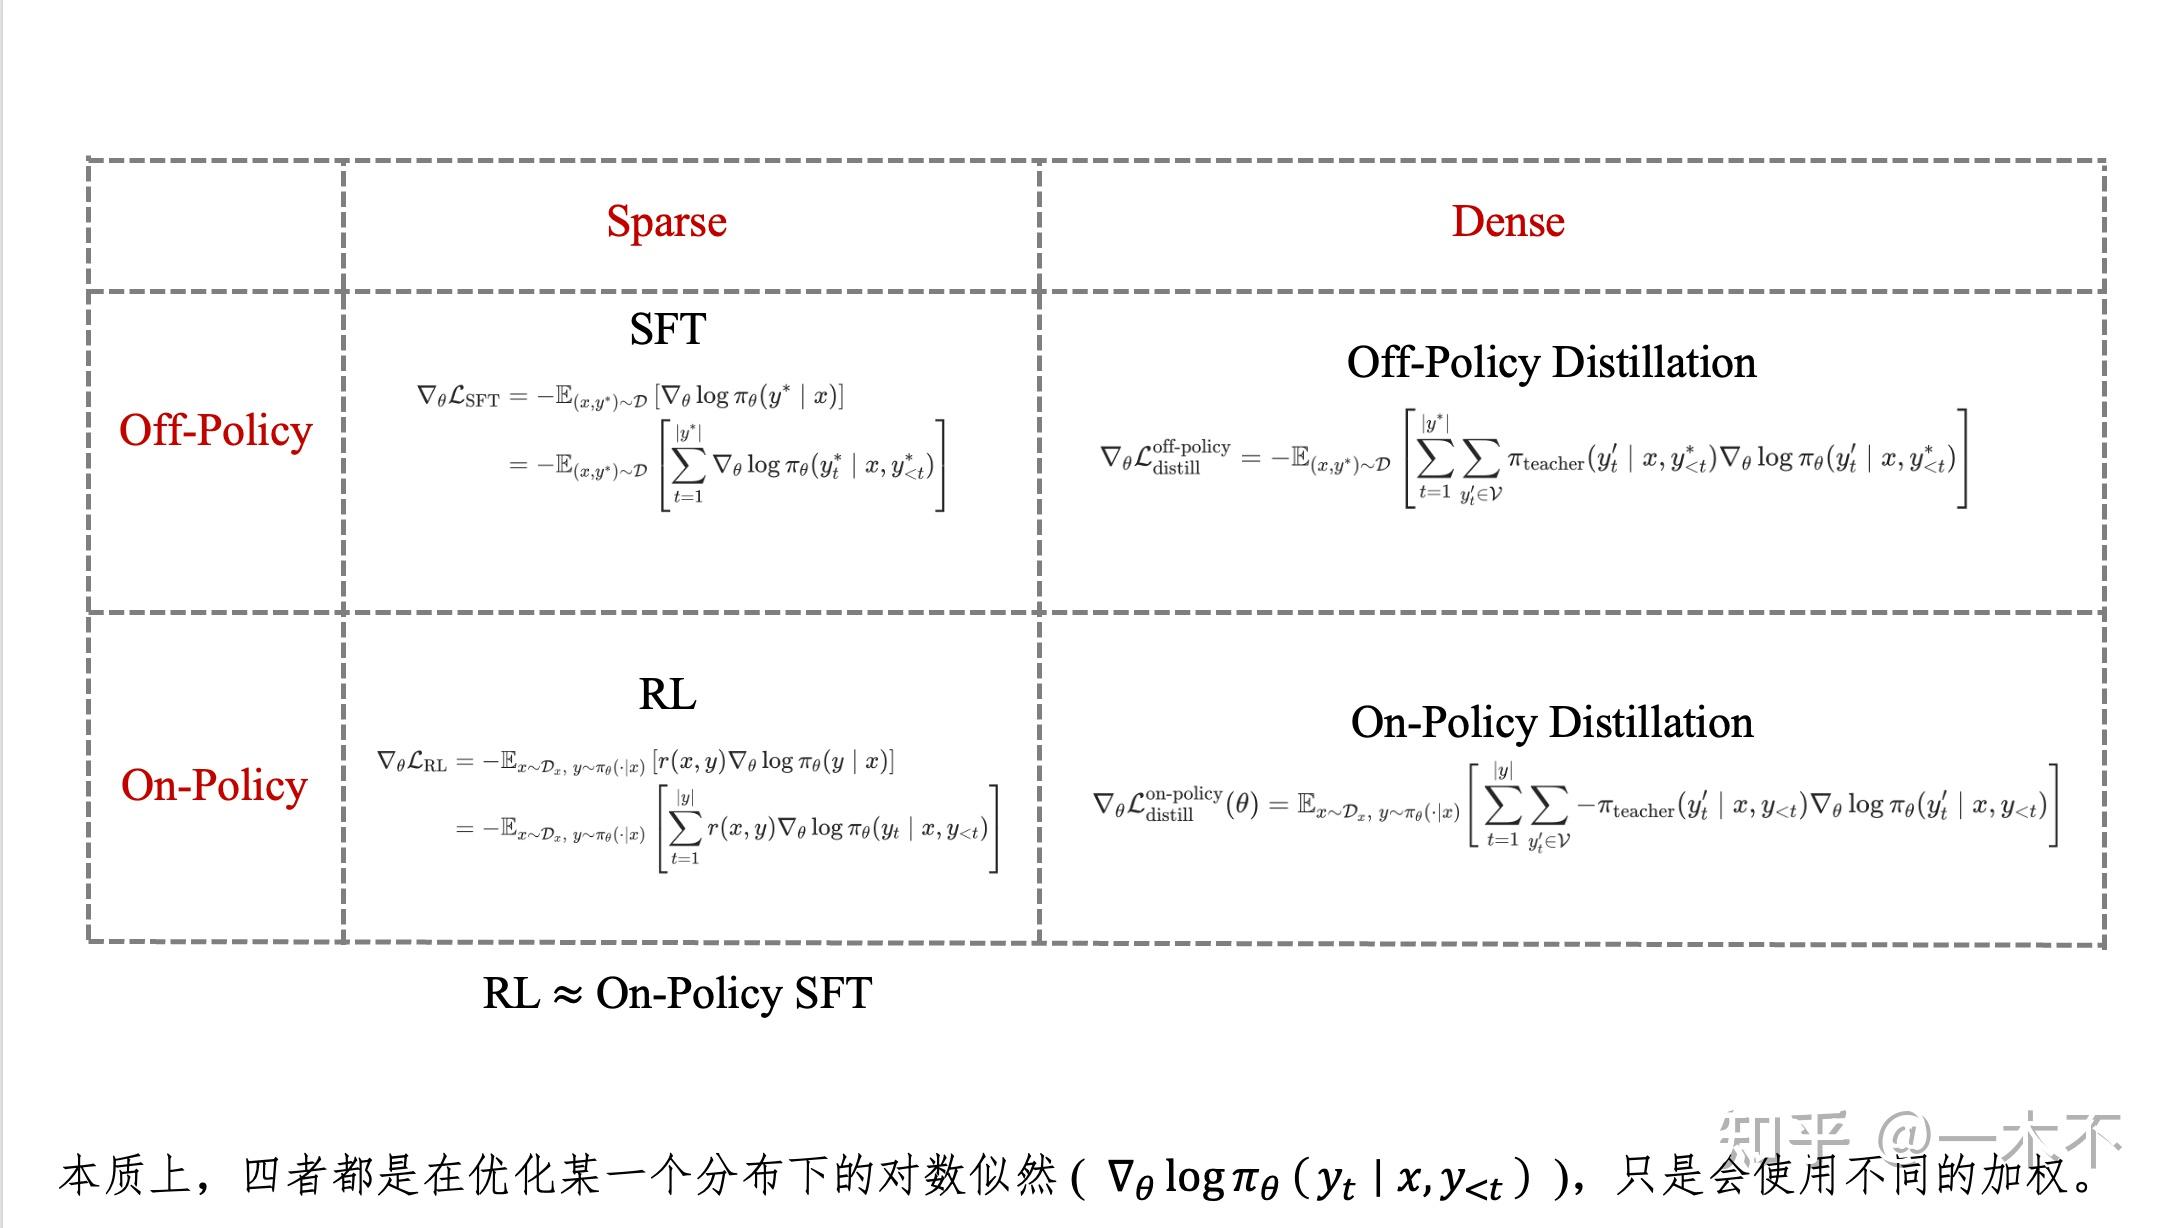
作者:一木不 原文:https://zhuanlan.zhihu.com/p/2004262797710738371 我们在此讨论SFT,Off-Policy Distillation,RL,On-Policy Distillation之间的联系和区别。 在RL没火的时候,我们提到distillat
去年有次组会,师弟和我说在复现一些Thinking with Images工作的时候,发现interleaved images是错的/被丢掉了,模型的表现也不会受到影响。另外,有些模型在实际上没有执行工具的时候也会幻觉说执行了工具。考虑到我们之前发现llm4math里有答案正确过程不对的情况,vis
本文为 AI AMA 栏目第一期 Agent自进化 主题全观点转录。 青稞 AMA(AI AMA)是由魔搭社区、青稞社区、机智流与知乎联合发起的 AI 前沿技术圆桌对话栏目。围绕真正值得讨论的AI技术方向,以「多元视角」邀请一线实践者同框深度对谈:拆解原理、还原细节、碰撞观点,直面工程落地的真实挑战
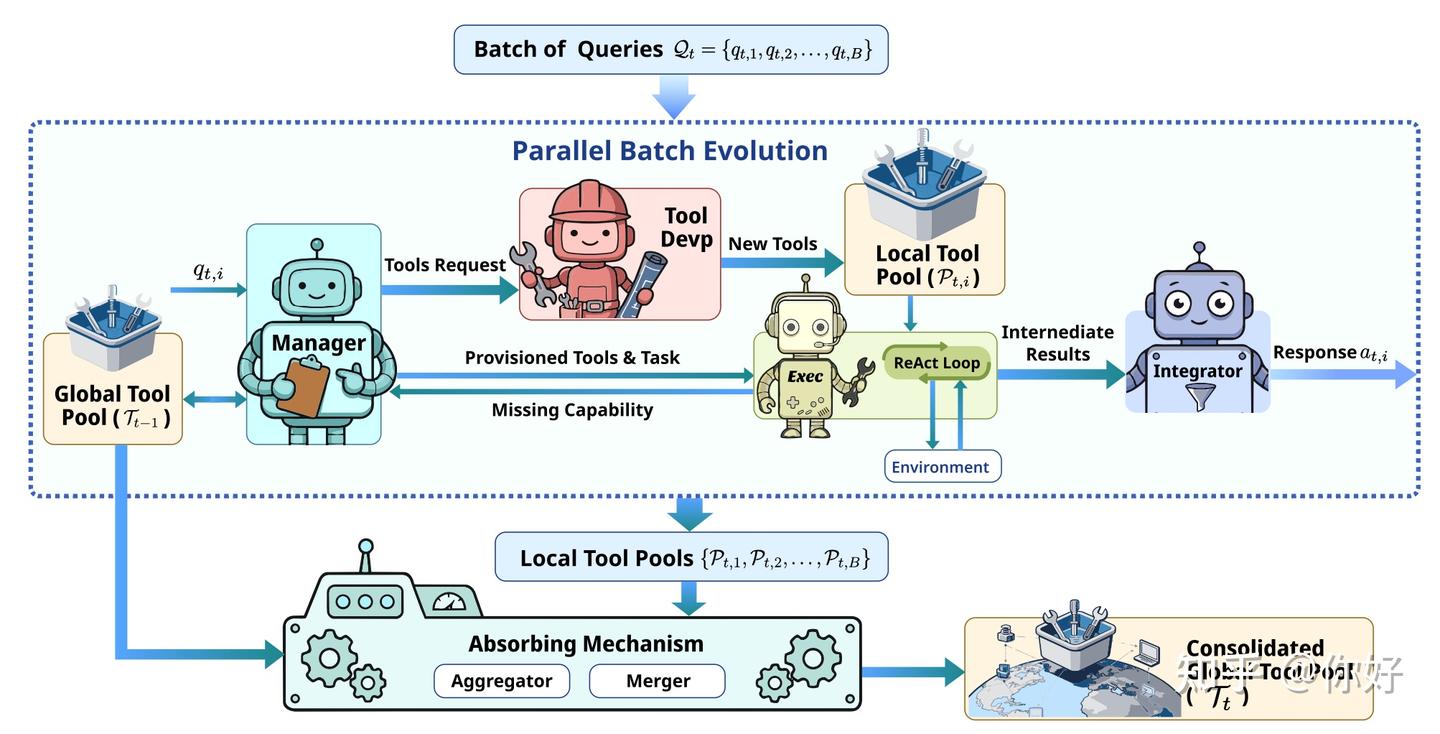
TL;DR 我们提出了 Yunjue Agent,一个面向开放域任务的原地自进化智能体系统。与当前主流的”在新环境生成数据再训练”范式不同,我们认为真正的自进化应该是 In-Situ(原位自进化)——在推理过程中持续积累工具能力,无需外部监督。 在HLE,DeepSearchQA等五个 benchm
作者:龙心尘 https://zhuanlan.zhihu.com/p/2005366418179385192 声明:为突出重点,部分背景知识已略去,同时涵盖的内容也难免有疏漏之处,还望读者理解。 背景说明 1.KL散度正则化涉及多种决策项,包括:使用正向KL散度还是逆向KL散度(2种)、将其置于损
让大模型生成 GPU Kernel是大家对大模型发展的一个共同期望,并且GPU Kernel本身作为一类代码,天然可被执行,从而获得来自环境的反馈。直觉上非常适合通过 LLM 结合强化学习(RL)的范式进行训练。然而目前并没有行之有效的办法对Kernel生成进行有效的、长时间的 RL 训练。 来自港
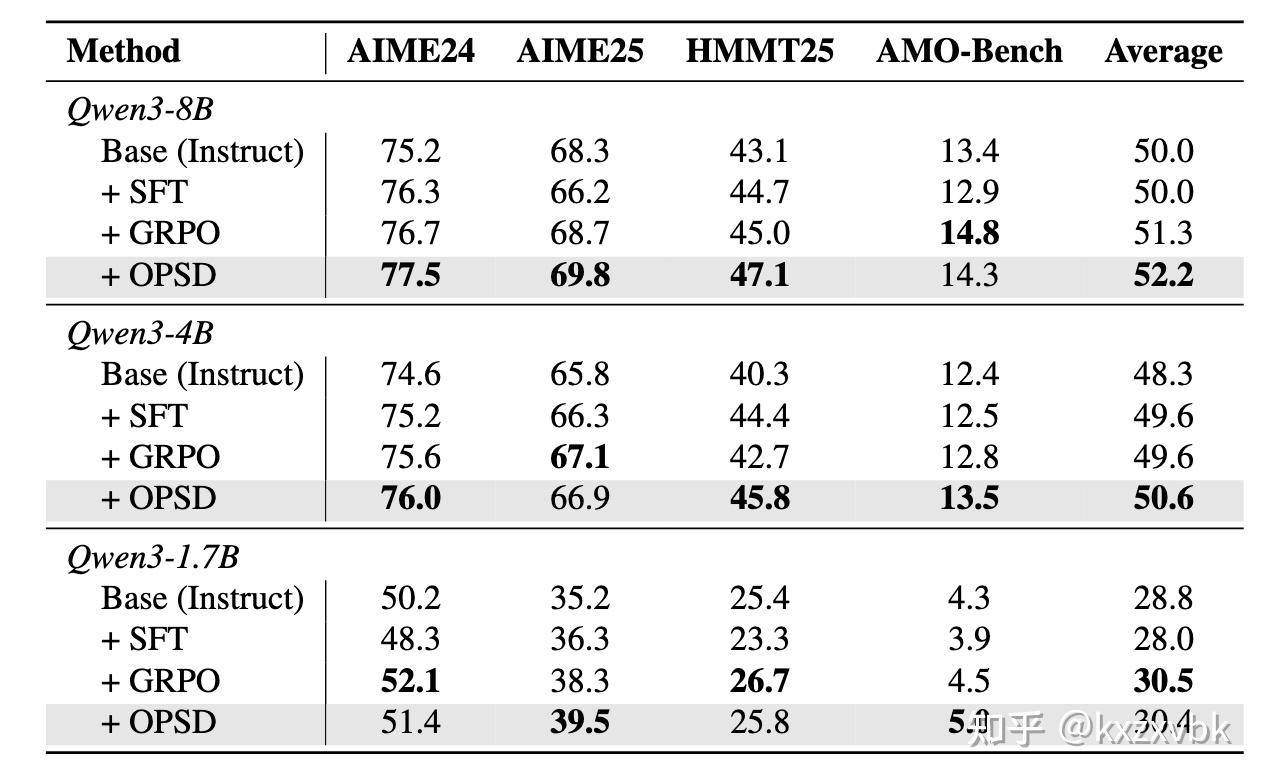
作者:kxzxvbk 原文:https://zhuanlan.zhihu.com/p/2000612721868177979 最近,越来越多 LLM 相关的工作提到了一个关键词 On-Policy Distillation (后文会简称为 OPD),这个方法迅速受到大家的广泛追捧和好评。 本文将从
作者:Haoning Wu https://www.zhihu.com/question/1999487395494588876/answer/2000362433332660070 Big Model Smell 作为一个在这个项目里拧了几个月螺丝的工程师,release 之后看到大家讨论,挺多感
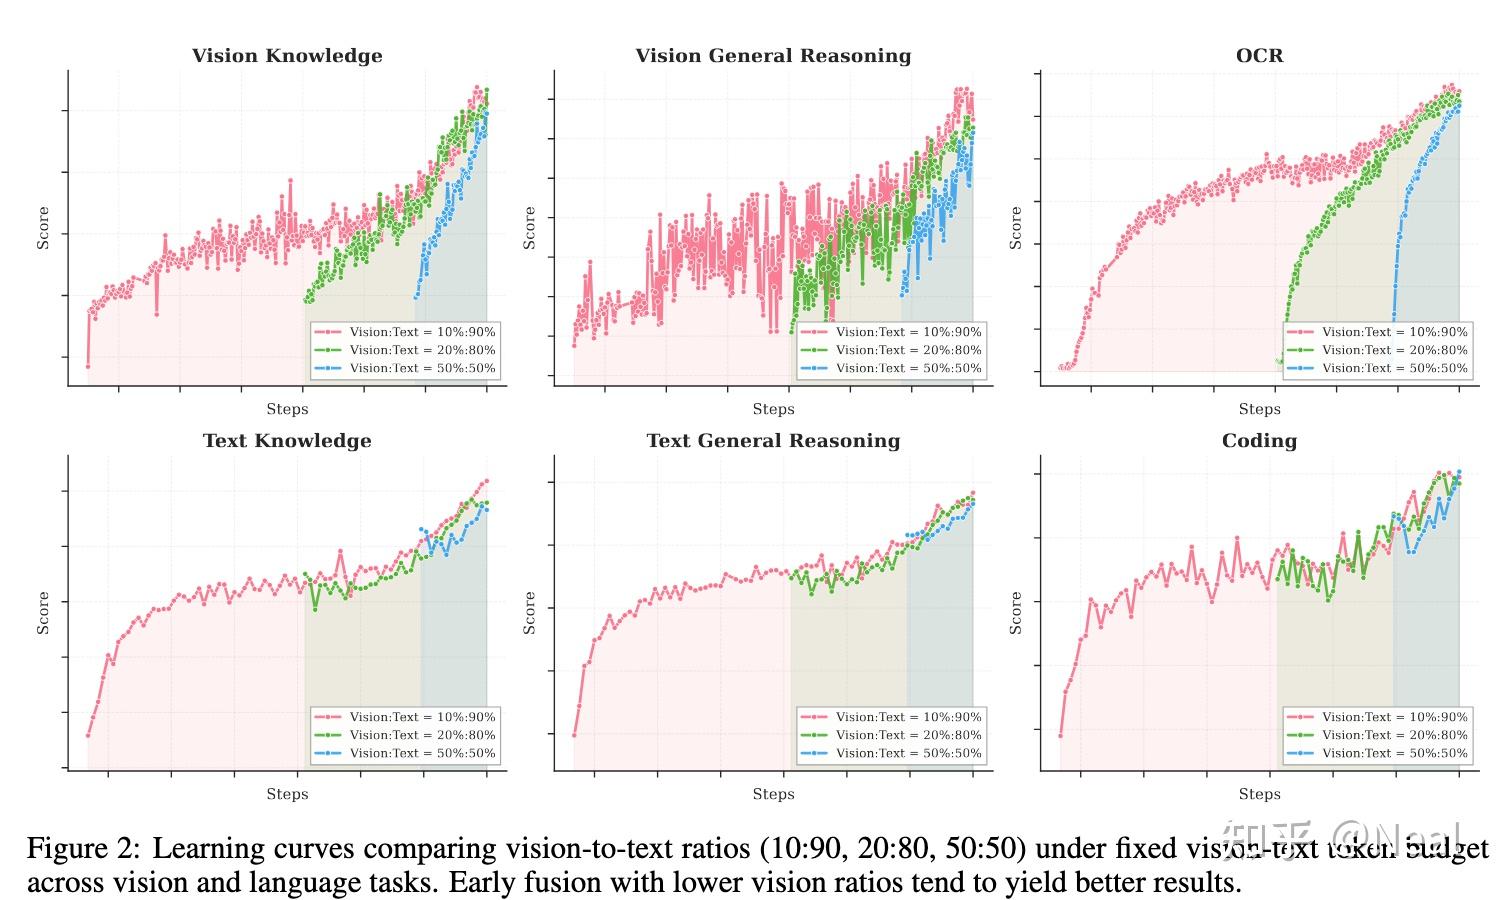
作者:Neal 链接:https://www.zhihu.com/question/1999487395494588876/answer/2000722695596299217 利益相关,在K2.5参与了Pretrain和部分Post-train的环节。本来想默默潜水,后面发现酒香也怕巷子深(还有很
作者:ybq https://zhuanlan.zhihu.com/p/1995265459285694156 LLM 论文千千万,有用的工作却没几篇。这篇文章,我想简单讨论下到底该如何把后训练工作做的 solid。文章并没什么技术细节,大家随便看看。 敲定正确的 Baseline 有太多论文工作不
作者:王小惟 Weixun https://zhuanlan.zhihu.com/p/1993017628877426830 大模型领域的发展,让我对时间的流速有了截然不同的认知。一方面,由于一直在埋头推进诸多事项,从微观层面来看,痛苦总会让人觉得时间过得很慢。 另一方面,领域的快速发展、不断突破的
作者:钱泽中,西安交通大学少年班本科大三 原文:http://xhslink.com/o/4JTOFucqnmw 之前的相关工作 其实从最早期的一派以Q-learning为基础,以及更加倾向于offline RL的真机强化学习算法就可以展现出整个具身社区对RL这一块的态度了,也就是online RL