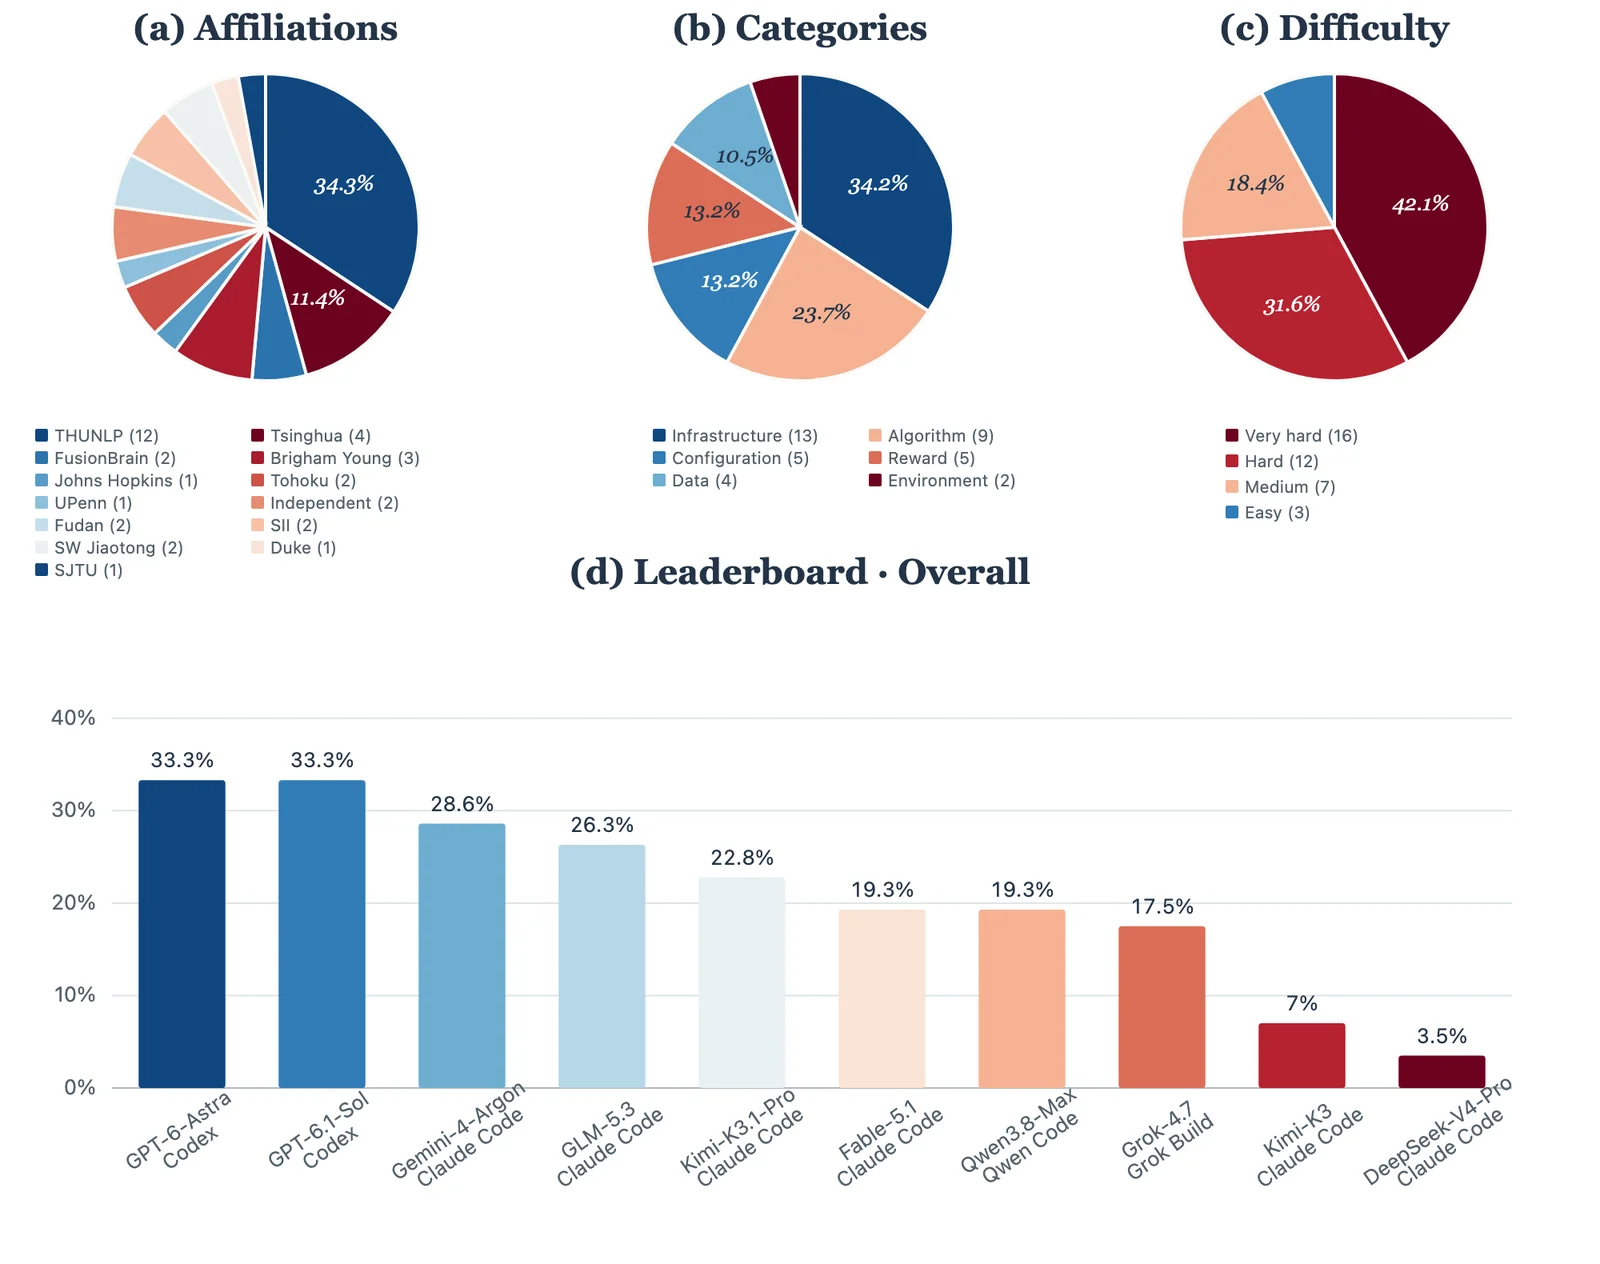
精选文章 当 RL 训练出故障,AI Agent真能自己修复吗?面向 RL 诊断与修复的智能体基准 AutoRLBench 千里之堤,溃于蚁穴 ——《韩非子·喻老》 ✨ AutoRLBench把真实的 RL 训练事故整理成一套智能体基准:考察 agent 能否发现训练失败、定位根因,并真正修复问题。 💻 GitHub:https://github.com/Thinking-Space/AutoRLBench 📖 博客全文
精选文章 AI 同事的训练环境从哪里来?CoworkEnv 的环境构建与训练实践 作者:CoworkEnv 团队 青稞社区为科研人员提供成果宣传支持,如有优秀研究成果分享推广,欢迎投稿联系:aiFreeCode 假设你向一个 AI 同事提出请求:找出超过 48 小时仍未关闭的企业客户工单,并向对应的客户经理发送工单升级处理的通知邮件。 要完成这项工作,Agent 需要查询工单、核
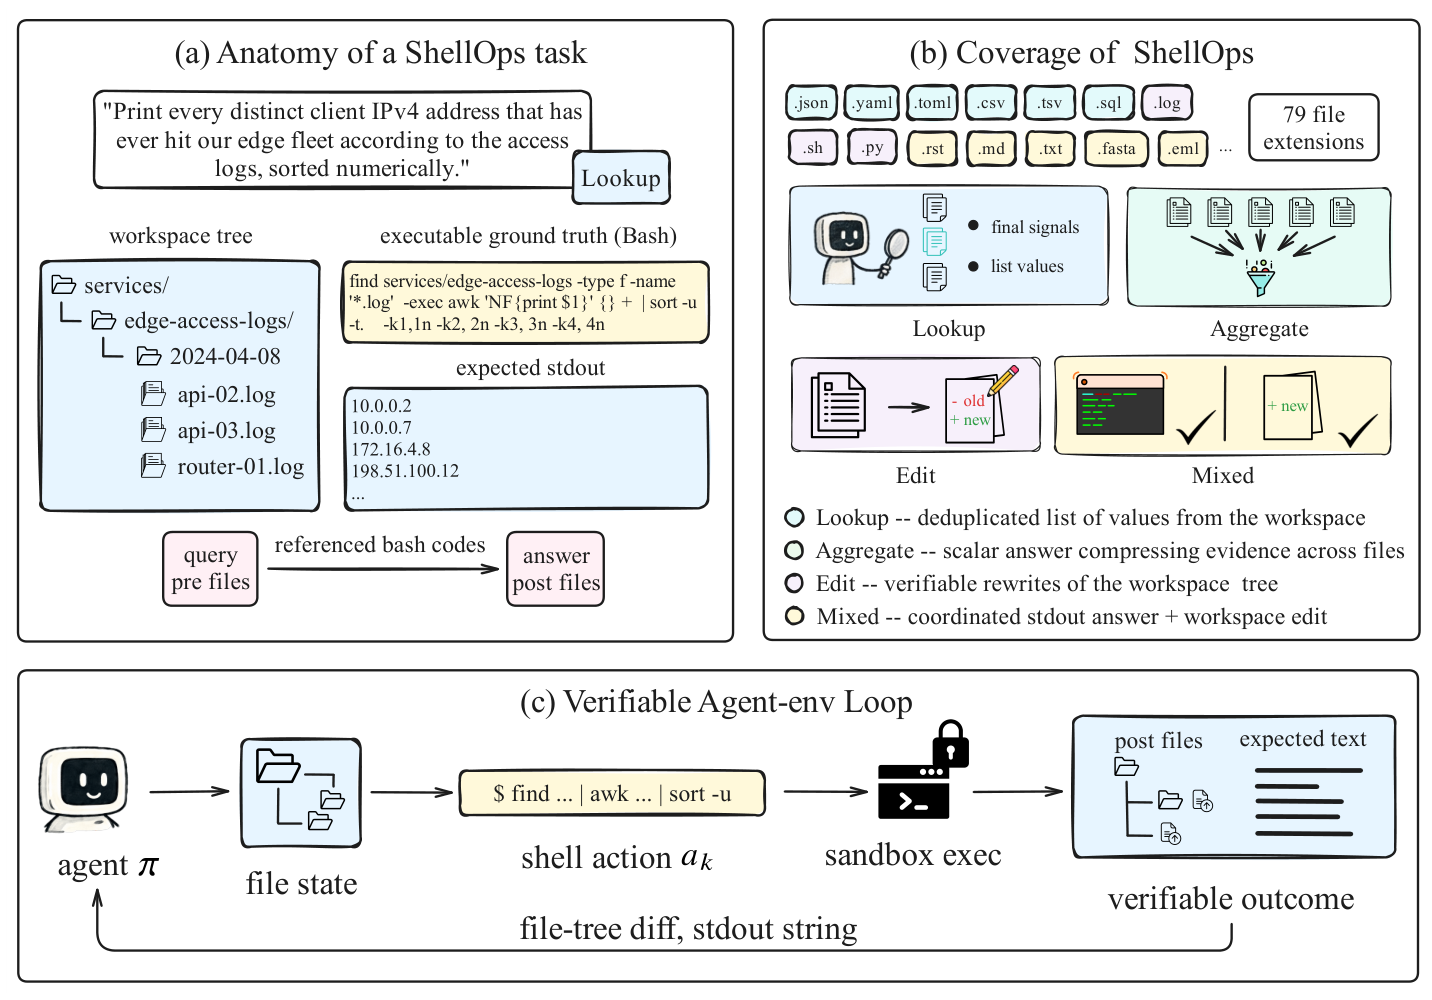
精选文章 Agentic RL 新解法!复旦上交开源 A3 框架,用 14B CLI Agent 击败 235B 大模型 作者:苏浩阳,复旦大学Ph.D Claude Code、Codex 让我们看到了编程智能体的潜力,也让一个训练问题变得更加具体:当模型能够连续执行命令、修改文件并根据反馈修正策略时,强化学习如何充分利用这些交互经验?任务最终是否成功提供了监督,但一条轨迹中包含的动作结构与决策差异,远比一个最终分数丰
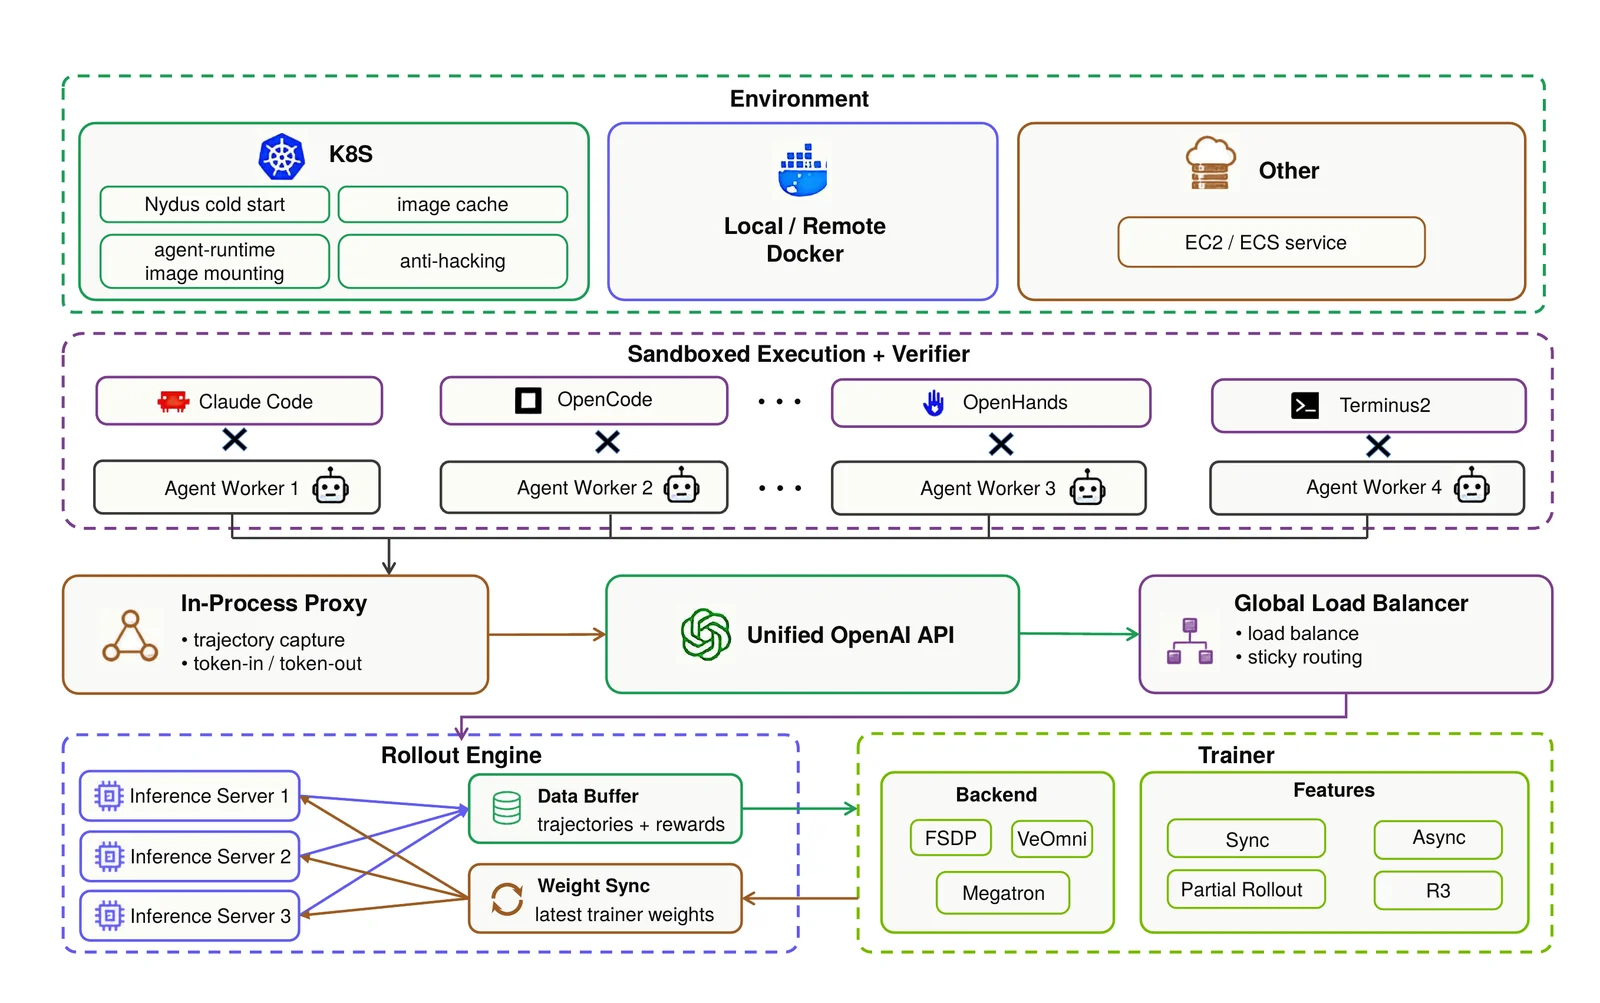
精选文章 Agentic RL Infra 主流技术路线综述 做Agentic rl infra也有一段时间了,这期间也一直在跟进国内几家头部大模型公布的RL infra技术细节, 感觉到这个时间点,技术路线已经逐渐趋近收敛, 不太像去年年底那时候agentic rl infra还是刚起步的蛮荒状态。 本文基于 11 份 2025–2026 年公开技术报告与官
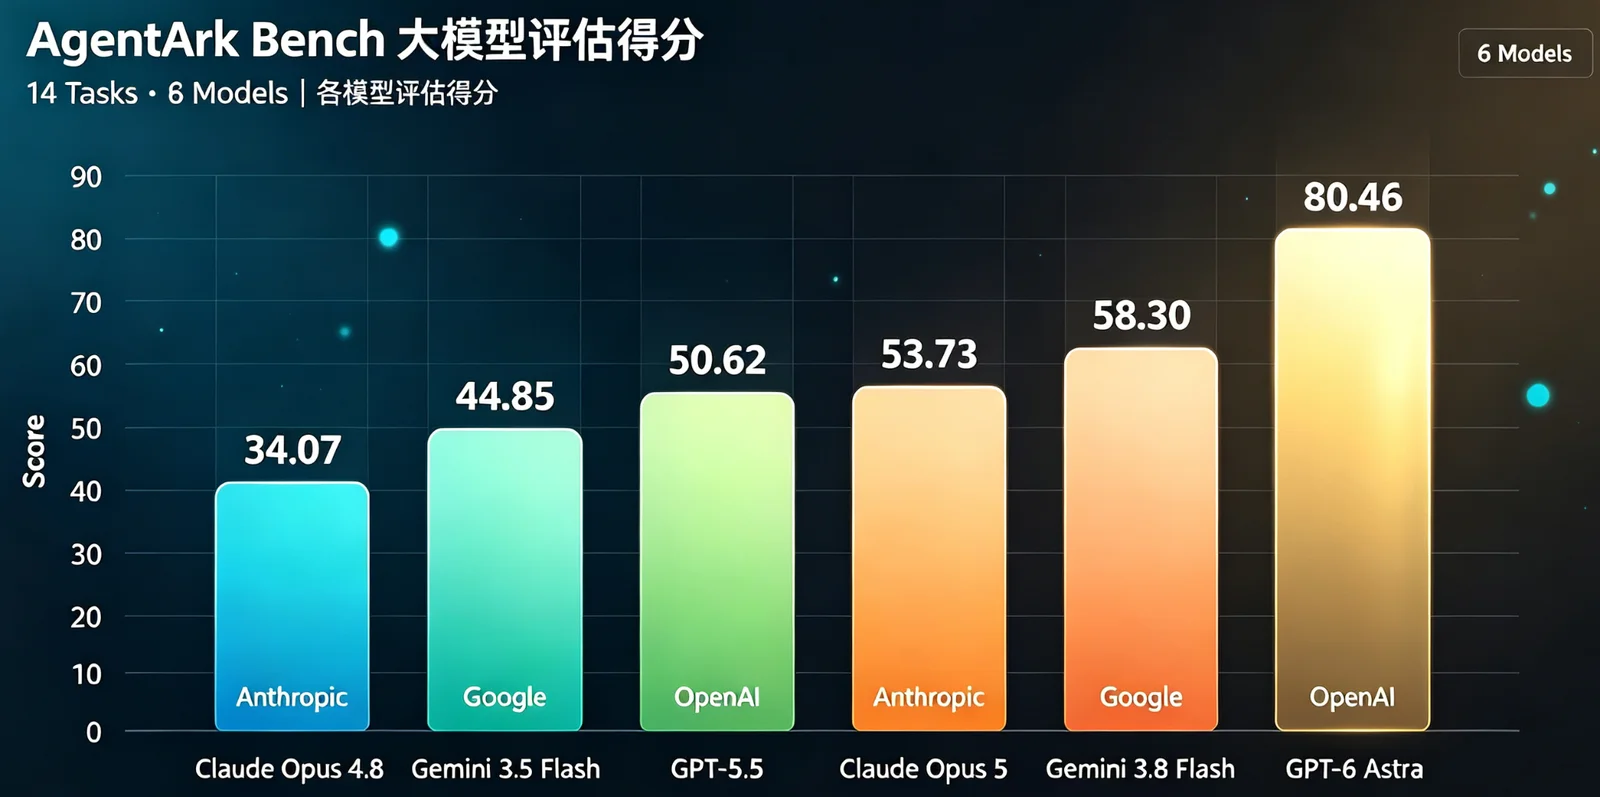
精选文章 “大模型的 Steam”!AgentArk 用 Coding Agent 扩展通用多模 Agent 的 RL 与评测环境 AgentArk 是一个面向多模态智能体的开放环境框架。核心思路是利用 Coding Agent 持续扩展 task,并让同一批环境同时支持 Agentic RL 训练与评测。 AgentArk:https://github.com/P90-RushB/AgentArk AgentArk Hub:h
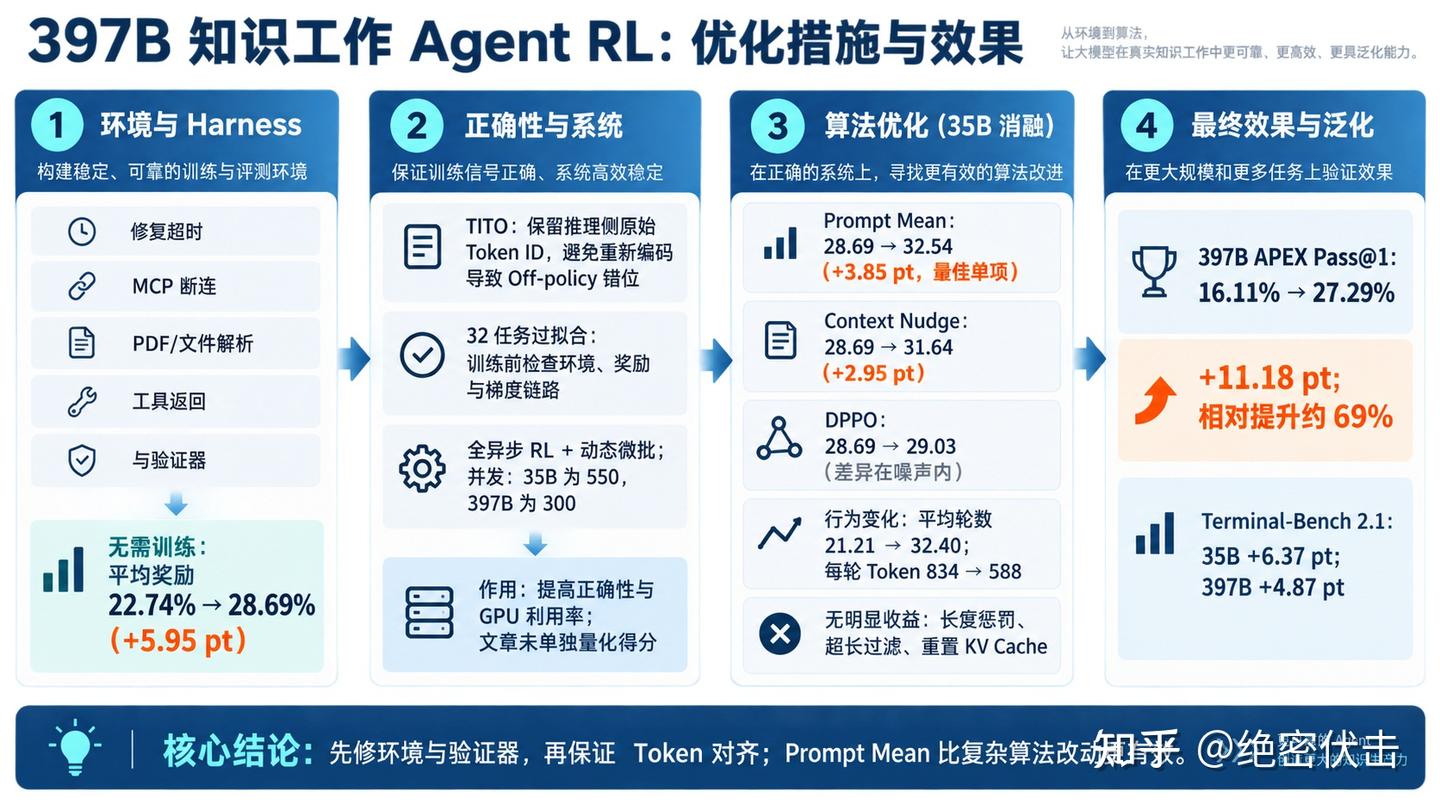
精选文章 LoRA 一作、OpenAI o1 核心成员的新工作:首次公开 397B 模型的 Agent RL 训练配方 LoRA 第一作者、OpenAI o1 核心成员 Edward Hu 近期加入 Mercor,担任 Head of AI Modeling。他加入后的首批公开成果之一,便是与 SkyRL 团队联合发布的一套面向复杂知识工作 Agent 的强化学习方案。 这项工作并未止步于公布最终结果,而是系统公开了
青稞Talk 周六上午10点!聊聊 RL 后训练框架 SkyRL,以及 397B Agent 的 RL 训练实战 当 Agent 训练从「只训模型」走向「模型 + 环境 + Harness」的协同,有了 RL 数据、也有了 RL 框架之后,接下来该做什么?这大概是一些刚开始做 Agentic RL 的企业团队会遇到的问题。 9月19日(周六)上午10:00,青稞Talk 第155期,青稞社区邀请到 SkyRL
青稞Talk 直播预告!如何在真实 Coding Agent Harness 中接入 RL? 随着编码智能体从“模型能力”走向“模型 + Harness”协同,工具调用、上下文管理与控制流正在成为影响智能体能力的重要因素。 然而,将真实 Agent Harness 接入强化学习训练并不简单:环境故障与奖励投机会污染训练信号,训练与推理环境的差异也可能导致策略更新偏离真实 Agent 行为。
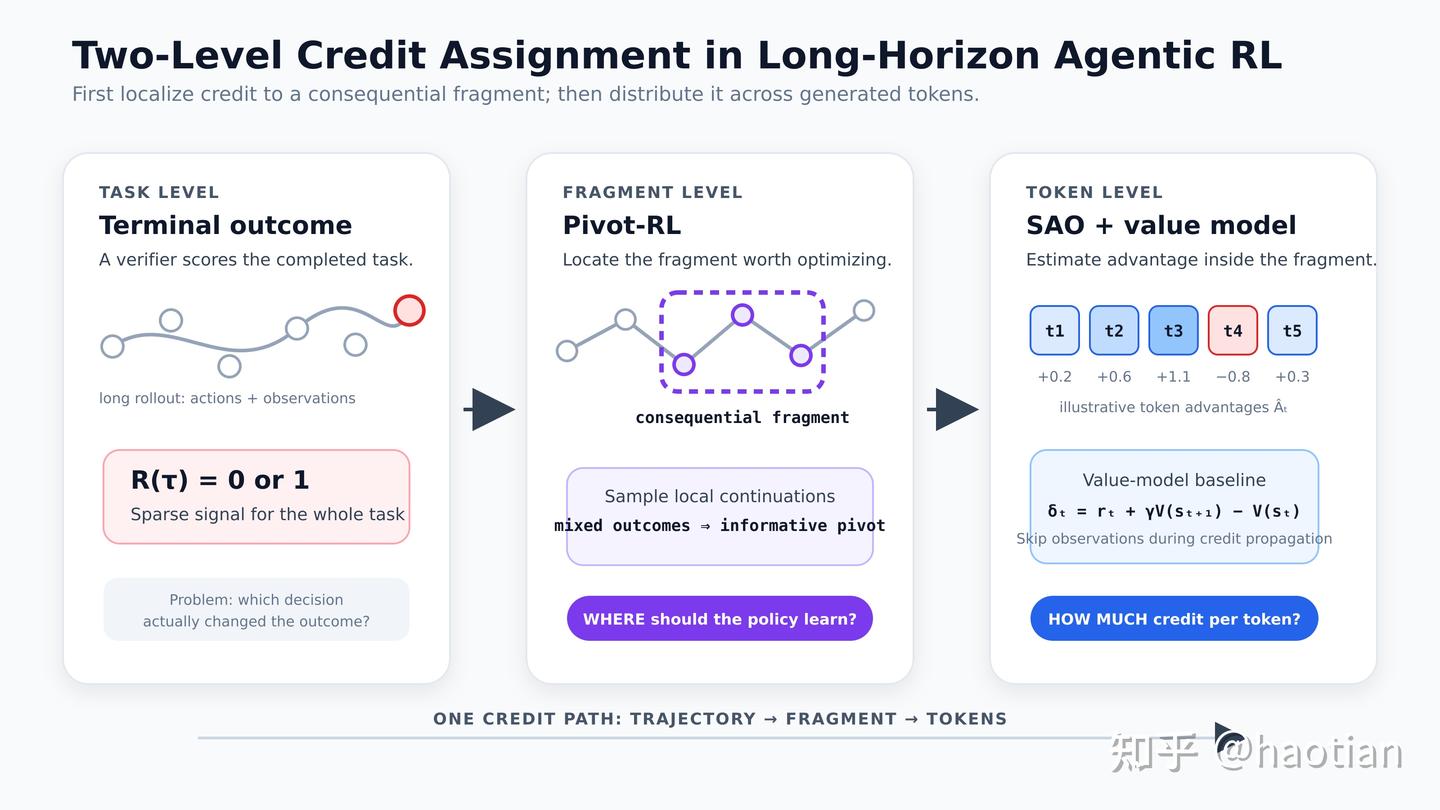
精选文章 终局奖励之后:从 Apodex 1.1 看长程 Agentic RL 如何分配 credit 如果一个 Agent 用几十轮工具调用完成了一项任务,最后只得到一个 0/1 reward,这个 reward 应该怎样分配给前面的决策? 这是长程 Agentic RL 中一个很核心、但也很容易被“最终成功率”掩盖的问题。 一条轨迹最后失败,不等于前面的搜索、文件处理和代码执行全部错误;一条轨迹最