
当 Agent 训练从「只训模型」走向「模型 + 环境 + Harness」的协同,有了 RL 数据、也有了 RL 框架之后,接下来该做什么?这大概是一些刚开始做 Agentic RL 的企业团队会遇到的问题。
9月19日(周六)上午10:00,青稞Talk 第155期,青稞社区邀请到 SkyRL 团队、加州大学伯克利分校 Sky Computing Lab 博士生阮世麟,和大家分享模块化 RL 后训练框架 SkyRL,以及 397B Office Work Agent 的 RL 训练实战经验。
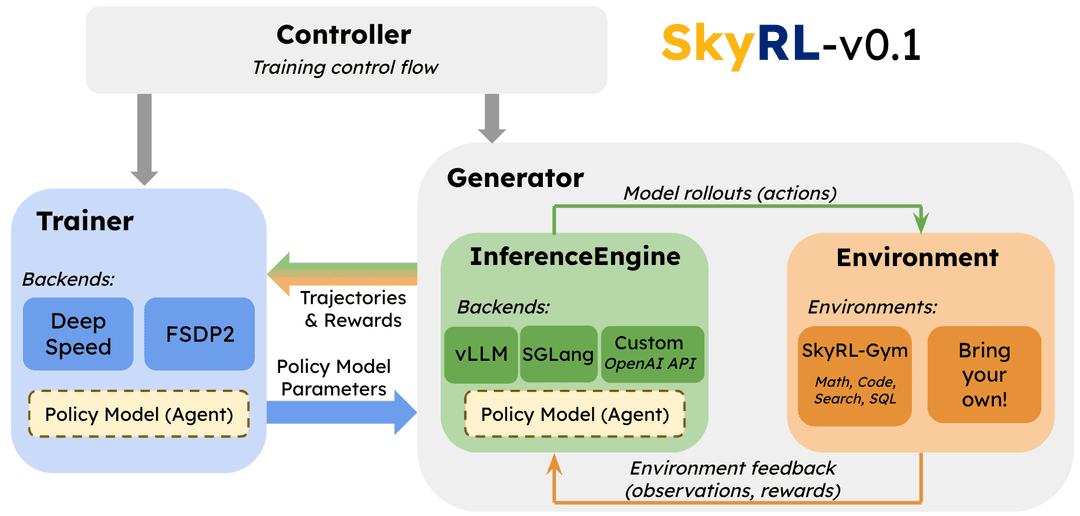
本期 Talk 分两部分:前半部分介绍开源 RL 后训练框架 SkyRL 的设计——原生异步 RL、基于 Megatron 的 5D 并行与大规模 MoE 训练,以及兼容 Tinker API 的多 LoRA 训练。
SkyRL 文档:https://docs.skyrl.ai/docs/tinker/overview
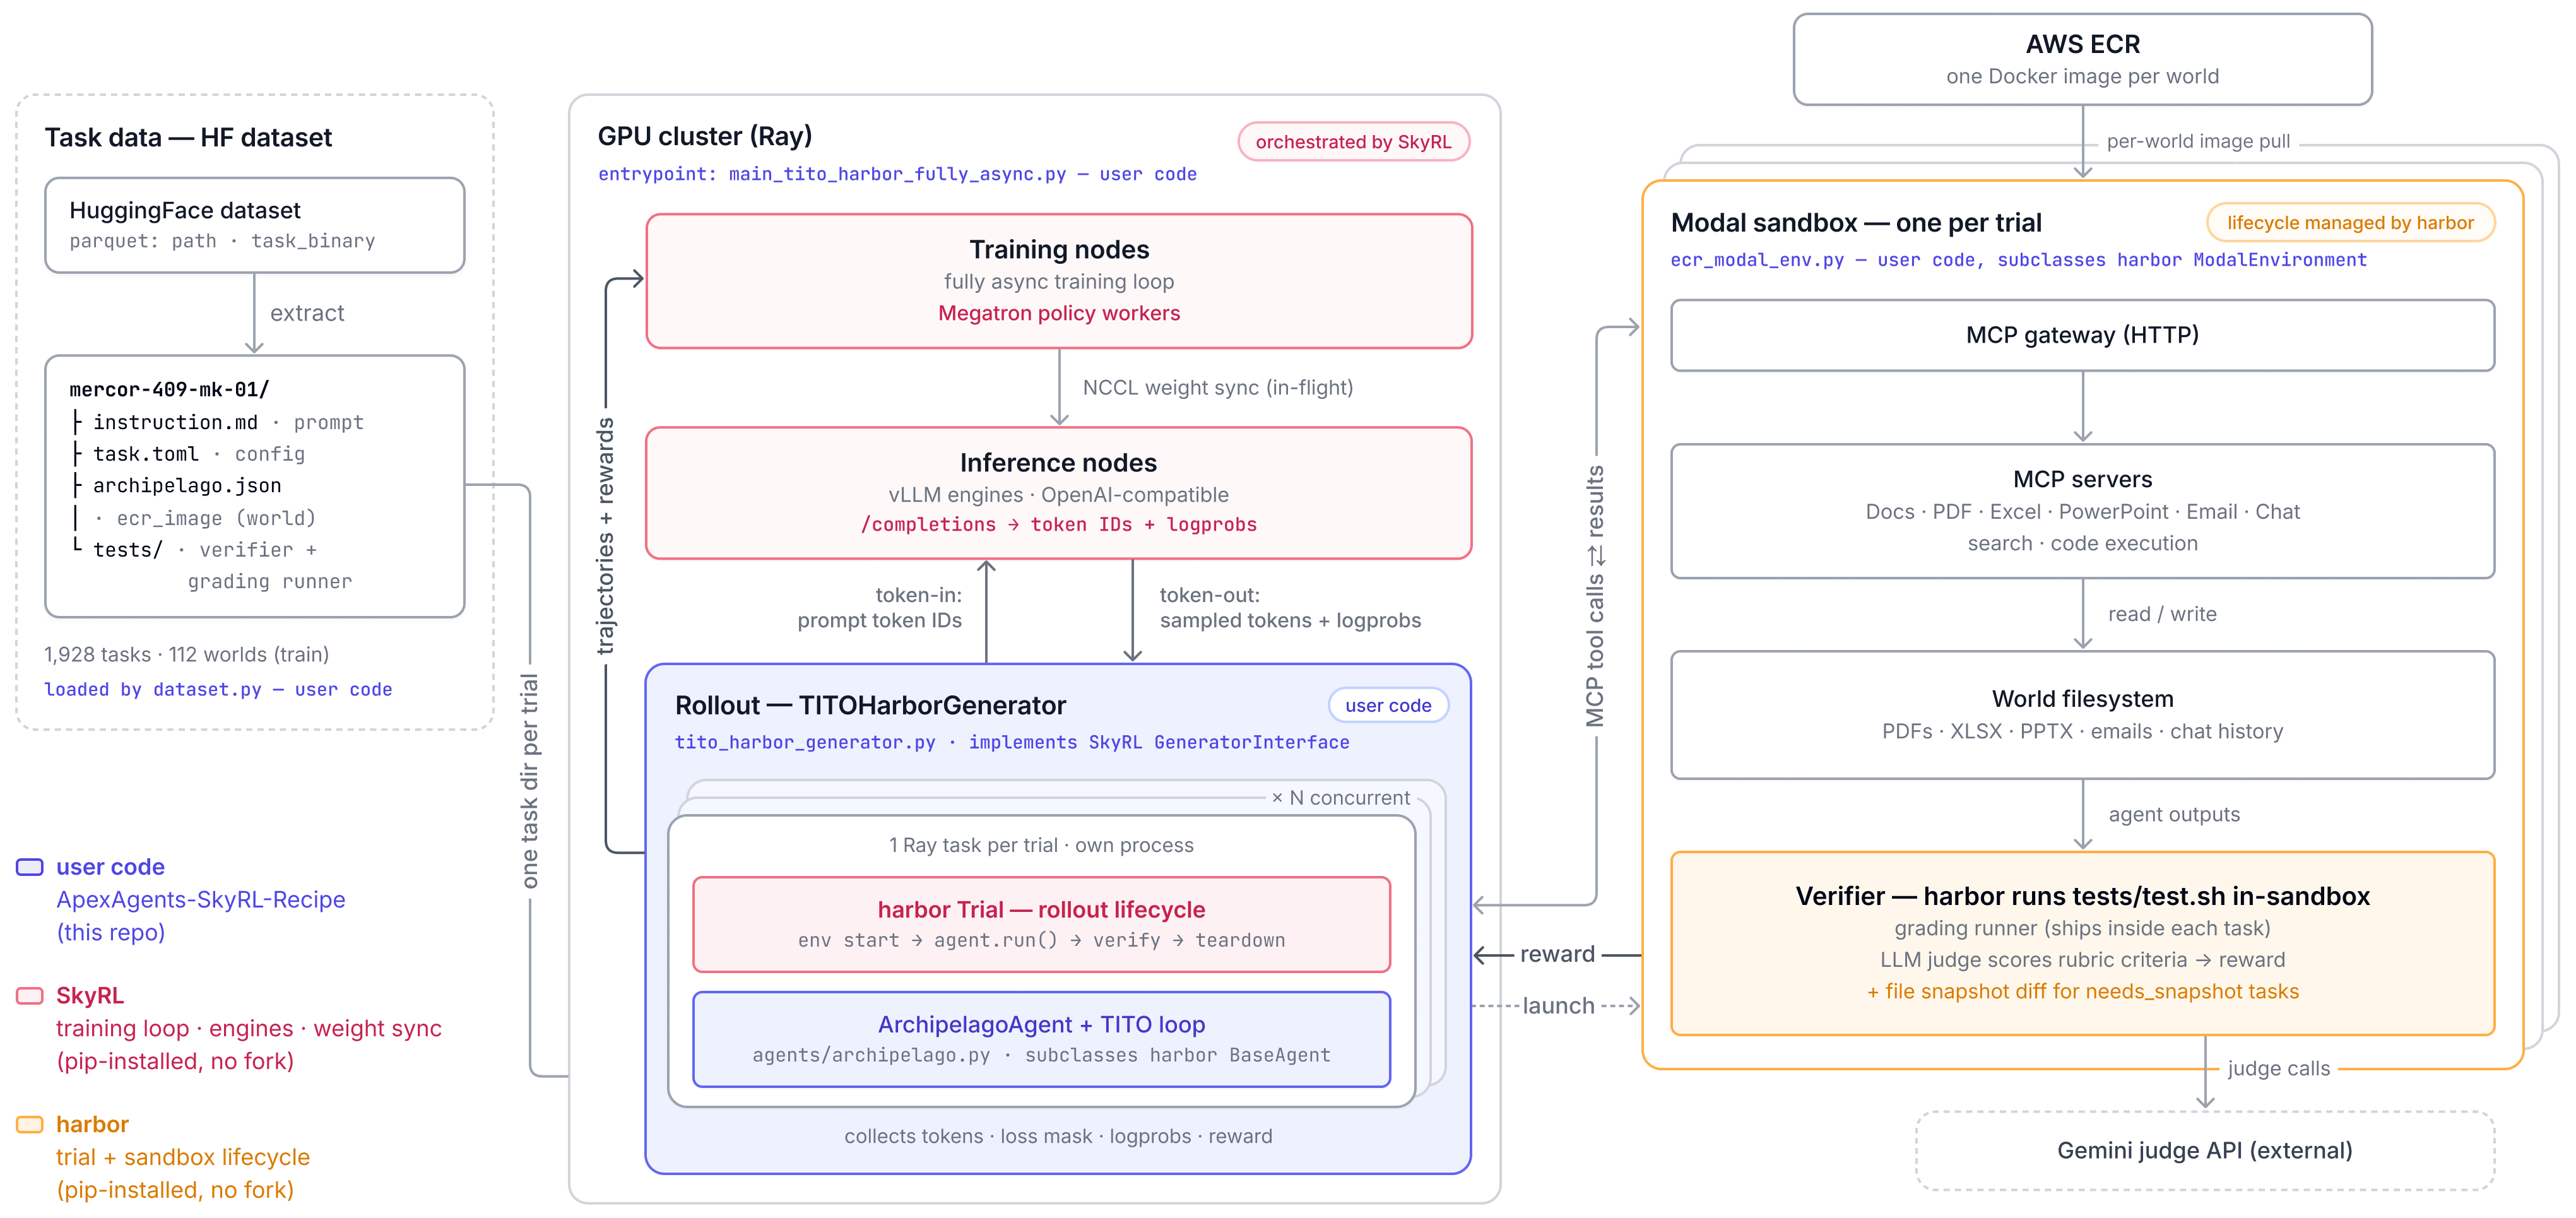
后半部分是一份写给这类团队的实战手册:以 Mercor × SkyRL 在 APEX-Agents(管理咨询、投行、公司法等真实办公任务)上的 397B 训练为例,分享我们从「拿到数据」到「指标真正开始爬坡」之间的一些经。
以及为什么这些步骤最好严格按顺序来排查——先把环境错误率打到接近零、修掉那些模型会学坏的 Harness bug、做到精确的 TITO token 记账,然后才是 RL 系统调优、过拟合验证、小模型消融,最后是大模型 Hero Run 与泛化评估。
训练实战(Mercor):https://www.mercor.com/blog/training-frontier-knowledge-work-agents-a-397b-rl-training-guide-with-skyrl/
配方代码:https://github.com/Mercor-Intelligence/ApexAgents-SkyRL-Recipe
青稞介绍
阮世麟 Charlie Ruan,加州大学伯克利分校 Sky Computing Lab 二年级博士生,师从 Ion Stoica 教授,共同主导开源强化学习后训练框架 SkyRL 的开发;同时在 Mercor 从事 RL 后训练基础设施与企业级训练方案的研究。在伯克利之前,他于卡内基梅隆大学获得硕士学位,与陈天奇教授合作,主导了浏览器端大模型推理引擎 WebLLM,并是基于编译的通用大模型推理引擎 MLC-LLM 的核心贡献者。
主题提纲
SkyRL:模块化 RL 后训练框架设计,与 397B Office Work Agent 的 RL 训练实战
1、模型 + 环境 + Harness 协同下,Agent 训练流程与难点
2、开源 RL 后训练框架 SkyRL 的设计
3、397B Agent 训练经验与 RL 系统调优实践
4、大模型 Hero Run 与泛化评估
5、SkyRL 与 Agentic RL 的下一步
6、AMA(Ask Me Anything)环节
直播时间
9月19日(周六)10:00 - 11:00