精选文章 从PD分离到AF分离!聊聊 LLM 推理架构演进中的几个关键技术节点 作者: ZxZhao,复旦大学集成电路与系统设计博士 https://zhuanlan.zhihu.com/p/1988221694591128167 大模型部署技术的演进太快了,相信有很多朋友两三年没有关注这个领域,对相关的名词已经是一头雾水了。这篇文章以杂谈的形式,和大家聊聊这里的几个关键技术节
精选文章 DeepInfer 后,开源社区推理框架何去何从? 作者:刘景初 原文:https://zhuanlan.zhihu.com/p/2098528942038823244 10 月 20 日,DeepSeek 开源了线上服务用的推理框架 DeepInfer,它的技术设计我在《技术设计解读》里分析过。不出意料,其他开源推理框架快速跟进。之后一周,vLLM
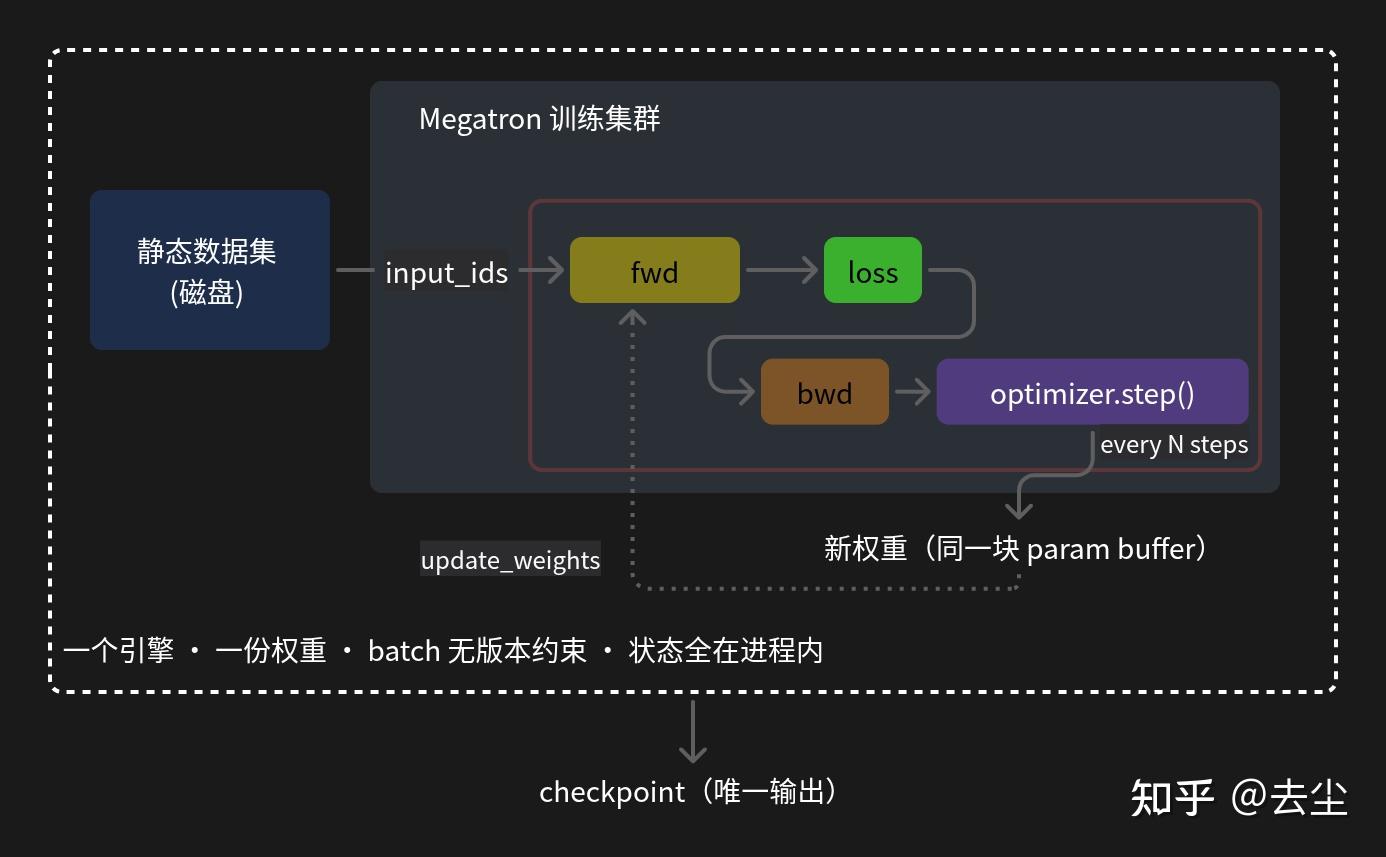
精选文章 从 SFT 到 RL:Infra 复杂度的三次跃迁 写在前面 写这篇文章是一次极其耗费心力的长途跋涉。发出了希望能和大家一起交流。 但受限作者个人的认知边界,书中内容难免存在疏漏、偏颇甚至错误之处。技术的探讨在于碰撞与纠错,若各位朋友在阅读时发现笔误、或者是作者思路狭窄未能理解核心奥义,非常欢迎指正交流。 作者:去尘 https://zhuanlan
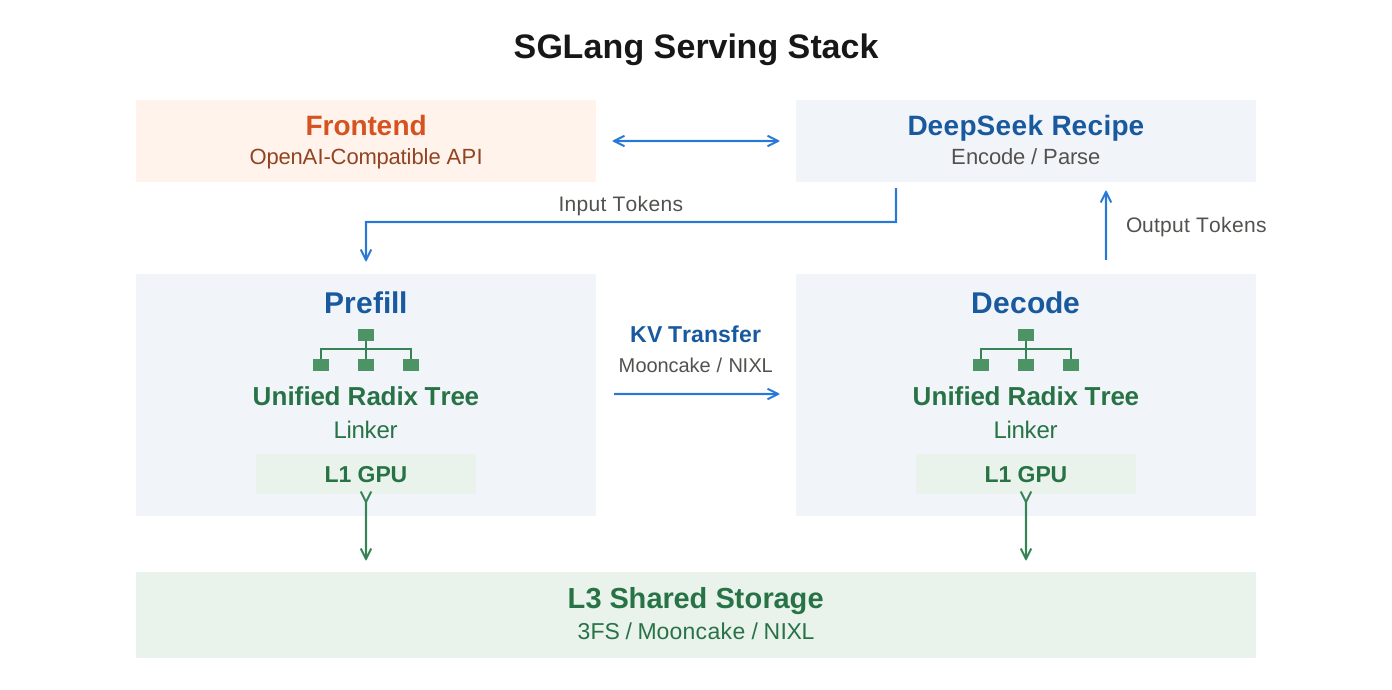
精选文章 DeepInfer 的优化,SGLang 也有了:4 卡打平,64 卡 decode 最高快 7.4% 作者:The SGLang Team 原文:https://www.lmsys.org/blog/2026-10-24-dsv41-deepinfer 摘要 在 DeepInfer 自己的基准上打平或领先 4x GB300 和 4x B300 上,prefill 吞吐最高到 1.04 倍;64x G
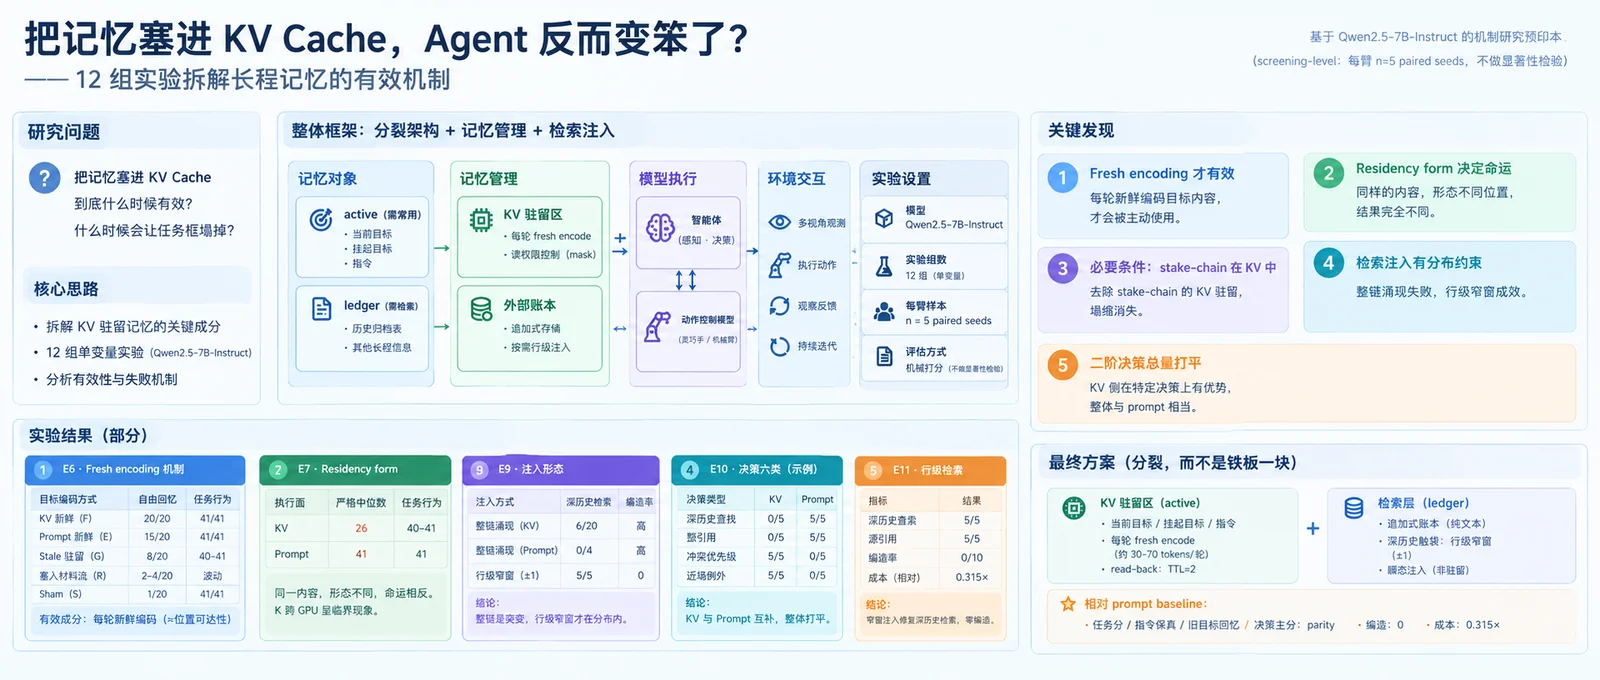
精选文章 把记忆塞进 KV Cache,Agent 反而变笨了?KV 驻留内存,到底靠什么在干活! 一篇机制拆解笔记。基于 Qwen2.5-7B-Instruct 上的十二次变量分解实验(screening-level:每臂 n=5 paired seeds,不做显著性检验)。 读完应能回答:为什么「把记忆塞进 KV cache」有时好使、有时会把任务框整个塌掉。 做长程 Agent 时,大家都绕
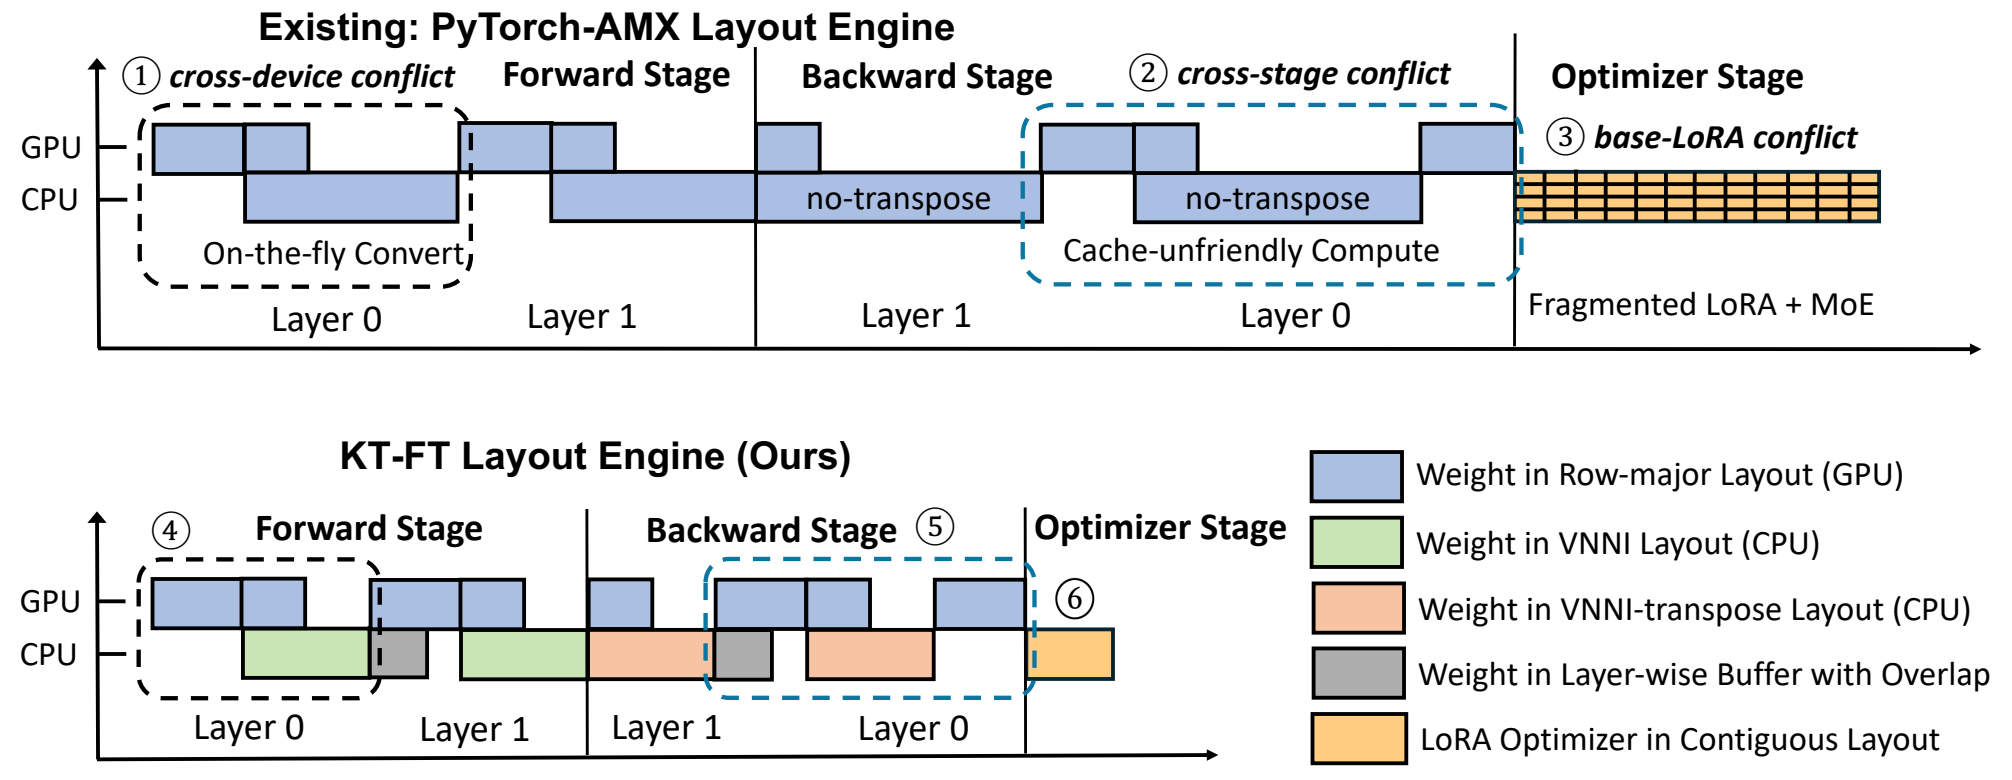
精选文章 别再让计算等着搬权重了!KTransformers 让 CPU 直接参与 MoE 微调计算 从 DeepSeek-V4 到 Qwen-3.8、Kimi-K3、GLM-5.3,每⼀次超⼤模型的开源都带来性能上的巨⼤跃升。 然⽽,随着模型规模越来越大,多数研究者与开发者只能尝试调用 API,无法在资源受限条件下进行微调,这进一步限制了大家探索前沿模型的特性,也难以把他们适配到自己的业务任务中。
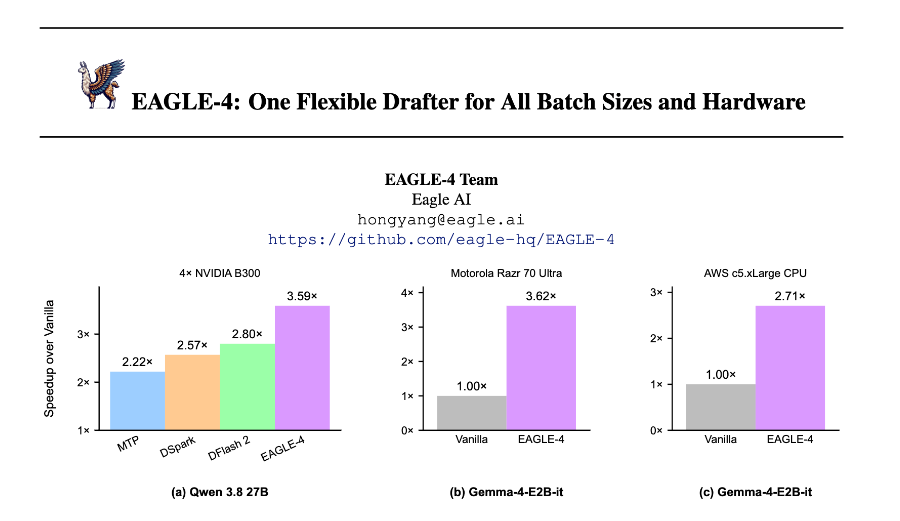
精选文章 前 EAGLE Team 成员自述 EAGLE-4 的设计,以及背后的工程取舍! 昨天,EAGLE-4 发布了,作为前 EAGLE Team 成员,想结合技术报告,聊聊它的设计,以及我参与研发时的一些实验和取舍。 作者:给你你的 https://zhuanlan.zhihu.com/p/2096797064151701313 先简单介绍一下背景:我在 2025 年 8 月至 20
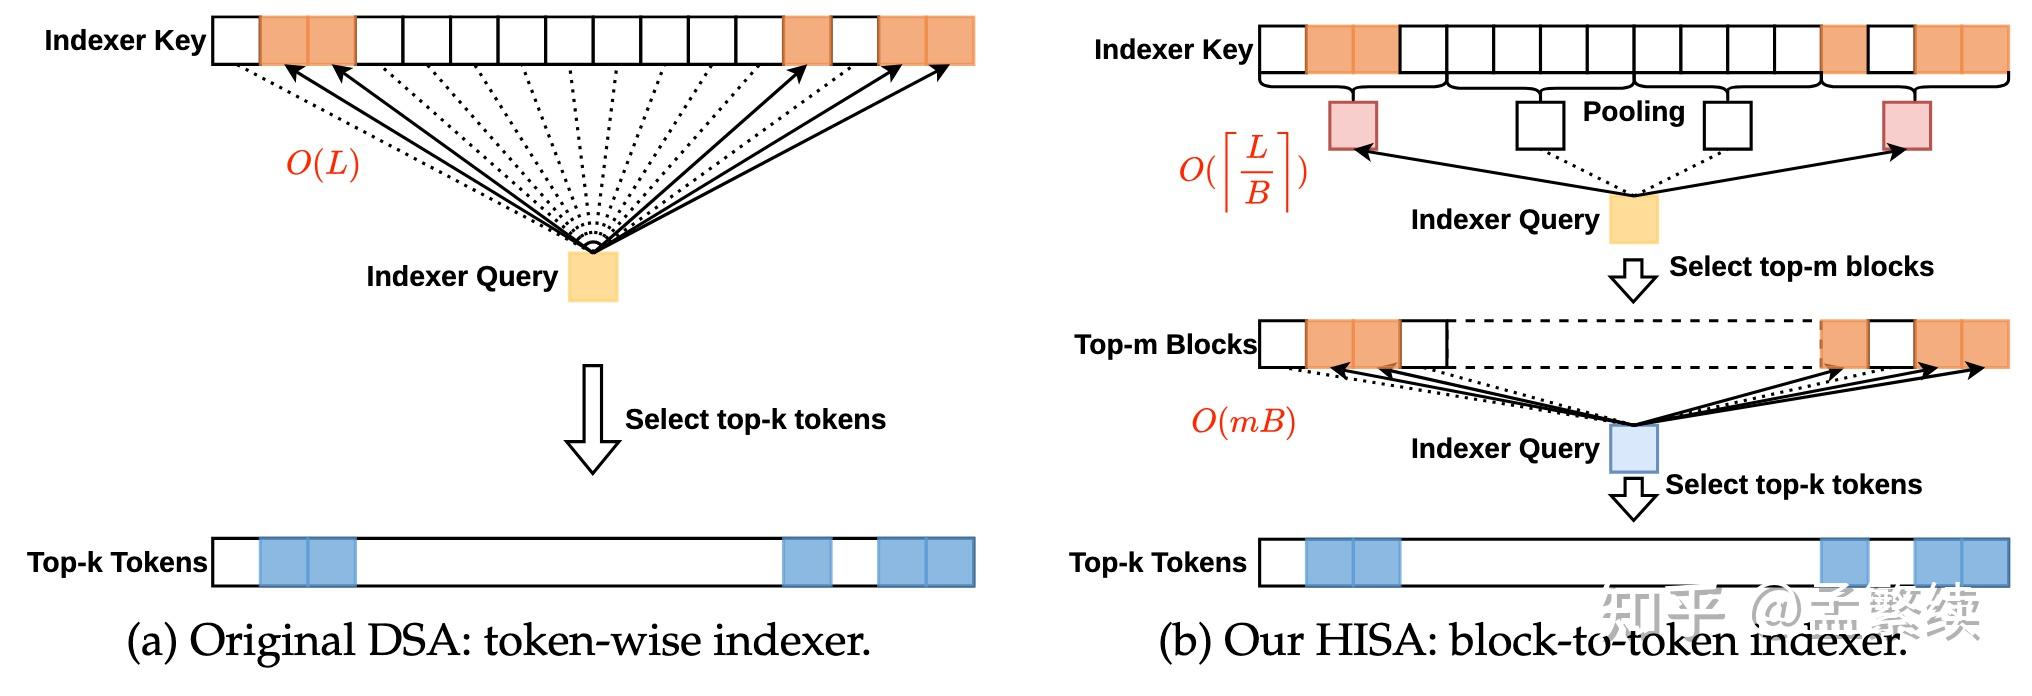
精选文章 字节最新论文意外“背刺”DeepSeek-V4?一文讲透 HISA 如何终结 CSA 的相位敏感性 碎碎念 DeepSeek-V4发布CSA的时候,我对比了一下HISA和CSA的异同,跟身边的同学说,CSA相比HISA确确实实的能减少KV Cache,但是效果会比HISA差一些。但是当时也没有想到如何很好的把这种优势通过实验给展示出来。 看到字节Seed团队最新发布的论文《Periodic Wea
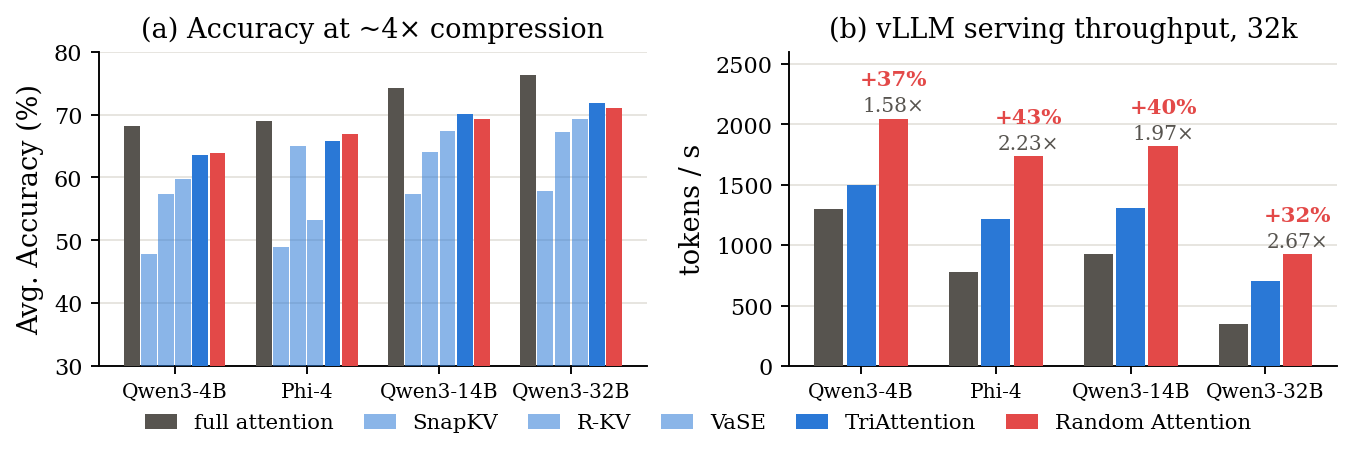
精选文章 不计算重要性分数,KV Cache 也能压得好?Salesforce AI × UIUC 提出 Random Attention 当推理模型需要连续生成几万 token 时,GPU 显存里保存的不只是输入问题,还有不断增长的中间推理历史。对于长链式推理(long-chain reasoning),KV Cache 往往成为限制并发和吞吐的重要瓶颈。 压缩 KV Cache 的常见做法是:先判断哪些历史位置最值得保留,再按照固定
精选文章 从 RoPE 到 NoPE:长上下文中的位置建模正在重新分工 作者:zqzzq,人大高瓴人工智能学院直博 TL;DR 一句话:RoPE 把位置先验直接写进架构;NoPE 把位置交给模型隐式学习。所以有一个趋势是把两者结合分工。 RoPE 好在哪:用绝对位置的旋转,得到只依赖相对距离的内积(”绝对进、相对出”)。 RoPE 坏在哪:注意力分数本质是一堆不同频率余
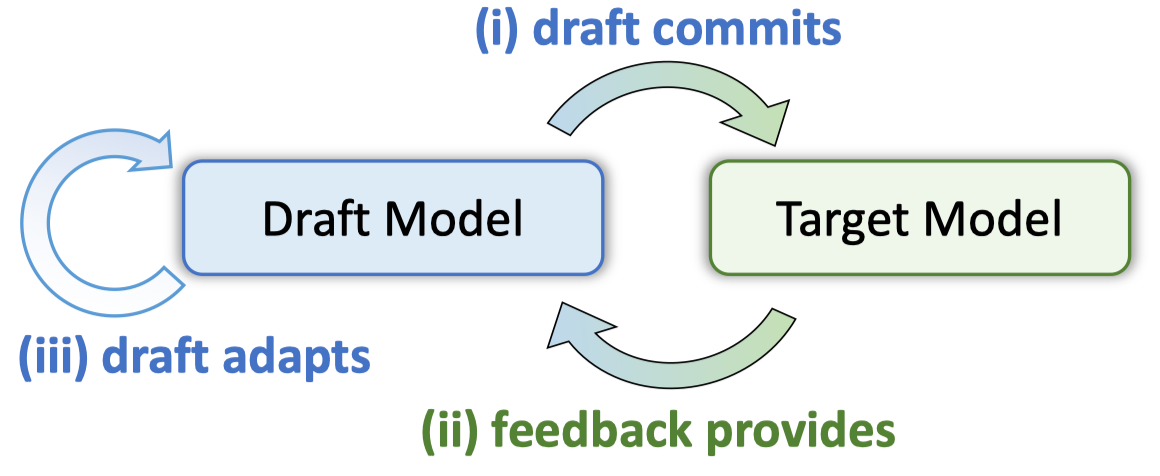
精选文章 大幅提升高并发下的推理速度!南京大学与华为基模团队提出 AdaFlash,让投机解码在线自我改进 AdaFlash 让投机解码在线自我改进,同时减少大模型无效工作,大幅提升高并发下的推理速度 DeepSeek 的 DSpark 让“投机解码推理加速”成为行业热点,尤其是在高并发的工业生产场景中。几乎同期时间,南京大学与华为基础模型团队共同提出的 AdaFlash,从扩散草稿模型的高方差出发,给出
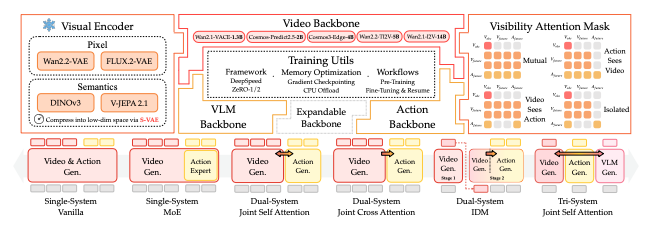
青稞Talk 直播预告!聊聊 OpenWAM ,面向世界–动作模型的开源研究全栈与基座模型 要让机器人真正“动手”,光有理解还不够:它既要看懂世界的物理与因果,还要把这些理解转化成可执行的动作。 但今天的世界–动作模型(World-Action Model,WAM)大多是“单体式”的:生成主干、视觉表示、网络架构、信息流、推理过程与训练数据全部耦合在一起,以至于研究者很难回答一个基本问题—
精选文章 乱谈 Kernel 之 Mega 向左,PDL向右 TLDR 刚入职就被老板抓来做megakernel,问及怎么做,曰:不知道,问及目标,曰:世界一流水平。 本文关注 GLM-5.2-FP8 在 decode 阶段执行完整 Indexer 的一个 Transformer layer,并优化这一层进入 Sparse FlashMLA 前的计算。 测量范
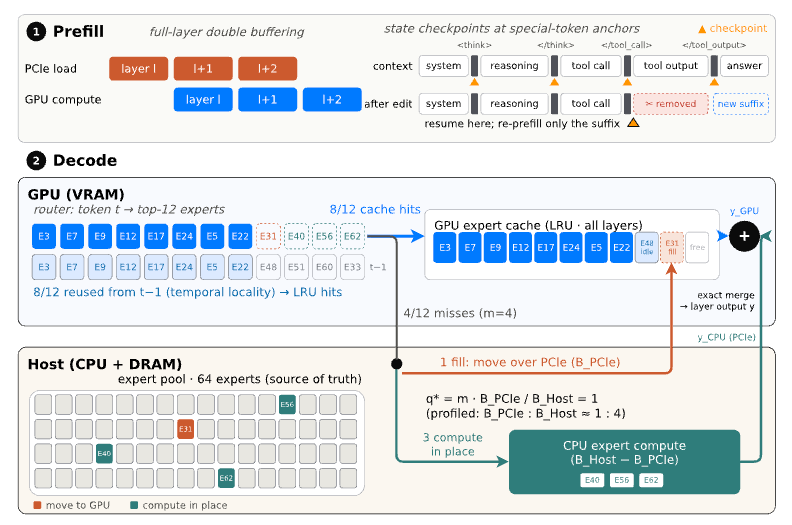
青稞Talk 直播预告!聊聊FreeToken:如何在 8GB 显存上跑起 35B 参数的 MoE 大模型 前沿开源权重模型正日益普及,但其部署服务目前仍主要依赖数据中心级别的基础设施。 来自 UC Berkeley、MIT 等团队推出了一种面向边缘设备原生设计的混合专家(MoE)推理服务系统: FreeToken,它不再将个人计算机简单视为一块小型 GPU,而是将其建模为一个统一、弹性可伸缩的推理平台。
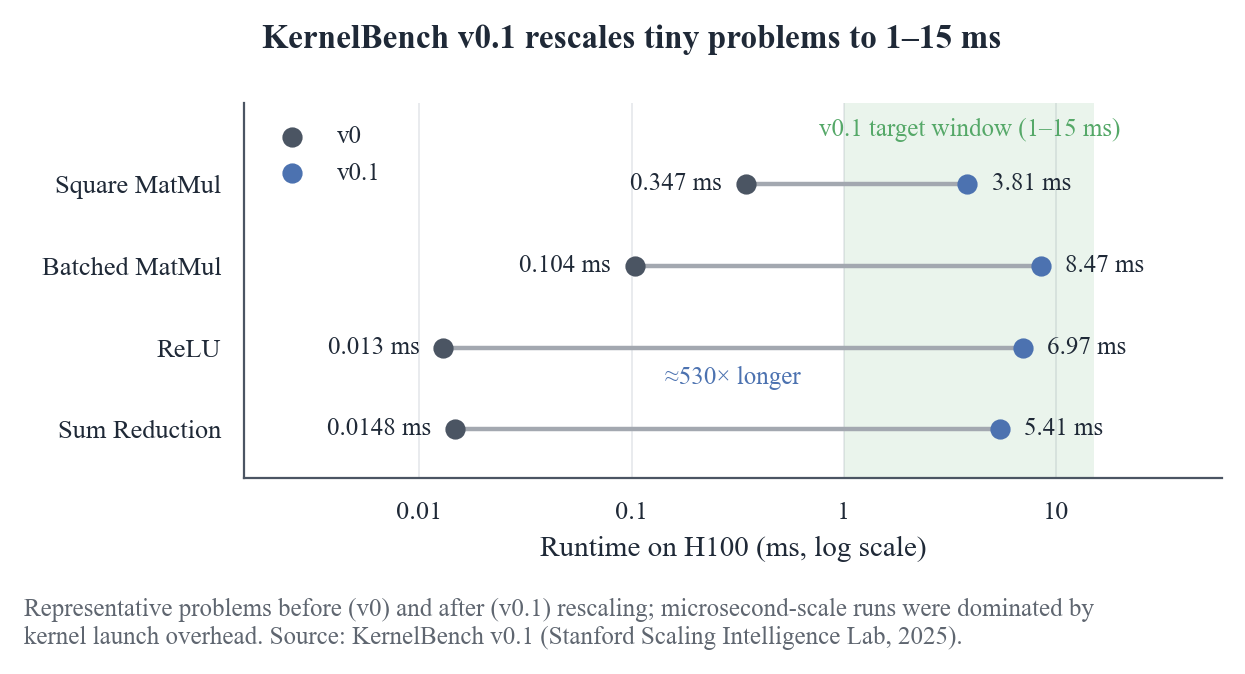
精选文章 两万字长文!2026 GPU Kernel Agent 最新进展:方法、基准与验证三者缺一不可 1. 前言 系统跑得快不快,很多时候不取决于纸面 FLOPS,而取决于真正落地的 kernel 质量。吞吐、效率和成本更多由 kernel 能否充分利用硬件决定,而不是硬件峰值本身 1。这在数据中心里是真金白银的差距:粗略估计,优化后的 kernel 每年在全球至少节省数亿美元 2。在每天数亿次调用
精选文章 大词表伤害小模型?深度解析 N-gram Embedding 与 Engram 架构 模型 核心做法 N-gram 地址映射 注入位置 Context-aware Gate 参数,比例 Over-Tokenized Transformer (OE) Hierarchical N-gram → Feature Hashing → sliced low-dim embeddings →
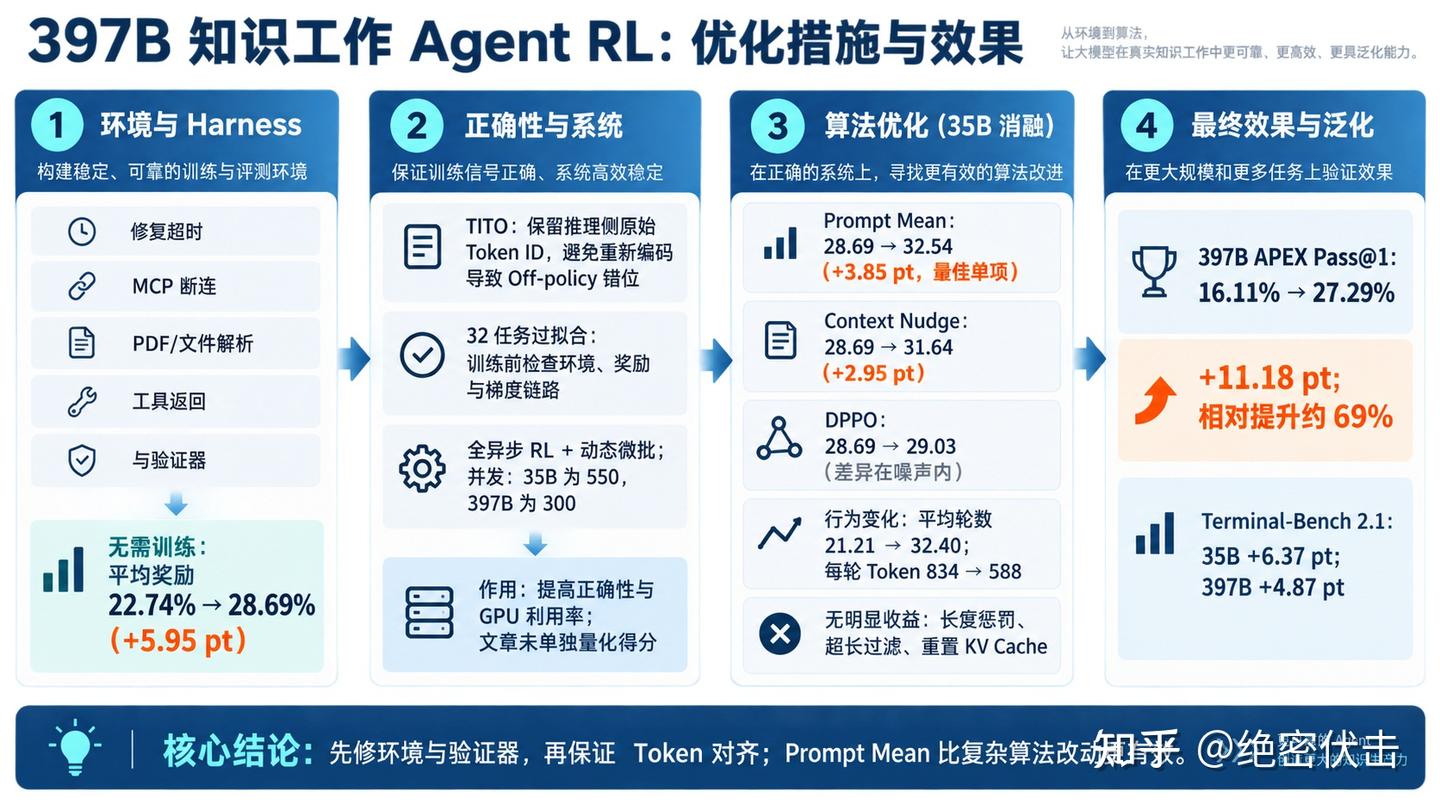
精选文章 LoRA 一作、OpenAI o1 核心成员的新工作:首次公开 397B 模型的 Agent RL 训练配方 LoRA 第一作者、OpenAI o1 核心成员 Edward Hu 近期加入 Mercor,担任 Head of AI Modeling。他加入后的首批公开成果之一,便是与 SkyRL 团队联合发布的一套面向复杂知识工作 Agent 的强化学习方案。 这项工作并未止步于公布最终结果,而是系统公开了
青稞Talk 周六上午10点!聊聊 RL 后训练框架 SkyRL,以及 397B Agent 的 RL 训练实战 当 Agent 训练从「只训模型」走向「模型 + 环境 + Harness」的协同,有了 RL 数据、也有了 RL 框架之后,接下来该做什么?这大概是一些刚开始做 Agentic RL 的企业团队会遇到的问题。 9月19日(周六)上午10:00,青稞Talk 第155期,青稞社区邀请到 SkyRL
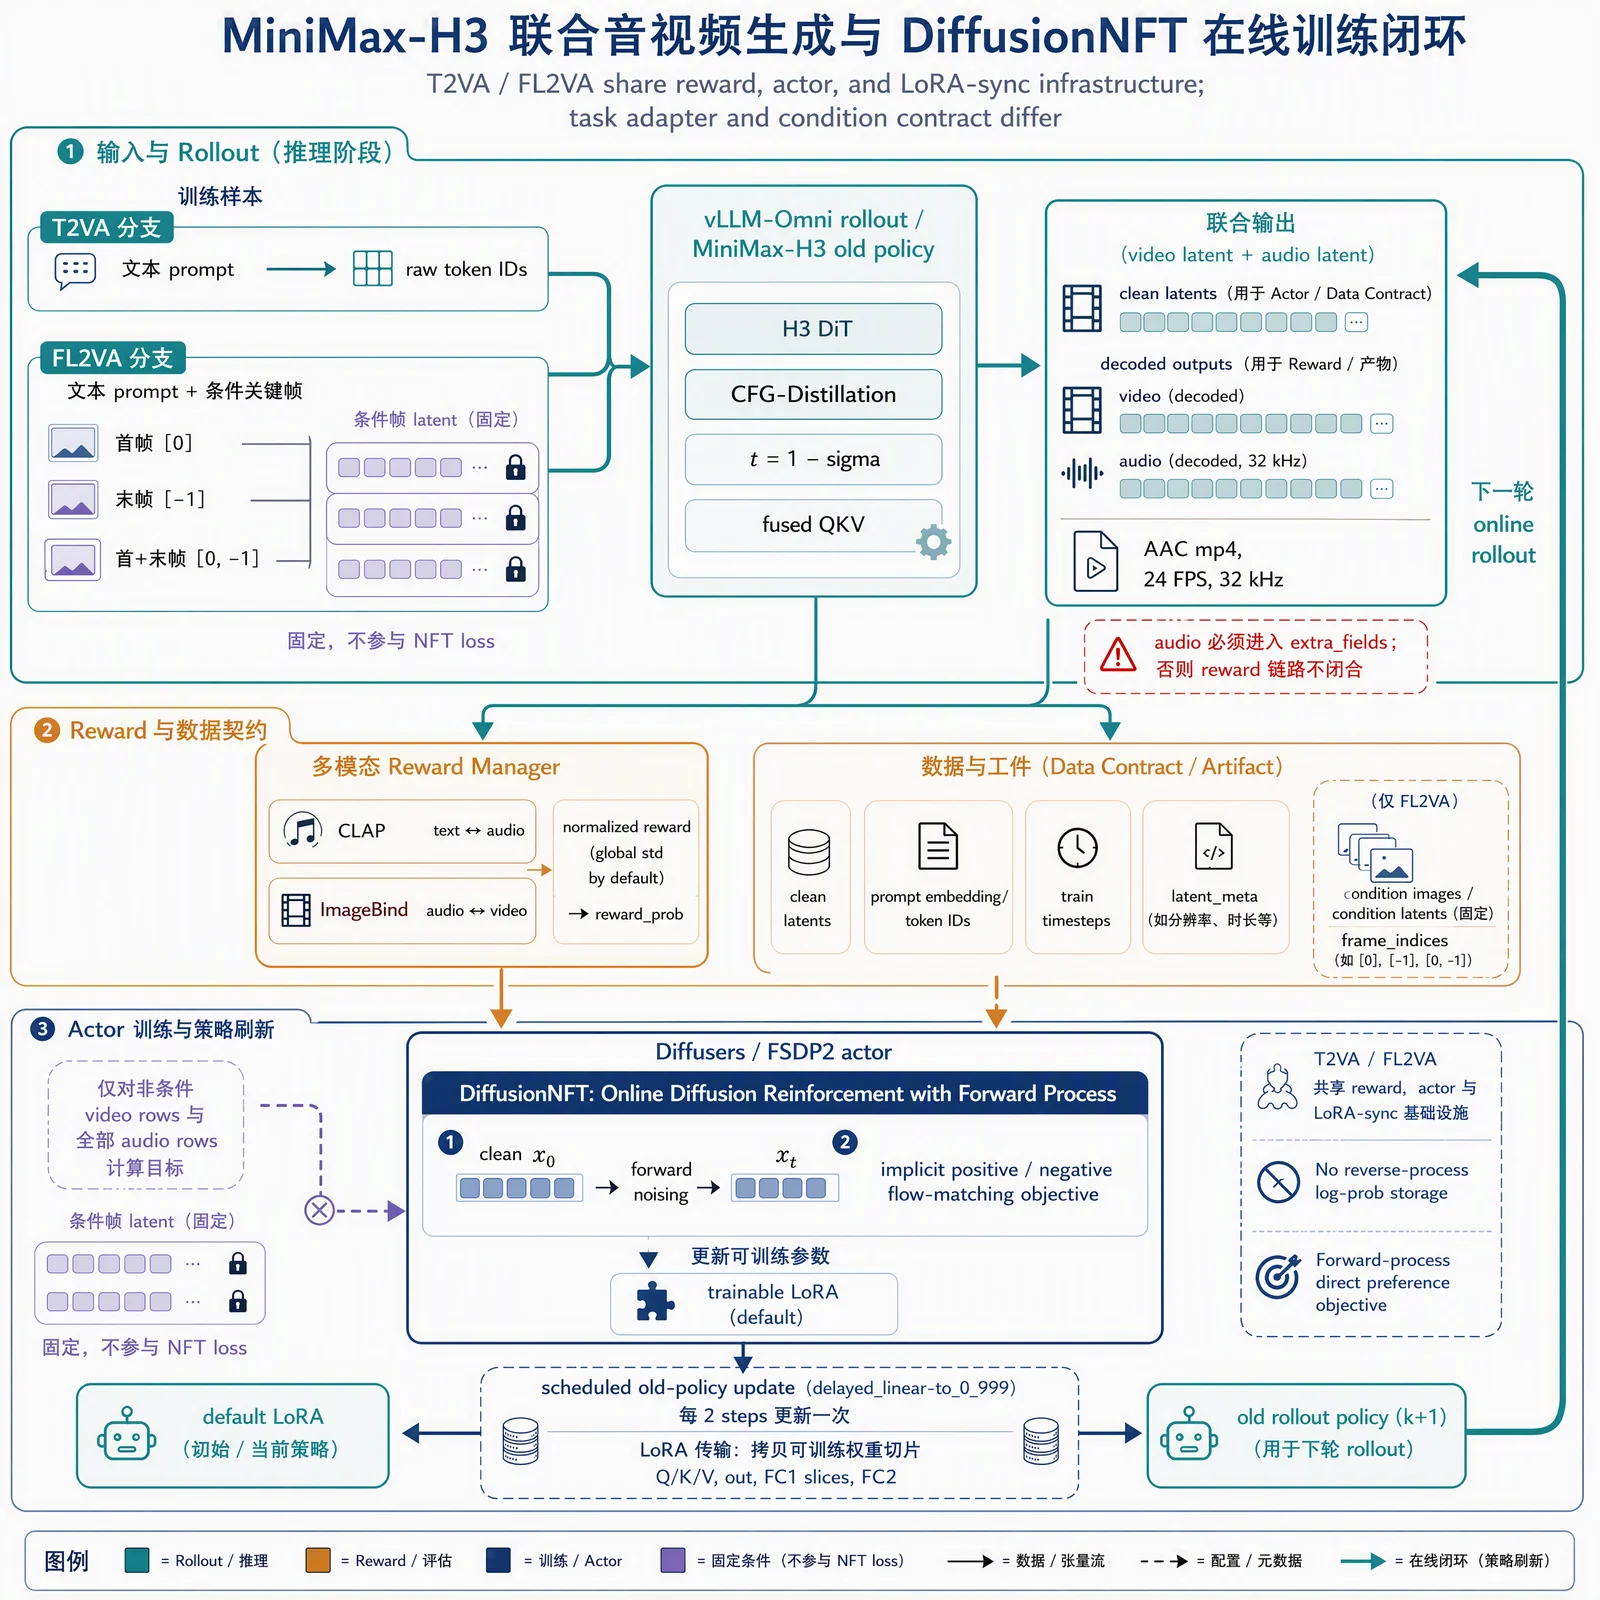
精选文章 MiniMax-H3 音视频生成 RL 后训练:基于 VeRL-Omni 的开源实践 引言 MiniMax-H3 是当前开源社区中最受关注的音视频生成模型之一。它是一个通用的多模态生成模型,接收文本、图像、视频、音频等多种输入,直接输出带原生立体声音轨的视频,支持最长 15 秒、最高 2K 分辨率、24 FPS、32 kHz 立体声。 在 Artificial Analysis 的
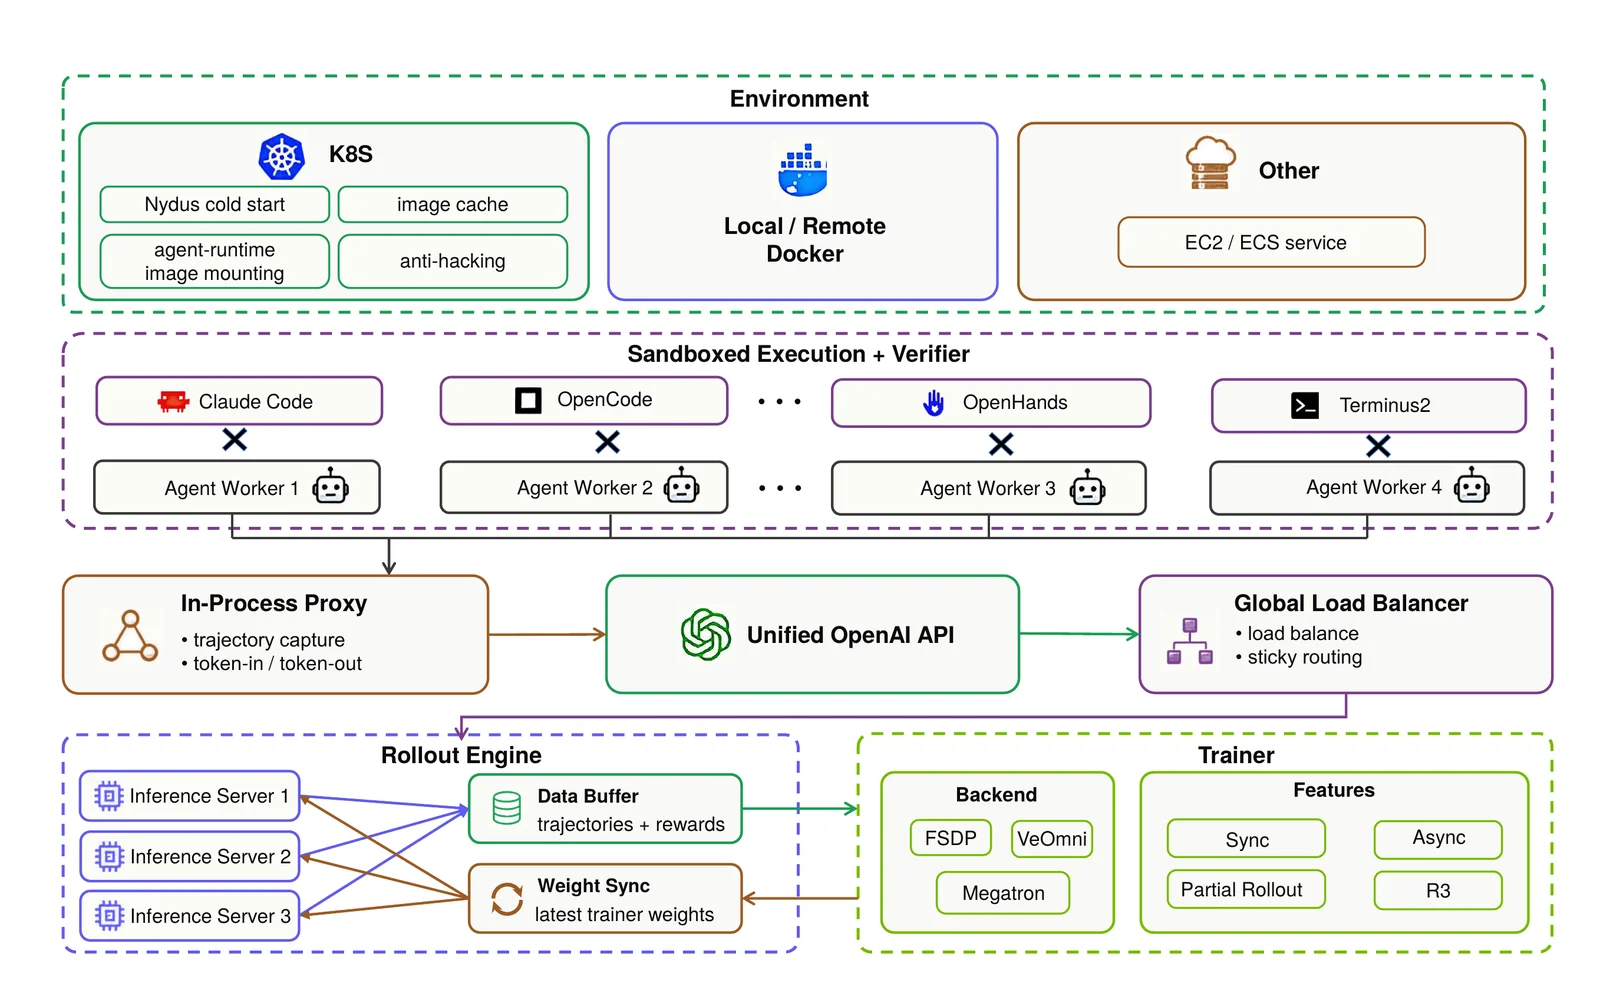
精选文章 华为&港中文最新开源 Lego-RL:让 Coding Agent 的强化学习训练真正"长稳可靠" Lego-RL 是一套面向 Coding Agent 的强化学习训练框架,也是 LegoX 系列的最新工作,由华为与香港中文大学联合团队完成。 论文:https://arxiv.org/abs/2608.17393 代码:https://github.com/LegoX/Lego-RL 文档:htt
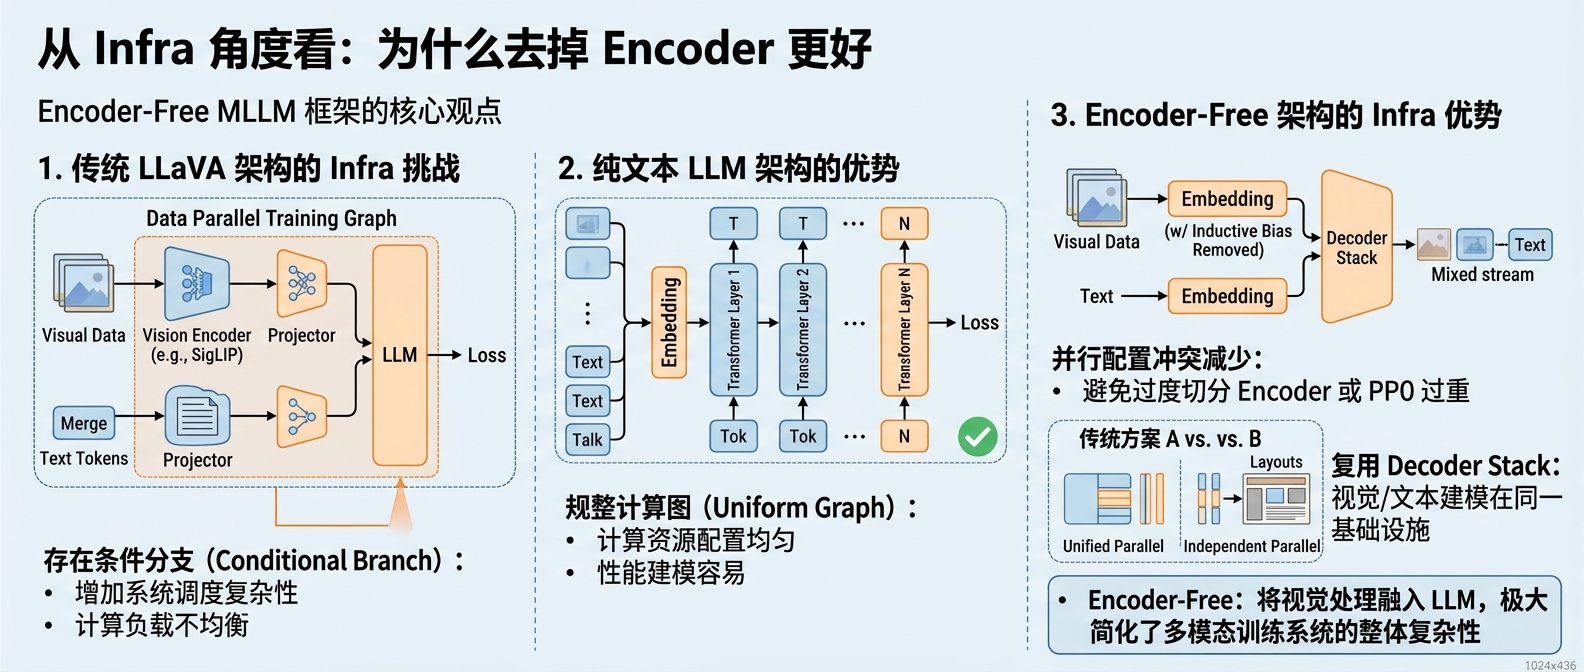
精选文章 从 Infra 角度看,为什么去掉 Encoder 更好? 作者:Yuwei Niu https://x.com/purshow04/status/2089737243267322349 从 Infra 角度看,为什么去掉 Encoder 更好 在过去半年,我研究上的主要叙事成为了尽可能去除 Inductive Bias,我也跟随 @Haiwen 成为了 E
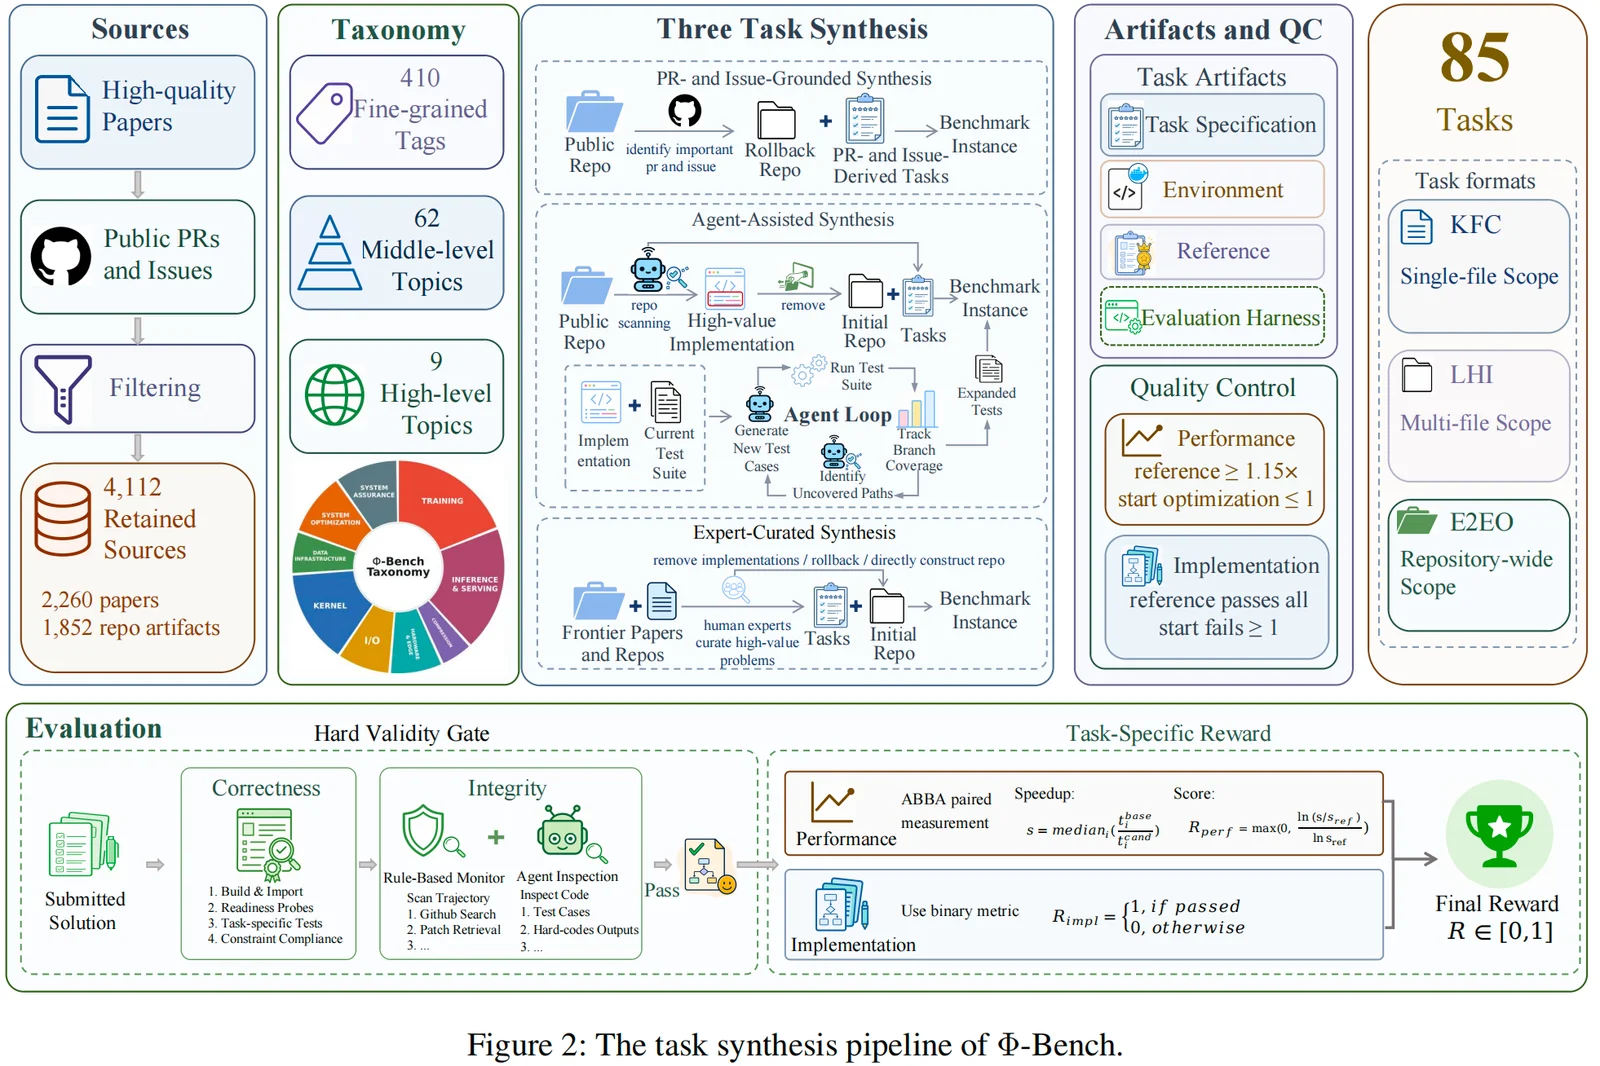
精选文章 Infra 也能自进化?Φ-Bench 深度评测:大模型距离“AI 工程师”还有多远? 过去几年,大语言模型(LLM)的能力快速提升。从写代码、完成复杂推理,到辅助科研和软件开发,模型正在逐渐成为越来越强大的工程助手。 但一个更深层的问题正在出现:如果模型能够帮助人类构建软件,大模型是否也能够反过来优化支撑自身运行的基础设施? 换句话说:Can Large Language Model
精选文章 为什么复杂 RL 离不开分布式系统,分布式 RL 的核心矛盾又是什么? 作者:觉醒也醉了 https://zhuanlan.zhihu.com/p/2047396735169908748 一、为什么复杂 RL 离不开分布式系统 近年来,强化学习(Reinforcement Learning, RL)在复杂决策任务中取得了大量突破,尤其是在游戏 AI、机器人控制等领域,以
青稞Talk 直播预告!聊聊大语言模型在 latent space(隐空间)里的优化和推理 语言模型的推理能力已成为当前研究的焦点,但传统思维链(CoT)受限于自然语言这一"思维介质",人类许多认知过程从未被显式书写,因而无法被模型从数据中习得。 在最新的研究中提出了一种新视角:将推理重新表述为"价值引导的隐空间优化",即不依赖外部信息,直接在模型内部隐空间中沿价值梯度搜索更优解。 8月2
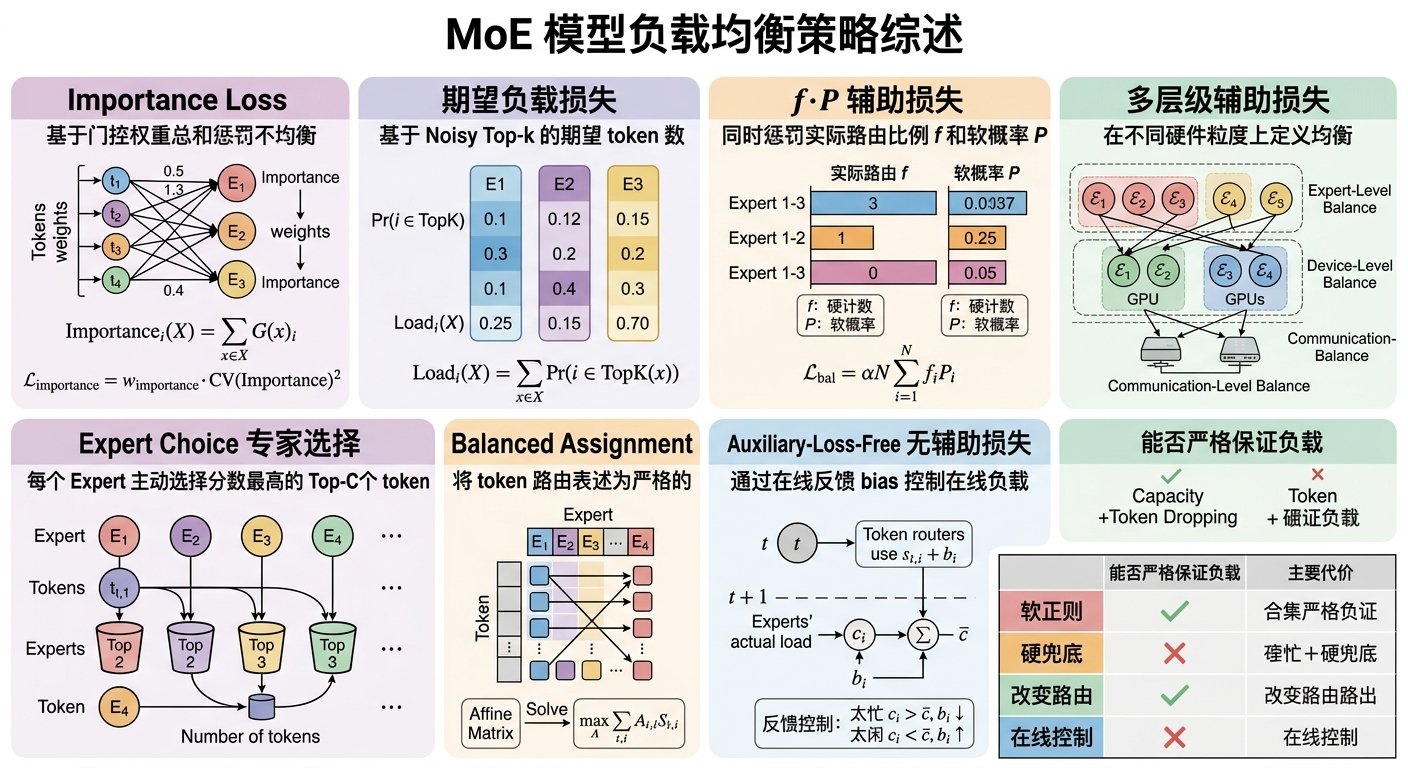
精选文章 大模型 MoE 负载均衡的 N 种方法 作者:觉醒也醉了 https://zhuanlan.zhihu.com/p/2066914125012283729 MoE 中的负载 假设一个 batch(或一个路由 group)中有 T 个 token、N 个 routed experts,每个 token 选择 k 个 Expert。 Rout
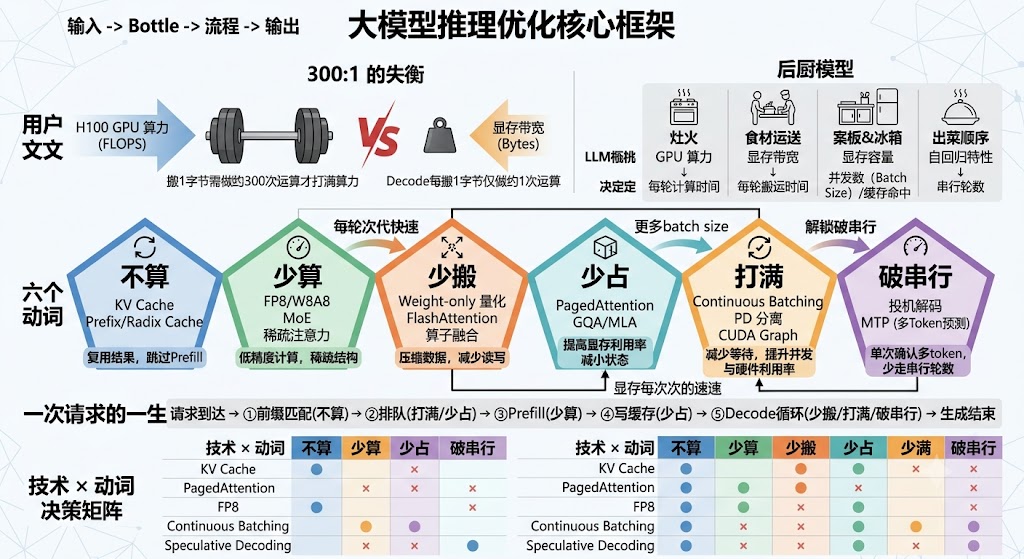
精选文章 一张全景图!拆解大模型推理性能优化技术的目标 作者:朱时昊(知乎 @保持好奇心) https://zhuanlan.zhihu.com/p/2060420409883898083 大模型推理优化的技术很多,但不建议从 FlashAttention、量化、PagedAttention 这些名字开始背。更有效的办法,是先看一条请求究竟慢在哪里。 在
精选文章 从推理角度看 kimi k3 作者:SuSun https://zhuanlan.zhihu.com/p/2061411883958137356 从推理角度看一下 Kimi K3,2.8 T, fp4 的话, 1.4 TB,hopper 其实也还行。但肯定这个架构说白了给 B 卡定制的,就是不知道国产卡是否受益了(投机一下,其实
精选文章 浅谈 AI 编译器趋势:从更快的 kernel 到重新定义执行边界 作者:画饼充饥 https://zhuanlan.zhihu.com/p/2040199323170951424 最近看AI infra和AI compiler的论文,一个很明显的变化是大家已经不满足于把某个算子编译的更快了。 早期深度学习编译器的叙事多半围绕operator graph,例如Mat
青稞Talk 直播预告!周六上午10点,聊聊 PithTrain:Agent 时代的 MoE 训练框架设计 陈天奇团队最新开源 PithTrain:Agent 时代的 MoE 训练框架设计 专家混合模型(MoE)已经成为当前大语言模型的主流架构,相应的生产级训练框架也经过多年工程积累,具备了优异的训练性能。 然而,随着新的模型架构和系统优化不断涌现,在这些大型框架上进行开发和演进仍然成本高昂。 随着 AI
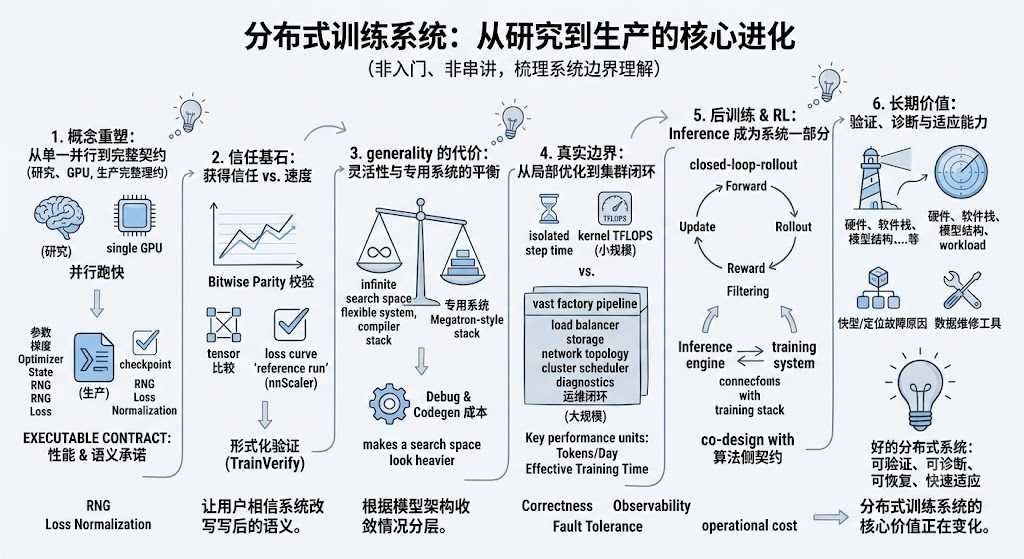
精选文章 从 nnScaler 到大规模训练:谈一谈对分布式训练系统边界的一些理解 作者:朱翼 https://zhuanlan.zhihu.com/p/2056045172111177252 这篇文章来自我最近准备的一个技术分享。原本的主题是 “Distributed Training Systems: From Research to Production”。整理成博客时,我不
青稞Talk 直播预告!聊聊 VeRL-Omni:基于VeRL及vLLM-Omni构建的面向多模态生成模型的开源 RL 后训练框架 随着文生图/视频及全模态模型快速落地,基于人类偏好与可验证信号的 RL 后训练已成为提升生成质量的关键手段。但与纯文本 LLM 不同,多模态生成 RL 在采样 rollout、reward 计算与分布式训练上的 I/O 与算力特征差异显著,亟需专门框架支撑。 VeRL-Omni 基于 VeRL及vL
青稞Talk 直播预告!一起聊聊腾讯混元最新开源的 UniRL:面向统一多模态模型的分布式 RL 后训练框架 目前多模态领域 RL 仍然缺少生成理解统一的 Infra。图像 / 视频的生成、理解,Prompt-Enhancer (PE),以及 HunyuanImage-3.0、Bagel 等 unified multimodal models,通常都需要各自维护 rollout、reward、advanta
精选文章 陈天奇团队最新开源 PithTrain:Agent 时代的 MoE 训练框架设计 作者:赖睿航,CMU CS Ph.D. https://zhuanlan.zhihu.com/p/2045509863221064141 TL;DR PithTrain 是一个精简、agent-native 的 MoE(Mixture-of-Experts)训练框架,整套实现约 1.1 万行 Pyt
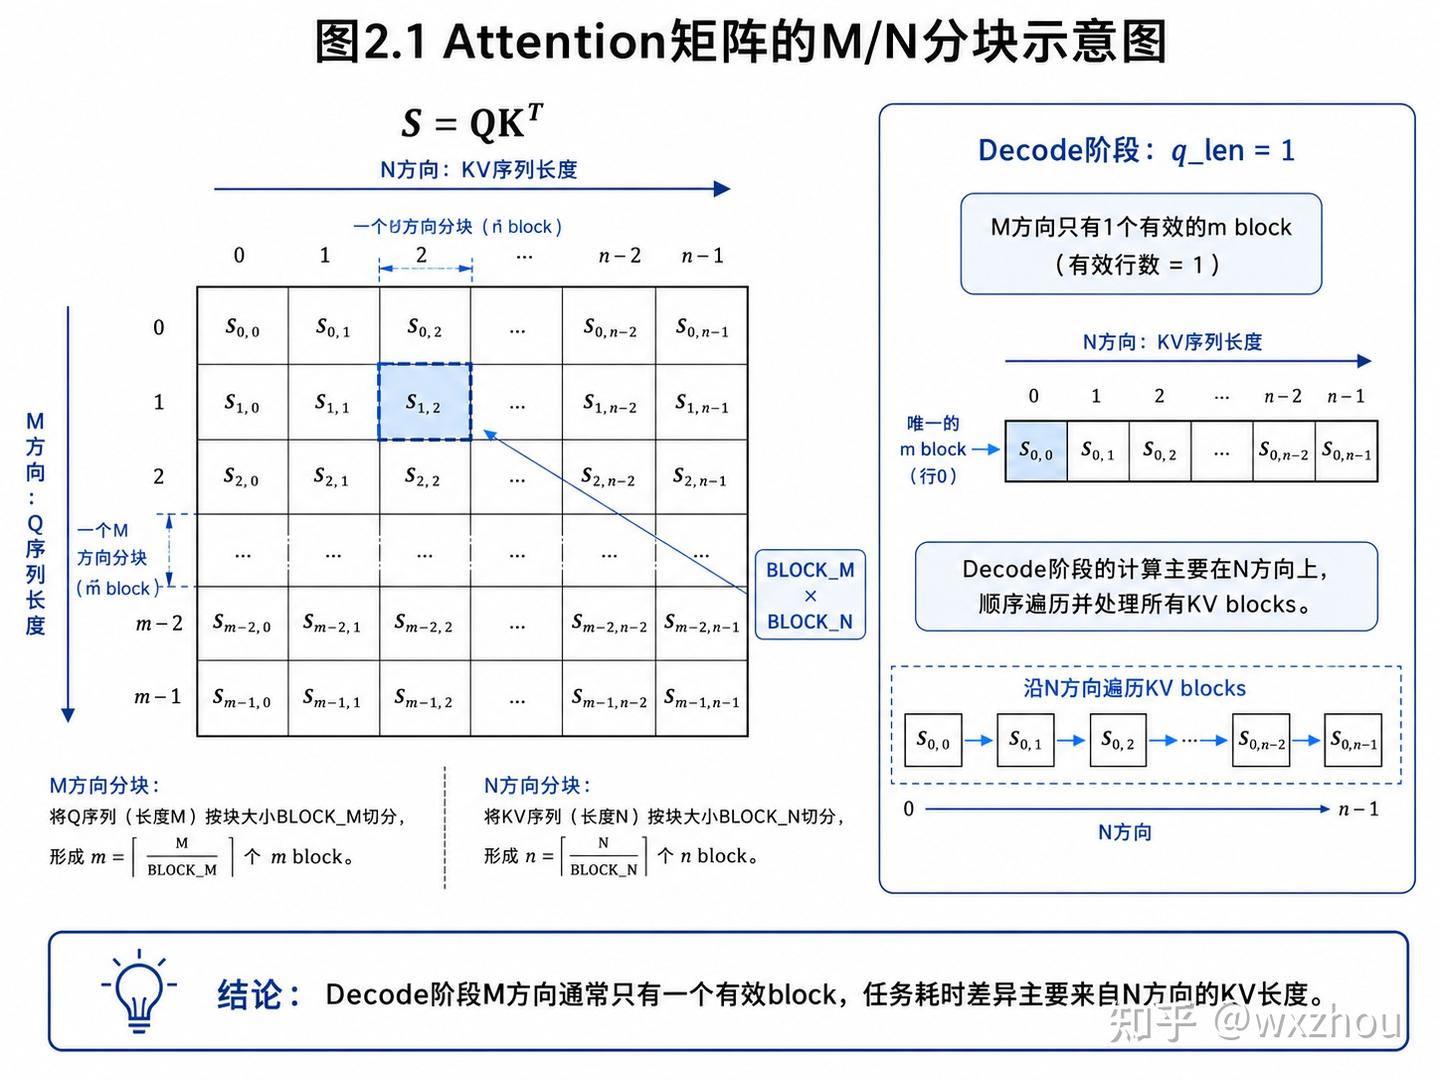
精选文章 深入解析 LLM 推理中的 Decode Batch 内部负载不均问题 作者:wxzhou https://zhuanlan.zhihu.com/p/2044873485688861958 本文仅使用大模型进行润色,并努力去除 AI 味,部分图片使用 gpt 生成。 1. 引言 先抛出一个问题:以典型 GQA 架构为例,在 LLM 推理的 Decode 阶段,Atten
青稞Talk DeepSeek V4 模型在 SGLang 中的系统级优化与全栈适配 4月25日,当 DeepSeek-V4 带着 1.6 万亿参数(Pro版)和百万级上下文窗口的震撼配置横空出世时,整个大模型圈的目光都聚焦在了它极具野心的架构革新上:混合稀疏注意力(CSA+HCA)、流形约束超连接(mHC)以及 FP4 专家权重。 然而,对于广大开发者和企业用户而言,面对如此庞大且
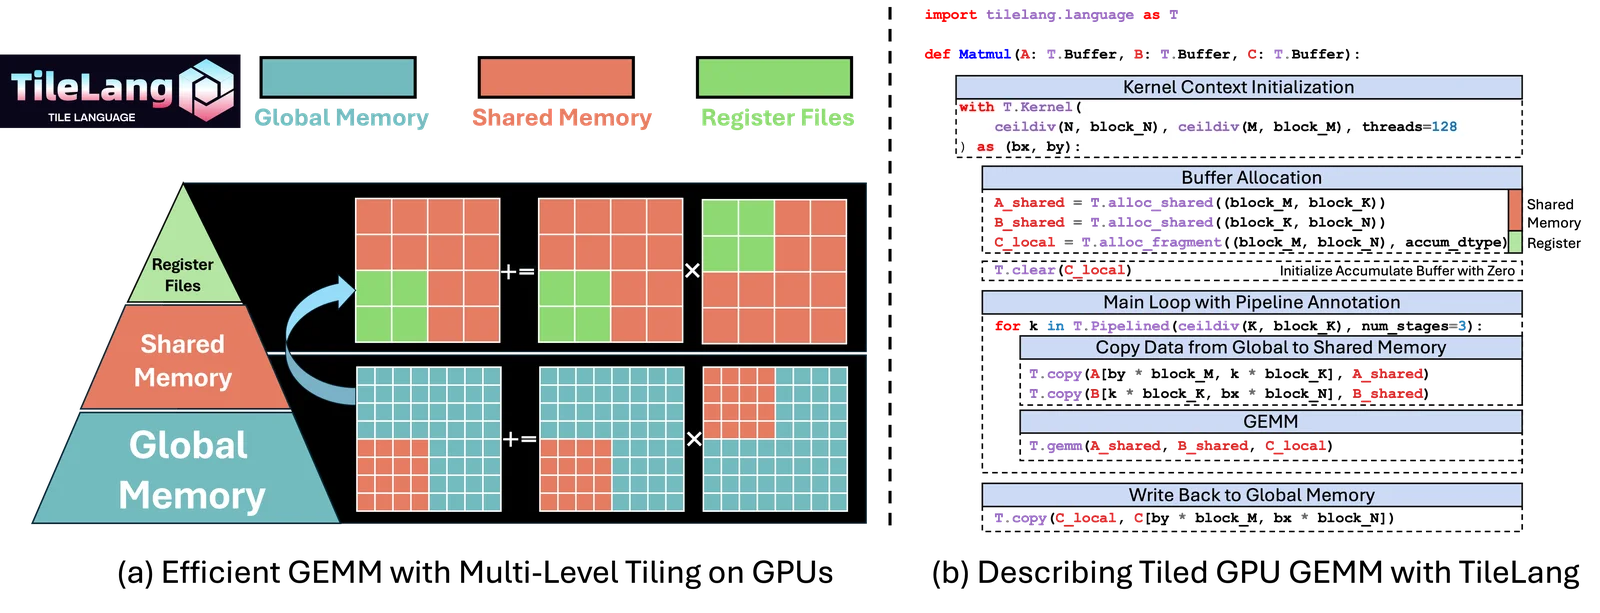
精选文章 DeepSeek-V4 技术报告背后的 TileLang:如何高效实现大模型中的小算子 作者:SiriusNEO https://zhuanlan.zhihu.com/p/2033034202720022871 大家五一快乐!最近 V4 的技术报告讨论度很高,其中 TileLang 在报告中也占了一部分内容,主要是总结了社区最近的一些技术进展、以及其投入实际工业界应用后的一些打磨经验。
青稞Talk 从 Depth Scaling 到 Width Scaling!WideSeek-R1:通过多智能体 RL 探索大模型的广度扩展(Width Scaling) DeepSeek-R1 的成功证明,深度扩展(Depth Scaling)在复杂逻辑推理中具有巨大潜力。但当任务从“深推理”转向“广信息”——如汇总全球头部科技公司多维财务数据——单一大模型往往受限于多轮检索带来的上下文干扰与串行效率瓶颈。 为此,我们提出“广度扩展”(Width Scaling)这
青稞Talk 面向对象的 Agent Infra 新范式:有状态运行时管理的设计与工程实践 当前主流的 LLM Agent 框架普遍采用 Text-in-Text-out 的交互范式——无论输入还是输出,所有数据都必须经过文本序列化。 这使得 Agent 难以直接操作复杂的外部对象(如 DataFrame、数据库连接、训练好的模型),其产出也无法被下游系统(数据可视化、Agentic UI
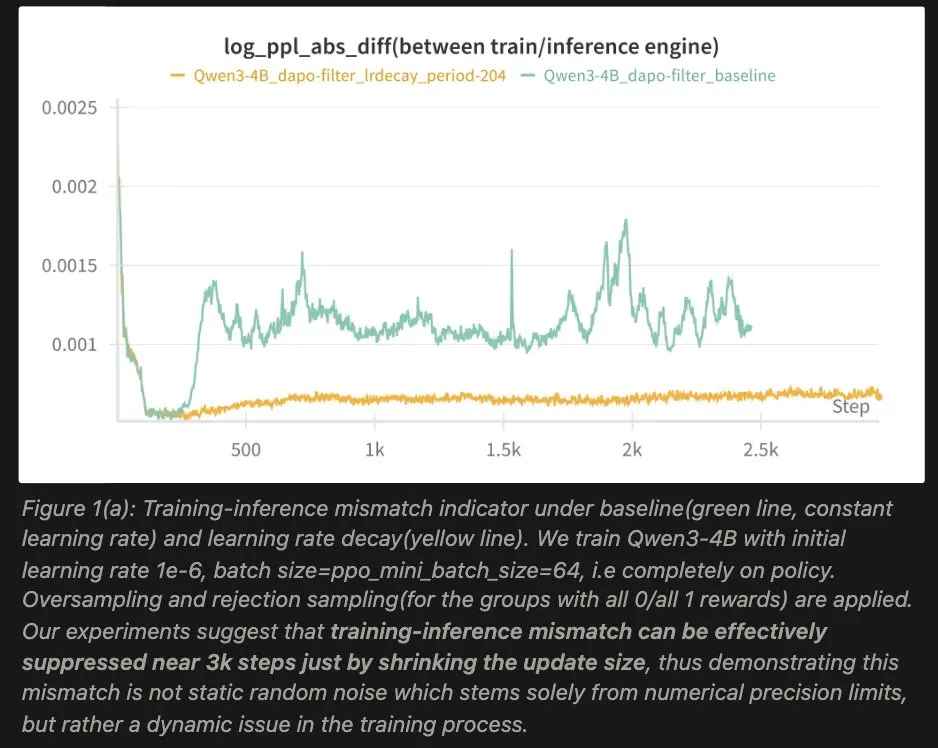
精选文章 超越精度:为什么训练-推理不一致是一个优化问题,以及简单的学习率调度(LR Scheduling)如何修复它 在 LLM 强化学习(RL)的训练中,有一个长期困扰算法工程师的“幽灵”:训练-推理不一致(Training-Inference Mismatch) 。很多时候,你会发现训练开始阶段一切正常,但是一段时间后训练引擎和推理引擎生成token的概率分布就有可能越来越远,accuracy断崖式下跌。 主流
精选文章 从“训推一体”到“AI 自主演进”——2025 AI 嘉年华 Infra 专题实录 青稞社区于12月28日组织了青稞Talk 第100期特辑:2025 “青稞” AI 嘉年华! 本次活动专为青年科学家打造,旨在搭建一场 AI 技术的深度对话,来自学术和工业界的 20+ 青年科学家,与大家一起回顾 2025,展望 2026! 其中 Infra 专题,由 Sea AI Lab 算法工程