前沿开源权重模型正日益普及,但其部署服务目前仍主要依赖数据中心级别的基础设施。
来自 UC Berkeley、MIT 等团队推出了一种面向边缘设备原生设计的混合专家(MoE)推理服务系统: FreeToken,它不再将个人计算机简单视为一块小型 GPU,而是将其建模为一个统一、弹性可伸缩的推理平台。
FreeToken 针对本地人工智能应用的两大现实特征,对整个服务栈进行了协同设计:
- 一是智能体(agent)类工作负载的执行模式持续动态变化;
- 二是边缘硬件资源具有高度异构性,且不同设备间的资源配比差异显著。
这两大特征具体体现在模型布局与加载、专家模块驻留策略、CPU–GPU 协同执行、智能体状态复用机制以及运行时内存管理等关键环节。
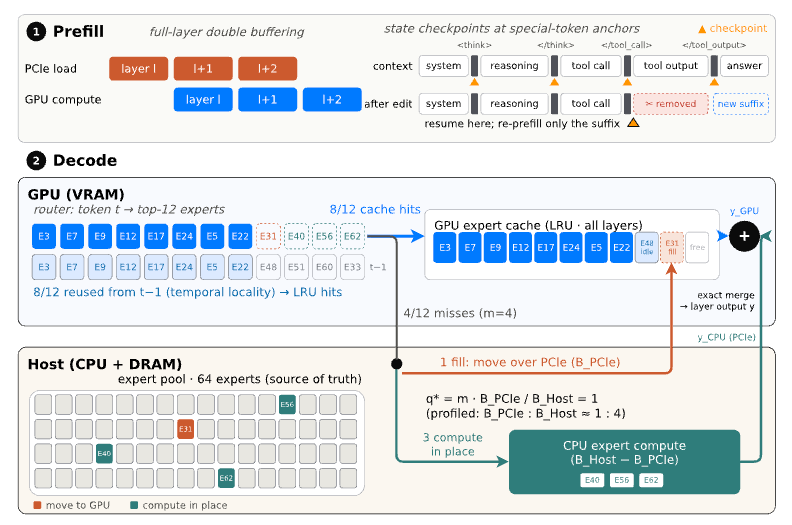
FreeToken 并不预先固化某种卸载策略,而是持续地、动态地将计算任务与模型状态映射到设备当前实际可用的资源之上。FreeToken 支持超过 20 种 MoE 模型,并已在涵盖从仅配备 8GB 显存的笔记本 GPU 到单块工作站级 GPU 的多种硬件平台上,成功运行真实的代码生成与工具调用类智能体。
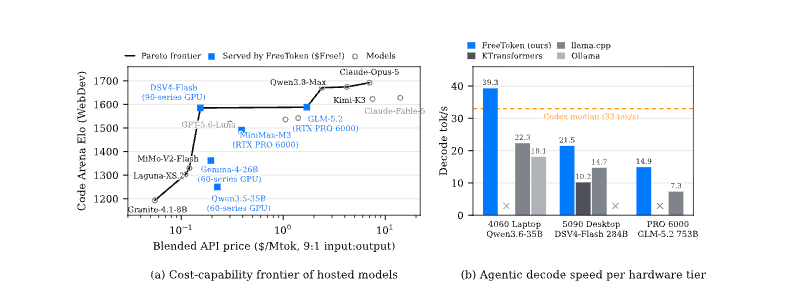
更重要的是,它显著拓展了各类终端设备的实际服务能力:在普通笔记本上即可部署 35B 参数规模的模型,在高端游戏台式机上可运行高达 284B 参数的模型,甚至可在单块工作站级 GPU 上直接部署参数量达 753B 的 GLM-5.2 模型。
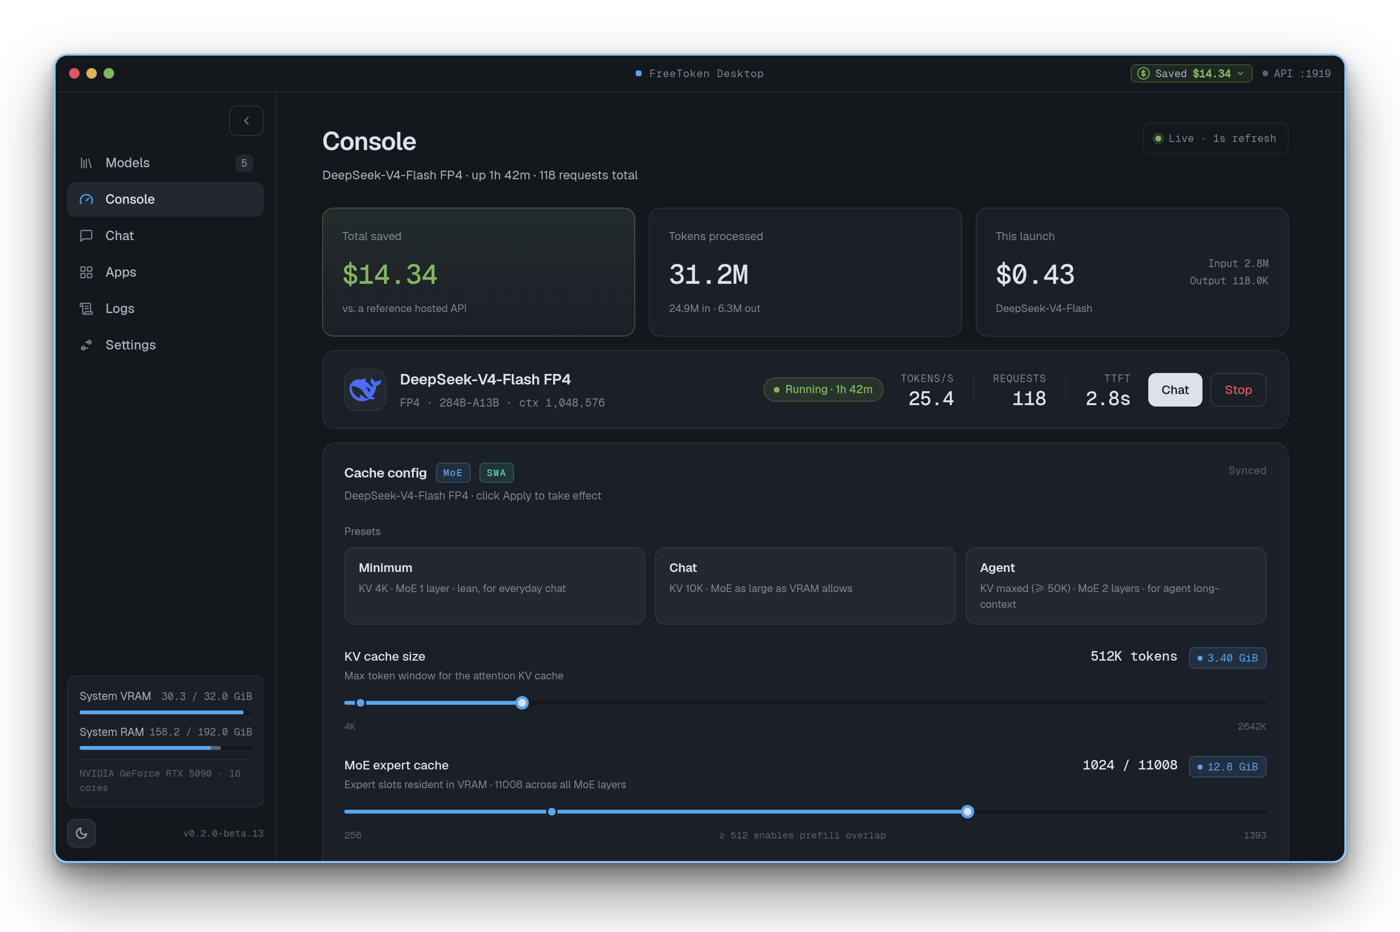
FreeToken 将开源权重真正转化为可即装即用的本地化软件,使用户手中已有的终端设备成为支撑前沿级人工智能能力的切实可行平台。本系统已在 flashml.ai 开源发布。
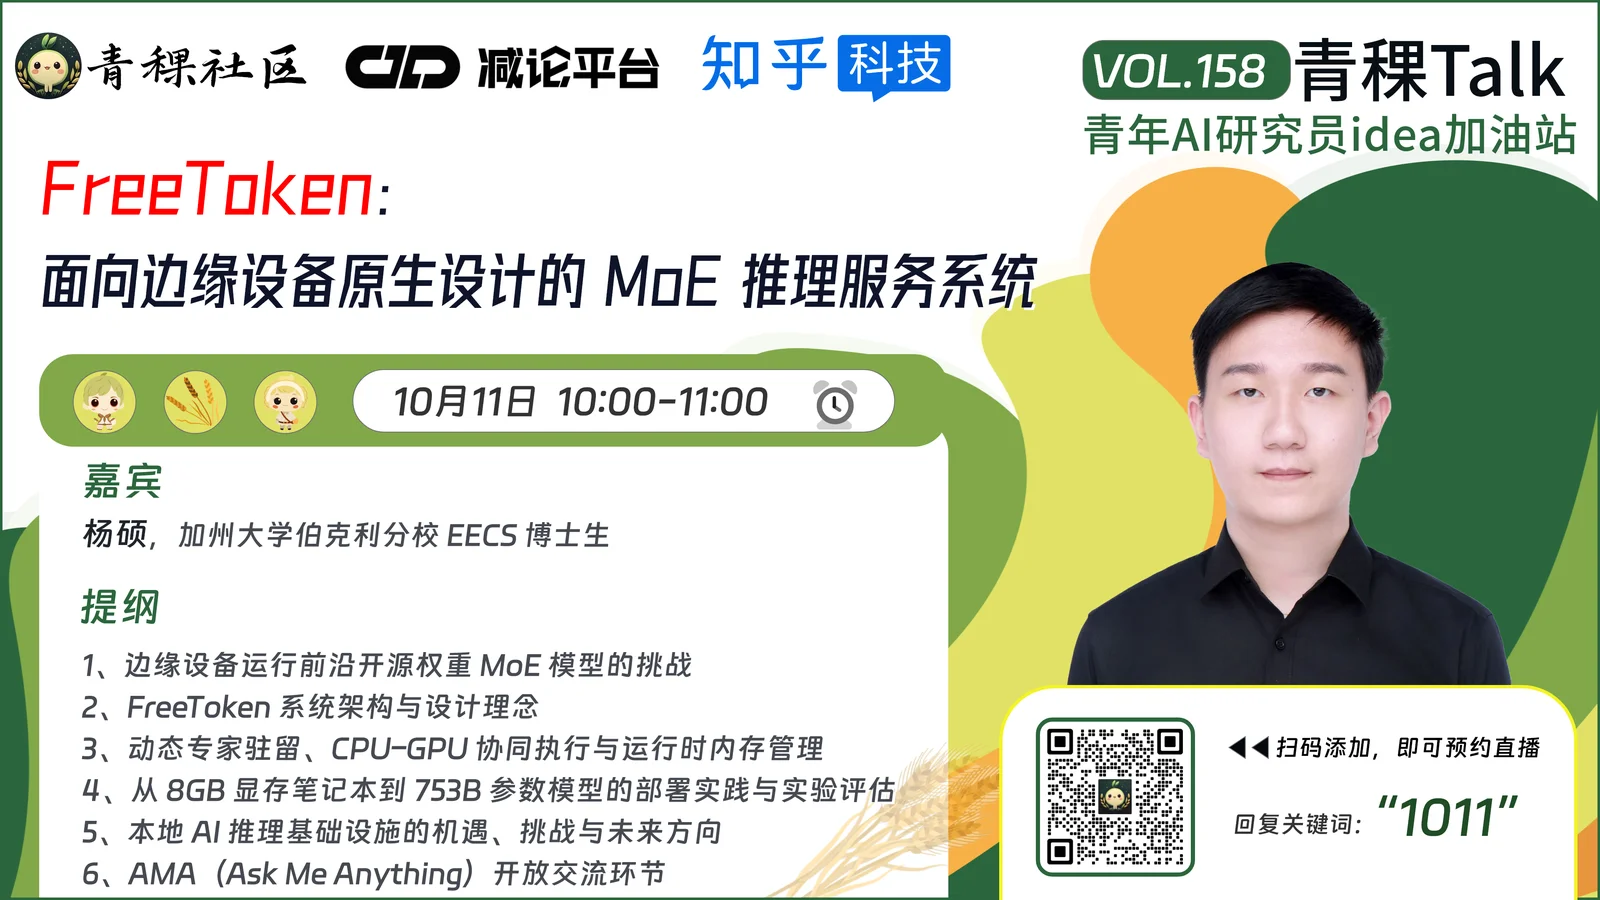
10月11日(周日)上午10:00,青稞Talk 第158期,青稞社区邀请到FreeToken 作者、加州大学伯克利分校 EECS 博士生杨硕,直播分享 FreeToken 的系统架构与设计理念,并探讨本地 AI 推理基础设施的机遇、挑战与未来方向。
青稞介绍
杨硕,加州大学伯克利分校 EECS 博士生,研究方向为机器学习系统,聚焦高效 AI 推理与硬件感知的算法设计。近期工作探索如何围绕现代硬件重新思考 AI 系统与算法,涵盖高效 LLM 服务、消费级硬件上的大规模模型推理以及高性能机器学习算子。他是 FlashLib 与 FreeToken 的主要开发者:FlashLib 为现代加速器重新设计经典机器学习算法,FreeToken 让前沿级模型在个人与边缘硬件上高效运行。
主题提纲
FreeToken:面向边缘设备原生设计的 MoE 推理服务系统
1、边缘设备运行前沿开源权重 MoE 模型的挑战
2、FreeToken 系统架构与设计理念
3、动态专家驻留、CPU–GPU 协同执行与运行时内存管理
4、从 8GB 显存笔记本到 753B 参数模型的部署实践与实验评估
5、本地 AI 推理基础设施的机遇、挑战与未来方向
6、AMA(Ask Me Anything)开放交流环节
直播时间
10月11日(周日)10:00 - 11:00
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册