青稞Talk 深度对话!2025 “青稞” AI 嘉年华,与 20+ 位青年科学家一起探讨AI 技术瞬间 本次活动专为青年科学家打造,旨在搭建一场 AI 技术的深度对话,来自学术和工业界的 20+ 青年科学家,将与大家一起回顾 2025,展望 2026!
青稞Talk 直播预告!聊聊线性注意力的低比特量化方法:STEPQuant 上下文越长,KV Cache 越大,这是推理服务里最熟的一笔账。 线性注意力换了个算法:把 KV Cache 换成固定大小的循环状态(Recurrent State),序列再长,状态也不涨。Qwen3.8-27B、Kimi-Linear-48B-A3B-Instruct 这类混合模型,就是用 gat
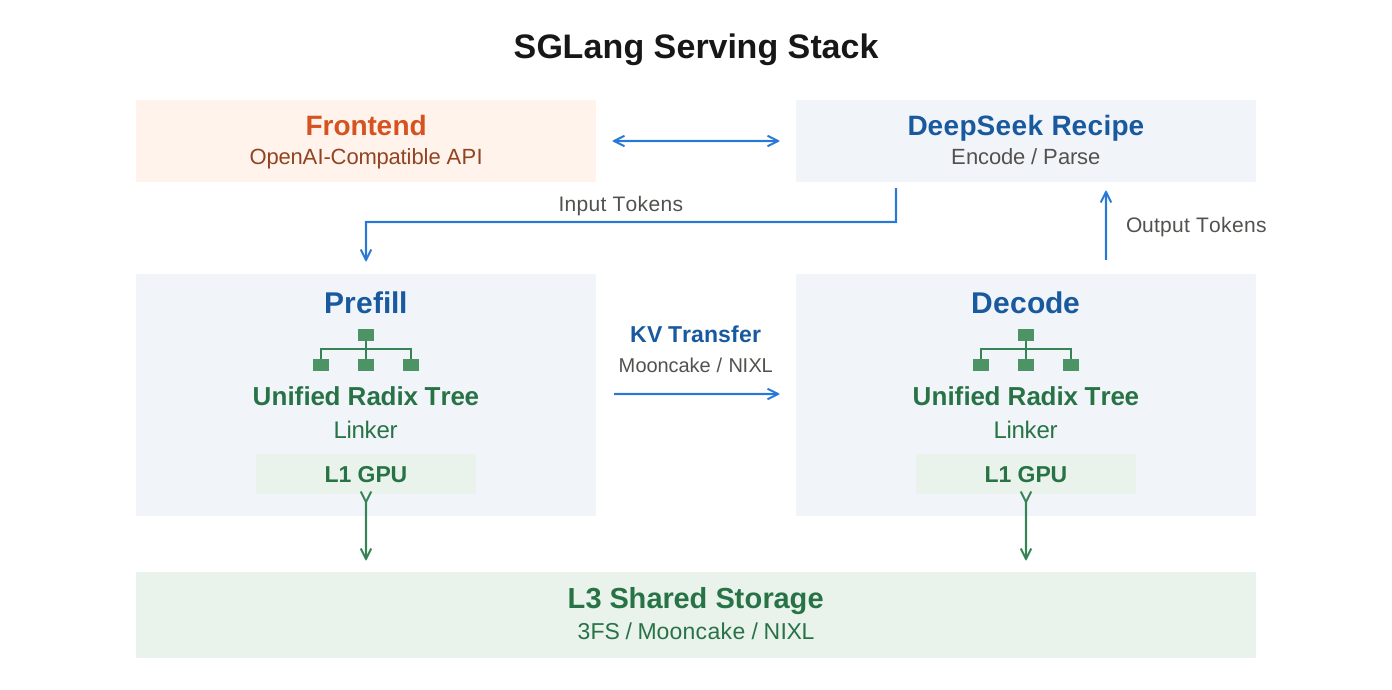
精选文章 DeepInfer 的优化,SGLang 也有了:4 卡打平,64 卡 decode 最高快 7.4% 作者:The SGLang Team 原文:https://www.lmsys.org/blog/2026-10-24-dsv41-deepinfer 摘要 在 DeepInfer 自己的基准上打平或领先 4x GB300 和 4x B300 上,prefill 吞吐最高到 1.04 倍;64x G
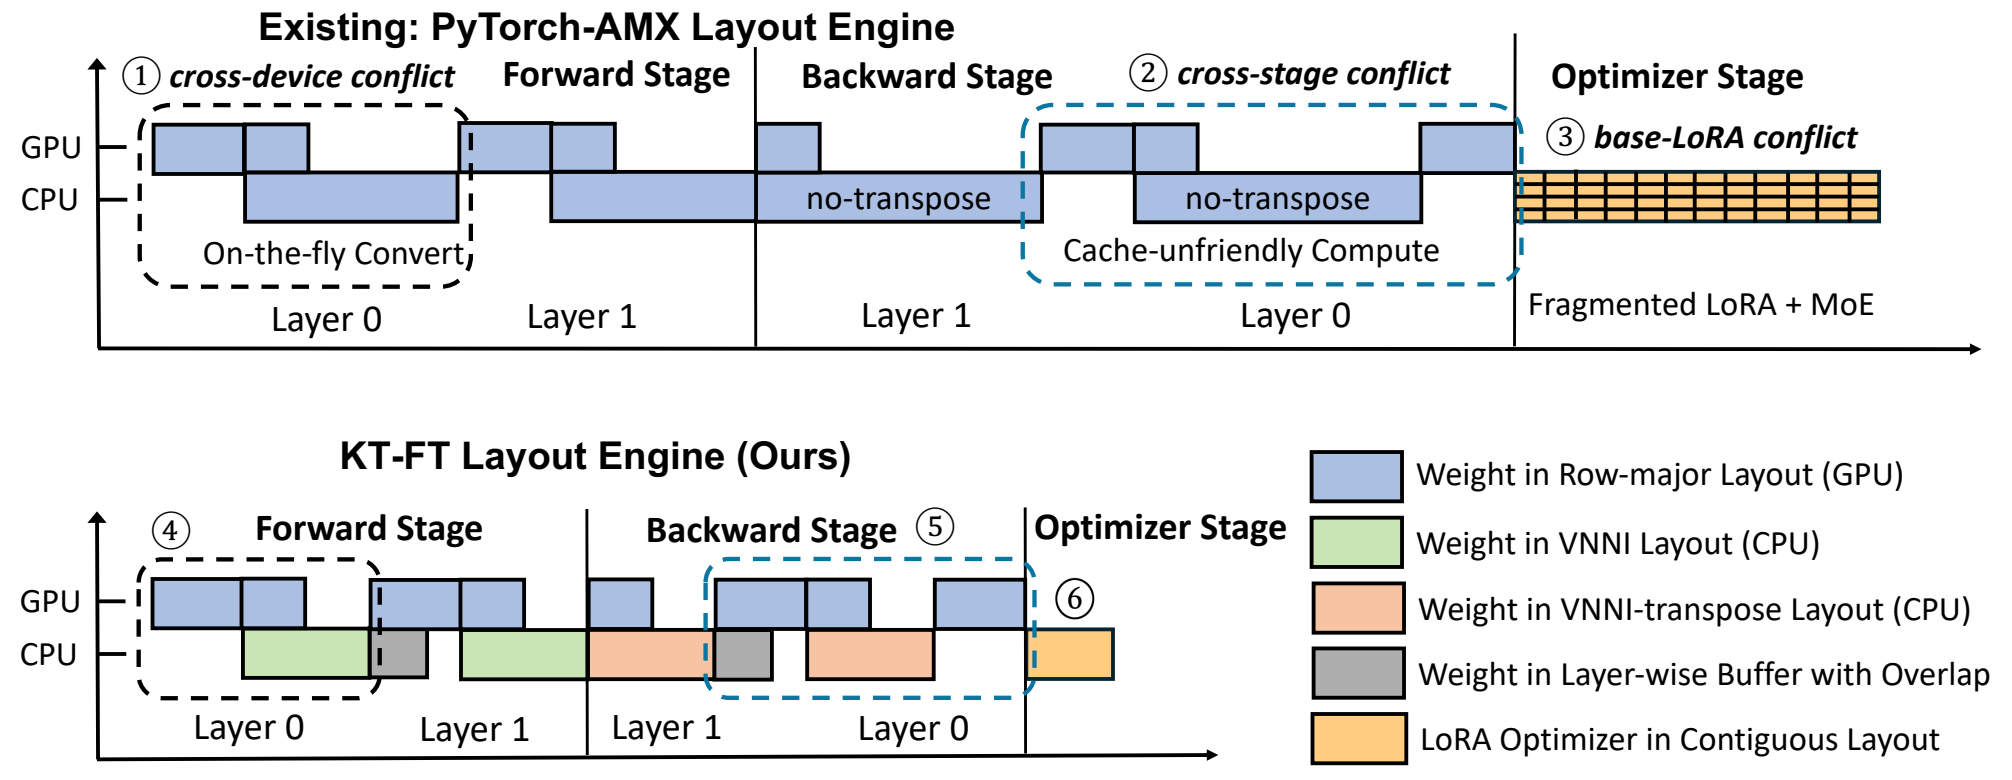
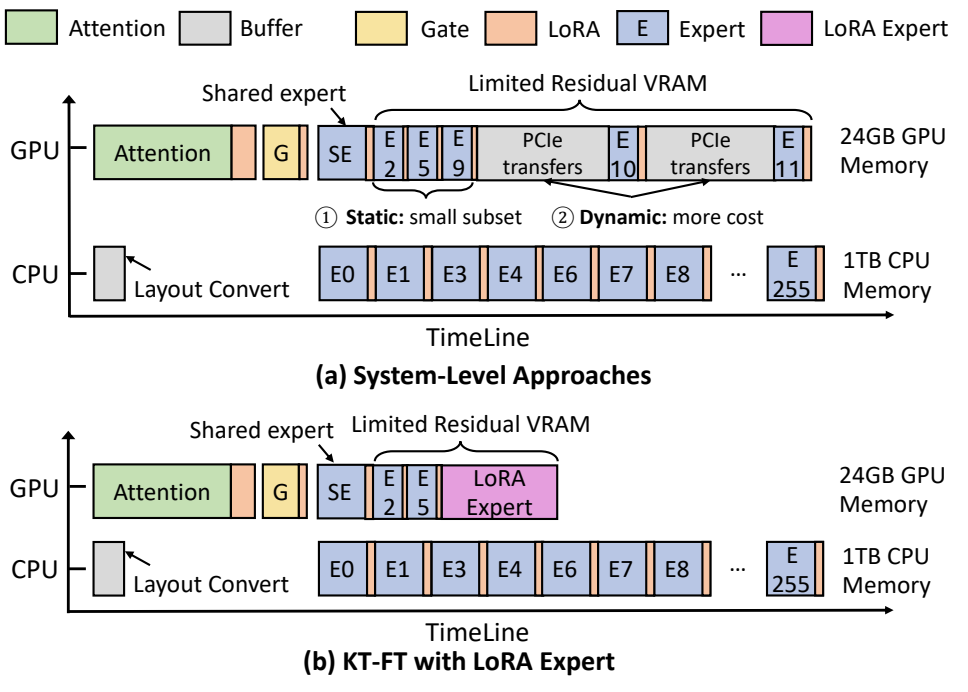
精选文章 别再让计算等着搬权重了!KTransformers 让 CPU 直接参与 MoE 微调计算 从 DeepSeek-V4 到 Qwen-3.8、Kimi-K3、GLM-5.3,每⼀次超⼤模型的开源都带来性能上的巨⼤跃升。 然⽽,随着模型规模越来越大,多数研究者与开发者只能尝试调用 API,无法在资源受限条件下进行微调,这进一步限制了大家探索前沿模型的特性,也难以把他们适配到自己的业务任务中。
精选文章 别再让计算等着搬权重了!KTransformers 让 CPU 直接参与 MoE 微调计算 从 DeepSeek-V4 到 Qwen-3.8、Kimi-K3、GLM-5.3,每⼀次超⼤模型的开源都带来性能上的巨⼤跃升。 然⽽,随着模型规模越来越大,多数研究者与开发者只能尝试调用 API,无法在资源受限条件下进行微调,这进一步限制了大家探索前沿模型的特性,也难以把他们适配到自己的业务任务中。
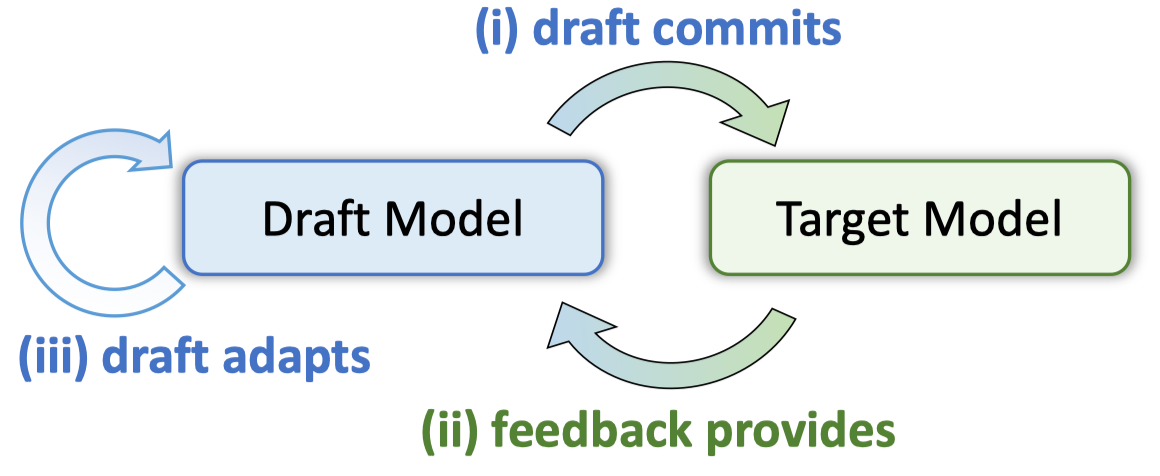
精选文章 大幅提升高并发下的推理速度!南京大学与华为基模团队提出 AdaFlash,让投机解码在线自我改进 AdaFlash 让投机解码在线自我改进,同时减少大模型无效工作,大幅提升高并发下的推理速度 DeepSeek 的 DSpark 让“投机解码推理加速”成为行业热点,尤其是在高并发的工业生产场景中。几乎同期时间,南京大学与华为基础模型团队共同提出的 AdaFlash,从扩散草稿模型的高方差出发,给出
青稞Talk 直播预告!聊聊 RL-Kernel ,大模型 RL 后训练中的训推一致性实践 大模型的 RL 后训练里,有一个常被忽略、却可能让训练悄悄跑偏的隐患。 Rollout 与 Training 往往由两套不同的引擎执行。即使模型、权重、token 完全相同,两边的 LogP 也可能对不上——浮点归约顺序、并行分片、通信合并树、精度转换边界,任何一处不同,都会在数值上分叉。 一个直观
精选文章 乱谈 Kernel 之 Mega 向左,PDL向右 TLDR 刚入职就被老板抓来做megakernel,问及怎么做,曰:不知道,问及目标,曰:世界一流水平。 本文关注 GLM-5.2-FP8 在 decode 阶段执行完整 Indexer 的一个 Transformer layer,并优化这一层进入 Sparse FlashMLA 前的计算。 测量范
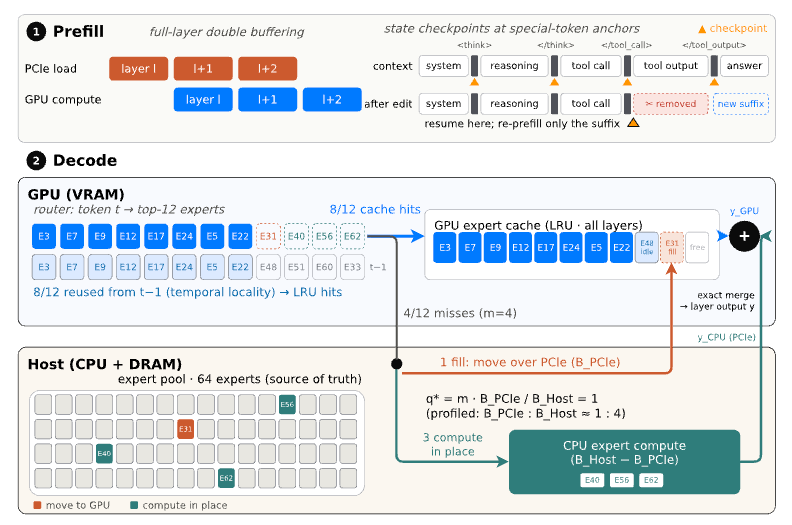
青稞Talk 直播预告!聊聊FreeToken:如何在 8GB 显存上跑起 35B 参数的 MoE 大模型 前沿开源权重模型正日益普及,但其部署服务目前仍主要依赖数据中心级别的基础设施。 来自 UC Berkeley、MIT 等团队推出了一种面向边缘设备原生设计的混合专家(MoE)推理服务系统: FreeToken,它不再将个人计算机简单视为一块小型 GPU,而是将其建模为一个统一、弹性可伸缩的推理平台。
青稞Talk 直播预告!聊聊大语言模型在 latent space(隐空间)里的优化和推理 语言模型的推理能力已成为当前研究的焦点,但传统思维链(CoT)受限于自然语言这一"思维介质",人类许多认知过程从未被显式书写,因而无法被模型从数据中习得。 在最新的研究中提出了一种新视角:将推理重新表述为"价值引导的隐空间优化",即不依赖外部信息,直接在模型内部隐空间中沿价值梯度搜索更优解。 8月2
精选文章 从推理角度看 kimi k3 作者:SuSun https://zhuanlan.zhihu.com/p/2061411883958137356 从推理角度看一下 Kimi K3,2.8 T, fp4 的话, 1.4 TB,hopper 其实也还行。但肯定这个架构说白了给 B 卡定制的,就是不知道国产卡是否受益了(投机一下,其实
青稞Talk 直播预告!周六上午10点,聊聊 PithTrain:Agent 时代的 MoE 训练框架设计 陈天奇团队最新开源 PithTrain:Agent 时代的 MoE 训练框架设计 专家混合模型(MoE)已经成为当前大语言模型的主流架构,相应的生产级训练框架也经过多年工程积累,具备了优异的训练性能。 然而,随着新的模型架构和系统优化不断涌现,在这些大型框架上进行开发和演进仍然成本高昂。 随着 AI
精选文章 深入理解 Agentic RL 中的行为崩塌现象 作者:Jason 原文:https://zhuanlan.zhihu.com/p/2050794185909876253 过去一段时间里,我一直在思考一个问题:Agentic RL 到底和传统 RLVR 有什么本质区别? 最容易想到的答案当然是工具调用。传统 RLVR 往往围绕单轮回答展开,模型生成
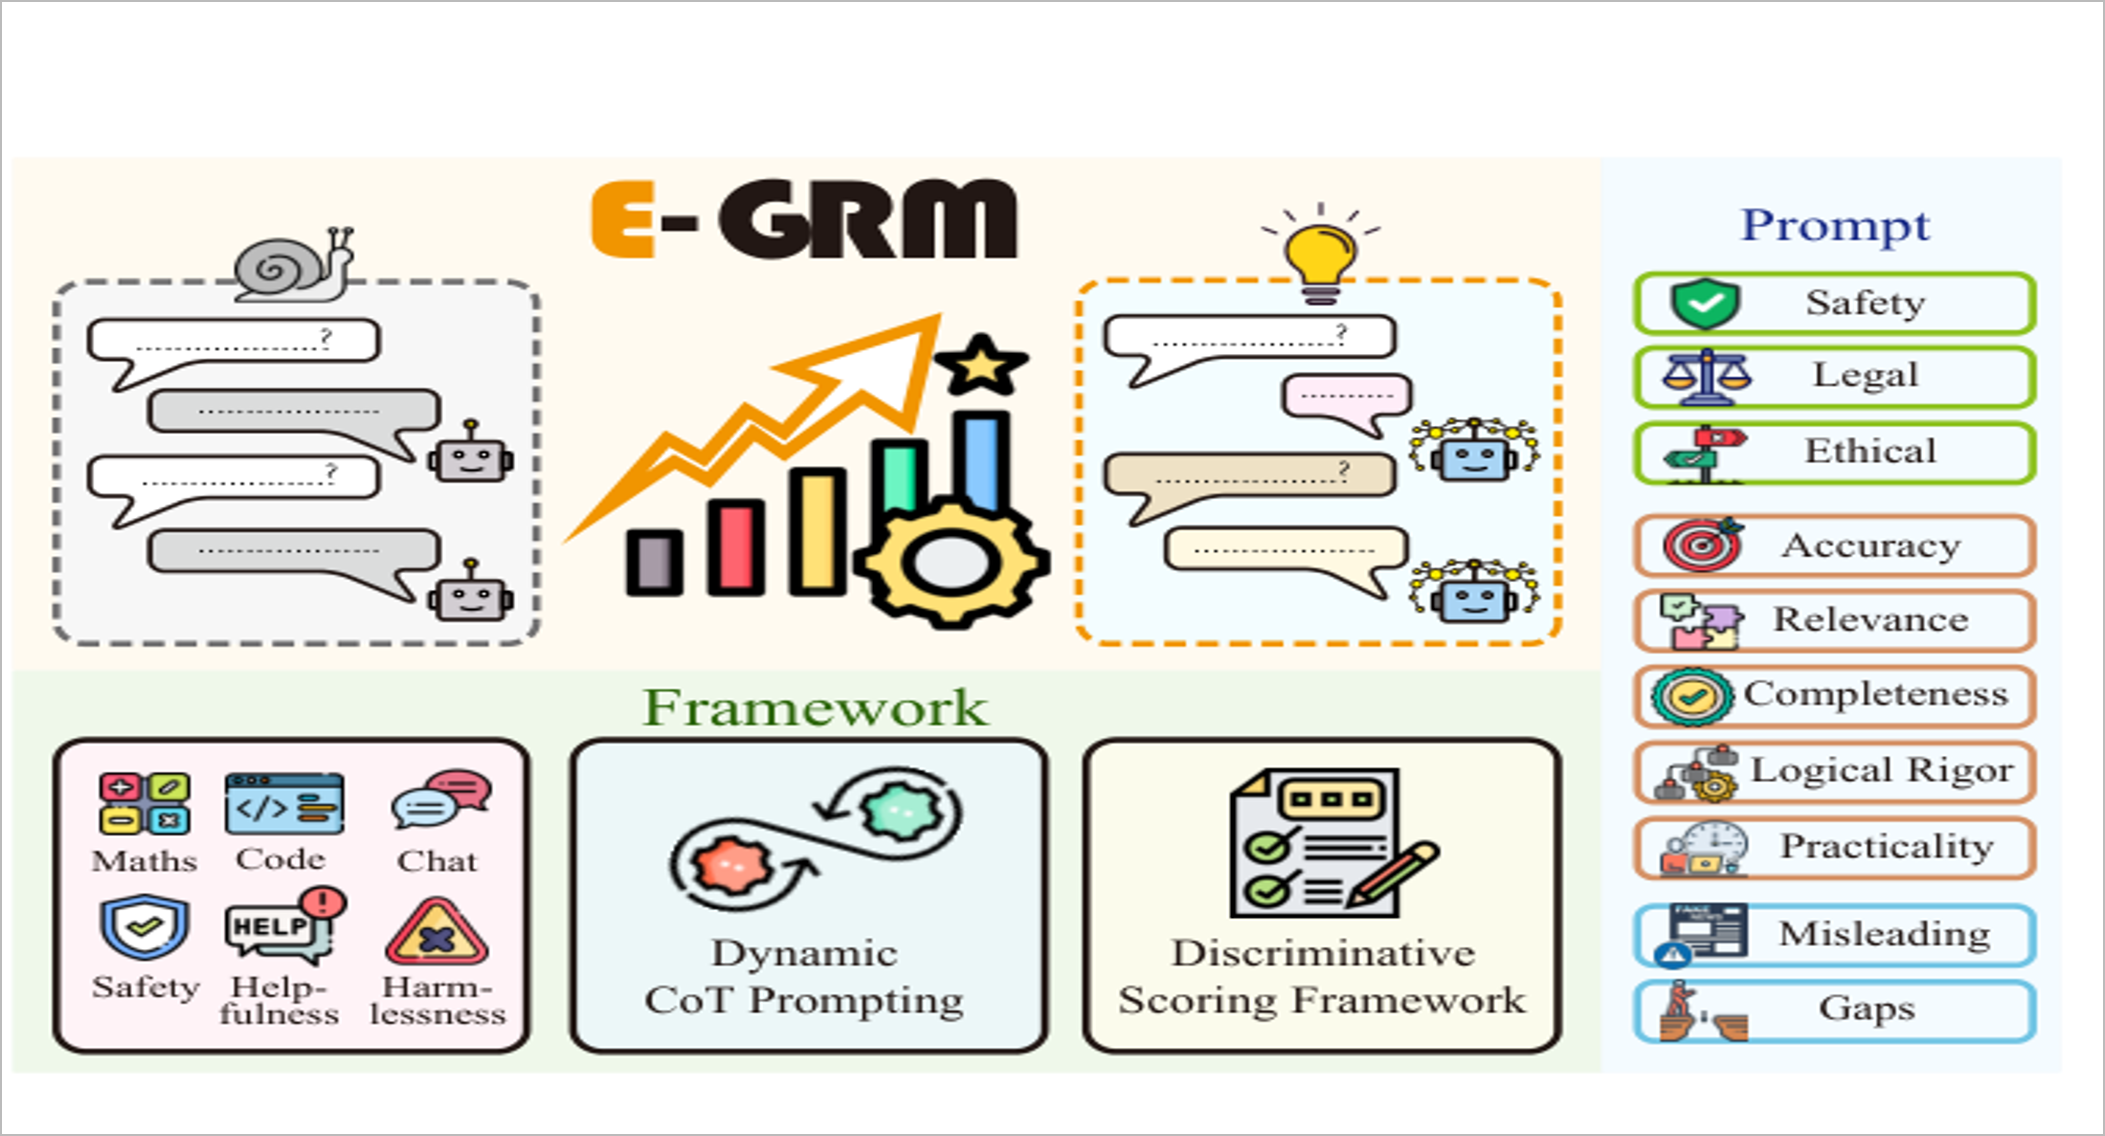
精选文章 ACL 2026 | CoT 真的是越多越好?混元提出 E-GRM, 让大模型“该省则省、该花则花”,按需推理! 论文题目:Reason Only When Needed: Efficient Generative Reward Modeling via Model-Internal Uncertainty arXiv 链接:https://arxiv.org/abs/2604.10072 作者单位:腾讯混元
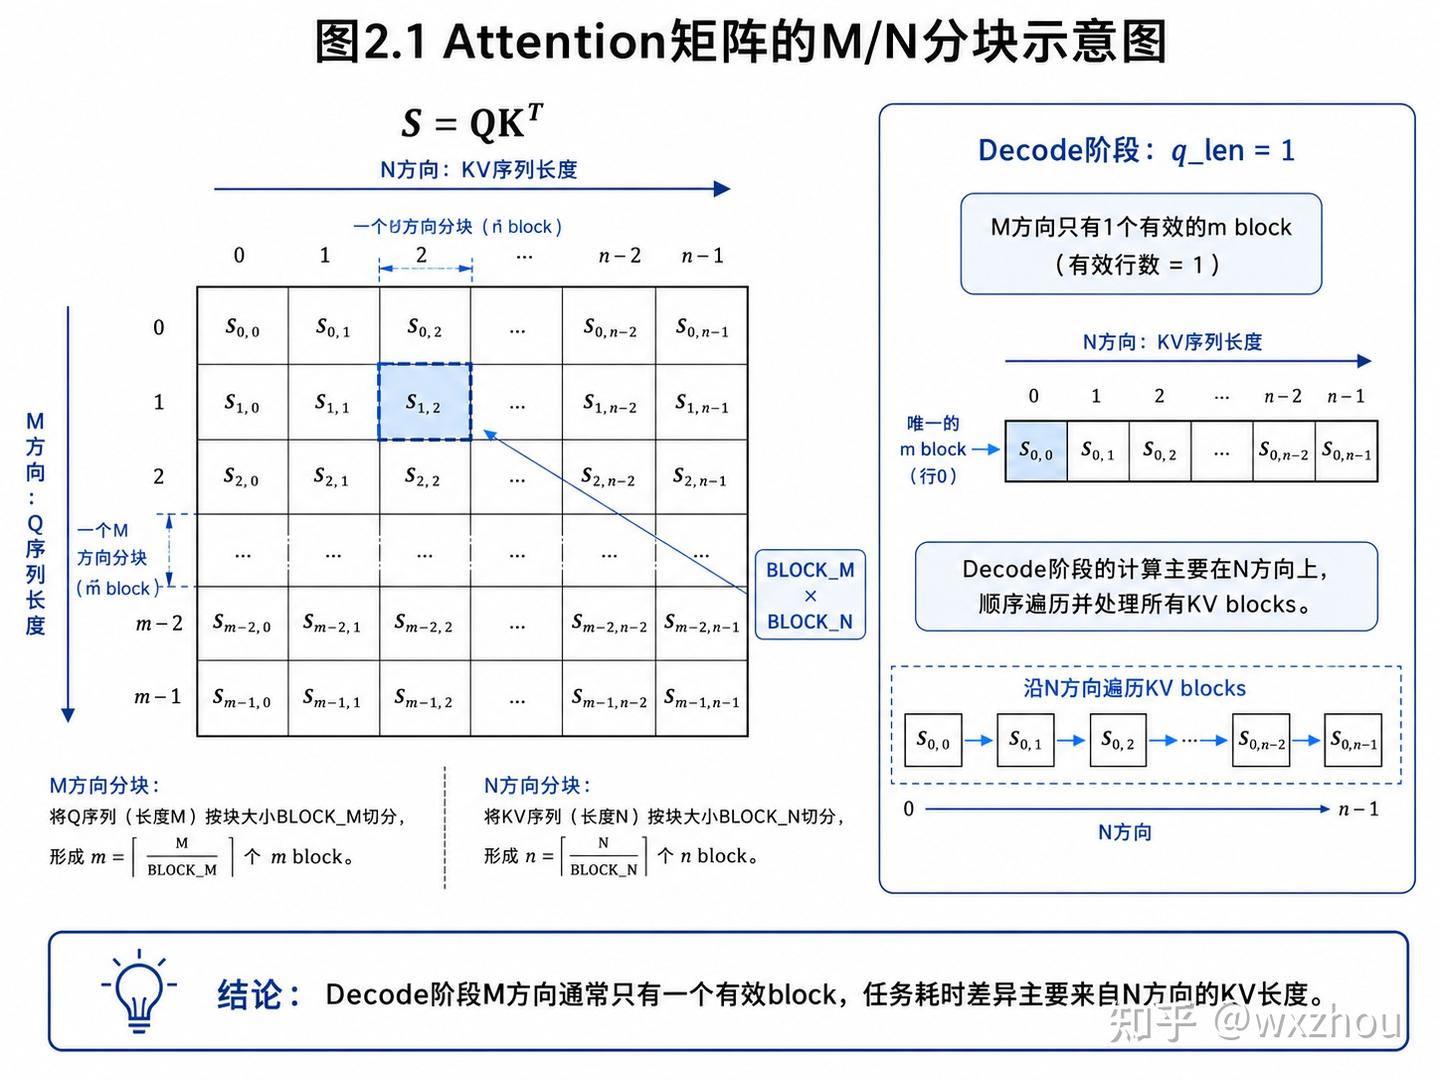
精选文章 深入解析 LLM 推理中的 Decode Batch 内部负载不均问题 作者:wxzhou https://zhuanlan.zhihu.com/p/2044873485688861958 本文仅使用大模型进行润色,并努力去除 AI 味,部分图片使用 gpt 生成。 1. 引言 先抛出一个问题:以典型 GQA 架构为例,在 LLM 推理的 Decode 阶段,Atten
青稞Talk 从 ARPO,到 AEPO,再到 Agent-World:探索通用智能体训练的可行路径 6月6日上午10点,青稞Talk 129 期,青稞社区邀请到中国人民大学高瓴人工智能学院博士生董冠霆,来直播分享《从 ARPO,到 AEPO,再到 Agent-World:探索通用智能体训练的可行路径》。 本次分享将主要围绕三篇通用智能体强化学习论文展开,沿着"智能体强化学习 → 多环境强化学习"的
青稞Talk MinT: 面向百万级 LoRA 策略的训练与推理基础设施 大模型后训练会带来一个很现实的系统问题:模型会不断产生新版本。一次强化学习实验、一个产品功能、一个客户、一组评测结果,都可能对应一种新的模型行为。基础模型本身又非常大,动辄万亿参数规模。系统如果把每种行为都保存成一份完整模型,再分别加载和部署,成本会很快失控。 MinT 是一套面向这个问题的大模型后
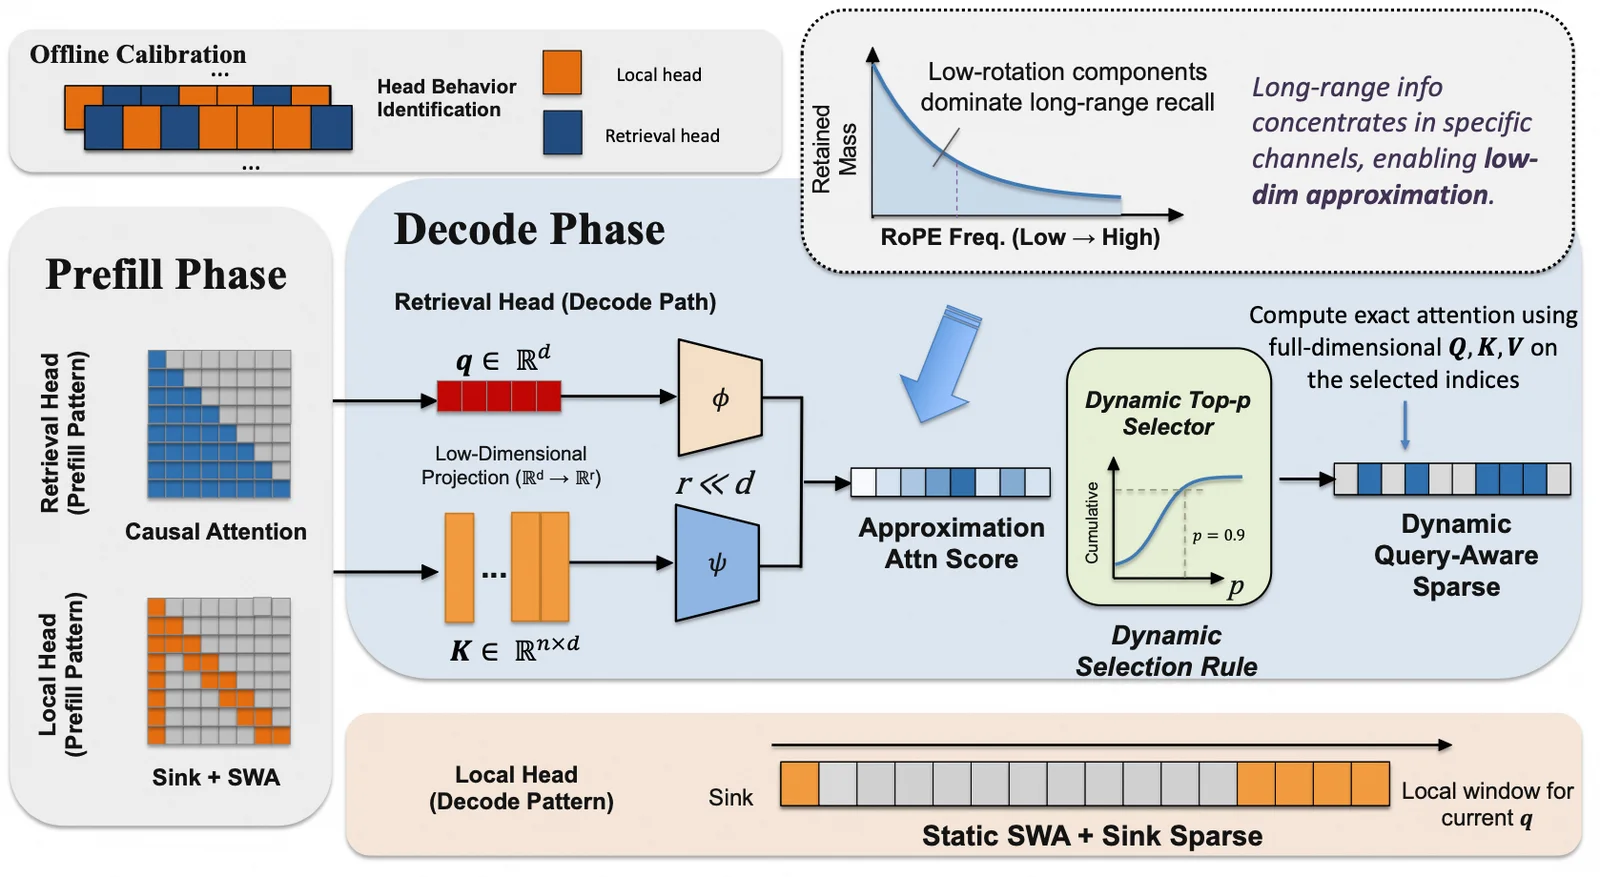
精选文章 长文本推理一定要改架构?阿里最新提出 RTPurbo:仅需百步训练,无损达到 97%+ 稀疏度与 9 倍加速 作者:周琰轲,南京大学二年级硕士研究生,阿里巴巴实习生,RTP-LLM项目核心贡献者 长上下文能力已成为现代大语言模型的基础要求,但全注意力机制(Full Attention)随序列长度呈平方级增长的计算复杂度,构成了推理阶段的核心瓶颈。为了缓解这一问题,目前业界主要探索了两条技术路线: 1.Tra
青稞Talk DeepSeek V4 模型在 SGLang 中的系统级优化与全栈适配 4月25日,当 DeepSeek-V4 带着 1.6 万亿参数(Pro版)和百万级上下文窗口的震撼配置横空出世时,整个大模型圈的目光都聚焦在了它极具野心的架构革新上:混合稀疏注意力(CSA+HCA)、流形约束超连接(mHC)以及 FP4 专家权重。 然而,对于广大开发者和企业用户而言,面对如此庞大且
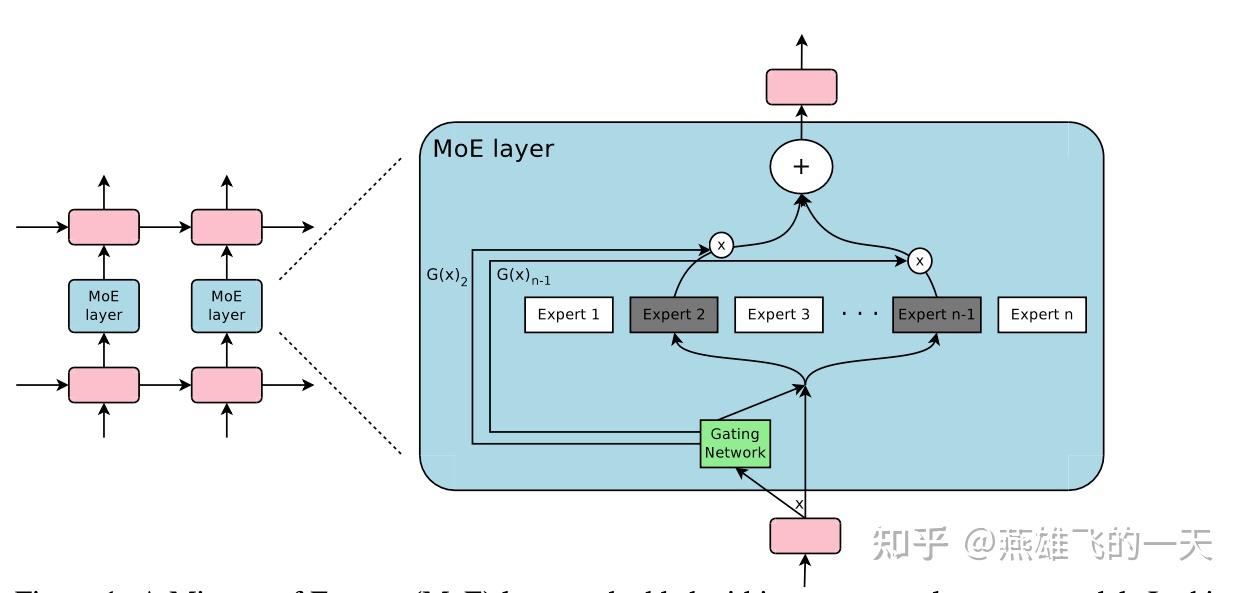
精选文章 MOE 架构如何做 SFT 和 RL?聊聊 post-training 难点与经验 作者:燕雄飞的一天 https://zhuanlan.zhihu.com/p/2018018879109091590 无论是开源还是顶尖商业模型,moe架构已经成为绝对主流,区别于dense模型,在sft和rl阶段有什么独特的训练难点或者挑战,对于这些挑战如何缓解。期望从基础原理入手,看如何训练mo
青稞Talk 从 BF16 到 FP16:如何解决RL训练-推理不匹配问题 大语言模型(LLM)的强化学习(RL)微调常因训练与推理策略间的数值不匹配而面临训练不稳定的问题。相比在算法上引入重要性采样来打补丁,我们发现直接从根源上提高浮点数的精度更加有效。 论文:Defeating the Training-Inference Mismatch via FP16 链接:ht
青稞Talk Fast-dLLM v2:高效训练推理的块扩散大语言模型框架 在往期的 #青稞Talk 中,香港大学MMLab博士生吴成岳,曾直播分享过Fast-dLLM!Fast-dLLM 是 NVIDIA 联合香港大学、MIT等机构推出的扩散大语言模型推理加速方案。 关于 Fast-dLLM 的介绍可以参考: 港大&NV&MIT开源Fast-dLLM:无需重新训练模型,直
青稞Talk RL 训练框架:QeRL 量化技术增强强化学习 Reasoning 探索 11月8日(周六)上午10点,青稞Talk 第87期,香港大学直博生黄炜,将直播分享《RL 训练框架:QeRL,量化技术增强强化学习 Reasoning 探索》。 分享嘉宾 黄炜,香港大学三年级直博生,师从齐晓娟教授。英伟达研究院Efficient AI & Learning and Percept
青稞Talk ProRL: 延长强化学习训练框架,拓展大语言模型的推理边界 7月12日上午10点,青稞Talk 第62期,英伟达公司研究员刁诗哲,将直播分享《ProRL: 延长强化学习训练框架,拓展大语言模型的推理边界》。 分享嘉宾 刁诗哲,英伟达公司研究员,曾以访问学者身份在伊利诺伊大学厄巴纳-香槟分校从事研究,并在字节跳动人工智能实验室与创新工场人工智能研究院实习。研究
青稞Talk Fast-dLLM:无需重训的扩散大语言模型推理加速 Fast-dLLM 是NVIDIA联合香港大学、MIT等机构推出的扩散大语言模型推理加速方案。 其通过分块KV缓存与置信度感知并行解码技术,在无需重新训练模型的前提下,实现了推理速度的突破性提升——在LLaDA模型1024 token长文本生成任务中,端到端推理速度狂飙27.6倍,整体耗时从266秒
青稞Talk MoLE & SpeCache:大语言模型端侧部署的架构与算法 LM在多个领域表现出强大能力,尽管在线服务广泛应用,但出于隐私和离线需求,个人常需要端侧部署。然而,现有的基于MoE和Transformer架构的LLM在端侧部署时面临显存容量不足的挑战。 5月22日20:00,青稞Talk 第50期,北京大学智能学院博士生、华为诺亚方舟实验室实习生节世博,将直播分
青稞Talk SGLang v0.2:面向 LLM 和 VLM 的快速、高效通用服务引擎 9月3日11点,青稞Talk第21期,Databricks Mosaic Research研究科学家,斯坦福大学博士盛颖 ,将直播分享的《SGLang v0.2:面向 LLM 和 VLM 的快速、高效通用服务引擎》。 主讲嘉宾 盛颖,Databricks Mosaic Research研究科学家,斯