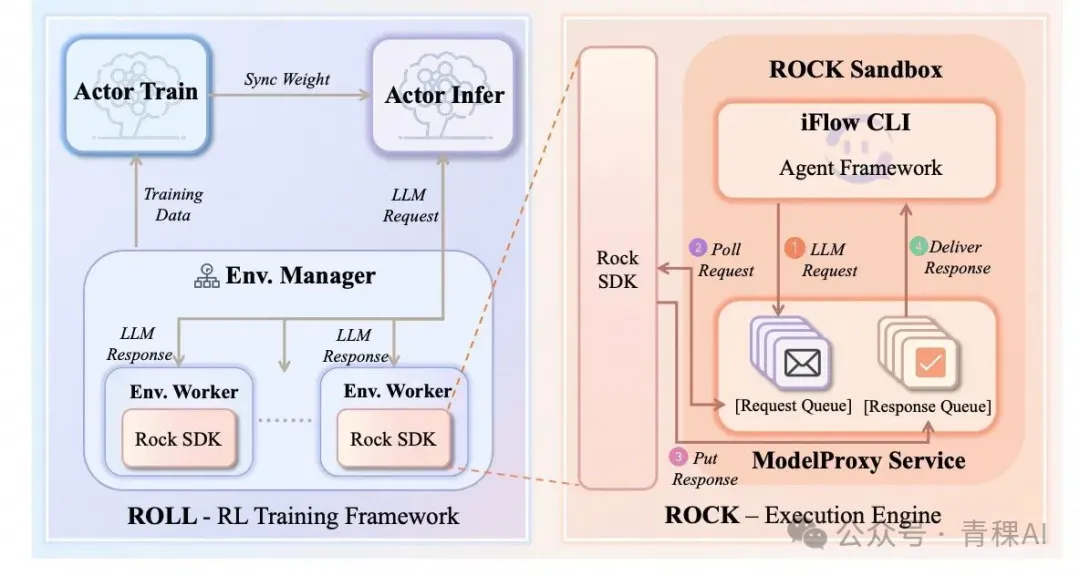
精选文章 苦涩的教训!ROLL团队分享:Agentic RL 训练中的实践经验 作者:Yancheng He, Weixun Wang, and Xiaoyang Li | Project Leader: Weixun Wang English Version:https://www.notion.so/The-Bitter-Lesson-Behind-Building-Age
精选文章 2026,进入 Agent RL 时代! 序章:三条哲学 在探讨技术之前,我们需要先确立三条基石性的认知: 人类的本质:人类在生物界的独特性在于高等智慧,而人与动物的分野,在于制造与使用工具的能力。 大模型的定位:ChatGPT 标志着人类首次赋予机器高等智慧。大模型之于现代人类,如同智慧之于原始人类,不仅不可或缺,更不可退化。 Agent
青稞Talk 深度对话!2025 “青稞” AI 嘉年华,与 20+ 位青年科学家一起探讨AI 技术瞬间 本次活动专为青年科学家打造,旨在搭建一场 AI 技术的深度对话,来自学术和工业界的 20+ 青年科学家,将与大家一起回顾 2025,展望 2026!
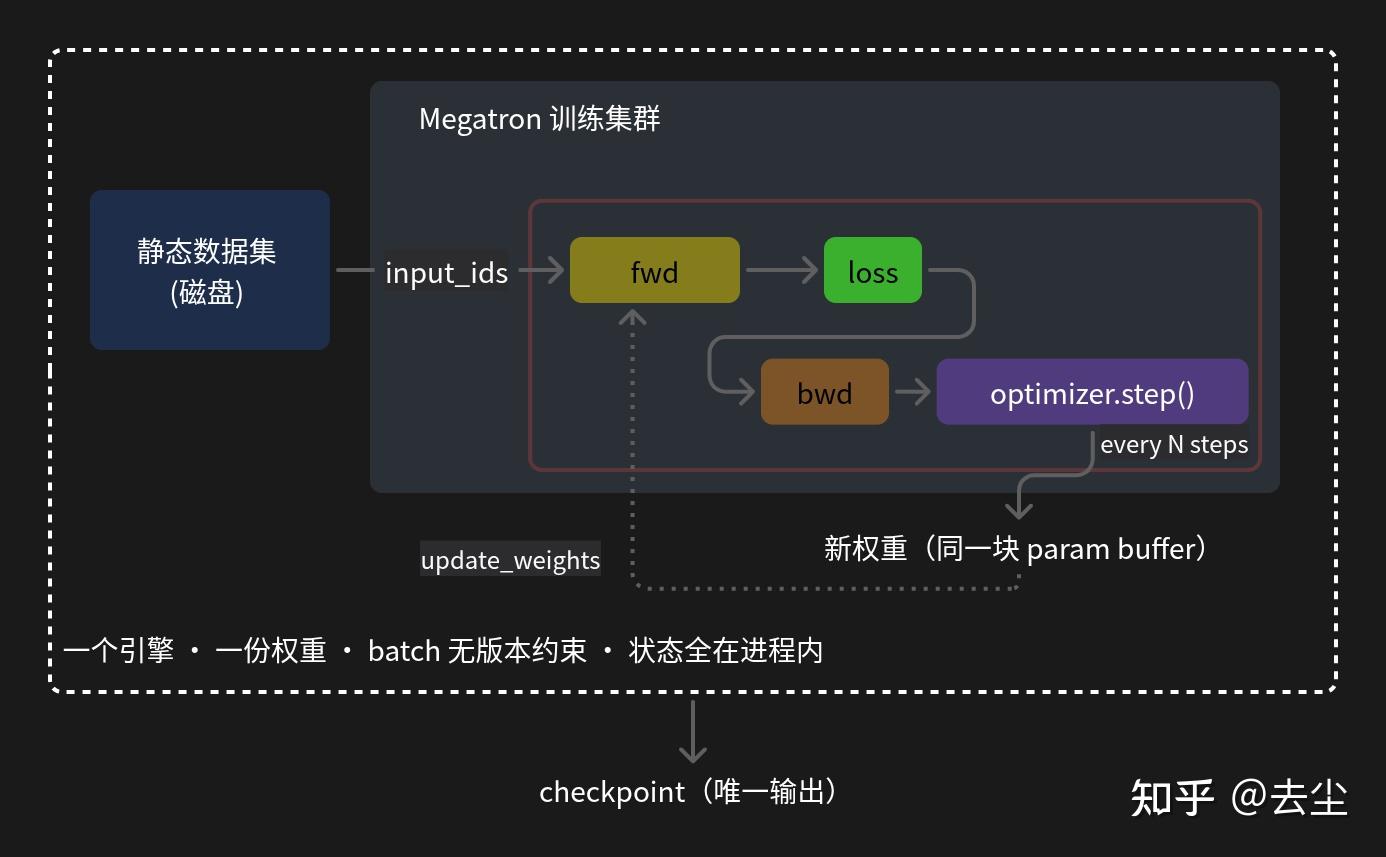
精选文章 从 SFT 到 RL:Infra 复杂度的三次跃迁 写在前面 写这篇文章是一次极其耗费心力的长途跋涉。发出了希望能和大家一起交流。 但受限作者个人的认知边界,书中内容难免存在疏漏、偏颇甚至错误之处。技术的探讨在于碰撞与纠错,若各位朋友在阅读时发现笔误、或者是作者思路狭窄未能理解核心奥义,非常欢迎指正交流。 作者:去尘 https://zhuanlan
青稞Talk 直播预告!聊聊 RL-Kernel ,大模型 RL 后训练中的训推一致性实践 大模型的 RL 后训练里,有一个常被忽略、却可能让训练悄悄跑偏的隐患。 Rollout 与 Training 往往由两套不同的引擎执行。即使模型、权重、token 完全相同,两边的 LogP 也可能对不上——浮点归约顺序、并行分片、通信合并树、精度转换边界,任何一处不同,都会在数值上分叉。 一个直观
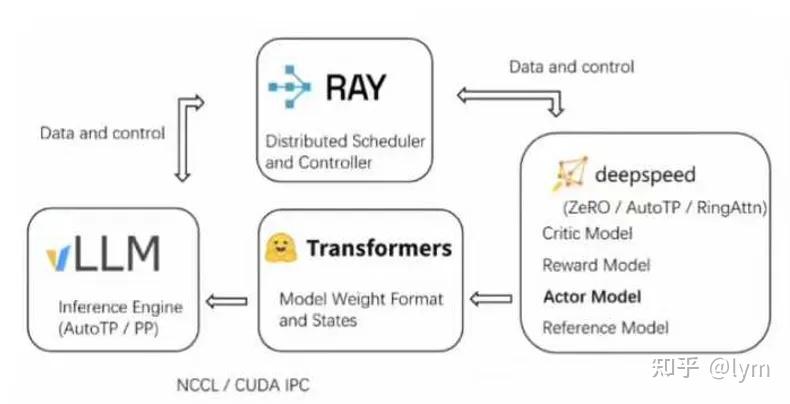
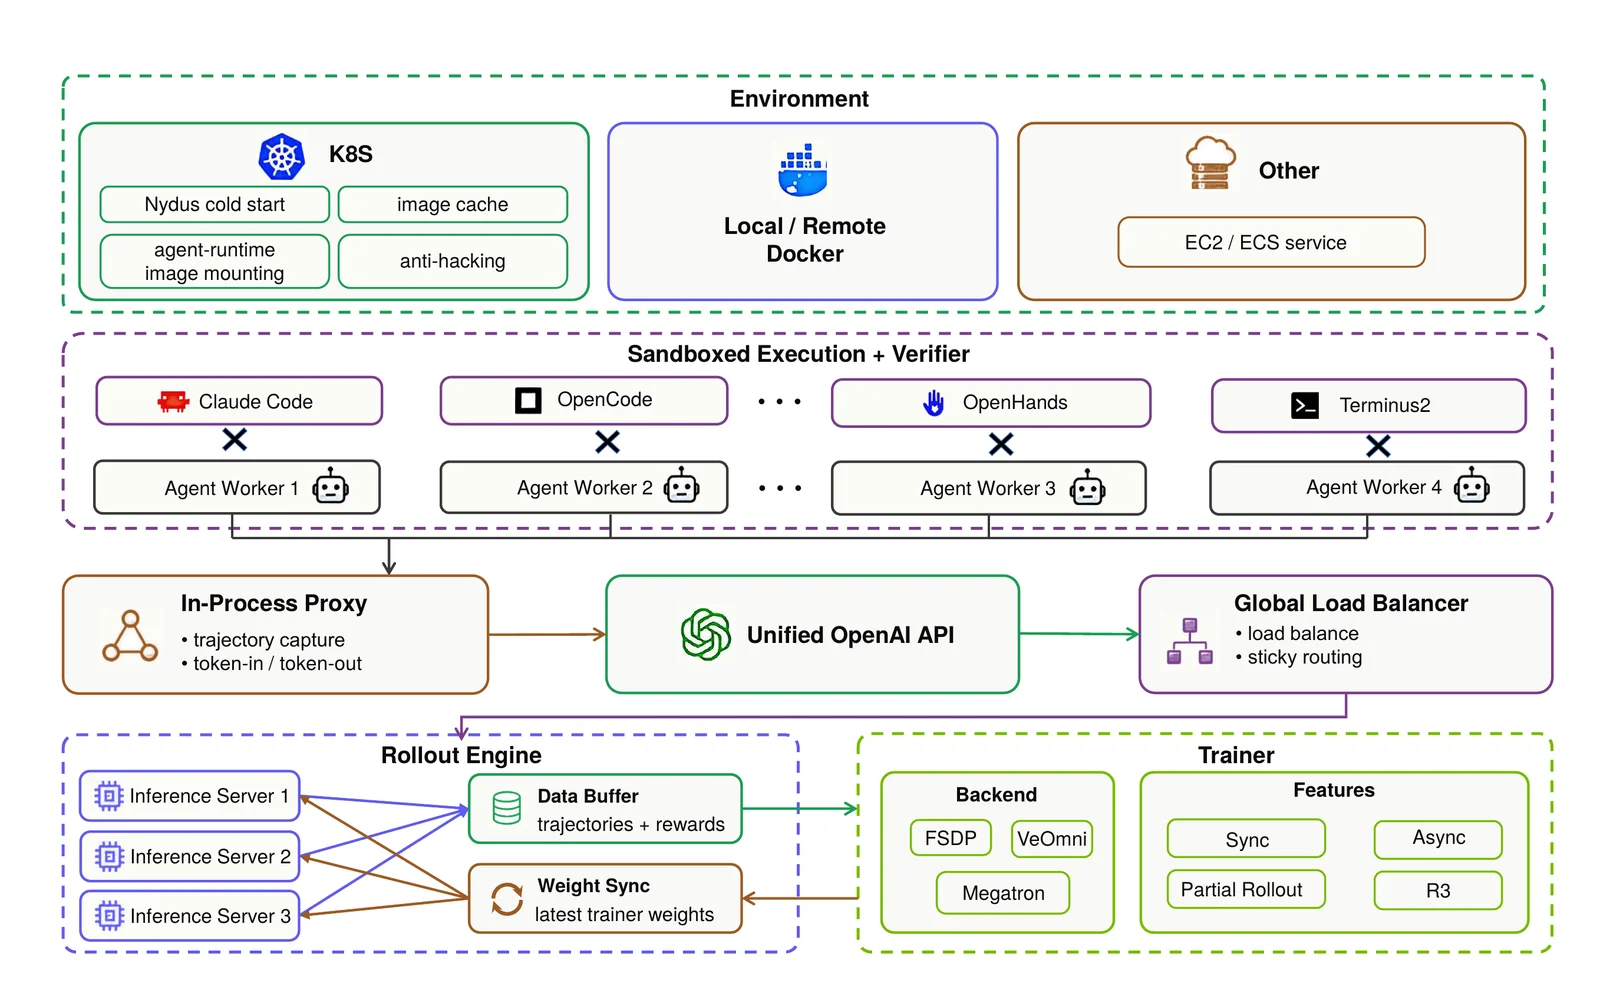
精选文章 Agentic RL Infra 主流技术路线综述 做Agentic rl infra也有一段时间了,这期间也一直在跟进国内几家头部大模型公布的RL infra技术细节, 感觉到这个时间点,技术路线已经逐渐趋近收敛, 不太像去年年底那时候agentic rl infra还是刚起步的蛮荒状态。 本文基于 11 份 2025–2026 年公开技术报告与官
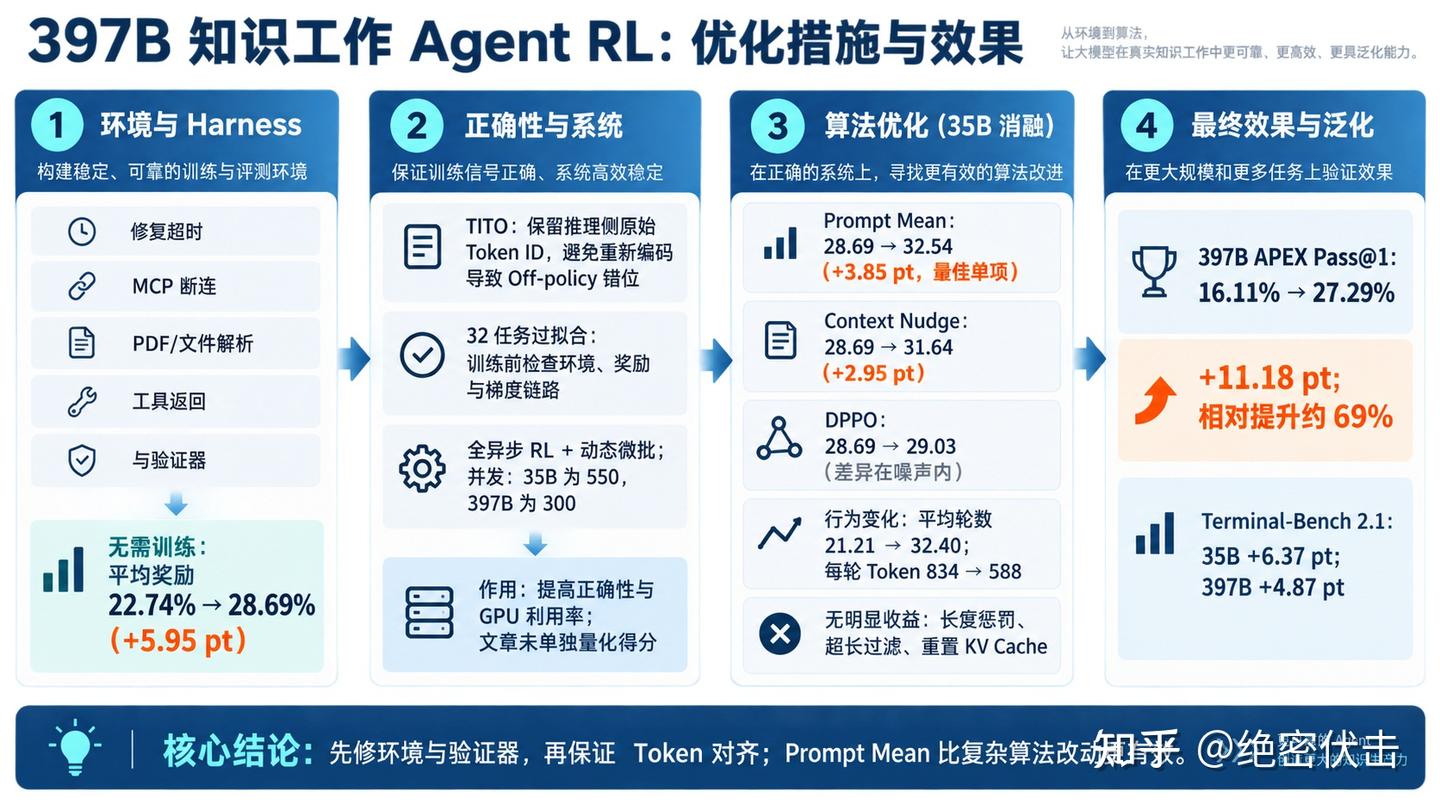
精选文章 LoRA 一作、OpenAI o1 核心成员的新工作:首次公开 397B 模型的 Agent RL 训练配方 LoRA 第一作者、OpenAI o1 核心成员 Edward Hu 近期加入 Mercor,担任 Head of AI Modeling。他加入后的首批公开成果之一,便是与 SkyRL 团队联合发布的一套面向复杂知识工作 Agent 的强化学习方案。 这项工作并未止步于公布最终结果,而是系统公开了
青稞Talk 周六上午10点!聊聊 RL 后训练框架 SkyRL,以及 397B Agent 的 RL 训练实战 当 Agent 训练从「只训模型」走向「模型 + 环境 + Harness」的协同,有了 RL 数据、也有了 RL 框架之后,接下来该做什么?这大概是一些刚开始做 Agentic RL 的企业团队会遇到的问题。 9月19日(周六)上午10:00,青稞Talk 第155期,青稞社区邀请到 SkyRL
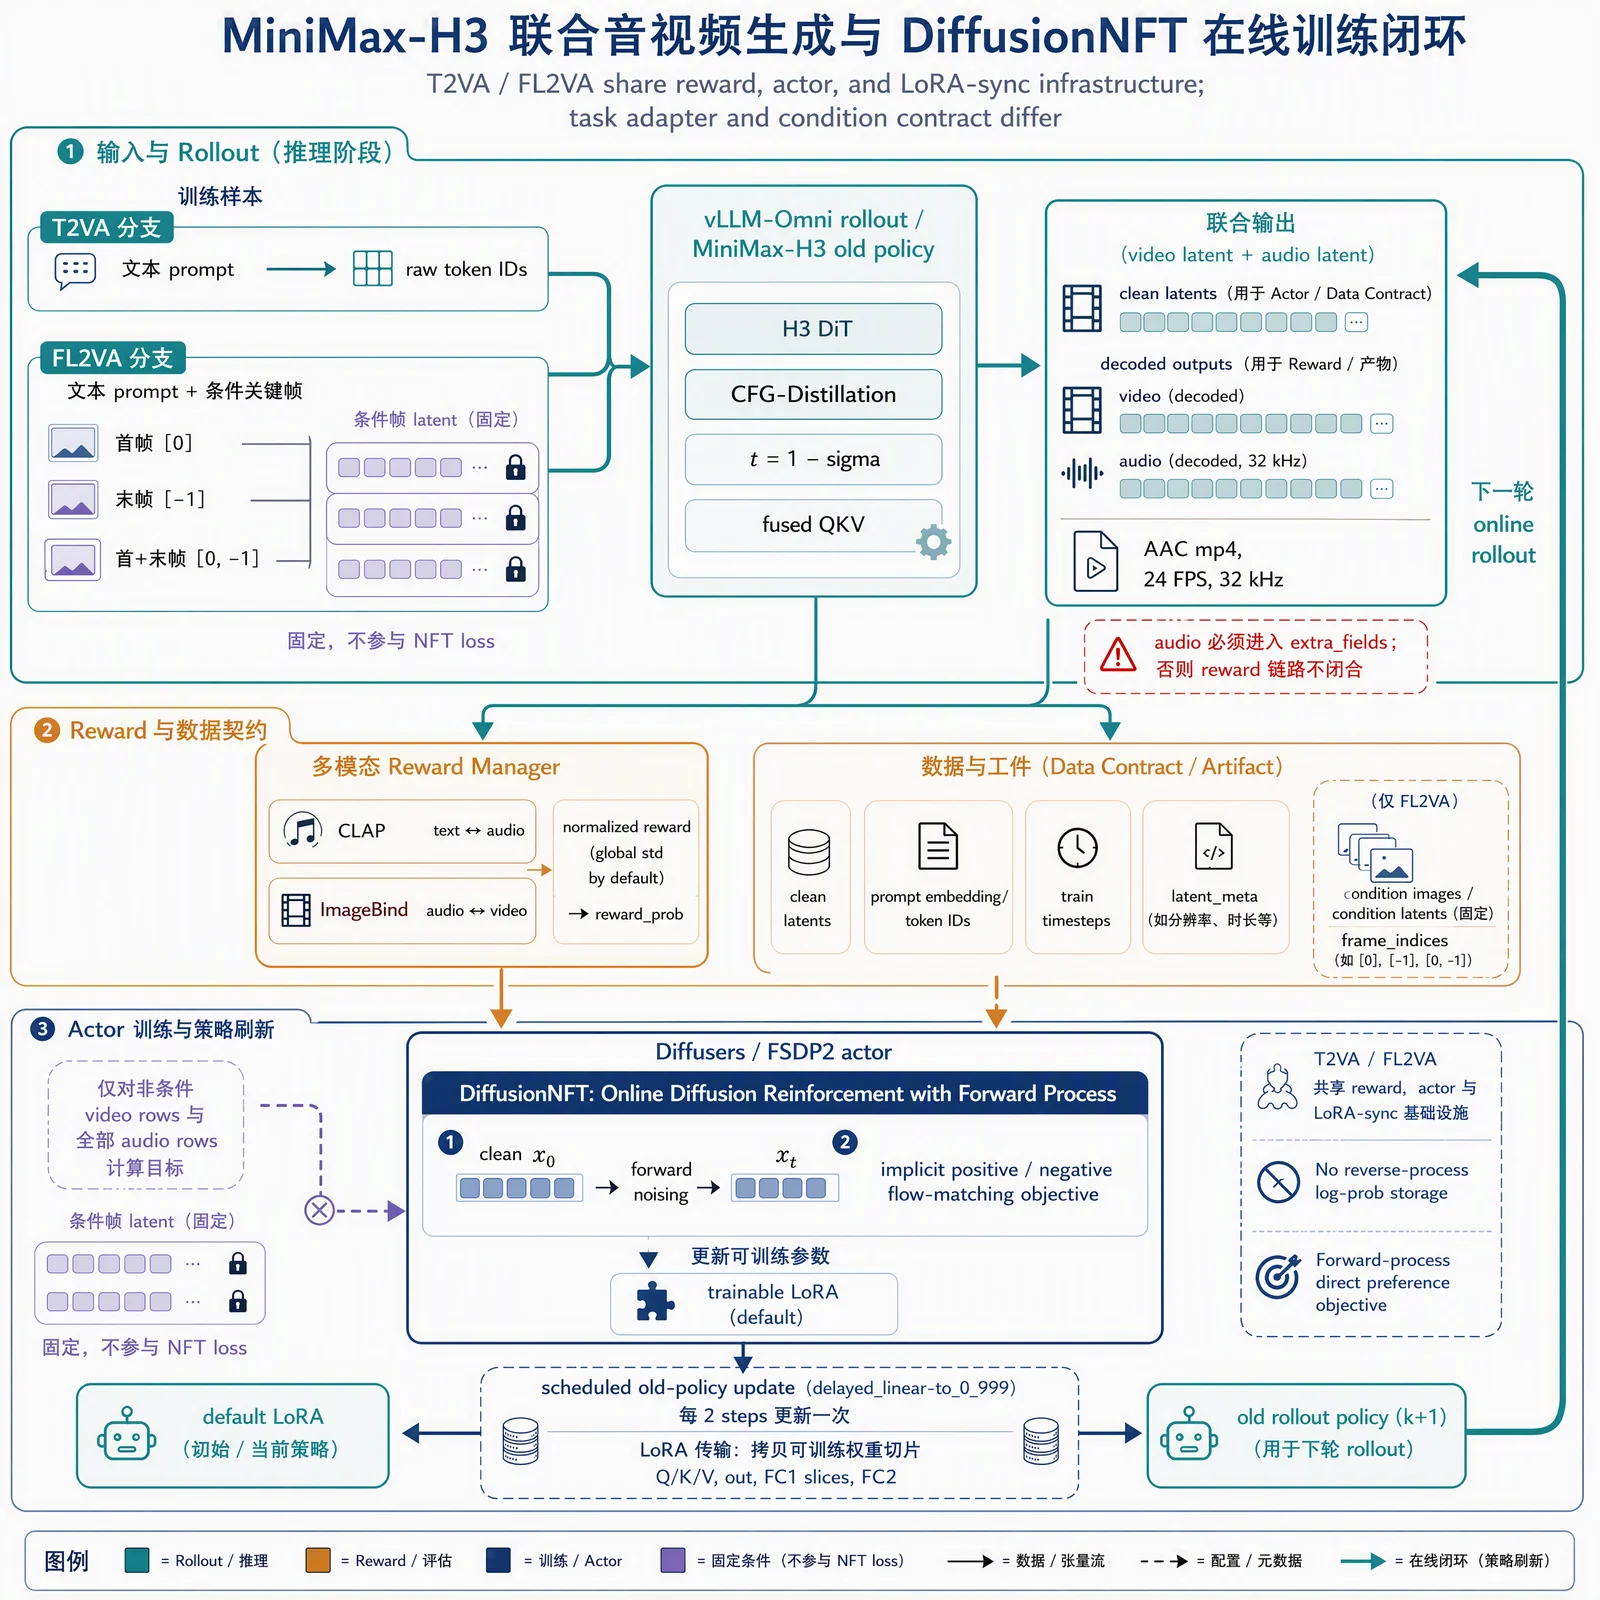
精选文章 MiniMax-H3 音视频生成 RL 后训练:基于 VeRL-Omni 的开源实践 引言 MiniMax-H3 是当前开源社区中最受关注的音视频生成模型之一。它是一个通用的多模态生成模型,接收文本、图像、视频、音频等多种输入,直接输出带原生立体声音轨的视频,支持最长 15 秒、最高 2K 分辨率、24 FPS、32 kHz 立体声。 在 Artificial Analysis 的
精选文章 华为&港中文最新开源 Lego-RL:让 Coding Agent 的强化学习训练真正"长稳可靠" Lego-RL 是一套面向 Coding Agent 的强化学习训练框架,也是 LegoX 系列的最新工作,由华为与香港中文大学联合团队完成。 论文:https://arxiv.org/abs/2608.17393 代码:https://github.com/LegoX/Lego-RL 文档:htt
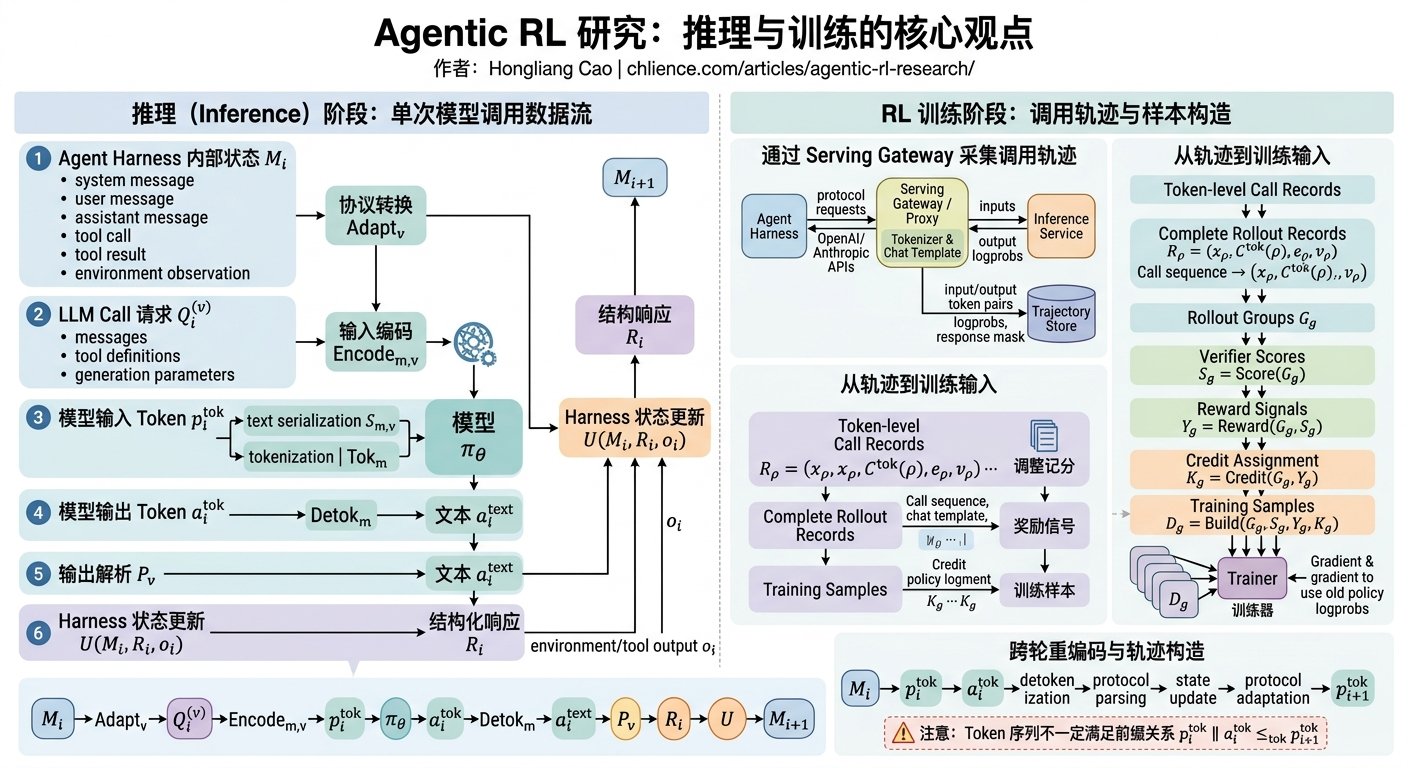
精选文章 聊聊 Agentic RL 中的多轮 rollout、上下文重建与 RL 训练 作者:Hongliang Cao https://chlience.com/articles/agentic-rl-research/ 推理 一次模型调用 对于一次典型的 agentic inference,第 i 次模型调用可以分为三个层次:agent harness 维护的内部状态、按照特定协议
精选文章 为什么复杂 RL 离不开分布式系统,分布式 RL 的核心矛盾又是什么? 作者:觉醒也醉了 https://zhuanlan.zhihu.com/p/2047396735169908748 一、为什么复杂 RL 离不开分布式系统 近年来,强化学习(Reinforcement Learning, RL)在复杂决策任务中取得了大量突破,尤其是在游戏 AI、机器人控制等领域,以
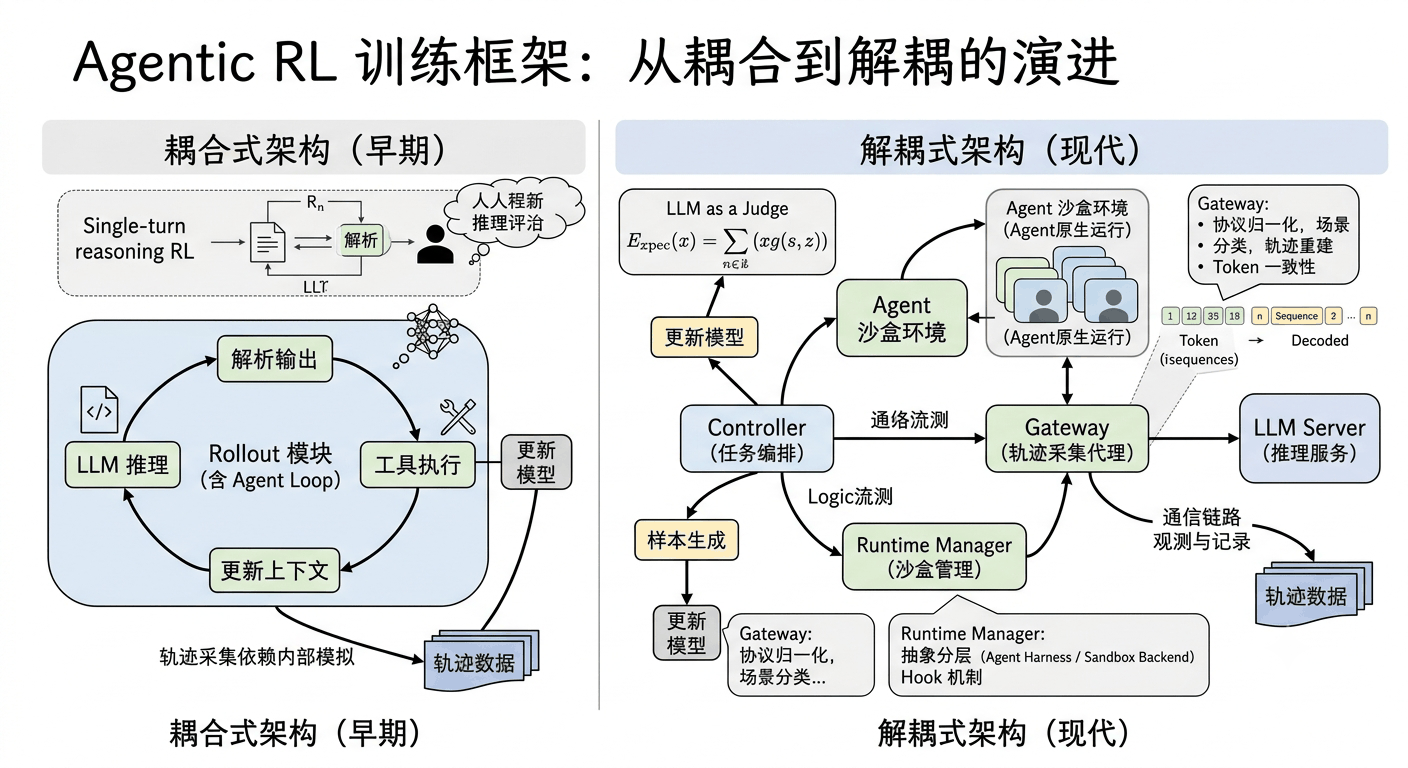
精选文章 从 LLM Rollout 到 Agentic Rollout!Agentic RL 训练框架设计中的一些总结和思考 作者:水木SH https://zhuanlan.zhihu.com/p/2062647902879667967 前言:前段时间支持了团队的Agentic RL训练工作,在框架开发过程中碰到诸多问题,有了一些新的思考,在此进行记录。 一、从 LLM Rollout 到 Agentic Rollout
精选文章 又造一个 RL 框架?Agentic RL Research 框架 Molt:9K 行核心 RL 代码、纯 PyTorch! 作者:初七9527 https://zhuanlan.zhihu.com/p/2060313194971846263 TL;DR Molt 是一个 agentic-first、纯 PyTorch-Native 的强化学习框架: 约 9,000 行核心 RL 代码,你能一口气从 CLI 追到执行分支;
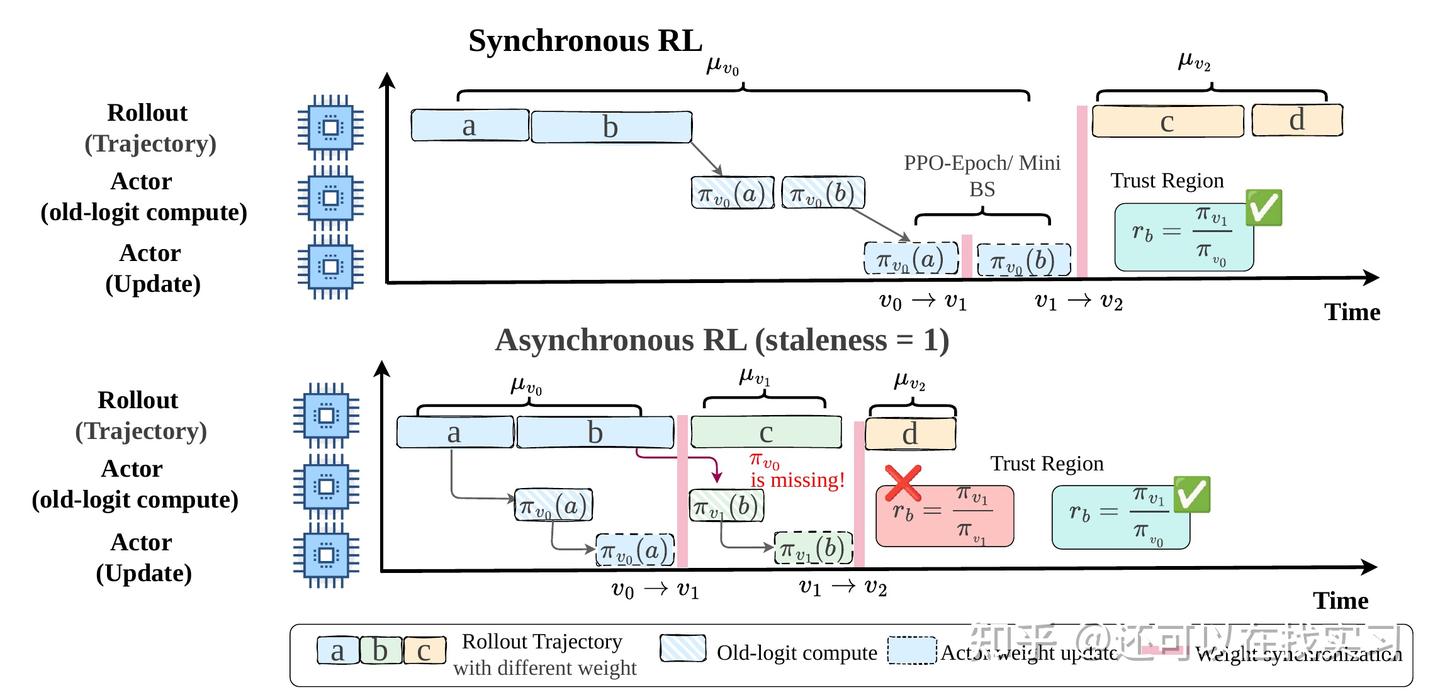
精选文章 当异步 Agentic RL 遇到“旧策略失忆”:重新理解 Off-Policy Correction 作者:还可以在找实习 https://zhuanlan.zhihu.com/p/2038002855374753895 欢迎关注我们关于异步 Agentic RL 的最新工作。本文聚焦一个在大规模 LLM 强化学习系统中非常基础、但经常被忽略的问题:当 rollout 和 training 异步解耦
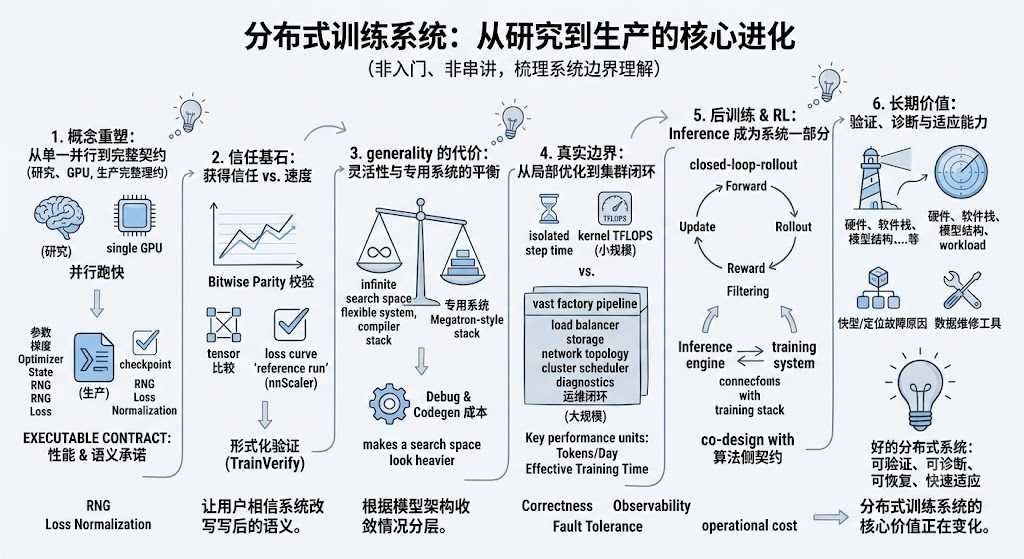
精选文章 从 nnScaler 到大规模训练:谈一谈对分布式训练系统边界的一些理解 作者:朱翼 https://zhuanlan.zhihu.com/p/2056045172111177252 这篇文章来自我最近准备的一个技术分享。原本的主题是 “Distributed Training Systems: From Research to Production”。整理成博客时,我不
精选文章 深入理解 Agentic RL 中的行为崩塌现象 作者:Jason 原文:https://zhuanlan.zhihu.com/p/2050794185909876253 过去一段时间里,我一直在思考一个问题:Agentic RL 到底和传统 RLVR 有什么本质区别? 最容易想到的答案当然是工具调用。传统 RLVR 往往围绕单轮回答展开,模型生成
青稞Talk 直播预告!一起聊聊腾讯混元最新开源的 UniRL:面向统一多模态模型的分布式 RL 后训练框架 目前多模态领域 RL 仍然缺少生成理解统一的 Infra。图像 / 视频的生成、理解,Prompt-Enhancer (PE),以及 HunyuanImage-3.0、Bagel 等 unified multimodal models,通常都需要各自维护 rollout、reward、advanta
精选文章 slime v0.3.0 发布: 重新思考面向 Agent 时代的 RL 训练框架 作者:朱小霖 原文:https://zhuanlan.zhihu.com/p/2044533166694732929 毫无疑问,OpenClaw 和 Opus 一起撞开了 agent 时代。 slime 从一开始坚持的 server-based engine + custom rollout 设计,
青稞Talk MinT: 面向百万级 LoRA 策略的训练与推理基础设施 大模型后训练会带来一个很现实的系统问题:模型会不断产生新版本。一次强化学习实验、一个产品功能、一个客户、一组评测结果,都可能对应一种新的模型行为。基础模型本身又非常大,动辄万亿参数规模。系统如果把每种行为都保存成一份完整模型,再分别加载和部署,成本会很快失控。 MinT 是一套面向这个问题的大模型后
青稞Talk DeepSeek V4 模型在 SGLang 中的系统级优化与全栈适配 4月25日,当 DeepSeek-V4 带着 1.6 万亿参数(Pro版)和百万级上下文窗口的震撼配置横空出世时,整个大模型圈的目光都聚焦在了它极具野心的架构革新上:混合稀疏注意力(CSA+HCA)、流形约束超连接(mHC)以及 FP4 专家权重。 然而,对于广大开发者和企业用户而言,面对如此庞大且
精选文章 拆解 Gemma 4 架构和训练的技术选择,以及与 Qwen3 和 GLM-5 的对比 作者:方弦 https://zhuanlan.zhihu.com/p/2023880667814003300 2026年4月2日,Google DeepMind发布Gemma 4。31B参数的dense模型在AIME 2026上拿到89.2%,MoE变体26B-A4B以3.8B活跃参数在MMLU P
精选文章 从推理架构的角度,谈谈 Attention Residual 架构一些背后的想法 作者:YyWangCS https://zhuanlan.zhihu.com/p/2017528295286133070 前言 作为月之暗面 AI Infra 团队的一员,这篇文章我想从 AI Infra,尤其是推理架构的角度(关于训练,我们的同事有一篇非常好的回答,推荐读一下,这里就不多谈了),聊
精选文章 从 ROLL、ForgeRL、Seer 和 ThunderAgent,看 26 年 Agentic RL Infra 优化方向 作者:attack204 https://zhuanlan.zhihu.com/p/2007250216227729670 调研了一些目前Agentic-RL场景下对Infra的一些需求,主要内容都来自于各家大厂的文章 值得一提的是除了最后一篇Seer的文章外,其他3篇都是春节期间发布的,LLM还是
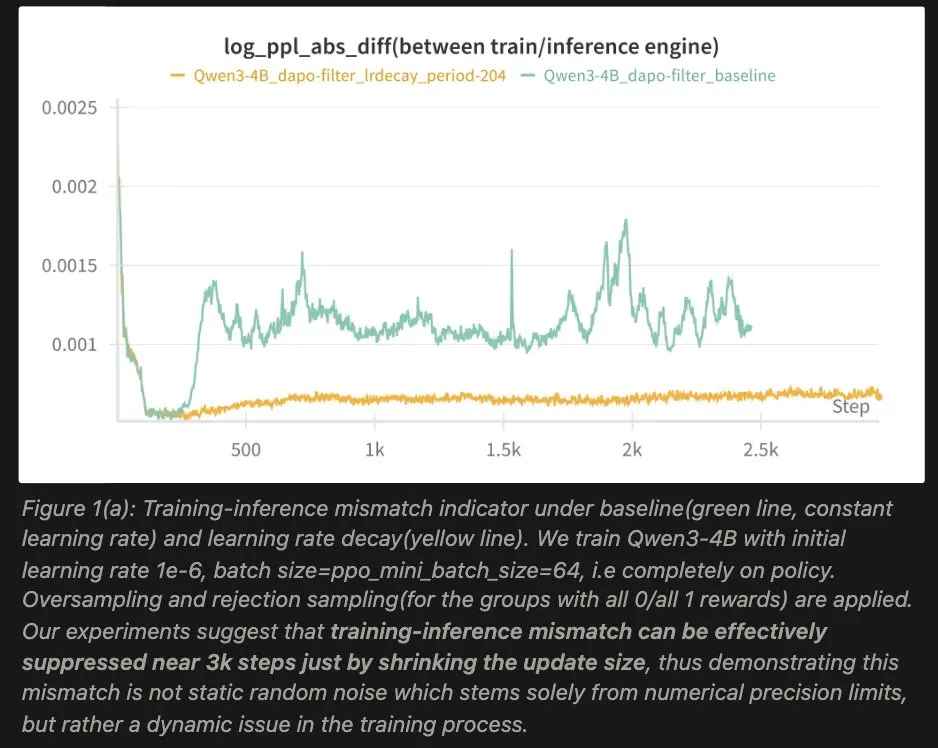
精选文章 超越精度:为什么训练-推理不一致是一个优化问题,以及简单的学习率调度(LR Scheduling)如何修复它 在 LLM 强化学习(RL)的训练中,有一个长期困扰算法工程师的“幽灵”:训练-推理不一致(Training-Inference Mismatch) 。很多时候,你会发现训练开始阶段一切正常,但是一段时间后训练引擎和推理引擎生成token的概率分布就有可能越来越远,accuracy断崖式下跌。 主流
精选文章 2025 Agentic RL 经验总结!这一年的弯路、暴论和下一步思考 作者:乞力马扎罗雪人 https://zhuanlan.zhihu.com/p/1992730229291111674 2025 年无疑是 Agentic RL 的“混战元年”。这一年从零到一做了很多尝试,认知也在不断刷新,这一篇不是严谨的博客或笔记分享,都只是当下的想法。 LLM 很有意思的一点是
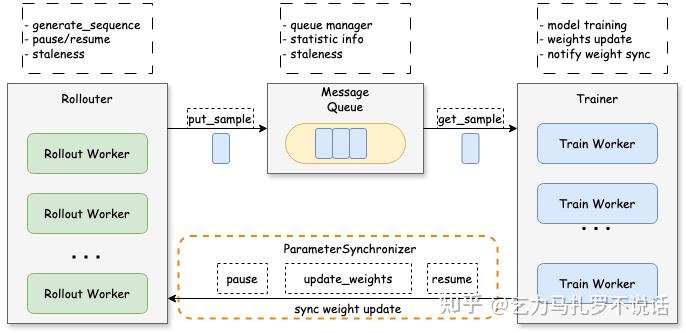
精选文章 工业级 Agentic RL 训练对比选型指南 作者:乞力马扎罗不说话 https://zhuanlan.zhihu.com/p/1978600046514685178 这篇博客想法诞生于上半年基于 trl / verl 魔改 agentic rl 时期,但拖延一直搁置。眼看相关技术栈演进速度惊人,再不发出来就要过气了,于是决定抛砖引玉分享。预计
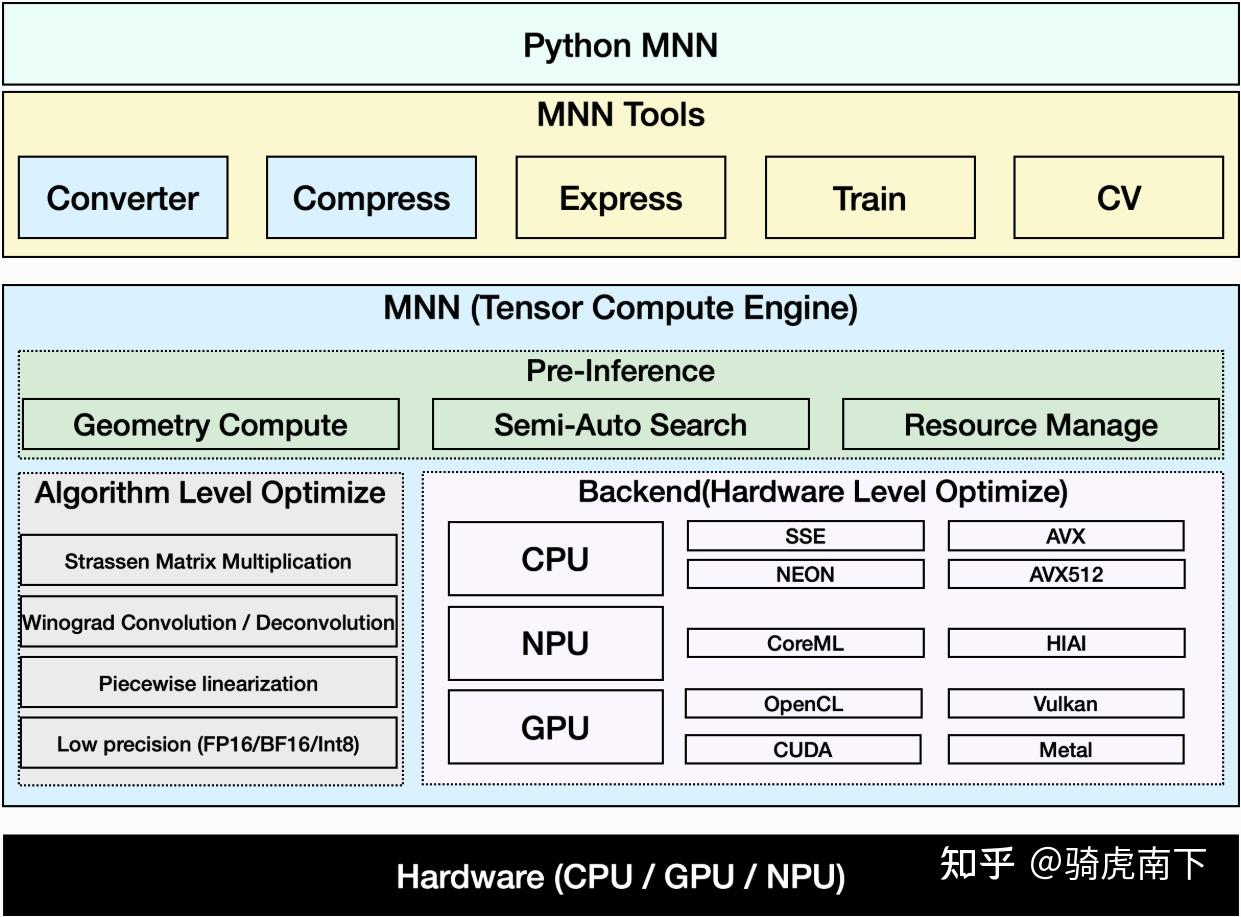
精选文章 聊聊小模型与大模型下的推理框架 作者:骑虎南下 https://zhuanlan.zhihu.com/p/1931235792501608813 这里,分两个主要模块介绍AI模型推理引擎整体架构与主要功能。回顾AI落地的发展过程,我们可以简单地将AI模型的发展分为小模型领域与大模型领域。 在小模型领域以CNN模型为主,模型结构变化
青稞Talk NeMo RL:让大规模 MoE 模型权重 Refit 加速 10 倍 9月6日(周六)上午10点,青稞Talk 第76期,英伟达NeMo团队高级深度学习算法工程师李之愈,以及高级产品经理高文雯,将直播分享《NeMo RL:让大规模 MoE 模型权重 Refit 加速 10 倍》。 分享嘉宾 李之愈是英伟达NeMo团队高级深度学习算法工程师,专注于大语言模型预训练以及后
青稞Talk ROLL:面向 Agentic 场景的生产级大规模强化学习训练框架 8月23日(周六)上午10点,青稞Talk 第74期,淘天集团未来生活实验室算法专家王维埙博士,爱橙科技智能引擎算法平台大模型强化学习框架工程师熊绍潘,将直播分享《ROLL:面向 Agentic 场景的生产级大规模强化学习训练框架》。 代码:https://github.com/alibaba/RO
青稞Talk slime:专为 RL Scaling 设计的大规模 RL 训练框架及实践 8月2日(周六)上午10点,青稞Talk 第68期,智谱 AI RL Infra 工程师、slime 开源项目作者朱子霖,将直播分享《slime:专为 RL Scaling 设计的大规模 RL 训练框架及实践》。 https://github.com/THUDM/slime 关于slime的分析可