青稞Talk 深度对话!2025 “青稞” AI 嘉年华,与 20+ 位青年科学家一起探讨AI 技术瞬间 本次活动专为青年科学家打造,旨在搭建一场 AI 技术的深度对话,来自学术和工业界的 20+ 青年科学家,将与大家一起回顾 2025,展望 2026!
精选文章 从“能回答”到“该回答”,大模型离负责任的判断还有多远?UtilityBench 揭示大模型的责任边界 大模型已经成为许多人学习和工作中的帮手。但你有没有想过:它答错一道数学题,和给出一条错误的用药建议,能算同一种错误吗? 如果大模型答错一道数学练习题,你可能只需要重新计算;给错一次出行建议,你可能会错过一趟火车;但如果它给出错误的用药建议,甚至可能会危及生命。这三个错误产生的现实后果显然不同。但在准
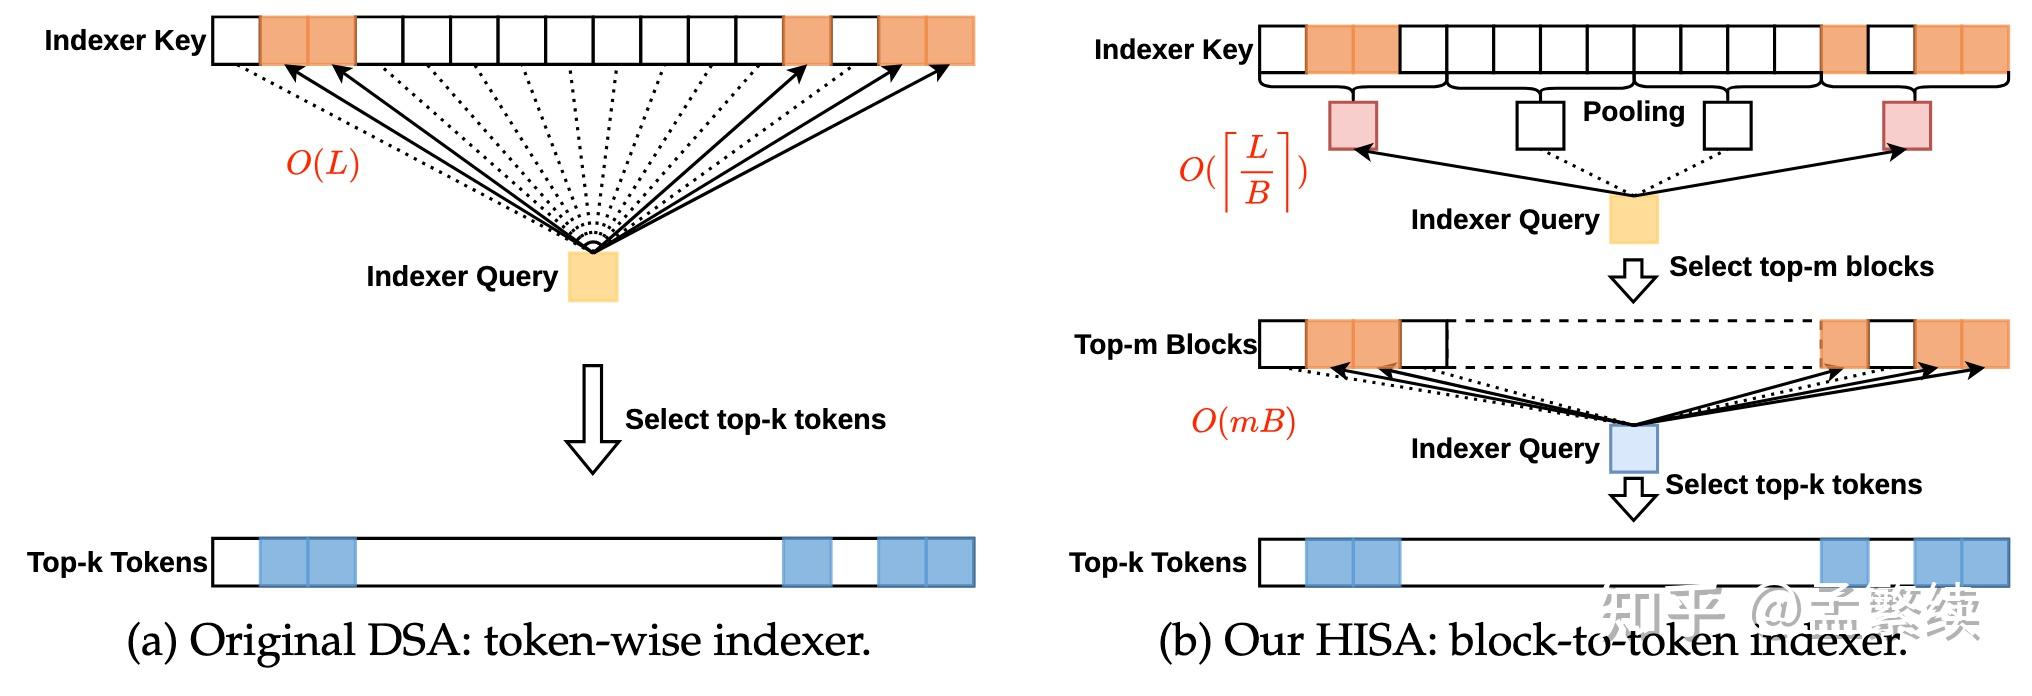
精选文章 字节最新论文意外“背刺”DeepSeek-V4?一文讲透 HISA 如何终结 CSA 的相位敏感性 碎碎念 DeepSeek-V4发布CSA的时候,我对比了一下HISA和CSA的异同,跟身边的同学说,CSA相比HISA确确实实的能减少KV Cache,但是效果会比HISA差一些。但是当时也没有想到如何很好的把这种优势通过实验给展示出来。 看到字节Seed团队最新发布的论文《Periodic Wea
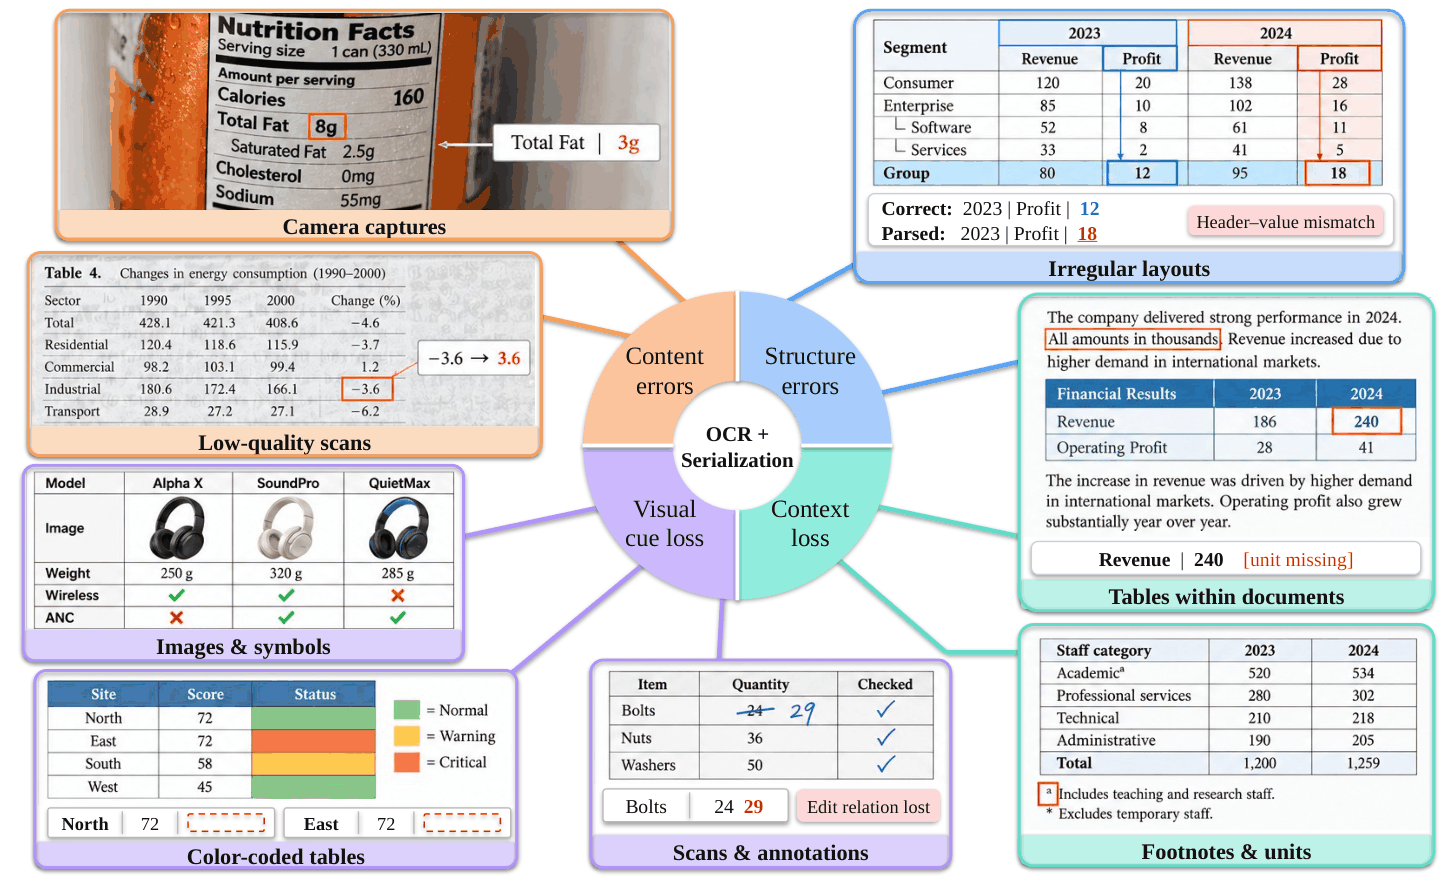
精选文章 表格转成文本,丢掉了什么?人大联合贝壳提出 MERIT,让 8B 模型从原图中找证据、做推理 一张表格,经过 OCR 和结构解析,变成了整齐的 Markdown。数字看起来齐全,语法也没有问题,但模型仍可能算出一个错误答案:它用到的数字,属于另一组表头;问题限定的高亮单元格,在转换后已经失去了颜色;决定数值含义的单位和脚注,也可能没有进入输入。 当证据在转成文本的过程中发生了变化,后续推理再
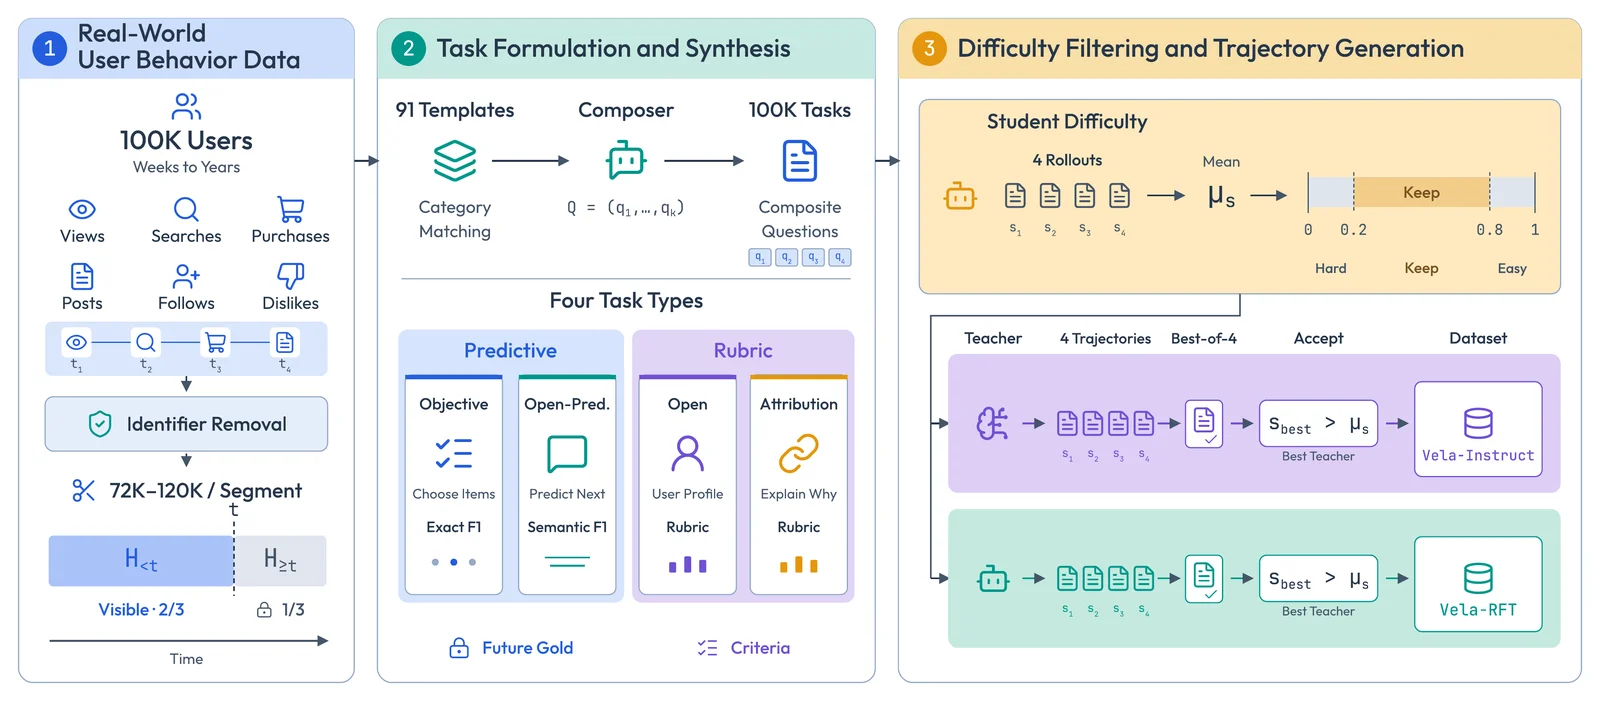
精选文章 大模型如何真正理解用户?Vela 把真实行为变成训练数据,10项基准全部提升! 当你让 personal agent 帮你规划一次出行时,它能否结合过去的交流、近期的搜索和最新的反馈,理解你这次的预算、偏好与实际需求?几个月前你喜欢紧凑的行程,这一次却想轻松休息,agent 就需要识别需求的变化,并据此调整安排。 大模型已经从回答问题走向参与决策与执行。随着它们承担个人助理、复
精选文章 从 RoPE 到 NoPE:长上下文中的位置建模正在重新分工 作者:zqzzq,人大高瓴人工智能学院直博 TL;DR 一句话:RoPE 把位置先验直接写进架构;NoPE 把位置交给模型隐式学习。所以有一个趋势是把两者结合分工。 RoPE 好在哪:用绝对位置的旋转,得到只依赖相对距离的内积(”绝对进、相对出”)。 RoPE 坏在哪:注意力分数本质是一堆不同频率余
青稞Talk 直播预告!聊聊 RL-Kernel ,大模型 RL 后训练中的训推一致性实践 大模型的 RL 后训练里,有一个常被忽略、却可能让训练悄悄跑偏的隐患。 Rollout 与 Training 往往由两套不同的引擎执行。即使模型、权重、token 完全相同,两边的 LogP 也可能对不上——浮点归约顺序、并行分片、通信合并树、精度转换边界,任何一处不同,都会在数值上分叉。 一个直观
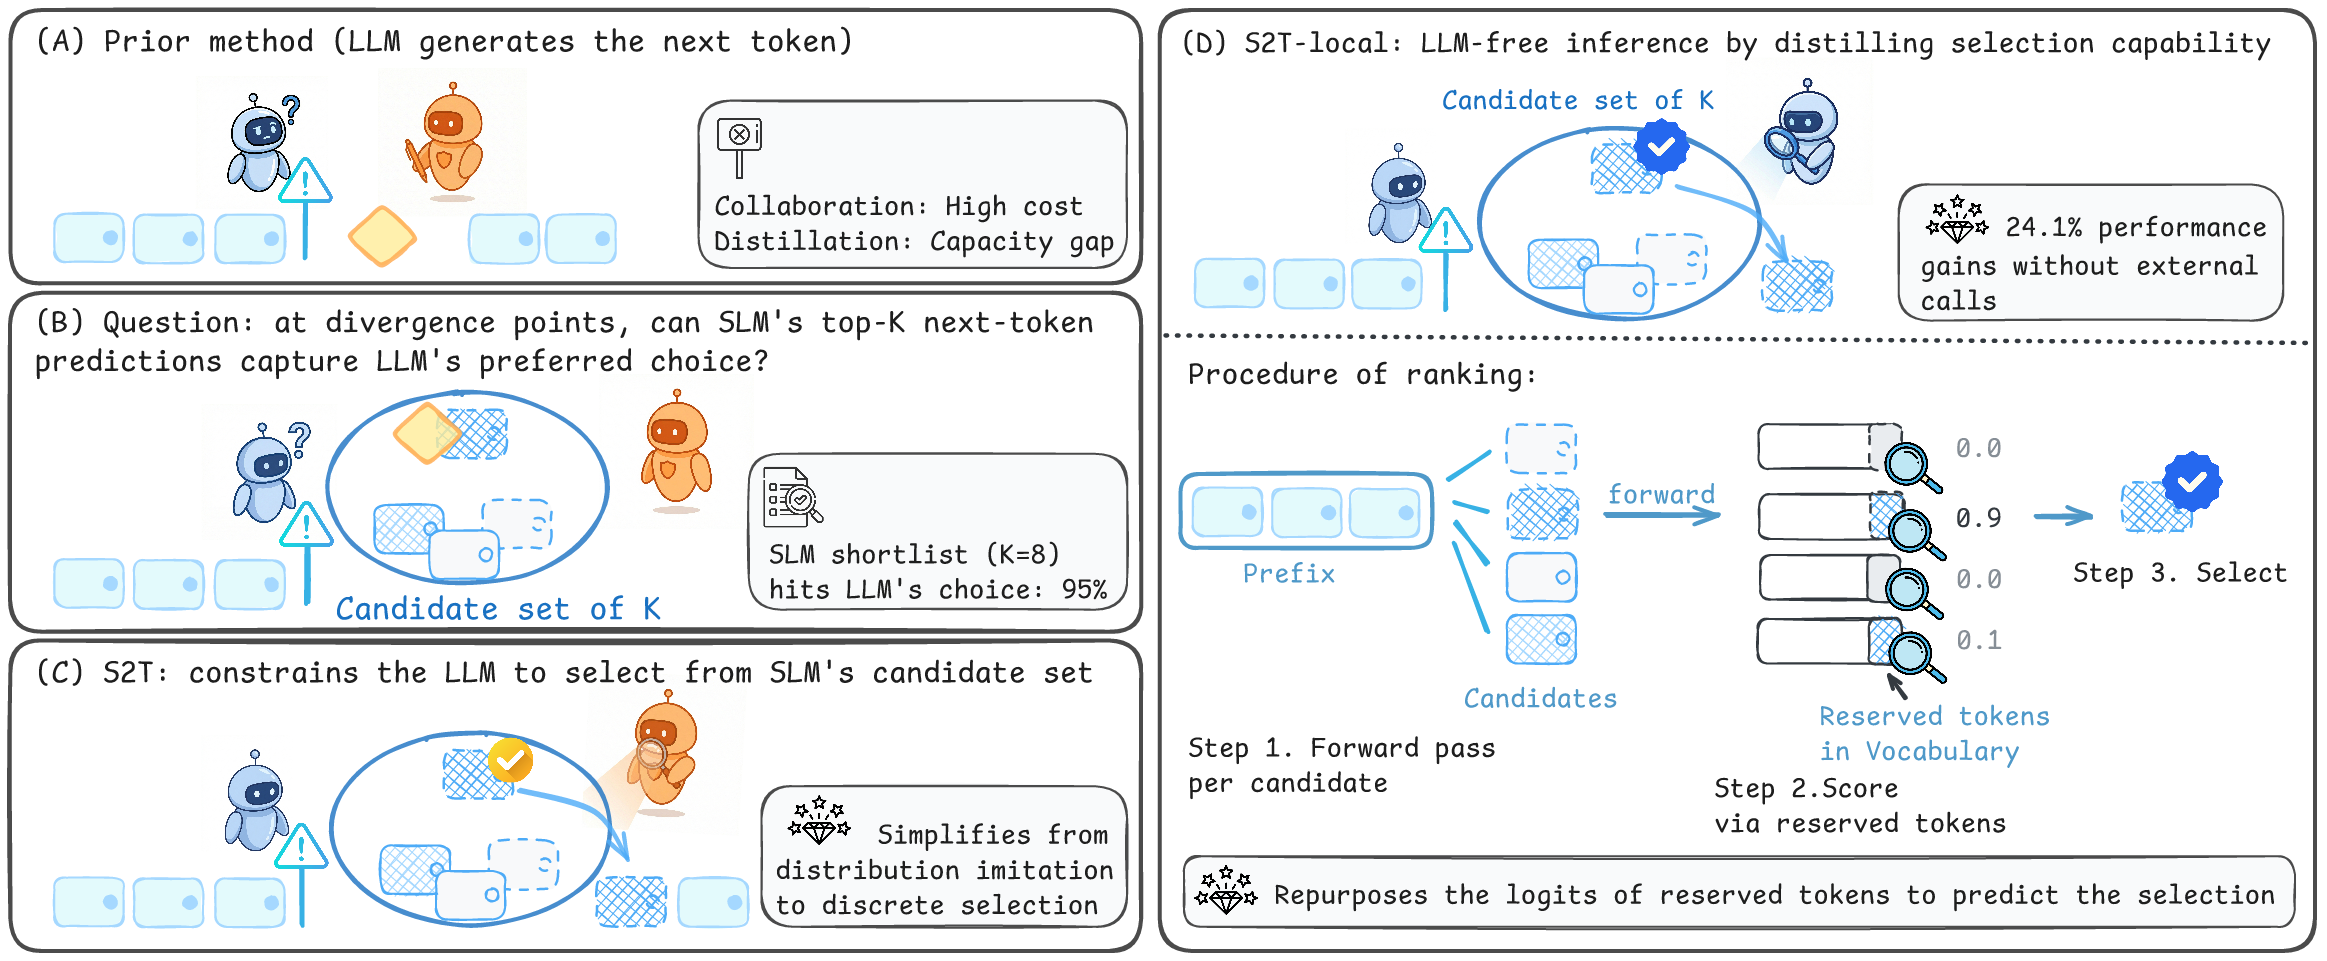
精选文章 我们可能一直都低估了小模型!Select to Think:也许选择比生成更重要 作者:叶文萱,tum在读博士 论文:Select to Think: Unlocking SLM Potential with Local Sufficiency Paper: https://proceedings.mlr.press/v306/ye26r.html Code: https://g
精选文章 乱谈 Kernel 之 Mega 向左,PDL向右 TLDR 刚入职就被老板抓来做megakernel,问及怎么做,曰:不知道,问及目标,曰:世界一流水平。 本文关注 GLM-5.2-FP8 在 decode 阶段执行完整 Indexer 的一个 Transformer layer,并优化这一层进入 Sparse FlashMLA 前的计算。 测量范
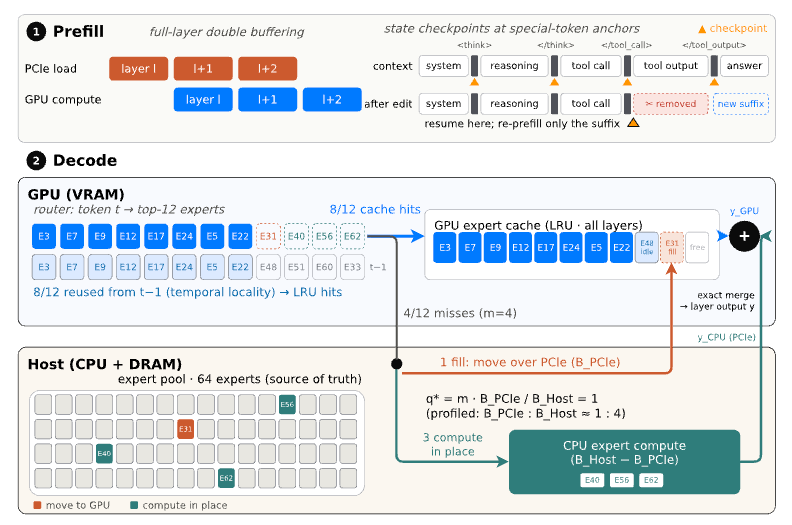
青稞Talk 直播预告!聊聊FreeToken:如何在 8GB 显存上跑起 35B 参数的 MoE 大模型 前沿开源权重模型正日益普及,但其部署服务目前仍主要依赖数据中心级别的基础设施。 来自 UC Berkeley、MIT 等团队推出了一种面向边缘设备原生设计的混合专家(MoE)推理服务系统: FreeToken,它不再将个人计算机简单视为一块小型 GPU,而是将其建模为一个统一、弹性可伸缩的推理平台。
精选文章 大词表伤害小模型?深度解析 N-gram Embedding 与 Engram 架构 模型 核心做法 N-gram 地址映射 注入位置 Context-aware Gate 参数,比例 Over-Tokenized Transformer (OE) Hierarchical N-gram → Feature Hashing → sliced low-dim embeddings →
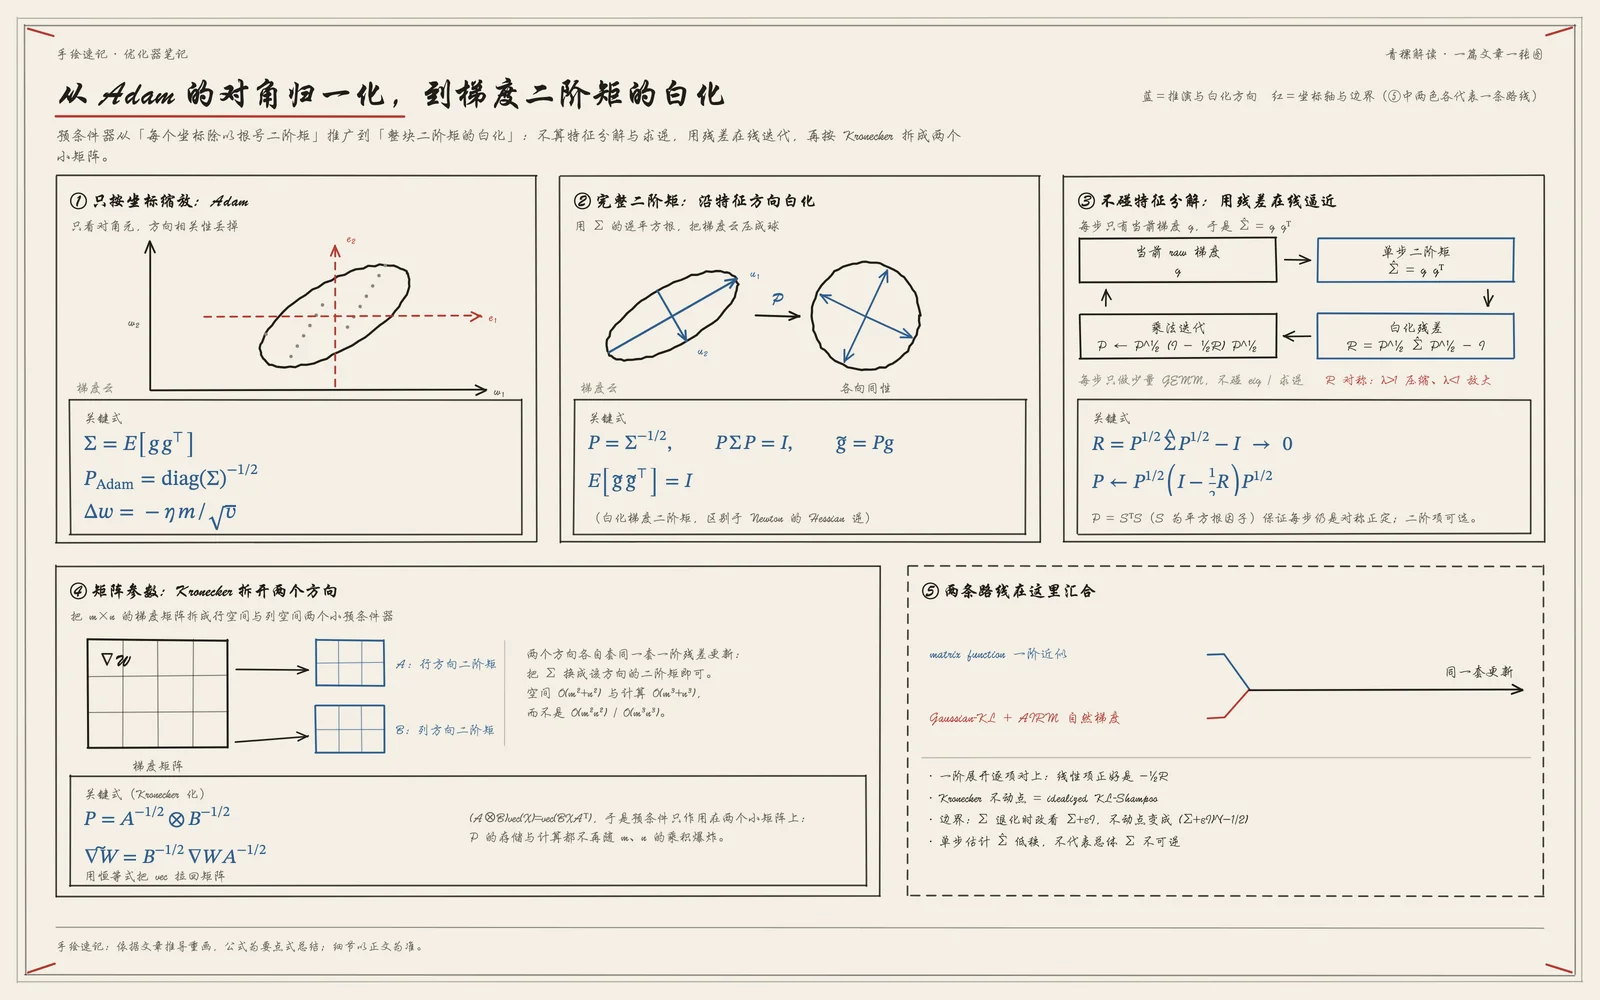
精选文章 深度!大模型优化器解读:从 Adam 到在线矩阵 Whitening Adam 的核心操作之一,是利用梯度的二阶矩对更新做归一化。对第 i 个参数坐标,Adam 维护 v_{t,i}\approx \mathbb E[ g_i^2],计算参数更新 \Delta \theta_i\propto-\frac{ m_i}{\sqrt{ v_i}}. 如果把梯度二阶矩写成 H
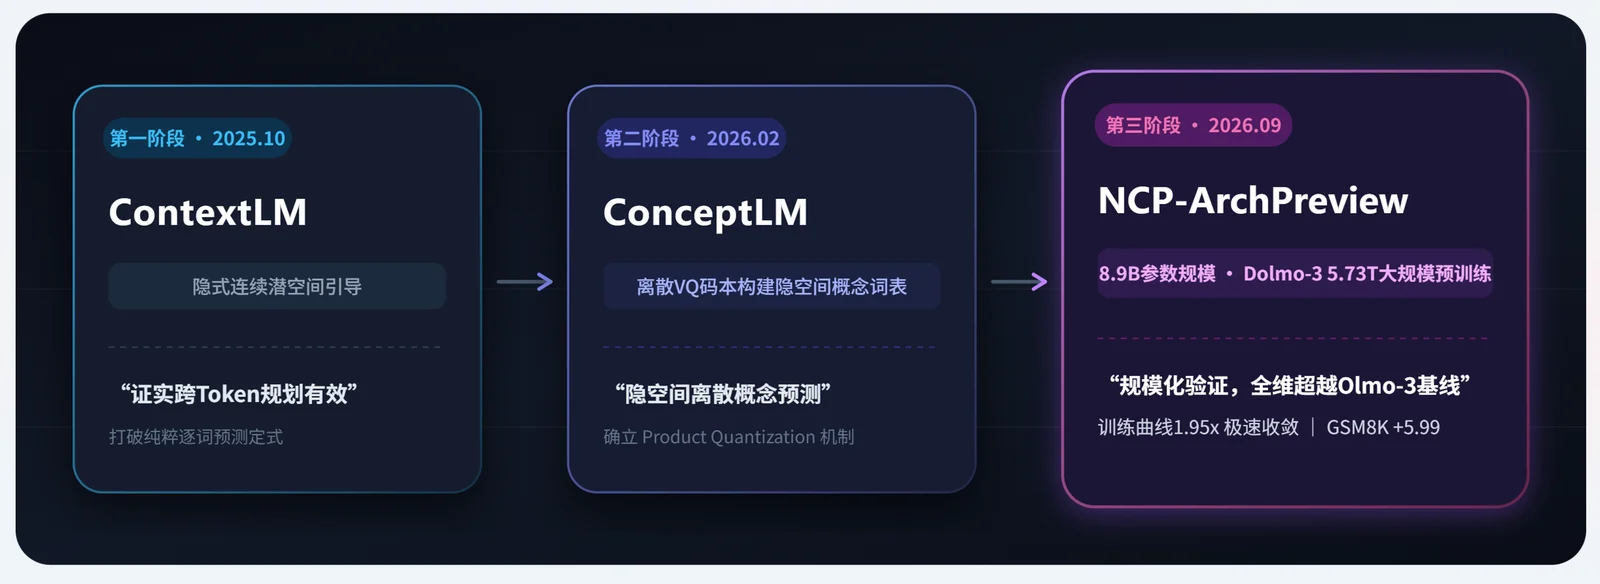
精选文章 从 Next-Token 到 Next-Concept:语言模型的预训练任务,还有得改进吗? 当全世界都在疯狂给大语言模型堆算力、卷数据、扩上下文时,我们是否曾停下来质疑过那个统治了整个生成式AI时代的底层铁律——Next Token Prediction(下一个词预测)? 人类说话写文章,从不是大脑里机械地蹦出一个字才去想下一个字;我们永远是 “先有概念与意图,后有遣词与造句”。 近日,来
精选文章 聊聊 DeepSeek-V4.1-Flas 背后的跨层 KV 共享 YOCO,以衍生变种 随着 DeepSeek-V4.1-Flash 的发布,YOCO 也重新进入大众视野。在我看来,YOCO 是一篇非常优秀的工作,基于 YOCO,也出现了一些有趣的变种。 YOCO 的 motivation 主要有以下两点: 1、 Prefill–Decode(PD)不对称 Prefill 的主要工作是
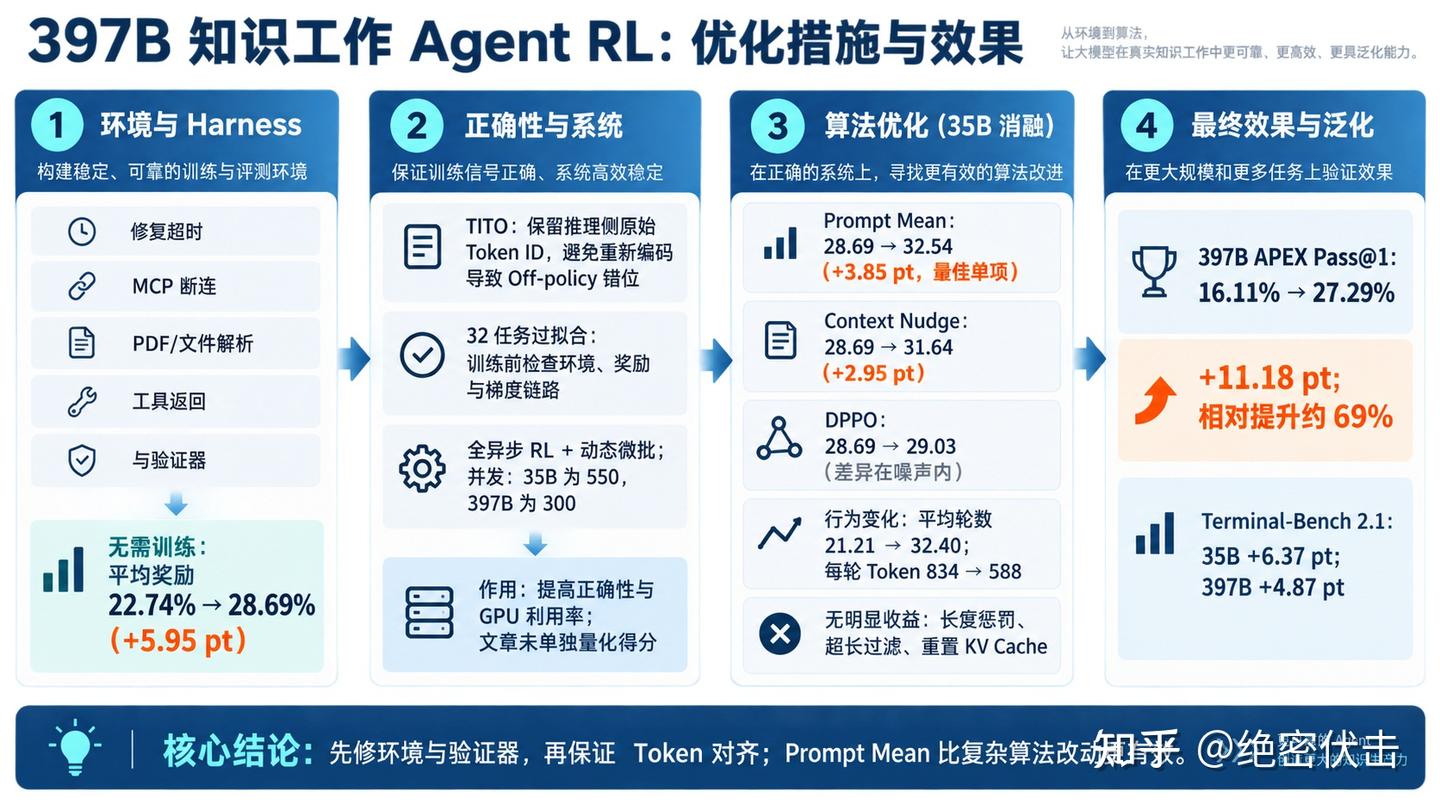
精选文章 LoRA 一作、OpenAI o1 核心成员的新工作:首次公开 397B 模型的 Agent RL 训练配方 LoRA 第一作者、OpenAI o1 核心成员 Edward Hu 近期加入 Mercor,担任 Head of AI Modeling。他加入后的首批公开成果之一,便是与 SkyRL 团队联合发布的一套面向复杂知识工作 Agent 的强化学习方案。 这项工作并未止步于公布最终结果,而是系统公开了
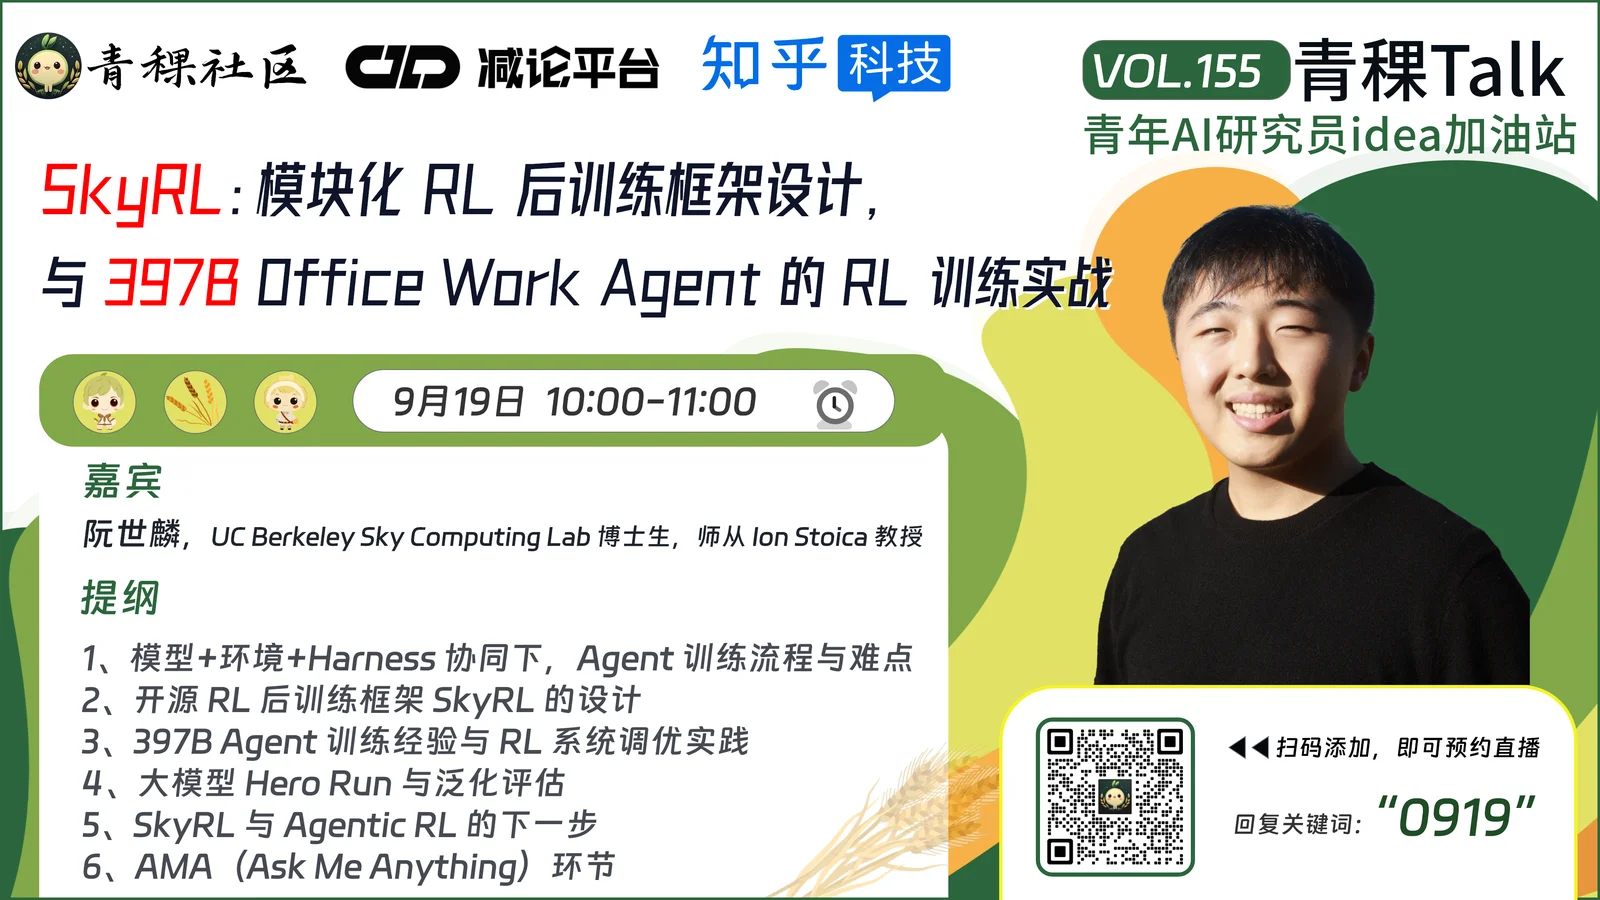
青稞Talk 周六上午10点!聊聊 RL 后训练框架 SkyRL,以及 397B Agent 的 RL 训练实战 当 Agent 训练从「只训模型」走向「模型 + 环境 + Harness」的协同,有了 RL 数据、也有了 RL 框架之后,接下来该做什么?这大概是一些刚开始做 Agentic RL 的企业团队会遇到的问题。 9月19日(周六)上午10:00,青稞Talk 第155期,青稞社区邀请到 SkyRL
精选文章 干货!大模型后训练的“剂量”学,什么剂量才能让 Qwen3.8-27B 想得少、不掉能力,还能用 XH 档? 先放最终后训练完成的模型地址: https://modelscope.cn/models/Merkyor/Qwen3.8-27B-EfficientThink-K3-Opus5-Grok4.6-GPT5.6Sol-SFT-SimPO-DFlash2 这件事一开始看起来挺简单。Qwen 3.8 27
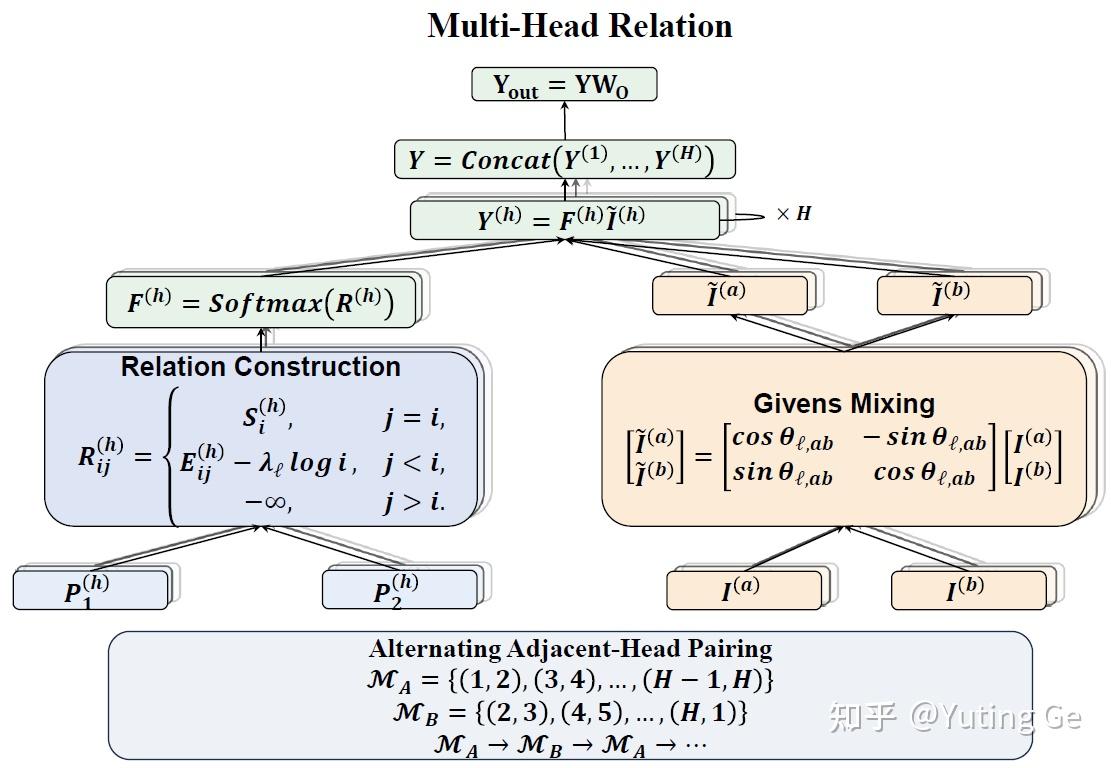
精选文章 从 Attention 到 Relation:深入理解 Token 到底应该怎么流动? 进城大之前,暑假写了两个小文章: 首先是Is SwiGLU's Open Positive Tail Necessary? Evidence from Closed-Tail Gating with MemGLU 。这篇文章是一个针对MLP激活门控的小论文:从RELU到SwiGLU,大家似乎默认了开
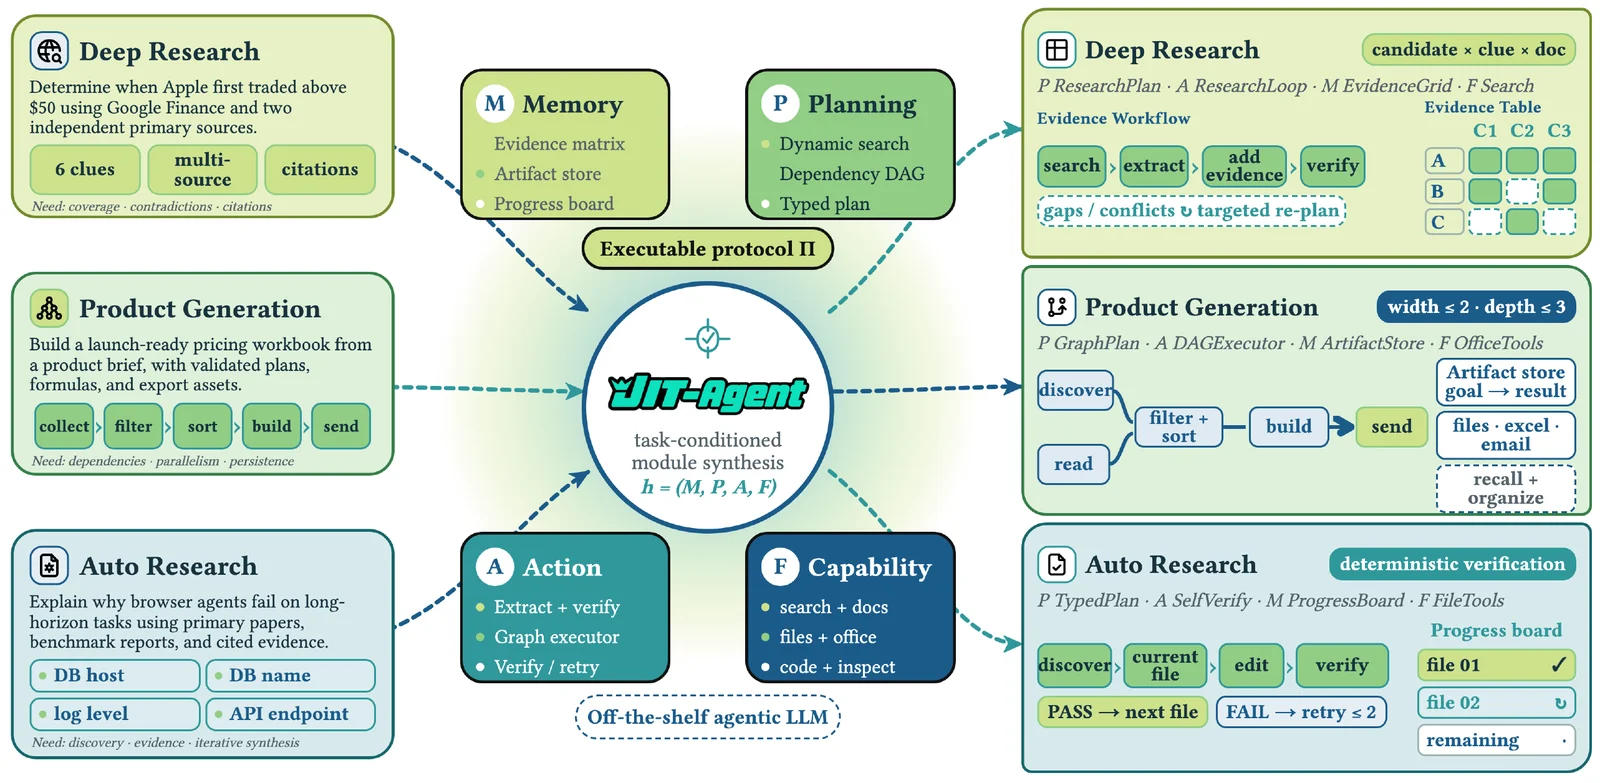
精选文章 Harness基模JIT-27B,为每个任务写一套“Claude Code” Harness基模JIT-27B,为每个任务写一套“Claude Code” Agent benchmark 通常把模型视为能力的主要来源,但同一模型只要更换记忆组织、规划协议、工具暴露方式或错误恢复流程,最终表现就可能跨越一个明显的档位。 这样的差异来自 Agent Harness:它定义模型在什
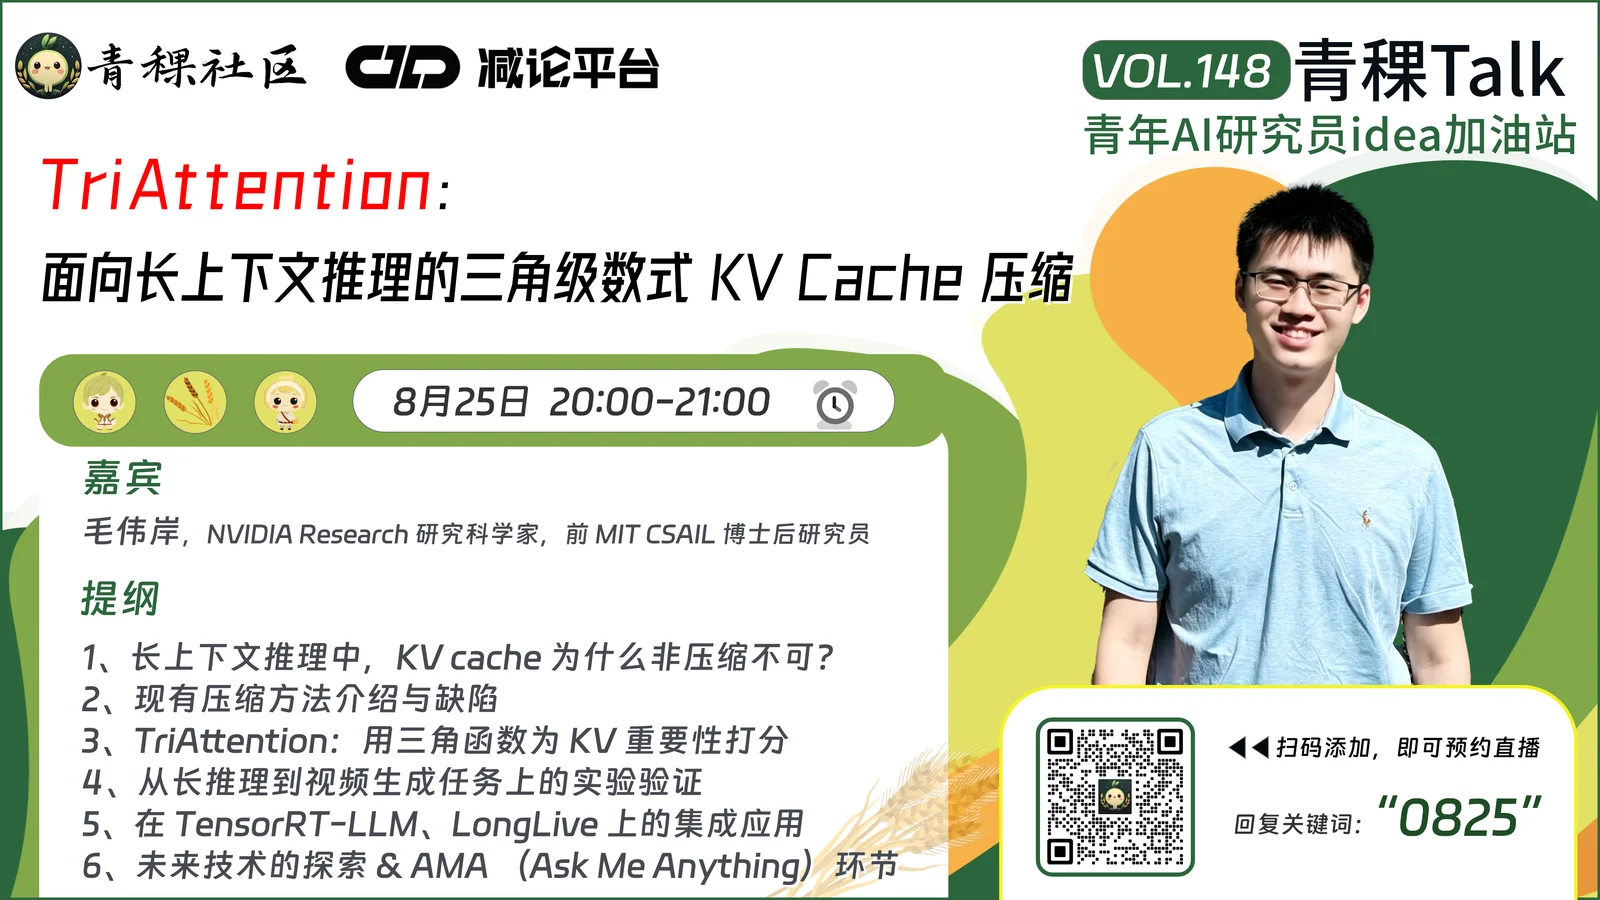
青稞Talk 直播预告!和 NVIDIA Research 研究科学家毛伟岸,聊聊 TriAttention:面向长上下文推理的三角级数式 KV Cache 压缩 长推理与 long-horizon agent 的上下文越来越长,KV cache 随之成为显存瓶颈。 现有压缩方法多用最近若干 post-RoPE query 的注意力分数估计 key 的重要性;但 query 经 RoPE 后随位置旋转,只有最近一小段仍保持当前朝向,可用样本有限,估计精度受限,
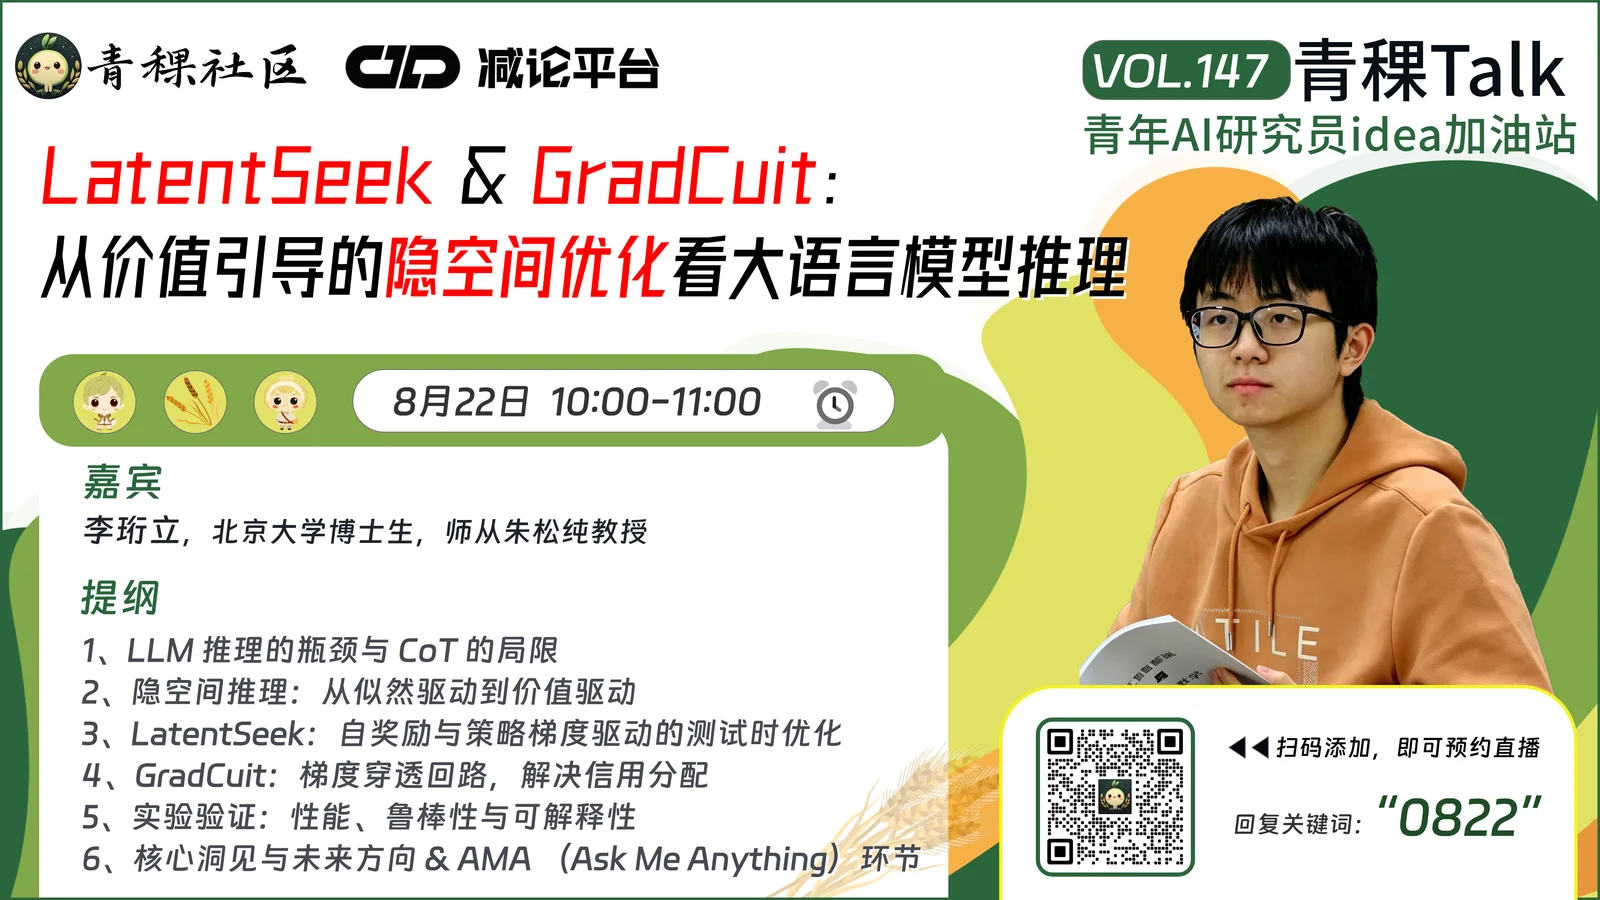
青稞Talk 直播预告!聊聊大语言模型在 latent space(隐空间)里的优化和推理 语言模型的推理能力已成为当前研究的焦点,但传统思维链(CoT)受限于自然语言这一"思维介质",人类许多认知过程从未被显式书写,因而无法被模型从数据中习得。 在最新的研究中提出了一种新视角:将推理重新表述为"价值引导的隐空间优化",即不依赖外部信息,直接在模型内部隐空间中沿价值梯度搜索更优解。 8月2
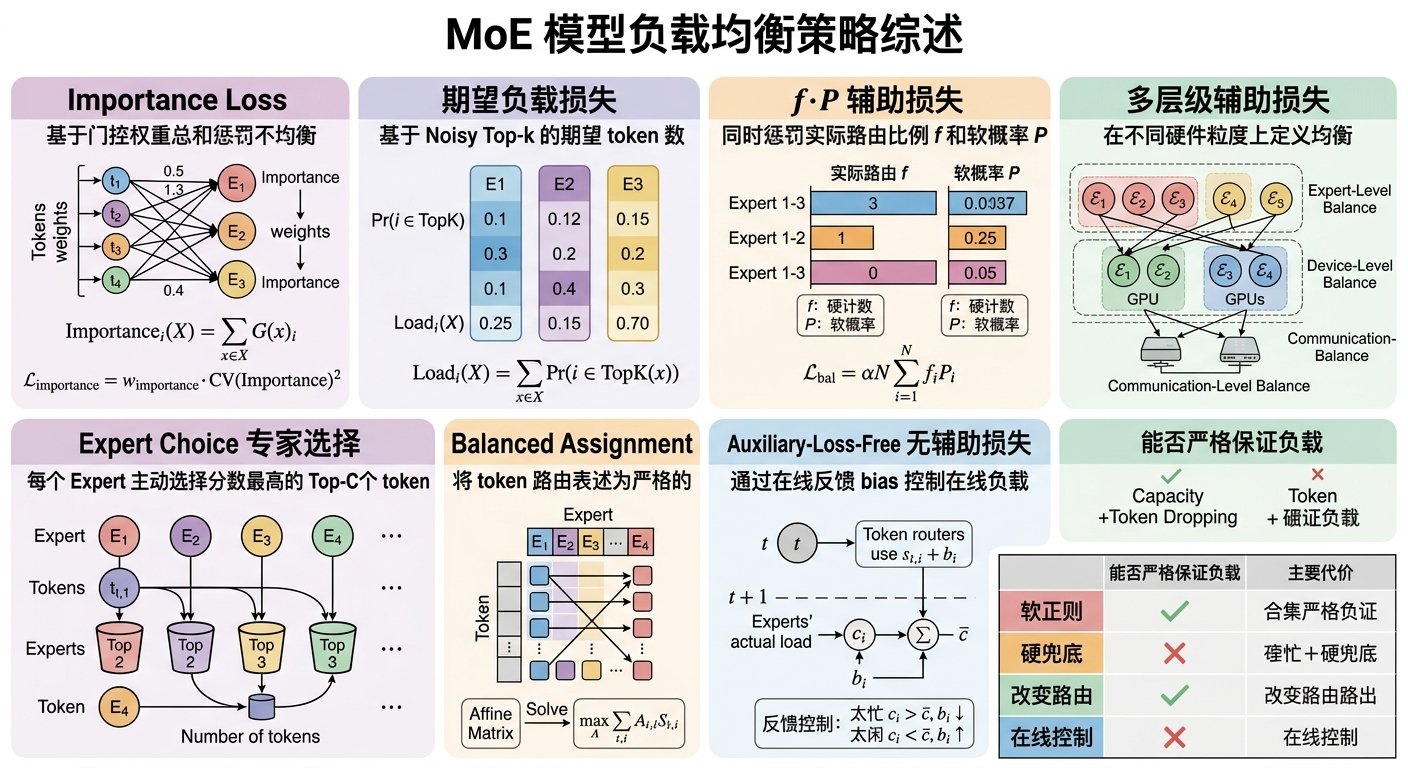
精选文章 大模型 MoE 负载均衡的 N 种方法 作者:觉醒也醉了 https://zhuanlan.zhihu.com/p/2066914125012283729 MoE 中的负载 假设一个 batch(或一个路由 group)中有 T 个 token、N 个 routed experts,每个 token 选择 k 个 Expert。 Rout
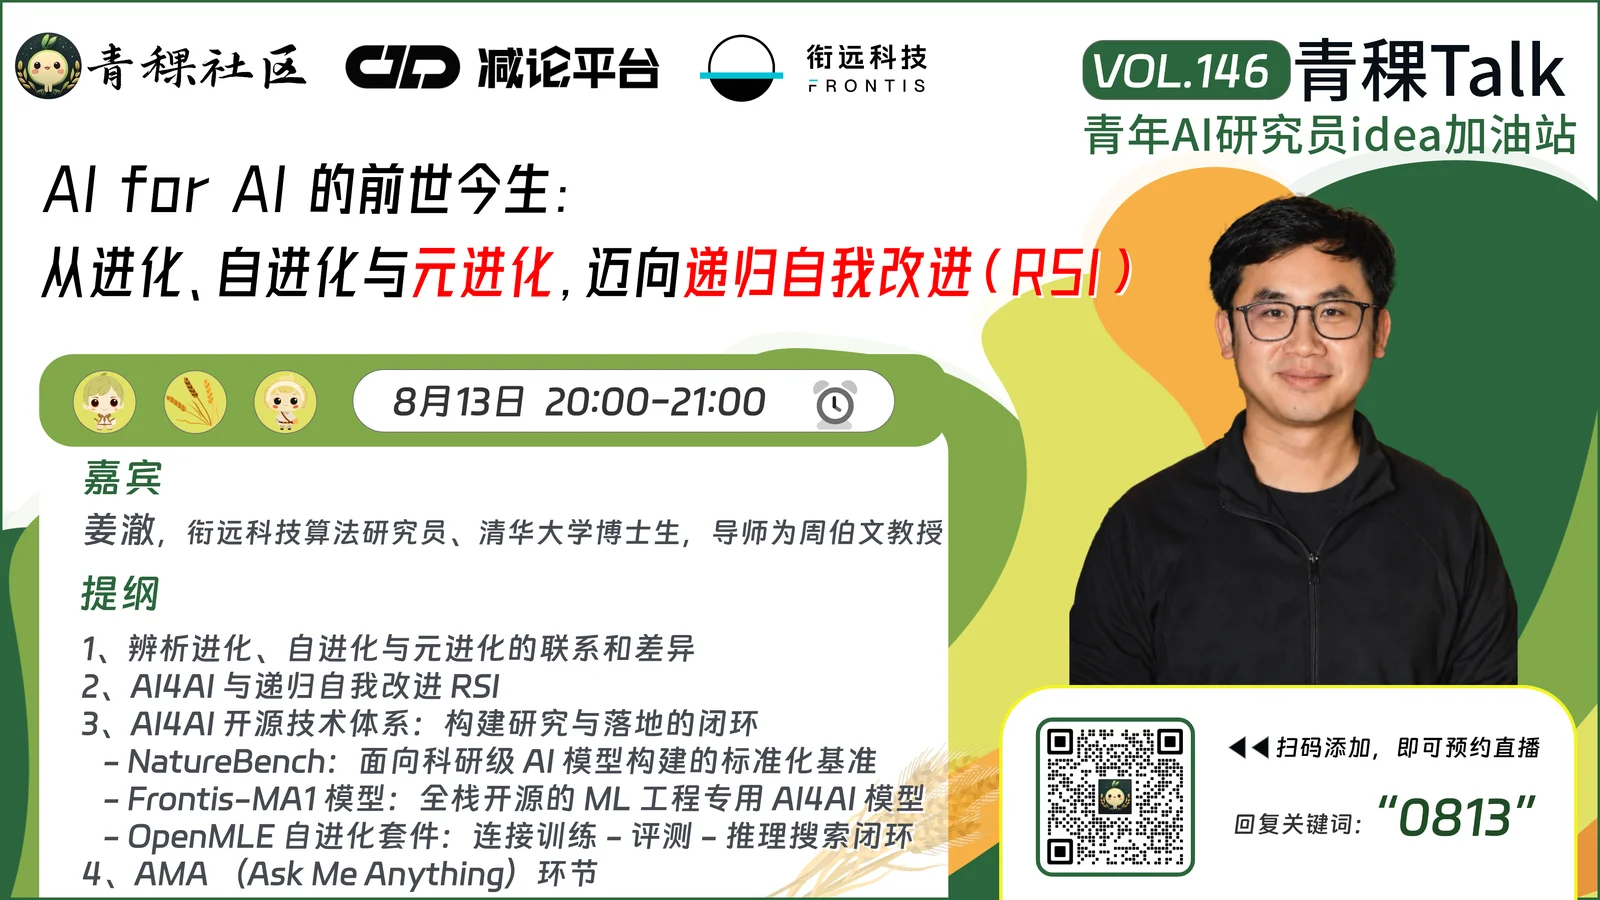
青稞Talk AI for AI 的前世今生: 从进化、自进化与元进化,迈向递归自我改进(RSI) 导语:当代码智能体(Code Agents)与测试床工程(Harness Engineering)飞速发展,AI 不再仅仅是被动接受指令的工具。AI for AI (AI4AI) 正在经历一场深刻的范式演变,其核心目标已明确指向人工智能领域的终极愿景之一——递归自我改进(Recursive Self
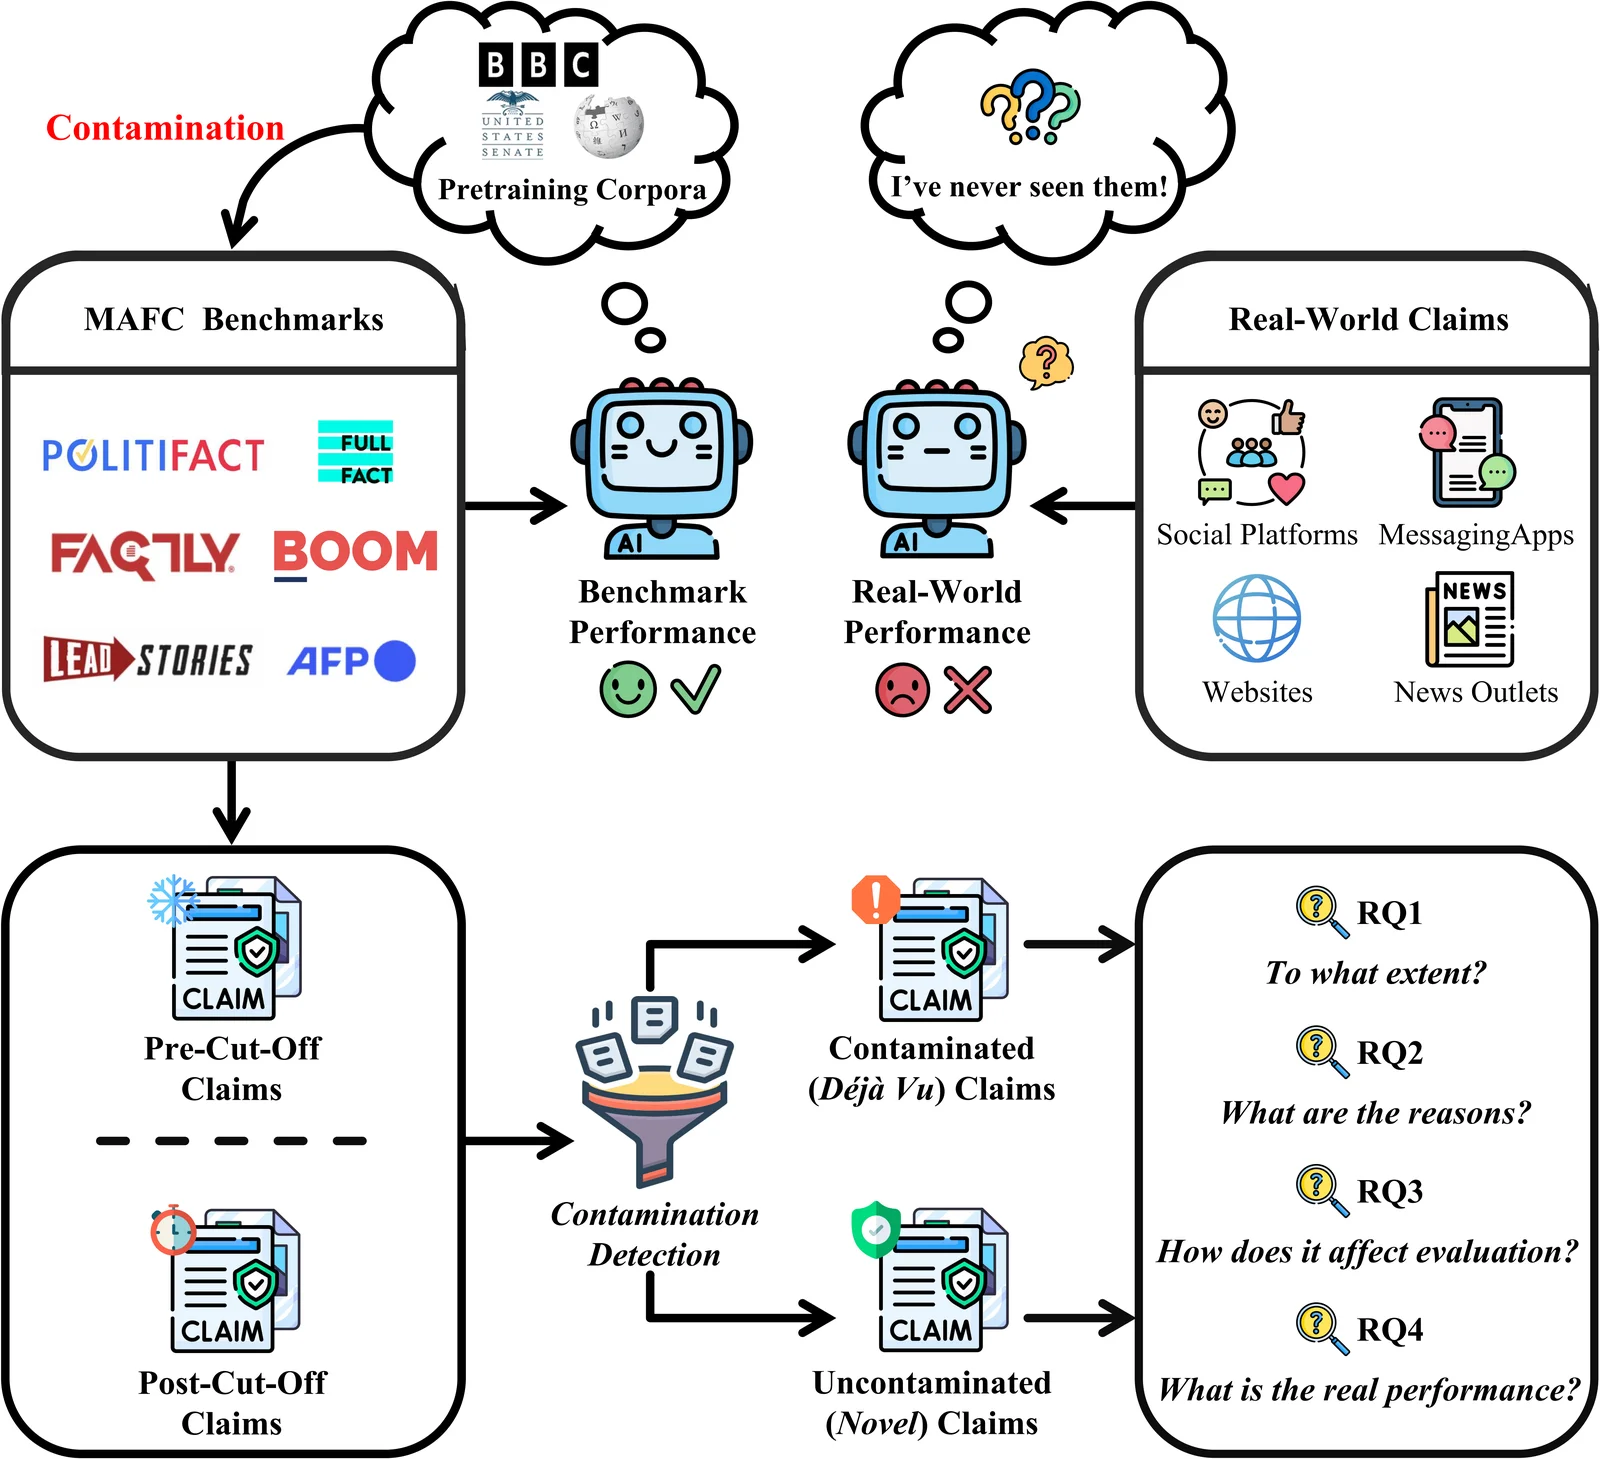
精选文章 打假大模型动态评测:你以为的“最新考题”,模型其实早就背过答案? 如今,评测圈最流行的词之一就是 Live。 旧题可能混进训练数据?那就不断收集刚刚发生的新题,专门挑选模型知识截止日期之后发布的题目,再按月、按季度更新测试集。 这类 Live Benchmark,也就是动态评测(Dynamic Evaluation),听起来几乎无懈可击:题目是在模型“闭卷”之后才
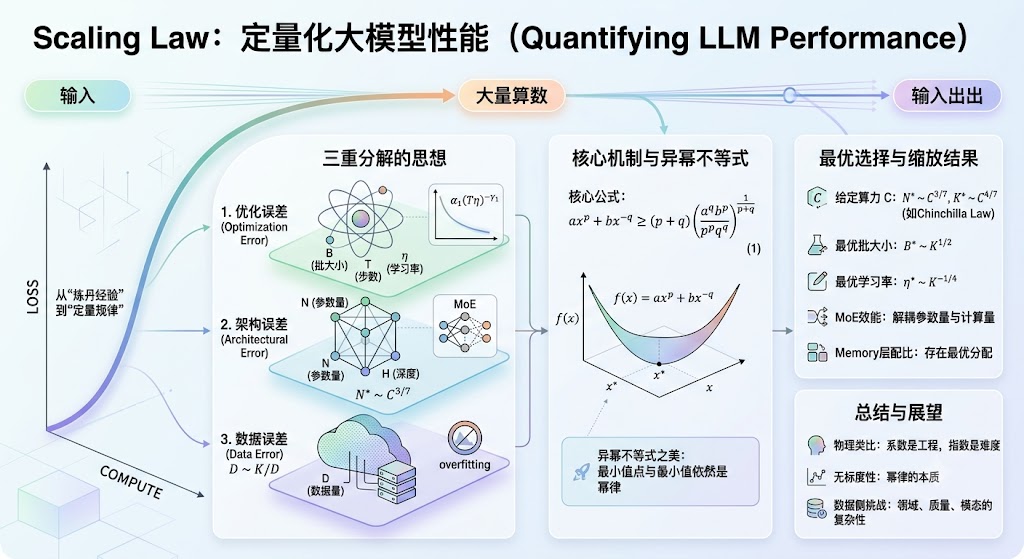
精选文章 苏剑林|解构 Scaling Law:优化、架构、数据的三重奏 作者:苏剑林 原文:https://kexue.fm/archives/11833 训练一个大型的神经网络,最终效果会受到非常多因素的影响,换个优化器,换个模型架构,或者换一个训练集,结果都可能截然不同。 在工程实践中,我们将调试这些因素的经验结果,戏称为“炼丹”。 但如何从经验上升到规律,更准确、
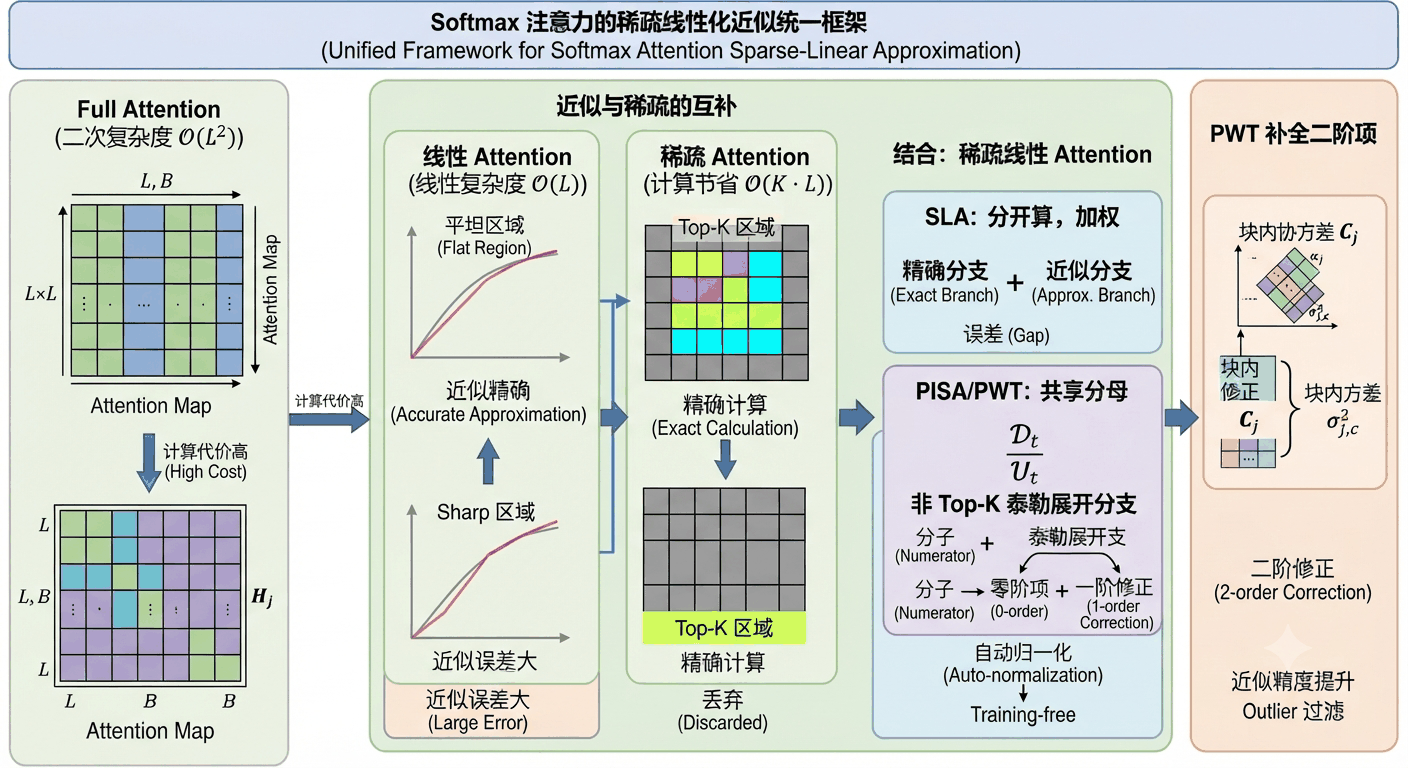
精选文章 Sparse Linear Attention: 当稀疏遇上线性注意力 作者:Haoyi Zhu,Ph.D @ USTC. https://www.haoyizhu.site/blog/sparse-linear-attention/ 背景介绍 大家常用的 Softmax Attention,对第 t 个 query 的输出可以写成 \boldsymbol{o}_t=\
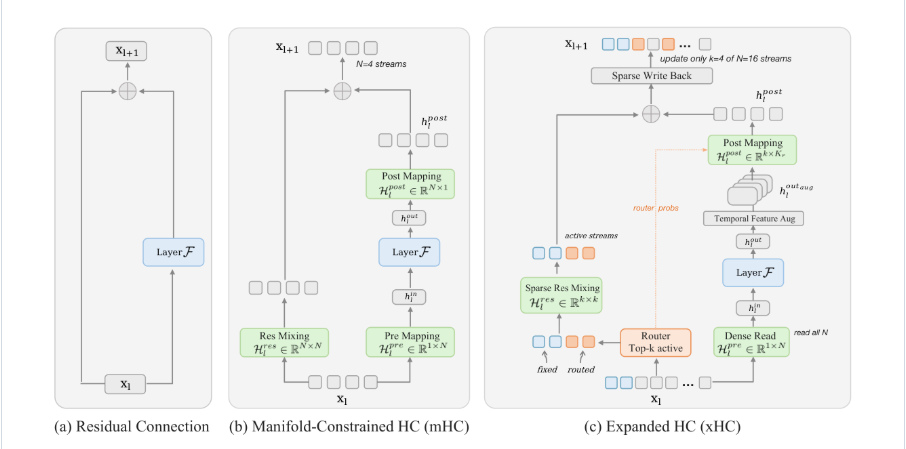
精选文章 从 DeepSeek mHC 到 xHC:如何高效 scale 残差流? 作者:null,上海交通大学AI博一 https://zhuanlan.zhihu.com/p/2063300859472221420 上周五我们发布了 xHC: Expanded Hyper-Connections,这段时间的工作也算告一段落。先用一句话概括我们做了什么:xHC 首次把语言模型的残
精选文章 从推理角度看 kimi k3 作者:SuSun https://zhuanlan.zhihu.com/p/2061411883958137356 从推理角度看一下 Kimi K3,2.8 T, fp4 的话, 1.4 TB,hopper 其实也还行。但肯定这个架构说白了给 B 卡定制的,就是不知道国产卡是否受益了(投机一下,其实
精选文章 从 kimi k3 看下一代 MoE 架构的转折点:LatentMoE 作者:华裳羽照 https://zhuanlan.zhihu.com/p/2061464412574242573 以 Kimi K3 与 Nemotron 3 Super 为例,看 MoE 架构如何在 2026 年完成一次关键的范式跳跃。 2026 年上半年,两件事同时发生:NVIDIA 发布了 1
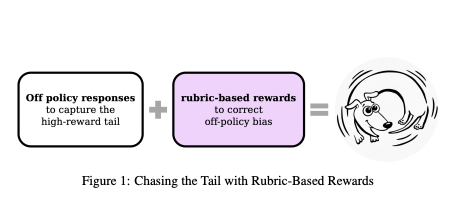
精选文章 大模型对齐中的古德哈特定律:为什么你的 Reward Model 总是被 “Hack”? 作者:蔡恒毅 https://zhuanlan.zhihu.com/p/2058574573143078204 做过 LLM 后训练的人,大概都见过这样一条曲线:强化学习跑着跑着,模型在奖励模型上的得分一路走高,训练日志里一片祥和;可当你真的翻开模型生成的文本,却发现它开始变得冗长、爱堆排版、甚至在
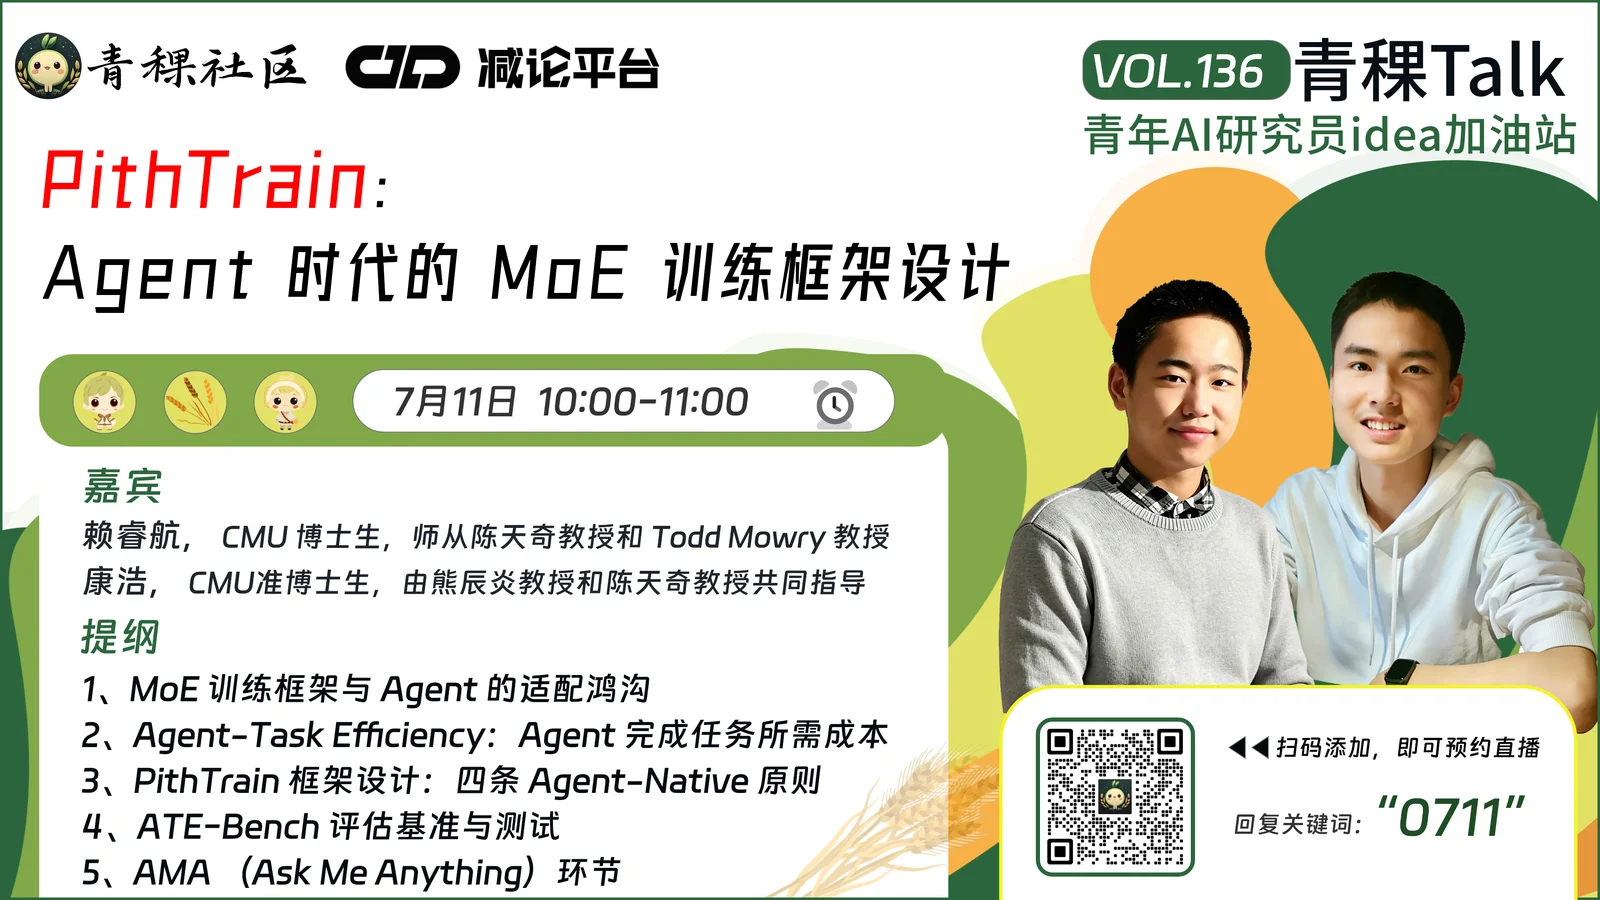
青稞Talk 直播预告!周六上午10点,聊聊 PithTrain:Agent 时代的 MoE 训练框架设计 陈天奇团队最新开源 PithTrain:Agent 时代的 MoE 训练框架设计 专家混合模型(MoE)已经成为当前大语言模型的主流架构,相应的生产级训练框架也经过多年工程积累,具备了优异的训练性能。 然而,随着新的模型架构和系统优化不断涌现,在这些大型框架上进行开发和演进仍然成本高昂。 随着 AI
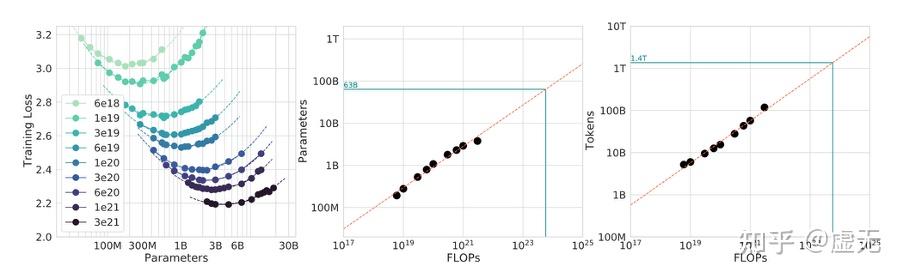
精选文章 Lilian Weng 最新硬核长文:万字拆解 Scaling Laws,大模型训练的“黄金法则” 作者:Weng, Lilian|青稞编辑部翻译 原文:https://lilianweng.github.io/posts/2026-06-24-scaling-laws/* 缩放定律是深度学习中最关键的实证发现之一。其观察形式简洁:随着模型规模 N、数据集大小 D 和计算量 C 的扩大,训练损失
精选文章 深入理解 Agentic RL 中的行为崩塌现象 作者:Jason 原文:https://zhuanlan.zhihu.com/p/2050794185909876253 过去一段时间里,我一直在思考一个问题:Agentic RL 到底和传统 RLVR 有什么本质区别? 最容易想到的答案当然是工具调用。传统 RLVR 往往围绕单轮回答展开,模型生成
精选文章 为什么 Pretrain Loss相同,但下游任务表现却天差地别? 作者:虚无 原文:https://zhuanlan.zhihu.com/p/2048769202819949265 TL, DR LLM Pretraining是模型能力的主要来源。模型的能力一般会随着pretraining loss的降低而单调提升。 那么,pretraining loss相同,模
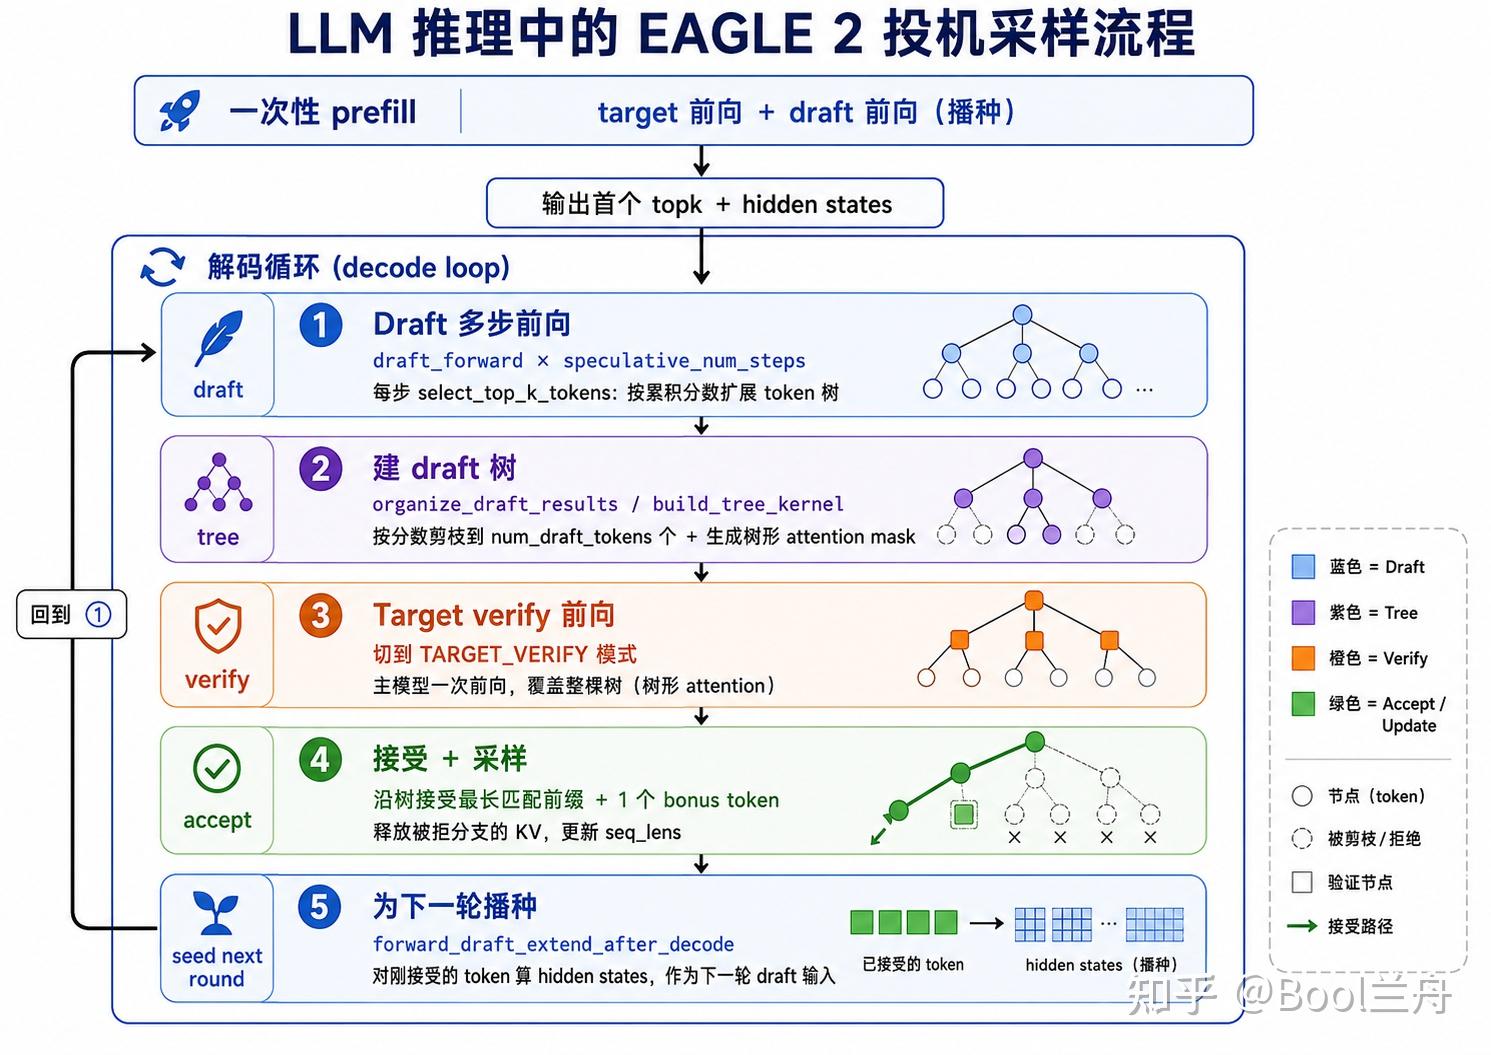
精选文章 把投机采样讲透:以 SGLang 中的 EAGLE-2 为例 投机采样(Speculative Decoding)这两年几乎成了 LLM 推理加速的标配,但真正理解它的人不多。很多人停留在”小模型猜、大模型验”这一句话上,一到细节就懵:主模型 verify 的时候到底在算什么?为什么一次前向能验好几个 token?长上下文到底是帮忙还是帮倒忙? 这篇文章以 S
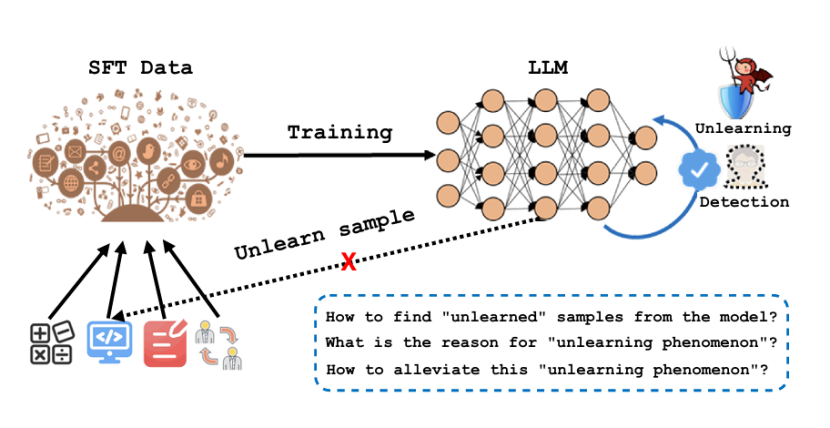
精选文章 不是所有SFT失败都该加epoch——ACL 2026腾讯混元教你五把「手术刀」 论文: Why Supervised Fine-Tuning Fails to Learn: A Systematic Study of Incomplete Learning in Large Language Models 会议: ACL 2026 |单位: 腾讯混元 × UNSW arXiv:
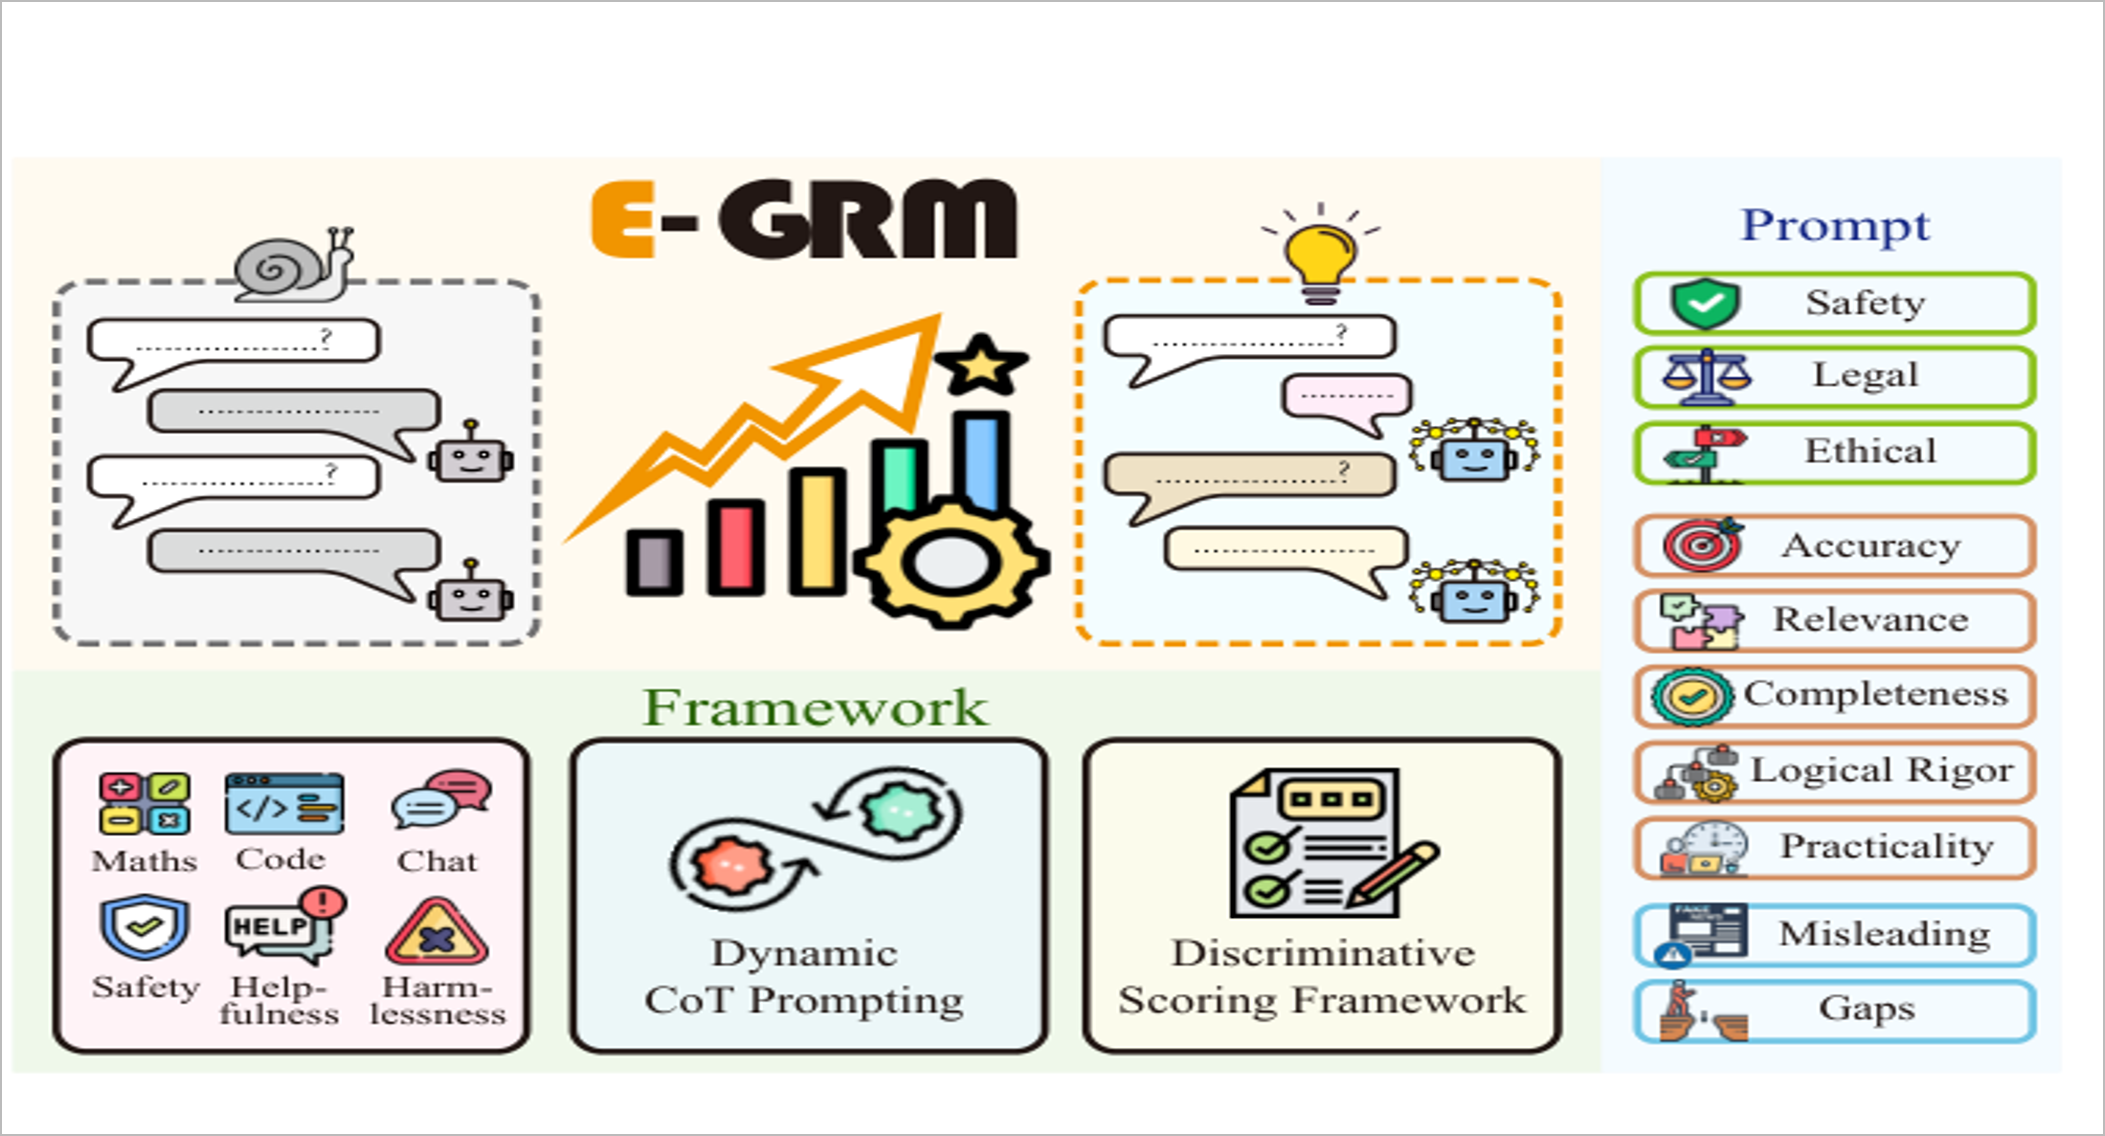
精选文章 ACL 2026 | CoT 真的是越多越好?混元提出 E-GRM, 让大模型“该省则省、该花则花”,按需推理! 论文题目:Reason Only When Needed: Efficient Generative Reward Modeling via Model-Internal Uncertainty arXiv 链接:https://arxiv.org/abs/2604.10072 作者单位:腾讯混元
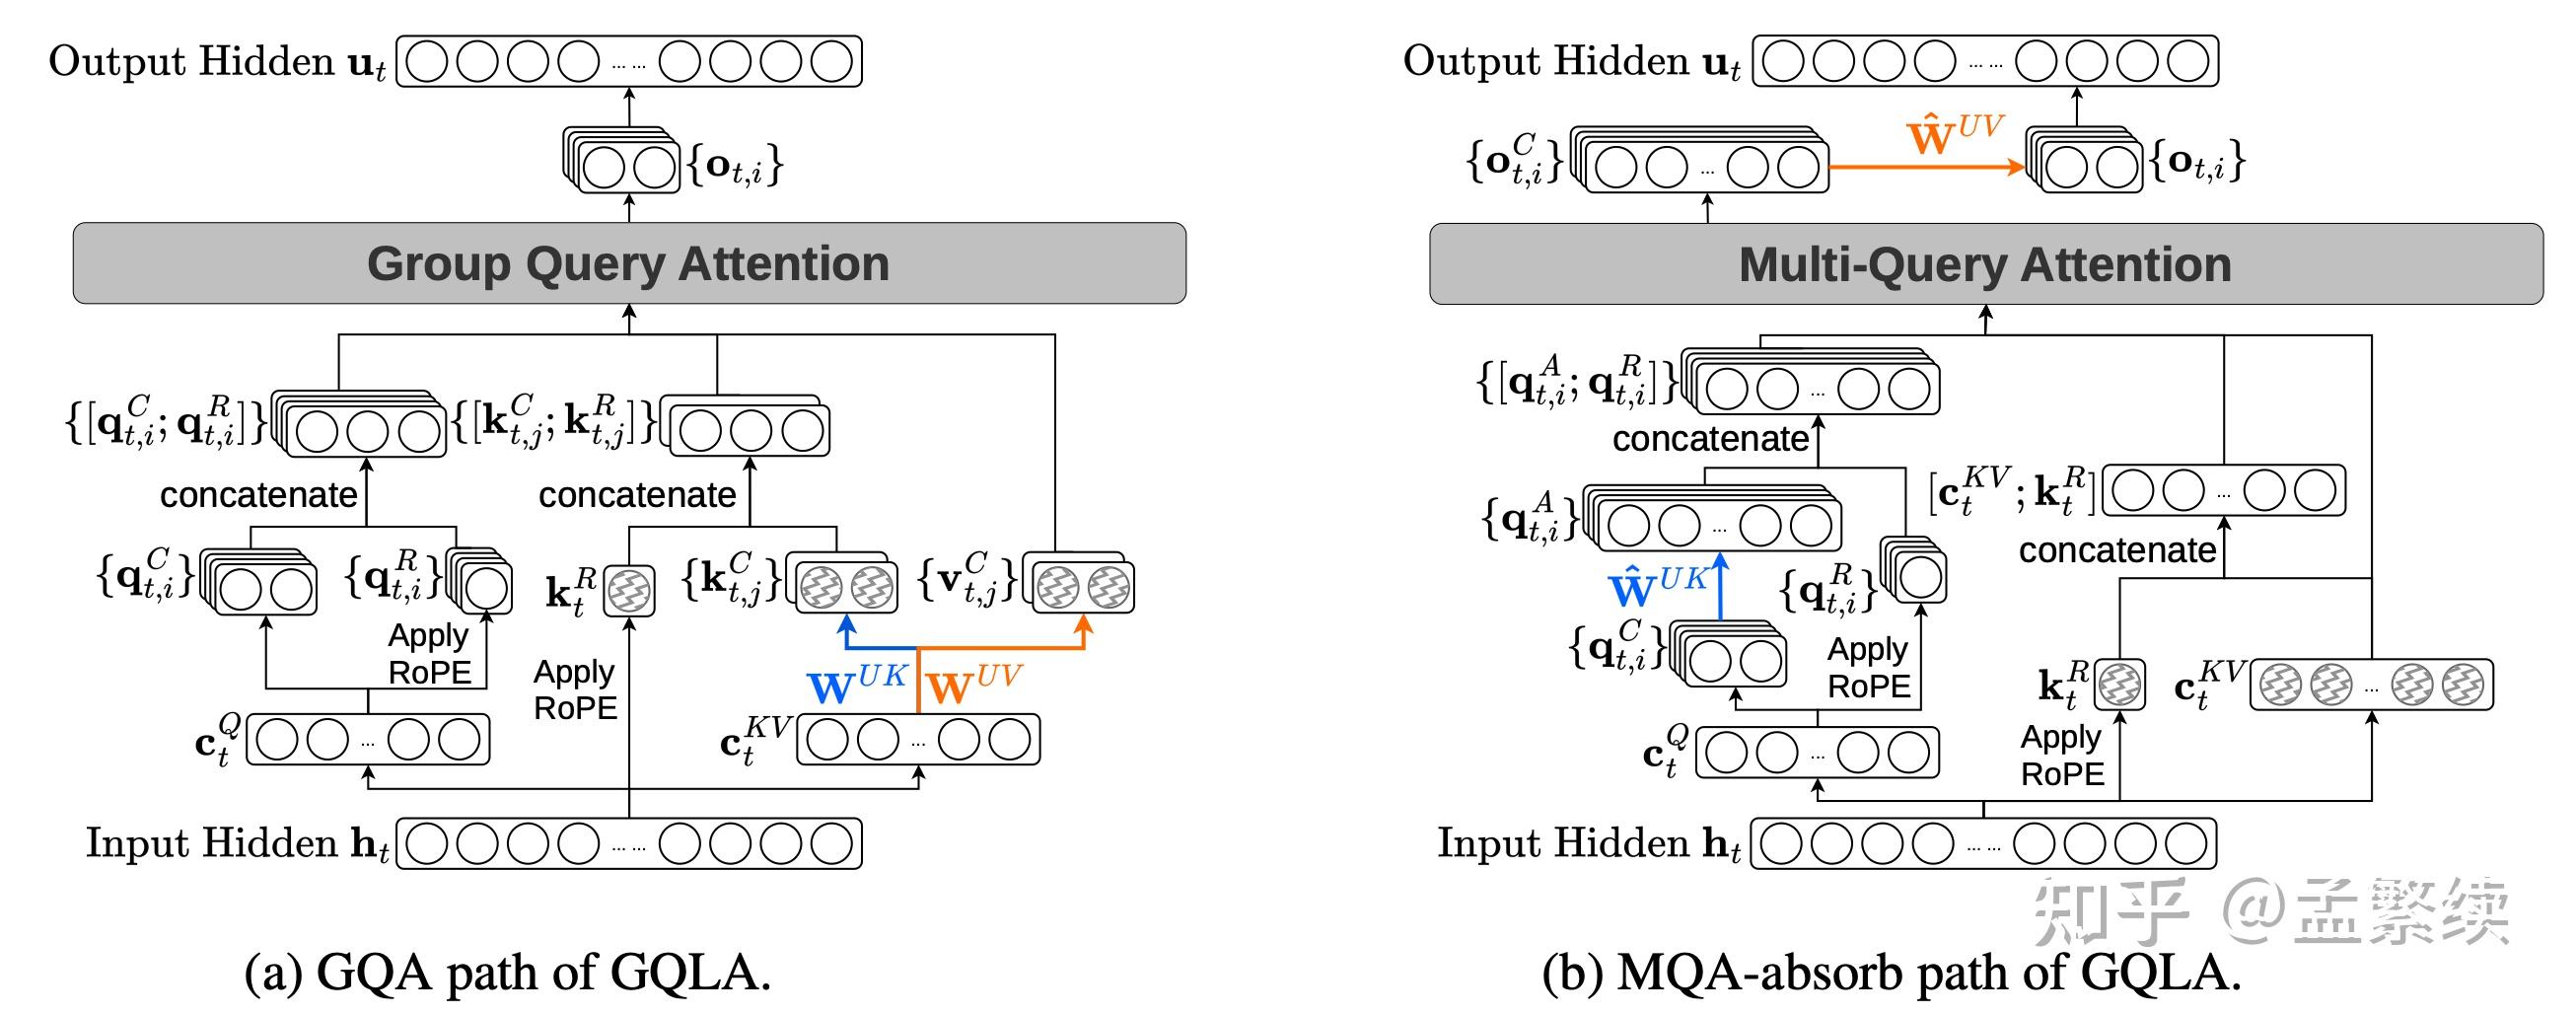
青稞Talk 直播预告!从 MLA 到 GQLA:无需从头训练,硬件自适应高效注意力机制 MLA能够在MHA/MQA之间等价切换,使其在训练推理时都能保持高效。然而MLA是针对H100进行设计的,对于H20这一类计算瓶颈的显卡,推理效率不如GQA。 本文提出GQLA的设计,在GQA/MQA之间等价切换。对于H100用MQA减少KV Cache;对于H20用GQA减少计算量。允许一个预训练
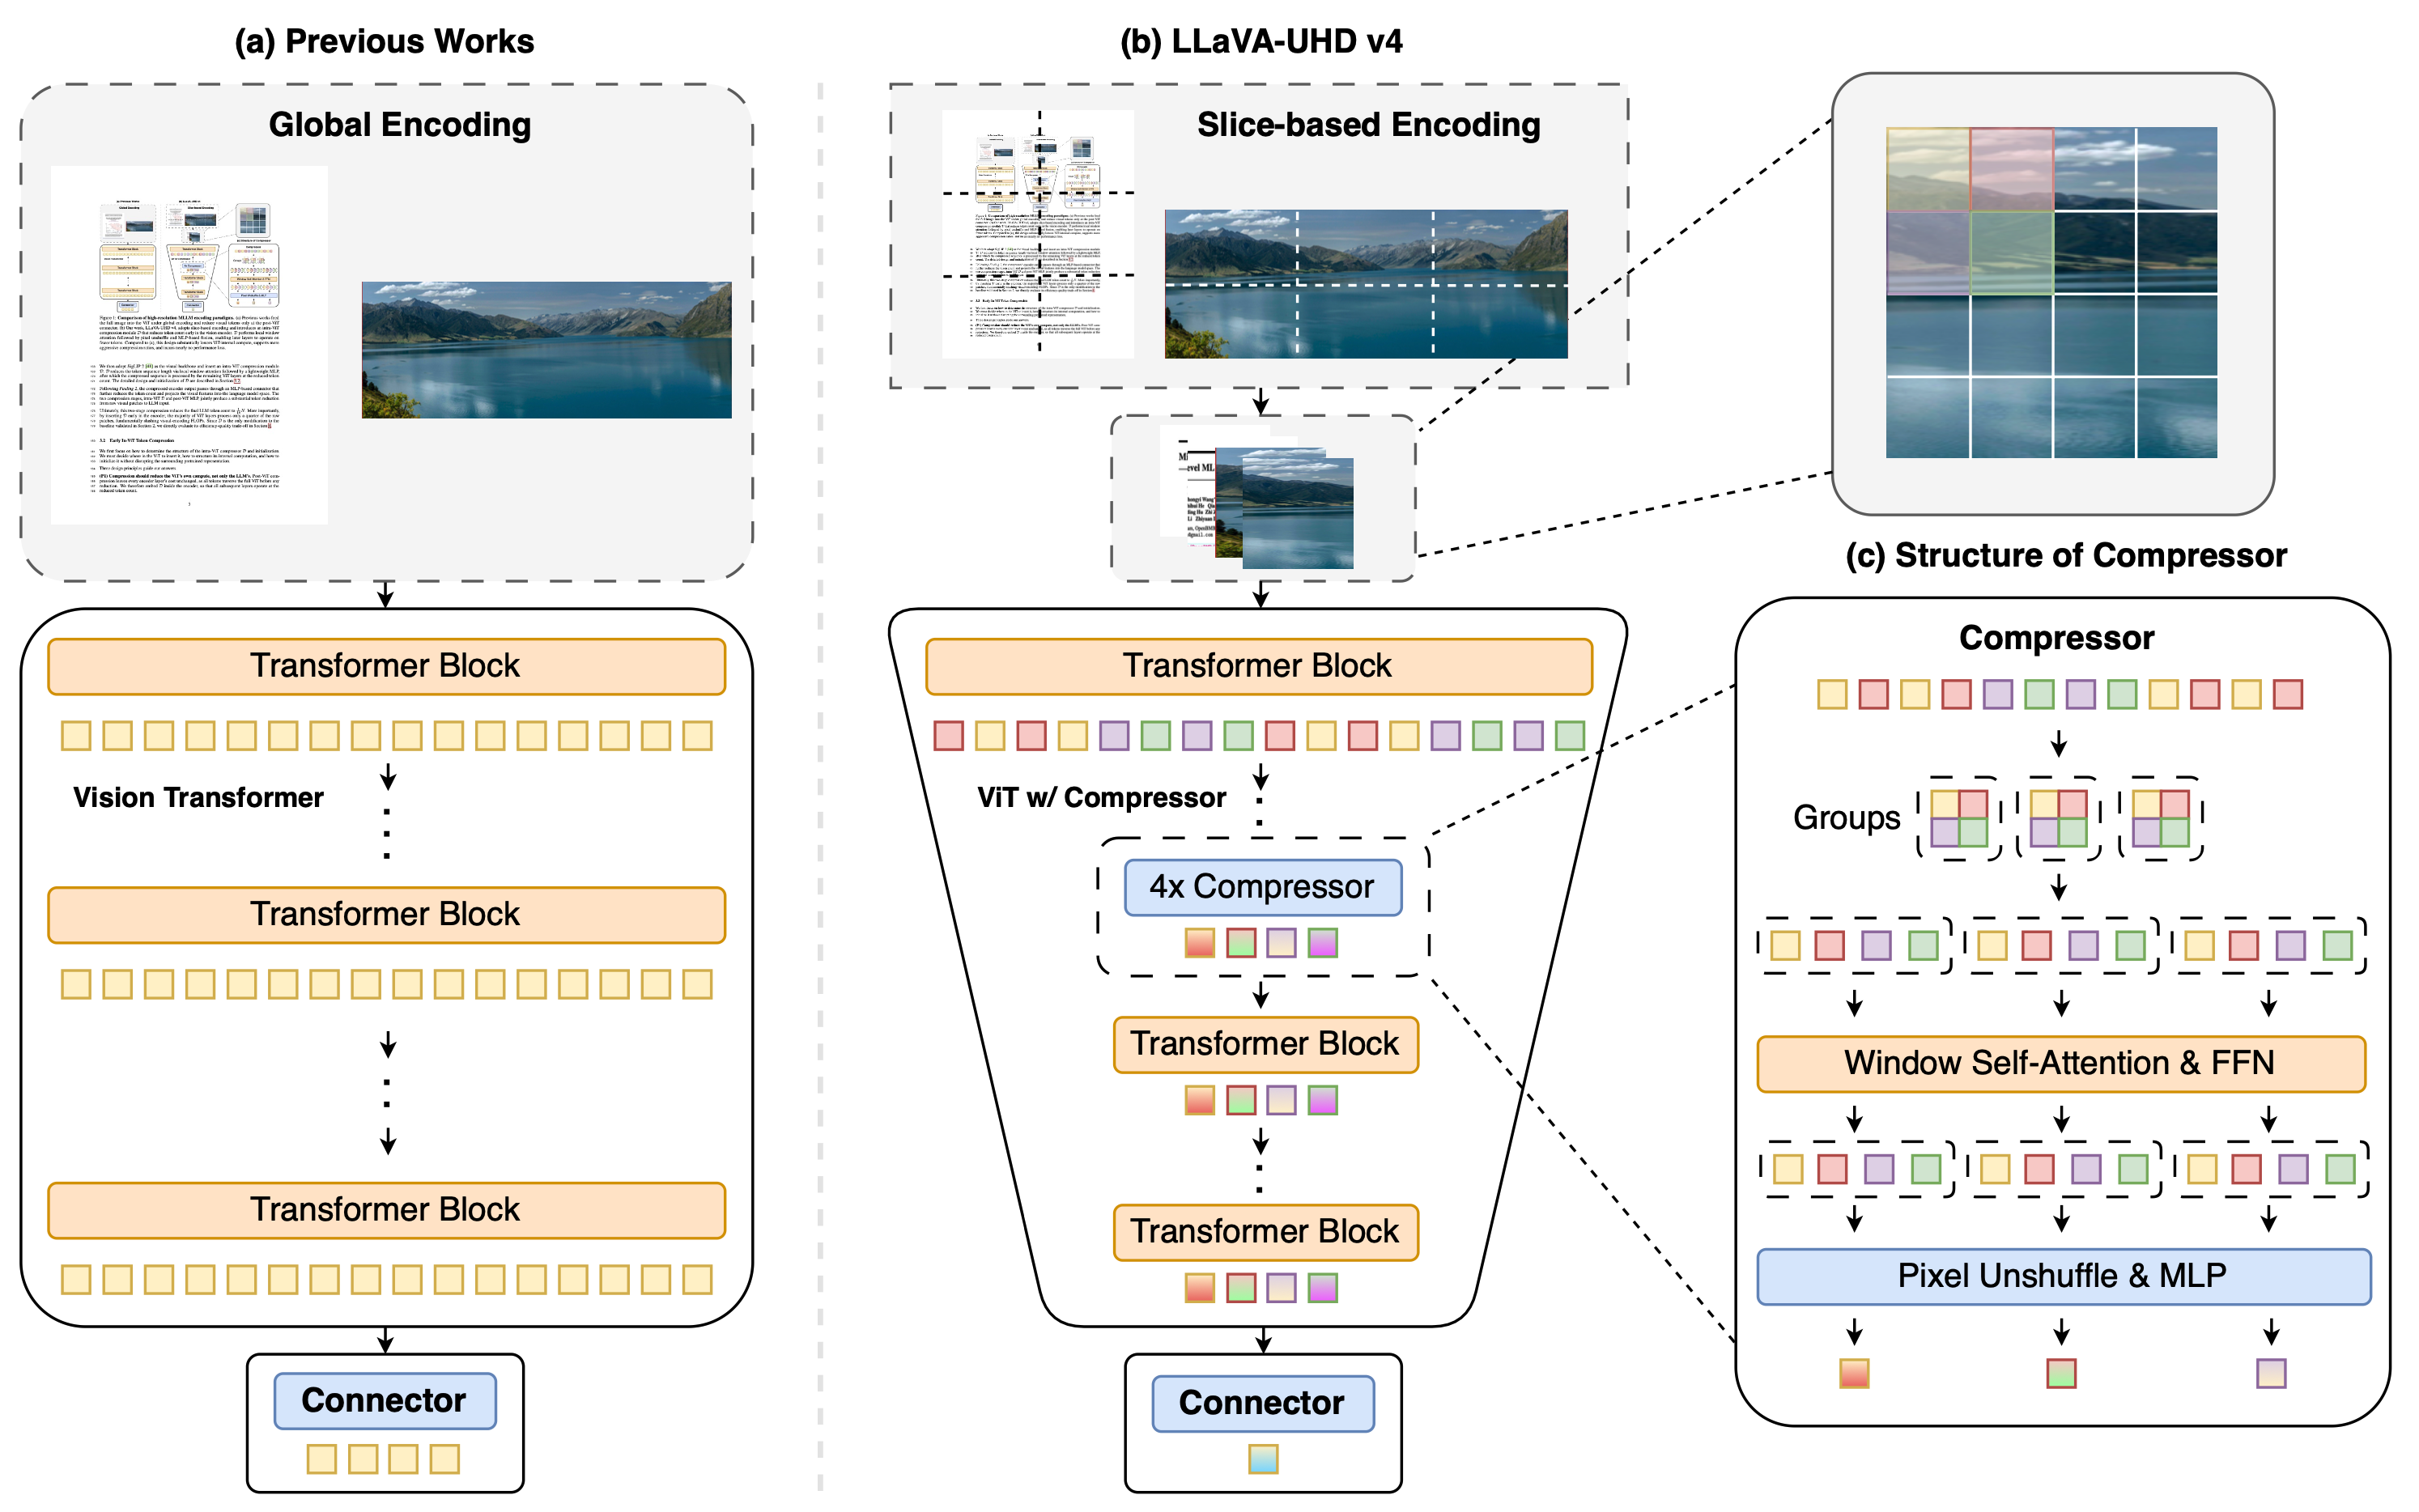
精选文章 视觉 FLOPs 减半!清华最新成果 LLaVA-UHD v4,突破高分辨率多模态大模型的视觉编码效率瓶颈 随着多模态大语言模型(Multimodal Large Language Models, MLLMs)不断向文档理解、OCR、图表分析与高分辨率真实场景理解等细粒度任务拓展,高分辨率图像输入正在逐渐成为主流配置。 然而,更高的视觉分辨率也带来了急剧增长的视觉 token 数量,使得视觉编码本身逐渐成
精选文章 陈天奇团队最新开源 PithTrain:Agent 时代的 MoE 训练框架设计 作者:赖睿航,CMU CS Ph.D. https://zhuanlan.zhihu.com/p/2045509863221064141 TL;DR PithTrain 是一个精简、agent-native 的 MoE(Mixture-of-Experts)训练框架,整套实现约 1.1 万行 Pyt
精选文章 slime v0.3.0 发布: 重新思考面向 Agent 时代的 RL 训练框架 作者:朱小霖 原文:https://zhuanlan.zhihu.com/p/2044533166694732929 毫无疑问,OpenClaw 和 Opus 一起撞开了 agent 时代。 slime 从一开始坚持的 server-based engine + custom rollout 设计,
青稞Talk ZEDA:将 Post-Trained MoE 迁移为高效动态 MoE MoE 通过稀疏激活在扩大参数容量的同时控制计算量;Dynamic MoE 可以动态调整专家激活数量,让简单 token 使用更少计算,从而进一步提升推理效率。 6 月 9 日(周二)晚 8 点,青稞 Talk 第 130 期,清华大学博士生吕兴泰,将直播分享《ZEDA:将 Post-Trained
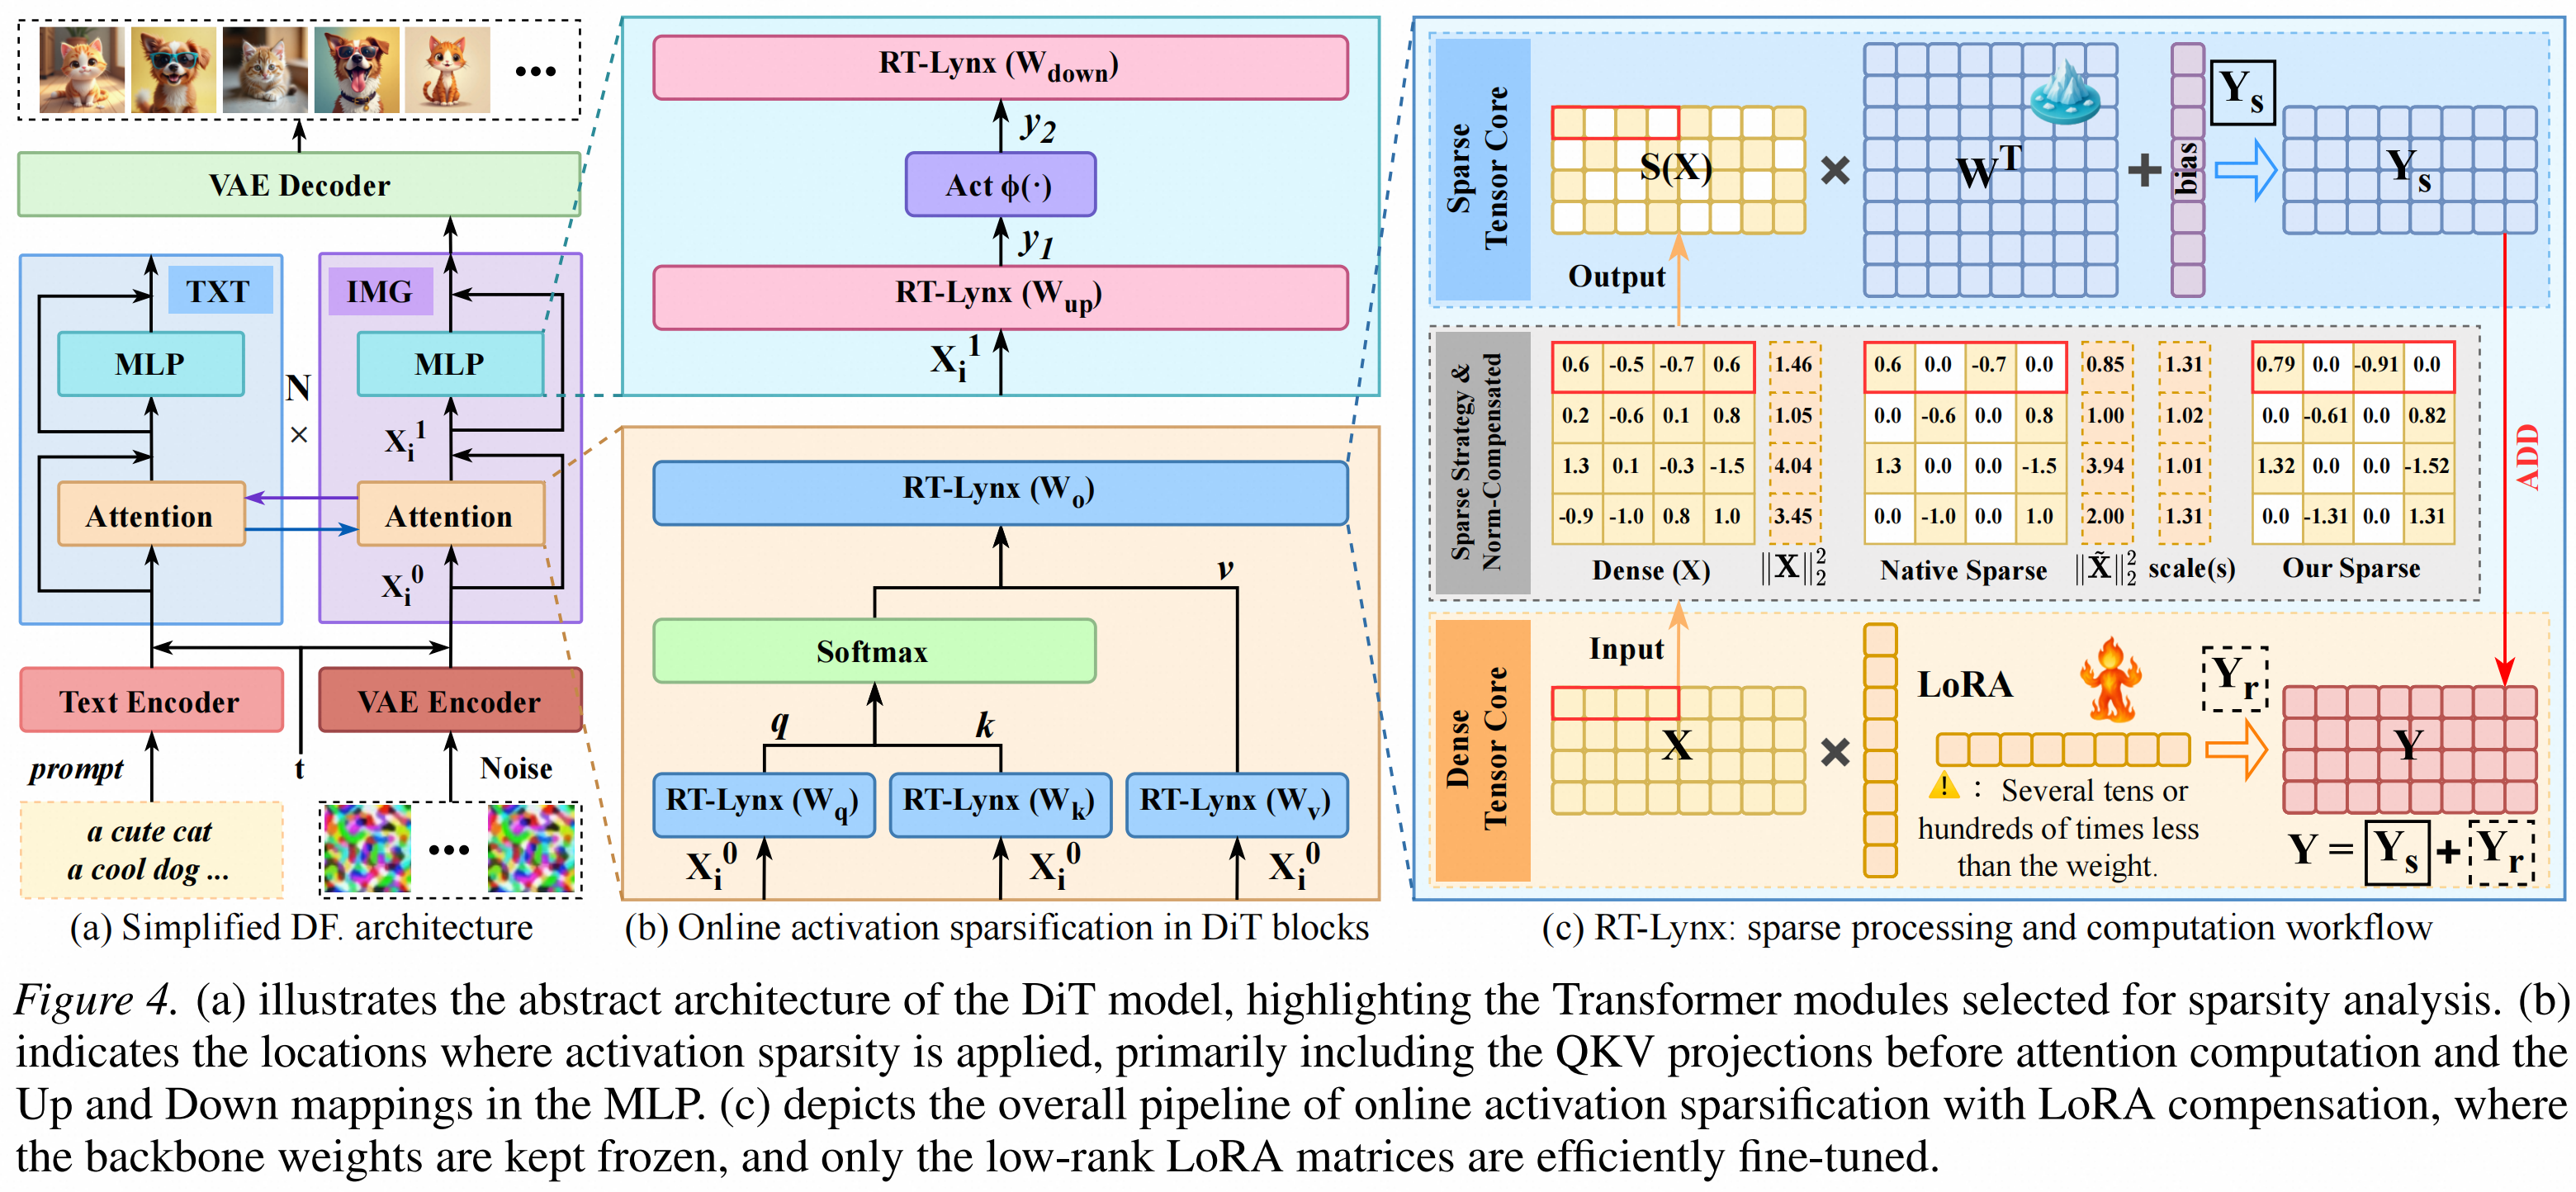
精选文章 ICML'26 | 阿里最新推出 RT-Lynx:把稀疏性用在“对的地方”,让DiT跑的快且不掉点! 如果说过去很多稀疏化方法一直在问“如何更好地剪掉权重”,那么 RT-Lynx 给出的答案是:对于 Diffusion Transformer,真正适合半结构化稀疏的对象可能不是权重,而是激活。 论文标题:RT-Lynx:Putting GEMM Sparsity in the Right Place
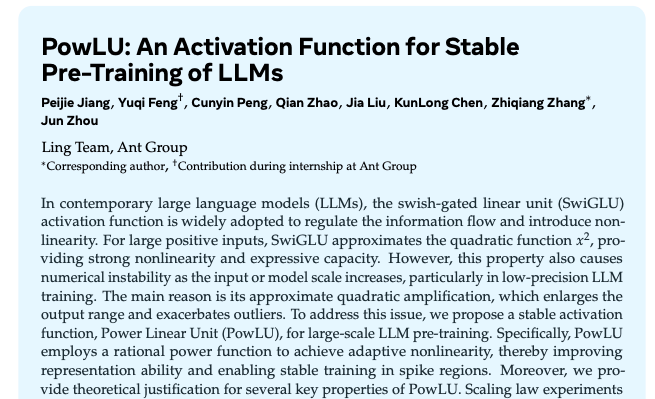
精选文章 解决大模型训练 Loss Spike!重新设计激活函数 SwiGLU,聊聊蚂蚁 Ling 模型背后的 PowLU 作者:jzx 原文:https://zhuanlan.zhihu.com/p/2043283053787841480 TL;DR:SwiGLU 是目前大模型的标配激活函数,但它在低精度训练中会产生严重的数值不稳定问题。我们设计了一个新激活函数 PowLU,用更平缓的增长曲线替代 SwiGLU 的二次
青稞Talk 从 ARPO,到 AEPO,再到 Agent-World:探索通用智能体训练的可行路径 6月6日上午10点,青稞Talk 129 期,青稞社区邀请到中国人民大学高瓴人工智能学院博士生董冠霆,来直播分享《从 ARPO,到 AEPO,再到 Agent-World:探索通用智能体训练的可行路径》。 本次分享将主要围绕三篇通用智能体强化学习论文展开,沿着"智能体强化学习 → 多环境强化学习"的
精选文章 自动化所最新推出 π-Play: 基于自博弈生成特权信息的自蒸馏大模型自进化框架 作者:张曜程,朱圆恒,赵冬斌@中科院自动化所 研究背景 智能体在训练过程中往往面临几个核心瓶颈,标注数据昂贵、奖励信号稀疏,以及长程任务中的信用分配困难。自博弈(Self-Play)提供了一条很有吸引力的路径:模型可以自己生成问题、自己学习解决问题,从而减少对外部训练数据的依赖。然而,现有自博弈方法
精选文章 一人独作GQLA,挑战DeepSeek的MLA、DSA 作者:孟繁续 https://zhuanlan.zhihu.com/p/2039637653314856841 文章链接:https://huggingface.co/papers/2605.15250 代码链接:https//github.com/MuLabPKU/TransArch GQLA的前
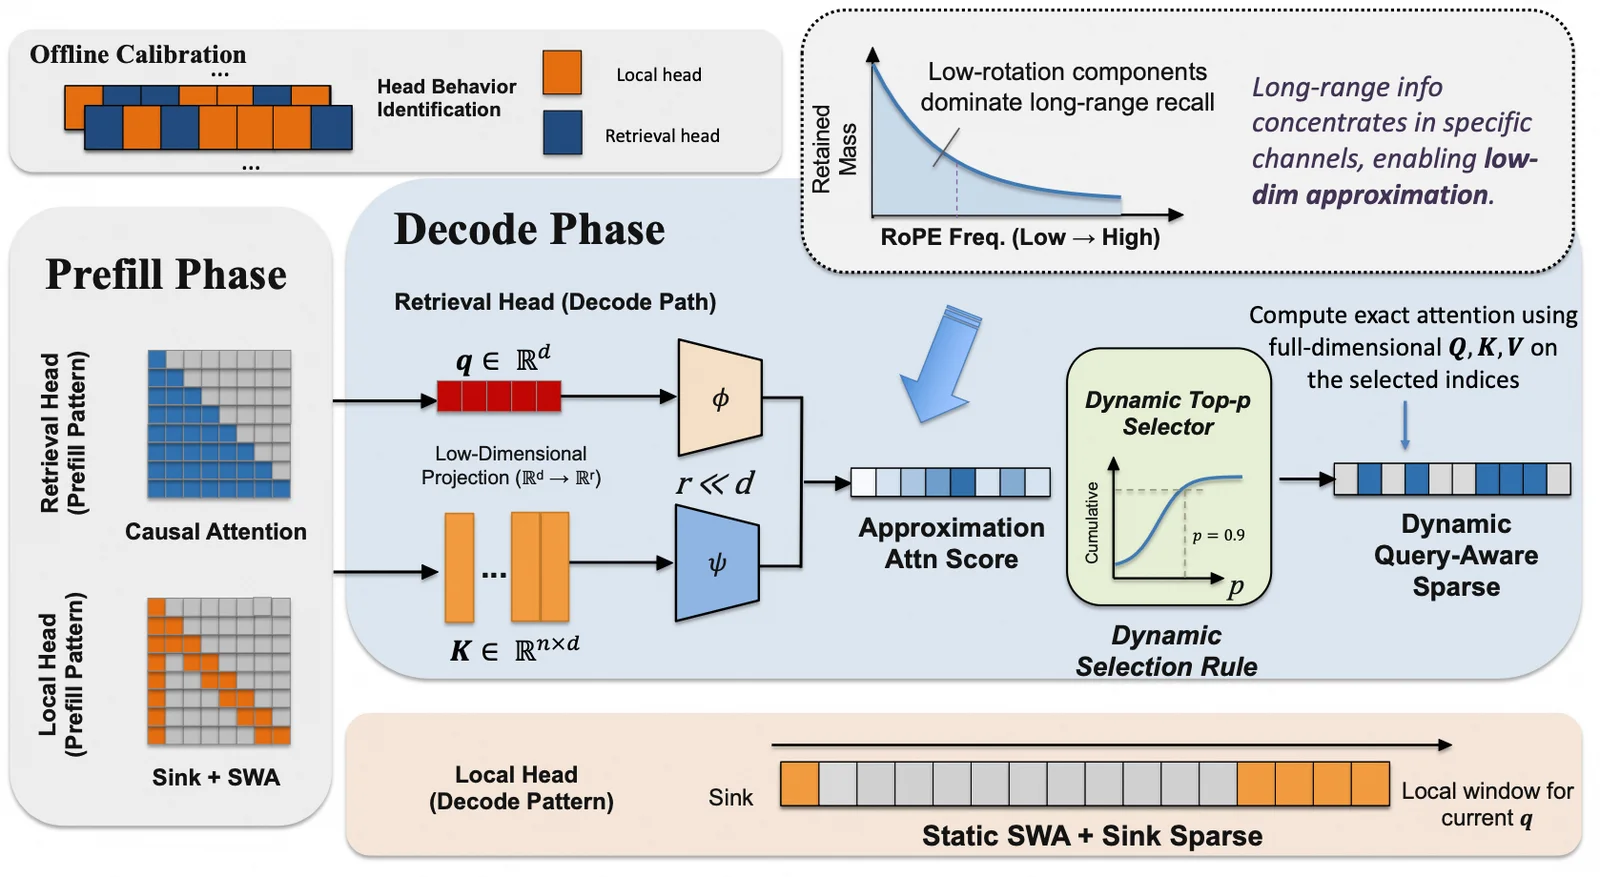
精选文章 长文本推理一定要改架构?阿里最新提出 RTPurbo:仅需百步训练,无损达到 97%+ 稀疏度与 9 倍加速 作者:周琰轲,南京大学二年级硕士研究生,阿里巴巴实习生,RTP-LLM项目核心贡献者 长上下文能力已成为现代大语言模型的基础要求,但全注意力机制(Full Attention)随序列长度呈平方级增长的计算复杂度,构成了推理阶段的核心瓶颈。为了缓解这一问题,目前业界主要探索了两条技术路线: 1.Tra
青稞Talk δ-mem:从长上下文到在线记忆,动态演化原生记忆的一次尝试 δ-mem是一种面向大语言模型的轻量级在线记忆机制。不同于把历史全部塞进长上下文,δ-mem 将过去信息压缩进一个极小的在线关联记忆状态,并在生成时通过低秩 correction 直接调制 frozen Transformer 的 attention computation。 主实验中,仅使用 8
精选文章 动态MoE迁移算法ZEDA:让 MoE 自己学会"摸鱼",推理提速 20% 作者:吕兴泰@清华-博士生 原文:https://zhuanlan.zhihu.com/p/2040445503150805754 免费为科研人员提供成果宣传支持,如有优秀研究成果分享推广,欢迎投稿联系:aiFreeCode 在标准 MoE 里,每个 token 通常都会激活固定数量的 expert
精选文章 ICLR 2026|Next-ToBE:让"自信而短视"的大模型看得更远、推理更准 论文标题:Next-ToBE: Probabilistic Next Token-Bag Exploitation for Activating Anticipatory Capacity in LLMs 论文链接:https://openreview.net/pdf?id=T8IJojfaOh 如
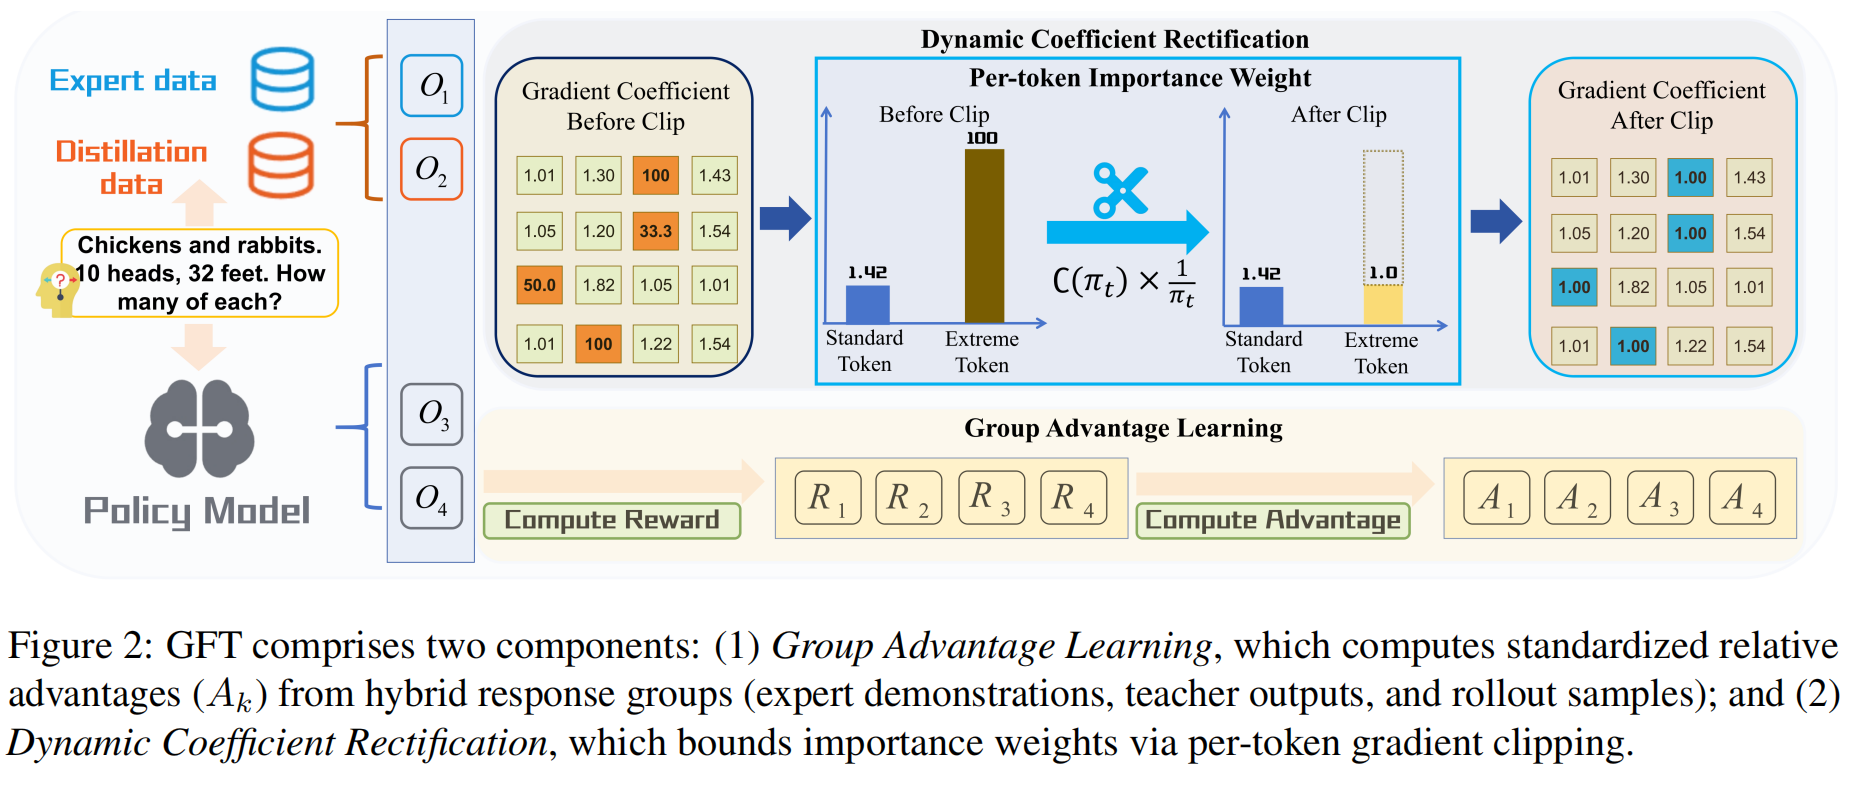
精选文章 ACL 2026 Findings | 浙大提出 GFT:On-Policy SFT 视角下的奖励微调 🧪 Title: GFT: From Imitation to Reward Fine-Tuning with Unbiased Group Advantages and Dynamic Coefficient Rectification 🎉 Venue: ACL 2026 Findings 📝 P
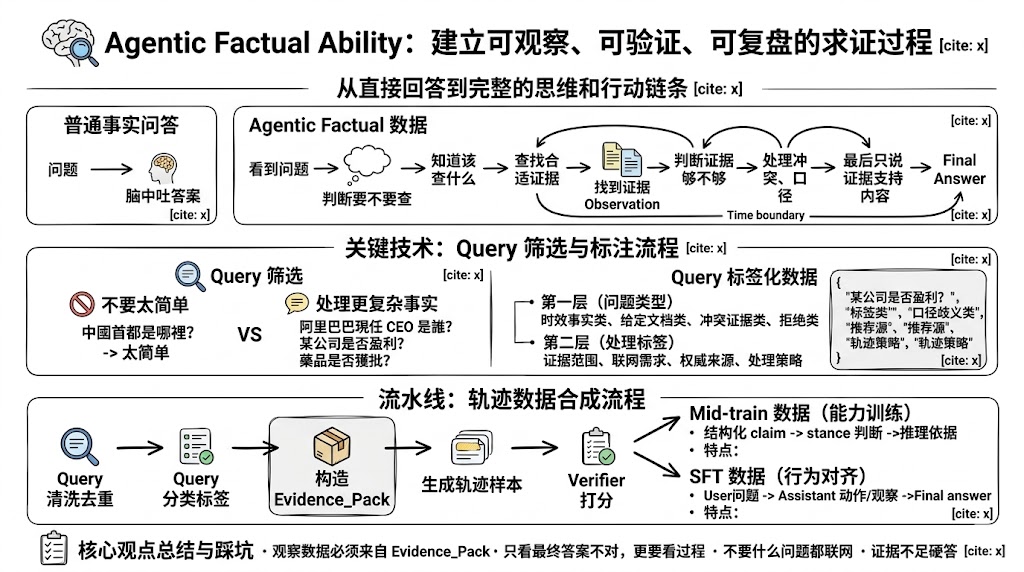
精选文章 如何合成 Agentic 事实性 SFT / Mid-train 数据? 作者:好奇的小逸 原文:https://zhuanlan.zhihu.com/p/2036619681105228260 最近正好在搞 agentic factual ability的问题,就想着先总结一下目前的内容,这里首先想一下我们的目标是什么?直接给出结果的普通事实类问答吗?显然不是。我们这里
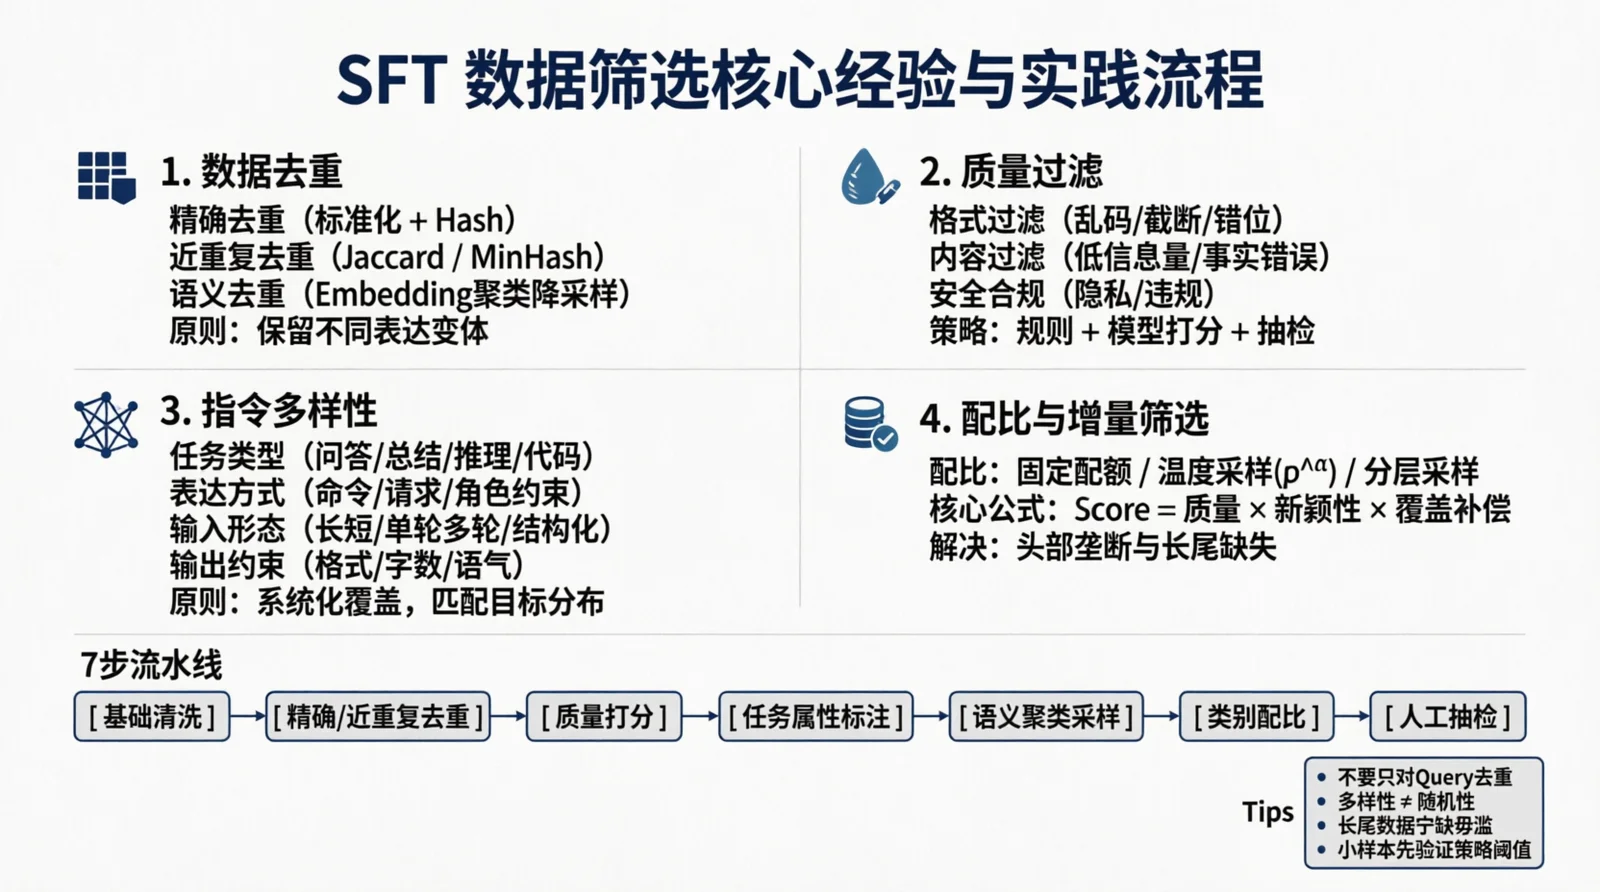
精选文章 经验分享!如何进行 Mid-train 以及 SFT 的 Query 筛选 作者:好奇的小逸 https://zhuanlan.zhihu.com/p/2035128896316756341 之前再做Mid-train和SFT时,积攒了一些经验,一直没有去写这方面的内容,这次就好好的总结一下相关的内容, 首先我们先有个认知就是:真正影响训练效果的,往往不是总量,而是样本的信
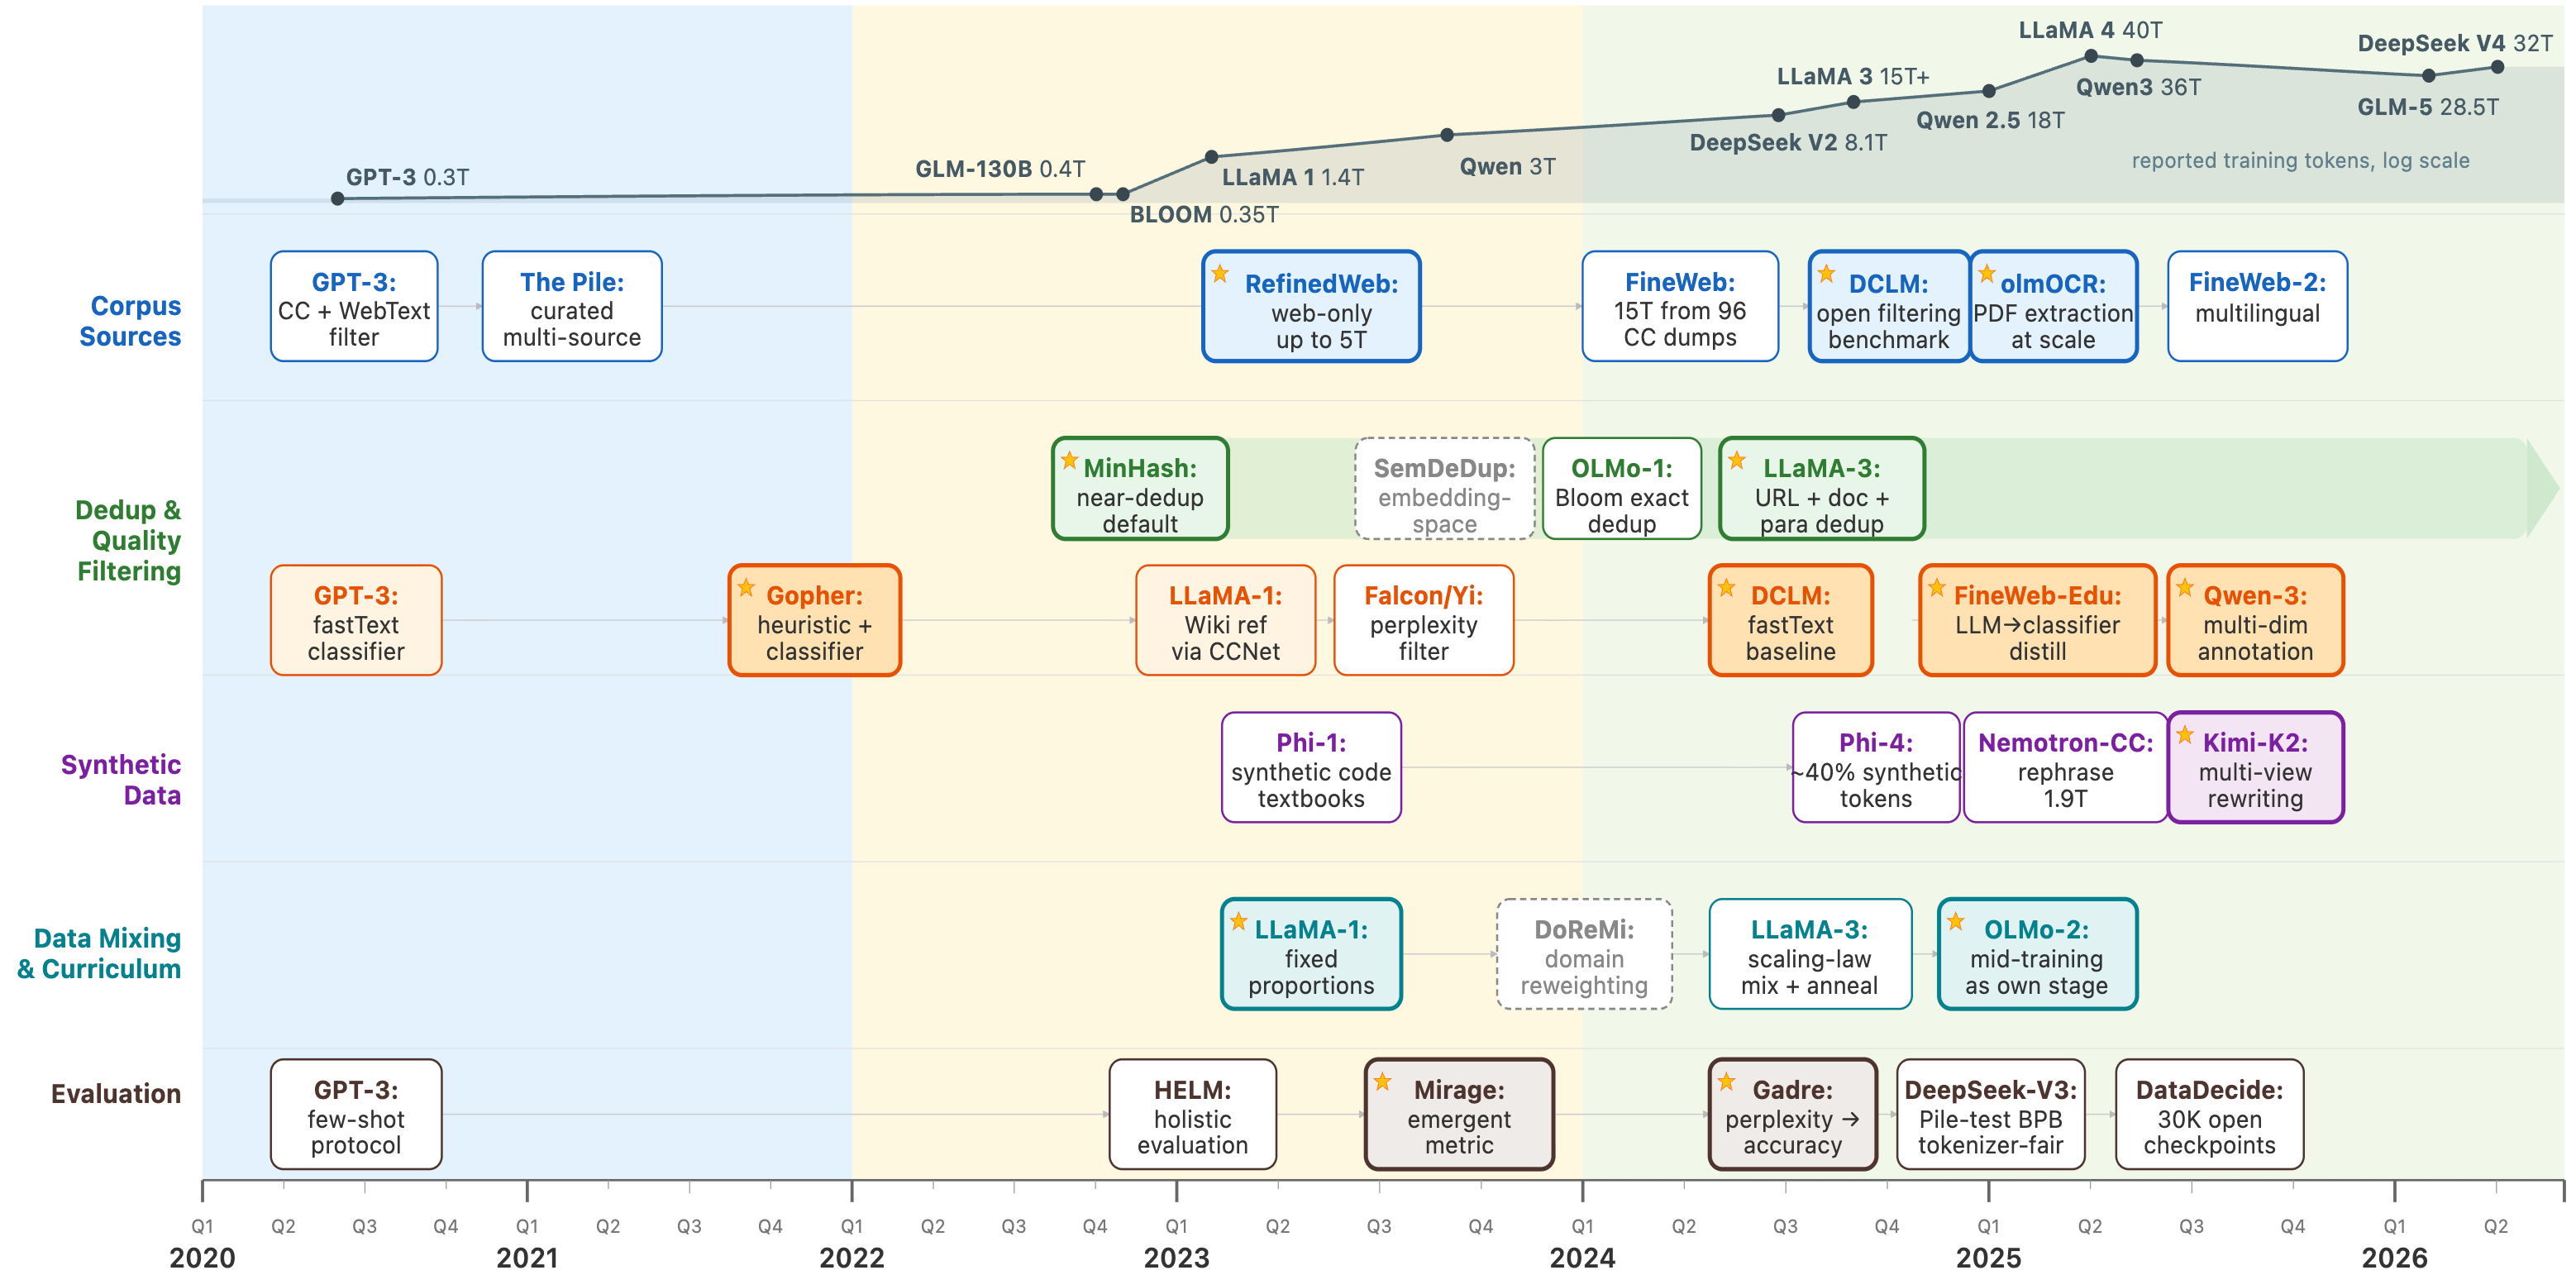
精选文章 工业级 LLM 预训练数据工程的关键实践! 作者:李煜东 Yudong https://zhuanlan.zhihu.com/p/2032080549381190858 写在前面: LLM 研究的关注重心正在这几年内不断转移,从post train到强化学习再到agentic/harness工作流。这些都体现了技术前沿和社区焦点的演进。对于用
精选文章 从 DeepSeek V4 的多专家 on-policy Distillation 反观人类学习模式 作者:九老师 https://zhuanlan.zhihu.com/p/2031622077107659474 2026 年了,一个 LLM 的训练流程并不陌生——pre-train,SFT,RLHF/RLVR。但实际这是一个领域 LLM 的训练方案,比如 Coder/Match/文本专家,怎么整合
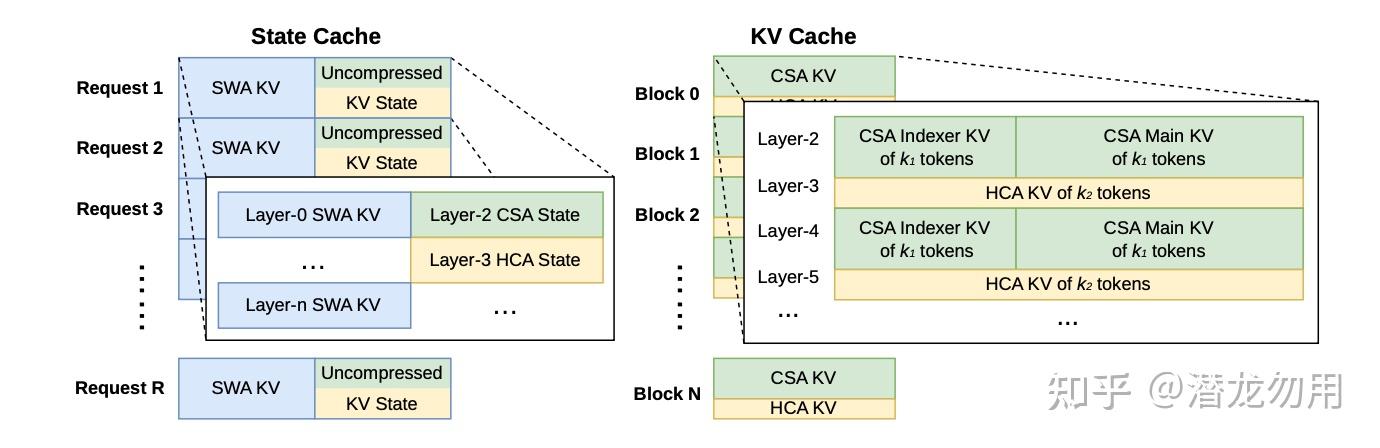
精选文章 DeepSeek-V4技术报告解读: 从架构到 Infra 的全栈重构 作者:潜龙勿用 https://zhuanlan.zhihu.com/p/2030982954617414764 这份技术报告发布了 DeepSeek-V4 系列的 preview 版本,包含两个 MoE 模型:DeepSeek-V4-Pro(总参数 1.6T,激活 49B)与 DeepSeek-V
精选文章 拆解 Gemma 4 架构和训练的技术选择,以及与 Qwen3 和 GLM-5 的对比 作者:方弦 https://zhuanlan.zhihu.com/p/2023880667814003300 2026年4月2日,Google DeepMind发布Gemma 4。31B参数的dense模型在AIME 2026上拿到89.2%,MoE变体26B-A4B以3.8B活跃参数在MMLU P
精选文章 大模型的下半场是什么?林俊旸:从 Reasoning Thinking 到 Agentic Thinking 林俊旸在x上发了一篇长文,特此分享 https://x.com/JustinLin610/status/2037116325210829168 过去这两年,彻底颠覆了我们评估和期待大模型的方式。 OpenAI 的 o1 告诉我们:思考本身就能成为模型一种核心的一等能力,你可以专门为了思考去训练模型,
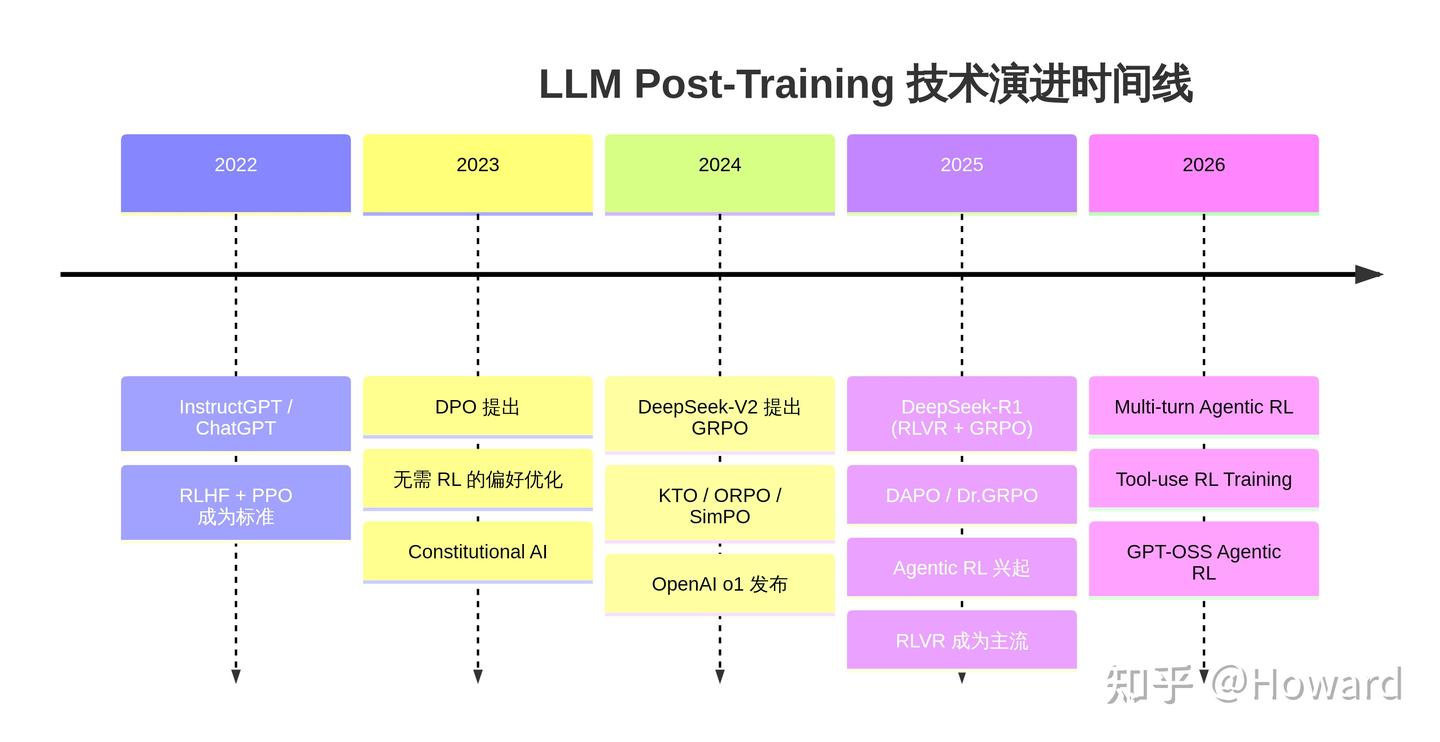
精选文章 LLM Post-Training 全景指南:从 RLHF 到 GRPO 再到 Agentic RL 作者:Haohe,Meta FAIR 研究科学家 https://zhuanlan.zhihu.com/p/2012909606771400823 1. 引言:什么是 Post-Training? 大语言模型(LLM)的训练通常分为两个大阶段:预训练(Pre-training) 和 后训练(Post
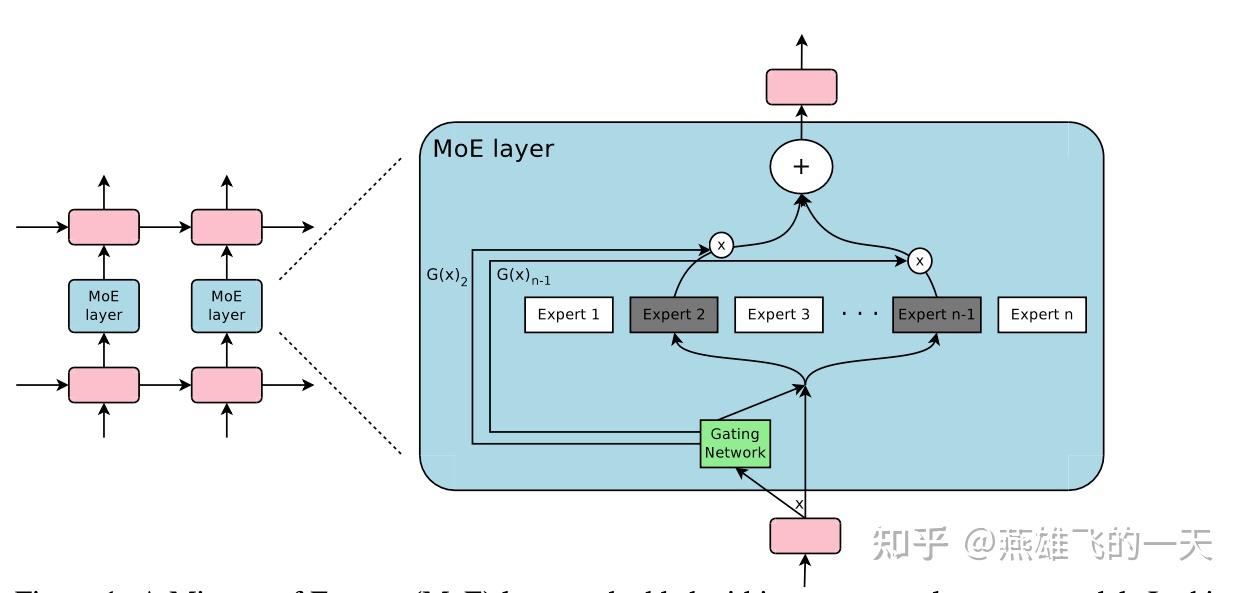
精选文章 MOE 架构如何做 SFT 和 RL?聊聊 post-training 难点与经验 作者:燕雄飞的一天 https://zhuanlan.zhihu.com/p/2018018879109091590 无论是开源还是顶尖商业模型,moe架构已经成为绝对主流,区别于dense模型,在sft和rl阶段有什么独特的训练难点或者挑战,对于这些挑战如何缓解。期望从基础原理入手,看如何训练mo
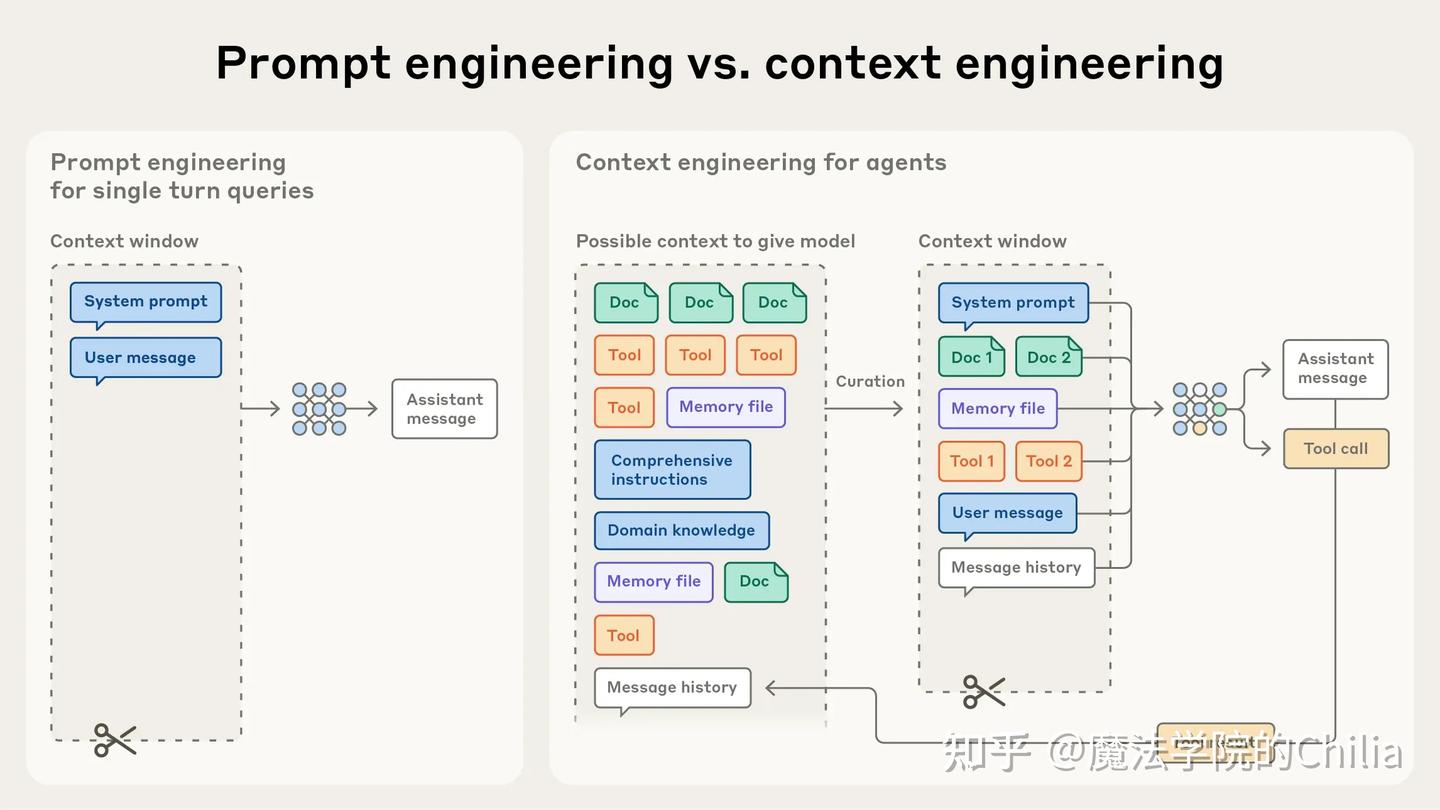
精选文章 干货!万字长文解析 Agent 框架中的上下文管理策略 作者:魔法学院的Chilia https://zhuanlan.zhihu.com/p/2012088406826562496 0x01. 背景 (1)什么叫上下文工程(Context Engineering)? “上下文工程”简单来说,就是在一些LLM的约束下(如上下文窗口大小、注意力长度的限制)
青稞Talk 从 Depth Scaling 到 Width Scaling!WideSeek-R1:通过多智能体 RL 探索大模型的广度扩展(Width Scaling) DeepSeek-R1 的成功证明,深度扩展(Depth Scaling)在复杂逻辑推理中具有巨大潜力。但当任务从“深推理”转向“广信息”——如汇总全球头部科技公司多维财务数据——单一大模型往往受限于多轮检索带来的上下文干扰与串行效率瓶颈。 为此,我们提出“广度扩展”(Width Scaling)这
精选文章 北航等最新提出!让 LLM 互相「审稿」:极简大语言模型协作/集成方法实现 7% 性能提升 论文题目:Scoring, Reasoning, and Selecting the Best! Ensembling Large Language Models via a Peer-Review Process 作者信息:Zhijun Chen 1, Zeyu Ji 1, Qianren Mao
青稞Talk EditReward : 当 AI 学会“审美”,可控多模态生成的下一代范式 为什么开源图像编辑模型总感觉不如 GPT-4o 或 Nano-Banana 那么“听话”?核心痛点在于缺乏一个真正理解人类审美的 AI “裁判”。 3月14日(周六)上午10点,青稞 Talk 第112期,清华大学在读博士生吴科明,将直播分享《EditReward :当 AI 学会“审美”,可控多模
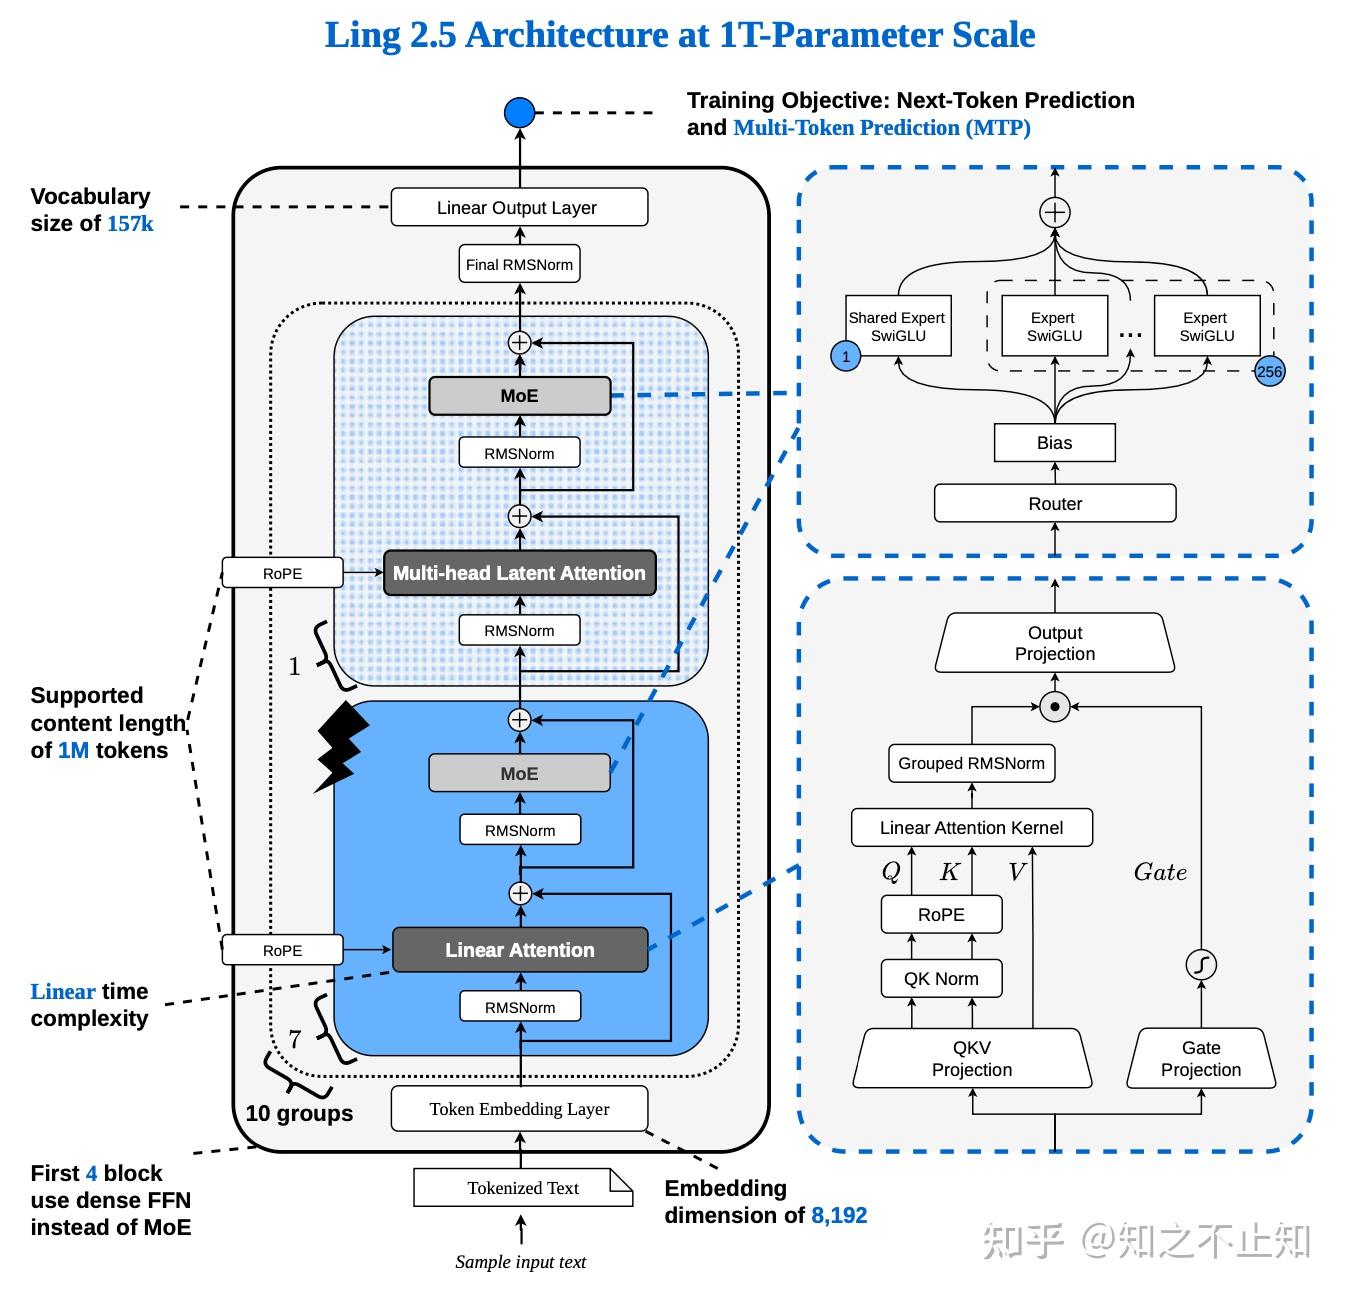
精选文章 Ling 2.5 Lightning Attention+MLA混合线性架构改造实践 作者:知之不止知 原文:https://zhuanlan.zhihu.com/p/2010050657122546578 基模架构设计的核心思路是用更低的理论计算(FLOPs)或真实算力(GPU hours)实现更大的架构效率杠杆(Efficiency-Leverage)。在 Ling 2.0架构的
青稞Talk Dr. Kernel: 突破大模型 GPU Kernel 生成的多轮 RL 训练瓶颈 比肩 GPT-5 的 Kernel Coding 模型!Dr. Kernel 用多轮 RL 训练大模型 GPU Kernel 生成 让大模型通过强化学习(RL)生成 GPU Kernel 是业界共同的期望。但由于极易受“钻漏洞(reward hacking)”和“惰性优化(lazy optimiza
青稞Talk 线性轨迹:揭示 LLM 强化学习中的高效捷径 LLM RL 训练轨迹竟然是线性的?Miaow Lab 最新工作:无需继续训练,直接“预测”未来模型! 研究发现,在RLVR训练过程中,LLM的权重和输出概率演化呈现出显著的线性特征,理论分析发现,这源于低学习率、大Batch Size及Adam优化器的特性。说明昂贵的RLVR存在大量冗余计算。 基
精选文章 LLM的RL训练轨迹竟然是线性的?Miaow Lab新工作:无需继续训练,直接“预测”未来模型! 作者:王天乐,香港城市大学数据科学系博士生,导师为苗宁教授,研究方向为大语言模型推理。 DeepSeek-R1 的爆火让 RLVR(带验证奖励的强化学习) 再次成为大模型后训练(Post-training)的焦点。然而,复现过 R1-Zero 或类似流程的同学都知道,RLVR 极其昂贵——它不仅需要
精选文章 一张表串讲LLM-RL中KL散度正则的正确与错误用法 作者:龙心尘 https://zhuanlan.zhihu.com/p/2005366418179385192 声明:为突出重点,部分背景知识已略去,同时涵盖的内容也难免有疏漏之处,还望读者理解。 背景说明 1.KL散度正则化涉及多种决策项,包括:使用正向KL散度还是逆向KL散度(2种)、将其置于损
精选文章 比肩 GPT-5 的 Kernel Coding 模型!Dr. Kernel 用多轮 RL 训练大模型 GPU Kernel 生成 让大模型生成 GPU Kernel是大家对大模型发展的一个共同期望,并且GPU Kernel本身作为一类代码,天然可被执行,从而获得来自环境的反馈。直觉上非常适合通过 LLM 结合强化学习(RL)的范式进行训练。然而目前并没有行之有效的办法对Kernel生成进行有效的、长时间的 RL 训练。 来自港
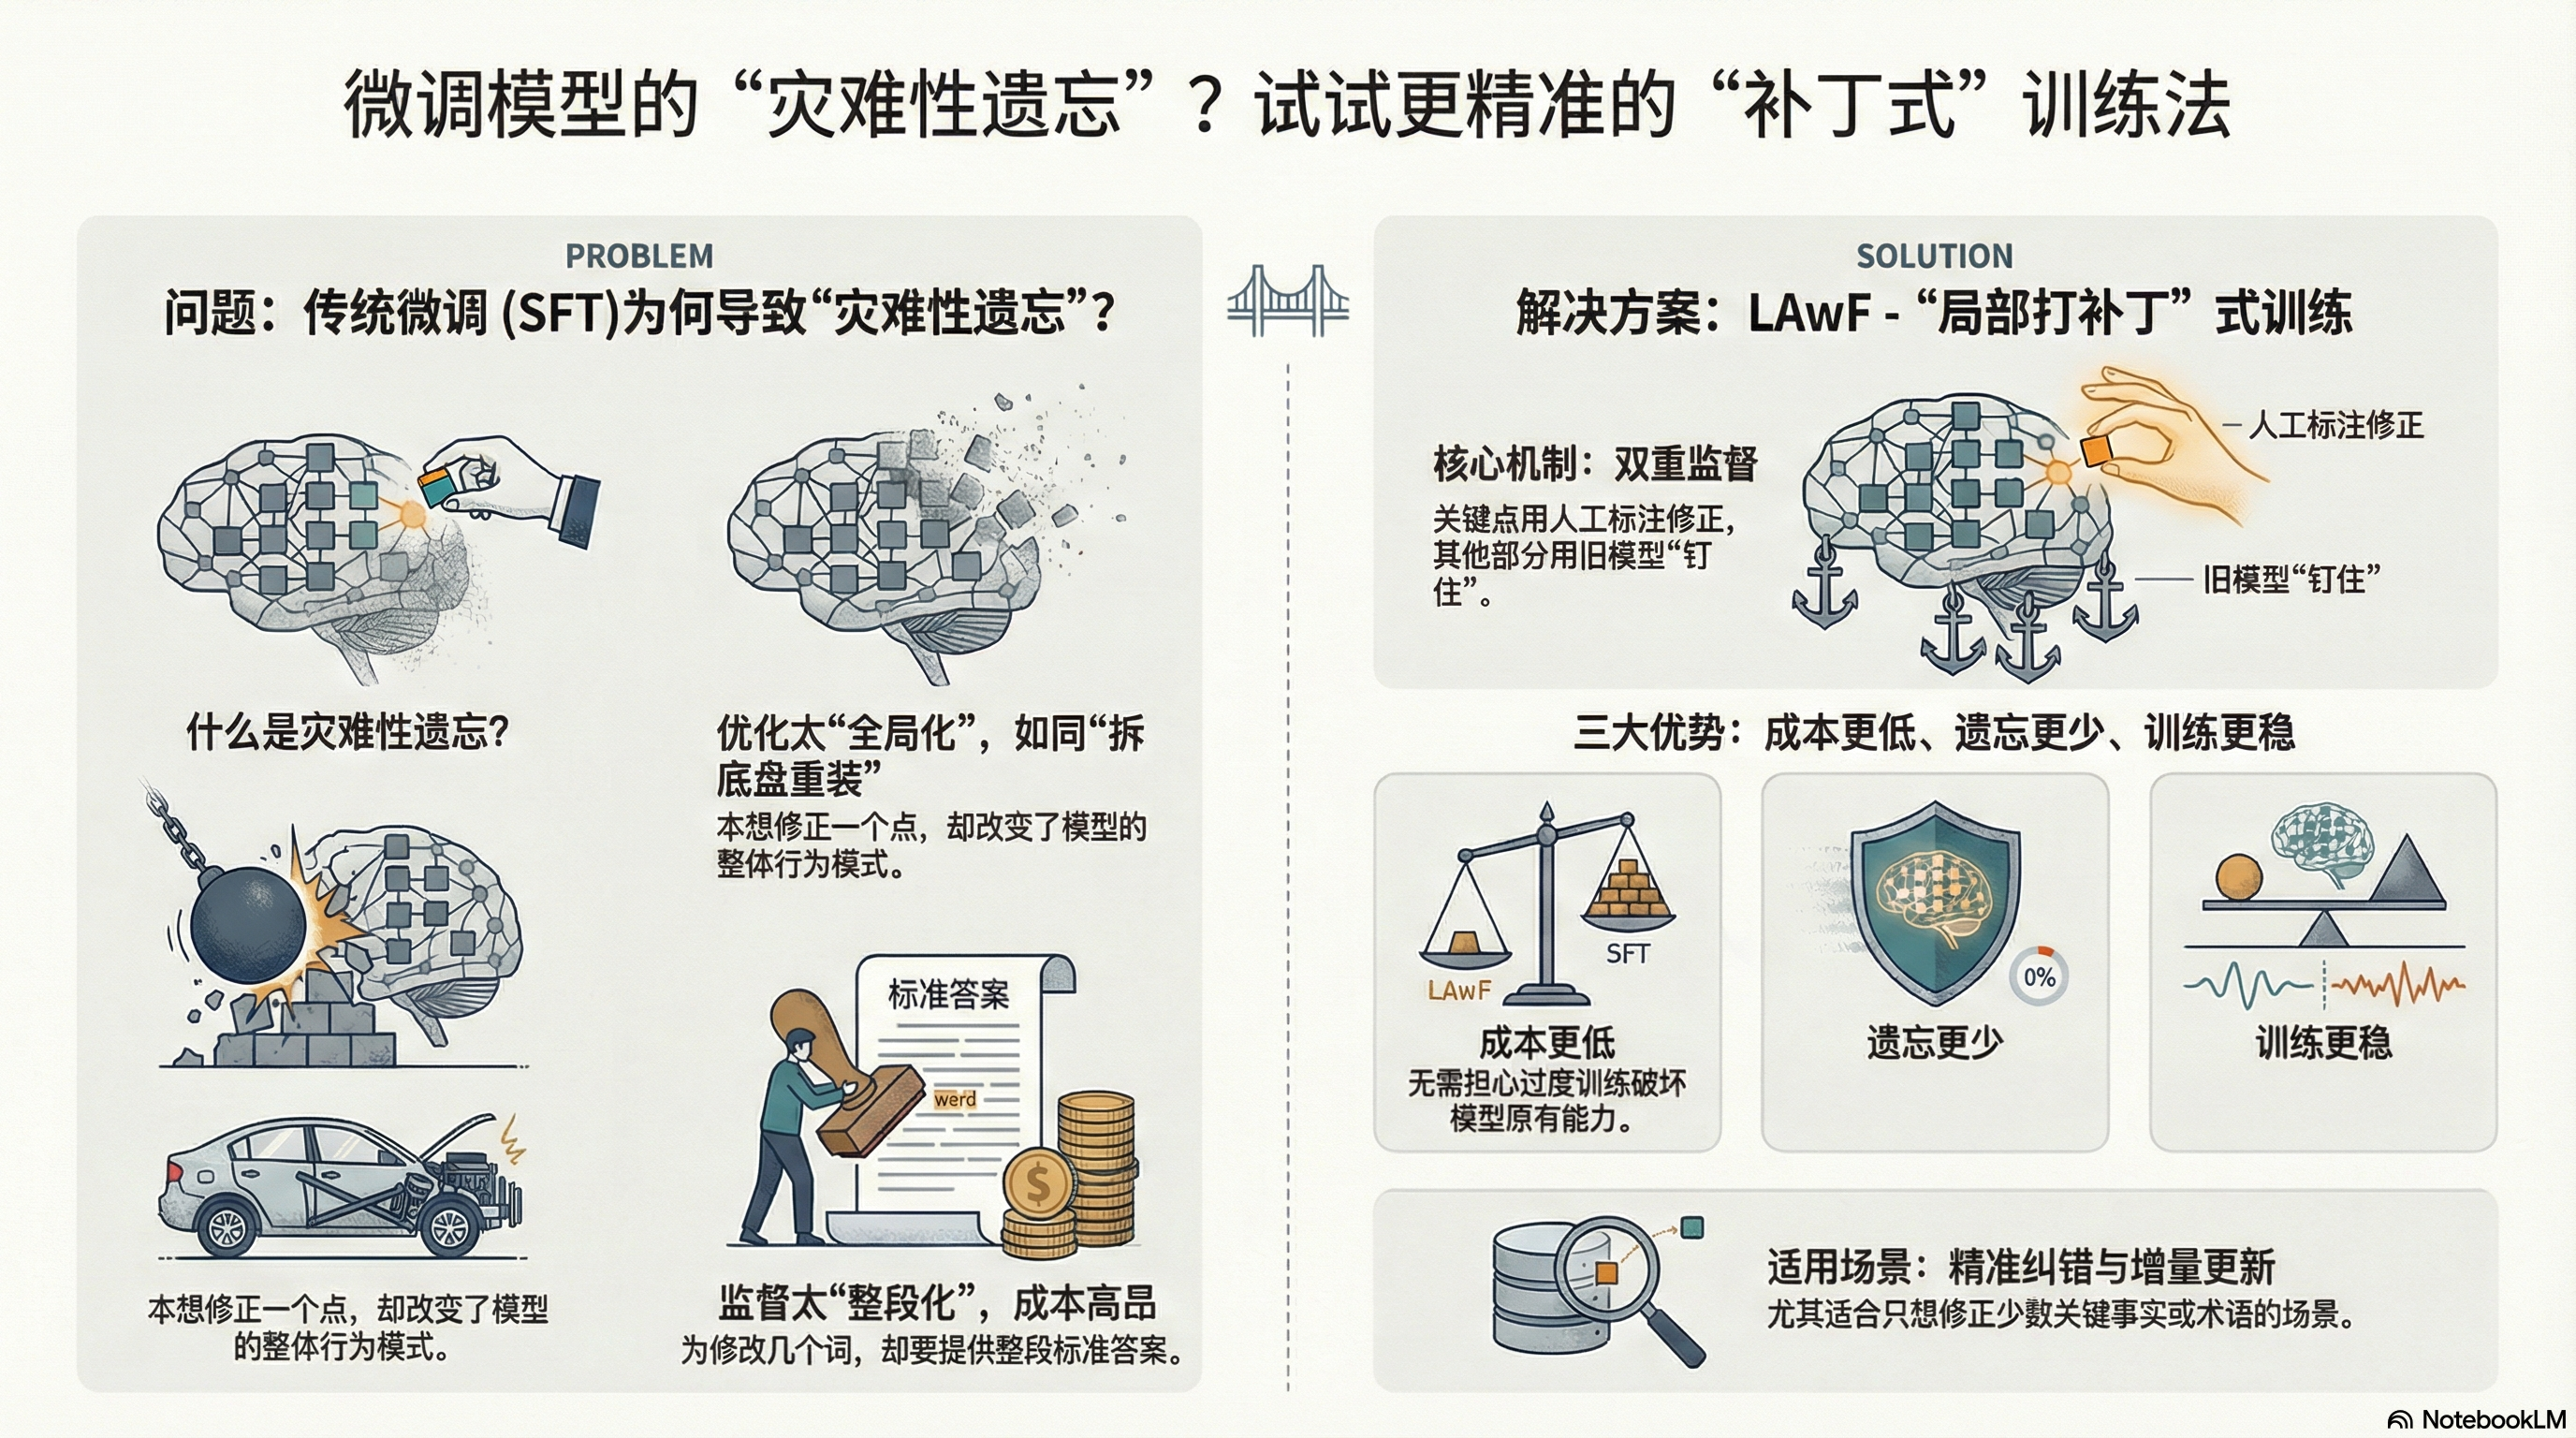
精选文章 只改几个 Token,就能教会大模型新知识,还不忘旧知识? 想微调一小部分,为什么模型会“连带变笨”? 很多人第一次微调大模型都会被一个现象吓到:你只是想教它一件很小的事——比如“某个术语必须按公司口径解释”,结果训练完它在别的题型上反而变差了,甚至一些原本答得挺稳的常识也开始飘。 这就是大家熟悉的灾难性遗忘(catastrophic forgetting)
精选文章 大模型为什么会产生“离群值”?深度解析RoPE与注意力机制 作者:唐瀚霖,阿里巴巴高级技术专家,开源推理引擎RTP-LLM的核心作者之一 研究方向为LLM和AIGC的高倍压缩和推理加速方案,曾参与DoubleSqueeze, 1bit-Adam, RazorAttention等工作。 团队介绍 RTP-LLM是阿里巴巴智能引擎团队自研的高性能大模型推理引擎,
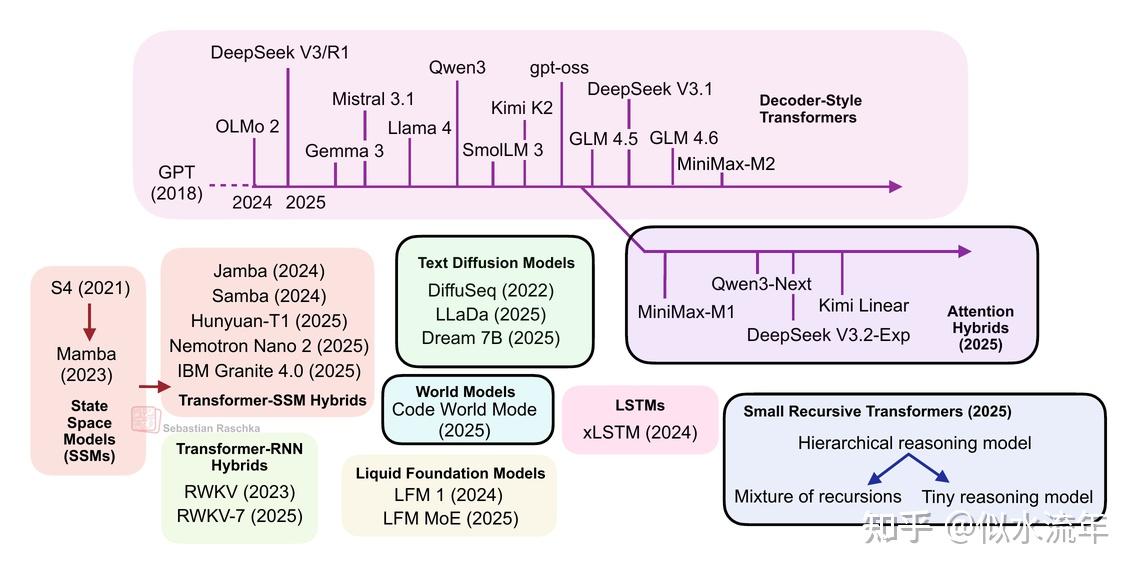
精选文章 标准LLMs的替代方案:线性注意力混合模型|文本扩散|代码世界模型|小型递归Transformer 从DeepSeek R1到MiniMax-M2,当今最大且功能最强的开源权重大型语言模型(LLMs)仍然是基于原始多头注意力机制变体的自回归解码器式Transformer。 然而,近年来我们也看到了标准LLMs的替代方案不断涌现,从文本扩散模型到最新的线性注意力混合架构。其中一些旨在提高效率,而另一
精选文章 智谱 AI 首席科学家唐杰:AI 应用的本质是替代或增强人类工种,而不是为了做 App 而做 App 作者:唐杰 https://weibo.com/2126427211/5247011059141988 最近的一些感悟,分享一下,希望对大家有用。 1、预训练使得大模型已经掌握世界常识知识,并且具备简单推理能力。更多数据、更大参数和更饱和的计算仍然是scaling基座模型最高效的办法。 2、激活对齐
青稞Talk 从 BF16 到 FP16:如何解决RL训练-推理不匹配问题 大语言模型(LLM)的强化学习(RL)微调常因训练与推理策略间的数值不匹配而面临训练不稳定的问题。相比在算法上引入重要性采样来打补丁,我们发现直接从根源上提高浮点数的精度更加有效。 论文:Defeating the Training-Inference Mismatch via FP16 链接:ht
青稞Talk Fast-dLLM v2:高效训练推理的块扩散大语言模型框架 在往期的 #青稞Talk 中,香港大学MMLab博士生吴成岳,曾直播分享过Fast-dLLM!Fast-dLLM 是 NVIDIA 联合香港大学、MIT等机构推出的扩散大语言模型推理加速方案。 关于 Fast-dLLM 的介绍可以参考: 港大&NV&MIT开源Fast-dLLM:无需重新训练模型,直
青稞Talk Generative RLHF-V: 面向多模态 RLHF 的人类意图对齐框架 训练与人类意图对齐的多模态大模型是一个长期挑战。传统的基于分数的奖励模型在强化学习(RLHF)中存在准确性低、泛化性弱和可解释性差等问题。 11月15日(周六)上午10点,青稞社区和减论平台将联合组织青稞Talk 第89期,并邀请到北京大学博士生周嘉懿,直播分享《Generative RLHF-V:
青稞Talk RL 训练框架:QeRL 量化技术增强强化学习 Reasoning 探索 11月8日(周六)上午10点,青稞Talk 第87期,香港大学直博生黄炜,将直播分享《RL 训练框架:QeRL,量化技术增强强化学习 Reasoning 探索》。 分享嘉宾 黄炜,香港大学三年级直博生,师从齐晓娟教授。英伟达研究院Efficient AI & Learning and Percept
青稞Talk OpenMoE 2: Sparse Diffusion Language Models 11月4日(周二)晚8点,青稞Talk 第85期,NUS AI Researcher倪瑾杰,将直播分享《OpenMoE 2: Sparse Diffusion Language Models》,聊一聊为什么 Diffusion MoE 可能是下一代大模型架构方向。 分享嘉宾 倪瑾杰,NUS AI R
青稞Talk 统一 SFT & RL:迈向大型语言模型后训练的统一视角 10月28日(周二)晚8点,青稞Talk 第83期,清华大学博士生吕兴泰,将直播分享《统一 SFT & RL:迈向大型语言模型后训练的统一视角》。 分享嘉宾 吕兴泰,清华大学二年级博士生,导师为周伯文教授。研究方向为大语言模型架构优化、强化学习和高效训练技术。在ACL,EMNLP,NeurIPS,I
青稞Talk RL for LRMs:探讨面向推理模型的 RL 最新研究 10月21日(周二)晚8点,青稞Talk 第80期,清华大学博士生张开颜,将直播分享《RL for LRMs:探讨面向推理模型的 RL 最新研究》。 分享嘉宾 张开颜,清华大学三年级博士生,导师为周伯文教授。研究方向为大语言模型测试时扩展(Test-time Scaling)、强化学习和多智能体协同
青稞Talk 从 LLM-RL 到 Agentic RL:如何让语言模型成为自主智能体 9月18日(周四)晚8点,青稞Talk 第78期,新加坡国立大学博士生张桂彬,将直播分享《从 LLM-RL 到 Agentic RL:如何让语言模型成为自主智能体》。 分享嘉宾 张桂彬是新加坡国立大学计算学院博士研究生,导师为颜水成教授,研究方向为Multi-Agent System,Agent M
青稞Talk ROLL:面向 Agentic 场景的生产级大规模强化学习训练框架 8月23日(周六)上午10点,青稞Talk 第74期,淘天集团未来生活实验室算法专家王维埙博士,爱橙科技智能引擎算法平台大模型强化学习框架工程师熊绍潘,将直播分享《ROLL:面向 Agentic 场景的生产级大规模强化学习训练框架》。 代码:https://github.com/alibaba/RO
青稞Talk RLPR:基于参考概率奖励的强化学习,推广 RLVR 到通用领域推理问题 关于RLPR的技术报告解读:RL突破通用领域推理瓶颈!清华NLP实验室提出基于参考概率奖励的强化学习RLPR 8月12日晚8点,青稞Talk 第71期,清华大学自然语言处理实验室博士生余天予,将直播分享《RLPR:基于参考概率奖励的强化学习,推广 RLVR 到通用领域推理问题》。 分享嘉宾 余天予,
青稞Talk GSPO:大规模强化学习训练算法,迈向持续拓展的语言模型强化学习 8月7日晚8点,青稞Talk 第68期,通义千问研究员,Qwen3、QwQ系列开源模型核心贡献者郑楚杰,将直播分享《GSPO:迈向持续拓展的语言模型强化学习》。 GSPO算法解析:DeepSeek-GRPO重要性权重设计错误?详解Qwen3新强化学习算法GSPO 论文:Group Sequence
青稞Talk 大模型训练流水线并行四部曲:吞吐、内存、负载均衡与线性扩展 8月5日晚8点,青稞Talk 第67期,Sea AI Lab(新加坡)算法工程师,新加坡国立大学博士生万信逸,将直播分享《大模型训练流水线并行四部曲:吞吐、内存、负载均衡与线性扩展》。 分享嘉宾 万信逸,Sea AI Lab(新加坡)算法工程师,新加坡国立大学博士生,专注机器学习系统领域的创新与突破
青稞Talk SIMoE:稀疏插值混合专家,大模型升级再造的自动化专家发现框架 论文:Automatic Expert Discovery in LLM Upcycling via Sparse Interpolated Mixture-of-Experts 链接:https://arxiv.org/abs/2506.12597 7月26日上午11点,青稞Talk 第66期,香
青稞Talk ProRL: 延长强化学习训练框架,拓展大语言模型的推理边界 7月12日上午10点,青稞Talk 第62期,英伟达公司研究员刁诗哲,将直播分享《ProRL: 延长强化学习训练框架,拓展大语言模型的推理边界》。 分享嘉宾 刁诗哲,英伟达公司研究员,曾以访问学者身份在伊利诺伊大学厄巴纳-香槟分校从事研究,并在字节跳动人工智能实验室与创新工场人工智能研究院实习。研究
青稞Talk Satori-SWE:用 Evolutionary Test-Time Scaling 让小语言模型解决复杂软件工程 7月5日(周六)上午10:00,青稞Talk 第60期,新加坡科技设计大学博士生曾广韬,将直播分享《Satori-SWE:用 Evolutionary Test-Time Scaling 让小语言模型解决复杂软件工程》。 分享嘉宾 曾广韬,新加坡科技设计大学的四年级博士生,研究方向为 Large L
青稞Talk 大模型推理强化学习中的熵机制 往期解读:聊聊在大模型推理强化学习中熵机制上的探索 强化学习已经成为大模型智能跃升的下一个增长点,在这个背景下,本文旨在解决将强化学习用于大语言模型推理时面临的一个主要障碍——策略熵塌缩问题。 这种现象在大量未引入熵干预的强化学习训练中普遍出现,表现为策略熵在训练初期急剧下降,探索能力随之减弱,并始
青稞Talk Chain-of-Model (模型链):引入因果建模,全新的大模型 Scaling 结构 6月9日20:00,青稞Talk 第53期,论文成果一作、微软亚洲研究院高级研究员宋恺涛,将直播分享《Chain-of-Model (模型链):引入因果建模,全新的大模型 Scaling 结构》。 分享嘉宾 宋恺涛,微软亚洲研究院高级研究员,博士毕业于南京理工大学。其主要研究方向为自然语言处理,大语
青稞Talk MoLE & SpeCache:大语言模型端侧部署的架构与算法 LM在多个领域表现出强大能力,尽管在线服务广泛应用,但出于隐私和离线需求,个人常需要端侧部署。然而,现有的基于MoE和Transformer架构的LLM在端侧部署时面临显存容量不足的挑战。 5月22日20:00,青稞Talk 第50期,北京大学智能学院博士生、华为诺亚方舟实验室实习生节世博,将直播分
青稞Talk verl 源码解读 与 HybridFlow 编程范式讲解 5月19晚8点,verl core contributor 童雨轩,将直播分享《verl 源码解读 与 HybridFlow 编程范式讲解》。 本次 Talk 会从entrypoint(例如 main_ppo.py)入手,按程序执行顺序讲解 verl 的主要逻辑(类似 debugger 视角,但经过
青稞Talk 从 TTS 到 TTRL:无标签数据强化学习探索与展望 在预训练 Scaling Law之后,测试时扩展(Test-time Scaling, TTS)已成为提升大模型推理能力的关键。OpenAI o1与DeepSeek R1等模型通过强化学习(RL)进行推理的范式,充分展现了TTS的潜力。然而,推理模型的性能上限仍深受基础模型(其架构与预训练数据)的制
青稞Talk 从 TinyZero 到 APR:语言模型推理能力的探索与自适应并行化 TinyZero由加州大学伯克利分校的研究团队开发的,也是首个DeepSeek R1-Zero的干净、简洁、易于获取的全开源复现,目前已11.6k Star。同时,它只需 30 美元就能模拟花费600万美元的DeepSeek R1-Zero 的推理。 TinyZero 以veRL为基础进行构建,采用
青稞Talk B-STaR & SimpleRL-Zoo:通过强化学习自我提升推理性能和效率 基于强化学习框架的自我提升正日益成为增强模型推理能力的关键后训练方法,这一方法直接促成了DeepSeek-R1的成功。 青稞Talk 第45期,香港科技大学(HKUST)计算机系博士生曾伟豪,将直播分享《B-STaR & SimpleRL-Zoo:通过强化学习自我提升推理性能和效率》。 B-STaR