公告
🔥提供代码、复杂推理、多模态与智能体任务等领域的高质量原创任务数据,可添加:aiFreeCode 咨询

Tag

RL

共 130 篇文章 · 第 1 / 2 页
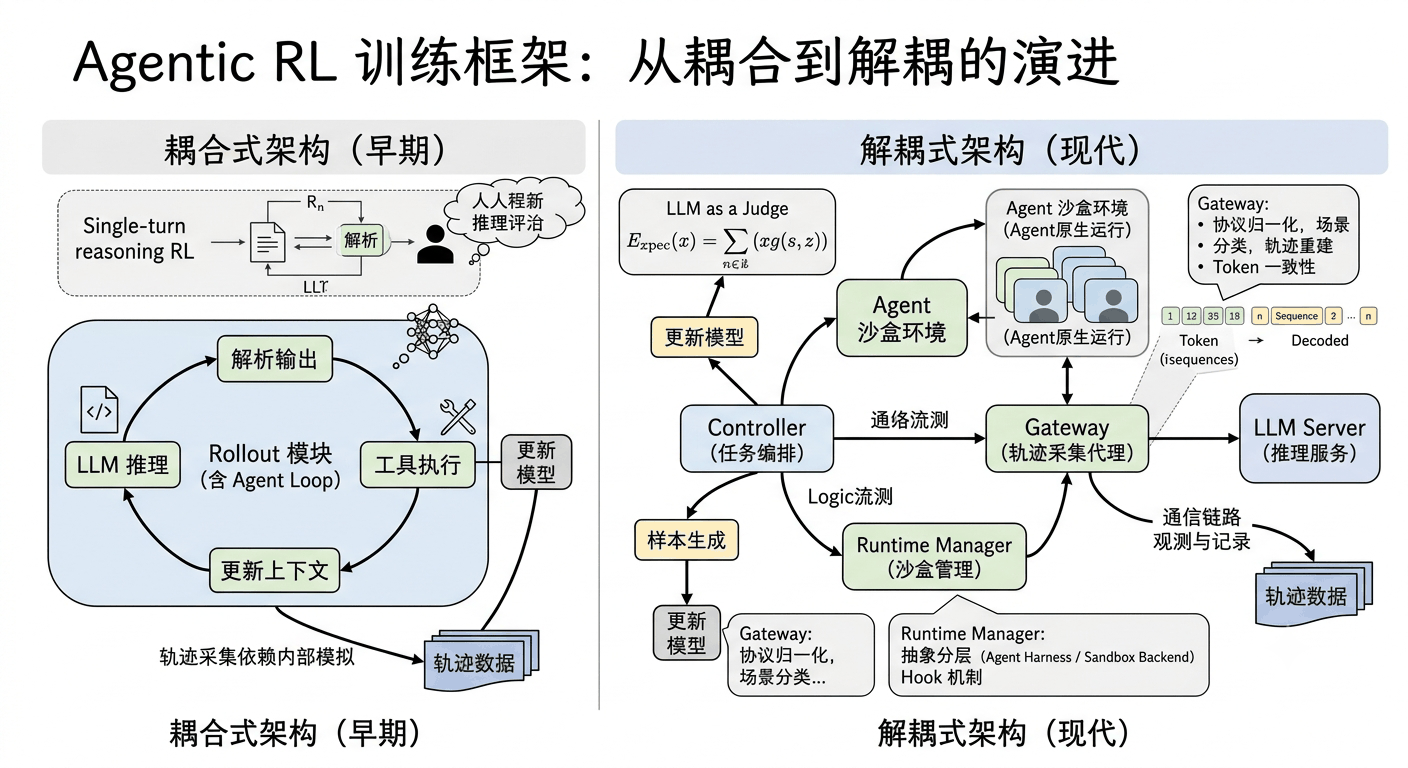
2026,进入 Agent RL 时代!

2026,进入 Agent RL 时代!

序章:三条哲学 在探讨技术之前,我们需要先确立三条基石性的认知: 人类的本质:人类在生物界的独特性在于高等智慧,而人与动物的分野,在于制造与使用工具的能力。 大模型的定位:ChatGPT 标志着人类首次赋予机器高等智慧。大模型之于现代人类,如同智慧之于原始人类,不仅不可或缺,更不可退化。 Agent
0
0
2861
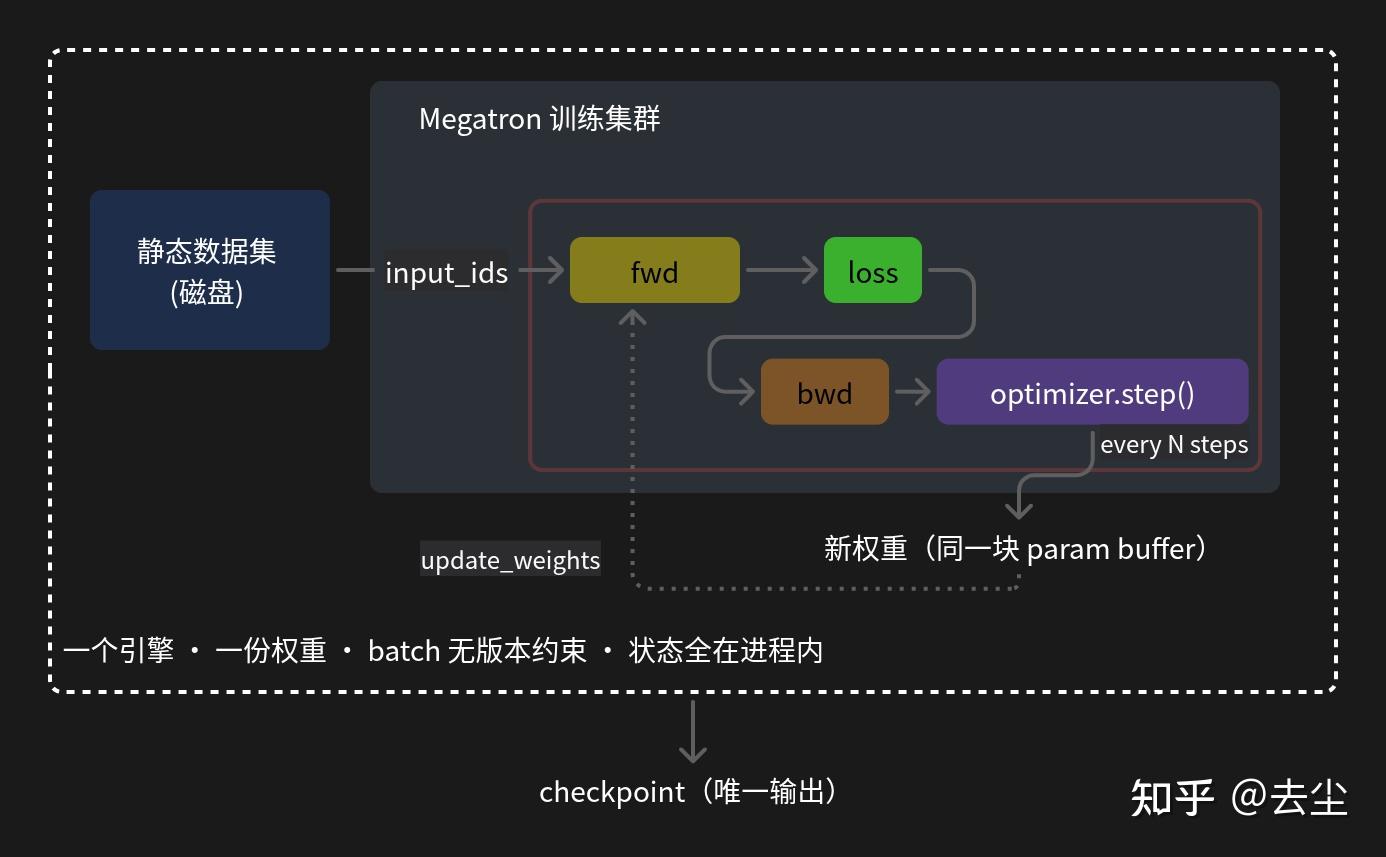
从 SFT 到 RL:Infra 复杂度的三次跃迁

从 SFT 到 RL:Infra 复杂度的三次跃迁

写在前面 写这篇文章是一次极其耗费心力的长途跋涉。发出了希望能和大家一起交流。 但受限作者个人的认知边界,书中内容难免存在疏漏、偏颇甚至错误之处。技术的探讨在于碰撞与纠错,若各位朋友在阅读时发现笔误、或者是作者思路狭窄未能理解核心奥义,非常欢迎指正交流。 作者:去尘 https://zhuanlan
0
0
126
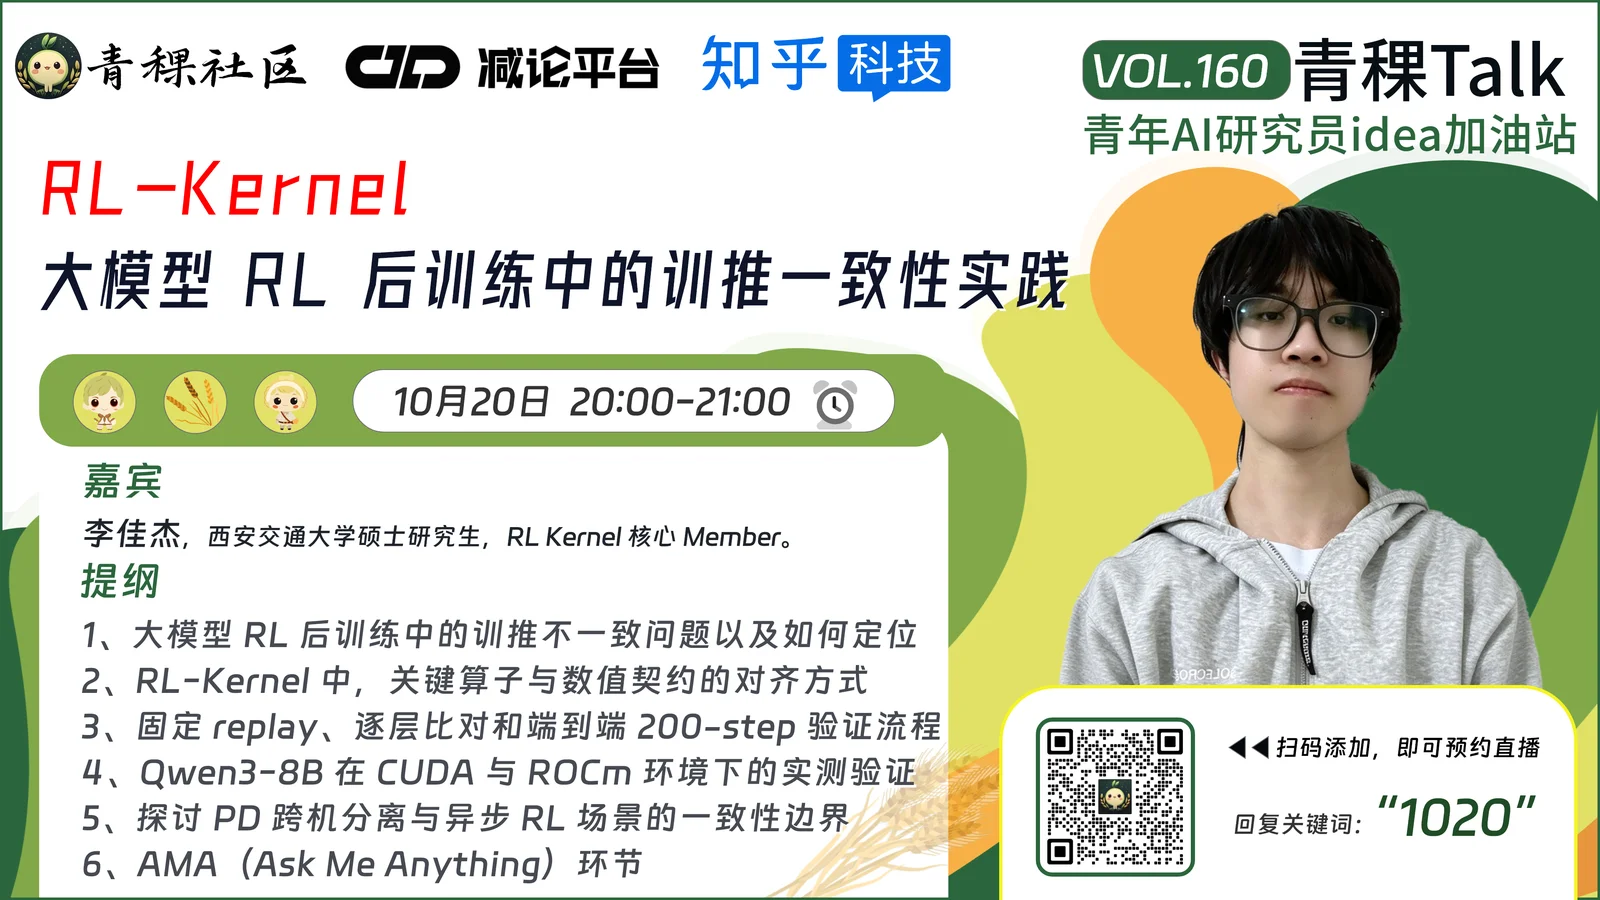
直播预告!聊聊 RL-Kernel ,大模型 RL 后训练中的训推一致性实践

直播预告!聊聊 RL-Kernel ,大模型 RL 后训练中的训推一致性实践

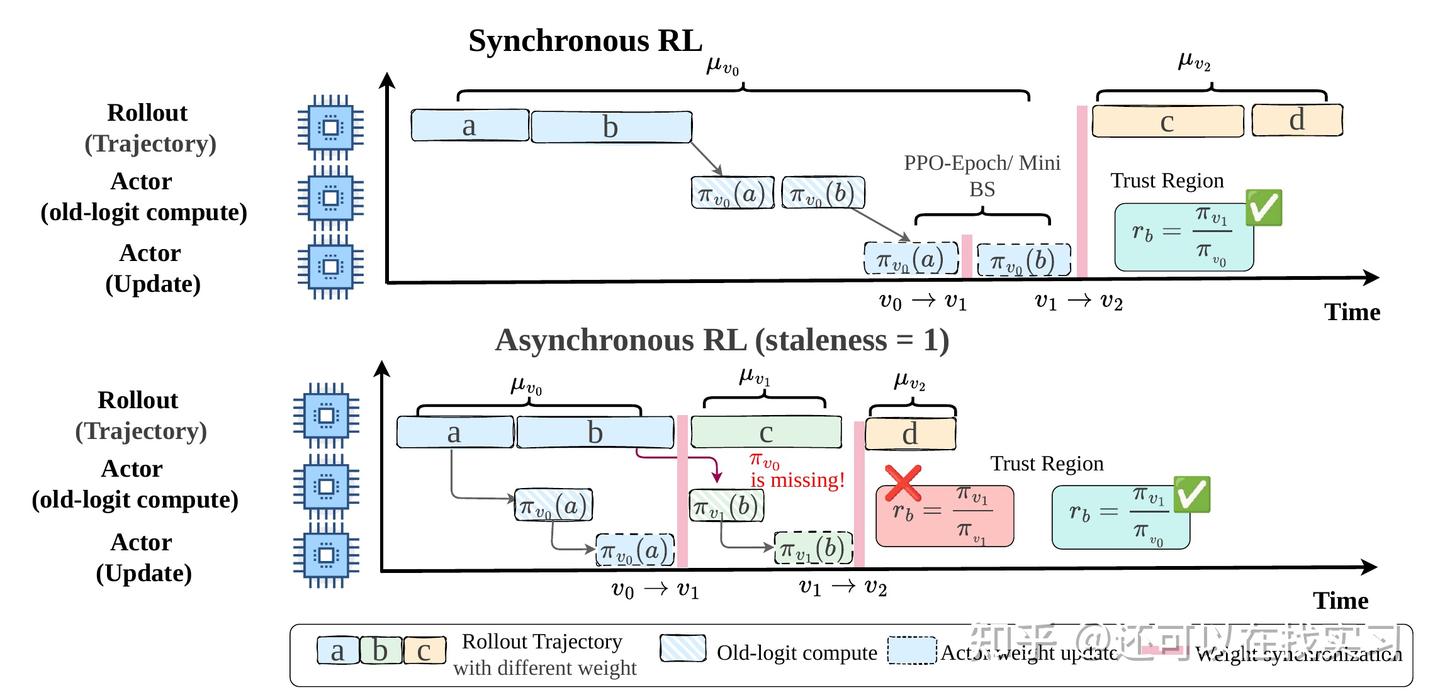
大模型的 RL 后训练里,有一个常被忽略、却可能让训练悄悄跑偏的隐患。 Rollout 与 Training 往往由两套不同的引擎执行。即使模型、权重、token 完全相同,两边的 LogP 也可能对不上——浮点归约顺序、并行分片、通信合并树、精度转换边界,任何一处不同,都会在数值上分叉。 一个直观
0
0
125
Agentic RL 新解法!复旦上交开源 A3 框架,用 14B CLI Agent 击败 235B 大模型

Agentic RL 新解法!复旦上交开源 A3 框架,用 14B CLI Agent 击败 235B 大模型

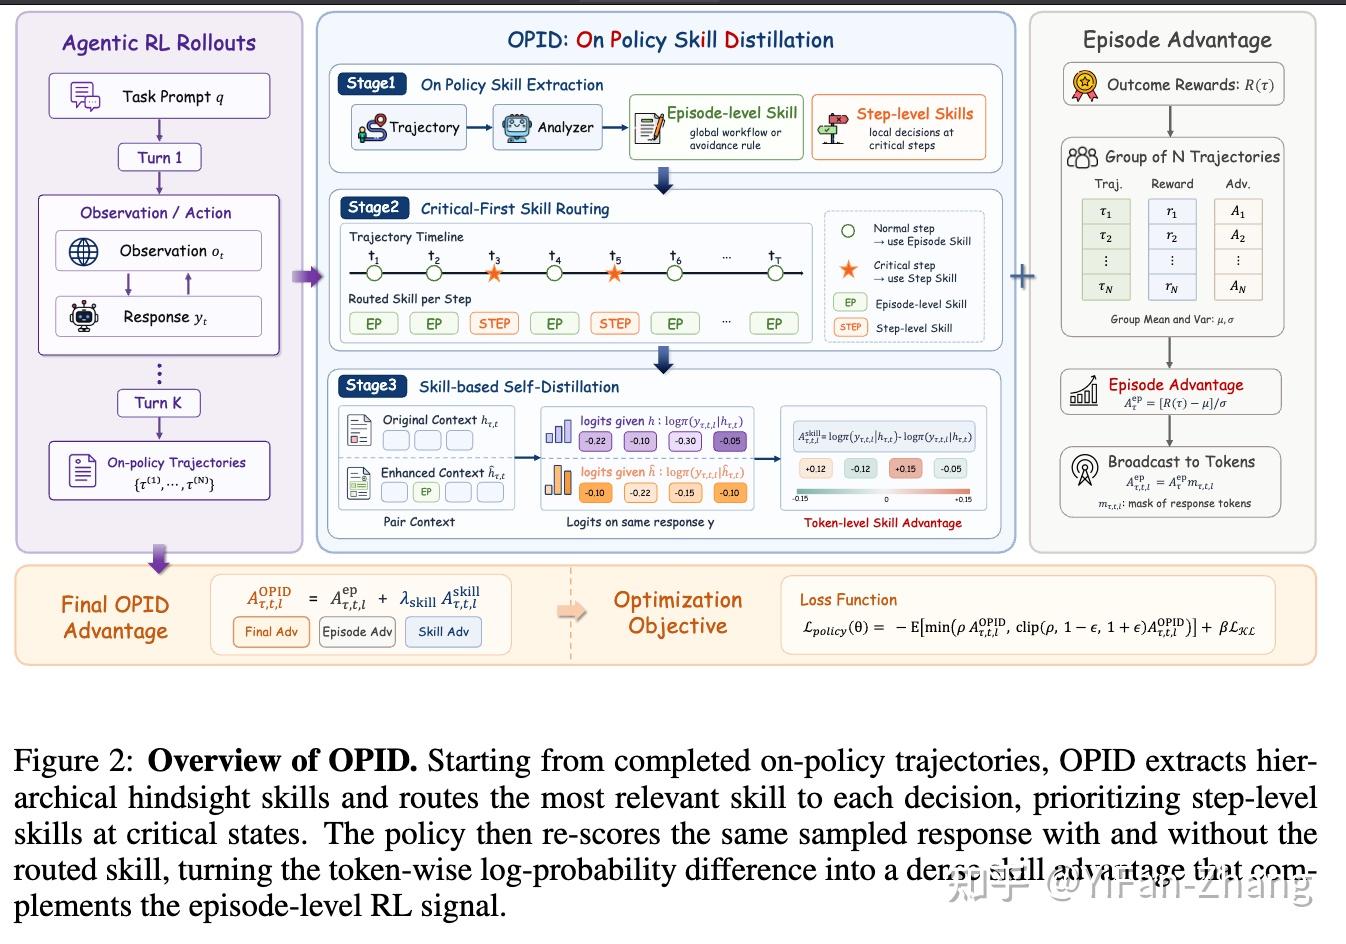
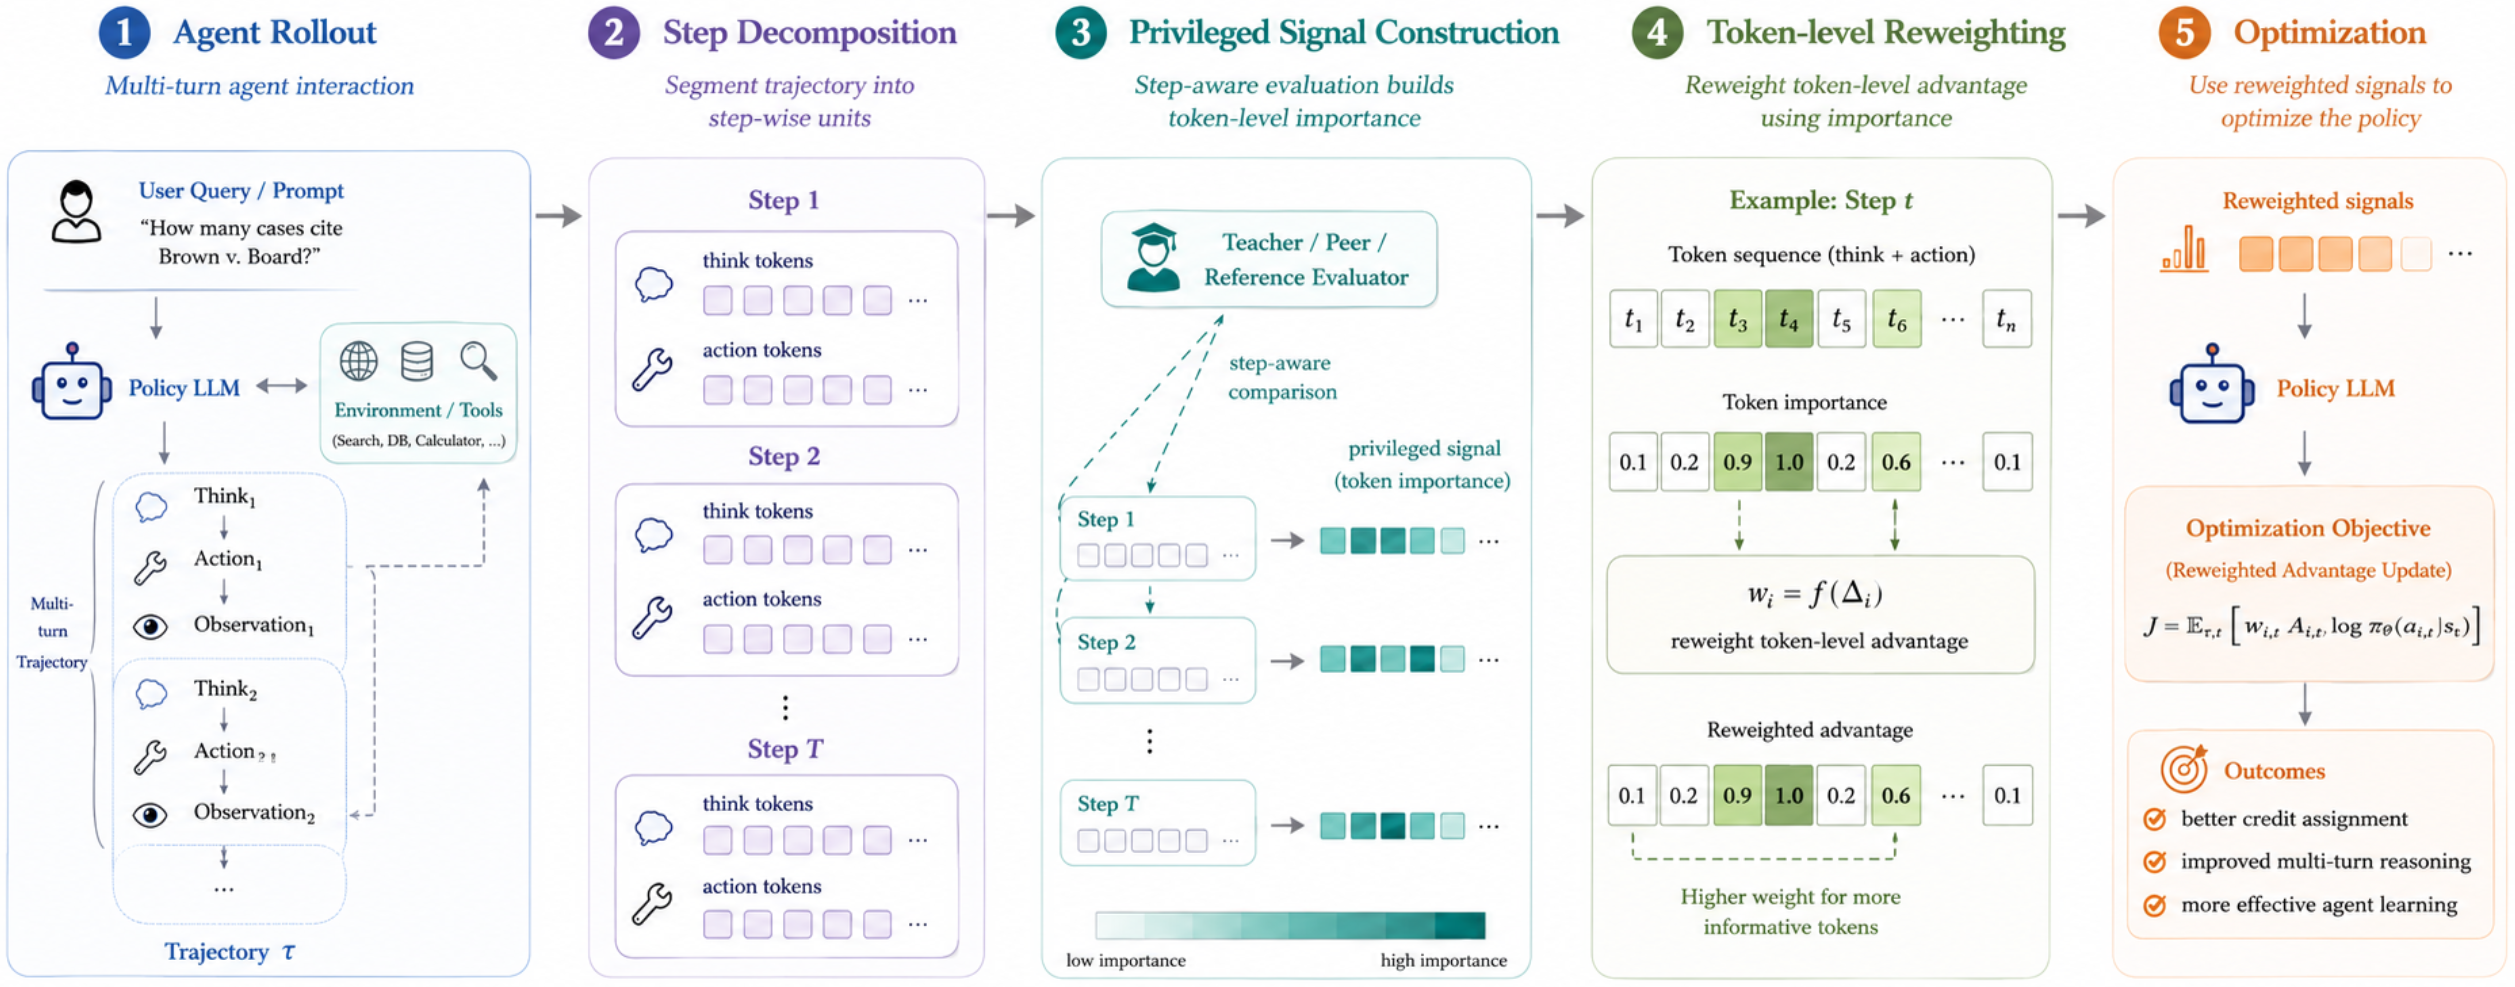
作者:苏浩阳,复旦大学Ph.D Claude Code、Codex 让我们看到了编程智能体的潜力,也让一个训练问题变得更加具体:当模型能够连续执行命令、修改文件并根据反馈修正策略时,强化学习如何充分利用这些交互经验?任务最终是否成功提供了监督,但一条轨迹中包含的动作结构与决策差异,远比一个最终分数丰
0
0
116
Agentic RL Infra 主流技术路线综述

Agentic RL Infra 主流技术路线综述

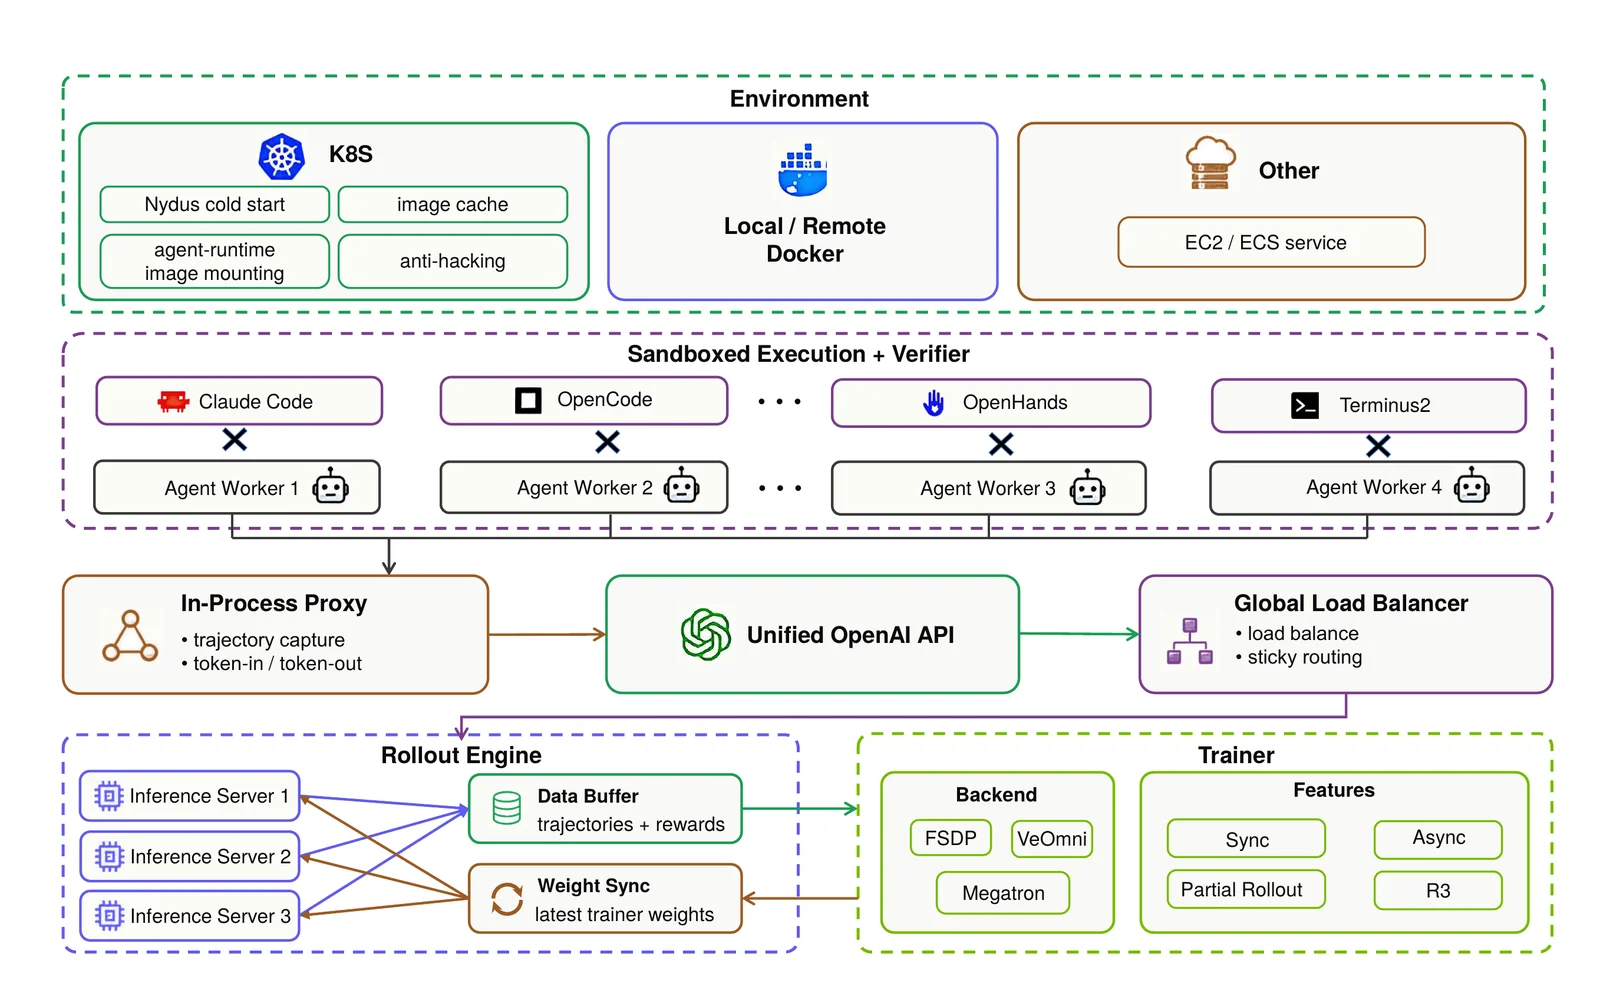
做Agentic rl infra也有一段时间了,这期间也一直在跟进国内几家头部大模型公布的RL infra技术细节, 感觉到这个时间点,技术路线已经逐渐趋近收敛, 不太像去年年底那时候agentic rl infra还是刚起步的蛮荒状态。 本文基于 11 份 2025–2026 年公开技术报告与官
0
0
892
MiniMax-H3 音视频生成 RL 后训练:基于 VeRL-Omni 的开源实践

MiniMax-H3 音视频生成 RL 后训练:基于 VeRL-Omni 的开源实践

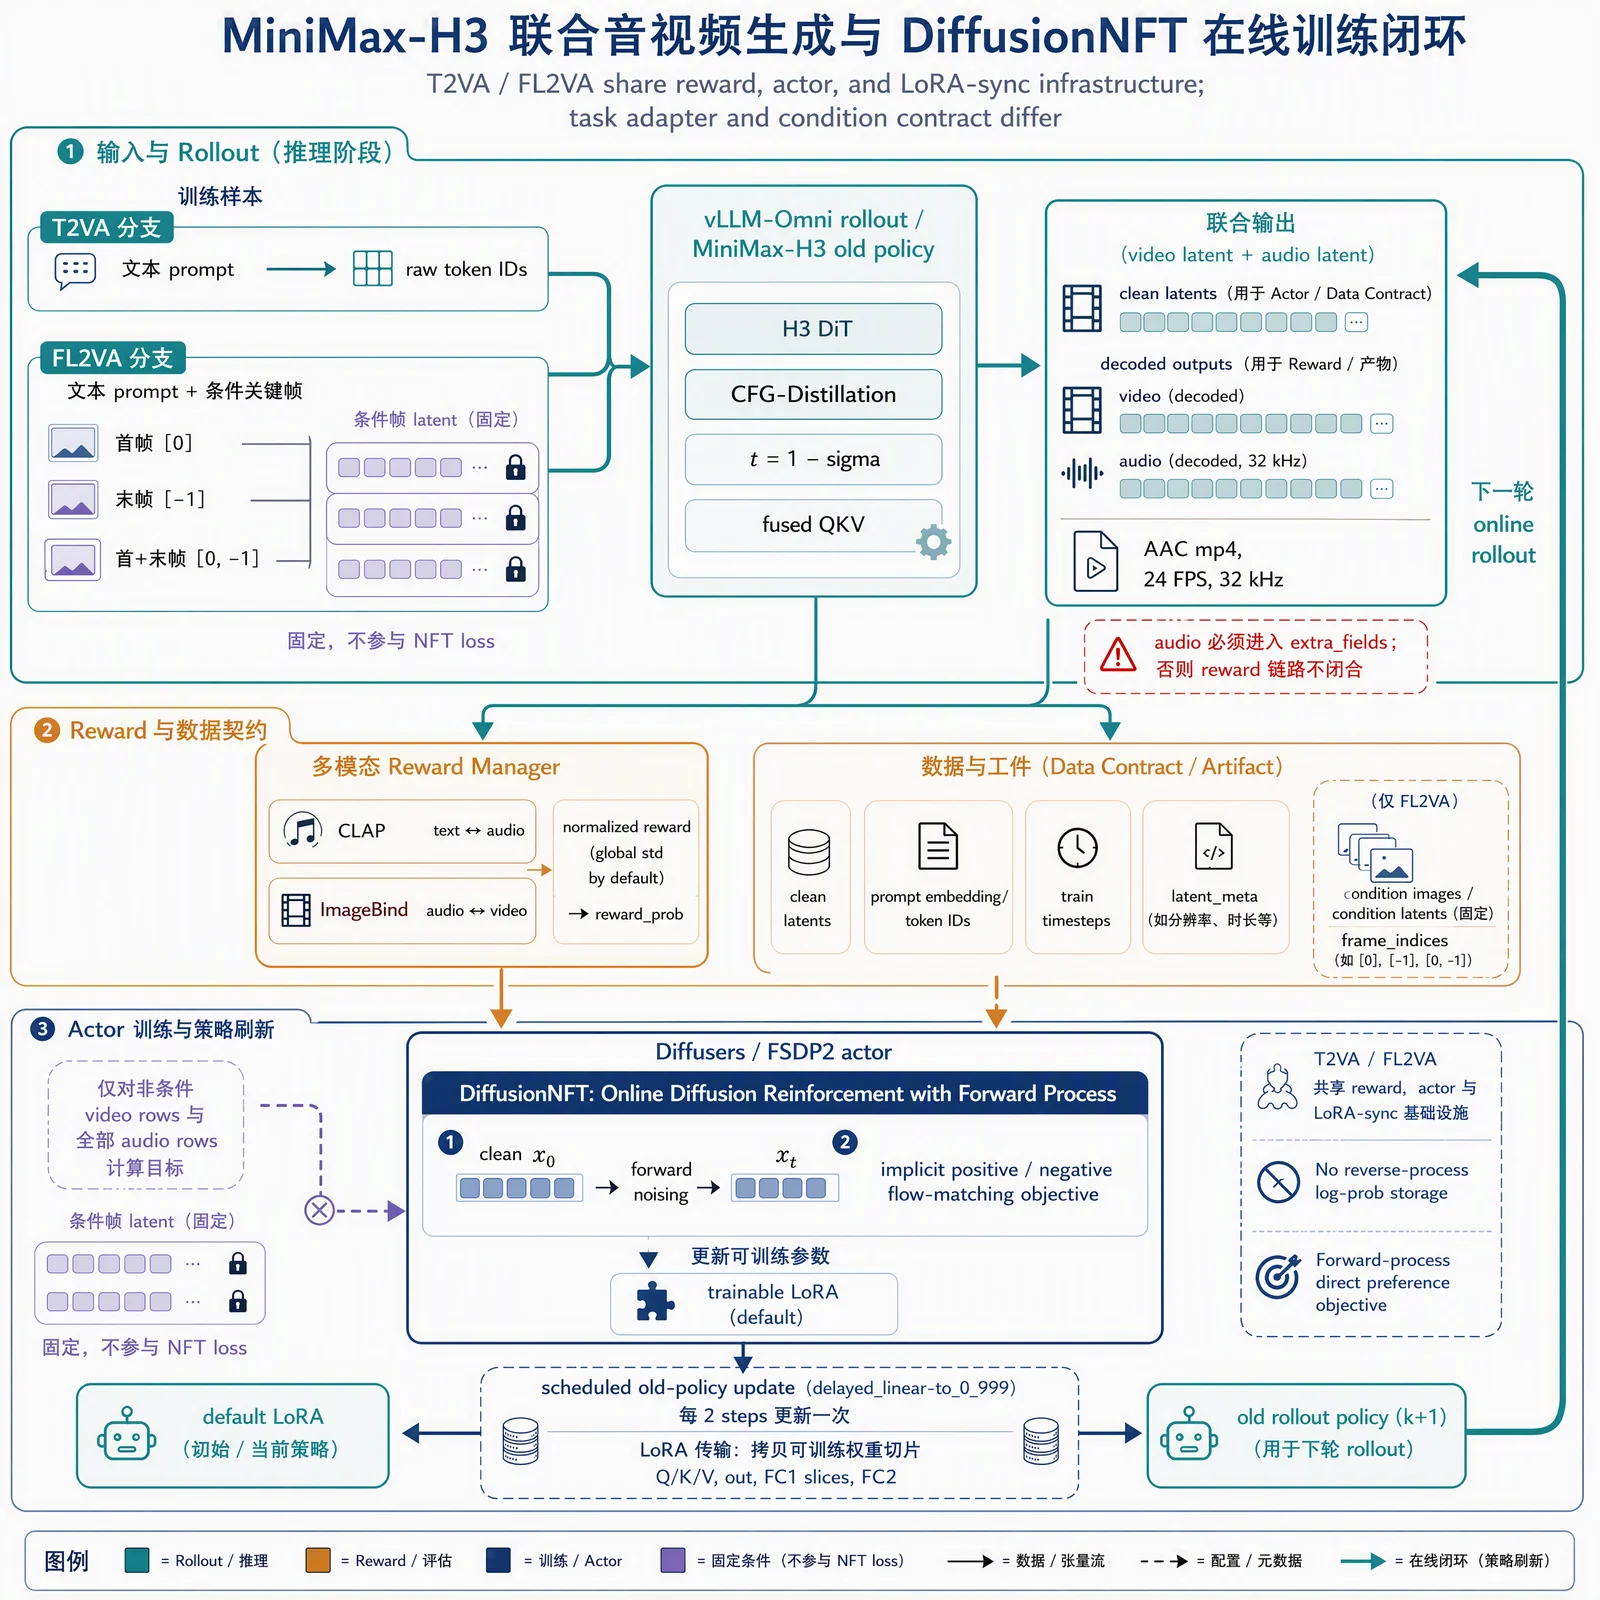
引言 MiniMax-H3 是当前开源社区中最受关注的音视频生成模型之一。它是一个通用的多模态生成模型,接收文本、图像、视频、音频等多种输入,直接输出带原生立体声音轨的视频,支持最长 15 秒、最高 2K 分辨率、24 FPS、32 kHz 立体声。 在 Artificial Analysis 的
0
1
700
终局奖励之后:从 Apodex 1.1 看长程 Agentic RL 如何分配 credit

终局奖励之后:从 Apodex 1.1 看长程 Agentic RL 如何分配 credit

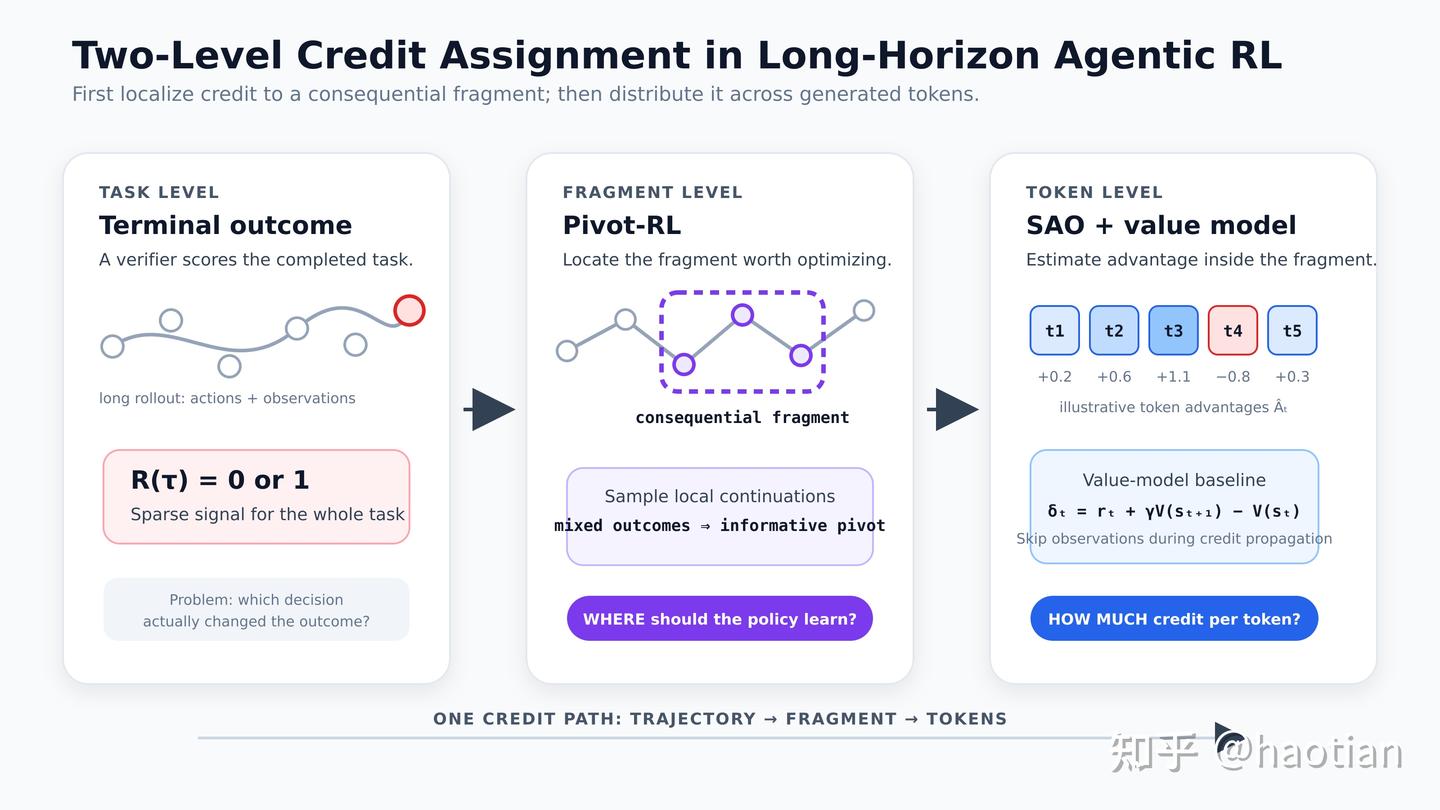
如果一个 Agent 用几十轮工具调用完成了一项任务,最后只得到一个 0/1 reward,这个 reward 应该怎样分配给前面的决策? 这是长程 Agentic RL 中一个很核心、但也很容易被“最终成功率”掩盖的问题。 一条轨迹最后失败,不等于前面的搜索、文件处理和代码执行全部错误;一条轨迹最
0
0
279
系统梳理 World Model in Agentic RL!

系统梳理 World Model in Agentic RL!

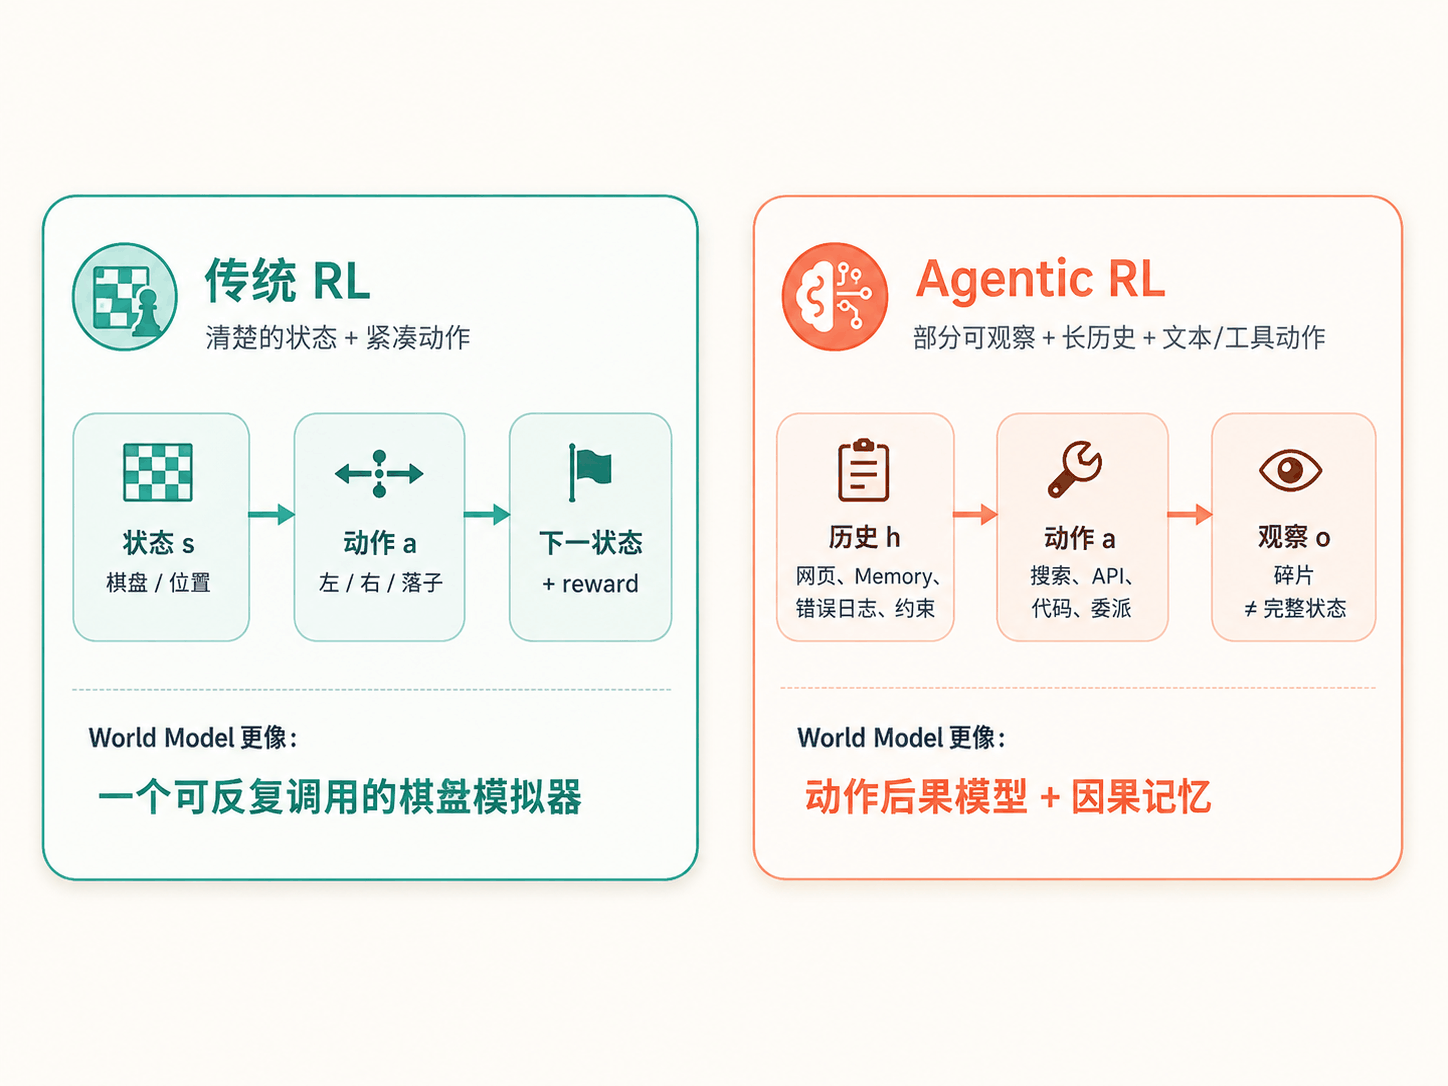
作者:Sherry https://www.xiaohongshu.com/user/profile/642d87c90000000011020daf World Model 这个概念其实已经提出很久了,我最近才第一次系统涉猎。虽然大家都在讨论 World Model,但真正试图解决的似乎并不是同一
0
0
237
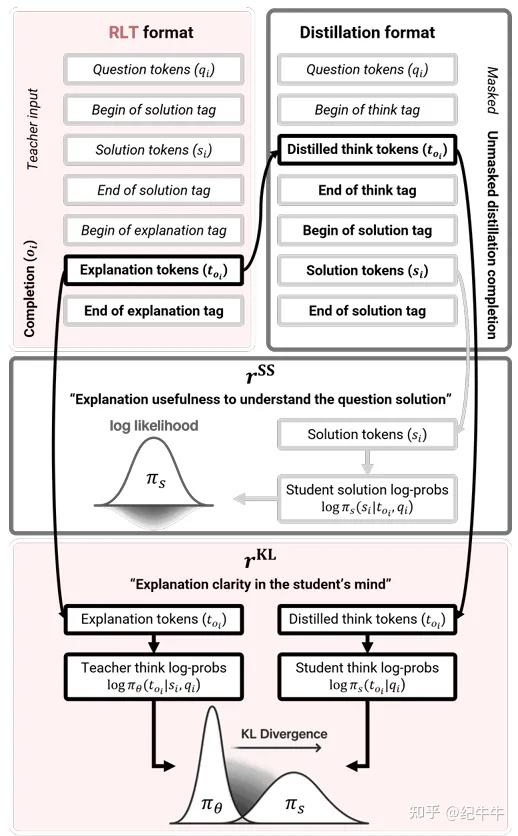
从 RL 到蒸馏,再到软蒸馏:Why RL Matters?

从 RL 到蒸馏,再到软蒸馏:Why RL Matters?

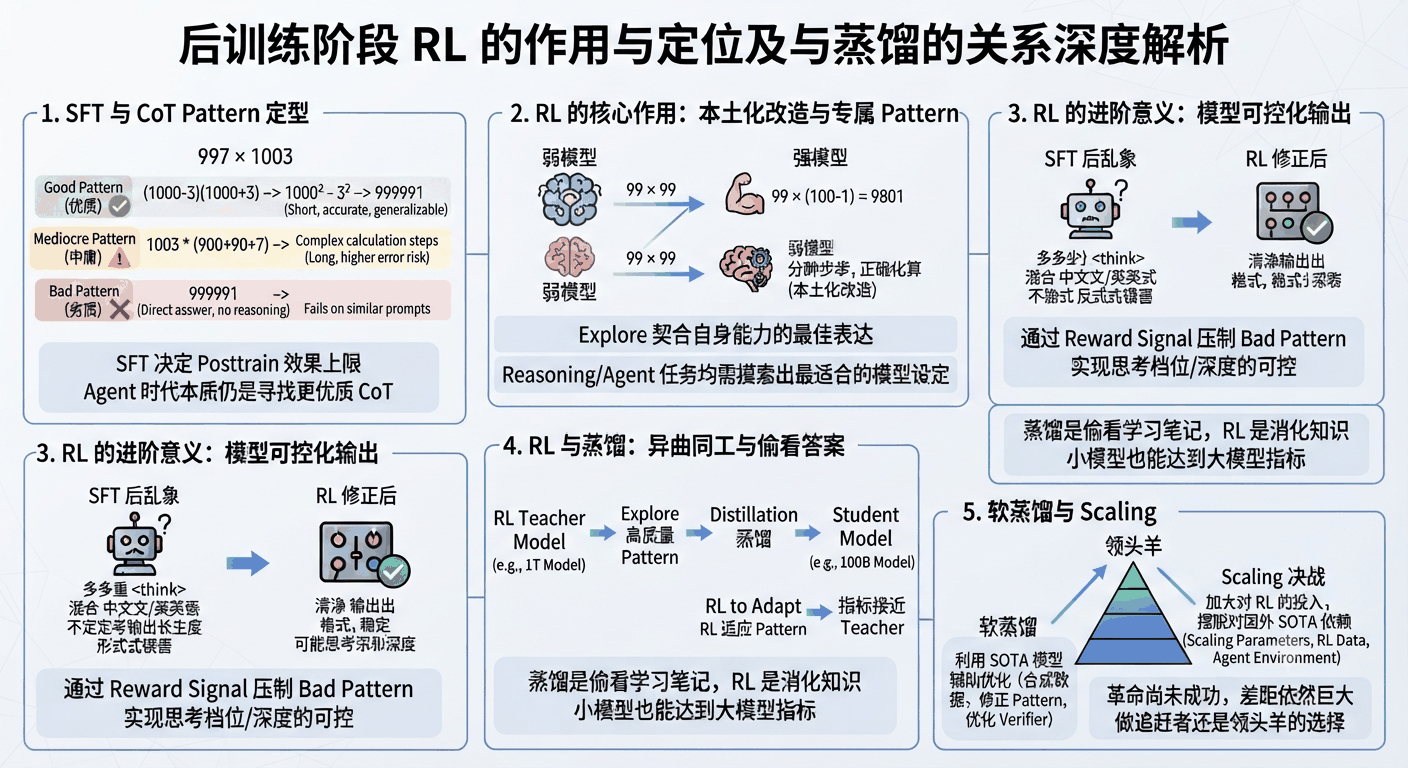
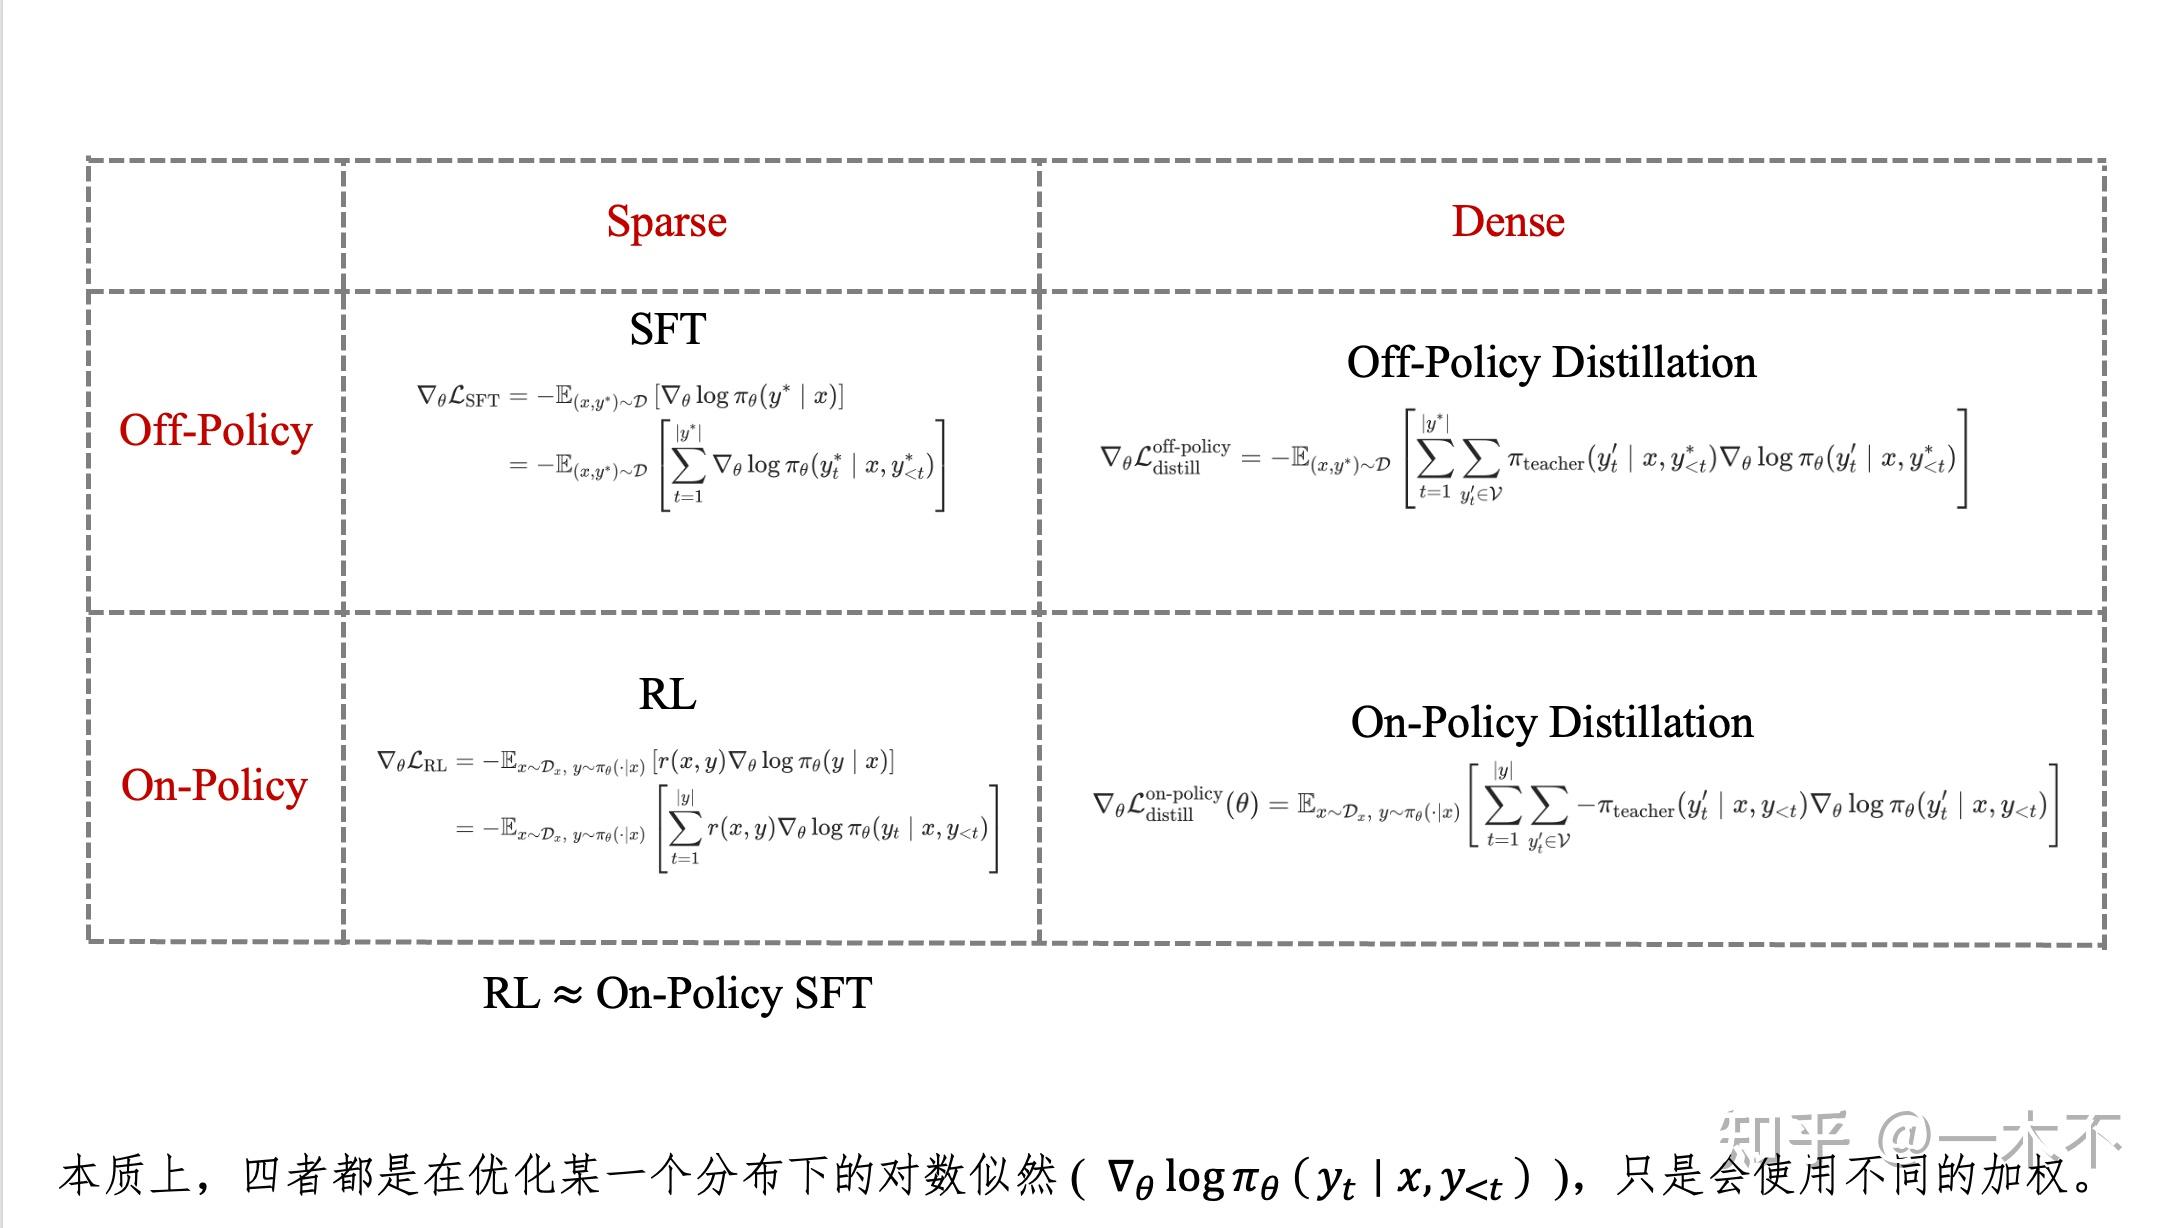
作者:ybq https://zhuanlan.zhihu.com/p/2067725096886785009 这篇文章简单讨论下 rl 的作用,我们到底该如何理解 rl 在 posttrain 阶段的定位?以及,为什么有时候模型仅仅靠蒸馏就能取得极好的效果呢? 文章系个人观点,未必正确,大家随便看
0
0
227
模型部署后还能越跑越强!淘天 × 华科大提出 SERPO,在开放式任务上实现无标注自进化

模型部署后还能越跑越强!淘天 × 华科大提出 SERPO,在开放式任务上实现无标注自进化

模型上线之后,还能不能在没有标注的情况下继续变强? TTRL(Test-Time Reinforcement Learning)给出的路径很直接:让模型在测试任务上自己采样、自己构造奖励、自己更新参数。但现有 TTRL 大多依赖答案投票:采样多条回答,抽取最终答案,再用多数票生成伪标签。数学题、选择
0
0
162
直播预告!机器人如何实现有效学习?聊聊正行创新 x 清华团队提出自监督帧级别优势建模算法STEAM

直播预告!机器人如何实现有效学习?聊聊正行创新 x 清华团队提出自监督帧级别优势建模算法STEAM

随着具身智越来越多地进入生产环境,策略进化的核心变成对混杂数据的高效利用。 这正是离线强化学习发挥的重要场景,但效果严重依赖于帧级的好坏标注——逐帧分辨哪些时刻在推进任务,哪些在停滞或倒退。但靠人类逐帧标注机器人数据非常耗费人力、难以规模化。 为了解决这个问题,清华于超老师团队与正行创新(Strid
0
0
214
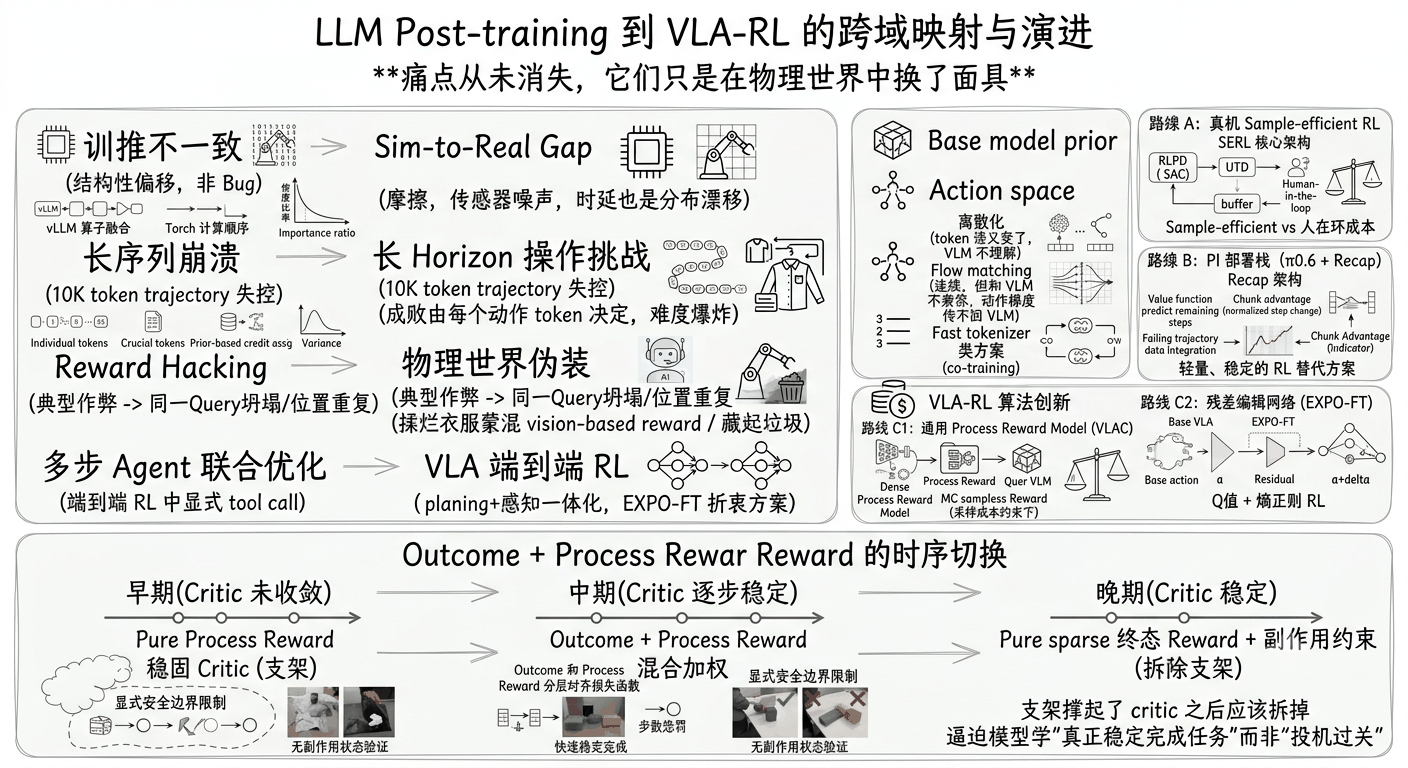
从 GLM/Qwen 看: Agentic RL 最新进展

从 GLM/Qwen 看: Agentic RL 最新进展

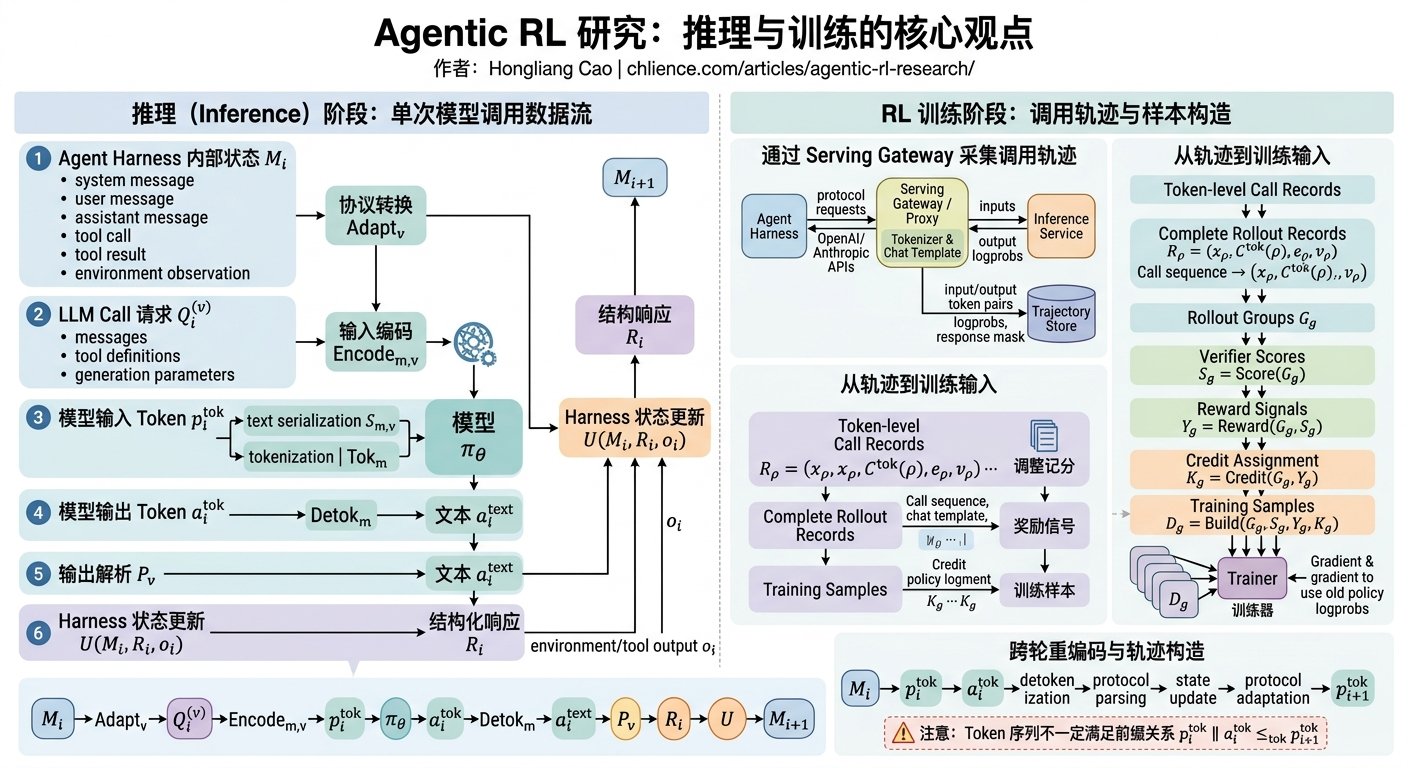
作者:YiFan-Zhang https://zhuanlan.zhihu.com/p/2054605815588435332 GLM 5.2: From Grpo to PPO 引入了 slime 这套训练与推理基础设施,同时在长链路任务里改用了更适合 compaction 的 PPO 训练方式,
0
0
741
深入理解 Agentic RL 中的行为崩塌现象

深入理解 Agentic RL 中的行为崩塌现象

作者:Jason 原文:https://zhuanlan.zhihu.com/p/2050794185909876253 过去一段时间里,我一直在思考一个问题:Agentic RL 到底和传统 RLVR 有什么本质区别? 最容易想到的答案当然是工具调用。传统 RLVR 往往围绕单轮回答展开,模型生成
0
0
335
Model-Based RL 与世界模型!拆解 Latent 世界模型范式

Model-Based RL 与世界模型!拆解 Latent 世界模型范式

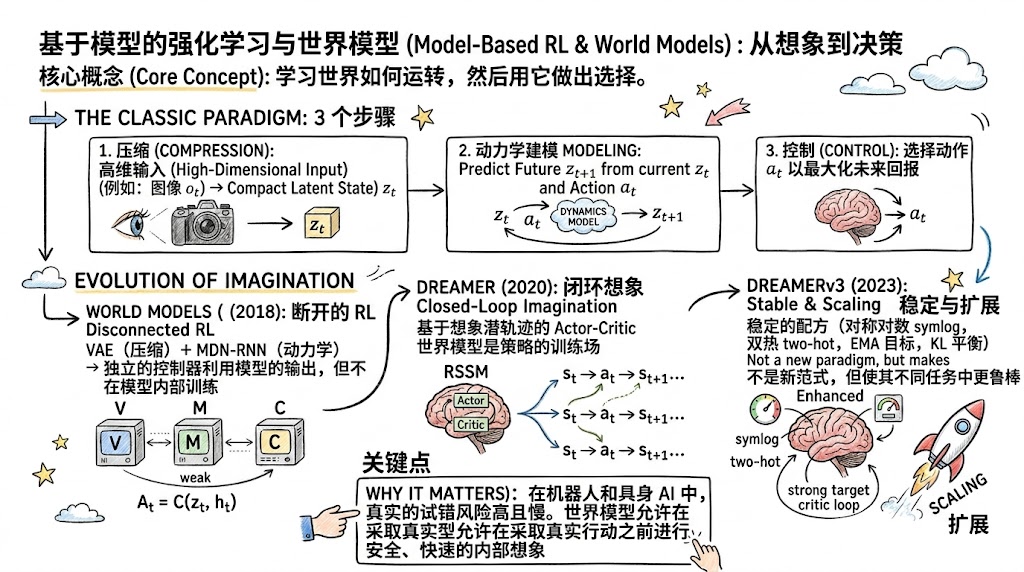
一、为什么具身智能重新关注世界模型? "世界模型"在具身智能领域似乎又变成了一个高频词,它为什么又回到了热门呢,和传统强化学习又有哪些区别? 首先,从 Model-Based RL 的视角看,世界模型并不是一个全新的概念,它可以理解为 Model-Based RL 中的 learned dynami
0
0
387
自动化所最新推出 π-Play: 基于自博弈生成特权信息的自蒸馏大模型自进化框架

自动化所最新推出 π-Play: 基于自博弈生成特权信息的自蒸馏大模型自进化框架

作者:张曜程,朱圆恒,赵冬斌@中科院自动化所 研究背景 智能体在训练过程中往往面临几个核心瓶颈,标注数据昂贵、奖励信号稀疏,以及长程任务中的信用分配困难。自博弈(Self-Play)提供了一条很有吸引力的路径:模型可以自己生成问题、自己学习解决问题,从而减少对外部训练数据的依赖。然而,现有自博弈方法
0
0
337
MinT: 面向百万级 LoRA 策略的训练与推理基础设施

MinT: 面向百万级 LoRA 策略的训练与推理基础设施

大模型后训练会带来一个很现实的系统问题:模型会不断产生新版本。一次强化学习实验、一个产品功能、一个客户、一组评测结果,都可能对应一种新的模型行为。基础模型本身又非常大,动辄万亿参数规模。系统如果把每种行为都保存成一份完整模型,再分别加载和部署,成本会很快失控。 MinT 是一套面向这个问题的大模型后
0
0
302
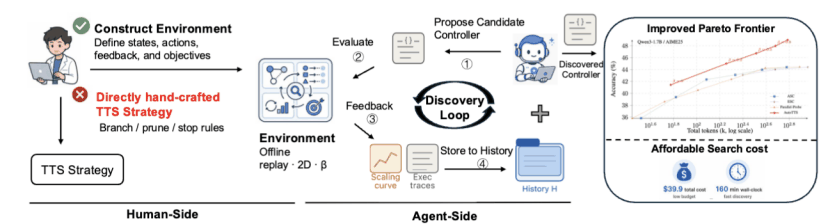
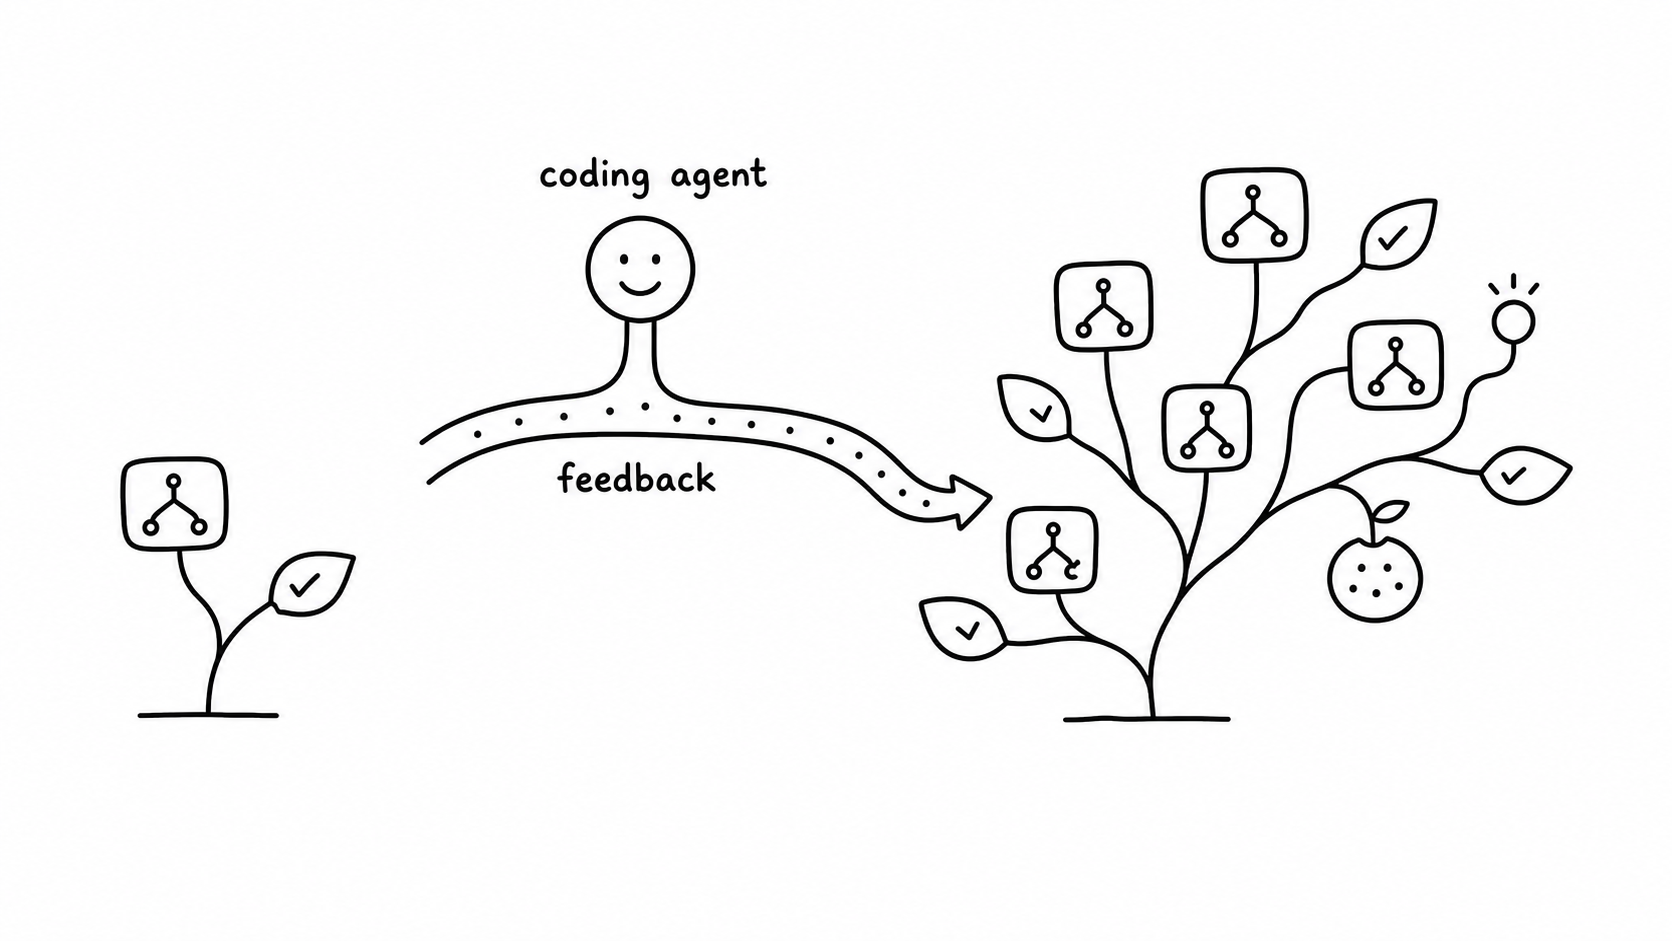
和翁家翌(OpenAI)一样的idea!如何让 AI 全自动刷榜——可能的下一个强化学习范式

和翁家翌(OpenAI)一样的idea!如何让 AI 全自动刷榜——可能的下一个强化学习范式

作者:黄呈松,圣路易斯华盛顿大学博士生 在Deep Learning之前,我们在做传统机器学习,通过研究规律,写基于规则的代码来完成我们想要完成的任务。 在LLM之前,我们用深度学习来提取特征,设计网络来完成我们想要完成的任务 在LLM之后,我们似乎试图用LLM来解决所有的任务 但...我们真的达到
0
0
294
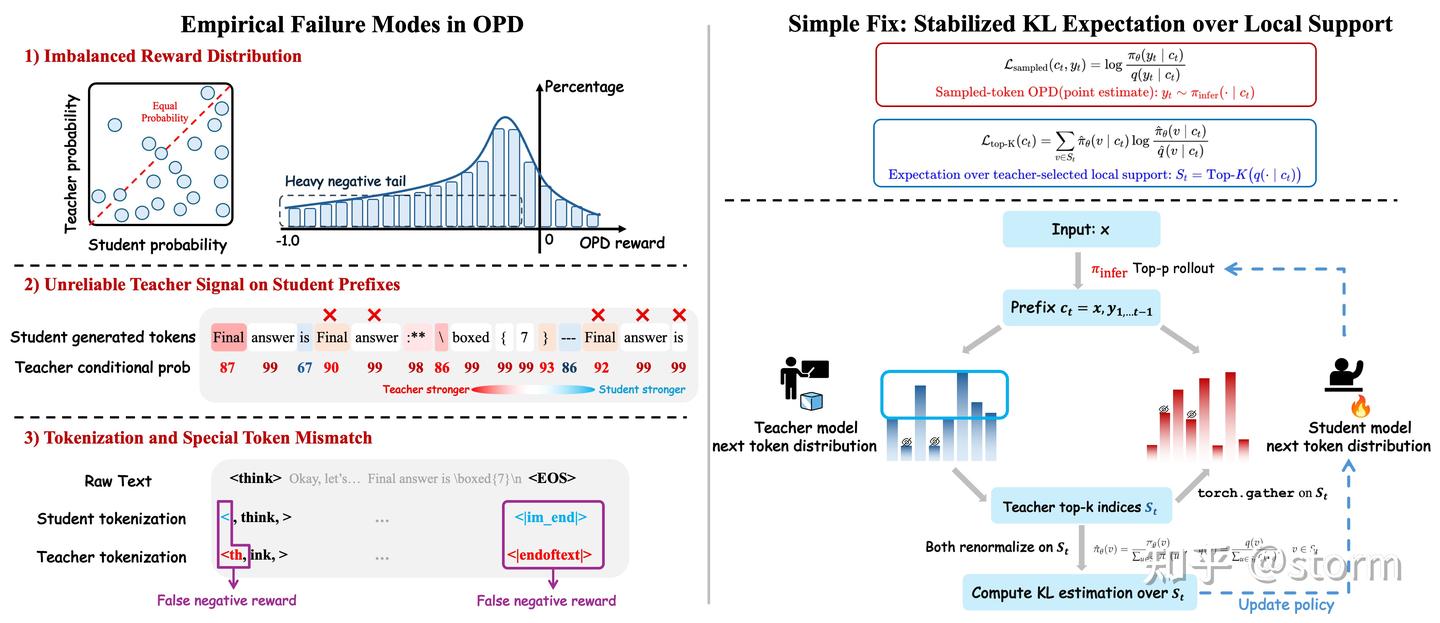
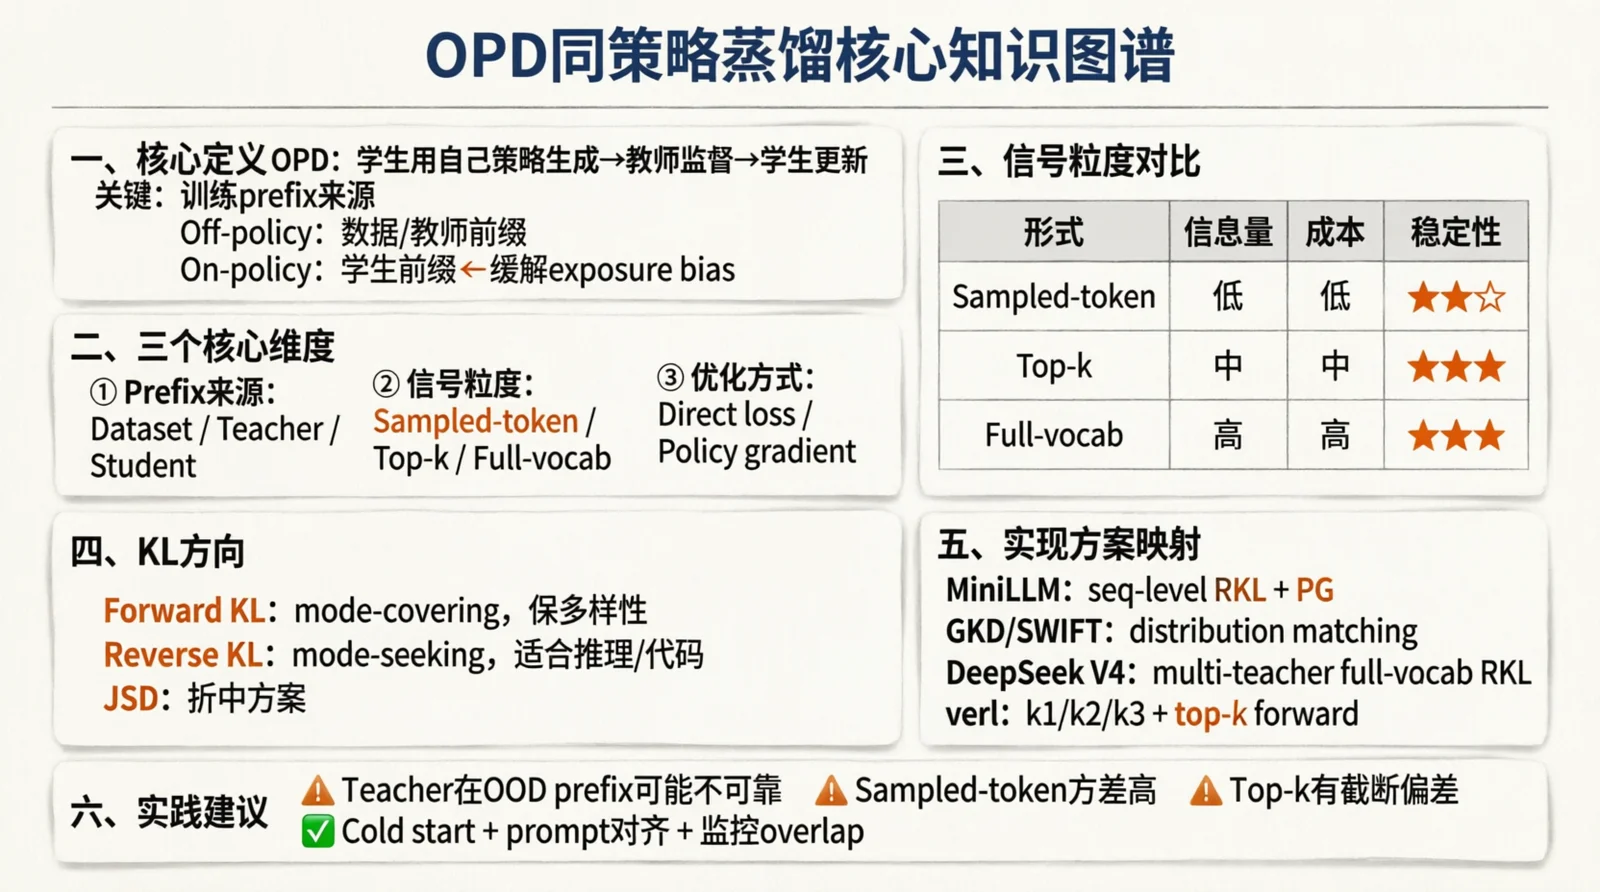
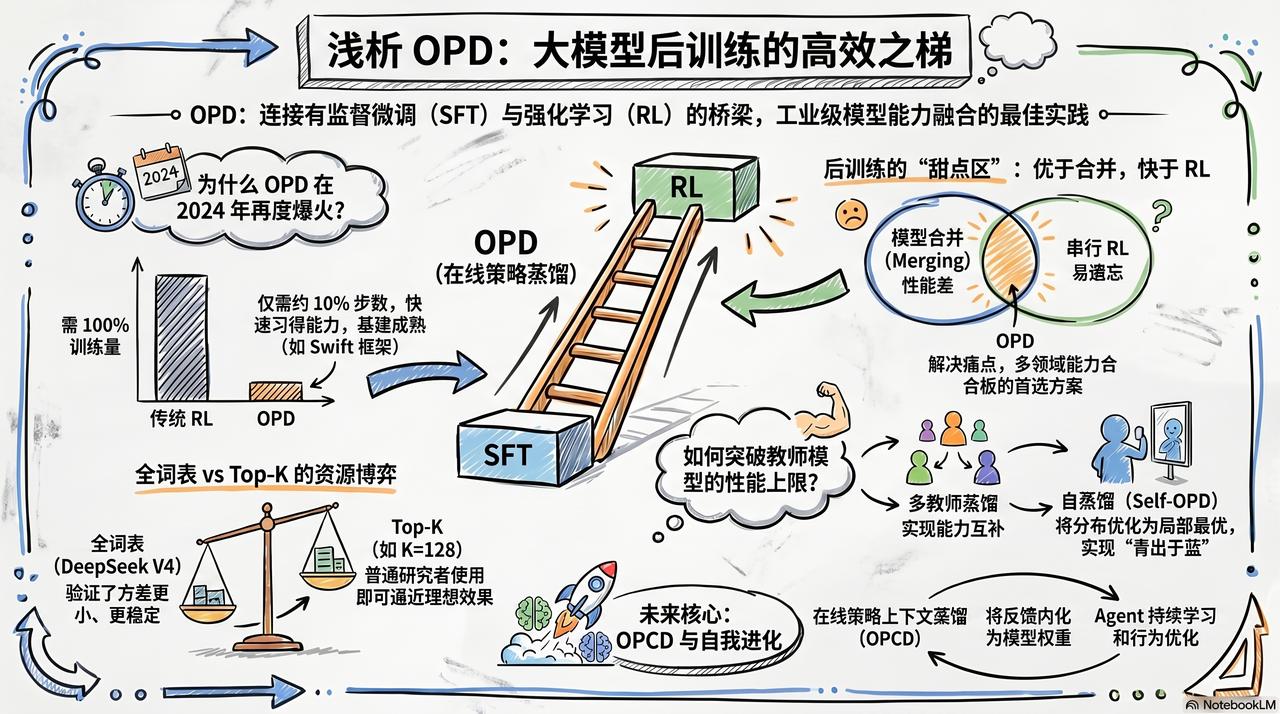
重探 On-Policy Distillation(OPD):三类典型失败以及修复路径

重探 On-Policy Distillation(OPD):三类典型失败以及修复路径

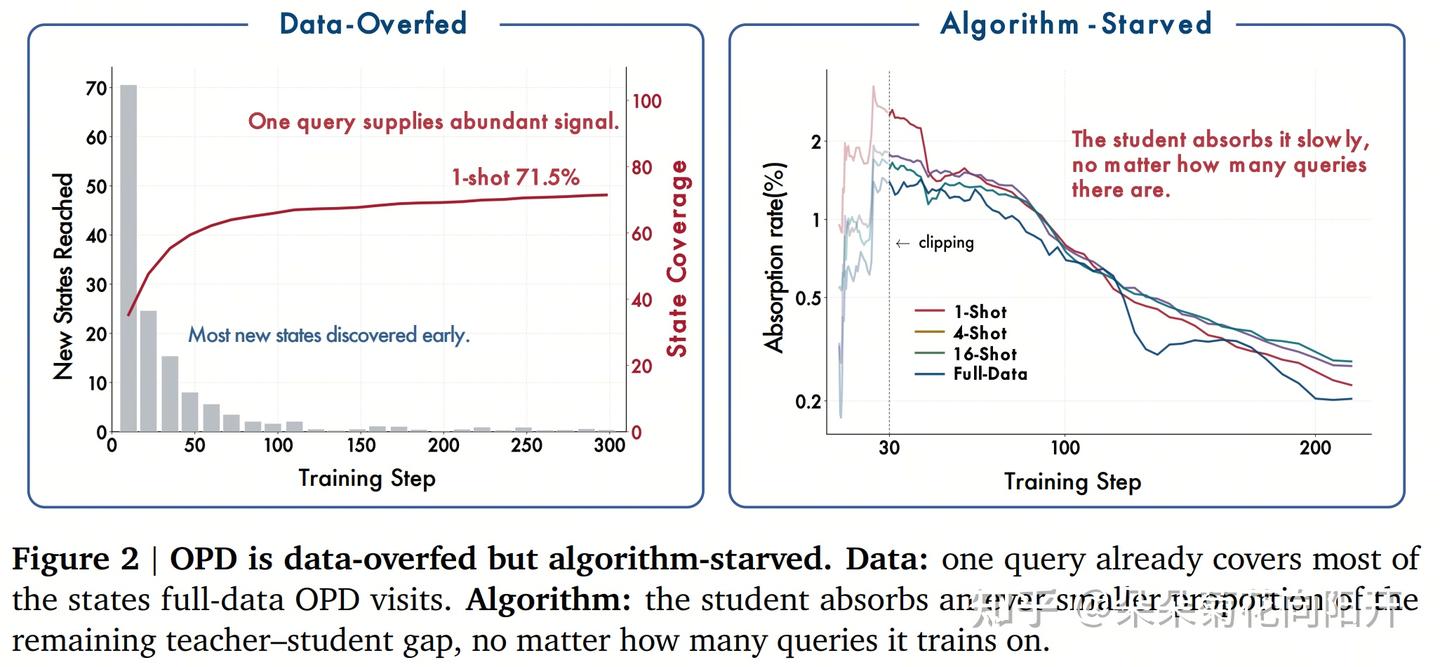
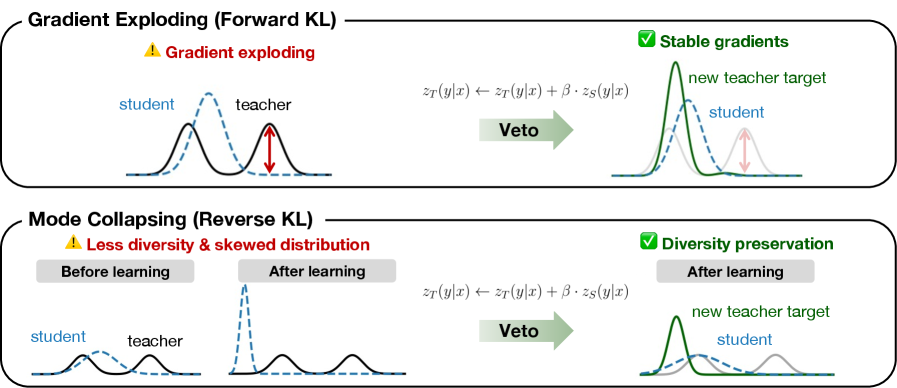
在最近的大模型后训练中,On-Policy Distillation已经成为默认选项之一。 但研究者们在分析训练日志、实验曲线和对比不同 OPD 方法实现时,反复碰到同一个问题:理论上很自然的 sampled-token OPD,实际运行起来并不稳定,甚至会把模型往一些局部上“看起来合理”、整体上却
0
0
834
大模型强化学习的Scaling Law

大模型强化学习的Scaling Law

随着 OpenAI o1 和 DeepSeek-R1 的惊艳亮相,强化学习(RL)后训练(Post-training) 已成为大模型通往高阶推理能力的必经之路。 但在这一新兴领域,开发者们正面临着缺乏系统的理论指引的困境。不同于预训练阶段成熟的 Scaling Law,RL 后训练阶段的许多关键工程
0
0
398
从 TTRL 到 URLVR:大模型的无监督强化学习还能走多远?

从 TTRL 到 URLVR:大模型的无监督强化学习还能走多远?

ICLR 2026 | 大模型的无监督强化学习能走多远? 强化学习正在重塑大模型能力边界。OpenAI o3、DeepSeek-R1、Gemini 3 等顶尖模型都在用大规模 RLVR(可验证奖励强化学习)刷新推理任务的天花板。 但所有人都知道,纯监督式训练不可持续。人工标注成本指数级增长,在专业领
0
0
298
FIPO & Future-KL:突破大语言模型在复杂推理中的性能瓶颈

FIPO & Future-KL:突破大语言模型在复杂推理中的性能瓶颈

最近 Qwen Pilot 团队一直在研究 RL 如何解锁复杂推理能力。翻遍数据后,抓到了 3 个反直觉的发现: 1️⃣ RL 其实很“懒” 策略演化极稀疏 在 >98% 的生成步骤里模型没变,RL 并没有重写基座,它更像是个教练,只在关键逻辑分叉口轻轻推一把。 论文:Sparse but Crit
0
0
314
ICLR'26 Oral | 当 LLM Agent 在多轮推理中迷失时:T3 如何让强化学习重新学会主动推理

ICLR'26 Oral | 当 LLM Agent 在多轮推理中迷失时:T3 如何让强化学习重新学会主动推理

随着大语言模型逐步从「单轮问答」走向「真实环境中的持续交互」,各种各样如OpenClaw的agentic applications正在成为当前研究与产业共同关注的核心方向。无论是在网页环境中进行信息检索与操作,还是完成代码生成与调试、个性化推荐等复杂决策任务. 这些场景都要求LLM agent具备主
0
0
387
从传统 RL 的视角看大模型 RLVR

从传统 RL 的视角看大模型 RLVR

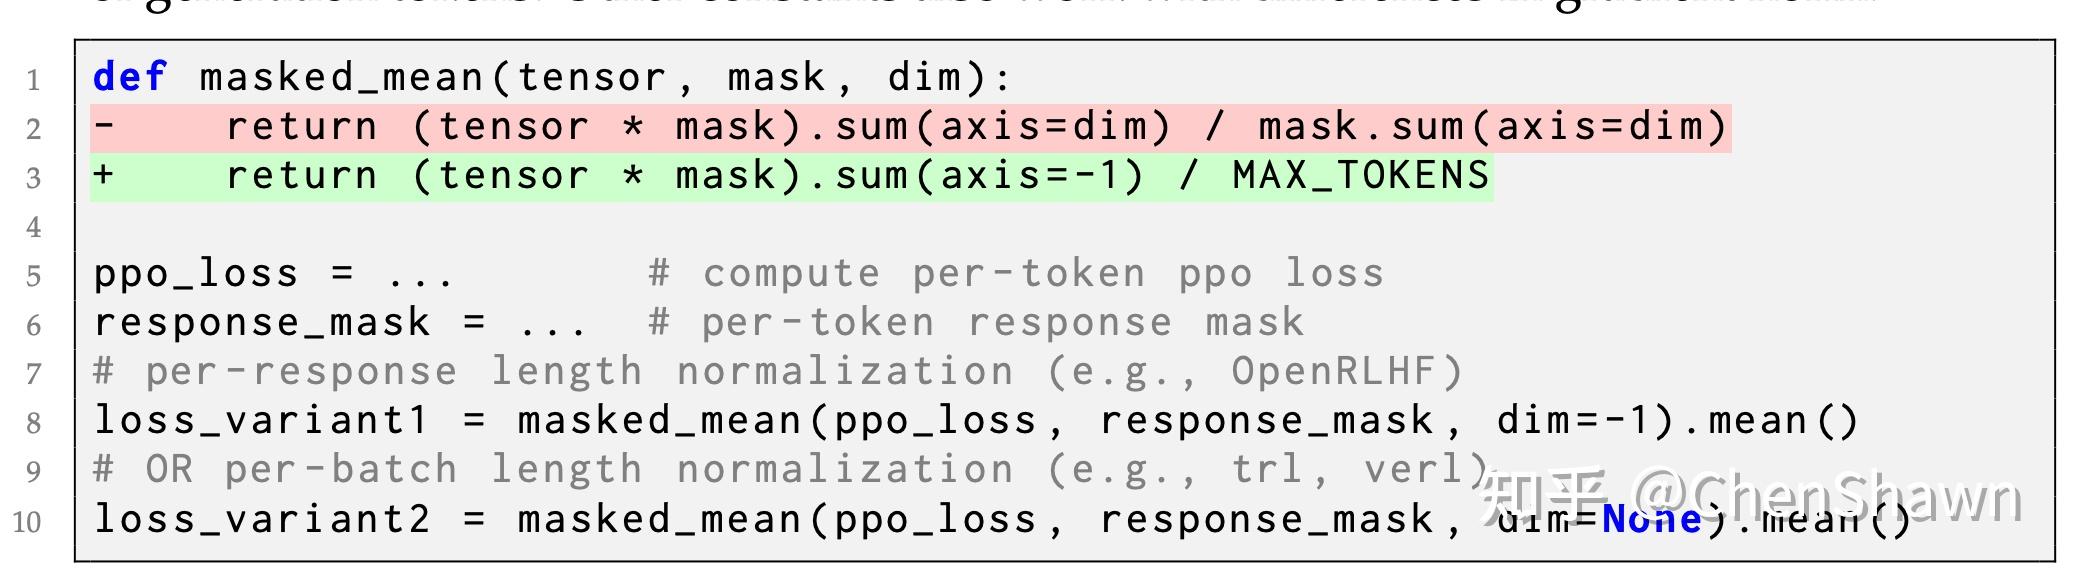
作者:ChenShawn https://zhuanlan.zhihu.com/p/2005256302918665528 我们最近 release 的工作 VESPO,是一个在 off-policy setting 下解决 LLM RLVR 训练稳定性问题,以及 bias-variance tra
0
0
250
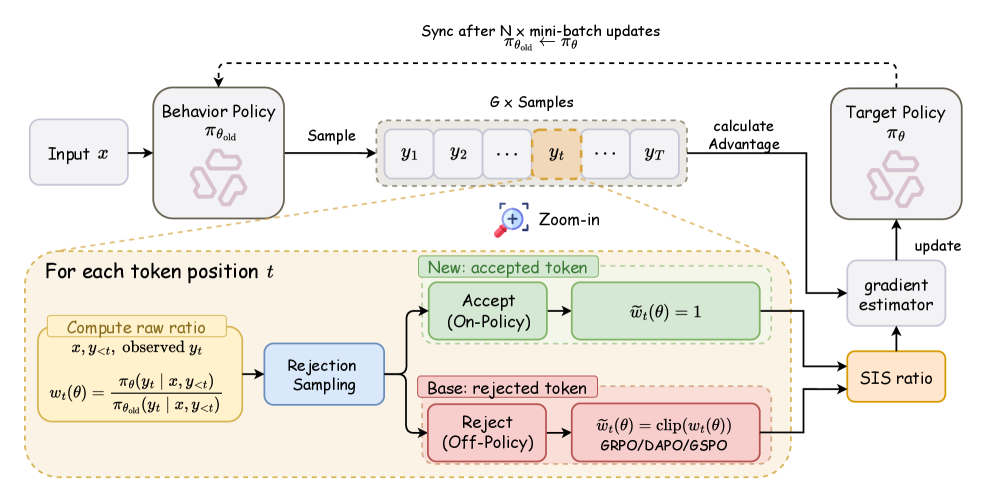
 大模型RL算法梳理:从全量词元到部分词元的路径演化

大模型RL算法梳理:从全量词元到部分词元的路径演化

一、 引言:大模型强化学习算法的演化格局 近年来,以 OpenAI 的 o1 系列、DeepSeek 的 R1,以及 Qwen 系列模型为代表,大语言模型在数学证明、代码生成等长链路推理任务中展现出更强的稳定性与推理深度。 在这一背景下,面向大语言模型的强化学习(RL for LLMs, RL4LL
0
0
429
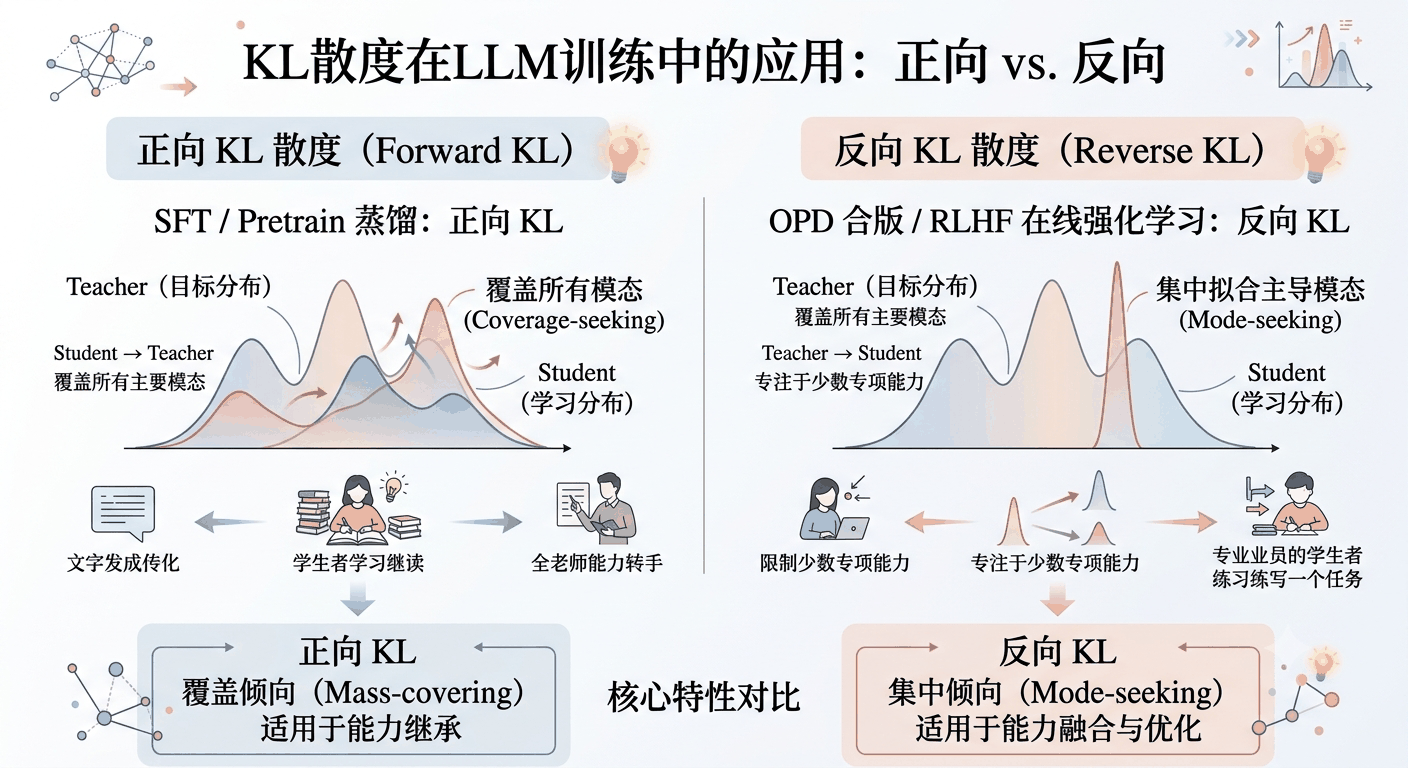
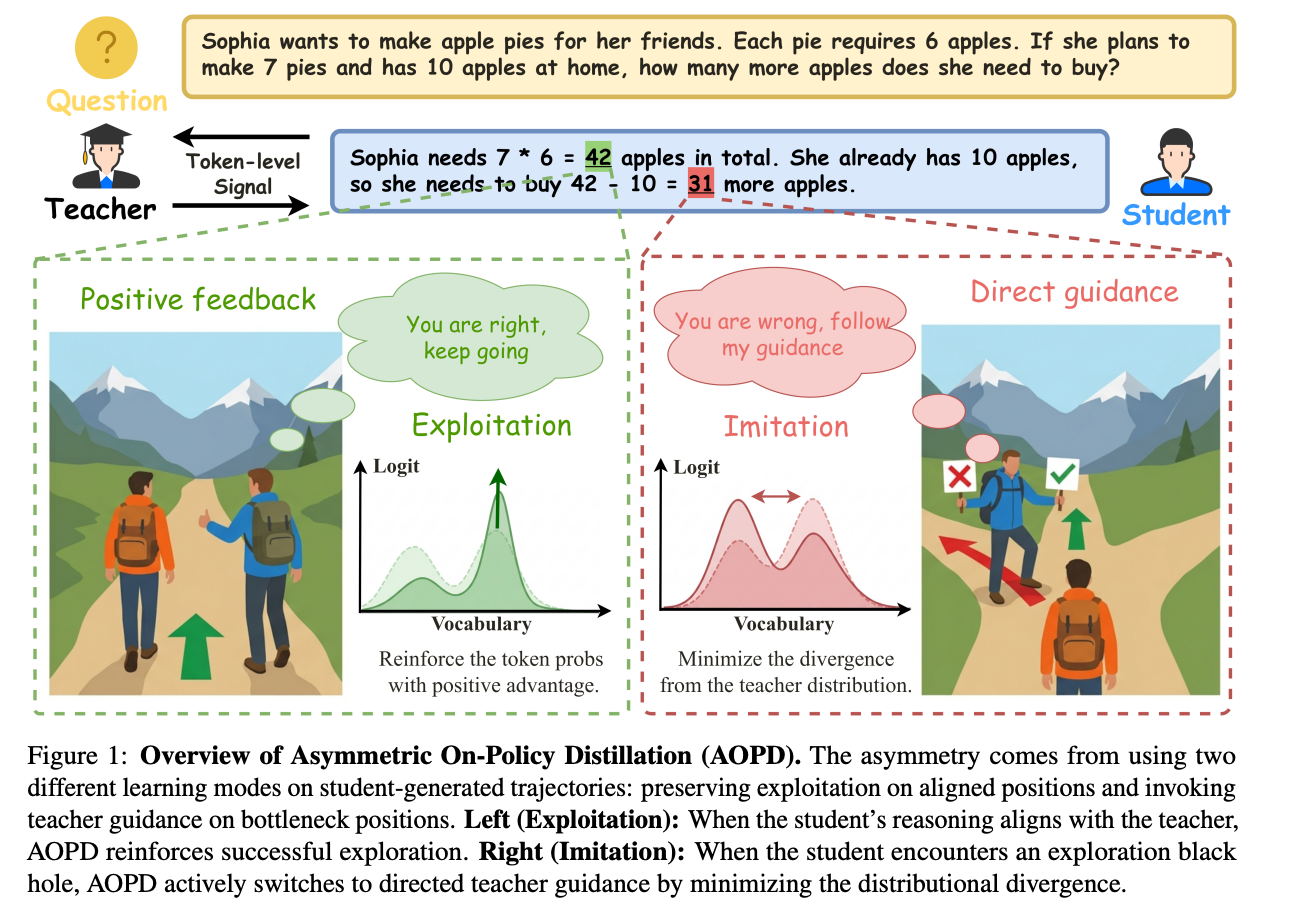
On-Policy Distillation 三大流派:一个方法解决两道难题

On-Policy Distillation 三大流派:一个方法解决两道难题

痛点与破局 RL 训练过的人都知道那种感觉——跑了三天 GRPO,token 消耗是 SFT 的十几倍,最后一看提升,几乎为零。 问题出在哪?Reward 信号太稀疏,credit assignment 做不到 token 级,rollout 全错时梯度直接归零。 但 SFT 也有自己的软肋:推理时
0
0
1653
OpenClaw-RL: 结合 GRPO + OPD,在使用中自适应变强的龙虾

OpenClaw-RL: 结合 GRPO + OPD,在使用中自适应变强的龙虾

在人工智能的发展进程中,我们正见证从纯粹的聊天机器人向能够执行实际任务的计算机使用智能体(Computer-Use Agents) 的范式转移。 OpenClaw-RL 是第一个通过对话自动训练工业级 Agent 的强化学习(RL)库,旨在让模型在真实的交互中实现自我进化。 一、 核心理念:随处部署
0
0
727
MOE 架构如何做 SFT 和 RL?聊聊 post-training 难点与经验

MOE 架构如何做 SFT 和 RL?聊聊 post-training 难点与经验

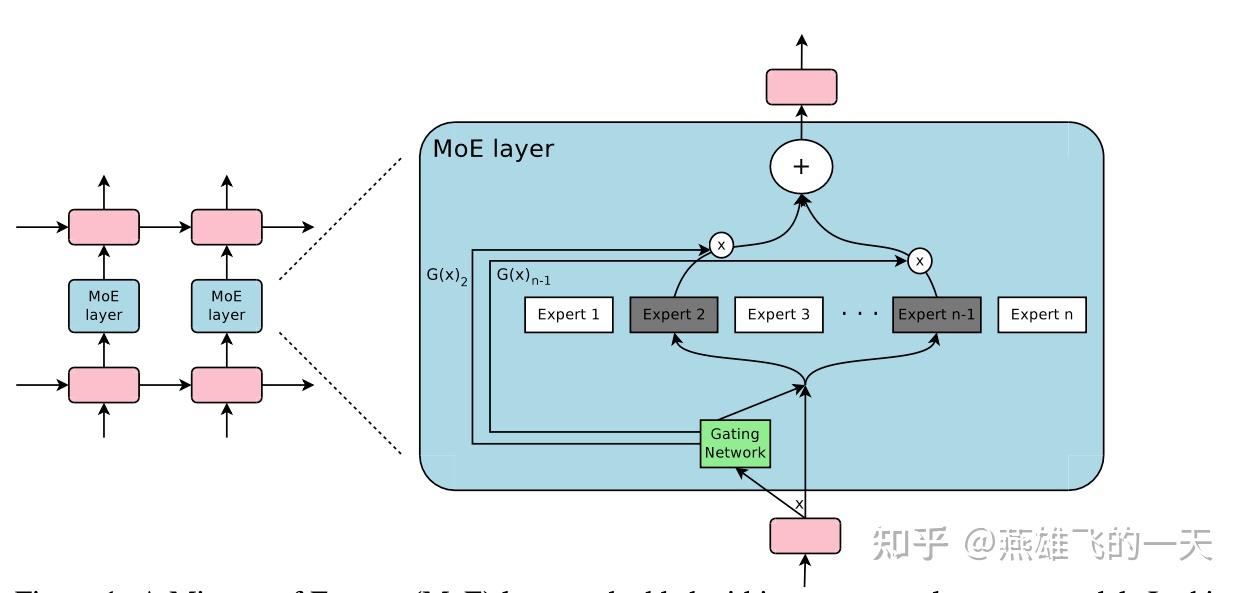
作者:燕雄飞的一天 https://zhuanlan.zhihu.com/p/2018018879109091590 无论是开源还是顶尖商业模型,moe架构已经成为绝对主流,区别于dense模型,在sft和rl阶段有什么独特的训练难点或者挑战,对于这些挑战如何缓解。期望从基础原理入手,看如何训练mo
0
0
773
从 Depth Scaling 到 Width Scaling!WideSeek-R1:通过多智能体 RL 探索大模型的广度扩展(Width Scaling)

从 Depth Scaling 到 Width Scaling!WideSeek-R1:通过多智能体 RL 探索大模型的广度扩展(Width Scaling)

DeepSeek-R1 的成功证明,深度扩展(Depth Scaling)在复杂逻辑推理中具有巨大潜力。但当任务从“深推理”转向“广信息”——如汇总全球头部科技公司多维财务数据——单一大模型往往受限于多轮检索带来的上下文干扰与串行效率瓶颈。 为此,我们提出“广度扩展”(Width Scaling)这
0
0
227
聊聊如何在大模型RL中灵活地控制熵

聊聊如何在大模型RL中灵活地控制熵

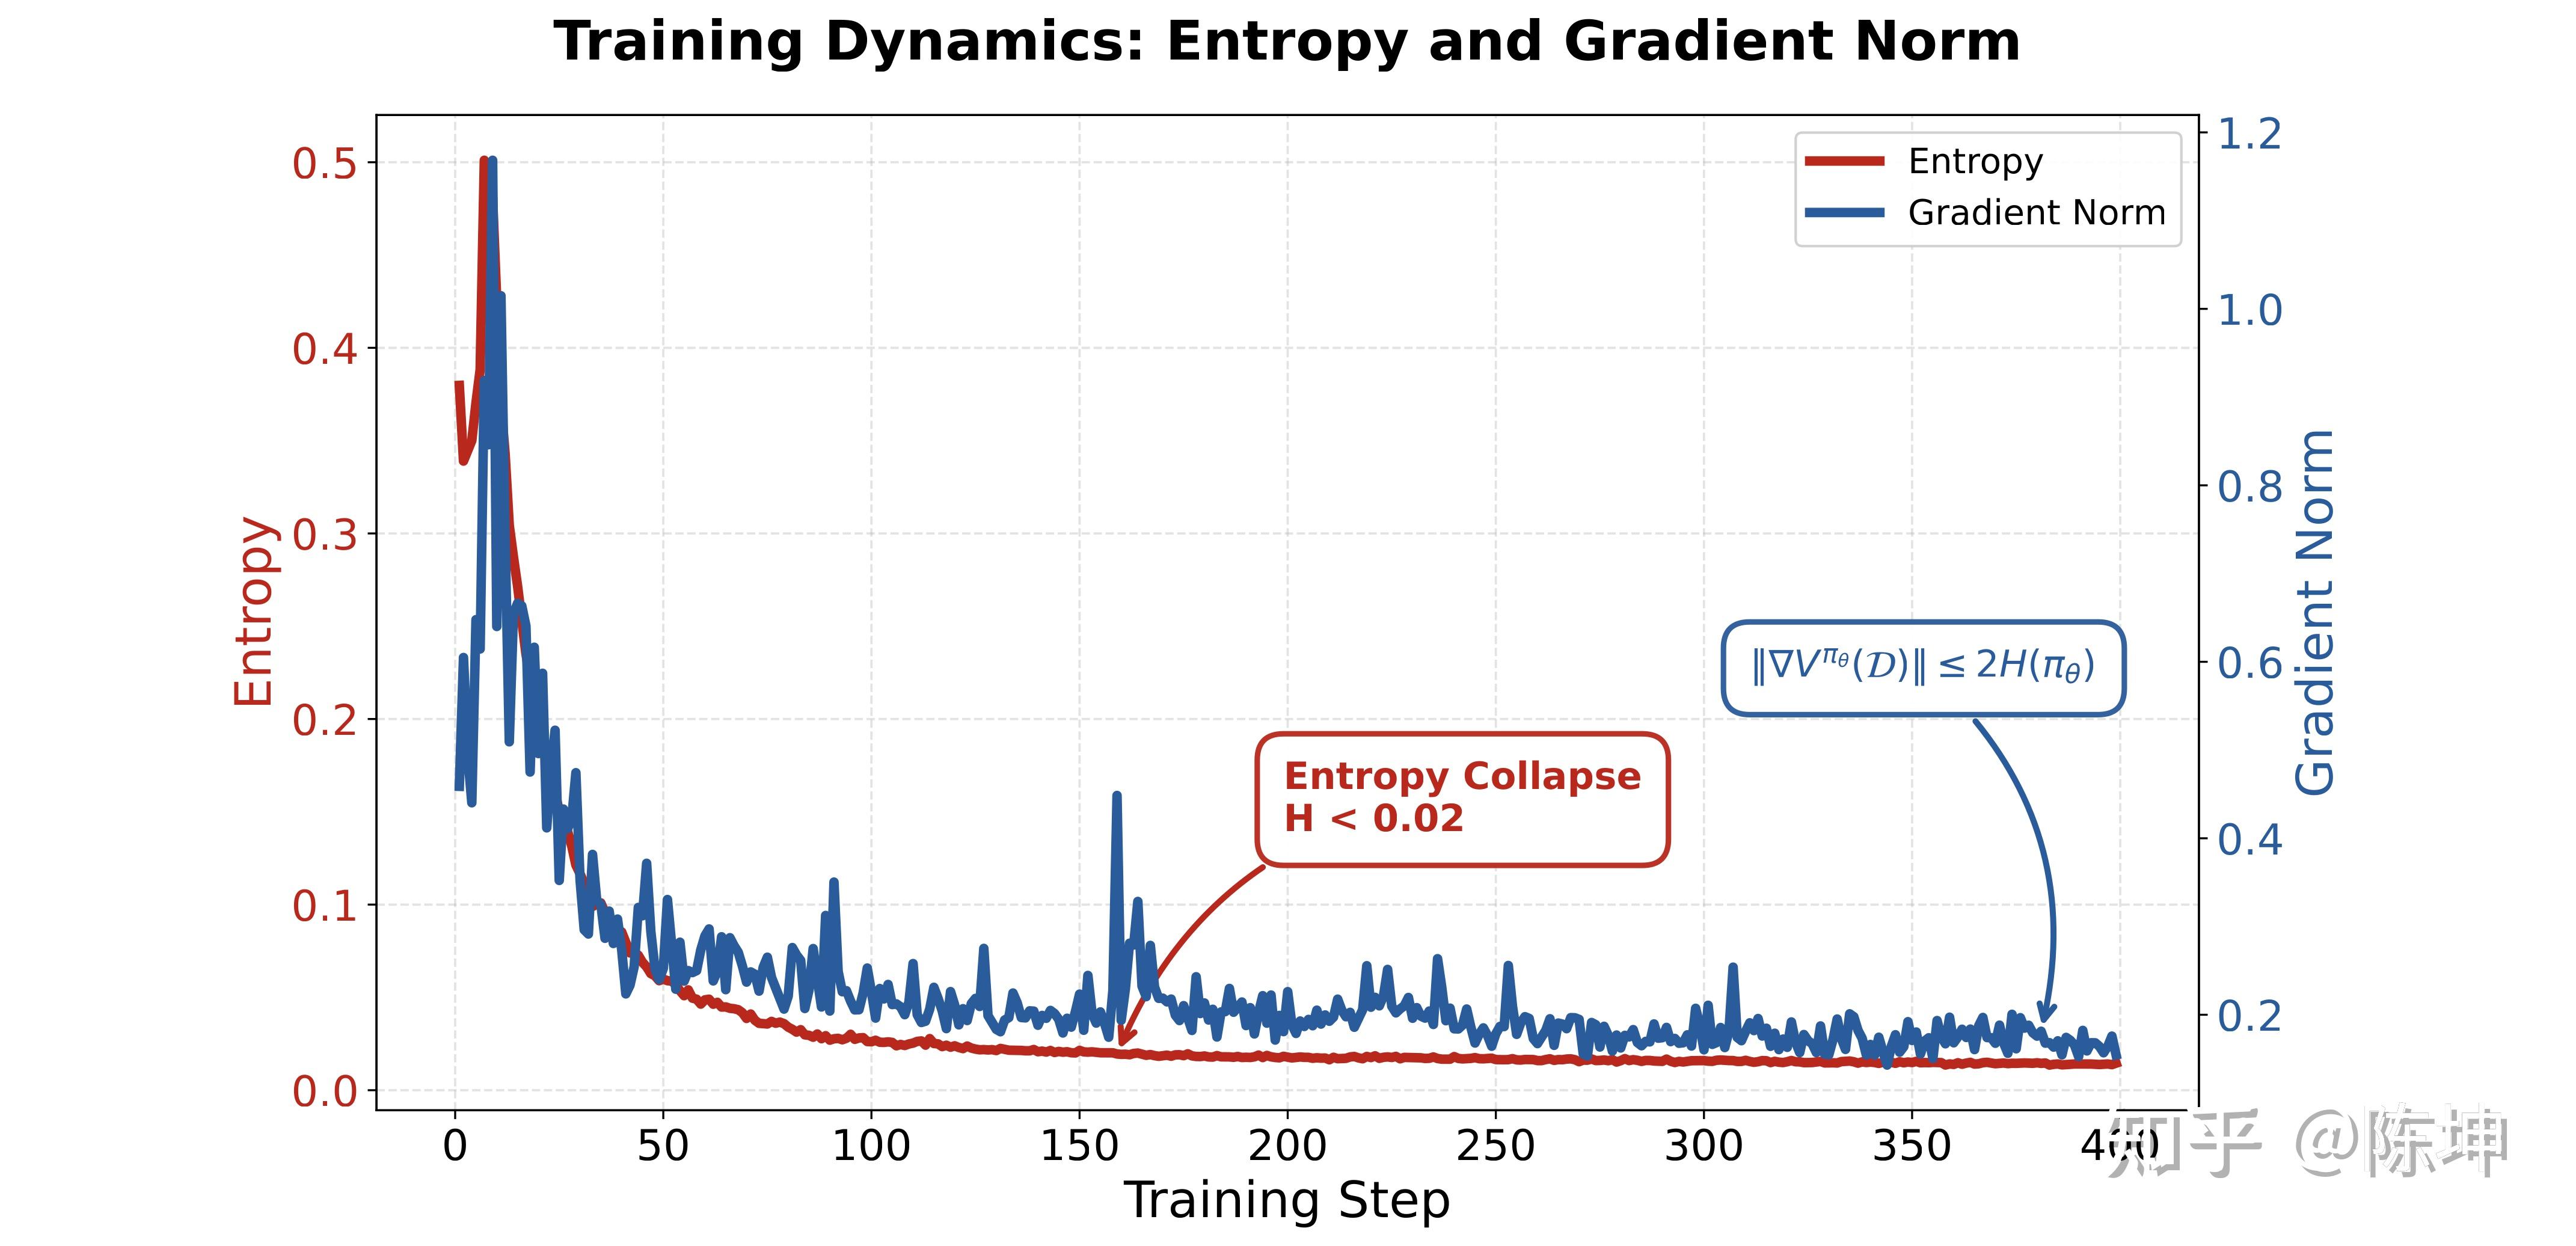
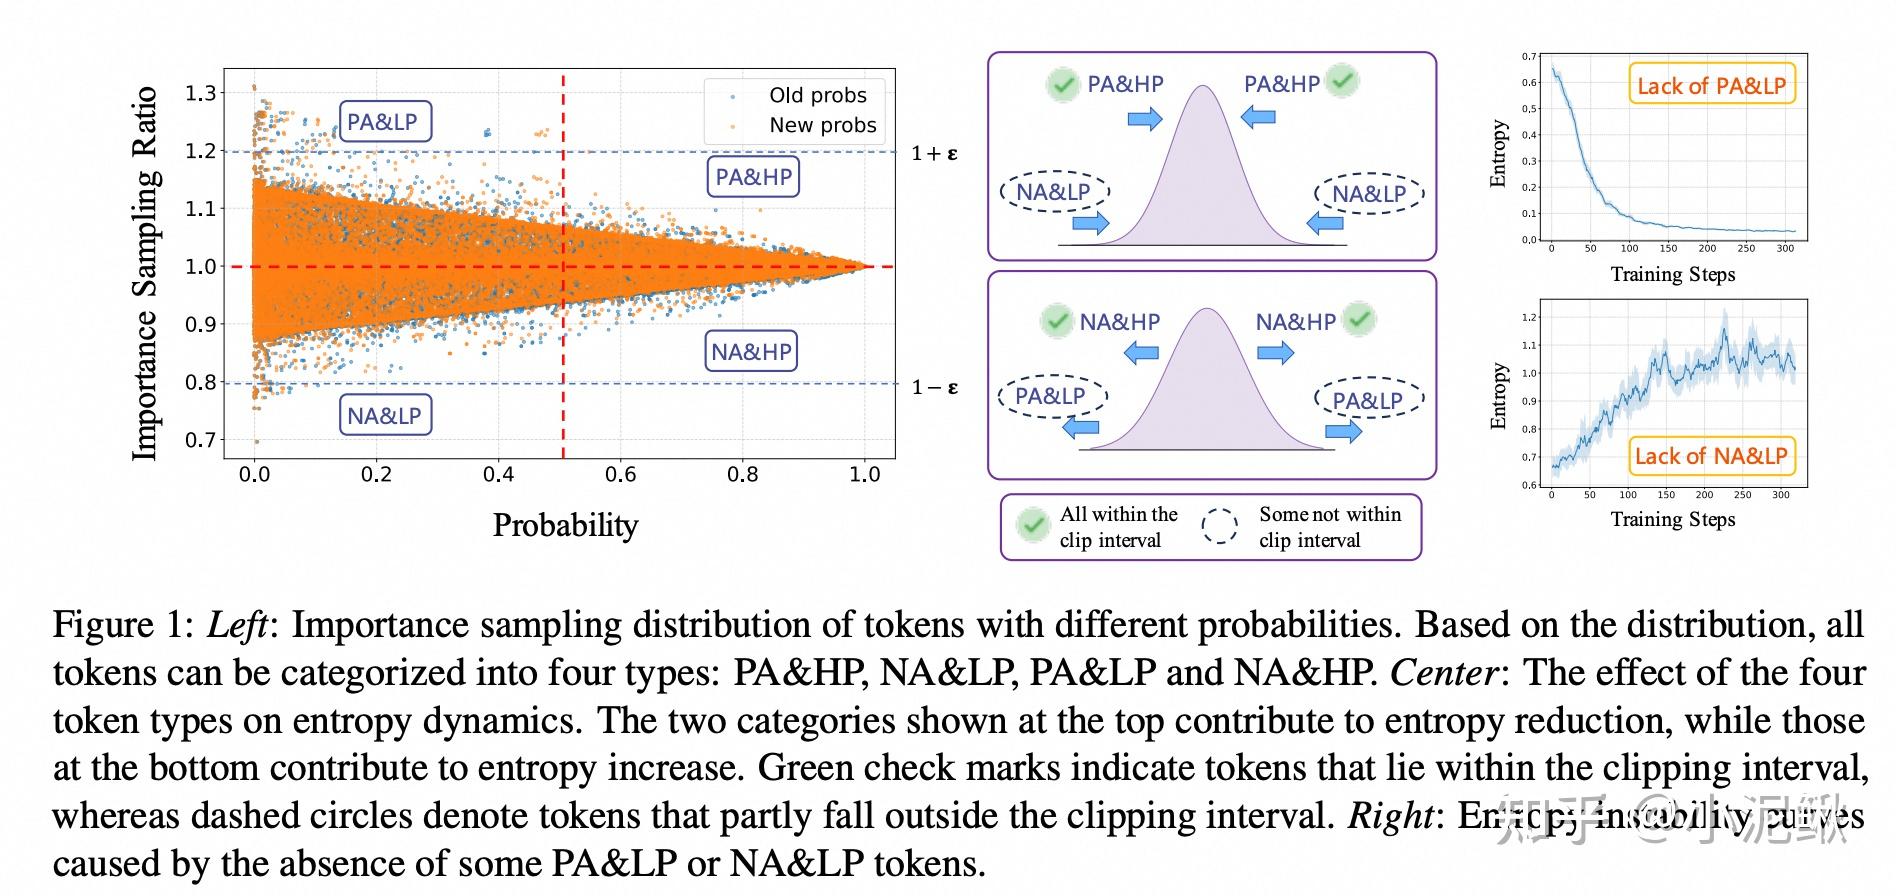
作者:陈坤 史鹏 https://zhuanlan.zhihu.com/p/2017276876004017170 本文介绍我们近期在 RLVR 训练动态方面的一项研究。我们从梯度保留裁剪(Gradient-Preserving Clipping)的理论视角出发,提出了一套灵活的熵调节机制,并基于熵
0
0
370
ICLR 2026 | 大模型的无监督强化学习能走多远?

ICLR 2026 | 大模型的无监督强化学习能走多远?

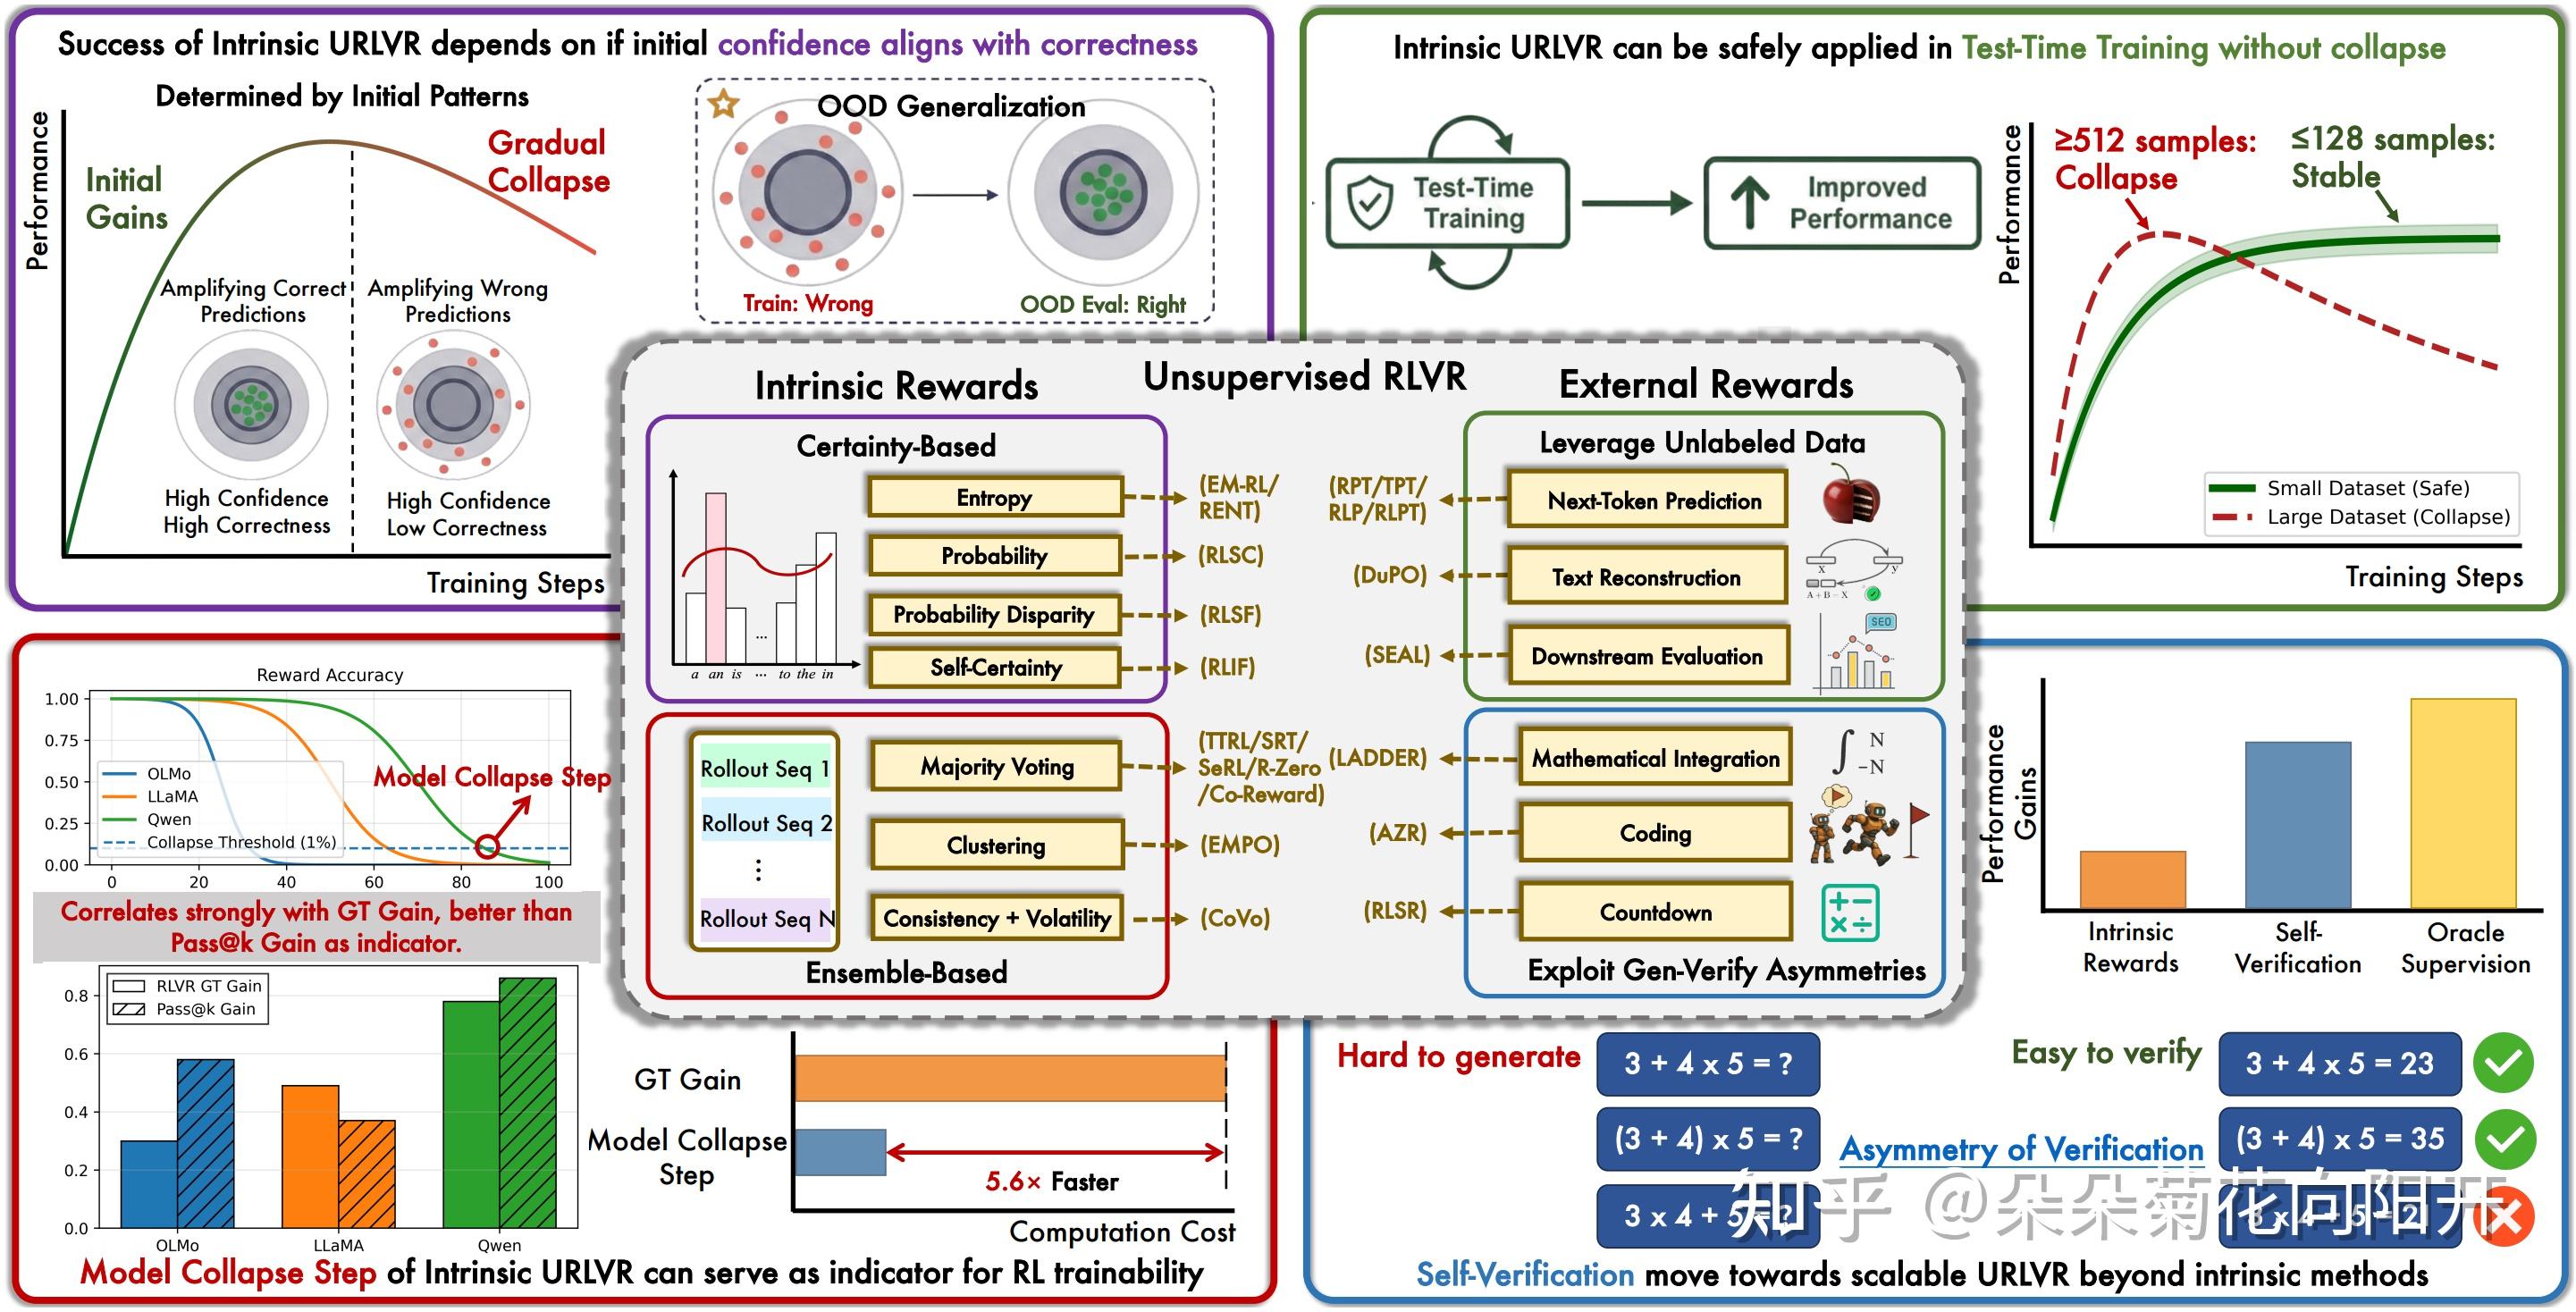
作者:朵朵菊花向阳开 原文:https://zhuanlan.zhihu.com/p/2015470633765593982 从TTRL开始,无监督RLVR(Unsupervised RLVR)应运而生,让模型在没有人工标注的情况下持续进化。这不仅是降本增效的需求,更是通往超级智能的必经之路。就像预
0
0
275
RLinf-USER:面向现实世界机器人在线策略学习的统一且可扩展系统

RLinf-USER:面向现实世界机器人在线策略学习的统一且可扩展系统

USER 是在 RLinf 上搭建的一套面向现实世界在线策略学习的统一且可扩展的系统。 在系统上,它建立了统一的硬件抽象层、自适应通信平面以解决硬件管理和通信问题。 算法侧,它搭建了全异步学习框架,设计了持久化、缓存感知的缓冲区,并提供了奖励函数、算法与策略的可扩展接口。
0
0
277
深度拆解!RLHF 泛化与收敛的可证明界

深度拆解!RLHF 泛化与收敛的可证明界

作者:sheriyuo https://zhuanlan.zhihu.com/p/2011084180654671820 从工程上看,我们通常把 RLHF 当成“在 \pi_{\rm ref} 附近,通过偏好信号或显式 reward 优化策略”的交互学习: 先收集偏好/评分数据,再通过某种带 KL
0
0
152
Agentic RL:解耦 Reasoning 与 Tool-use

Agentic RL:解耦 Reasoning 与 Tool-use

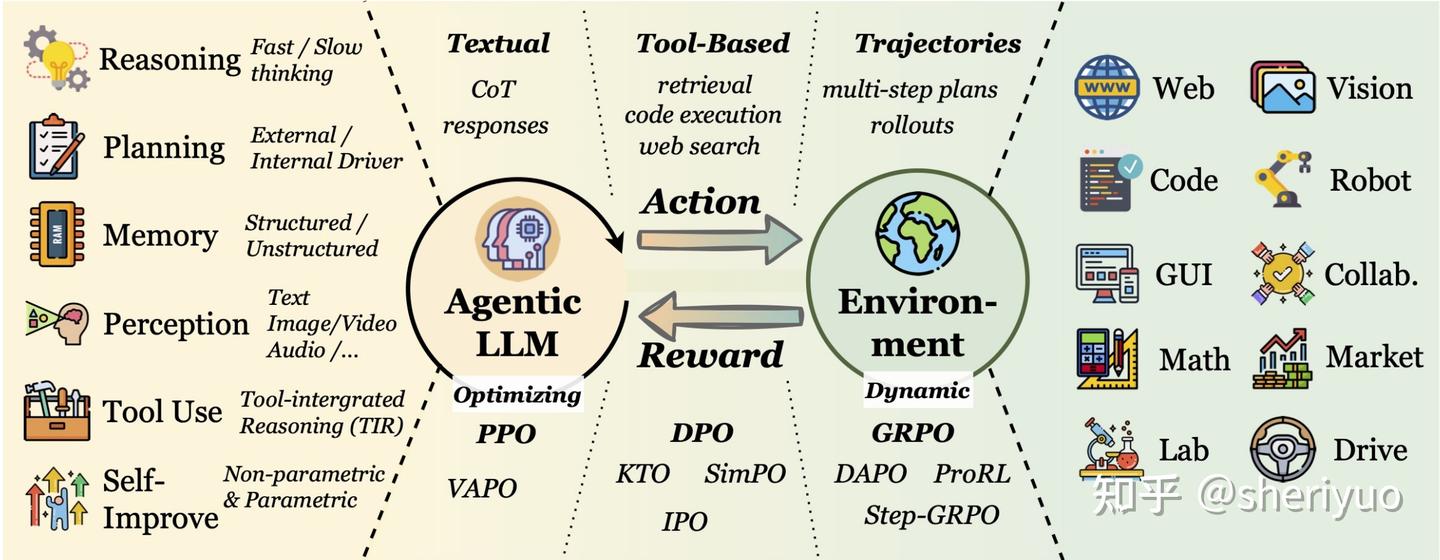
作者:sheriyuo https://zhuanlan.zhihu.com/p/2009946011120971848 近年来,随着 Agentic RL 的兴起,LLM 逐渐从“单次问答器”转变为能够在推理(Reasoning)与外部工具调用(Tool-use)之间反复交互(multi-turn
0
0
567
线性轨迹:揭示 LLM 强化学习中的高效捷径

线性轨迹:揭示 LLM 强化学习中的高效捷径

LLM RL 训练轨迹竟然是线性的?Miaow Lab 最新工作:无需继续训练,直接“预测”未来模型! 研究发现,在RLVR训练过程中,LLM的权重和输出概率演化呈现出显著的线性特征,理论分析发现,这源于低学习率、大Batch Size及Adam优化器的特性。说明昂贵的RLVR存在大量冗余计算。 基
0
0
252
From Traditional RL to LLM RL 理论推导与工程改进

From Traditional RL to LLM RL 理论推导与工程改进

作者:extreme1228 原文:https://zhuanlan.zhihu.com/p/1997363850849300572 过去半年到一年时间,自己也算是在LLM RL领域的一个科研工作者。 自从25年年初DeepSeek-R1横空出世后,LLM RL就变成了一个非常火爆的方向,与此同时基
0
0
276
On-Policy Distillation 是什么?如何做?

On-Policy Distillation 是什么?如何做?

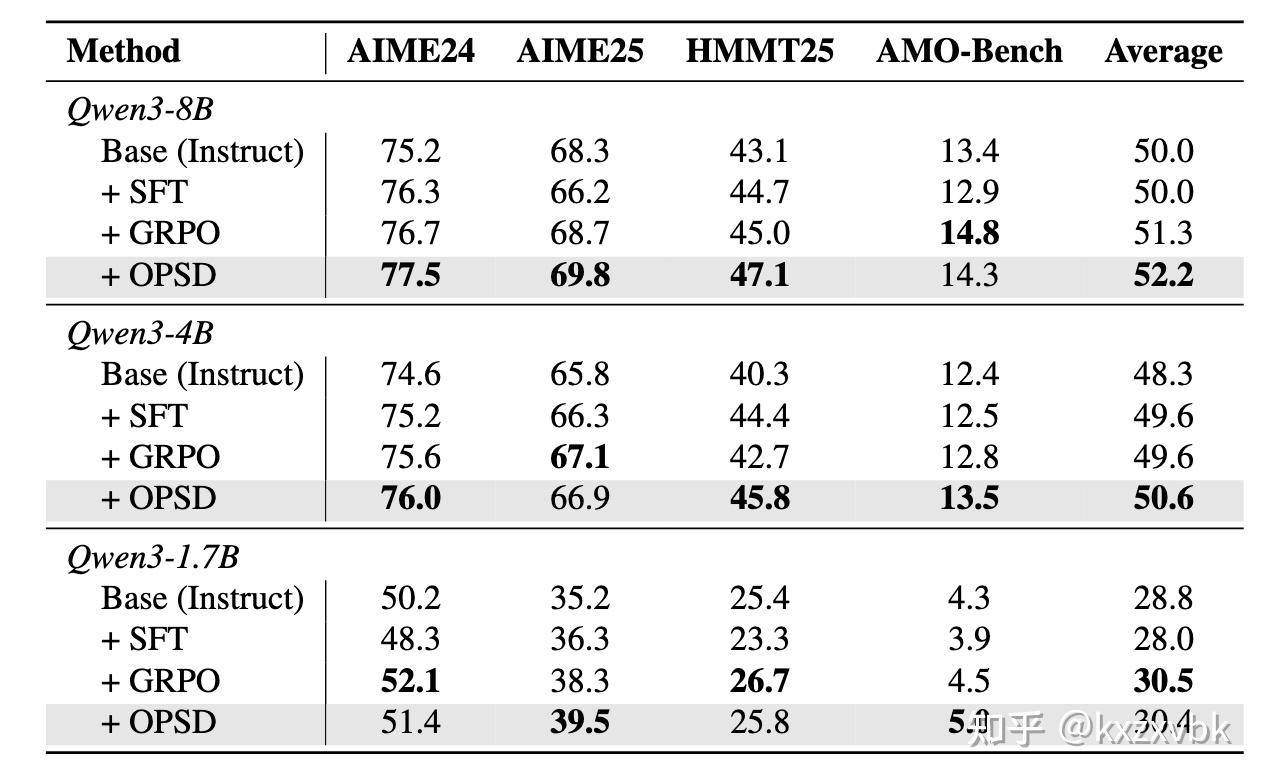
作者:kxzxvbk 原文:https://zhuanlan.zhihu.com/p/2000612721868177979 最近,越来越多 LLM 相关的工作提到了一个关键词 On-Policy Distillation (后文会简称为 OPD),这个方法迅速受到大家的广泛追捧和好评。 本文将从
0
0
1056
Qwen用假信号也能拿高分?虚假的RLVR如何激活隐藏记忆回路?

Qwen用假信号也能拿高分?虚假的RLVR如何激活隐藏记忆回路?

无需真实奖励,哪怕用随机、错误的信号进行训练,大模型准确率也能大幅提升? 此前,学术界已经发现了一个令人困惑的现象:像 Qwen2.5 这样的模型,即使在 RLVR(带验证奖励的强化学习)过程中给予虚假奖励(Spurious Rewards),它在对应测试集上的准确率依然能神奇地大幅提升,并通过一系
0
0
147
超越精度:为什么训练-推理不一致是一个优化问题,以及简单的学习率调度(LR Scheduling)如何修复它

超越精度:为什么训练-推理不一致是一个优化问题,以及简单的学习率调度(LR Scheduling)如何修复它

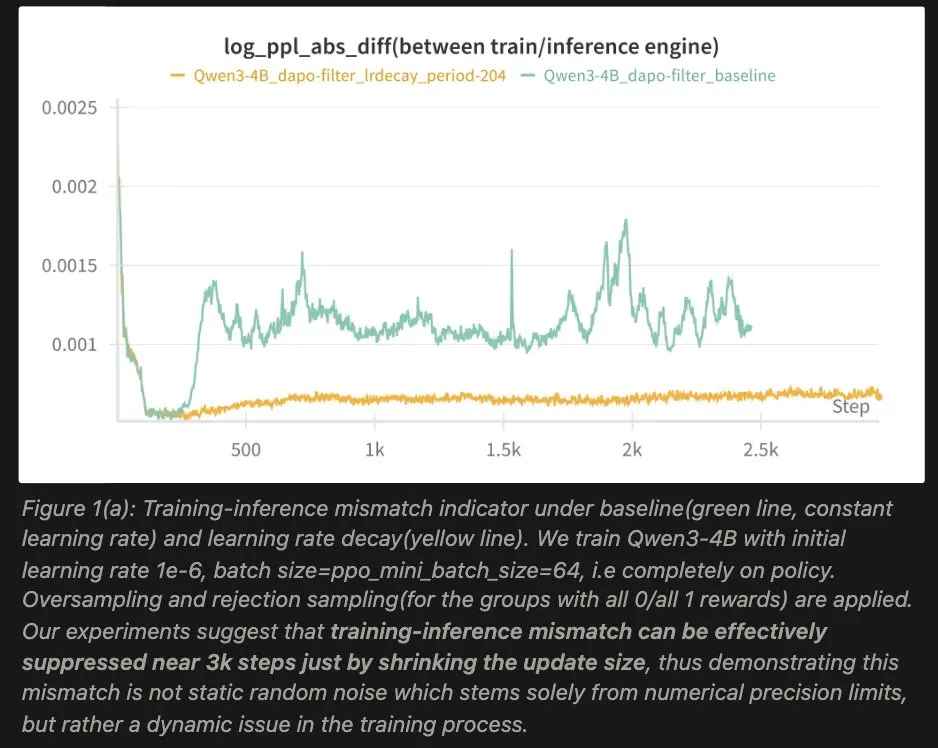
在 LLM 强化学习(RL)的训练中,有一个长期困扰算法工程师的“幽灵”:训练-推理不一致(Training-Inference Mismatch) 。很多时候,你会发现训练开始阶段一切正常,但是一段时间后训练引擎和推理引擎生成token的概率分布就有可能越来越远,accuracy断崖式下跌。 主流
0
0
513
JustRL: 用"最笨"的 RL 方法刷新 1.5B 推理模型新基线

JustRL: 用"最笨"的 RL 方法刷新 1.5B 推理模型新基线

如果有人说:不用分阶段训练、不搞课程学习、不动态调参,只用最基础的 RL 配方也能达到不错的性能,会是怎样的结果? 我们团队用两个 1.5B 模型做了这个尝试。结果在 9 个数学推理基准上达到了 54.87% 和64.32% 的新基线,算力只用了一半,训练过程也很平稳,4000步没遇到什么大问题。 更有趣的是,当我们试着加入一些"应该有用"的优化时,性能反而下降了。也许在某些情况下,简单的方法充分训练后,效果可能比我们预期的要好。这个工作最大的 novelty,也许就在于没有 novelty。
0
0
390
GDPO:解决 GRPO  在多奖励 RL 训练中的"优势崩溃"问题

GDPO:解决 GRPO 在多奖励 RL 训练中的"优势崩溃"问题

随着大模型能力的不断提升,越来越多的研究开始在RL(强化学习)训练中同时优化多种偏好(如正确性、格式、长度、bug ratio等)。 我们发现多奖励强化学习(multi-reward RL)中经常会遇到训练不稳定的问题,并非主要源于奖励设计或权重冲突,而是优势信号在归一化过程中被“压扁”,导致分辨率下降,提出“advantage collapse”这一关键问题。 传统 GRPO 在多奖励场景下的 group-wise normalization 会使不同奖励组合的样本难以区分,削弱学习方向。 为此,研究提出 GDPO,通过逐奖励解耦归一化保留细粒度优势差异,并在聚合后进行 batch 归一化以稳定尺度。实验表明,GDPO 在工具调用、数学推理和代码推理任务中显著提升了训练稳定性与最终性能。 该工作指出,多目标 RL 的核心在于保持训练信号清晰度,为推理模型与智能体训练提供了更可诊断、可复用的方法论。
0
0
468
1 2
正在直播 B 站

视频号直播二维码

用微信扫一扫,在视频号观看直播